Capterra Scraper










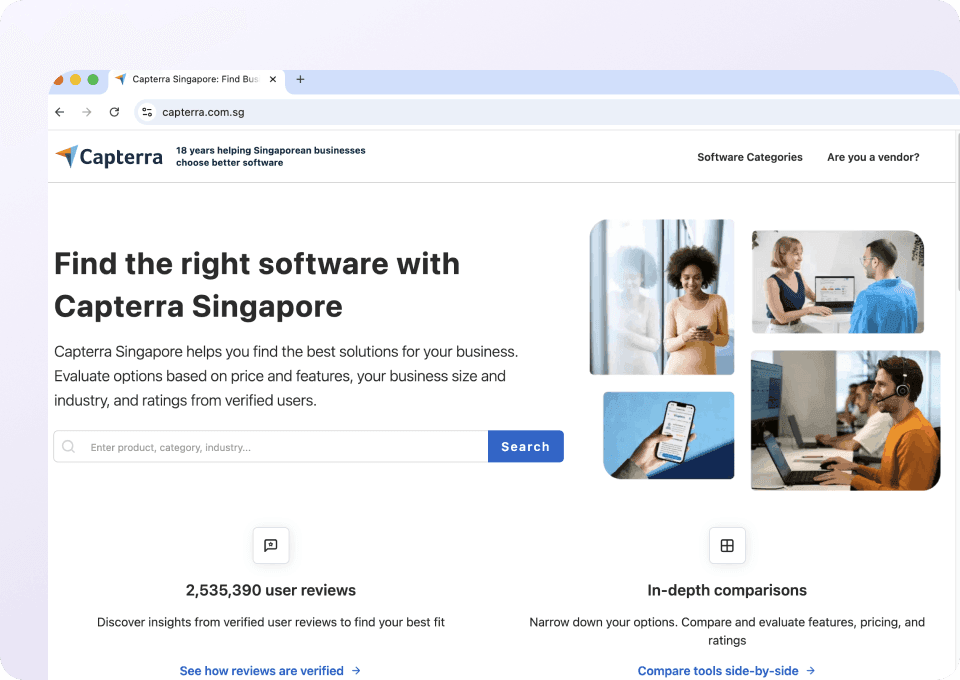
Capterra-Daten mühelos mit Thunderbit extrahieren
Passt sich an Layout-Änderungen bei Capterra an
Genervt davon, dass Scraper bei jedem Design-Update von Capterra versagen? Thunderbit versteht die Seitenstruktur statt starrer CSS-Selektoren. Wenn Capterra ein Feld verschiebt oder ein Listing neu gestaltet, passt sich Thunderbit automatisch an – so extrahieren Sie weiterhin Software-Namen, Bewertungen und Beschreibungen, ohne etwas an Ihrer Einrichtung ändern zu müssen.
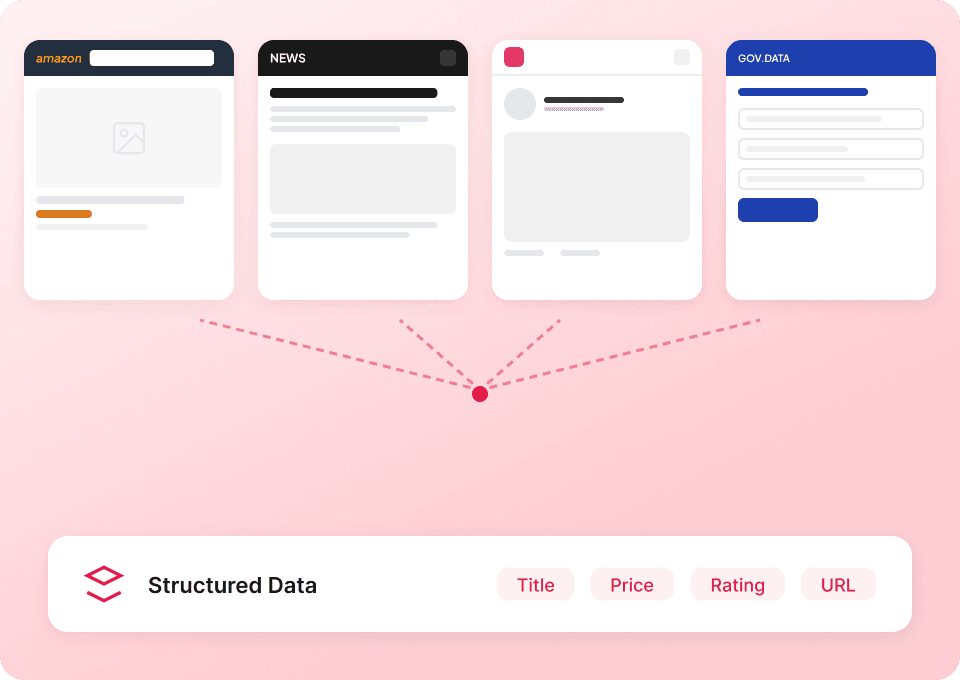
Ein Tool für jede Datenquelle
Verwalten Sie nicht länger für jede Website einen anderen Scraper. Thunderbit funktioniert sofort auf Capterra und bringt über 50 vorgefertigte Vorlagen für weitere beliebte Plattformen mit – von Bewertungsportalen über Verzeichnisse bis hin zu Marktplätzen und mehr. Ein Tool deckt alles ab.
Das volle Capterra-Bild erfassen
Bleiben Sie nicht bei den Daten der Listing-Seite stehen. Thunderbit kann automatisch die Detailseiten jedes Software-Produkts auf Capterra besuchen und ausführliche Beschreibungen, Einstiegspreise, Hauptfunktionen und mehr übernehmen – als neue Spalten in Ihrer Tabelle oder Datenbank Ihrer Wahl.

Schwierigkeiten, Capterra effektiv zu scrapen?
Sehen Sie, wie Thunderbit die Extraktion von Capterra-Daten vereinfacht – selbst bei komplexen Layouts.
Klassische Scraper
Der alte WegThunderbit
Der intelligentere AnsatzVerlass dich nicht nur auf unser Wort
Sieh dir an, was unsere Nutzer über Thunderbit sagen.
Häufig gestellte Fragen
Verwandt Anwendungsfälle
Entdecke weitere Anwendungsfälle für Thunderbits Web-Scraper.
Flixster-Scraper
Mit dem Thunderbit Flixster Web-Scraper können Sie Daten aus Flixsters Top-Box-Office-Listen und nahegelegenen Kinos extrahieren. Dank KI-gestützter Feldvorschläge sammeln Sie im Handumdrehen Filmtitel, Einspielergebnisse, Bewertungen, Erscheinungsdaten, Kinonamen, Standorte und verfügbare Filme – ideal für Analysen oder Recherchen.
Mehr erfahren ->
olympustaff.com Scraper
Mit dem Thunderbit olympustaff.com Web-Scraper können Sie Daten aus Comics-Listen und Kommentaren auf olympustaff.com extrahieren. Dank KI-gestützter Feldvorschläge erfassen Sie schnell Comic-Titel, Autoren, Erscheinungsdaten und Leserfeedback – ideal für Analyse oder Recherche. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Daten von olympustaff.com benötigen.
Mehr erfahren ->
Hatena-Scraper
Mit dem Thunderbit Hatena Web-Scraper können Sie mühelos Daten aus Hatena-Blogs und Themenlisten extrahieren – dank KI-gestützter Feldvorschläge. Sammeln Sie Blogtitel, Autorennamen, Veröffentlichungsdaten, Inhaltszusammenfassungen und Trendthemen für Recherche, Marketing oder Inhaltsanalysen. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Hatena-Daten benötigen.
Mehr erfahren ->
namu.wiki Scraper
Mit dem Thunderbit namu.wiki Web-Scraper können Sie Daten von namu.wiki extrahieren – darunter relevante Seiten und neueste Diskussionen. Dank KI-gestützter Feldvorschläge sammeln Sie schnell und einfach Seitentitel, URLs, letzte Bearbeitungsdaten, Diskussionsthemen und Teilnehmernamen – ideal für Recherche, Content-Erstellung oder Community-Analysen.
Mehr erfahren ->
NetEase Music Scraper
Mit dem Thunderbit NetEase Music Web-Scraper können Sie gezielt Daten aus den Suchergebnissen und Künstlerseiten von NetEase Music erfassen. Dank KI-gestützter Feldvorschläge sammeln Sie Songtitel, Künstlernamen, Albumdetails, Laufzeiten und Song-Links im Handumdrehen – perfekt für Analysen, Recherchen oder Musikliebhaber, die strukturierte NetEase Music Daten benötigen.
Mehr erfahren ->
QQ Music Scraper
Mit dem Thunderbit QQ Music Web-Scraper können Sie gezielt Daten aus den Suchergebnissen und Werkslisten von QQ Music erfassen. Dank KI-gestützter Feldvorschläge sammeln Sie Songtitel, Künstlernamen, Albuminformationen, Veröffentlichungsdaten und vieles mehr im Handumdrehen – perfekt für Analysen oder Recherchen. Ideal für Musikexperten, Marketer und Musikliebhaber, die strukturierte Daten von QQ Music benötigen.
Mehr erfahren ->Bereit, deine Datenextraktion auf das nächste Level zu bringen?
Schließe dich über 200.000 Profis an, die Thunderbit bereits nutzen, um ihre Web-Scraping-Workflows zu automatisieren.
Die kostenlose Testversion bietet unbegrenzte Credits für 8 Webseiten.



