Baidu-Scraper für Suchergebnisse und Artikel










Verwandeln Sie Baidu-Ergebnisse in saubere, nutzbare Daten
Halten Sie Suchergebnisse und verfügbare Artikeldetails in einer klaren Tabelle zusammen.
Baidu-Daten direkt beim Erfassen bereinigen
Thunderbit ordnet sichtbare Titel, URLs, Snippets, Daten und Quellen übersichtlich in Spalten an. Wird ein Feld nicht angezeigt, bleibt die Zelle leer.

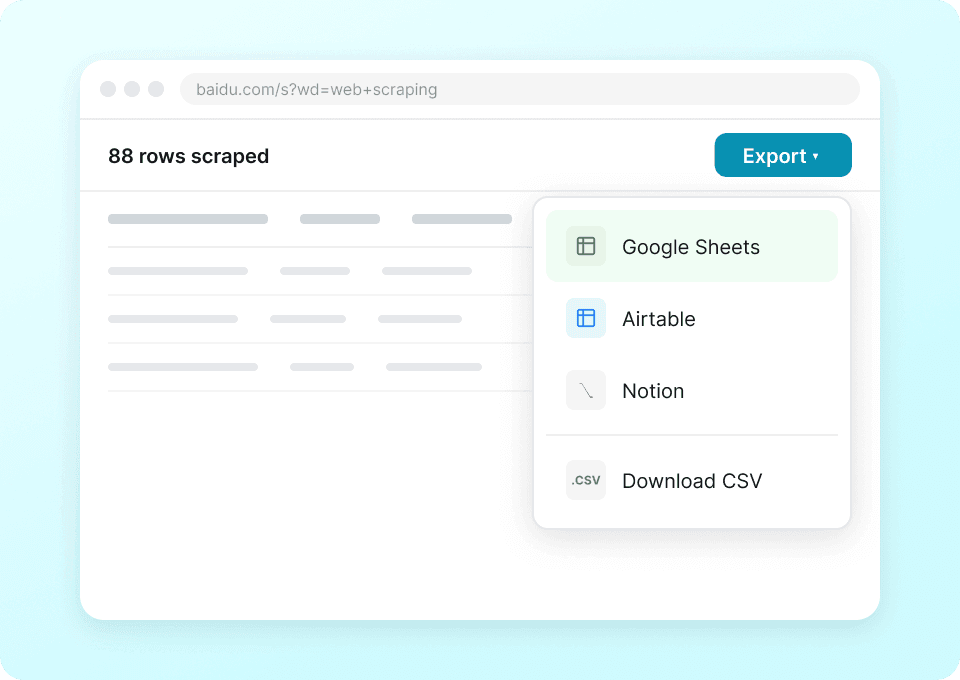
Baidu-Recherche mit einem Klick exportieren
Senden Sie jeden Durchlauf in ein Prüfblatt für Suchergebnisse. Ränge, Quellen, Daten und Details der verlinkten Seite bleiben direkt neben dem passenden Baidu-Ergebnis.
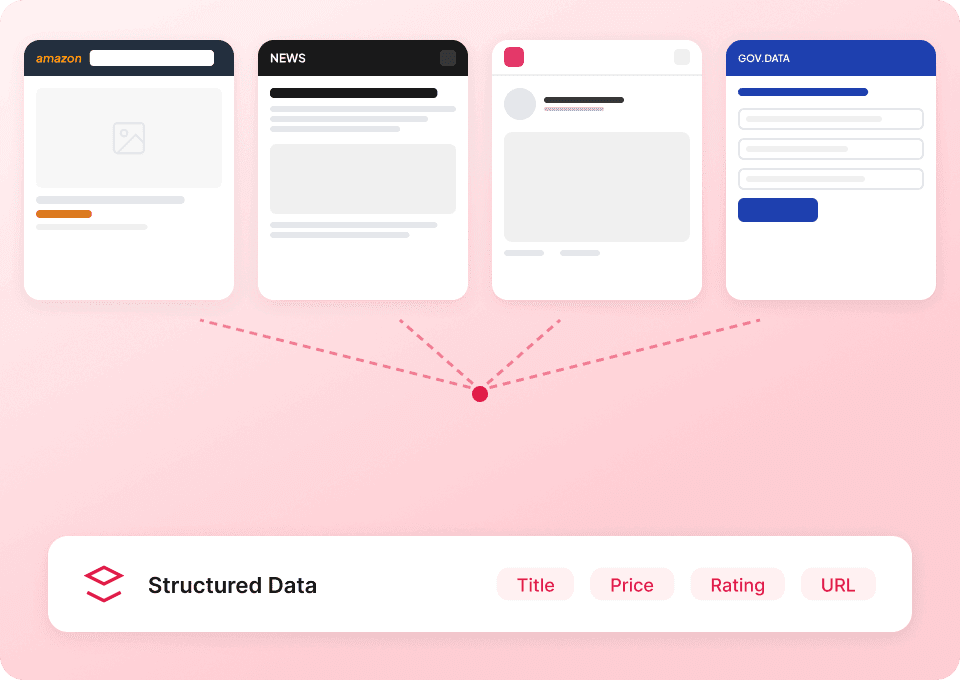
Den gleichen Workflow auf jeder Website nutzen
Thunderbit liest Felder nach Bedeutung, nicht nach einem festen Baidu-Layout. Verwenden Sie denselben Ansatz auf jeder zugänglichen öffentlichen Website, wenn Ihre Recherche eine neue Quelle erreicht.
Behalten Sie den Kontext zu jedem Baidu-Ergebnis
Eine reine Linkliste verliert den Kontext. Thunderbit hält sichtbare Details direkt bei jedem Ergebnis.
Kopierte Links und lose Notizen
Ergebnisdetails gehen auseinanderStrukturierte Baidu-Recherche
Der sichtbare Kontext bleibt bei jedem Ergebnis erhaltenWelche Daten können Sie aus Baidu extrahieren?
Wählen Sie aus diesen öffentlichen, sichtbaren Feldern. Ergebnis-Module und verknüpfte Seiten zeigen nicht für jede Suche alle Felder an.
- Suchanfrage
- Ergebnis-Rang
- Ergebnistitel
- Ergebnis-URL
- Angezeigte URL
- Ergebnis-Snippet
- Ergebnisdatum
- Symbol der Ergebnis-Website
- Verwandter Suchbegriff
- Rechtschreibvorschlag
- Pinyin-Vorschlag
- Seitennummer der Suchergebnisse
- Quellseite
- Quell-Domain
- Autor des Artikels
- Veröffentlichungsdatum des Artikels
- Artikelzusammenfassung
- Dokumentenname
- Dokumentbeschreibung
- Dokument-Breadcrumb
- Dokumenttyp
- Dokumenten-Dateiformat
- Dokument-Seitenanzahl
- Hochladezeit des Dokuments
- Dokument-URL
- Ergebnistyp
- Bildminiatur
- Video-Miniatur
- Standortadresse
- Baidu-Feature-Modul
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.
Fragen zur Erfassung von Baidu-Suchdaten
Verfügbare Felder variieren je nach Suchanfrage, Ergebnistyp und den auf verlinkten Seiten angezeigten Informationen.
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Flixster-Scraper
Mit dem Thunderbit Flixster Web-Scraper können Sie Daten aus Flixsters Top-Box-Office-Listen und nahegelegenen Kinos extrahieren. Dank KI-gestützter Feldvorschläge sammeln Sie im Handumdrehen Filmtitel, Einspielergebnisse, Bewertungen, Erscheinungsdaten, Kinonamen, Standorte und verfügbare Filme – ideal für Analysen oder Recherchen.
Mehr erfahren ->
olympustaff.com Scraper
Mit dem Thunderbit olympustaff.com Web-Scraper können Sie Daten aus Comics-Listen und Kommentaren auf olympustaff.com extrahieren. Dank KI-gestützter Feldvorschläge erfassen Sie schnell Comic-Titel, Autoren, Erscheinungsdaten und Leserfeedback – ideal für Analyse oder Recherche. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Daten von olympustaff.com benötigen.
Mehr erfahren ->
Hatena-Scraper
Mit dem Thunderbit Hatena Web-Scraper können Sie mühelos Daten aus Hatena-Blogs und Themenlisten extrahieren – dank KI-gestützter Feldvorschläge. Sammeln Sie Blogtitel, Autorennamen, Veröffentlichungsdaten, Inhaltszusammenfassungen und Trendthemen für Recherche, Marketing oder Inhaltsanalysen. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Hatena-Daten benötigen.
Mehr erfahren ->
namu.wiki Scraper
Mit dem Thunderbit namu.wiki Web-Scraper können Sie Daten von namu.wiki extrahieren – darunter relevante Seiten und neueste Diskussionen. Dank KI-gestützter Feldvorschläge sammeln Sie schnell und einfach Seitentitel, URLs, letzte Bearbeitungsdaten, Diskussionsthemen und Teilnehmernamen – ideal für Recherche, Content-Erstellung oder Community-Analysen.
Mehr erfahren ->
NetEase Music Scraper
Mit dem Thunderbit NetEase Music Web-Scraper können Sie gezielt Daten aus den Suchergebnissen und Künstlerseiten von NetEase Music erfassen. Dank KI-gestützter Feldvorschläge sammeln Sie Songtitel, Künstlernamen, Albumdetails, Laufzeiten und Song-Links im Handumdrehen – perfekt für Analysen, Recherchen oder Musikliebhaber, die strukturierte NetEase Music Daten benötigen.
Mehr erfahren ->
QQ Music Scraper
Mit dem Thunderbit QQ Music Web-Scraper können Sie gezielt Daten aus den Suchergebnissen und Werkslisten von QQ Music erfassen. Dank KI-gestützter Feldvorschläge sammeln Sie Songtitel, Künstlernamen, Albuminformationen, Veröffentlichungsdaten und vieles mehr im Handumdrehen – perfekt für Analysen oder Recherchen. Ideal für Musikexperten, Marketer und Musikliebhaber, die strukturierte Daten von QQ Music benötigen.
Mehr erfahren ->Bereit, deine Datenextraktion auf das nächste Level zu bringen?
Schließe dich über 200.000 Profis an, die Thunderbit bereits nutzen, um ihre Web-Scraping-Workflows zu automatisieren.
Die kostenlose Testversion bietet unbegrenzte Credits für 8 Webseiten.



