

Thunderbit 的 PubMed 爬虫 能借助 AI,把 PubMed 页面快速整理成干净、结构化的数据集。你可以提取热门医学研究、临床试验证据、摘要、作者、机构、发表日期、PMID 和文章链接,然后导出到 Excel、Google Sheets、Airtable 或 Notion。只需在 Chrome 中打开 PubMed,让 AI 推荐最佳字段,再点击抓取即可。
🧬 什么是 PubMed 爬虫
PubMed 爬虫 是专为 PubMed | US National Library of Medicine 打造的 AI 网页爬虫。借助 Thunderbit(一款 AI 网页爬虫 Chrome 扩展),你可以进入任意 PubMed 结果页,点击 AI Suggest Columns,再点击 Scrape,无需编写代码即可提取结构化数据。
🔎 使用 PubMed 可以抓取什么
PubMed 包含大量高价值的生物医学元数据,但它们通常并不是现成可分析的格式。Thunderbit 的 AI 网页爬虫 (https://thunderbit.com/) 可以帮你收集并整理 PubMed 列表,还能通过 子页面抓取 进一步补充文章级信息(打开每篇文章页面,追加摘要、机构、DOI 等字段)。
下面是两个常见的工作流,你几分钟内就能跑起来。
📈 抓取 PubMed 热门医学研究监测数据
这个工作流适合监控 PubMed 热门页面上的医学研究趋势。你可以用它来跟进最新动态、整理内部简报、追踪竞品发表,或为文献监测流程提供数据。
目标页面示例:PubMed Trending
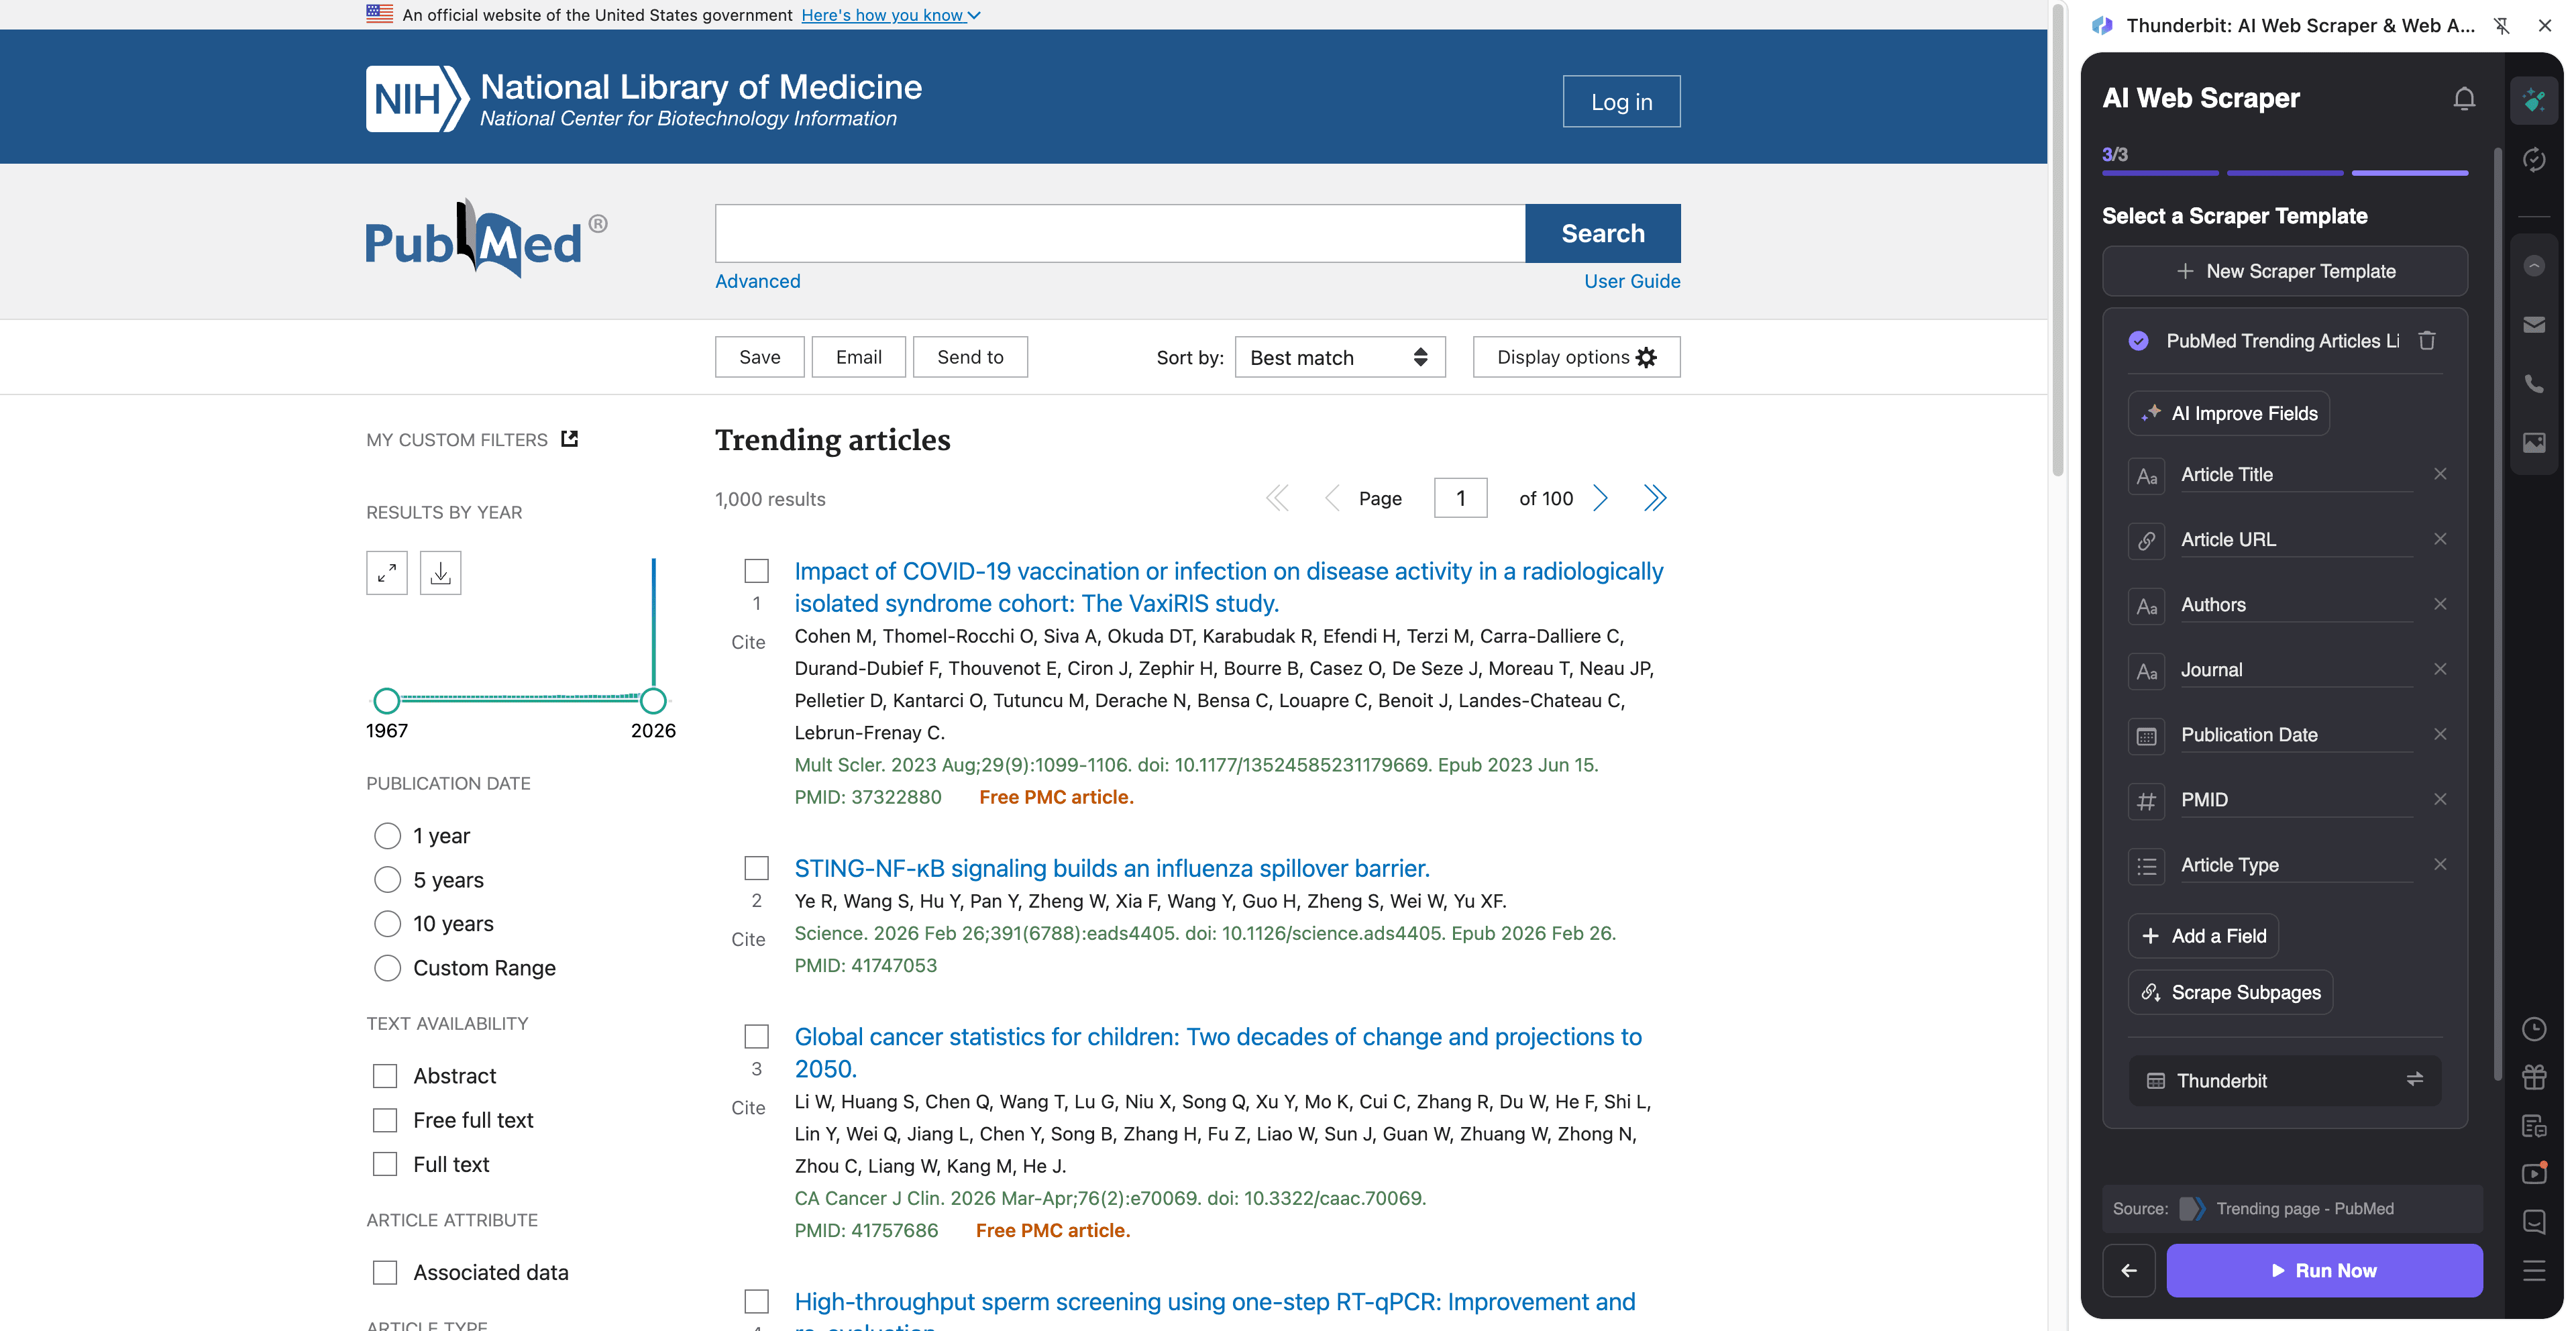
步骤:
- 下载 Thunderbit Chrome Extension 并注册账号。
- 前往目标页面,例如:PubMed Trending。
- 点击 AI Suggest Columns,让 AI 推荐最佳列名和数据类型。
- 点击 Scrape 提取数据,然后导出到 Excel、Google Sheets、Airtable 或 Notion。
列名
| 列 | 说明 |
|---|---|
| 🧾 文章标题 | 热门 PubMed 文章的标题。 |
| 🔗 文章 URL | 指向 PubMed 记录页面的直接链接。 |
| 🆔 PMID | 该记录的 PubMed 标识符(适合作为稳定主键)。 |
| 🏛️ 期刊 | 文章发表的期刊名称。 |
| 📅 发表日期 | 列表中显示的发表日期。 |
| ✍️ 作者 | 结果卡片上显示的作者字符串。 |
| 🧪 文章类型 | 可见时的发表类型(例如 Review、Clinical Trial)。 |
| 🏷️ 关键词 / 主题 | 列表中可见的主题标签或关键词(如果有)。 |
| 📝 摘要片段 / 概要 | 列表中显示的简短片段文本(如果有)。 |
| 🧷 DOI | DOI(通常通过子页面抓取效果更好)。 |
| 🧑🔬 机构信息 | 作者机构归属(通常通过子页面抓取提取)。 |
| 📄 摘要 | 摘要正文(通常通过子页面抓取提取)。 |
🧫 抓取 PubMed 临床试验证据
这个工作流适合从 PubMed 搜索结果中提取与临床试验相关的证据,然后再访问文章页面,为每一行补充摘要、试验信号以及审阅所需的元数据。
目标页面示例:临床试验搜索结果
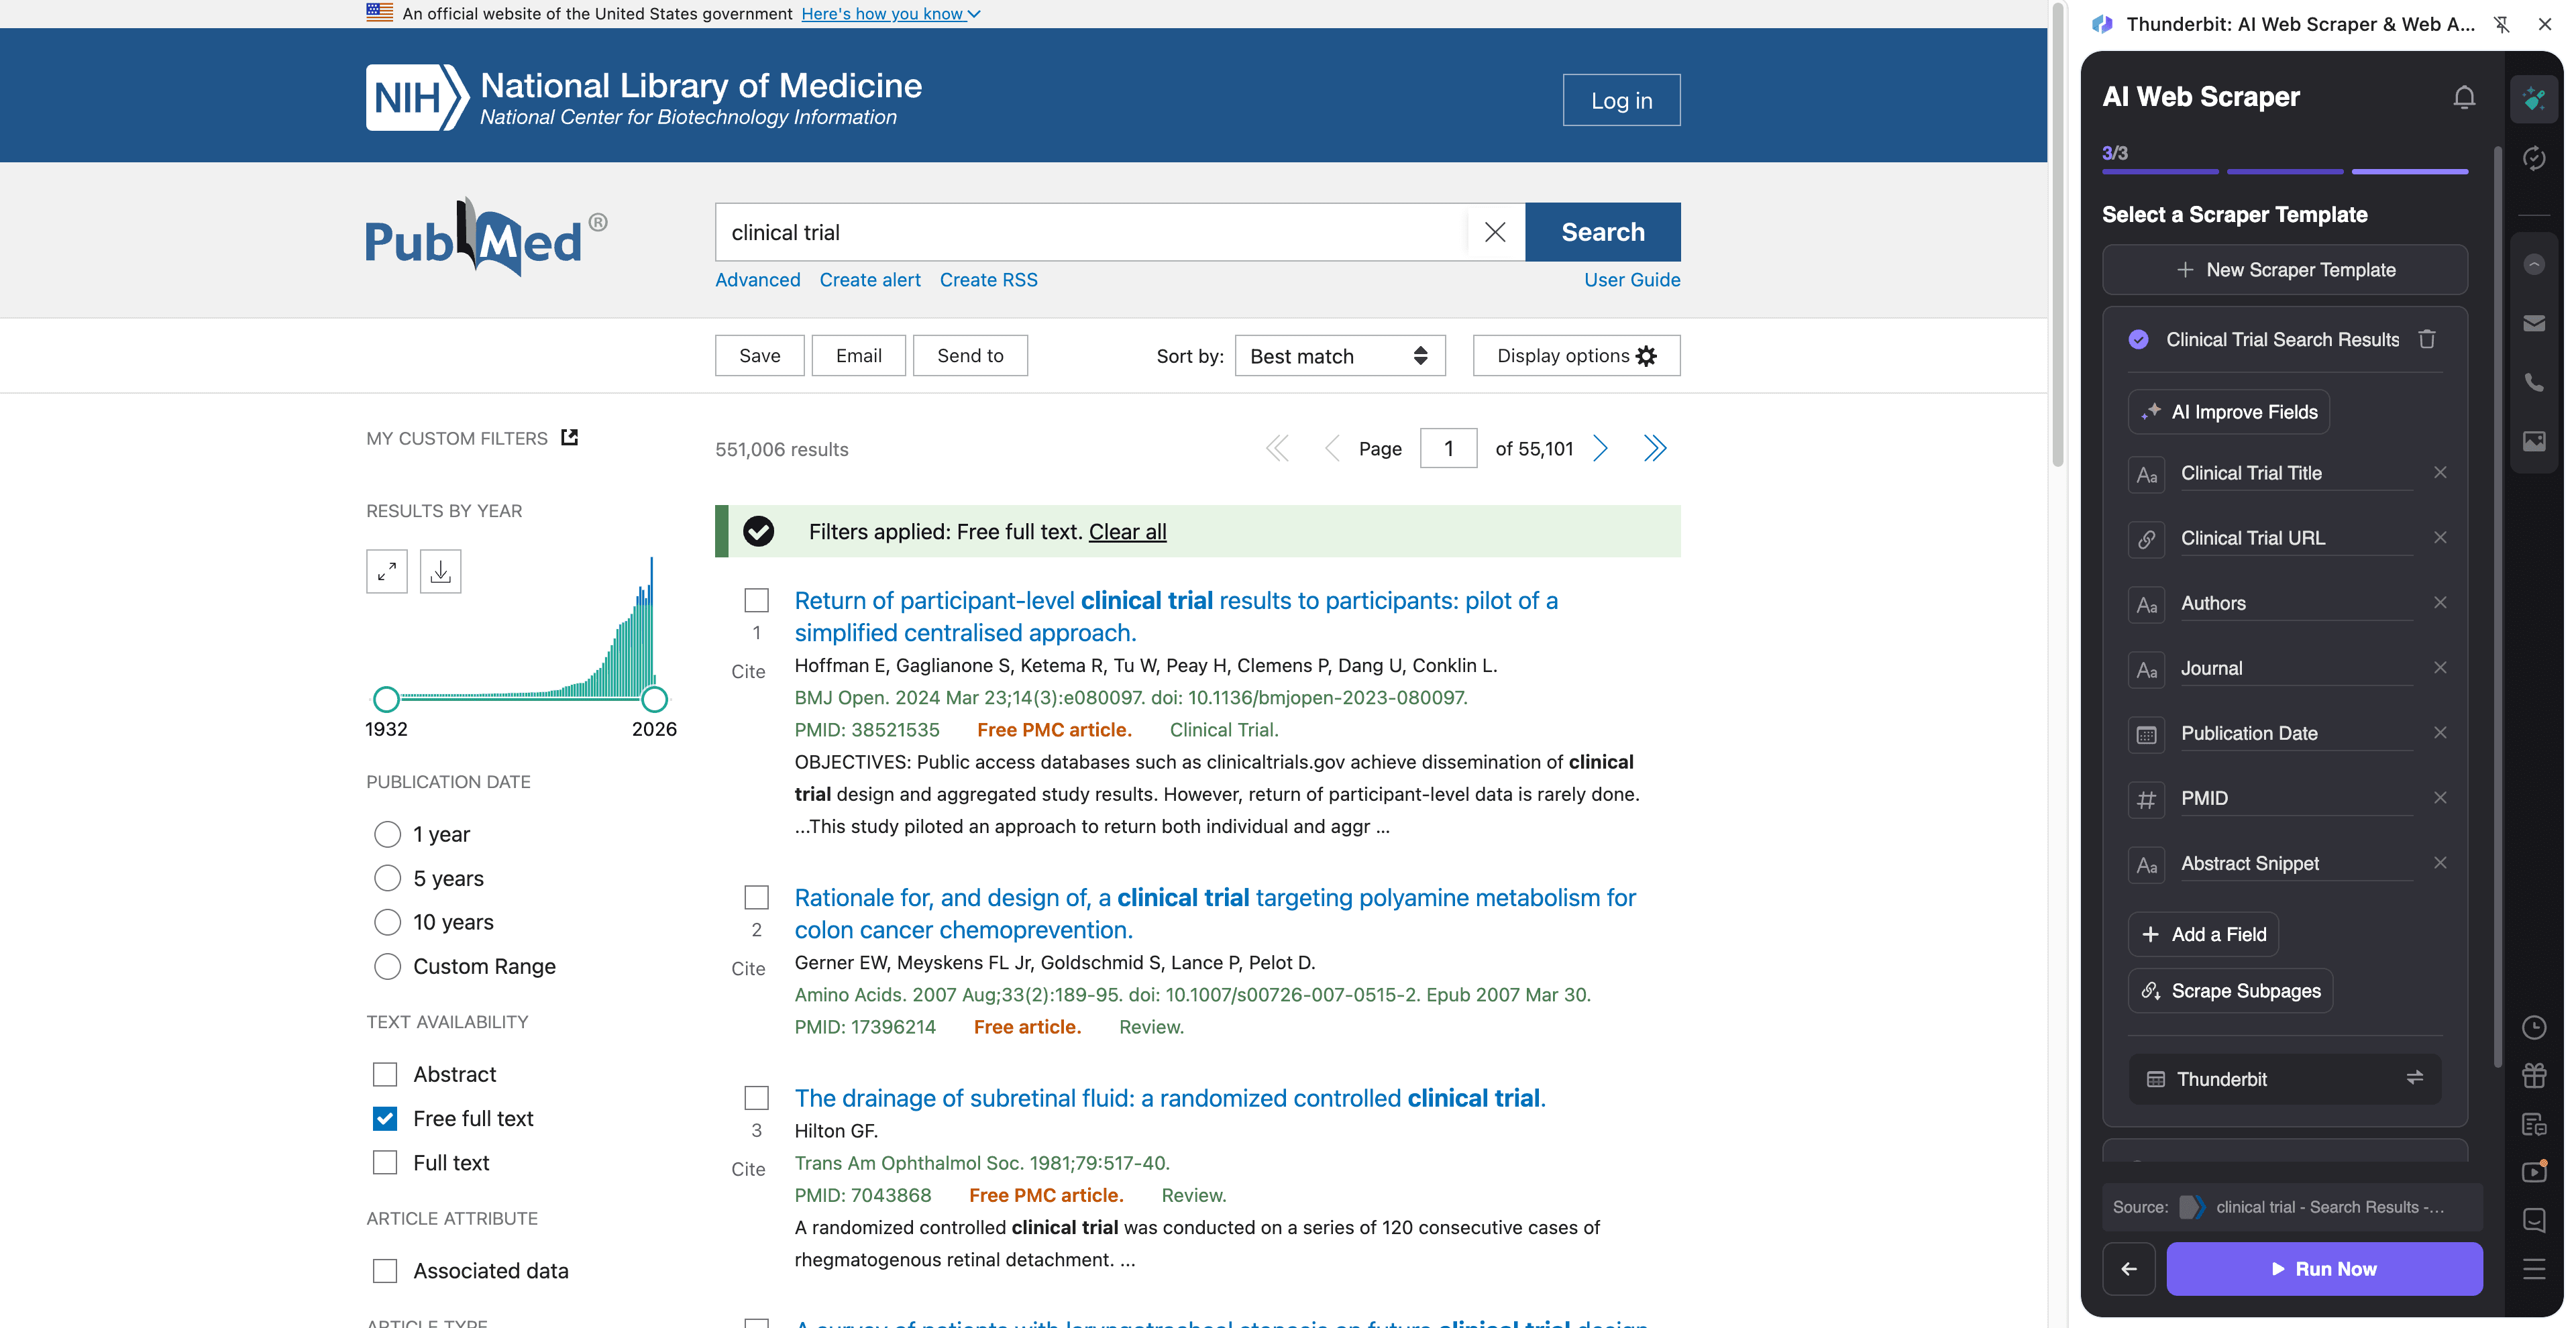
步骤:
- 下载 Thunderbit Chrome Extension 并注册账号。
- 前往目标页面,例如:临床试验搜索结果。
- 点击 AI Suggest Columns 生成推荐字段(你也可以重命名或自行添加字段)。
- 点击 Scrape 收集结果,再使用 Scrape Subpages 为每一行补充摘要、机构、DOI 等信息。
列名
| 列 | 说明 |
|---|---|
| 🧾 标题 | 搜索结果中的文章标题。 |
| 🔗 PubMed URL | 指向 PubMed 文章页面的链接,便于后续补充子页面数据。 |
| 🆔 PMID | 用于去重和引用的 PubMed 标识符。 |
| 🧑⚕️ 作者 | 结果摘要中列出的作者。 |
| 🏛️ 期刊 | 结果中显示的期刊名称和引文信息。 |
| 📅 日期 | 列表中显示的发表日期(或 ePub 日期)。 |
| 🧪 发表类型 | 例如 Clinical Trial、Randomized Controlled Trial、Meta-Analysis 等信号(通常在文章页面更清晰)。 |
| 🧾 摘要 | 完整摘要正文(建议通过子页面抓取)。 |
| 🧬 MeSH 术语 | 可用时的医学主题词(通常在文章页面)。 |
| 🧷 DOI | 用于链接到出版商页面和参考文献管理工具的 DOI。 |
| 🏥 机构信息 | 作者机构信息,便于做机构分析(通过子页面抓取)。 |
| 🌍 国家 / 机构 | 通过 Field AI Prompts 从机构信息中解析得出(可选)。 |
| 🔍 临床试验关键词 | AI 标注的“randomized”“double-blind”“placebo”等标记(可选,通过 Field AI Prompt)。 |
| 📎 全文链接 | 指向出版商或可免费下载全文的外链(如有)。 |
🎯 为什么要用 PubMed 工具
抓取 PubMed 的核心价值在于速度、一致性,以及让研究数据能真正融入你的工作流。你不必再一条条复制引文,而是能搭建可筛选、可打标签、可共享的结构化数据集。
团队常见的抓取原因包括:
- 医学事务与制药团队:追踪某治疗领域的新发表,监控竞品试验,并为内部评审整理证据表。
- 生物科技与临床运营团队:收集试验相关文献,梳理机构和研究者,并维护持续更新的文献库。
- 医疗营销与内容团队:识别热门话题、高影响力期刊和新兴关键词,用于内容规划。
- 学术研究人员与图书馆员:搭建文献综述数据集,按 PMID 去重,并导出到表格中进行筛选。
- 数据团队:为后续分析、仪表盘或内部知识库创建结构化输入。
当你需要的不只是列表页时,Thunderbit 尤其有用。借助 子页面抓取,你可以批量提取摘要、机构、DOI、MeSH 术语和全文链接。
🧩 如何使用 PubMed Chrome 扩展
- 安装 Thunderbit Chrome Extension:前往 Chrome Web Store 安装并创建账号。
- 打开 PubMed 页面:进入 PubMed、Trending 这样的热门页面,或像 clinical trial results 这样的查询结果页。
- 启动 AI 驱动爬虫:点击 AI Suggest Columns 生成字段,调整数据类型(text/date/url),并添加可选的 Field AI Prompts(用于标注、格式化或提取试验信号)。
- 抓取并导出:点击 Scrape。如果你需要摘要/机构/MeSH,再运行 Scrape Subpages 为每一行补充信息,然后导出到 Excel、Google Sheets、Airtable 或 Notion。
如果你正在搭建可重复使用的工作流,推荐阅读:
💳 PubMed 定价
Thunderbit 采用简单的积分机制:
- 1 积分 = 结果表中的 1 行输出(例如一条 PubMed 记录)。
- 数据导出免费:可下载 CSV/JSON,或发送到 Excel、Google Sheets、Airtable、Notion。
你可以从以下方案开始:
- 免费版:每月可抓取 6 个页面(Free 方案按页面数限制)。
- 免费试用:可免费抓取 10 个页面,非常适合测试 PubMed 热门页面和少量临床试验结果页。
如果你会定期抓取(每周监测、证据更新或大规模查询),付费方案会提供更多积分。与按月付费相比,年度方案通常更划算,因为包含折扣。
你可以在 Thunderbit Pricing 查看详细方案。
❓ 常见问题
-
什么是 AI 驱动的 PubMed 爬虫?
AI 驱动的 PubMed 爬虫是 Thunderbit 中的一种工作流,可从 PubMed 搜索结果和文章页面提取结构化数据。你可以用 AI 推荐字段、抓取列表页,并通过访问文章子页面,为摘要、机构、DOI 等内容补充信息。 -
Thunderbit 是什么?
Thunderbit 是一款 AI 网页爬虫 Chrome 扩展,专为需要从网站获取结构化数据的商业和研究工作流而设计。它能帮助你快速提取、标注并导出数据,无需编写或维护爬虫脚本。 -
可以抓取 PubMed 热门页面和普通搜索结果吗?
可以。你既可以抓取 PubMed Trending 页面,也可以抓取标准关键词搜索和筛选后的结果页(例如聚焦临床试验的查询)。Thunderbit 的 AI 会读取页面并自动提出字段建议,以适应不同布局。 -
Thunderbit 能提取摘要、机构和 MeSH 术语吗?
可以,而且这正是 子页面抓取 最有用的地方。你可以先抓取结果列表,再让 Thunderbit 打开每个 PubMed 记录页面,把摘要正文、机构、MeSH 术语、DOI 和其他元数据提取到同一张表里。 -
PubMed 的分页和无限滚动怎么处理?
Thunderbit 支持分页抓取,包括“下一页”式的导航。如果 PubMed 调整了结果加载方式,AI 提取通常比固定选择器更稳定,因为它会在每次运行时重新读取页面结构。 -
PubMed 数据可以导出成哪些格式?
你可以导出为 CSV 或 JSON,也可以将数据集发送到 Excel、Google Sheets、Airtable 或 Notion。这对筛选流程、证据表、仪表盘以及协作共享都很有用。 -
我可以免费抓取多少条 PubMed 记录?
在免费版中,你每月可抓取 6 个页面,这通常足以覆盖小规模监测任务。通过免费试用,你可以免费抓取 10 个页面,用于验证列设置和子页面补充策略。 -
我能否根据具体证据提取需求自定义列?
可以。你可以重命名列、设置数据类型(text/date/url),并添加 Field AI Prompts 来提取或标记信息,例如试验设计关键词、研究人群、干预措施、对照、结局,或从机构信息中提取国家。这样你就不只是做原始抓取,而是在构建结构化证据准备流程。 -
抓取 PubMed 合适吗?
PubMed 是公开资源,很多团队会收集其中的书目信息用于研究和分析。不过你仍需遵守适用法律、尊重网站条款,并采用负责任的抓取方式,尤其是在执行大规模、高频任务时。
📚 了解更多
- 获取扩展: Thunderbit Chrome Extension 下载页
- 浏览 Thunderbit 博客 上的指南
- 学习基础知识: 什么是数据抓取,以及如何在 2025 年完成
- 搭建列表工作流: 什么是列表爬取,以及如何借助 AI 完成
- 导出到表格: 如何使用 AI 将网站数据抓取到 Excel
- 如果你在研究运营中也会抓取 PDF: 如何使用 AI 从 PDF 中抓取数据










