
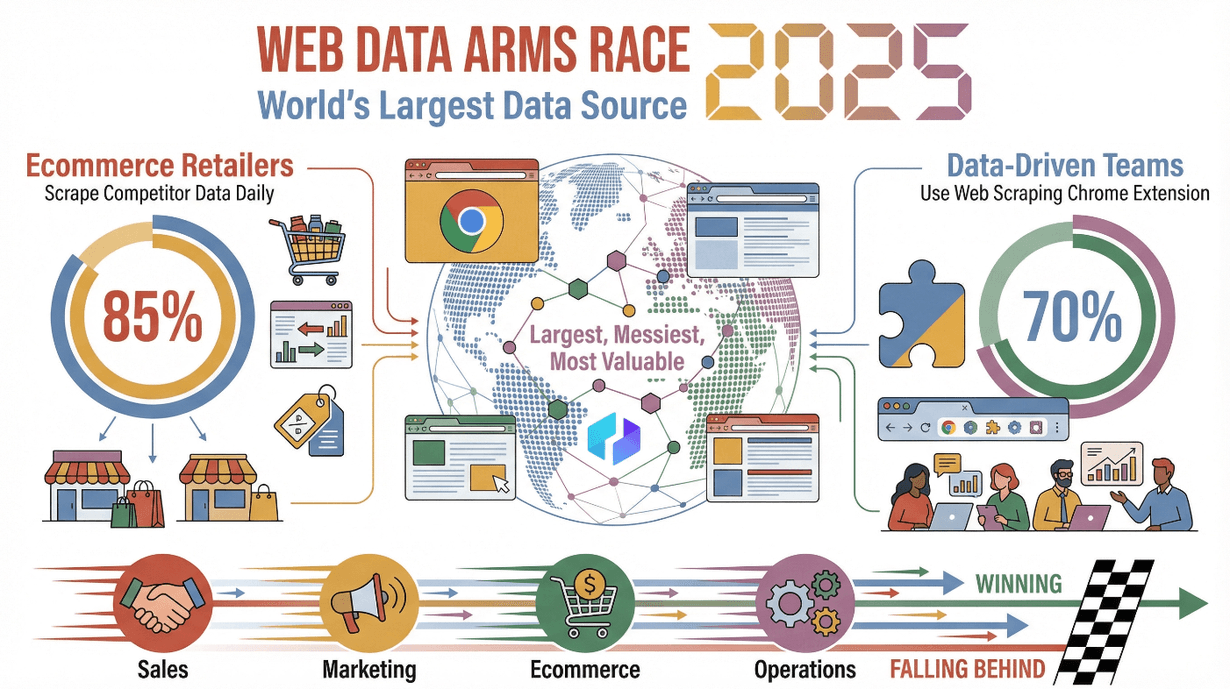
网页早就不只是猫咪视频和表情包的集合了——它已经成了全球最大、最杂乱、也最有价值的数据来源。现在,企业正卷进一场实打实的数据竞赛:零售商每天盯着竞争对手的定价,而越来越多数据驱动的团队,已经开始直接用浏览器插件,而不是提工程需求工单。无论你是在销售、营销、电商还是运营岗位,只要能更快、更准地拿到需要的数据,而且格式还对路,通常就意味着你先赢一步。
 但问题是:网站不会主动把数据整理好递到你手上。它们往往内容杂、结构还会动态变化,本来就是给人看、给人点的,不是给表格处理准备的。这时候,网页爬虫工具就特别顶用——它们能把乱七八糟的信息转成干净、结构化的表格,真正方便你拿来用。我在 SaaS 和自动化领域做了很多年,也亲眼见过选对工具能帮团队省下大量时间、提高准确率,还能挖出那些原本就在眼前、却很容易被忽略的洞察。
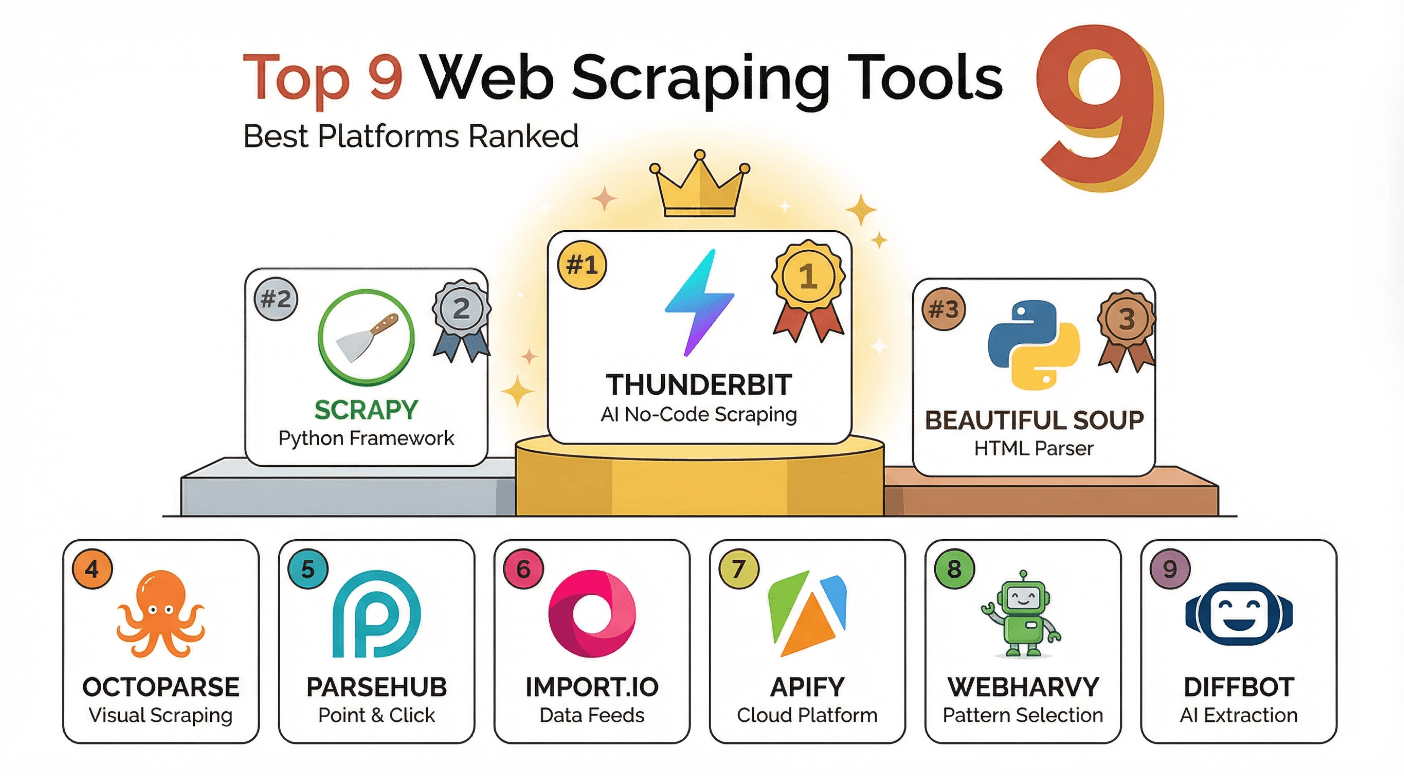
那么,2025 年到底哪些网页爬虫工具真的值得花时间?我整理了 9 款最值得看的选择——从面向商务用户的 AI Chrome 扩展,到适合开发者的开源框架。接下来一起看看。
为什么网页爬虫工具对现代企业如此重要
使用 AI 从任何网站抓取数据 Get Started Free
网页爬虫工具是更聪明的销售、更精准的营销和更敏捷运营背后的秘密武器。它们之所以重要,原因包括:
- 线索开发: 销售团队会抓取名录、LinkedIn 和评论网站,批量整理潜在客户名单。
- 竞品分析: 营销和电商团队持续监控竞争对手的价格、上新和广告投放,很多时候甚至是实时追踪。
- 市场研究: 研究人员和分析师会汇总评论、新闻和用户反馈,在竞争对手之前先发现趋势。
- 价格监控: 零售商和品牌会追踪数百个网站上的价格与库存情况,以保持竞争力(Kanhasoft)。
- 内容汇总: 运营团队会从招聘网站、房产列表或供应商目录中提取数据,以简化工作流程。
下面这张简表,快速展示了网页爬虫工具如何推动业务成果:
| 业务场景 | 手动处理痛点 | 网页爬虫解决方案 |
|---|---|---|
| 线索开发 | 从几十个网站复制粘贴 | 自动提取、批量导出 |
| 价格监控 | 每天手动检查 | 定时爬取、即时提醒 |
| 市场研究 | 阅读成百上千条评论 | 汇总后的结构化数据 |
| 内容汇总 | 整合多个网站的数据 | 一键导出到 Excel/Sheets |
| 竞品分析 | 数据慢、不完整 | 实时、全面的洞察 |
回报非常明显:用了现代爬虫工具的团队,原本要花好几天做的调研和数据收集,现在几个小时就能搞定;销售团队也经常直接拿抓到的数据来定制话术和方案。
我是如何筛选出最佳网页爬虫工具的
不是所有网页爬虫工具都一个样。有些是给想零代码出结果的商务用户准备的;有些则更适合开发者,用来做定制化的大规模项目。下面是我挑选最佳工具时重点看的维度:
- 易用性: 非技术用户能不能快速上手?界面是不是一看就懂?
- 扩展性: 能不能处理几百页甚至几百万页?支不支持自动化和定时任务?
- 数据导出能力: 能不能导出到 Excel、Google Sheets、Airtable、Notion,或者通过 API 导出?
- 支持与社区: 有没有完善文档、教程和及时响应的支持?
- 价格与性价比: 有没有免费版?付费方案是不是透明、合理?
- 独特功能: AI 提取、子页面抓取、API 集成,或者可视化工作流等。
我也给每款工具匹配了最适合的业务场景,帮你根据需求和技术水平找到最合适的选择。
1. Thunderbit
Thunderbit 是我最推荐给商务用户的选择——它能用 AI 完成网页爬取,而且完全不用被技术细节折腾。作为一款 Chrome 扩展,Thunderbit 专为销售、营销、电商和运营团队打造,帮助他们快速拿到准确、结构化的数据。
Thunderbit 的特别之处在于,它把“简单”和“强大”结合得很到位:
- AI 智能字段推荐: 点击“AI Suggest Fields”,Thunderbit 会自动识别页面内容,推荐列名(如姓名、价格、邮箱),甚至还会为每个字段生成提取提示词。
- 子页面抓取: 需要更详细的信息?Thunderbit 的 AI 可以自动访问每个子页面(如商品页或个人资料页),并把你的表格补全,不用额外配置。
- 即时导出: 可直接将数据导出到 Excel、Google Sheets、Airtable 或 Notion,导出一直免费。
- 定时爬取: 通过自然语言设置定期任务,比如每天检查价格变化。
- 免费邮箱、电话和图片提取器: 一键从任意网站提取联系方式或图片。
- AI 自动填表: 让 AI 帮你自动填写在线表单,非常适合工作流和重复性任务。
Thunderbit 已经获得全球超过 200,000 名用户 的信赖,免费版 每月最多可抓取 6 个页面。付费方案每月仅 $15 起,就能拿到 500 credits,很适合不同规模的团队。
如果你想看看 Thunderbit 的实际效果,可以去我们的 YouTube 频道,或者浏览我们的 博客 看教程和技巧。
2. Scrapy
Scrapy 是开发者最常用的开源框架,适合想完全掌控网页爬取项目的人。它基于 Python 编写,你可以用它搭建自定义爬虫,实现大规模抓取、提取和处理数据。
开发者为什么喜欢 Scrapy?
- 功能强大: 支持复杂的多层级爬取、自定义数据管道,并可与 API 集成。
- 可扩展性强: 能处理大规模项目、并发请求,还能同时抓取大量页面(ZenRows)。
- 可扩展插件丰富: 可接入代理、User-Agent 或 JavaScript 渲染中间件(通过 Splash)。
- 社区活跃: 教程、插件和高级用例支持都很丰富。
如果你的团队熟悉 Python,而且需要大规模抓取、对接数据管道,或者搭建稳定可复用的工作流,Scrapy 会很合适。它开源且免费,但需要你自己完成环境搭建和代码维护。
3. Beautiful Soup
Beautiful Soup 是一个很受初学者欢迎的 Python 库,因为它在解析 HTML 和 XML 时既简单又强大。如果你想快速从静态网页里提取数据,Beautiful Soup 会是一个很顺手的工具。
为什么选择 Beautiful Soup?
- 适合新手: 学习门槛低,上手容易,而且教程很多(ScraperAPI)。
- 解析灵活: 能轻松处理凌乱或不完整的 HTML。
- 适合小型项目: 很适合一次性脚本、快速抓取数据,或者学习网页爬取基础。
局限性呢?Beautiful Soup 不适合大规模或动态网站,也不处理 JavaScript。如果你碰到这类场景,通常要配合 requests 或 Selenium 一起用,或者直接升级到 Scrapy。
4. Octoparse
Octoparse 是一款零代码网页爬虫工具,面向从个人创业者到企业团队的各类用户。它的点选式界面让从复杂或动态网站中提取数据变得轻松不少。
用户喜欢 Octoparse 的原因包括:
- 无需编程: 可视化工作流构建器、拖拽式选择器,以及预设模板。
- 云端与本地双模式: 可以在电脑本地运行,也可以放到云端执行,更适合更大、更快的任务。
- 支持分页与动态内容: 可抓取“加载更多”页面、无限滚动页面和 AJAX 网站。
- 导出选项丰富: 可下载为 CSV、Excel、JSON、HTML,或导出到数据库(Octoparse Pricing)。
Octoparse 的免费方案适合小任务,而付费方案大约从每月 $69 起,适合更高强度使用。它在市场研究、竞品分析,以及不想写代码也能把活干完的用户里都很受欢迎。
5. ParseHub
ParseHub 是一款可视化爬虫工具,在处理 JavaScript 很重、而且结构动态的网站时表现很不错。它的工作流构建器允许你通过点击、循环和条件判断来提取数据,就算网站结构比较复杂也能应付。
ParseHub 的亮点功能:
- 可视化选取数据: 通过点击选择元素,循环处理列表,并支持嵌套页面。
- 支持动态内容: 可抓取由 JavaScript 加载的数据,处理下拉菜单,并自动点击。
- 导出灵活: 可下载为 CSV、Excel、JSON,或集成到 Dropbox/Amazon S3(Salesforge)。
- 免费计划: 最多支持 5 个项目、每次运行 200 个页面;付费计划则提供更强能力。
ParseHub 很适合想兼顾灵活性、又不想直接写代码的中级用户,尤其在电商、招聘网站和房产数据抓取方面非常受欢迎。
6. Import.io
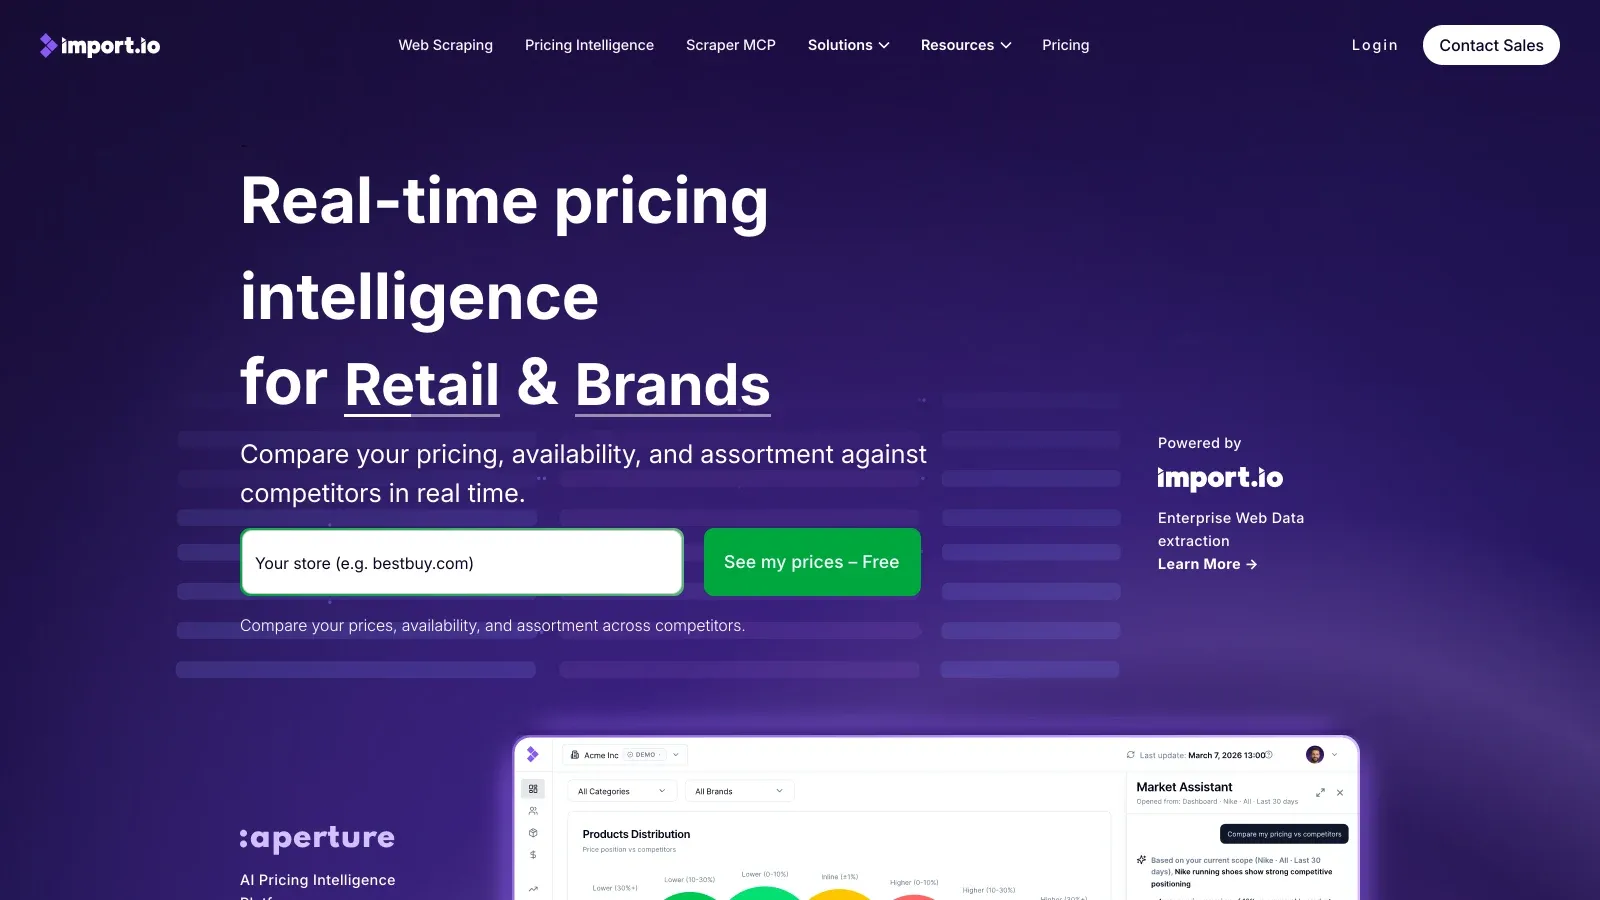
Import.io 是专门为企业级数据提取和可视化打造的。它聚焦大规模项目,提供直观的界面、强大的支持服务和高级分析能力。
Import.io 的亮点在于:
- 点选式提取: 无需编程,只要选择你想要的数据就行。
- 数据可视化: 内置工具可以帮助你分析、制图并分享结果。
- 企业级功能: 包括合规支持、托管服务和高吞吐量支持。
- 导出与集成: 可下载为 CSV、Excel,或与 Google Sheets 和 BI 工具集成(Salesforge)。
它的定价面向企业客户定制,所以更适合数据需求大、预算也比较充足的组织。
7. Apify

Apify 是一个面向大规模网页自动化和自定义数据提取的平台。对开发者来说,它很适合构建、运行和共享爬虫“Actors”(预置脚本或自定义脚本)。
Apify 成为热门选择的原因:
- Actor 市场: 可直接使用 200+ 个常见网站的现成爬虫,也可以用 JavaScript/Python 自己开发。
- API 优先: 能把抓取到的数据直接接入你的工作流或应用程序。
- 云端部署: 支持规模化运行、定时任务,并可通过仪表盘统一管理(Apify Pricing)。
- 灵活计费: 小任务有免费层,更大项目则支持按量付费。
如果你的团队有一定技术能力,希望自动化流程、提升规模,并把网页数据无缝接入业务系统,Apify 会非常合适。
8. WebHarvy
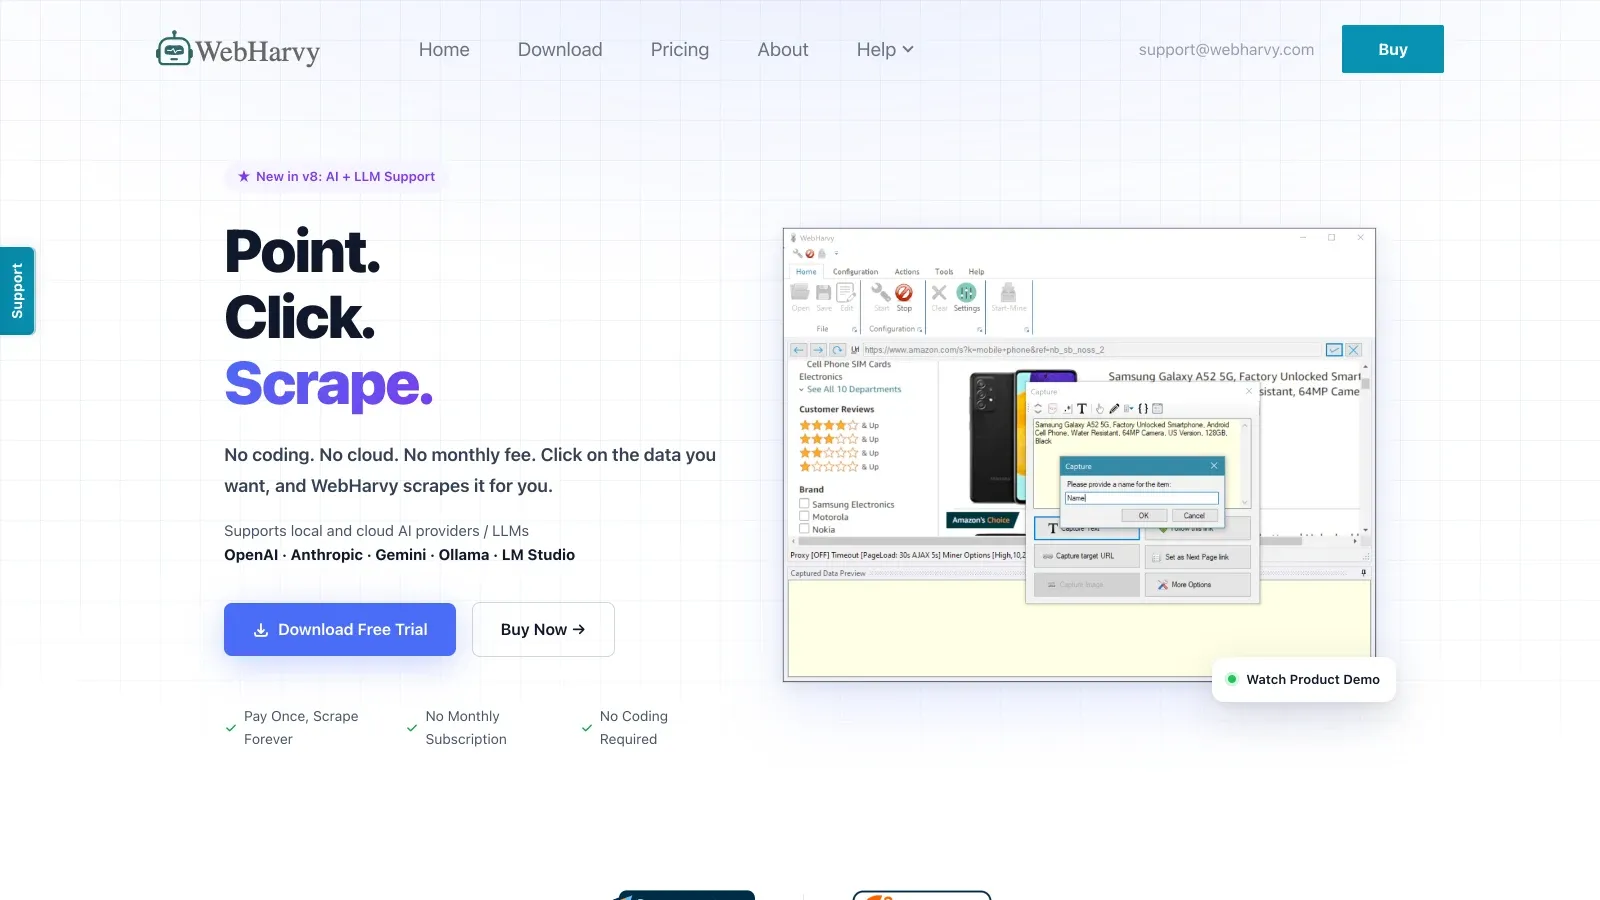
WebHarvy 是一款点选式网页爬虫工具,能够自动识别网页中的数据模式。它面向不想学习 XPath 或 CSS 选择器的非技术用户,主打“点一点就能出结果”。
WebHarvy 的核心功能:
- 自动识别模式: 点击一个数据字段后,WebHarvy 会自动帮你找到相似元素(Thunderbit Blog)。
- 支持 AJAX/JavaScript: 可处理动态内容、图片抓取以及基于关键词的提取。
- 导出方式多样: 可下载为 Excel、CSV、XML、JSON 或 SQL。
- 一次性授权: 只需支付一次费用即可长期使用(包含一年的更新与支持)。
WebHarvy 很受中小企业、研究人员和独立创业者欢迎,尤其适合想要可视化操作、但又不需要复杂自动化的用户。
9. Diffbot
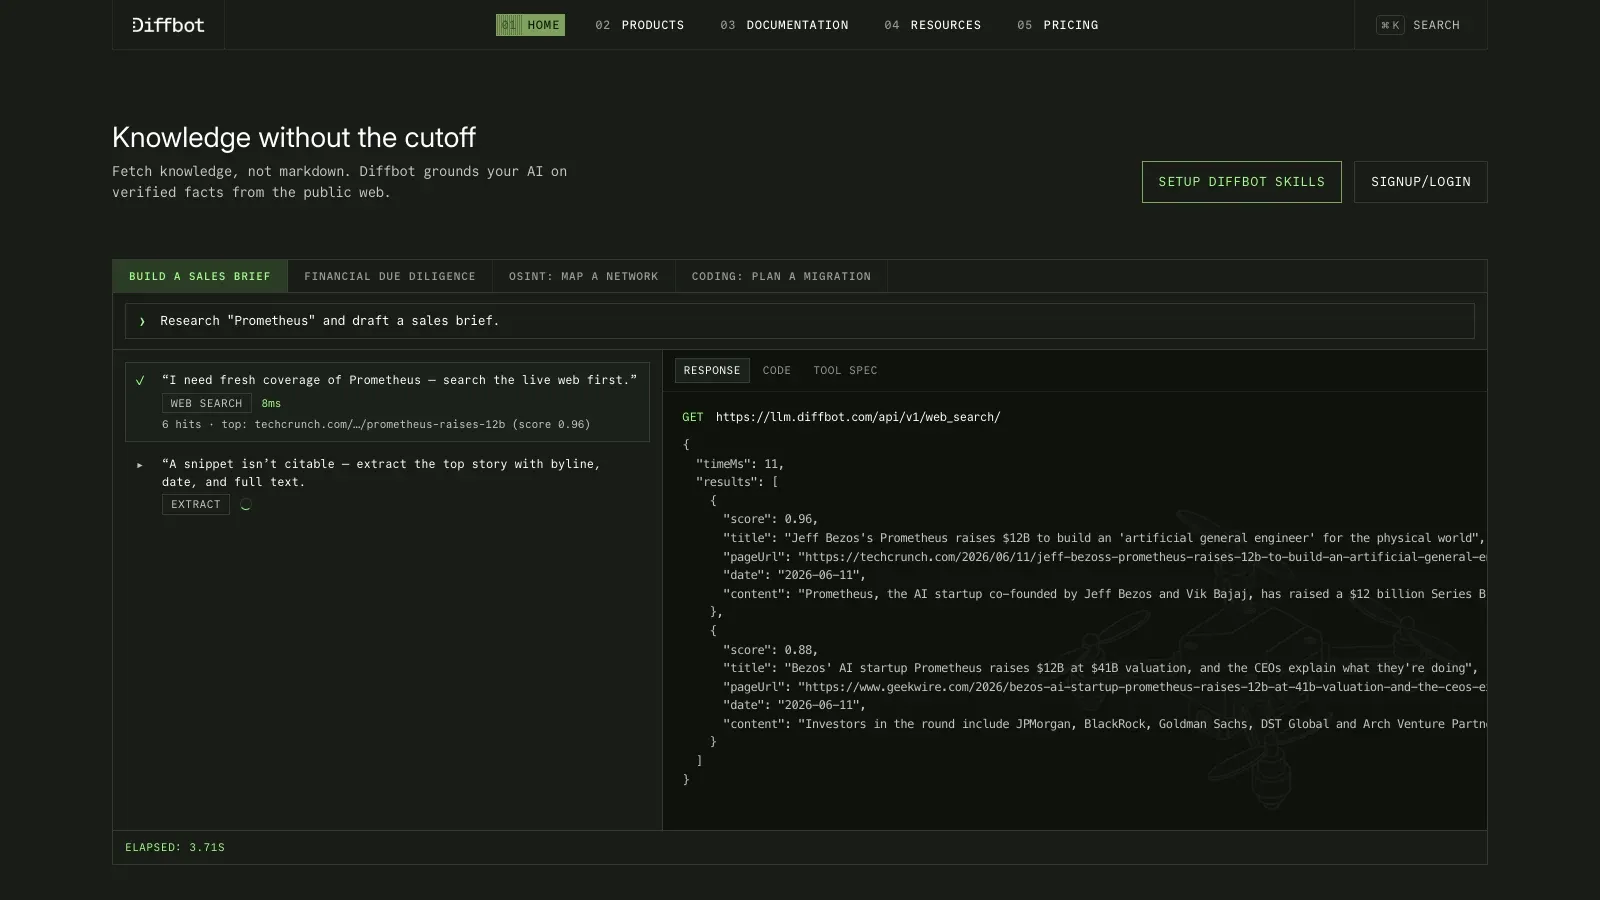
Diffbot 是网页数据提取领域的 AI 强力工具。它利用机器学习和计算机视觉,把任何公开网页转换成结构化数据——不用手动配置。
Diffbot 的独特之处:
- AI 驱动提取: 可自动识别并提取网页中的实体、关系和事实(VentureBeat)。
- 知识图谱: 提供一个庞大且持续更新的人物、公司、产品等数据库。
- API 接入: 可将结构化数据集成到你的应用、研究或分析流程中(Diffbot Docs)。
- 企业级就绪: 被 Microsoft、Adobe、Hubspot 等大型企业使用。
它的价格从每月 $299 起,初创团队也能用;API 访问还支持按调用计费(Diffbot Pricing)。如果你需要做研究、企业级数据科学,或者想在大规模场景里获得接近 AI 级别的准确性,Diffbot 会很合适。
网页爬虫工具对比表
下面是这 9 款工具的横向对比:
| 工具 | 最适合 | 零代码 | AI 驱动 | 适合 API/开发者 | 支持子页面抓取 | 导出选项 | 起售价 |
|---|---|---|---|---|---|---|---|
| Thunderbit | 商务用户 | 是 | 是 | 否 | 是 | Excel、CSV、Sheets、Notion、Airtable | 免费(6 页),$15/月 |
| Scrapy | 开发者 | 否 | 否 | 是 | 是(自定义) | CSV、JSON、XML、数据库 | 免费,开源 |
| Beautiful Soup | 初学者、开发者 | 否 | 否 | 是 | 否 | 自定义(通过 Python) | 免费,开源 |
| Octoparse | 非技术用户、团队 | 是 | 否 | 部分支持 | 是 | CSV、Excel、JSON、数据库 | 免费,$69/月 |
| ParseHub | 可视化操作、动态网站 | 是 | 否 | 部分支持 | 是 | CSV、Excel、JSON、S3、Dropbox | 免费,$189/月 |
| Import.io | 企业、分析场景 | 是 | 否 | 是 | 是 | CSV、Excel、Sheets、BI 工具 | 定制报价,企业版 |
| Apify | 开发者、自动化 | 否 | 否 | 是 | 是 | CSV、JSON、Sheets、API | 免费,按量付费 |
| WebHarvy | 非技术用户、中小企业 | 是 | 否 | 否 | 是 | Excel、CSV、XML、JSON、SQL | $129(一次性) |
| Diffbot | AI、研究、企业 | 否 | 是 | 是 | 是(AI 爬取) | JSON、Knowledge Graph API | $299/月 |
如何根据需求选择合适的网页爬虫工具
2025 年最佳网页爬虫工具与软件 Get Started Free
那到底该选哪一款?这里给你一份快速参考:
- 适合非技术用户/商务用户: Thunderbit、Octoparse、ParseHub、WebHarvy
- 适合开发者/自动化场景: Scrapy、Beautiful Soup、Apify
- 适合企业/AI 需求: Import.io、Diffbot
- 适合动态或 JavaScript 很重的网站: ParseHub、Octoparse、Apify
- 适合快速、结构化导出: Thunderbit、Import.io
我的建议是:先从你的业务目标和技术熟悉度出发。如果你想要 AI 驱动、无需折腾,还能直接导出结果, Thunderbit 几乎很难被超越;如果你需要完全控制权,或者想自己搭爬虫,Scrapy 和 Apify 都很强;如果你要的是企业级规模或者 AI 驱动的数据提取,Import.io 和 Diffbot 就是硬实力选手。
大多数工具都提供免费试用或免费层,不妨多试几个,看看哪一个最适合你的工作流。
常见问题
1. 什么是网页爬虫工具?为什么我需要它?
网页爬虫工具是一类能从网站中提取数据,并把它转换成电子表格或数据库等结构化格式的软件。企业会把它用于线索开发、价格监控、市场研究等任务——比起手动复制粘贴,它更省时,也更准确。
2. 网页爬取合法吗?
只要你抓取的是公开可访问的数据,并遵守网站的服务条款,网页爬取通常是合法的。务必避免在未经同意的情况下抓取个人信息或敏感信息,同时也要查看当地法规。
3. 哪款网页爬虫工具最适合非技术用户?
Thunderbit、Octoparse、ParseHub 和 WebHarvy 都很适合非技术用户。其中 Thunderbit 尤其突出,因为它支持 AI 智能字段推荐,并可直接导出到 Excel、Google Sheets、Notion 或 Airtable。
4. 我能抓取动态网站或 JavaScript 很重的网站吗?
可以。像 ParseHub、Octoparse 和 Apify 这类工具就是为动态内容、AJAX 和“加载更多”页面设计的。Thunderbit 的 AI 也能很好地适配许多现代网站布局。
5. 我该如何为我的企业选择合适的网页爬虫工具?
请综合考虑你的技术水平、数据量、导出需求和预算。非技术用户可以从 Thunderbit 或 Octoparse 入手;开发者可能更偏好 Scrapy 或 Apify;而有大数据需求的企业则可以考虑 Import.io 或 Diffbot。多数工具都提供免费试用,建议先试几款,再看看哪一款最适合你的流程。
准备好把网页变成你的下一项业务优势了吗?下载 Thunderbit 或浏览我们的 Thunderbit 博客 获取更多指南和技巧。祝你爬取顺利!
试用 AI 网页爬虫 Get Started Free
了解更多



