
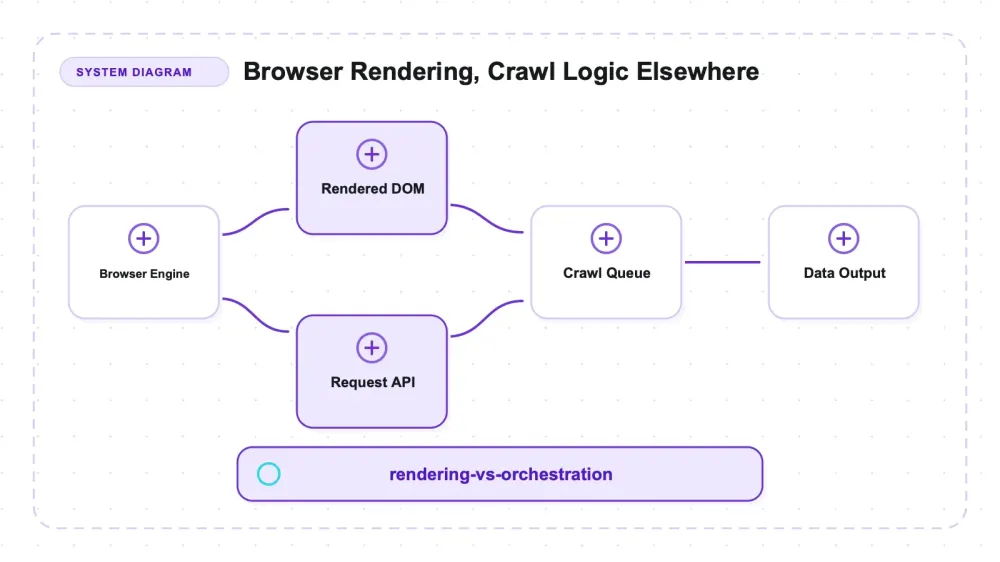
Playwright là framework tự động hóa trình duyệt của Microsoft: một thư viện Apache-2.0, ưu tiên TypeScript, có thể khởi chạy trình duyệt thật, điều khiển nó qua một API duy nhất và trả về trang sau khi JavaScript đã chạy xong. Sản phẩm này được quảng bá như một framework kiểm thử end-to-end, nhưng phần động cơ bên dưới lại là thứ rất nhiều người âm thầm chọn dùng khi một yêu cầu HTTP chỉ trả về một “vỏ rỗng” thay vì dữ liệu. Về bản chất, nó cạnh tranh với Puppeteer và Selenium — tức là điều khiển trình duyệt thật, chứ không phải phân tích HTTP response.
Tôi đã chạy microsoft/playwright 1.56.0 qua một bộ test scraping cố định — gồm danh mục tĩnh có phân trang, một bài viết, danh mục render bằng JavaScript, một JSON API, lỗi 500, một đồ thị crawl nhỏ, cùng hai trang thực hành công khai — trên Node v22.22.3, macOS arm64, chỉ dùng Chromium. Phần render cho kết quả rất ổn. Nhưng phần crawling thì gần như không có sẵn, và chính khoảng trống đó là điều đáng hiểu nhất về công cụ này trước khi bạn quyết định dùng.
Điểm nổi bật
Có hai kết quả nằm ở nhóm đầu, và chúng chỉ ra hai hướng khá khác nhau.
Kết quả thứ nhất là kết quả trình duyệt đúng như kỳ vọng, được giới hạn bởi các điều kiện chờ tôi đặt ra. Sau khi page.goto(..., { waitUntil: 'domcontentloaded' }), bài test fixture động tiếp tục đợi #dynamic-products article.product-card, còn bài test công khai Quotes to Scrape đợi .quote. Khi các selector đặc thù của ứng dụng này xuất hiện, các lượt chạy lần lượt trả về 8/8 mục fixture và 10 câu trích dẫn từ site công khai; với fixture, độ recall đạt 1.0 so với dữ liệu chuẩn gồm 8 mục. Không cần vòng polling tùy biến nào, nhưng Playwright cũng không tự giải quyết vấn đề “đã sẵn sàng chưa” — chính bài test đã cung cấp điều kiện hoàn tất. Ảnh chụp toàn trang cũng được lưu thành công ngay lần gọi đầu tiên.
Kết quả thứ hai dùng browserContext.request: cụ thể là ctx.request.get(...) sau khi Chromium đã khởi chạy và browser context đã tồn tại. Lệnh này gọi thẳng endpoint JSON của fixture và trả về 8/8 sản phẩm mà không cần tạo hay render trang. Cách này bỏ qua phần làm việc với DOM, nhưng không loại bỏ chi phí tiến trình trình duyệt trong cấu hình thử nghiệm này. Request client gắn với context có thể chia sẻ trạng thái cookie với các trang trong trình duyệt; còn playwright.request.newContext() độc lập thì không cần browser context nhưng cũng không tự động chia sẻ session đó. Bài test ở đây chỉ kiểm tra đường đi thứ nhất.
Playwright cũng không cung cấp hàng đợi crawl, bộ ghi dataset hay cơ chế tự điều tiết tốc độ. Bài test đồ thị crawl của tôi — đi theo các liên kết nội bộ, theo dõi độ sâu và tránh quay lại trang cũ — đã chạm tới 12 trang ở các độ sâu {0:1, 1:4, 2:7}, nhưng toàn bộ duyệt theo breadth-first search là code tôi tự viết. Playwright mở và đọc trang; còn frontier persistence, chính sách URL, retry và scheduling là việc của lớp khác.
Playwright thực chất là gì
Công cụ này — microsoft/playwright trên GitHub — được viết bằng TypeScript, cấp phép Apache-2.0 và do Microsoft duy trì. Bản được kiểm tra ở đây là 1.56.0 vào ngày 9 tháng 7 năm 2026. Các kết quả bên dưới phản ánh đúng bản đó, chứ không phải là cam kết tương thích với các phiên bản mới hơn.
Định vị chính thức của nó rất rõ: một framework cho web testing và automation, điều khiển Chromium, Firefox và WebKit qua một API duy nhất. Đường đi chính của Playwright là test runner với fixture, assertion và trace viewer. Nếu dùng nó như một primitive để scraping, bạn sẽ đi theo chế độ Library mode được tài liệu hóa: chromium.launch(), rồi context, rồi page, tách khỏi test harness. Toàn bộ bài đánh giá này dùng đúng bề mặt API công khai đó. Tôi không chạy kiểm tra tương thích qua nhiều phiên bản, nên đây không phải khẳng định rằng mọi hành vi đã thử đều ổn định giữa các bản phát hành.
Phạm vi đa trình duyệt là điểm nhấn ở hầu hết tài liệu, nên tôi nói rõ một cách cẩn thận. Playwright điều khiển ba engine trình duyệt — Chromium, Firefox và WebKit — qua một API, và có client chính thức cho Python, Java và .NET bên cạnh JavaScript. Điều đó đã được tài liệu hóa, và thực sự là ưu thế lớn nhất của công cụ này về mặt thiết kế. Nhưng lượt thử này chỉ kiểm chứng phạm vi hẹp hơn:
| Khả năng | Trạng thái trong bài đánh giá này |
|---|---|
| Chromium engine | Đã kiểm tra — mọi test ở đây đều chạy trên Chromium |
| Firefox engine | Có tài liệu, chưa xác minh ở đây |
| WebKit engine | Có tài liệu, chưa xác minh ở đây |
| Một API cho cả ba engine | Có tài liệu, chưa xác minh ở đây |
| Client Python, Java và .NET | Có tài liệu, chưa xác minh ở đây |
| Proxy | Chưa thử |
| Quy mô nhiều context song song | Chưa thử |
| Network interception cho scraping ưu tiên API | Chưa thử |
Nếu một website hiển thị khác trên WebKit của Safari, hoặc đội của bạn dùng Python, thì phạm vi đó chính là lý do để chọn Playwright — chỉ đừng xem kết quả của tôi như bằng chứng cho sự tương đồng giữa Firefox và WebKit, vì tôi chưa kiểm tra chúng.
Cách nó hoạt động bên trong
Mô hình tư duy ở đây là một engine trình duyệt được bạn điều khiển bằng code. chromium.launch() sẽ khởi chạy một process trình duyệt. context là một phiên tách biệt với cookie, storage và cache riêng; page là một tab bên trong context đó. Bạn gọi page.goto(url), đợi điều kiện thể hiện ứng dụng đã sẵn sàng, rồi đọc DOM kết quả bằng các helper như page.$$eval. Điều này gần với việc dùng trình duyệt như người dùng thật hơn là phân tích một HTTP response, nhưng nó không đồng nghĩa với việc môi trường hoàn toàn tương đương: headless signals, viewport, locale, font, profile state, đường đi TLS/network và các cơ chế phòng vệ của site vẫn có thể làm nội dung được trả về thay đổi. Bài đánh giá này không kiểm tra anti-bot hay mức độ tương đương với trình duyệt sản xuất.
page.screenshot() chụp lại trang đã render, toàn trang hoặc một phần, và trong lượt chạy của tôi nó hoạt động ngay từ lần gọi đầu tiên. Còn API request mà tôi nhắc tới — context.request.get — dùng cookie của context đó nhưng bỏ qua phần render, nên bạn có thể kết hợp “tải trang và đọc DOM” với “chỉ gọi endpoint JSON” trong cùng một script mà không cần đổi công cụ.
Điều không có sẵn ở bên dưới là cơ chế crawling. Không có scheduler cho request, không có visited-set được lưu bền vững, không có chính sách lịch sự với website, và cũng không có pipeline export. Một lượt duyệt có giới hạn thì dễ phác thảo, nhưng để frontier hoạt động đáng tin cậy còn cần chuẩn hóa URL, xử lý redirect, retry, phạm vi hợp lệ, giới hạn tốc độ và cơ chế phục hồi. Bạn либо tự xây lớp đó, либо dùng một framework bao bọc engine trình duyệt.
Thực tế cài đặt và thiết lập
Việc cài đặt gồm hai bước, và bước thứ hai mới là phần nặng nhất khi triển khai. npm install playwright chỉ lấy thư viện; còn npx playwright install sẽ tải các bản browser build xuống (trong trường hợp của tôi là Chromium). Hãy tính đến dung lượng đĩa, thời gian tải, việc cache trình duyệt trong CI, và dọn dẹp process, thay vì coi gói npm là toàn bộ hệ thống có thể chạy được.
Nếu bạn cài Playwright với kỳ vọng đó là một scraper rồi đi theo tutorial kiểm thử, bạn sẽ bắt đầu bằng file test và các assertion expect(). Còn code scraping thì dùng trực tiếp API của thư viện. Cả hai đều có tài liệu, nhưng sự khác biệt này rất quan trọng khi tìm ví dụ và quyết định lệnh triển khai.
Trong lần chạy này, các trải nghiệm hữu ích đều khá cụ thể: browser contexts tách biệt state phiên, các lời gọi async ghép nối gọn gàng, chụp ảnh màn hình chỉ mất một lệnh, và lỗi HTTP 500 vẫn có thể xem qua response object. Điểm khó chịu nằm ở khâu vận hành hơn là cú pháp: browser build phải được cài riêng và vòng đời của nó phải được quản lý tách khỏi thư viện.
Kết quả thực chiến
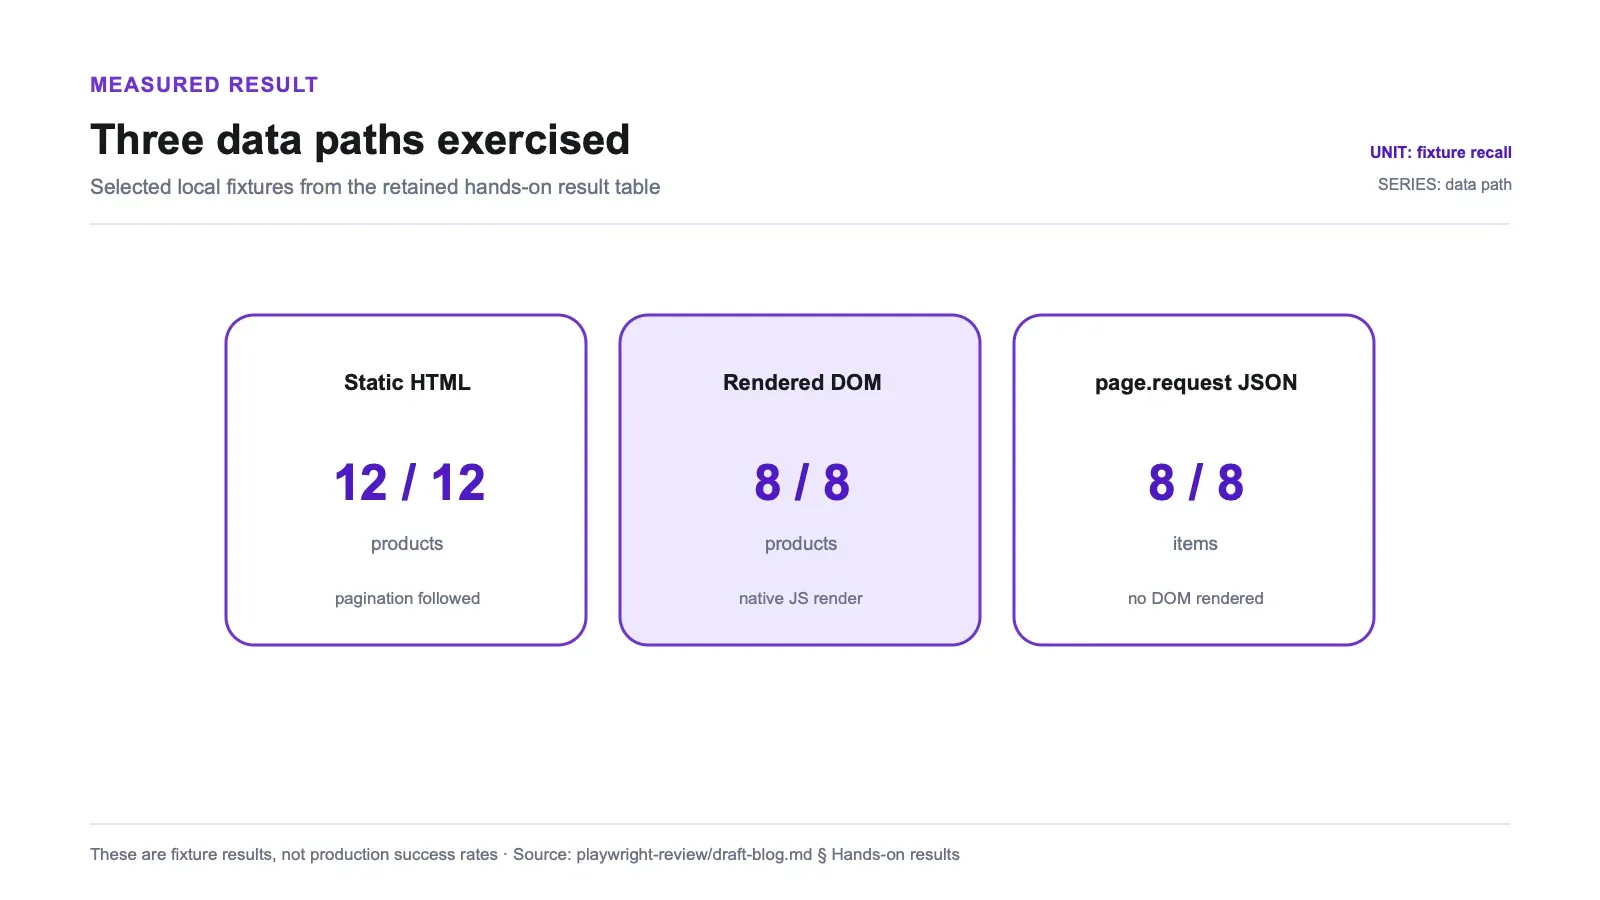
Mọi con số cục bộ đều được chạy trên một fixture server ở 127.0.0.1, với dữ liệu chuẩn được ghi lại trước khi crawl. Bộ harness chi tiết nằm trong run_playwright_material_tests.mjs, còn phần raw artifacts đã commit bao gồm dữ liệu chuẩn và output của từng test. Đây vẫn là các quan sát do tác giả tự chạy trên một máy và một lượt; các đường link chỉ giúp tái hiện chứ không biến chúng thành một benchmark rộng hơn.
| Test | Mục tiêu | Kết quả |
|---|---|---|
| Danh mục tĩnh + phân trang | fixture cục bộ | 12/12 sản phẩm, recall 1.0 |
| Trích xuất bài viết | fixture cục bộ | tiêu đề + 3/3 đoạn văn, phần boilerplate được tách riêng |
| Trang JS động (render gốc) | fixture cục bộ | 8/8, recall 1.0, đã lưu full-page screenshot |
JSON API động (page.request) | fixture cục bộ | 8/8, recall 1.0, không render DOM |
| Xử lý HTTP 500 | fixture cục bộ | status 500 xem được, điều hướng không ném lỗi |
| Crawl graph (BFS tự viết) | fixture cục bộ | 12 trang, độ sâu {0:1, 1:4, 2:7} |
| Books to Scrape | demo công khai | 20 sản phẩm |
| Quotes JS (render bằng JS) | demo công khai | 10 câu trích dẫn, render gốc |
Vòng lặp phân trang đi theo liên kết tiếp theo một cách rõ ràng; Playwright không tự phát hiện trang mới. Selector của bài viết giữ phần navigation và footer text tách khỏi body result. Ở nhánh lỗi, điều hướng trả về một response object với status 500 thay vì ném ngoại lệ, để người gọi tự quyết định nên log, retry hay tiếp tục. Hai mục thực hành công khai trả về số lượng đúng như trong bảng.
Một ranh giới cần nói thẳng: tất cả ở đây đều chạy trên Chromium, trên một máy, một lần duy nhất. Bảng năng lực tách riêng phạm vi được tài liệu hóa với hành vi đã kiểm tra. Tôi không chạy lại bộ test trên một bản Playwright khác, nên không thể rút ra kết luận liên phiên bản. Thời gian của từng test cũng không được dùng làm benchmark; một lần bấm giờ trên một laptop không đủ để so sánh tốc độ.
Điều kiện sẵn sàng là một phần của hợp đồng trích xuất
Kết quả động phụ thuộc vào các điều kiện chờ phản ánh đúng dữ liệu tôi cần, chứ không chỉ là việc điều hướng trình duyệt. Với danh mục cục bộ, harness điều hướng bằng waitUntil: 'domcontentloaded' rồi gọi waitForSelector('#dynamic-products article.product-card') với timeout 15 giây. Lượt chạy Quotes JS công khai dùng cùng trạng thái điều hướng và đợi .quote với timeout 20 giây. Chỉ sau khi các selector đó xuất hiện thì việc trích xuất mới diễn ra.
Sự khác biệt đó rất quan trọng khi chỉnh sửa script. domcontentloaded chỉ nói rằng tài liệu ban đầu đã được parse; nó không nói rằng một response API trễ đã tới, hydration đã xong, danh sách vô hạn đã ngừng mở rộng, hay một hàng ảo hóa đã xuất hiện trong viewport. Một selector rất hữu ích khi chỉ cần thấy một phần tử khớp là đủ. Nhưng nếu độ đầy đủ phụ thuộc vào một response đã biết, số lượng item, trạng thái ứng dụng hoặc một khoảng mạng im lặng, thì hãy đợi chính điều kiện đó. Điều kiện nên gắn với hợp đồng đầu ra: “ít nhất phải có một card” và “mọi trang dự kiến đã tải xong” là hai xác nhận rất khác nhau.
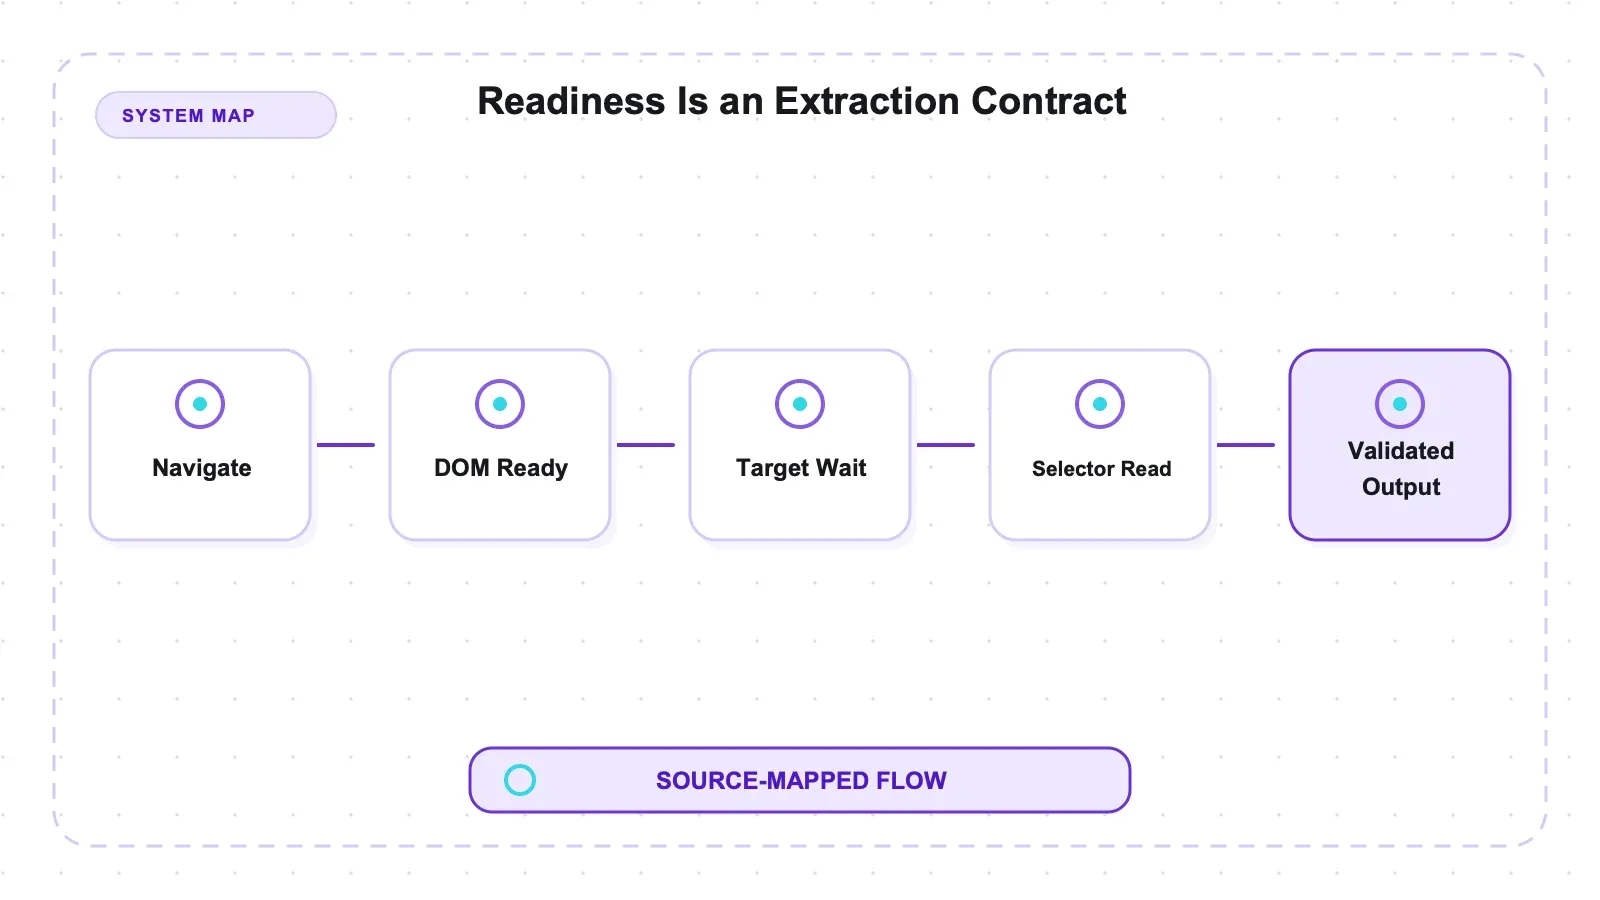
Timeout cũng là trách nhiệm của bên gọi. Bài test dùng selector timeout hữu hạn, nhưng không nghiên cứu chính sách retry hay phân biệt một trang chậm với một selector đã đổi vĩnh viễn. Một wrapper production nên ghi lại điều kiện sẵn sàng nào thất bại, chụp đủ trạng thái trang để chẩn đoán, và quyết định liệu có an toàn để thử điều hướng lại hay không. Playwright cung cấp event và DOM; nó không thể tự hiểu thế nào là “dữ liệu hoàn chỉnh” cho công việc của bạn.
Ranh giới đó nên được ghi rõ bên cạnh mỗi extractor, chứ không nên để ẩn trong một timeout mặc định.
Đường đi API cũng có một hợp đồng song song. ctx.request.get phù hợp vì browser context đã tồn tại và việc chia sẻ session có thể hữu ích. Nếu một job phát hiện endpoint dữ liệu của nó hoạt động mà không cần browser session nào, thì request context độc lập là một kiến trúc khác, với vòng đời và hành vi cookie khác. Lượt chạy này không so sánh hai cách đó. Hãy coi “không render DOM” là факт được đo, rồi mới quyết định riêng xem workflow rộng hơn có cần process trình duyệt hay không.
Câu hỏi về crawling
Kết quả crawl-graph là thứ quyết định cách bạn nên nghĩ về Playwright. Mười hai trang, ba độ sâu, đúng — và toàn bộ logic đi trang đều là của tôi. Playwright cung cấp nửa việc “mở URL này và đọc nó”; tôi cung cấp hàng đợi, visited-set và theo dõi độ sâu.
Với job nhỏ, giới hạn rõ ràng, điều đó không thành vấn đề. Nhưng với công việc quy mô crawl thì nó có nghĩa là bạn либо tự viết crawler trên nền một browser library, либо ghép Playwright với thứ đã làm sẵn phần đó. Mẫu được tài liệu hóa là Crawlee, công cụ bọc Playwright (và Puppeteer) bằng một request queue thật, lưu dataset và tự điều tiết tốc độ — bạn giữ phần render của Playwright và mượn phần điều phối. Nếu bạn muốn queue được tích hợp sẵn trong framework thay vì gắn thêm, thì đó chính là triết lý của Scrapy, dù Scrapy thiên về HTTP và không tự render JavaScript. Ý ở đây không phải là Playwright kém; mà là “tự động hóa trình duyệt” và “crawling” là hai việc khác nhau, và Playwright chỉ nhận làm một trong hai.
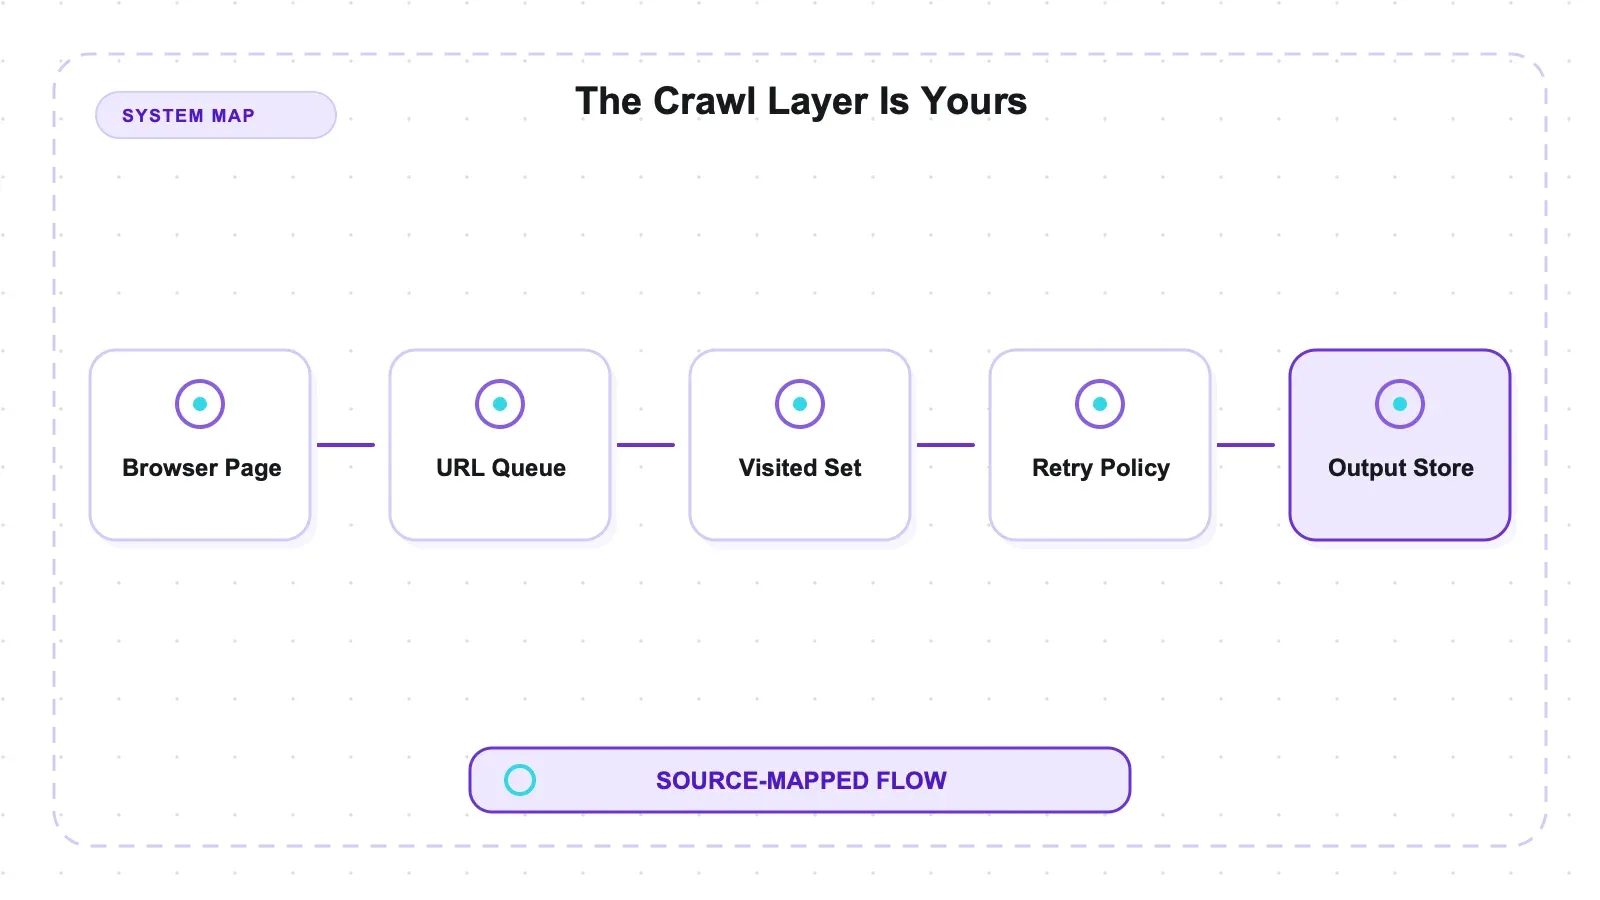
Lượt BFS 12 trang làm ranh giới trách nhiệm trở nên rất cụ thể. Nó cung cấp queue, visited set và theo dõi độ sâu cho một đồ thị có kiểm soát. Frontier production vẫn phải định nghĩa canonicalization URL, xử lý redirect, host được phép, khóa trùng, retry, concurrency, độ trễ theo host, persistence và semantics khi khởi động lại. Xuất dữ liệu cũng là một lựa chọn khác: fixture ghi JSON và CSV vì harness làm vậy, chứ không phải vì Playwright có abstraction dataset.
Thiết kế session cũng ảnh hưởng tới wrapper. Một browser có thể chứa nhiều context với cookie và storage tách biệt, nhưng bài đánh giá này không đo quy mô song song giữa các context hay khả năng cô lập lỗi. Tái sử dụng một context có thể giữ đăng nhập và giảm công thiết lập; tạo context riêng có thể ngăn state rò rỉ giữa các job. Đó là các chính sách ở cấp crawler, dù Playwright có cung cấp primitive context. Hãy benchmark vòng đời bạn chọn với đúng browser build và môi trường triển khai thực tế mà bạn sẽ chạy.
Ưu và nhược điểm
Ưu điểm:
- JavaScript chạy qua Chromium thật; cả hai mục tiêu động đều chạm đúng selector được dùng làm điều kiện sẵn sàng.
- Ảnh chụp full-page được lưu ngay ở lần gọi đầu tiên.
- Selector trích xuất đúng các trường của danh mục tĩnh và bài viết từ fixture kiểm soát.
browserContext.requesttruy cập endpoint JSON mà không cần render trang, trong khi process trình duyệt đã khởi chạy vẫn nằm trong harness.- Ổn định khi gặp response lỗi: HTTP 500 vẫn xem được và navigation không ném lỗi.
- Có tài liệu hỗ trợ ba engine (Chromium, Firefox, WebKit) qua một API duy nhất, cộng với client Python, Java và .NET (được tài liệu hóa; ở đây chỉ kiểm tra Chromium).
- Apache-2.0 và được Microsoft duy trì.
- Trải nghiệm developer rất gọn khi bạn làm việc ở library mode: một API cho nhiều engine, async tốt, screenshot rất đơn giản.
Nhược điểm:
- Không có sẵn queue crawl, dataset hay auto-throttle — công việc ở quy mô crawl là code của bạn hoặc một wrapper như Crawlee.
- Tốn tài nguyên trình duyệt: tải binary và chi phí mỗi trang mới là cái giá thật so với tool chỉ dùng HTTP.
- Khung mặc định vẫn là test runner; muốn scraping thì phải biết rằng library mode tồn tại và rời khỏi đường dẫn được quảng bá.
- Chỉ Playwright 1.56.0 và Chromium được thử; chưa kiểm tra tương thích qua phiên bản hay qua engine.
- Không có output JSON theo schema sẵn có; bạn phải tự viết selector và định hình dữ liệu.
Ai nên dùng, và ai nên bỏ qua
Nếu vấn đề của bạn là render các trang mà dữ liệu chỉ xuất hiện sau khi JavaScript chạy, hoặc cần lấy screenshot cùng lúc với dữ liệu DOM, Playwright là một ứng viên hợp lý để tái hiện trên target của bạn. Các đội đã dùng Playwright cho test có thể tái sử dụng cùng tư duy và kỹ năng selector trong library mode. Client Python, Java và .NET là các lựa chọn đã được tài liệu hóa, nhưng bài đánh giá này chỉ chạy Node và Chromium.
Hãy cân nhắc một lớp khác trong ba trường hợp. Nếu dữ liệu cần lấy đã có sẵn trong HTTP response, một công cụ ưu tiên HTTP sẽ tránh được chi phí khởi động và render trình duyệt; Colly là một crawler library thuộc nhóm đó, còn Trafilatura nhắm tới trích xuất bài viết. Nếu bạn cần queue, persistence và throttling, hãy dùng crawler framework hoặc wrapper cho Playwright. Nếu bạn cần đầu ra dạng schema mà không muốn tự giữ selector, hãy so sánh các dịch vụ trích xuất được quản lý. Không lựa chọn thay thế nào trong số đó được benchmark trong bài đánh giá này.
Nếu bạn đang phân vân riêng giữa Playwright và Puppeteer, thì đó là một cuộc đối đầu khác; bài so sánh trực tiếp của chúng tôi chạy cả hai trên cùng bộ fixture và chỉ ra nơi lựa chọn thực sự khác nhau.
Các lựa chọn thay thế và vai trò của dịch vụ trích xuất được quản lý
Playwright miễn phí, Apache-2.0 và tự host. Bạn tự chịu trách nhiệm triển khai browser, selector, điều kiện sẵn sàng, code crawl, cập nhật và xử lý lỗi. Bài đánh giá này không đo hiệu quả chống bot hay so sánh tổng chi phí vận hành với một dịch vụ được quản lý.
Trong thế giới open source, so sánh hữu ích nhất là theo từng nhiệm vụ. Với công việc crawl quy mô lớn trên nền trình duyệt, Crawlee bổ sung phần queue và dataset mà Playwright không có. Nếu mục tiêu đầu ra của bạn là Markdown sẵn cho LLM từ một trình duyệt thật thay vì các dòng dữ liệu tự định dạng, Crawl4AI sẽ chạy browser và tạo Markdown cho pipeline đó. Còn nếu bạn đang cân nhắc nhiều công cụ cùng lúc, bài tổng hợp open-source scraper của chúng tôi sẽ đặt các nhóm này cạnh nhau.
Công bố: Thunderbit là sản phẩm của đơn vị xuất bản và không được chạy qua fixture Playwright này. Nó đại diện cho nhóm trích xuất được quản lý: dịch vụ vận hành phần render và trả về text của trang hoặc bản ghi theo schema, còn Playwright để lại việc vận hành trình duyệt và logic selector cho nhà phát triển. Vì vậy, đây là so sánh về mô hình hosting, hình dạng đầu ra và mô hình chi phí — không phải một kết quả hiệu năng từ bài đánh giá này.
Thử Thunderbit để trích xuất dữ liệu web
Kết luận
Hãy dùng Playwright khi target của bạn cần một browser engine và bạn sẵn sàng tự quản lý điều kiện sẵn sàng, selector và orchestration cho crawl. Bảng kết quả cho thấy library mode trên Chromium đã xử lý tốt các fixture tĩnh, động, API, screenshot và lỗi trong lượt kiểm tra do tác giả tự chạy này.
Hãy giữ nguyên ranh giới bằng chứng: chỉ Chromium và Node được kiểm tra, lượt đi 12 trang phụ thuộc vào BFS tự viết, browserContext.request bỏ qua render trang nhưng không bỏ qua process trình duyệt đang chạy, và mọi trích xuất động đều dùng một selector sẵn sàng đã nêu rõ. Những giới hạn đó khiến Playwright trong bài đánh giá này chỉ là một primitive trình duyệt, chứ chưa phải một hệ thống crawling end-to-end được đo lường hoàn chỉnh.
Thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Khi scraping bằng Playwright, tôi có còn cần chờ không?
Có. Việc trình duyệt chạy xong không tự nói cho script biết khi nào dữ liệu của ứng dụng đã sẵn sàng. Các test này điều hướng tới domcontentloaded rồi mới đợi một selector đặc thù của target trước khi trích xuất. Trang production có thể cần tín hiệu khác, như một response, trạng thái locator hoặc một event của ứng dụng.
Playwright có thể tự crawl toàn bộ website không? Không có sẵn. Nó không có request queue, dataset writer hay auto-throttle — bài test crawl-graph của tôi chỉ chạm 12 trang ở các độ sâu {0:1, 1:4, 2:7} vì tôi tự viết breadth-first search bằng tay. Với công việc quy mô crawl, hãy ghép Playwright với Crawlee, công cụ bọc nó bằng một lớp crawl thực thụ, hoặc dùng hẳn một crawler framework khác.
Khi nào nên dùng browserContext.request thay vì request context độc lập?
Dùng browserContext.request khi các HTTP call cần chia sẻ cookie với các trang trong một browser context đang có sẵn. Dùng playwright.request.newContext() khi bạn muốn một context chỉ dành cho API, không khởi chạy browser và không cần chia sẻ cookie tự động với browser pages. Ở đây chỉ kiểm tra đường đi đầu tiên.
Firefox và WebKit có được kiểm tra ở đây không? Không. Mọi test đều chạy trên Chromium, trên một máy, một lần duy nhất. Hỗ trợ ba engine của Playwright (Chromium, Firefox, WebKit) và các client Python, Java, .NET là những khả năng đã được tài liệu hóa mà tôi đang thuật lại đúng như tài liệu, chứ chưa xác minh — độ tương đương của Firefox và WebKit, proxy, quy mô song song và network interception đều nằm ngoài phạm vi của các con số này.
Bài đánh giá này bao phủ môi trường nào? Playwright 1.56.0, Node v22.22.3, macOS arm64, và chỉ Chromium. Firefox, WebKit, proxy, quy mô song song, hành vi anti-bot và các phiên bản Playwright mới hơn đều không nằm trong lượt chạy. Việc cài đặt cần cả thư viện lẫn một lần tải browser build riêng.




