
Hầu hết các bài tổng hợp kiểu “scraper mã nguồn mở tốt nhất” đều dính chung một lỗi rất tinh vi: chẳng ai chạy các công cụ đó trên cùng một bộ trang. Scrapy bị đem test trên một bài tin tức, Playwright thì trên một demo thương mại điện tử nào đó, Colly lại trên thứ mà tác giả đang có sẵn — rồi sau đó chúng được xếp hạng đối đầu trực tiếp, như thể những con số đó có cùng ý nghĩa. Kiểu xếp hạng này chỉ nói lên đặc tính của website, chứ không nói lên sức mạnh thật của công cụ.
Vì vậy tôi làm một việc đơn giản nhưng thường bị các danh sách bỏ qua. Tôi tạo ra một bộ fixture duy nhất rồi đưa cả chín công cụ chạy qua nó: một danh mục tĩnh, một danh mục render bằng JavaScript, một bài viết bị nhúng giữa rác điều hướng và footer, một lỗi HTTP 500 có chủ đích, một đồ thị crawl liên kết nội bộ nhỏ, cộng thêm hai website thực hành công khai. Cùng một “đáp án chuẩn”, cùng một cách đo, và mọi lượt chạy đều như nhau. Mã script và dữ liệu thô đều nằm trong một repo benchmark công khai để bạn có thể tự chạy lại bất kỳ phần nào. Kết quả trả về không phải một bảng xếp hạng gọn gàng như các bài roundup thường hứa — không có một người thắng duy nhất. Có ba kiểu nhiệm vụ khác nhau, và chín công cụ này gần như tự chia vào đúng nhóm của mình.
Dùng thử Thunderbit để trích xuất dữ liệu web
Cách benchmark hoạt động, và một giới hạn duy nhất tôi muốn nói rõ
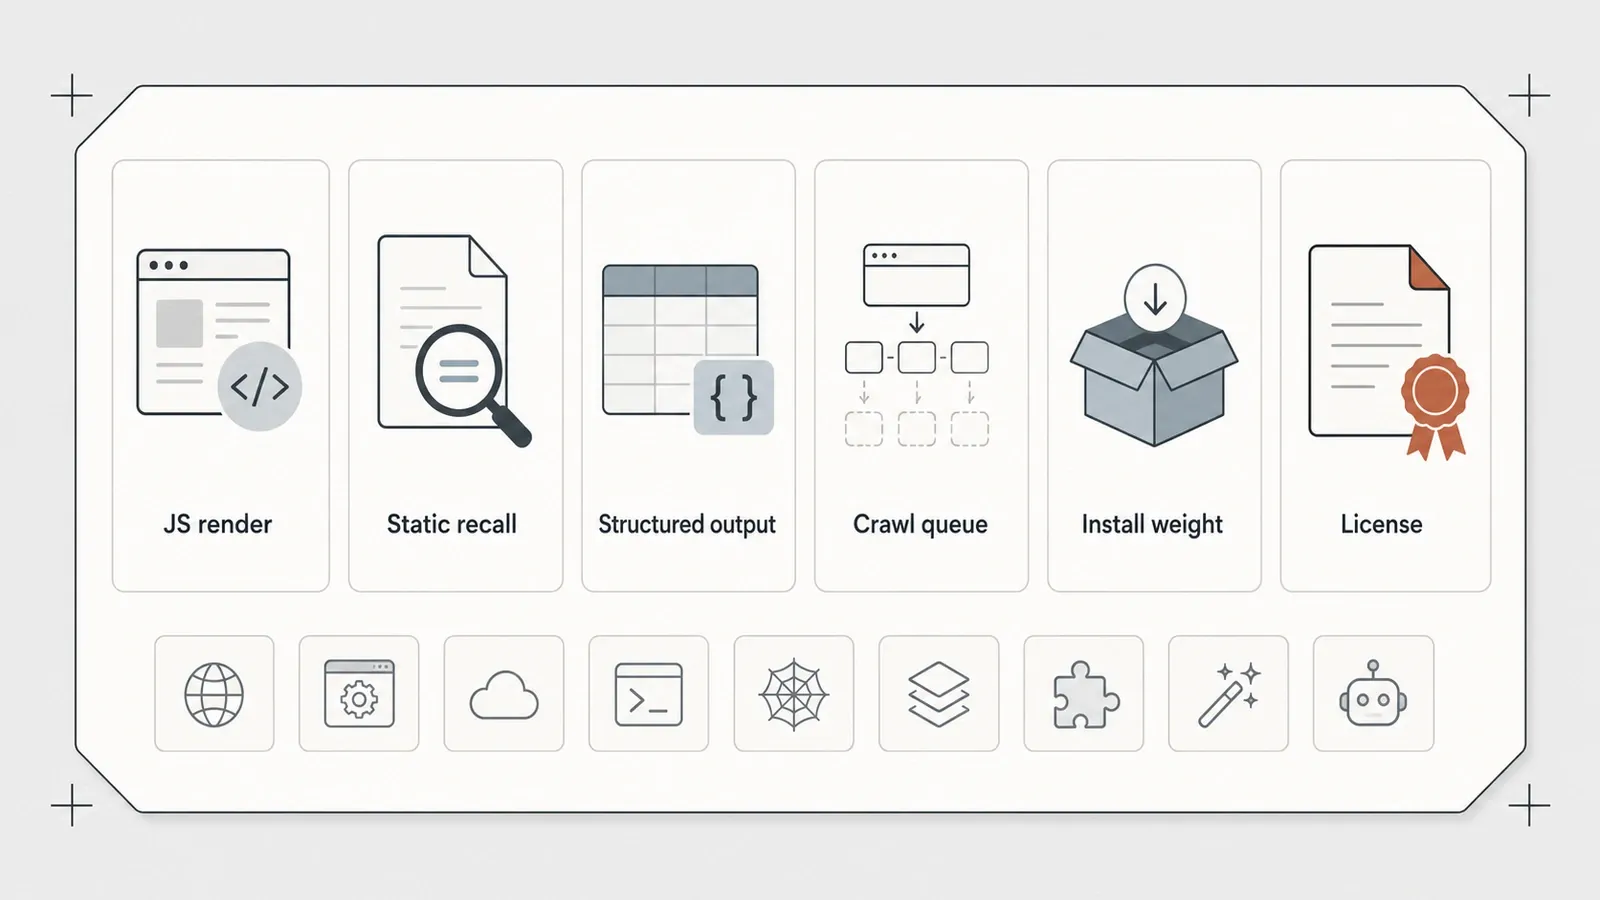
Tất cả công cụ đều được đưa qua cùng một loại fixture: 12 sản phẩm tĩnh trải trên hai trang, 8 sản phẩm được JavaScript bơm vào sau một khoảng trễ, một bài viết bị bao quanh bởi nav/footer với ba đoạn nội dung thật, một lỗi máy chủ 500 cố ý, và một đồ thị liên kết nội bộ. Chính thiết kế này giúp kết quả khớp nhau — “8/8 sản phẩm động” có cùng ý nghĩa dù Puppeteer hay Crawlee tạo ra nó.
Đây là ranh giới mà nhiều bài tổng hợp thường bỏ qua. Gói fixture của mỗi công cụ phản chiếu chính bộ fixture đó, nên số ký tự tuyệt đối không thể so sánh trực tiếp giữa các công cụ — hãy xem chúng như tín hiệu trong từng công cụ, đừng xem như điểm số chéo giữa các công cụ. Những con số có thể so sánh là recall (hãy coi như một tỷ lệ), việc có vượt qua JavaScript hay không, và hành vi cấu trúc. Cũng có một ghi chú phạm vi tương tự: lượt chạy của Crawl4AI với danh mục tĩnh chỉ bao gồm trang một, nên 6/6 là recall đầy đủ trên một lát cắt hẹp hơn; trong khi các công cụ khác crawl cả hai trang để đạt 12/12 — phạm vi nhỏ hơn, chứ không phải bỏ sót nửa chừng. Phân tích đầy đủ theo từng fixture nằm trong bài viết phương pháp.
Thêm một lưu ý trước khi nhìn vào số liệu. Mỗi gói cũng có một điểm nghiên cứu tạm thời, nhưng tôi cố ý không in chúng thành bảng xếp hạng. Đó chỉ là công cụ nội bộ để kiểm tra từng tool theo chính bằng chứng của nó, không phải một bảng league — và nếu công bố nó như vậy thì sẽ lặp lại đúng vấn đề “chính xác giả tạo” mà toàn bộ bài này muốn tránh. Đây là bản tổng hợp từ những gì benchmark cho thấy, không phải bảng điểm thi đấu.
Toàn bộ cuộc chơi, trên một sân benchmark
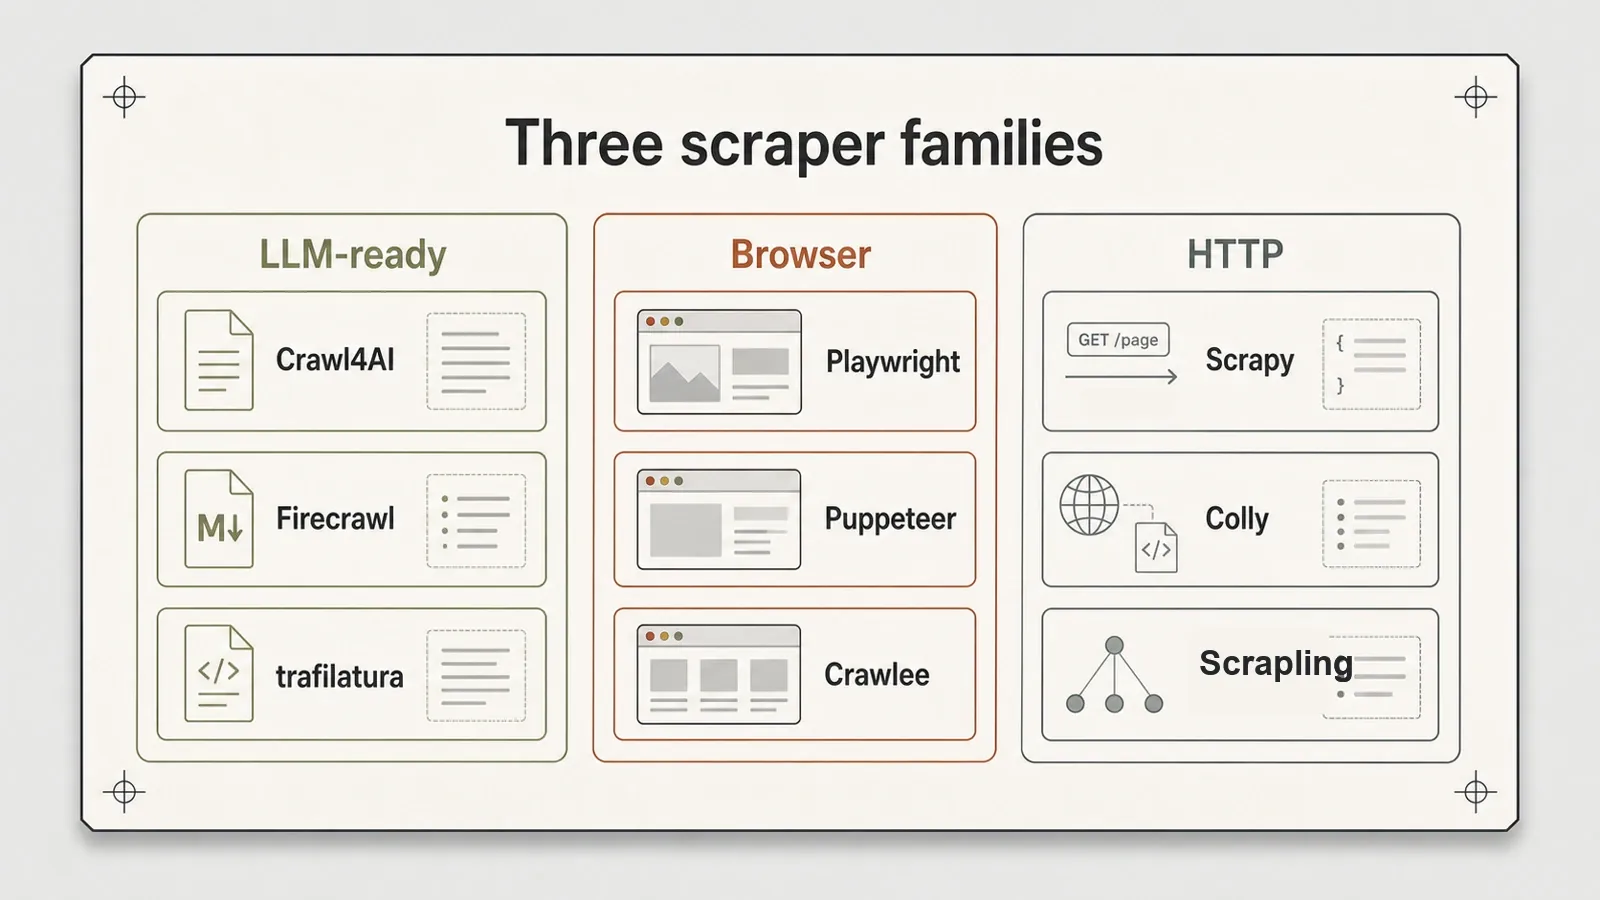
Chỉ cần nhìn xuống hai cột của bảng này — “Renders JS?” và “Built-in crawl queue” — là ba nhóm nhiệm vụ gần như lộ ra ngay.
| Công cụ | Ngôn ngữ | Render JS? | Recall tĩnh | Đầu ra có cấu trúc | Built-in crawl queue | Mức độ cài đặt | Giấy phép |
|---|---|---|---|---|---|---|---|
| Crawl4AI | Python | Có (browser) | 6/6 (trang 1) | CSS schema | BFS/DFS tích hợp | Nặng (2 browser stack) | Apache-2.0 |
| Firecrawl | Tự host | Có (playwright-service) | Markdown đầy đủ | Có | /v1/crawl | Nặng nhất (6 container) | AGPL-3.0 |
| trafilatura | Python | Không | 3/3 bài viết | Không (chỉ text) | Không | Nhẹ | Apache-2.0 |
| Crawlee | Node/TS | Tùy engine | 12/12 | Qua extraction | Có (RequestQueue) | Trung bình (+~80 MiB) | Apache-2.0 |
| Playwright | Node/đa ngôn ngữ | Có | 12/12 | Thủ công | Không (BFS tự viết) | Trung bình (browser) | Apache-2.0 |
| Puppeteer | Node | Có (Chrome) | 12/12 | Thủ công | Không (BFS tự viết) | Trung bình (Chrome) | Apache-2.0 |
| Scrapy | Python | Không | 12/12 | Feed export (JSON/CSV/XML) | Có (tích hợp sẵn) | Trung bình (Twisted deps) | BSD-3 |
| Colly | Go | Không | 12/12 | Qua callback | Kiểm soát độ sâu | Nhẹ (1 binary + Go) | Apache-2.0 |
| Scrapling | Python | Không (HTTP fetcher) | 12/12 | Có | Không | Trung bình ([fetchers]) | BSD-3 |
Một lưu ý về metadata trong bảng này và ở mọi phần bên dưới: số sao và phiên bản được chụp lại vào đầu tháng 7/2026, và cả hai thay đổi rất nhanh. Hãy kiểm tra lại trên GitHub và trang package của từng dự án trước khi coi bất kỳ số nào là hiện tại.
Mục lục đánh giá từng công cụ
Mỗi dự án trong roundup này đều có một bài review chuyên sâu tương ứng:
- Đánh giá Crawl4AI
- Đánh giá Firecrawl
- Đánh giá trafilatura
- So sánh Playwright vs Puppeteer
- Đánh giá Crawlee
- Đánh giá Scrapy
- Đánh giá Colly
- Đánh giá Scrapling
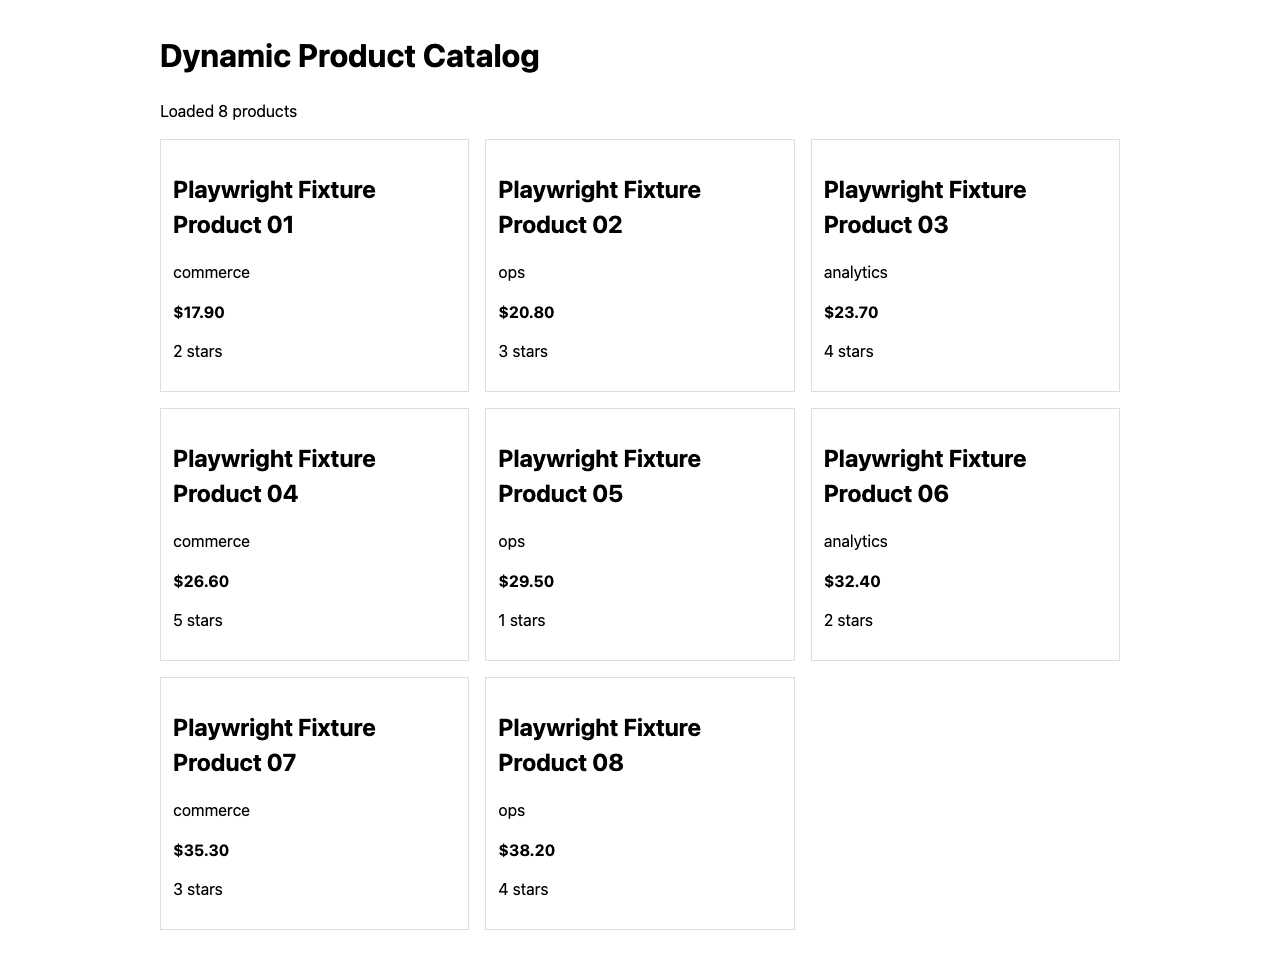
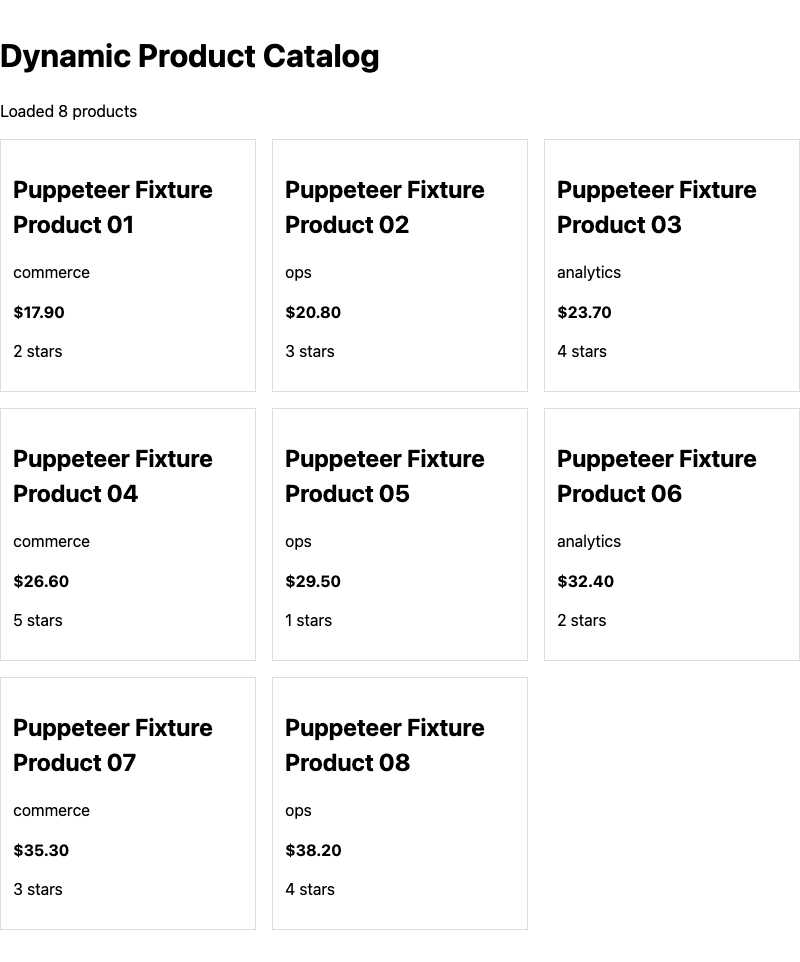
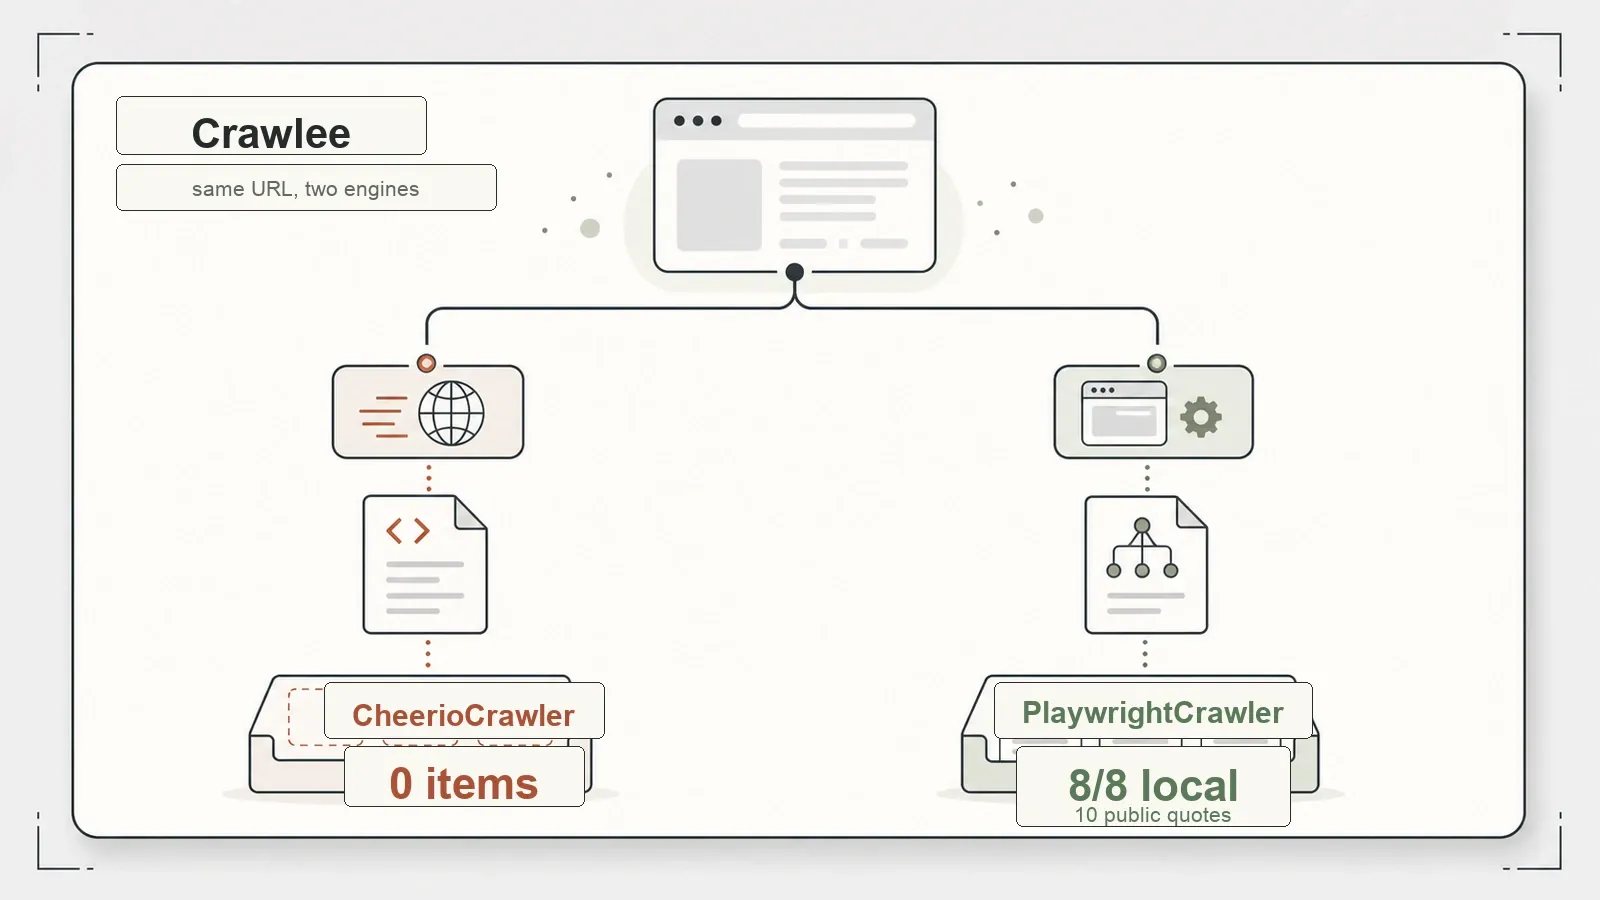
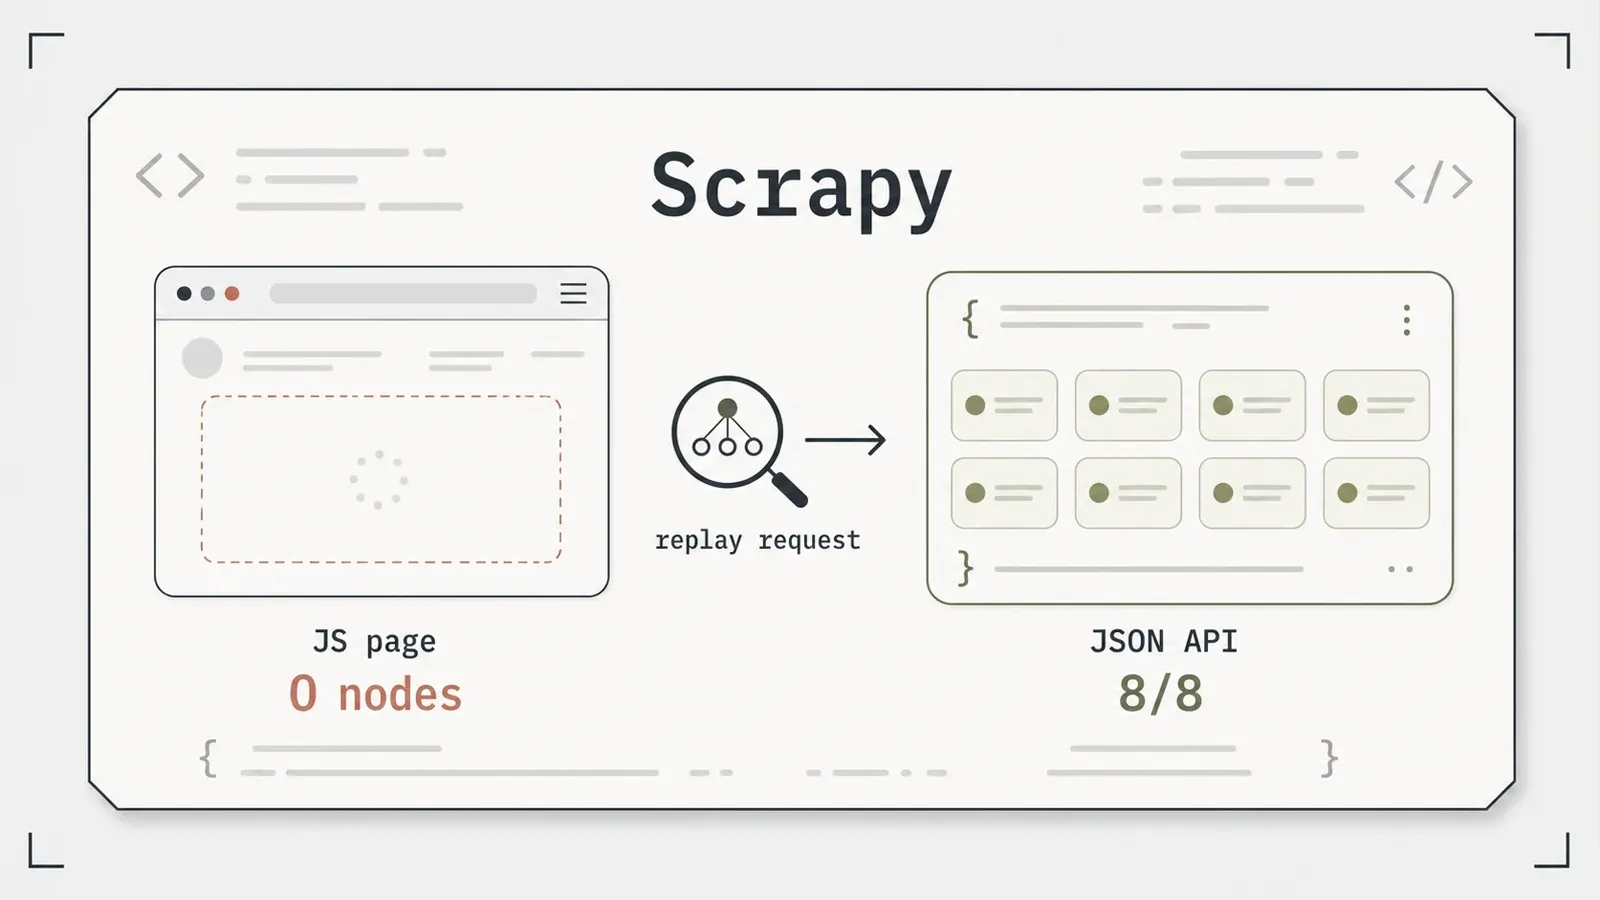
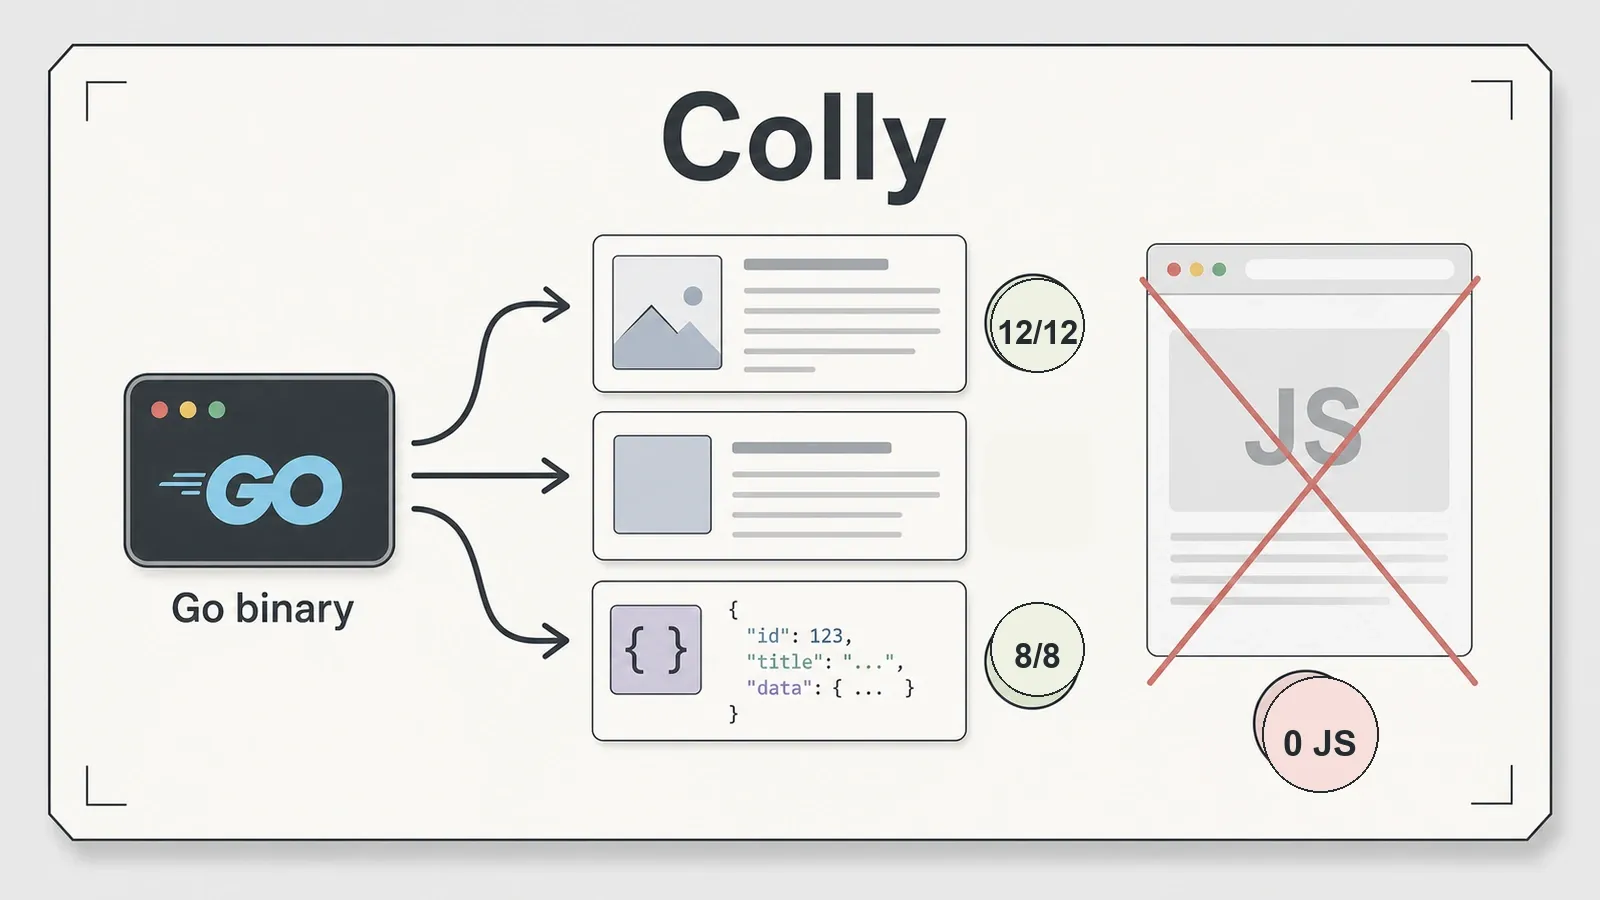
Đây là ảnh bìa của từng bài — kèm thêm hai ảnh chụp thật từ bài test render JavaScript, để khẳng định “8/8 dynamic” không chỉ là một con số trên giấy.
Nhiệm vụ 1: biến một trang thành văn bản sẵn sàng cho LLM
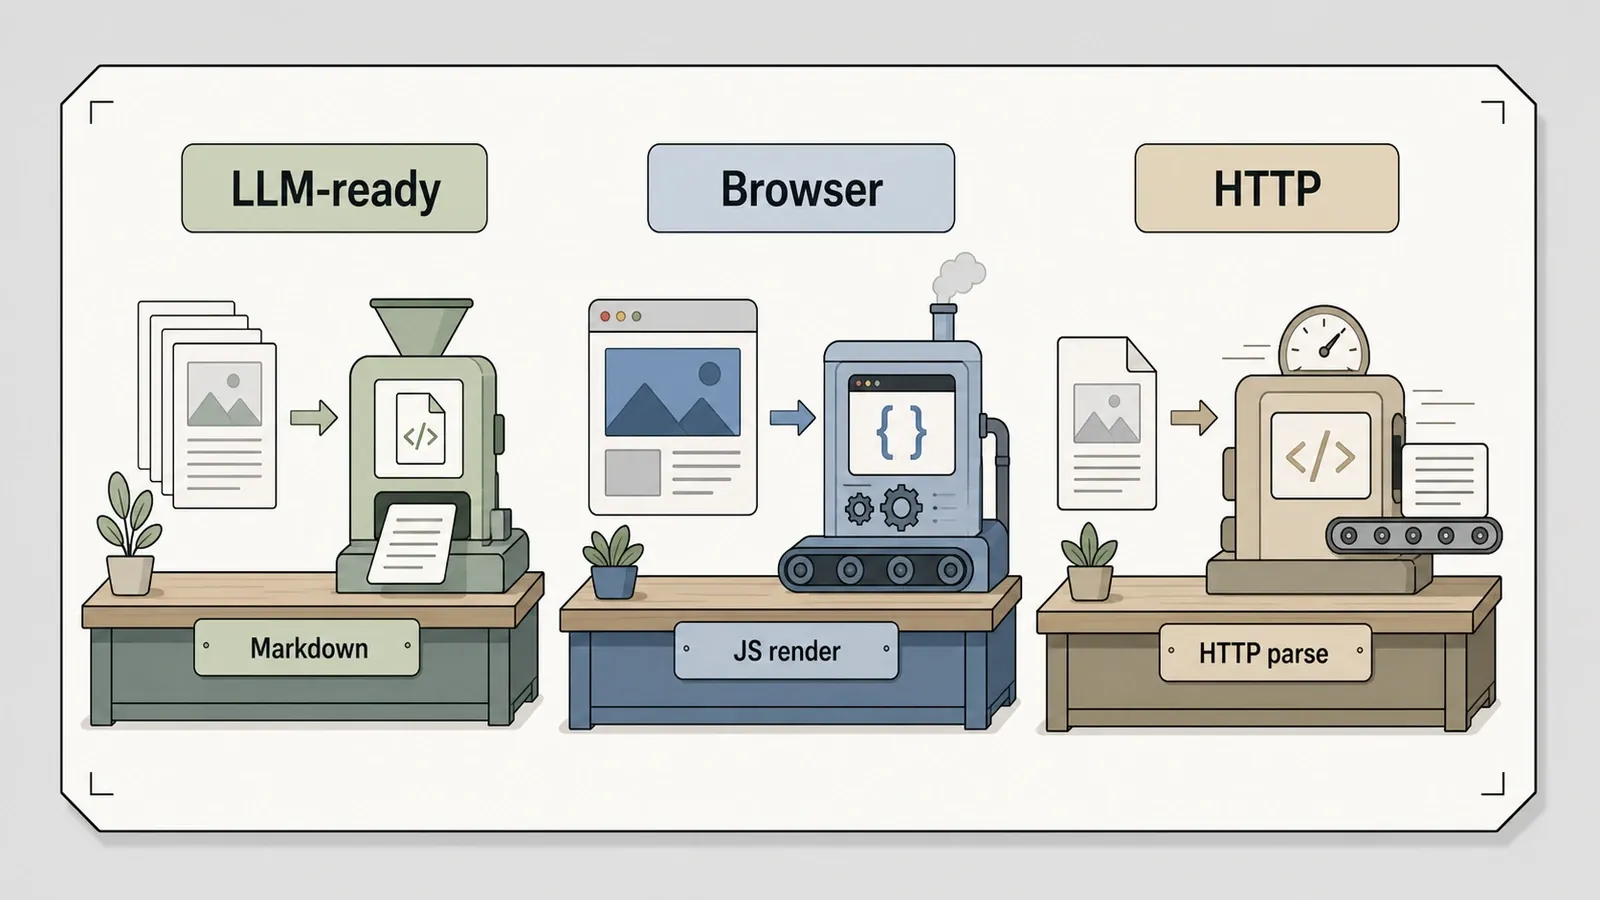
Nếu thứ bạn cần là Markdown sạch để đưa vào pipeline RAG, thì có ba công cụ cạnh tranh — và chúng khác nhau rất nhiều về cách tiếp cận.
Crawl4AI, dưới lớp marketing, thực chất là một bộ tạo Markdown dựa trên browser. Cần gạt bỏ luôn câu chuyện “adaptive intelligence self-learning selector” mà nó hay được gắn vào kết quả tìm kiếm: nó không có thứ đó — đó là mẹo của một thư viện khác hoàn toàn (phần đó sẽ rõ hơn khi nói đến Scrapling). Nhưng những gì nó thực sự làm thì làm khá tốt. Trên site thực hành Books to Scrape, nó xuất ra 13.476 ký tự Markdown, hỗ trợ trích xuất theo CSS schema cho dữ liệu có cấu trúc, và deep crawl BFS tích hợp sẵn đã đi qua 5 trang trên fixture crawl-graph trong khi render một trang JavaScript và chụp ảnh màn hình. Tuy nhiên có hai điểm trừ rõ ràng. Markdown thô của nó vẫn mang theo boilerplate của trang nếu bạn không bật bộ lọc nội dung, và lỗi 500 cố ý bị trả về success=false — không phải vì Crawl4AI bắt lỗi HTTP một cách gọn gàng, mà vì heuristic nội dung của chính nó nhìn vào phần thân lỗi quá ngắn rồi gắn nhãn minimal_text ... blocked. Việc cài đặt cũng kéo hai bộ browser stack xuống máy bạn. Phiên bản 0.9.0, Apache-2.0, khoảng 71 nghìn sao tính đến đầu tháng 7.
Firecrawl là “ông lớn” nặng ký, và việc tự host nó thực sự chạy được — tôi nói “thực sự” vì stack sáu container (api, playwright-service, redis, rabbitmq, nuq-postgres, và foundationdb) đã khởi động thành công và tạo ra 9.222 ký tự Markdown sẵn sàng cho LLM từ đúng trang Books to Scrape đó. Nó render được một trang JavaScript qua playwright-service đi kèm, và câu nói của Einstein xuất hiện sau khi script chạy, chứng minh quá trình render là thật. Hai trục trặc tôi gặp ra thực ra là do môi trường, không phải do Firecrawl, và tôi nói thật chính xác để không ai sao chép nhầm cách sửa: một lần build từ source vấp lỗi snapshotter của containerd dưới colima (tôi chuyển sang image dựng sẵn), và dải DNS 198.18.x.x của colima kích hoạt bộ chống SSRF của Firecrawl, tôi đã gỡ bằng ALLOW_LOCAL_WEBHOOKS=true — đây chỉ là mẹo cho local dev, không phải thứ nên vô hiệu hóa trong môi trường thật. Core self-hosted của nó cũng thiếu Fire-engine, lớp anti-block trên cloud, và tôi không test API cloud. Điểm đáng chú ý lớn hơn là giấy phép: core self-hosted của Firecrawl là AGPL-3.0, nghĩa là trước khi dùng cho mục đích thương mại bạn cần xem xét pháp lý nghiêm túc, không phải một chú thích nhỏ. Khoảng 148 nghìn sao tính đến đầu tháng 7.
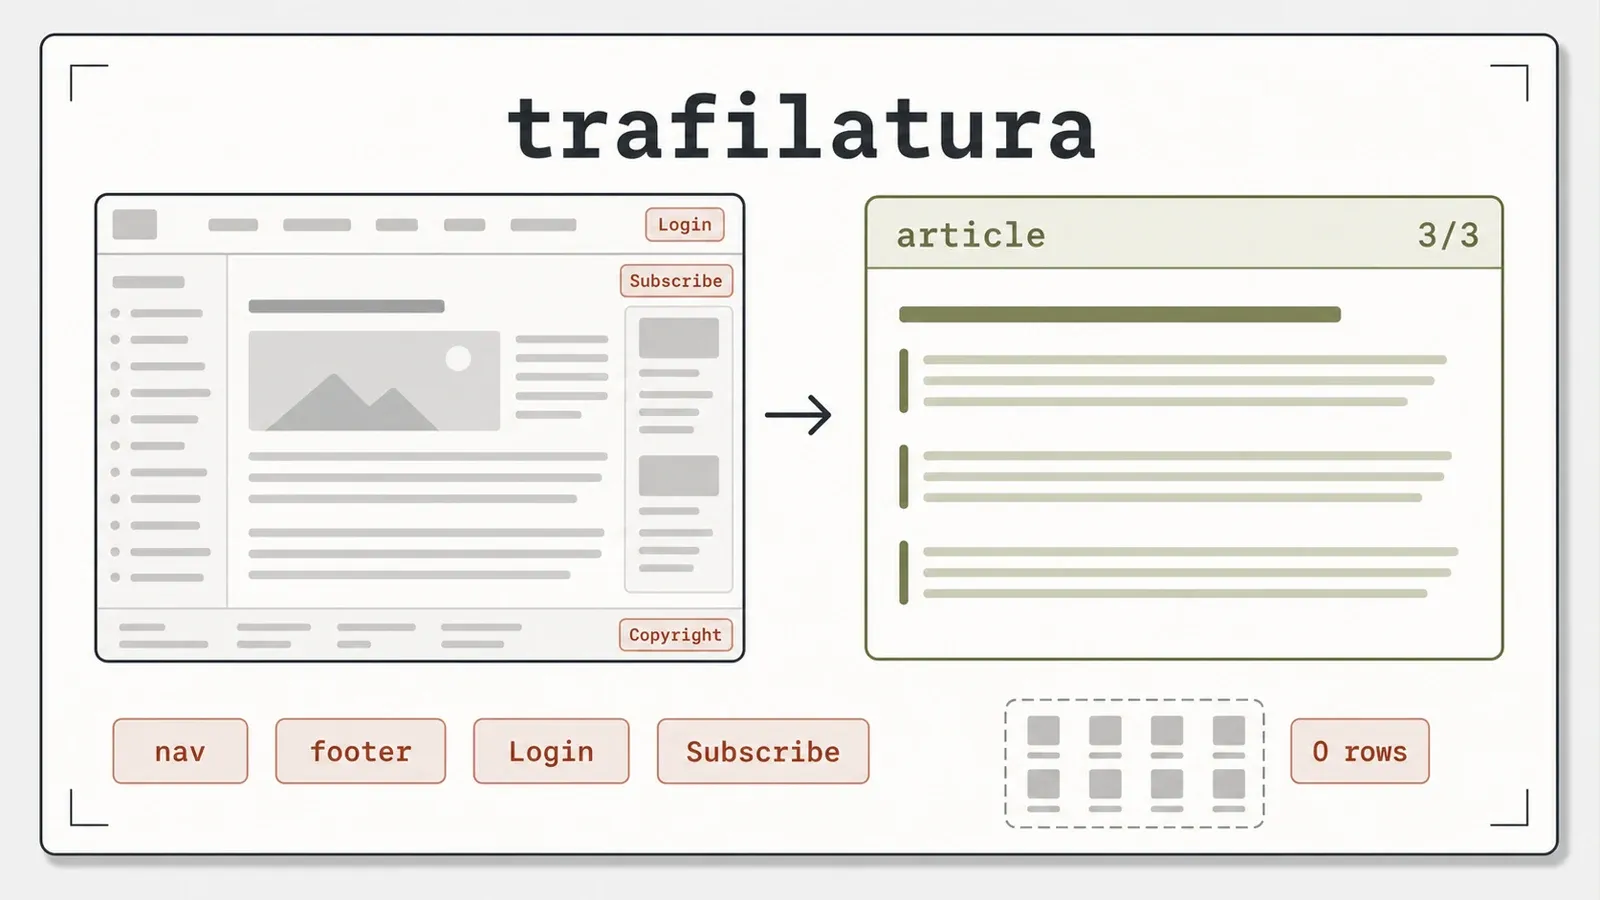
trafilatura là người “ngược dòng” trong nhóm, và cũng là công cụ mà các danh sách AI-hype hay quên nhất. Không browser. Không hàng dữ liệu có cấu trúc. Chỉ là trích xuất bài viết nhanh, sạch, thuần Python. Trên fixture bài viết, nó lấy được tiêu đề cùng cả 3/3 đoạn thật, loại bỏ hoàn toàn boilerplate — không rò rỉ “Login,” “Subscribe,” hay “Copyright” — và còn lấy luôn tác giả lẫn ngày đăng. Trên một trang sản phẩm công khai, nó trả về 1.324 ký tự văn bản sạch. Giới hạn của nó đúng như thiết kế: nếu đưa nó một danh mục, nó sẽ trả lại 12 tên sản phẩm dưới dạng text nhưng 0 hàng có cấu trúc — text có đó, cấu trúc thì không, và nó cũng không render JavaScript. Phiên bản 2.1.0 (bản phát hành hiện tại), Apache-2.0, khoảng 6,2 nghìn sao. Nếu chỉ cần trích xuất bài viết thuần túy, đây là thứ tôi sẽ chọn đầu tiên.
Hai con số ký tự Markdown — 13.476 từ Crawl4AI, 9.222 từ Firecrawl — đều lấy từ cùng một trang công khai, nhưng đừng đọc chúng như một khoảng cách về chất lượng. Chúng phản ánh chiến lược Markdown khác nhau (mức độ giữ lại “chrome” của trang), không phải phán quyết xem đầu ra nào tốt hơn. Đó chính là quy tắc “tín hiệu trong từng công cụ” ở trên, đang diễn ra công khai.
Nhiệm vụ 2: render JavaScript một cách đáng tin cậy
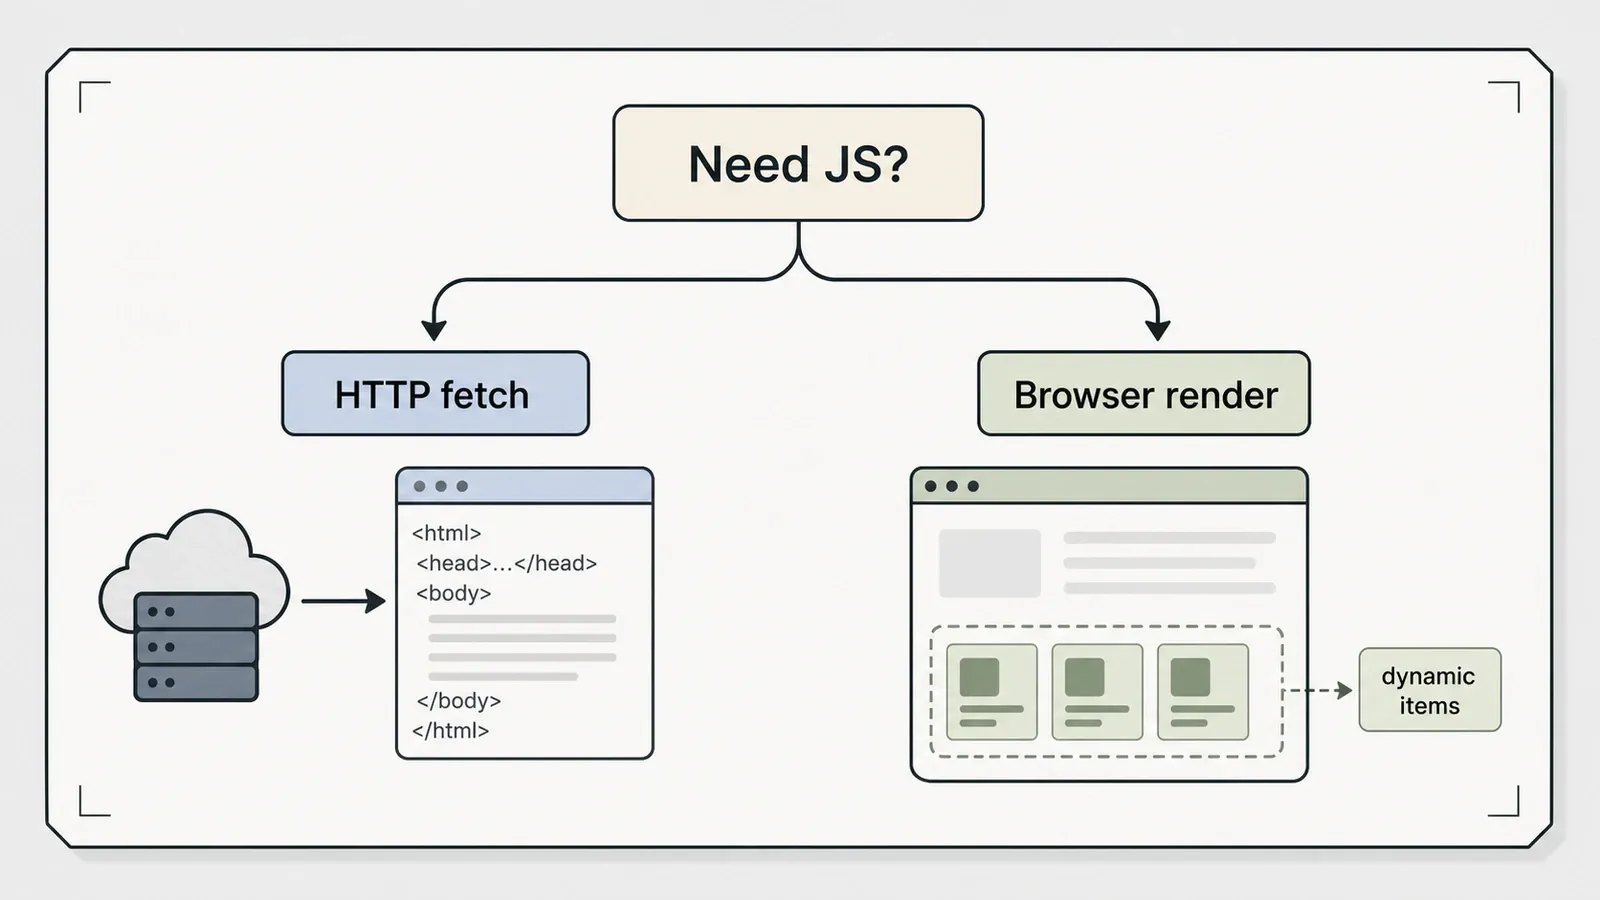
Một số dữ liệu đơn giản là chưa xuất hiện trong HTML cho đến khi script chạy, và đó là lúc một browser thật sự trở nên bắt buộc. Ba công cụ đảm nhận nhiệm vụ này — và hai trong số đó hóa ra gần như là cùng một loại công cụ.
Playwright và Puppeteer hòa nhau trên mọi bài test tôi đưa ra. Cả hai đều render được 8/8 sản phẩm động trên fixture nội bộ và 10 trên site Quotes JS công khai, cả hai đều đạt 12/12 recall tĩnh, và cả hai đều xử lý lỗi 500 sạch sẽ (Puppeteer trả về response object thay vì ném lỗi). Không công cụ nào có sẵn crawl queue, nên cả hai đều cần BFS viết tay, và cách này đi được 12 trang ở độ sâu 0–2 trên đồ thị crawl. Điểm khác thực sự chỉ là phạm vi hỗ trợ: Playwright điều khiển Chromium, Firefox và WebKit, đồng thời hỗ trợ Python và .NET, còn Puppeteer thiên về Chrome và chỉ dành cho Node. Có hai ghi chú quan trọng vì phiên bản đổi rất nhanh: tôi test Playwright 1.56.0 so với bản hiện tại 1.61.1 và chỉ chạy Chromium; còn Puppeteer 24.16.0 so với bản hiện tại 25.3.0 — hãy tự chạy lại hoặc đọc kết quả với sự thận trọng tương ứng. Cả hai đều Apache-2.0; khoảng 92k và 95k sao tương ứng.
Crawlee là công cụ giải quyết bài toán hàng đợi mà hai công cụ kia để ngỏ. Nó bọc engine Cheerio (HTTP) và engine Playwright (browser) dưới cùng một API, và sự khác biệt trên cùng một trang chính là toàn bộ lời hứa của nó: engine Cheerio thấy 0 mục được JavaScript chèn vào, còn engine Playwright thấy đủ 8/8 trên máy local (và 10 trên site công khai), và việc chuyển đổi giữa chúng chỉ là đổi một dòng. Nó cũng cho bạn một RequestQueue đúng nghĩa, và đó là lý do nó thuộc nhóm nhiệm vụ này thay vì nhóm số ba. Điều mà hầu như không ai viết ở headline: browser engine cần chạy thêm npx playwright install, khoảng 80 MiB mà npm install crawlee không tự tải về cho bạn. Phiên bản 3.17.0, TypeScript, Apache-2.0, khoảng 24,6k sao.
Nhiệm vụ 3: crawl nhanh mà không cần browser
Khi trang không có JavaScript, dùng browser là thừa và tốn kém. Ba công cụ thiên về HTTP cạnh tranh ở đây, mỗi công cụ đại diện cho một triết lý ngôn ngữ khác nhau, và chúng khác nhau khá thú vị.
Scrapy là framework ở cấp độ kỹ thuật cao nhất trong nhóm — spider, feed export ra JSON/CSV/XML, AutoThrottle, đủ cả. Nó đạt 12/12 recall tĩnh, lấy được 3/3 đoạn của bài viết, đi qua 11 trang ở độ sâu 0–2 trên crawl graph, và bắt được lỗi 500 qua handle_httpstatus_list. Điều thú vị nằm ở cách nó nhìn thế giới: nó không render, nó tái hiện request. Khi đưa vào trang JavaScript, nó nhận về 0 node — rồi API JSON nằm phía sau trang đó lại cho nó 8/8. Đó chính là triết lý Scrapy trong một điểm dữ liệu: tìm request mà trang đang gọi rồi replay lại, chứ không điều khiển browser. Cái giá phải trả là một stack phụ thuộc tương đối lớn (Twisted, lxml, parsel), và tôi chỉ test nó trên các fixture nhỏ. Phiên bản 2.17.0, BSD-3-Clause, khoảng 63k sao.
Colly là câu trả lời của Go, và nó rất thẳng thắn về bản chất của mình: một binary tĩnh duy nhất, chạy bằng callback qua OnHTML, OnResponse, và OnError, kèm theo kiểm soát độ sâu. Nó đạt 12/12 recall tĩnh, lấy được 8/8 từ API JSON qua OnResponse, bắt lỗi 500 qua OnError, và đi đến 17 trang trong một crawl độ sâu 2 — và tôi cố ý nói đúng y như vậy, vì con số trang này là bộ đếm của harness, không phải một cam kết về độ đầy đủ của Colly. Thứ nó không làm là JavaScript: fixture động và site Quotes JS đều trả về 0, đúng như thiết kế. Bạn sẽ cần Go toolchain để build nó, và phiên bản module (v2.3.0) hiện đang đi trước bản tag phát hành (v2.2.0). Apache-2.0, khoảng 25k sao.
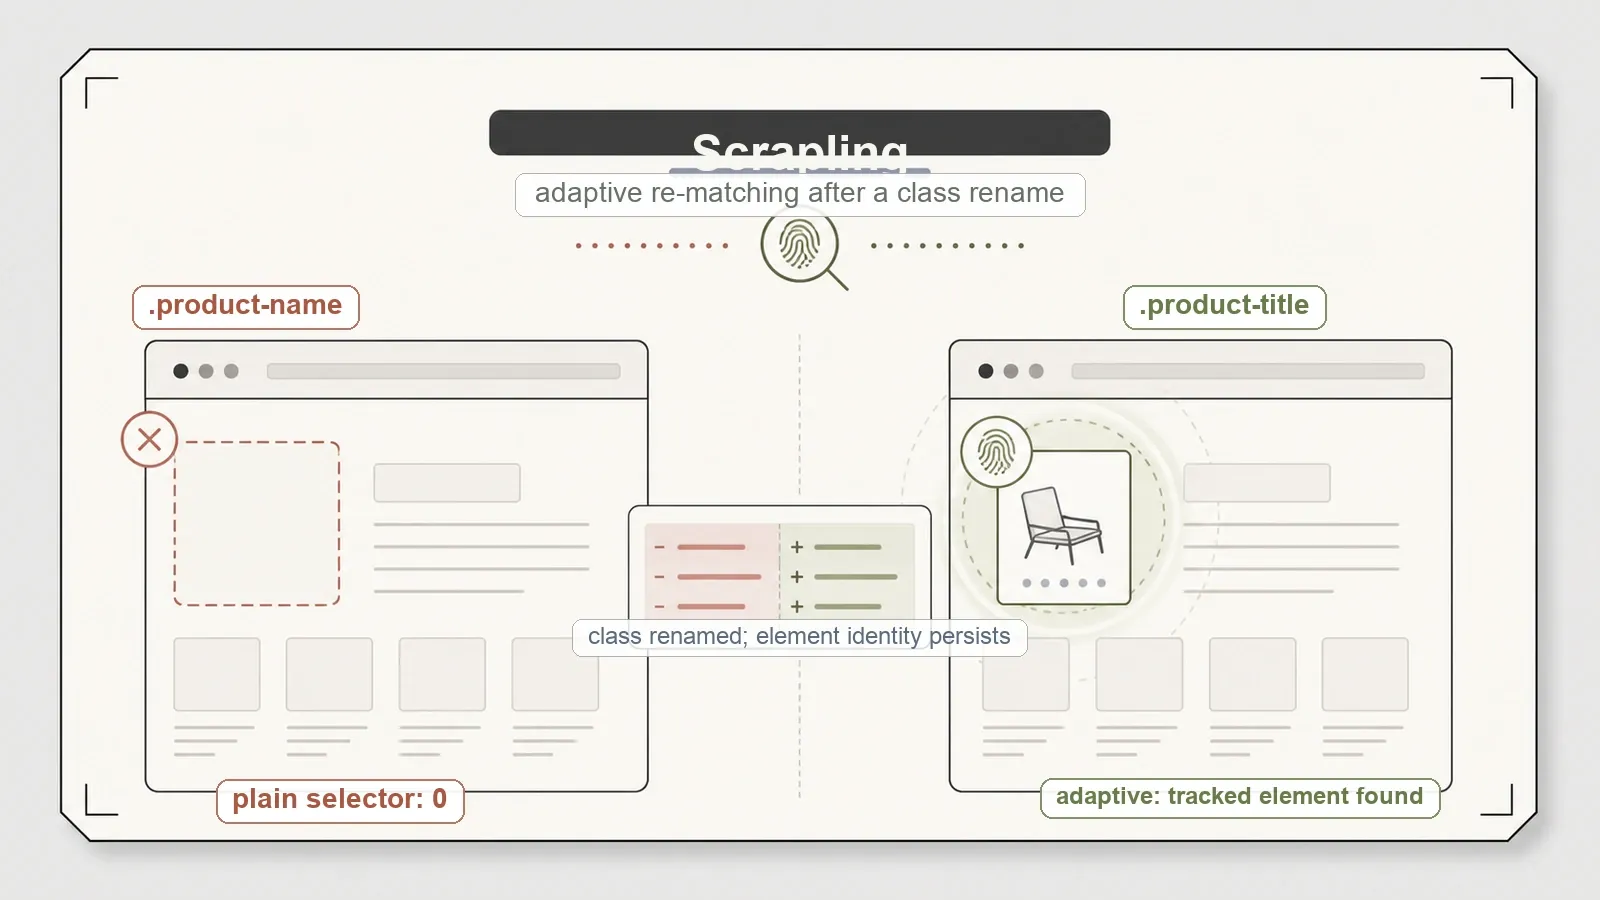
Scrapling là công cụ chuyên biệt, và nó xứng đáng với cái tên đó. Các selector thích ứng của nó được thiết kế để tìm lại phần tử sau khi markup thay đổi — vì thế khi tôi đổi class HTML của mục tiêu từ product-name sang product-title, selector thường chỉ khớp 0, còn cơ chế adaptive re-match vẫn tìm lại được phần tử đang theo dõi. Với trích xuất HTTP thuần, nó đạt 12/12 trên tĩnh và 8/8 trên API JSON. Nhưng phần mà tài liệu của nó cũng không che giấu: trong một bài test synthetic nhiều phần tử, nó chỉ khôi phục được 1/3 — đây là khả năng theo dõi phần tử bền bỉ, không phải phép màu khôi phục toàn bộ, nên đừng tự thổi phồng nó. Lệnh pip install scrapling cơ bản cũng cần thêm [fetchers] để chạy, và StealthyFetcher là một cảnh báo về tuân thủ, không phải tính năng để đem lên slide. Phiên bản 0.4.10 (bản hiện tại), BSD-3-Clause, khoảng 68,7k sao.
Mẫu hình nằm dưới ba nhiệm vụ này
Xếp cả chín công cụ cạnh nhau, một bức tranh rõ ràng hiện ra. Recall tĩnh đầy đủ — con số phẳng 12/12 — là mức tối thiểu đối với mọi công cụ thiên về HTTP; không ai trượt ở case dễ, nên đó không phải điểm phân biệt. Các công cụ browser chỉ đáng với trọng lượng bổ sung của chúng khi thực sự có JavaScript, và chúng đều phải trả giá ở khâu cài đặt: một browser stack, một lần cài thêm, hoặc cả một cụm container. Và cột “built-in crawl queue” thực ra chính là ranh giới giữa framework và engine — Scrapy và Crawlee mang theo cơ chế điều phối, còn Playwright và Puppeteer bắt bạn tự viết BFS. Đó là hình dạng thật của lĩnh vực này. Không có ai thắng chung cuộc vì không ai đang chơi cùng một trò chơi.
Vậy rốt cuộc bạn nên chọn công cụ nào
Benchmark này không thể trao vương miện cho một người thắng duy nhất, vì câu trả lời đúng không phải là một công cụ — mà là một câu hỏi: bạn đang làm nhiệm vụ nào trong ba nhiệm vụ đó?
- Cần Markdown sẵn sàng cho LLM? Chọn trafilatura nếu bạn chỉ cần bài viết sạch, chọn Crawl4AI nếu bạn muốn vừa CSS extraction vừa render JavaScript trong cùng một thư viện, và chọn Firecrawl nếu bạn cần một dịch vụ self-hosted và chấp nhận cả giấy phép AGPL-3.0 lẫn trọng lượng sáu container.
- Cần render JavaScript? Dùng Playwright hoặc Puppeteer nếu chỉ cần khả năng render thô — chọn theo engine và ngôn ngữ vì gần như hòa nhau — và dùng Crawlee khi bạn muốn có sẵn orchestration crawl thay vì phải tự viết.
- Crawl trang tĩnh hoặc API có thể tái hiện ở quy mô lớn? Scrapy nếu bạn cần một framework Python đầy đủ, Colly nếu bạn muốn tốc độ Go thuần trong một binary duy nhất, và Scrapling nếu vấn đề lớn nhất của bạn là website thay đổi markup liên tục.
Chọn đúng nhóm nhiệm vụ thì mỗi công cụ ở đây đều là một lựa chọn hoàn toàn có thể bảo vệ. Lấy nhầm nhóm — dùng browser tool cho trang tĩnh, hoặc dùng HTTP parser cho ứng dụng JavaScript — thì dù đó có là thư viện được xếp hạng cao nhất trên internet, nó vẫn sẽ làm bạn thất vọng.
Khi nào nên dùng một API AI được quản lý thay vào đó
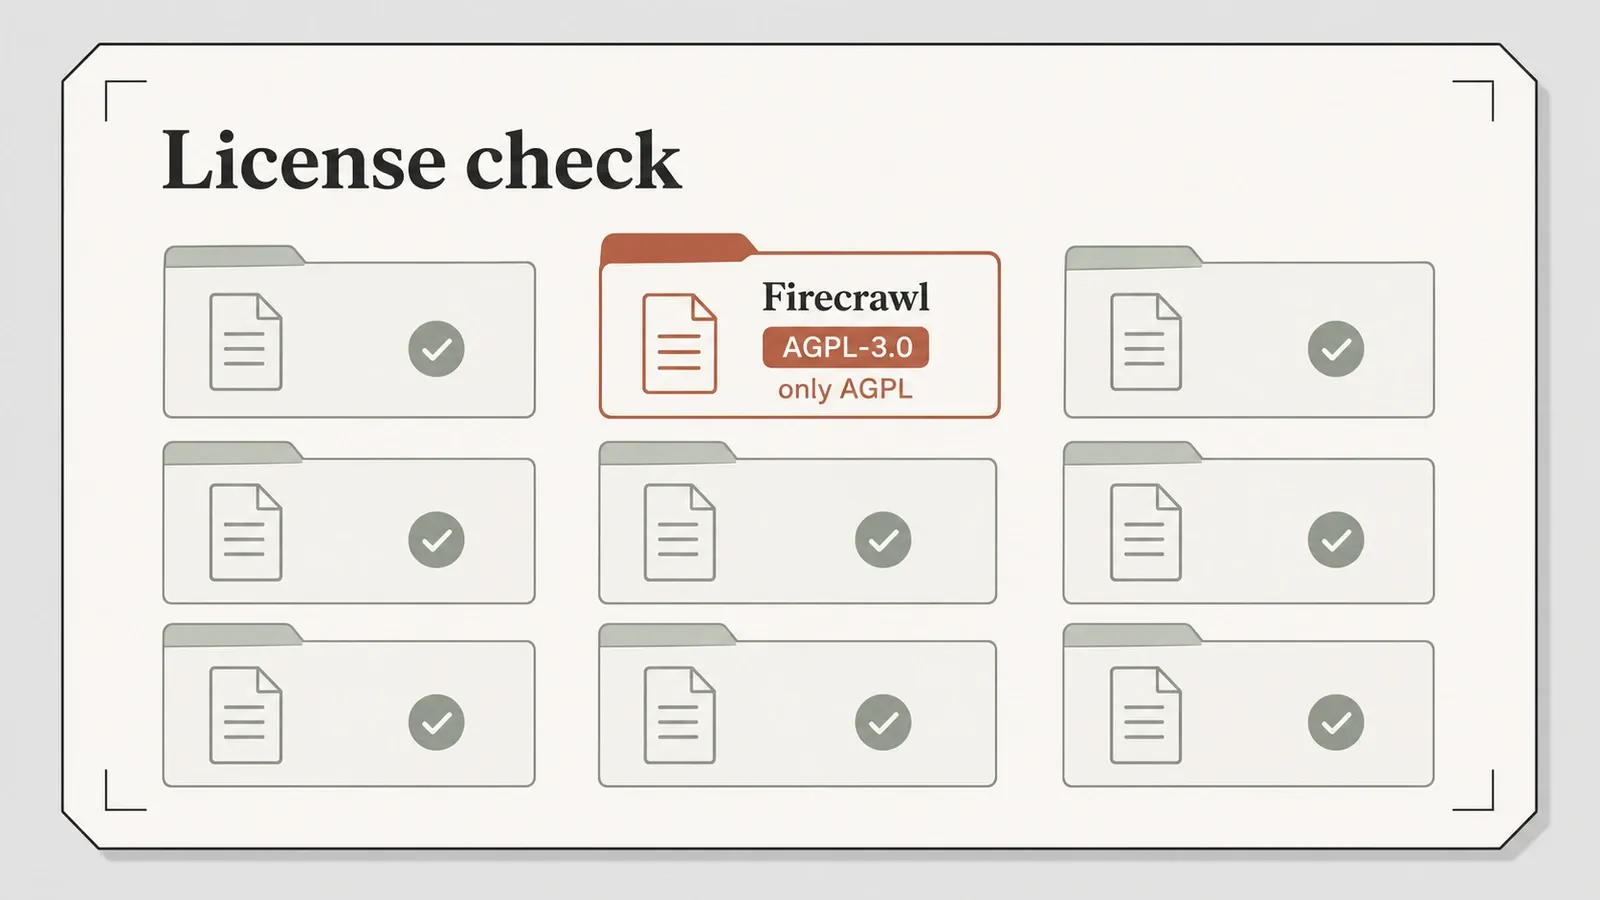
Tất cả công cụ phía trên đều miễn phí, mã nguồn mở, và bạn có thể tự chạy chúng. Nhưng đó cũng là đánh đổi chung mà benchmark này liên tục cho thấy: bạn tự quản lý môi trường browser, code crawl, cuộc đua chống bot, và mọi thứ vận hành đi kèm. Với nhiều đội ngũ, quyền kiểm soát đó chính là lý do họ chọn chúng, và bản đồ giấy phép cũng rất quan trọng khi bạn đi theo hướng này — phần lớn thị trường khá thoáng (Apache-2.0 cho Crawl4AI, Crawlee, Playwright, Puppeteer và Colly; BSD-3 cho Scrapy và Scrapling), còn core self-hosted của Firecrawl mang giấy phép AGPL-3.0 là phần cần được xem xét kỹ trước khi đưa vào sử dụng thương mại.
Nhưng hãy để ý benchmark này cũng cho thấy điều gì mà các công cụ đó không làm. Render, crawl, cấu trúc hóa, và xoay vòng khi bị chặn — hiếm khi làm trọn vẹn tất cả, và hầu như không bao giờ làm mà không cần bạn bảo trì. Một API scraping AI được quản lý sẽ gom cả đống đó thành một lệnh gọi duy nhất. Surface dành cho developer của chúng tôi tại Thunderbit là một lựa chọn như vậy, và với nhóm kỹ thuật thì API, MCP server, và CLI mới là thứ quan trọng chứ không phải extension trình duyệt. POST /distill trả về Markdown sạch còn POST /extract trả về JSON theo schema, với việc render JavaScript và chống bot được xử lý ở phía server thay vì trên máy của bạn. Có một MCP server chính thức cho agent và coding assistant — thunderbit_suggest_fields chạy miễn phí để lên kế hoạch extraction, rồi thunderbit_distill (1 credit) và thunderbit_extract (20 credit) thực hiện công việc — và có cả CLI bạn có thể cài bằng npx @thunderbit/thunderbit-cli cho terminal và cron job. Với những người không lập trình trong đội ngũ của bạn thì cũng có một Chrome extension không cần code, và giá thì bao phủ cả hai hướng.
Đánh đổi ở đây cũng chính là đánh đổi mà toàn bộ benchmark này xoay quanh: tự chạy và tự bảo trì tới chín thư viện với chi phí mỗi lần gọi bằng 0, hoặc giao phần hạ tầng đó cho dịch vụ khác và trả tiền theo request. Không có lựa chọn nào sai. Vấn đề là bạn thật sự muốn sở hữu bao nhiêu phần của stack. Nếu muốn xem quá trình trích xuất trông như thế nào trong thực tế, kênh YouTube của Thunderbit có các hướng dẫn chi tiết.
Kết luận
Không có một web scraper mã nguồn mở nào là tốt nhất cho mọi trường hợp, và bất kỳ danh sách nào tự tin trao cho bạn một cái tên duy nhất đều đang lặng lẽ che đi câu hỏi thực sự quyết định kết quả: bạn đang làm nhiệm vụ nào trong ba nhiệm vụ đó? Biến một trang thành văn bản, render JavaScript, hay crawl nhanh mà không cần browser — lĩnh vực này chia rất rõ thành ba nhóm, và bên trong từng nhóm, lựa chọn phụ thuộc vào ngôn ngữ và mức độ cồng kềnh khi cài đặt, chứ không phải một nhà vô địch tuyệt đối nào cả.
Nếu bạn chỉ rút ra một thói quen từ toàn bộ bài này, hãy nhớ điều này: hãy test trên chính trang của bạn trước khi quyết định. Mọi con số ở đây đều có thể tái tạo trong repo benchmark chính vì lý do đó — vì công cụ đứng đầu một bảng tổng hợp chung chung và công cụ sống sót trên mục tiêu thật của bạn không phải lúc nào cũng là cùng một thứ.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Web scraper mã nguồn mở nào tốt nhất? Không có một công cụ duy nhất cho mọi trường hợp — còn tùy nhiệm vụ. Nếu cần text sẵn sàng cho LLM, chọn trafilatura hoặc Crawl4AI; nếu cần render JavaScript, chọn Playwright, Puppeteer hoặc Crawlee; nếu cần crawl HTTP nhanh, chọn Scrapy hoặc Colly. Trên cùng một benchmark, mỗi công cụ mạnh nhất trong nhóm của mình và yếu rõ rệt khi ra ngoài nhóm đó, nên kiểu xếp hạng “một cho tất cả” rất dễ gây hiểu lầm.
Những scraper mã nguồn mở nào render được JavaScript? Crawl4AI, Firecrawl, Playwright, Puppeteer, và engine Playwright của Crawlee đều render được JavaScript. Scrapy, Colly, trafilatura, và HTTP fetcher mặc định của Scrapling thì không — hoặc cần một API có thể tái hiện phía sau trang (cách tiếp cận của Scrapy, và nó lấy được 8/8 từ JSON endpoint), hoặc cần một chế độ browser riêng.
Tôi có cần headless browser để scrape một website không? Chỉ khi dữ liệu xuất hiện sau khi JavaScript chạy. Nếu chỉ cần request HTTP bình thường cộng với parser là lấy được nội dung, thì browser là quá nặng và thừa; trong trường hợp đó Scrapy, Colly, hoặc Scrapling sẽ nhẹ và nhanh hơn rất nhiều.
Công cụ nào thân thiện nhất với việc dùng thương mại? Phần lớn đều khá thoáng: Apache-2.0 (Crawl4AI, Crawlee, Playwright, Puppeteer, Colly) hoặc BSD-3-Clause (Scrapy, Scrapling). Ngoại lệ là core self-hosted của Firecrawl, vốn là AGPL-3.0 và cần được xem xét giấy phép nghiêm túc trước khi bạn xây sản phẩm thương mại dựa trên nó.
Các số benchmark này có tái tạo lại được không? Có. Mọi runner, fixture, và kết quả thô đều nằm trong một repo công khai có giấy phép MIT. Một lưu ý cần nhớ: recall và kết quả cấu trúc có thể so sánh chéo giữa các công cụ, nhưng số ký tự tuyệt đối chỉ là tín hiệu trong từng công cụ, vì mỗi gói phản chiếu bộ fixture thay vì dùng chung một bản canonical — nên hãy so sánh tỷ lệ và pass/fail, đừng so sánh tổng số ký tự thô.




