
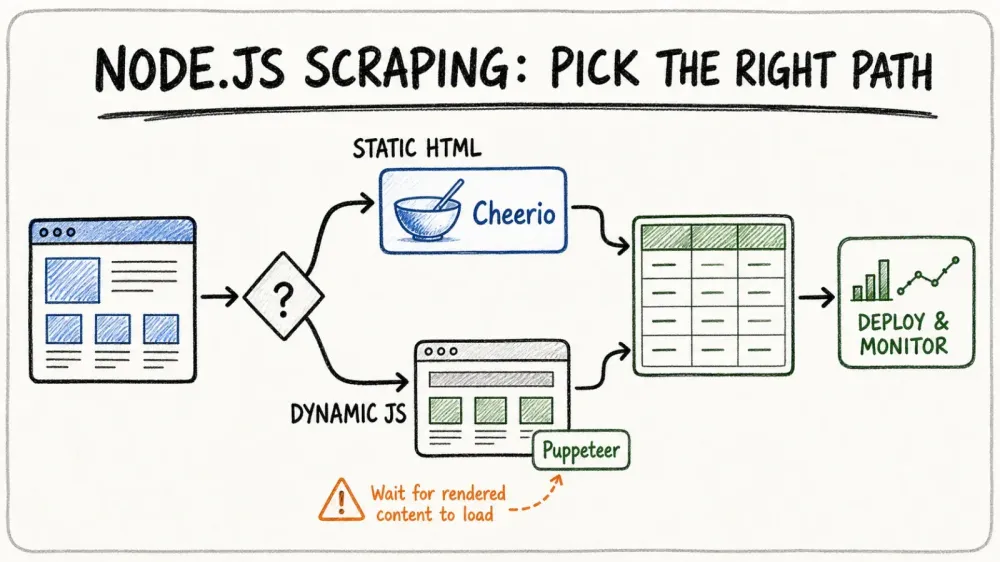
Web, her zamankinden daha fazla veriye aç; 2026’da Node.js, işleri zorlayarak değil akıllıca ilerletmek isteyen ekipler için öne çıkıyor. İster satışta, ister e-ticarette, ister benim gibi veri meraklısı olun, scraping’in artık yalnızca “veriyi çekmekten” ibaret olmadığını fark etmişsinizdir — mesele hızlı olmak, ölçeklenebilmek ve IP’nizin dijital hapse düşmemesini sağlamak. Üstelik talep de yavaşlamıyor: herkese açık web verisi sessiz sedasız, fiyat istihbaratından LLM eğitim hatlarına kadar modern ekiplerin üzerine kurduğu temel girdiye dönüştü ve rekabet hiç olmadığı kadar sert.
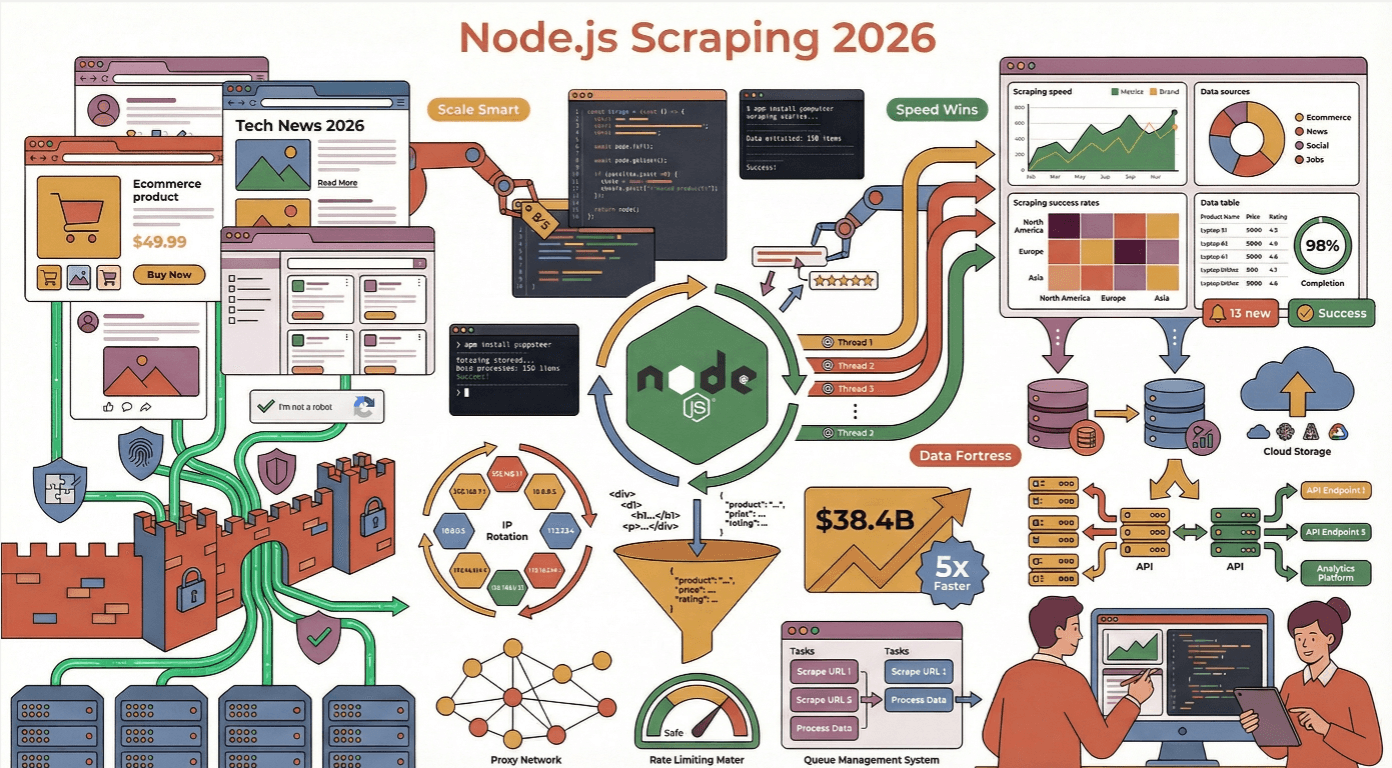
Ama işin püf noktası şu: modern web; dinamik içerik, bot karşıtı tuzaklar ve sürekli değişen arayüzlerle dolu bir kale gibi. Açık konuşayım, boşa düşen ve dağılan scraper’ların sayısını ben de sayamıyorum—çoğu ya en iyi uygulamaları umursamadığı ya da bu anti-scraping savunmalarının ne kadar akıllı hale geldiğini hafife aldığı için. O yüzden gelin, Node.js web scraping verimliliği için gerçek dünyada işe yarayan en iyi uygulamalara; birkaç hikâye, biraz mizah ve bolca uygulanabilir tavsiyeyle dalalım.
Web Scraping Verimliliği İçin Neden Node.js Seçilmeli?
Aynı anda yüzlerce, hatta binlerce sayfayı çekmeye çalıştıysanız, hız ve eşzamanlılığın her şey olduğunu bilirsiniz. Node.js’in öne çıktığı yer tam da burası. Asenkron, bloklamayan I/O modeli; devasa sayıda eşzamanlı ağ isteğini yönetmek için tasarlanmıştır—onu web için nihai çoklu görev ustası gibi düşünebilirsiniz (Node.js Docs). Diğer diller her isteğin bitmesini beklerken yavaşlayabilir; Node.js ise event loop’unu döndürmeye devam eder, istekleri hiperaktif bir sirk sanatçısı gibi aynı anda idare eder.
Gerçek zamanlı güncellemelerin ve büyük ölçekli veri çekmenin gerekli olduğu senaryolarda, özellikle hedef siteler JavaScript ile yükleniyorsa, Node.js’in Python ve Java’yı geride bıraktığını gördüm. Hatta geliştiricilerin yaklaşık %40’ı artık backend ve otomasyon işlerinde Node.js kullanıyor; bu da onu dünyadaki en popüler web teknolojisi haline getiriyor.
Node.js ve Diğer Web Scraping Framework’leri
Biraz teknik konuşalım. Node.js rakiplerine karşı nasıl konumlanıyor:
| Framework | Güçlü Yanları | Zayıf Yanları | En Uygun Kullanım Alanları |
|---|---|---|---|
| Node.js | Asenkron, yüksek eşzamanlılık için ideal, dev npm ekosistemi, dinamik siteler için yerel JS | Bellek tüketimi yüksek olabilir, async/await kullanılmazsa callback cehennemi yaşatabilir | Gerçek zamanlı scraping, JS ağırlıklı siteler, ölçeklenebilir mikroservisler |
| Python | Çok sayıda scraping kütüphanesi (BeautifulSoup, Scrapy), kolay sözdizimi | Büyük eşzamanlılıkta daha yavaş, JS ile render edilen sitelerde zorlanır | Statik HTML, araştırma, prototipleme |
| Java | Güçlü tip sistemi, kurumsal kullanım için sağlam | Ayrıntılı ve uzun, hızlı scriptler için daha az esnek | Büyük ölçekli, kurumsal seviye scraping |
| Go | Hızlı, verimli eşzamanlılık | Daha küçük ekosistem, öğrenme eğrisi daha dik | Yüksek performanslı, düşük gecikmeli scraping |
Çoğu iş kullanıcısı için Node.js tam kararında bir seçenek sunuyor: hızlı, esnek ve modern, JavaScript tabanlı web için mükemmel şekilde ayarlanmış (Thunderbit Blog).
Sağlam Bir Node.js Web Scraping Ortamı Kurmak
İyi bir scraper, sağlam bir temelle başlar. Benim favori kurulumum şöyle:
- Proje yapısı: Her şeyi modüler tutun.
/src,/libsve/configgibi klasörler kullanın. API anahtarları ve proxy’ler gibi hassas bilgileridotenvile environment variable olarak saklayın (Thunderbit Guide). - HTTP istemcisi: İstekler için axios, got veya node-fetch kullanın.
- HTML ayrıştırma: Statik HTML için Cheerio, dinamik içerik için Puppeteer veya Playwright.
- Yardımcı araçlar: Veri düzenleme için Lodash, veri doğrulama için validator.js veya Joi.
- Test ve lint: Testler için Mocha, kod kalitesi için ESLint (LogRocket).
Temel Node.js Web Scraping Kütüphaneleri
- HTTP istemcileri (axios / got / yerleşik
fetch): İstek göndermek için kullanılır. Baştan söyleyelim: Node.js v18’den itibarenfetchyerleşik olarak kullanılabiliyor ve Node.js v22 ile de kararlı hale geldi. Yeni ve güncel bir Node sürümünde projeye başlıyorsanız, büyük ihtimallenode-fetchpaketine hiç ihtiyacınız yok — doğrudanfetchçağırmanız yeterli. Yine de interceptor’lar, otomatik JSON işleme ve Node ile tarayıcı arasında tanıdık bir promise API’si istediğimde hâlâ axios kullanırım. Retry, stream veya kutudan çıktığı gibi HTTP/2 gerekiyorsa tercih ettiğim araç got olur. Hangisi stack’inize uyuyorsa onu seçin; hızlı bir script için yerleşikfetchgayet yeterli. - Cheerio: Hızlı, jQuery benzeri HTML ayrıştırıcı. Statik sayfalar için mükemmel—yaklaşık 0.5 saniyede parse eder (Oxylabs).
- Playwright / Puppeteer: Dinamik ve JS ağırlıklı siteler için headless tarayıcı otomasyonu. Daha yavaş olabilir (~sayfa başına 4 saniye), ama içerik sayfa yüklendikten sonra geliyorsa vazgeçilmezdir (Bright Data). 2026’da sıfırdan başlıyorsanız varsayılan tercih Playwright olmalı — çapraz tarayıcı desteği yerleşik gelir (Chromium / Firefox / WebKit), trace viewer içerir ve Puppeteer’ı ilk geliştiren ekip artık Microsoft bünyesinde onu yönetiyor. Puppeteer hâlâ yalnızca Chrome odaklı işler için destekleniyor, ancak sürüm notları bir süredir yeni özelliklerden çok Chrome uyumluluğu güncellemelerine kaymış durumda.
- dotenv: Environment variable yönetimi için.
- csv-writer/jsonfile: Veriyi dışa aktarmak için.
Yaygın Node.js Web Scraping Hatalarından Kaçınmak
Scraper’ların engellenip çöktüğüne ya da sadece dağınık veri kusup bıraktığına kaç kez şahit olduğumu sayamıyorum. Dikkat etmeniz gerekenler:
- robots.txt ve Kullanım Şartlarını göz ardı etmek: Scrape etmeden önce mutlaka kontrol edin. Bunları ihlal etmek IP ban’ine, hatta daha kötüsü hukuki sorunlara yol açabilir (ScraperAPI).
- Sunucuları aşırı yüklemek: İstekleri yağdırmayın. Scraper’ınızı rastgele gecikmelerle (1–3 saniye) yavaşlatın, concurrency kontrolü kullanın ve hiperaktif bir robot gibi davranmaktan kaçının (ScrapeGraphAI).
- Hata yönetmemek: İstekleri her zaman try/catch içine alın, HTTP hatalarını yönetin ve başarısızlıkları loglayın. Geçici hataları exponential backoff ile yeniden deneyin (ScrapeGraphAI).
- İstek başlıklarını unutmak: Gerçekçi User-Agent dizeleri kullanın ve bunları döndürerek değiştirin. Gerçek tarayıcıları taklit etmek için Accept-Language, Referer ve diğer başlıkları ekleyin (ScrapeGraphAI).
Anti-Scraping Mekanizmalarını Nasıl Aşabilirsiniz?
Modern web siteleri anti-bot teknolojileriyle dişine kadar silahlı. Dijital mayınlardan nasıl kaçtığıma bakalım:
- Dönen proxy/IP’ler: Ban’lerden kaçınmak için proxy havuzu kullanın ve IP’leri dönüşümlü değiştirin (Medium).
- Başlıkları rastgeleleştirmek: Her istek için User-Agent, Accept-Language ve diğer başlıkları döndürün.
- Headless browser gizliliği: Otomasyon izlerini gizlemek için
puppeteer-extra-plugin-stealthgibi eklentiler kullanın. - İnsan davranışını taklit etmek: Rastgele gecikmeler, fare hareketleri, kaydırma ve hatta yazım hataları ekleyin (ZenRows).
Node.js Scraper’larda İnsan Davranışını Taklit Etmek
İşin eğlenceli ve biraz da garip kısmı burası. Hemen tıklayıp kaydırmak yerine scraper’ınızı şöyle yazın:
- İşlemler arasında rastgele aralıklar bekleyin (
await page.waitForTimeout(randomDelay)) - Fareyi küçük ve titrek adımlarla hareket ettirin (
page.mouse.move(x, y)) - Rastgele gecikmelerle ve ara sıra yazım hatalarıyla yazın (
page.type(selector, text, {delay: random(100,200)})) - Sadece sona kadar değil, düzensiz biçimde kaydırın
Bu taktikler, korumalı sitelerde başarı oranınızı ciddi biçimde artırabilir (ScraperAPI).
Thunderbit ile Karmaşık Veri Çekmeyi Sadeleştirmek
Herhangi Bir Siteden AI ile Veri Çekin Boilerplate kodu atlayın: Thunderbit’in ajan tabanlı web scraper’ı herhangi bir sayfayı okur ve veriyi tek tıkla çıkarır; bakım gerektiren Node.js kodu yoktur. Get Started Free
Şimdi gelelim odadaki file: scraping zordur. Ama olmak zorunda değil. İşte bu yüzden Thunderbit geliştirdik.
Thunderbit, ajan tabanlı bir web scraper Chrome uzantısıdır ve herhangi bir siteden düz İngilizce kullanarak veri çıkarmanızı sağlar. Sadece “One Click Extract”e tıklayın, AI’nin sayfadaki içeriği anlamasına izin verin ve “Scrape”e basın. Hiç uyumayan ve maaş zammı istemeyen bir junior geliştiriciye sahip olmak gibi.
Dahası, Thunderbit bir API sunar; böylece onu doğrudan Node.js iş akışlarınıza bağlayabilirsiniz. Binlerce satır scraping kodu yazmak yerine, dinamik içerik, alt sayfalar, sayfalama gibi ağır işleri Thunderbit’e bırakabilirsiniz. Siz sadece yapılandırılmış veriyi çekersiniz (CSV, JSON ya da doğrudan Google Sheets, Airtable, Notion’a) ve işinize devam edersiniz (Thunderbit Blog).
Thunderbit Chrome Uzantısını Ücretsiz Deneyin Ücretsiz Chrome uzantısını kurun ve yapılandırılmış veriyi tek tıkla çıkarın — ya da Thunderbit API’sini Node.js uygulamanızdan çağırın. Get Started Free
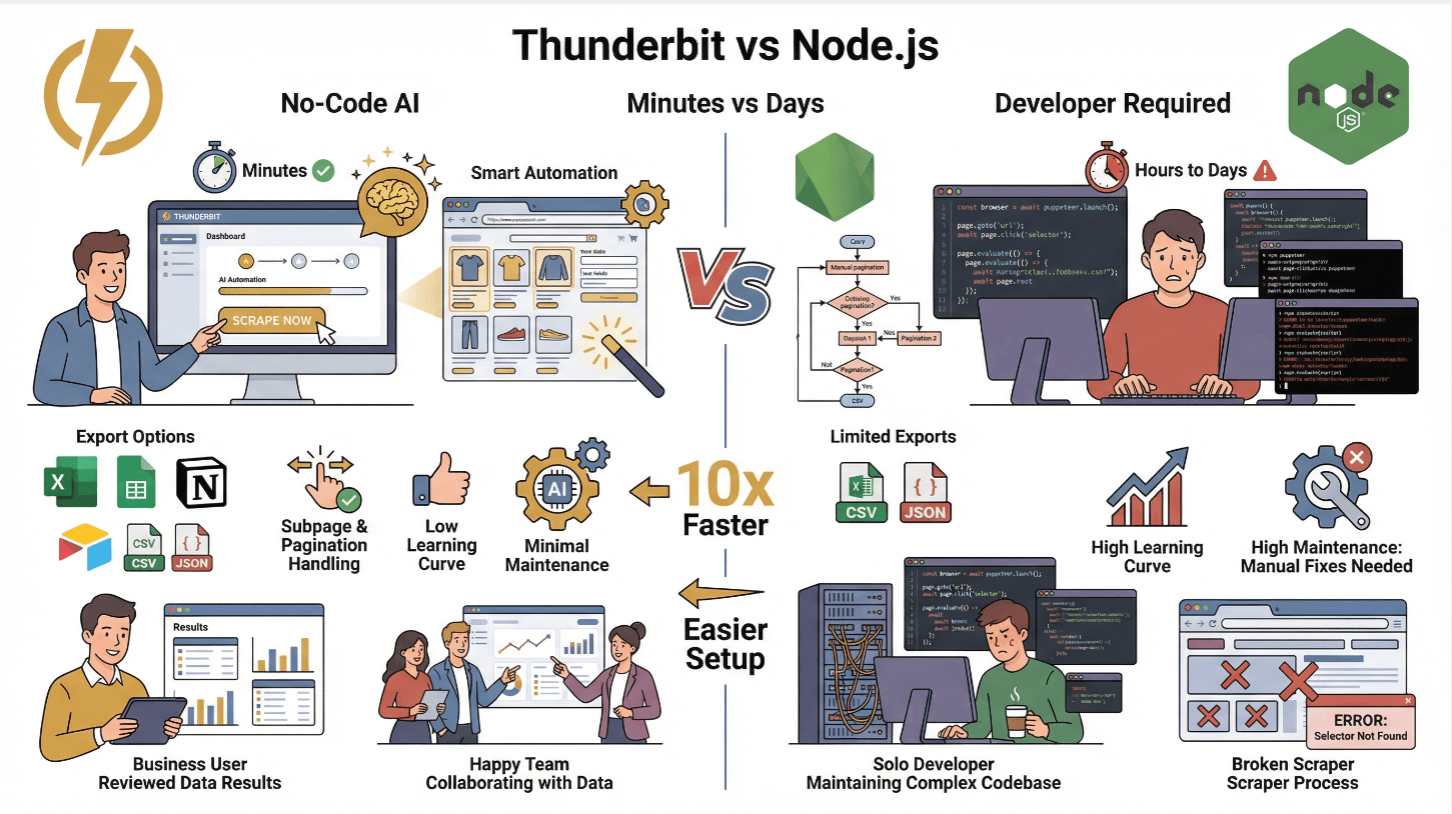
Thunderbit ve Geleneksel Node.js Scraping
| Özellik | Thunderbit | Geleneksel Node.js Scraper |
|---|---|---|
| Kurulum Süresi | Dakikalar (kodsuz) | Saatler ile günler (kodlama, test) |
| Dinamik İçeriği İşleme | Evet (AI + tarayıcı) | Evet (Puppeteer/Playwright ile) |
| Alt Sayfa ve Sayfalama | Tek tık | Manuel kodlama gerekir |
| Veri Dışa Aktarma | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (özel kod) |
| Öğrenme Eğrisi | Düşük (iş kullanıcıları) | Yüksek (geliştiriciler) |
| Bakım | Minimum (AI uyum sağlar) | Yüksek (site değişikliklerinde manuel düzeltme gerekir) |
Thunderbit, teknik olmayan ekipler için ya da ham işleri atlayıp içgörülere odaklanmak isteyen herkes için mükemmeldir. Gelişmiş kullanıcılar için ise Thunderbit API’sini kullanarak scraping sürecini ölçekli biçimde otomatikleştirmek hâlâ mümkündür (Thunderbit Docs).
Dinamik İçerik İçin Cheerio ve Puppeteer’ı Birlikte Kullanmak
Bu, benim en sevdiğim Node.js scraping güç birleşimi. Nasıl çalıştığı şöyle:
- Puppeteer kullanın ve sayfayı yükleyip JavaScript’i çalıştırın (
networkidlegelene kadar bekleyerek tüm içeriğin yüklendiğinden emin olun). - HTML’i alın:
await page.content()ile sayfanın HTML’ini çekin. - Cheerio ile parse edin: HTML’i Cheerio’ya verin; ultra hızlı, jQuery tarzı ayrıştırma ve veri çıkarma işlemi yapın.
Bu hibrit yaklaşım size iki dünyanın en iyisini verir: dinamik içerik için Puppeteer’ın gücü, parse işlemi için Cheerio’nun hızı (Browserless).
Performans ipucu: Sadece ihtiyacınız olan öğeleri seçin. Cheerio tüm DOM’u belleğe yükler, bu yüzden geniş seçimlerden kaçının ve aynı sayfaları tekrar tekrar çekiyorsanız sonuçları önbelleğe alın (Oxylabs).
HTML Ayrıştırma ve Veri Çıkarmayı Optimize Etmek
- Belirgin selector’lar kullanın:
$('body *')gibi aşırı geniş seçimlerden kaçının; sadece gereken alanları hedefleyin. - Büyük sayfaları stream edin: Çok büyük HTML’lerde stream yaklaşımını veya işi parçalara bölmeyi düşünün.
- Render edilmiş HTML’i önbelleğe alın: URL’leri tekrar ziyaret ediyorsanız, gereksiz istekleri önlemek için HTML’i cache’leyin.
- Veriyi doğrulayın ve temizleyin: Veritabanınızı çöple doldurmamak için doğrulama kütüphaneleri kullanın (ScrapeGraphAI).
Bulutta Ölçeklenebilir Node.js Web Scraper Dağıtımı
Büyük ölçekte scraping mi yapıyorsunuz? Artık cloud-native düşünmenin zamanı geldi.
- Scraper’ınızı Docker’a alın: Bir
Dockerfileyazın, kodunuzu kopyalayın, bağımlılıkları kurun ve giriş noktasını ayarlayın. - Buluta dağıtın: Basit işler için AWS EC2, Google Cloud Compute veya Azure VM’leri kullanın. Ciddi ölçek için Kubernetes ya da AWS ECS/EKS, Google Cloud Run veya Azure Kubernetes Service gibi yönetilen servisleri tercih edin (DigitalOcean).
- Kubernetes ile orkestrasyon: Birden fazla pod çalıştırın, talebe göre otomatik ölçeklendirin ve URL’leri dağıtmak için load balancer kullanın.
- İşleri zamanlayın: Belirli aralıklarla scrape tetiklemek için cloud scheduler’lar (CloudWatch Events, Cloud Scheduler) veya cron job’ları kullanın.
Gerçek dünyadan bir örnekte, Kubernetes pod sayısını 5’ten 10’a çıkarmak 400 sayfalık bir scrape’i dakikalardan bir dakikanın altına indirdi (DigitalOcean).
Scraping Altyapısını İzleme ve Otomatik Ölçeklendirme
- Loglama: Logları CloudWatch, Stackdriver veya Datadog’a aktarın. Hatalar ve yavaşlamalar için uyarılar kurun.
- Sağlık kontrolleri: Dakikada taranan sayfa sayısı, hata oranları ve pod sağlığı gibi metrikler için Prometheus ve Grafana kullanın.
- Otomatik ölçeklendirme: CPU veya istek sayısına göre pod ölçeklemek için Kubernetes HPA (Horizontal Pod Autoscaler) kurun.
Ağ sorunlarından veya geçici ban’lerden toparlanmak için her zaman exponential backoff ile yeniden deneme mekanizması ekleyin.
Veri Depolama ve Son İşleme İçin En İyi Uygulamalar
Veriyi çektikten sonra onu saklamanız ve temizlemeniz gerekir:
- Küçük işler: CSV, JSON olarak dışa aktarın veya Google Sheets, Airtable ya da Notion’a gönderin (Thunderbit bunu hazır şekilde sunar).
- Büyük işler: Yapılandırılmış veriler için SQL (MySQL/PostgreSQL), yarı yapılandırılmış veya değişken şemalar için NoSQL (MongoDB, DynamoDB) kullanın (ScrapeHero).
- Bulut depolama: Ham dosyalar ve yedekler için S3 veya Google Cloud Storage kullanın.
- Veri temizleme: Alanları her zaman doğrulayın, formatları standartlaştırın (tarihler, sayılar) ve tekrar eden kayıtları temizleyin. Veri kalitesini korumak için şema doğrulayıcıları kullanın (ScrapeGraphAI).
Ham veriyi de temizlenmiş veriyi de saklayın—yeniden işleme ya da hata ayıklama gerektiğinde işinize yarayacağını asla bilemezsiniz.
Sonuç: Node.js Web Scraping Verimliliği İçin Ana Çıkarımlar
Scraper Kodunu Atlayın Thunderbit’in ajan tabanlı web scraper’ının, kendi scraping script’lerinizi yazıp sürdürmeye kıyasla nasıl fark yarattığını görün. Get Started Free
Özetleyelim:
- Node.js’in async gücünden yararlanın; özellikle JS ağırlıklı sitelerde yüksek eşzamanlılıkla scraping için idealdir.
- Doğru araçları birleştirin: İstekler için axios/got, statik HTML için Cheerio, dinamik içerik için Puppeteer kullanın; hız ve esnekliği bir araya getirin.
- Bot karşıtı tuzaklardan kaçının: Proxy ve header’ları döndürün, insan davranışını taklit edin ve robots.txt’ye saygı gösterin.
- Thunderbit ile sadeleştirin: İş kullanıcıları veya hızlı prototipleme için Thunderbit, AI ile karmaşık verileri çıkarmanıza ve API üzerinden Node.js stack’inize bağlamanıza olanak tanır.
- Ölçekli dağıtım yapın: Docker kullanın, Kubernetes ile orkestrasyon kurun ve güvenilirlik için her şeyi izleyin.
- Verinizi saklayın ve temizleyin: İhtiyacınıza uygun depolamayı seçin ve kullanmadan önce mutlaka doğrulayın.
Web daha kolay olmayacak; ama bu en iyi uygulamalarla Node.js scraper’larınız hızlı, güvenilir ve bot karşıtı silah yarışında bir adım önde kalabilir. Ve eğer 2’de selector debug etmekten yorulursanız, şunu hatırlayın: Thunderbit’in AI’si her zaman uyanıktır.
Daha fazla öğrenmek ister misiniz? Daha derin içerikler için Thunderbit Blog sayfasına göz atın ya da scraping’in ne kadar kolay olabileceğini görmek için Thunderbit’in Chrome Uzantısını deneyin.
Thunderbit Ajan Tabanlı Web Scraper ile Veri Çekin Thunderbit’in Web Scraper API’si, ücretsiz başlangıç planıyla kendi Node.js kodunuzdan veri çıkarmayı tetiklemenizi sağlar. Get Started Free
SSS
1. Node.js neden 2025’te web scraping için özellikle iyi?
Node.js’in asenkron ve event-driven modeli, binlerce eşzamanlı isteği yönetmesine olanak tanır; bu da onu büyük hacimli veri çekme veya gerçek zamanlı güncellemeler için ideal hale getirir. Dev npm ekosistemi ve yerleşik JavaScript desteği, modern ve JS ağırlıklı siteler için mükemmeldir (Node.js Docs).
2. Node.js ile scraping yaparken engellenmekten nasıl kaçınırım?
Dönen proxy’ler kullanın, istek başlıklarını rastgeleleştirin, isteklere rastgele gecikmeler ekleyerek hızınızı sınırlayın ve Puppeteer gibi araçlarla insan davranışını taklit edin (fare hareketi, kaydırma, yazma). Her zaman robots.txt ve sitenin kullanım şartlarına uyun (Medium).
3. Node.js scraper’ımda Cheerio ile Puppeteer’ı ne zaman kullanmalıyım?
Veri ham HTML içinde yer alıyorsa, statik HTML’i hızlıca parse etmek için Cheerio kullanın. JavaScript ile dinamik olarak yüklenen siteler için Puppeteer tercih edin. En iyi sonuç için önce Puppeteer ile sayfayı render edin, ardından HTML’i Cheerio ile ayrıştırın (Bright Data).
4. Thunderbit Node.js web scraping’i nasıl kolaylaştırır?
Thunderbit, herhangi bir siteden AI ve doğal dil komutlarıyla yapılandırılmış veri çıkarmanızı sağlar—kod yazmanız gerekmez. Dinamik içerik, alt sayfalar ve sayfalama işlemlerini yönetir; Node.js entegrasyonu için API sunar. Veriler doğrudan Excel, Google Sheets, Airtable veya Notion’a aktarılabilir (Thunderbit Blog).
5. Node.js scraper’ları bulutta ölçeklemek ve izlemek için en iyi yöntem nedir?
Scraper’ınızı Docker’a alın, Kubernetes veya yönetilen bulut servislerine dağıtın ve ani trafik artışlarını yönetmek için auto-scaling kullanın. Logları ve metrikleri CloudWatch veya Prometheus gibi araçlarla izleyin ve hatalar ya da yavaşlamalar için uyarılar kurun (DigitalOcean).
Web scraping seviyenizi yükseltmeye hazır mısınız? Thunderbit’i deneyin; scraper’larınız hızlı, gizli ve her zaman bir adım önde olsun.
Ajan Tabanlı Web Scraper’ı Deneyin Get Started Free
Daha Fazla Bilgi
- Yeni Başlayanlar İçin Node Web Scraping’i Ustalaşma: Adım Adım Rehber
- En İyi Araçlarla Web Sitesi Verisini Verimli Şekilde Nasıl Çekersiniz
- Bir Web Sitesi Verimli Şekilde Nasıl Tarama Yapılır: Adım Adım Rehber
- JavaScript Crawling’de Ustalaşma: Yeni Başlayanlar İçin Rehber
- 2026’da Fiyat Karşılaştırması İçin Web Scraping’de Ustalaşma




