
Thunderbit คือส่วนขยาย Chrome สำหรับ AI Web Scraper ที่ช่วยให้ฝั่งธุรกิจดึงข้อมูลจากเว็บไซต์ได้ด้วย AI แกนหลักของเรื่องนี้คือ: สิ่งที่ดูเหมือนคุ้มค่าบนหน้าราคา ScrapingBee อาจเปลี่ยนไปแบบหน้ามือเป็นหลังมือเมื่อเริ่มใช้จริงในระดับโปรดักชัน แล้วเห็นเครดิตไหลหายไปในอัตรา 5× ถึง 75× ของเรตราคาเริ่มต้น บทความรีวิวนี้จะพาไปดู 5 มุมที่บทความส่วนใหญ่มักมองข้าม ได้แก่ ต้นทุนจริงเมื่อสเกลใหญ่ขึ้น, การดึงข้อมูลแบบใช้ selector เทียบกับ AI, ความง่ายในการใช้งานสำหรับคนไม่เขียนโค้ด, เวิร์กโฟลว์จัดการข้อมูลหลังการสแครป และเกณฑ์ความเสถียรในปี 2026 ถ้าคุณกำลังประเมิน ScrapingBee สำหรับทีมของคุณ — ไม่ว่าคุณจะเป็นนักพัฒนา, หัวหน้าฝ่าย sales ops หรือผู้ก่อตั้ง — นี่คือภาพรวมที่คุณควรอ่านให้จบ
ScrapingBee คืออะไร? ภาพรวมแบบเร็ว
ScrapingBee คือ API สำหรับเว็บสแครปที่ช่วยจัดการเรื่อง proxy rotation, การเรนเดอร์ JavaScript และการแก้ CAPTCHA ให้กับนักพัฒนา เพื่อให้ดึงข้อมูลจากเว็บไซต์ได้โดยไม่ต้องไปสร้างโครงสร้างสแครปเองทั้งหมด แค่ส่ง HTTP request พร้อมพารามิเตอร์ ระบบก็จะส่ง HTML กลับมาให้ (หรือ JSON สำหรับบาง endpoint) มันไม่มีหน้าตาแบบ visual หรือ interface แบบคลิกสร้างงานสแครป
ความสามารถหลักมีดังนี้:
- Rotating และ premium proxies (classic, premium, stealth, residential)
- Headless browser rendering (ใช้ Chrome แบบเต็มรูปแบบ เปิดเป็นค่าเริ่มต้น)
- บายพาส CAPTCHA อัตโนมัติ
- Google Search API (JSON แบบมีโครงสร้าง: organic results, ads, maps, knowledge graph, People Also Ask, images, news)
- จับภาพหน้าจอ (แบบมาตรฐาน, เต็มหน้า, หรือกำหนดด้วย CSS selector)
- กำหนดภูมิภาคเป้าหมาย ผ่านพารามิเตอร์ country_code
- กฎการดึงข้อมูลด้วย CSS/XPath (กำหนดแบบ declarative ผ่าน JSON และส่งออกเป็น structured JSON)
- API เฉพาะทาง สำหรับการสแครป Amazon, Walmart, YouTube และ ChatGPT
- AI extraction (เพิ่มเข้ามาราวปี 2024–2025): พารามิเตอร์ ai_query, ai_extract_rules, ai_selector (+5 credits ต่อ request)
- CLI tool (เปิดตัวราวปี 2025–2026): ประมวลผลแบบแบตช์, crawling, แยก sitemap, เติมข้อมูลให้ CSV, ตั้ง cron job, เพิ่มระดับ proxy
ScrapingBee ก่อตั้งในปี 2019 ที่ฝรั่งเศส และเติบโตจนมีรายได้ราว $5 million ARR ภายในต้นปี 2026 พร้อมลูกค้ามากกว่า 2,500 ราย (SAP, Zapier, Deloitte, Zillow) — ทั้งหมดนี้ทำแบบ bootstrapped ด้วยทีมแค่ 4–6 คน ในเดือนมิถุนายน 2025 Oxylabs Group ได้เข้าซื้อ ScrapingBee ด้วยดีลระดับแปดหลัก แบรนด์และผู้นำยังคงแยกอิสระจากกัน และทีมซัพพอร์ต เพิ่มขึ้นมากกว่าสองเท่า เพื่อรองรับหลายเขตเวลาได้ดีขึ้น
อีกจุดที่ต้องรู้คือ ScrapingBee ยัง ไม่มี visual builder แบบเนทีฟ, GUI แบบ point-and-click หรือ scheduler บนเว็บแดชบอร์ดในตัว การตั้งเวลาต้องใช้ CLI tool, cron jobs หรือระบบอัตโนมัติของบุคคลที่สาม (Zapier, Make, n8n) คู่มือ "no-code" ที่เขาเผยแพร่จริง ๆ แล้วหมายถึงการใช้ Make และ Zapier integrations — ไม่ใช่หน้าจอ no-code แบบมีให้ในตัว
ScrapingBee ถูกสร้างมาสำหรับใครกันแน่?
ScrapingBee ออกแบบมาสำหรับนักพัฒนาที่คล่องกับ Python หรือ cURL, อ่าน HTML ได้ และเขียน CSS/XPath selectors ได้ เอกสารประกอบค่อนข้างเอนเอียงไปทางโค้ด โดยมักยกตัวอย่างด้วย Python และ cURL เป็นหลัก ผู้รีวิวคนหนึ่งบน Capterra บอกว่าพวกเขา "ไม่ค่อยมีตัวอย่างใน JavaScript" และอีกคนบอกว่าเอกสาร "เยอะและหนา อ่านตั้งแต่วันเดียวไปจนถึงเป็นสัปดาห์"
แต่กลุ่มคนที่ค้นหา "ScrapingBee review" ในปี 2026 ไม่ได้มีแค่วิศวกรฝั่ง backend มันยังรวมถึงผู้จัดการฝ่ายการตลาดที่กำลังปั้นรายชื่อ lead, ทีม sales ops ที่กำลังเพิ่มคุณภาพข้อมูลใน CRM, ทีม ecommerce ops ที่คอยจับตาราคาคู่แข่ง และผู้ก่อตั้งที่กำลังเลือกเครื่องมือให้ทีมตัวเอง ในแต่ละหัวข้อด้านล่าง ผมจะบอกให้ชัดว่า feature หรือข้อจำกัดนั้นสำคัญกับนักพัฒนา, ผู้ใช้งานธุรกิจ หรือทั้งสองฝั่ง
แพ็กเกจราคา ScrapingBee แบบดูง่าย ๆ
นี่คือแพ็กเกจปัจจุบันของ ScrapingBee (ณ เมษายน 2026):
| แพ็กเกจ | ราคา/เดือน | API Credits/เดือน | คำขอพร้อมกัน |
|---|---|---|---|
| Freelance | $49 | 250,000 | 10 |
| Startup | $99 | 1,000,000 | 50 |
| Business | $249 | 3,000,000 | 100 |
| Business+ | $599 | 8,000,000 | 200 |
| Enterprise | ติดต่อฝ่ายขาย | 41M+ | กำหนดเอง |
ถ้าชำระรายปีจะได้ ส่วนลด 17% และมีทดลองใช้ฟรี 1,000 API credits โดยไม่ต้องใช้บัตรเครดิต ส่วน Google Search API เพิ่งถูก ปรับลดจาก 25 เหลือ 15 credits ต่อครั้งหลังการเข้าซื้อ
ตัวเลขเครดิตบนหน้าราคาดูน่าดึงดูดก็จริง แต่ความจริงไม่ได้ง่ายแบบนั้น
ตารางตัวคูณเครดิต
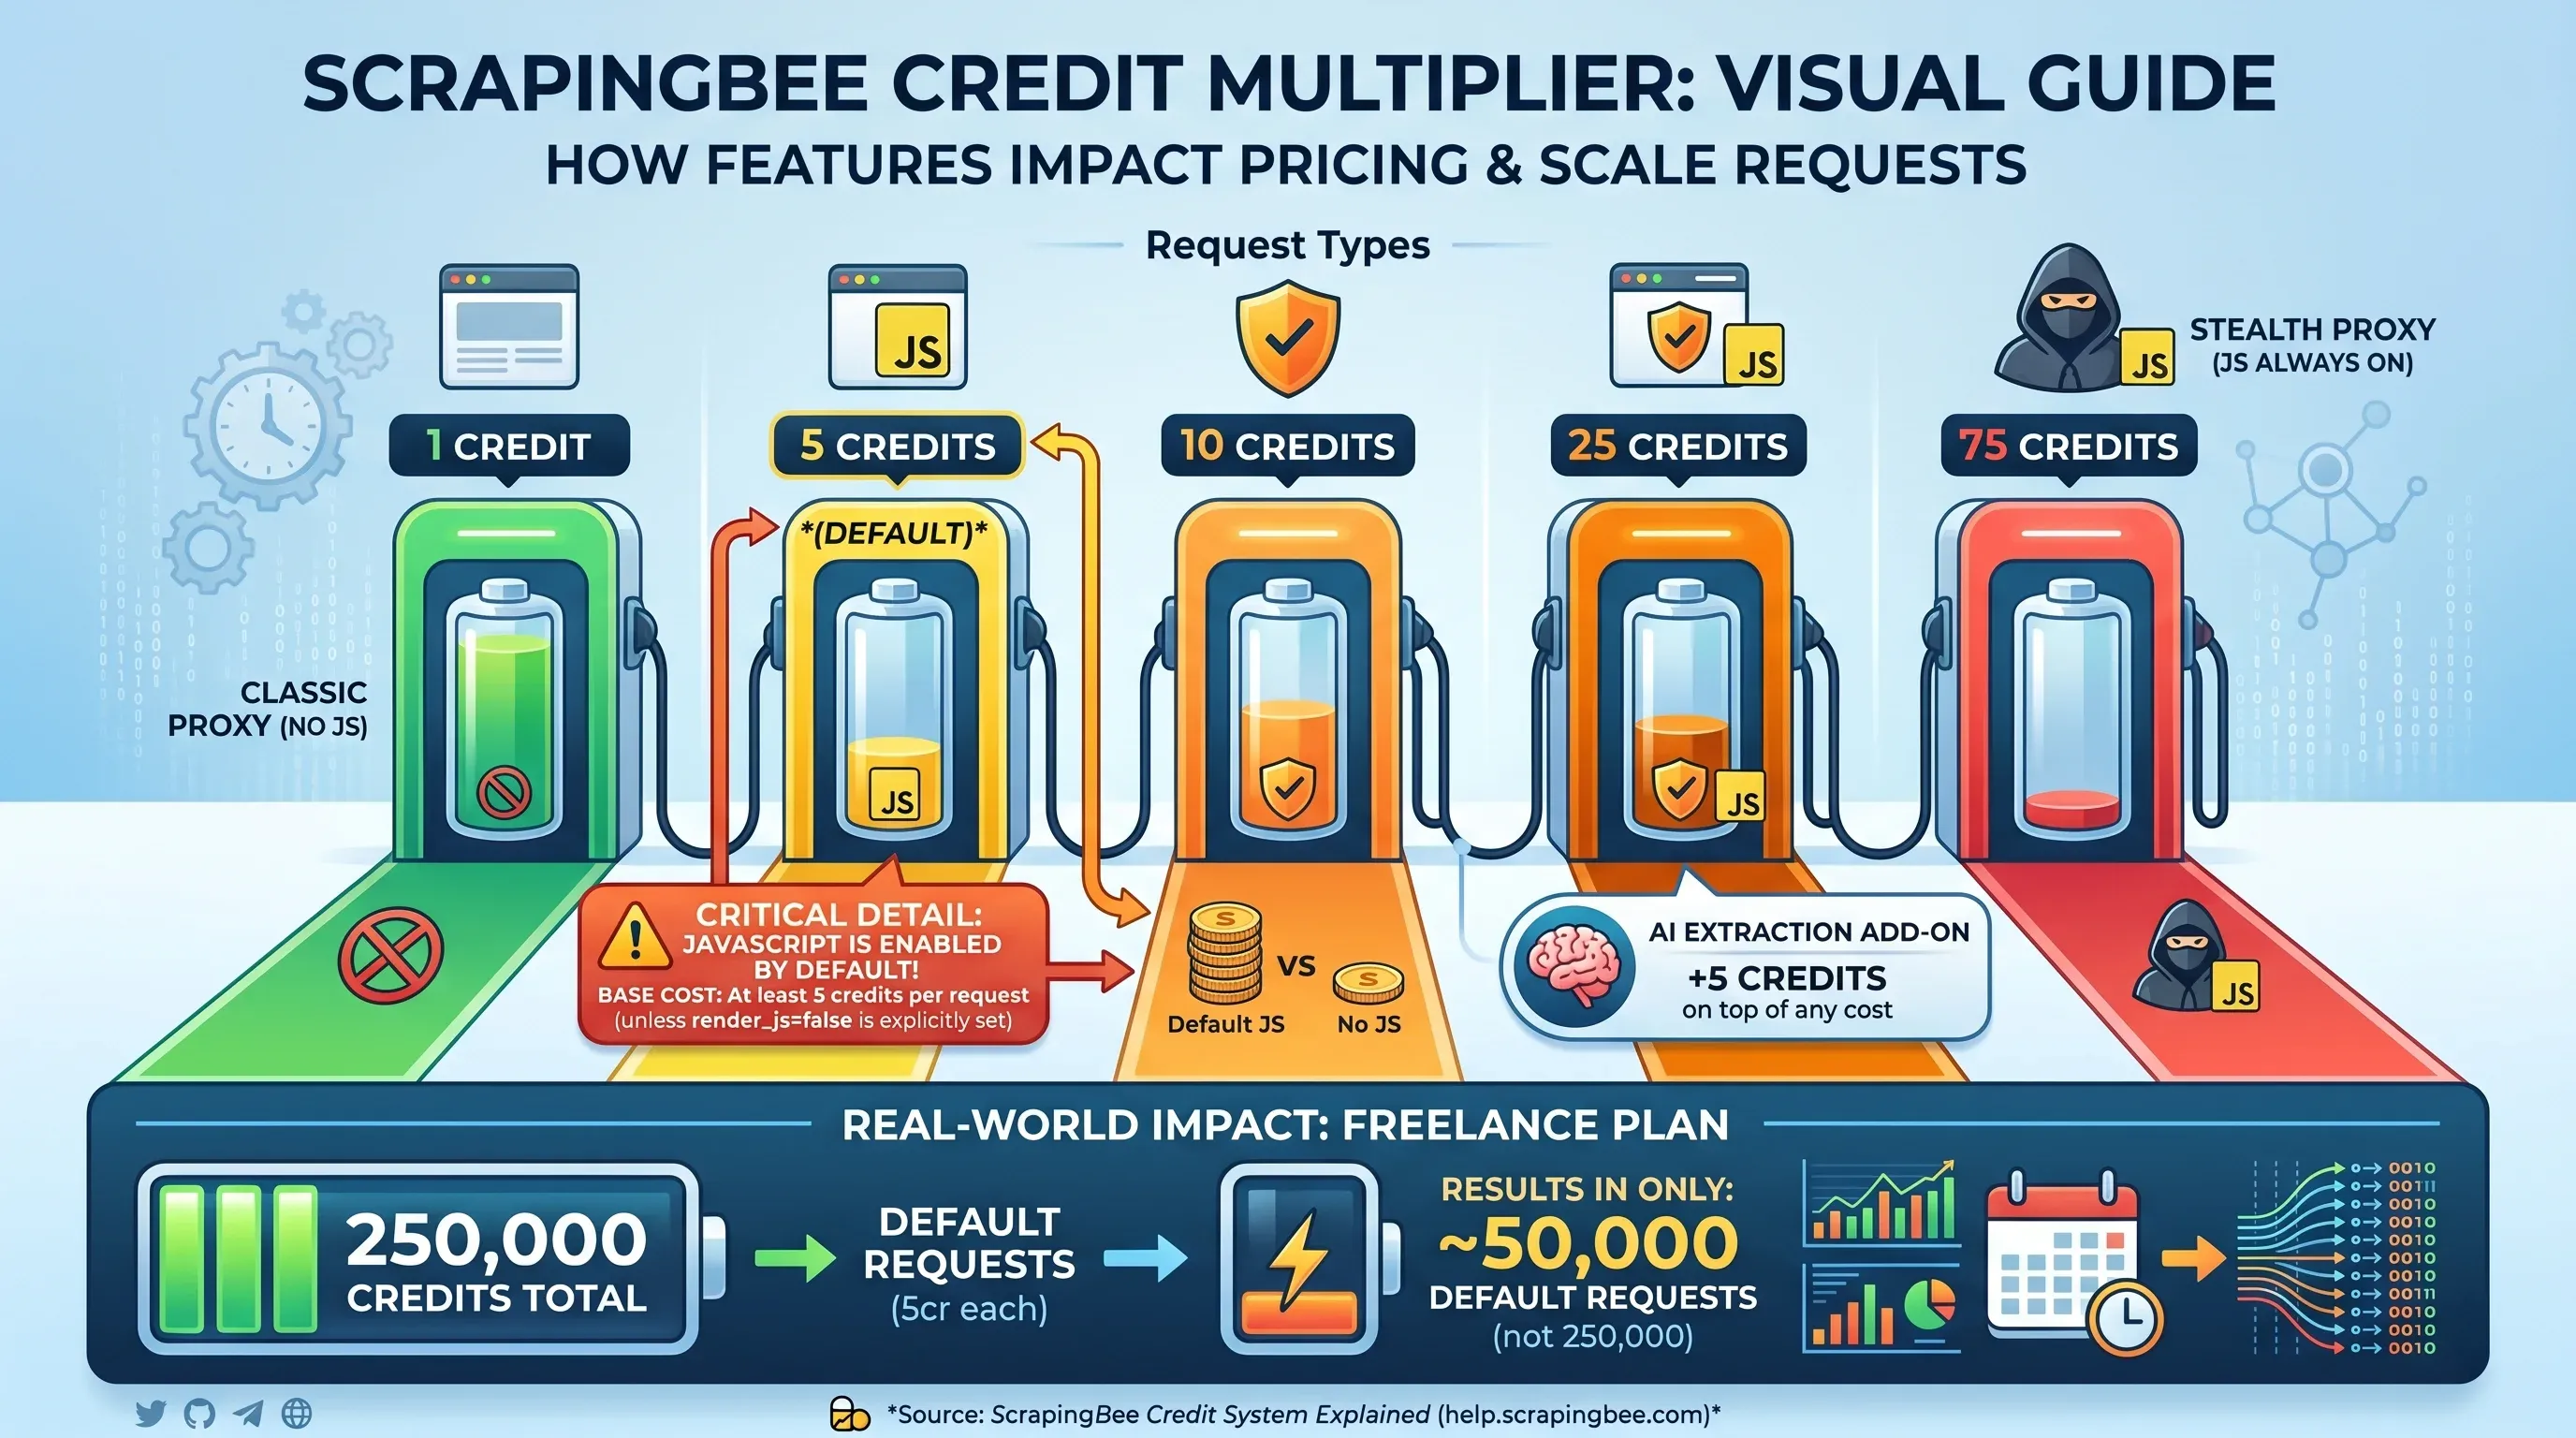
ตรงนี้แหละที่ราคา ScrapingBee เริ่มซับซ้อน จำนวนเครดิตที่โชว์ไม่ใช่จำนวนหน้าที่คุณสแครปได้จริง — มันขึ้นอยู่กับฟีเจอร์ที่เปิดใช้ในแต่ละ request:
| ประเภทคำขอ | เครดิตต่อคำขอ |
|---|---|
Classic proxy, ไม่เรนเดอร์ JS (render_js=false) | 1 credit |
| Classic proxy, เรนเดอร์ JS (ค่าเริ่มต้น) | 5 credits |
| Premium proxy, ไม่เรนเดอร์ JS | 10 credits |
| Premium proxy, เรนเดอร์ JS | 25 credits |
| Stealth proxy (เปิด JS ตลอด) | 75 credits |
| AI extraction add-on | +5 credits เพิ่มจากเดิม |
จุดสำคัญ: การเรนเดอร์ JavaScript ถูก เปิดเป็นค่าเริ่มต้น ถ้าคุณไม่ตั้ง render_js=false เอง ทุก request จะเสียอย่างน้อย 5 credits เท่ากับว่าแพ็กเกจ Freelance ที่มี 250,000 credits จริง ๆ แล้วรองรับได้แค่ 50,000 requests แบบค่าเริ่มต้น — ไม่ใช่ 250,000
คณิตศาสตร์เครดิตแฝงที่ไม่มีใครโชว์ให้ดู
นี่คือต้นทุนจริงของ ScrapingBee สำหรับ 10,000 หน้า ในหลายสถานการณ์และหลายแพ็กเกจ:
| สถานการณ์ | เครดิตที่ต้องใช้ | Freelance ($49/250K) | Startup ($99/1M) | Business ($249/3M) |
|---|---|---|---|---|
| 10K หน้า (HTML ธรรมดา, 1 cr) | 10,000 | ✅ ครอบคลุม ($0.20/1K) | ✅ ครอบคลุม ($0.10/1K) | ✅ ครอบคลุม ($0.08/1K) |
| 10K หน้า (JS render, 5 cr) | 50,000 | ✅ ครอบคลุม ($0.98/1K) | ✅ ครอบคลุม ($0.50/1K) | ✅ ครอบคลุม ($0.42/1K) |
| 10K หน้า (premium proxy + JS, 25 cr) | 250,000 | ⚠️ เต็มโควตาพอดี ($4.90/1K) | ✅ ครอบคลุม ($2.48/1K) | ✅ ครอบคลุม ($2.08/1K) |
| 10K หน้า (stealth proxy, 75 cr) | 750,000 | ❌ เกินโควตาไปมาก | ✅ พอครอบคลุม ($7.43/1K) | ✅ ครอบคลุม ($6.23/1K) |
หน้า 10,000 หน้าเดียวกันอาจมีต้นทุนตั้งแต่ $0.20 ถึง $7.43 ต่อหนึ่งพันหน้า แล้วแต่ proxy และการตั้งค่า rendering และคุณอาจไม่รู้ด้วยซ้ำว่าต้องใช้คอนฟิกแบบไหนจนกว่าจะลองจริง
สถานการณ์งบประมาณ: Lead generation ที่ 10,000 หน้า/เดือน
ทีมขายสแครปหน้าเว็บบริษัท 10,000 หน้า/เดือนเพื่อสร้าง lead เว็บไซต์ B2B สมัยใหม่จำนวนมากใช้ React หรือ Vue ดังนั้นจึงต้องใช้ JS rendering:
- เครดิตที่ต้องใช้: 50,000 (10K × 5 credits)
- แพ็กเกจ Freelance ($49): ครอบคลุมได้ และยังเหลืออีก 200K credits
- แต่ถ้าเป้าหมายต้องใช้ premium proxies: 250,000 credits — เท่ากับโควตาของ Freelance พอดี ไม่มี buffer
- ถ้าต้องใช้ stealth proxies: 750,000 credits — ต้องใช้แพ็กเกจ Startup ราคา $99/เดือน
สถานการณ์งบประมาณ: ติดตามราคาสินค้า ecommerce ที่ 100,000 หน้า/เดือน
ทีม ecommerce ติดตามสินค้า 100,000 หน้า บนเว็บไซต์คู่แข่ง:
| คอนฟิก | เครดิตที่ต้องใช้ | แพ็กเกจที่ต้องมี | ค่าใช้จ่าย/เดือน |
|---|---|---|---|
| HTML ธรรมดา (1 cr) | 100,000 | Freelance | $49 |
| JS rendering (5 cr) | 500,000 | Startup | $99 |
| Premium proxy + JS (25 cr) | 2,500,000 | Business | $249 |
| Stealth proxy (75 cr) | 7,500,000 | Business+ | $599 |
งานเดียวกันอาจมีราคาตั้งแต่ $49 ถึง $599 ต่อเดือน นี่ไม่ใช่ความต่างเล็ก ๆ แต่เป็นช่องว่างต้นทุน 12 เท่าจากคอนฟิกที่ต่างกัน
"ราคาเริ่มต้น $49 คือเลขที่ชวนเข้าใจผิดที่สุดในตลาด API สำหรับการสแครป" — Prospeo
"เครดิตถูกใช้หมดเร็วเมื่อใช้ JavaScript rendering หรือฟีเจอร์ขั้นสูง ทำให้ยากจะคุ้มค่าสำหรับโปรเจกต์เล็ก ๆ หรือทีมที่คาดเดาปริมาณสแครปไม่ได้" — Nick S, Manager, Computer Software, Capterra
และเครดิตที่ไม่ได้ใช้จะ ไม่ถูกยกยอดไปเดือนถัดไป
ต้นทุนของ ScrapingBee เทียบกับคู่แข่ง
ใช้แพ็กเกจระดับกลางเพื่อการเปรียบเทียบที่ยุติธรรม:
| สถานการณ์ (ต่อ 1K หน้า) | ScrapingBee ($99/1M) | ScraperAPI ($149/1M) | Scrapfly ($100/1M) |
|---|---|---|---|
| HTML ธรรมดา | $0.10 | $0.15 | $0.10 |
| หน้าที่ต้องเรนเดอร์ JS | $0.50 | $1.64 | $0.60 |
| Premium + JS | $2.48 | $3.73 | $3.00 |
| Stealth/ultra premium + JS | $7.43 | $11.18 | N/A |
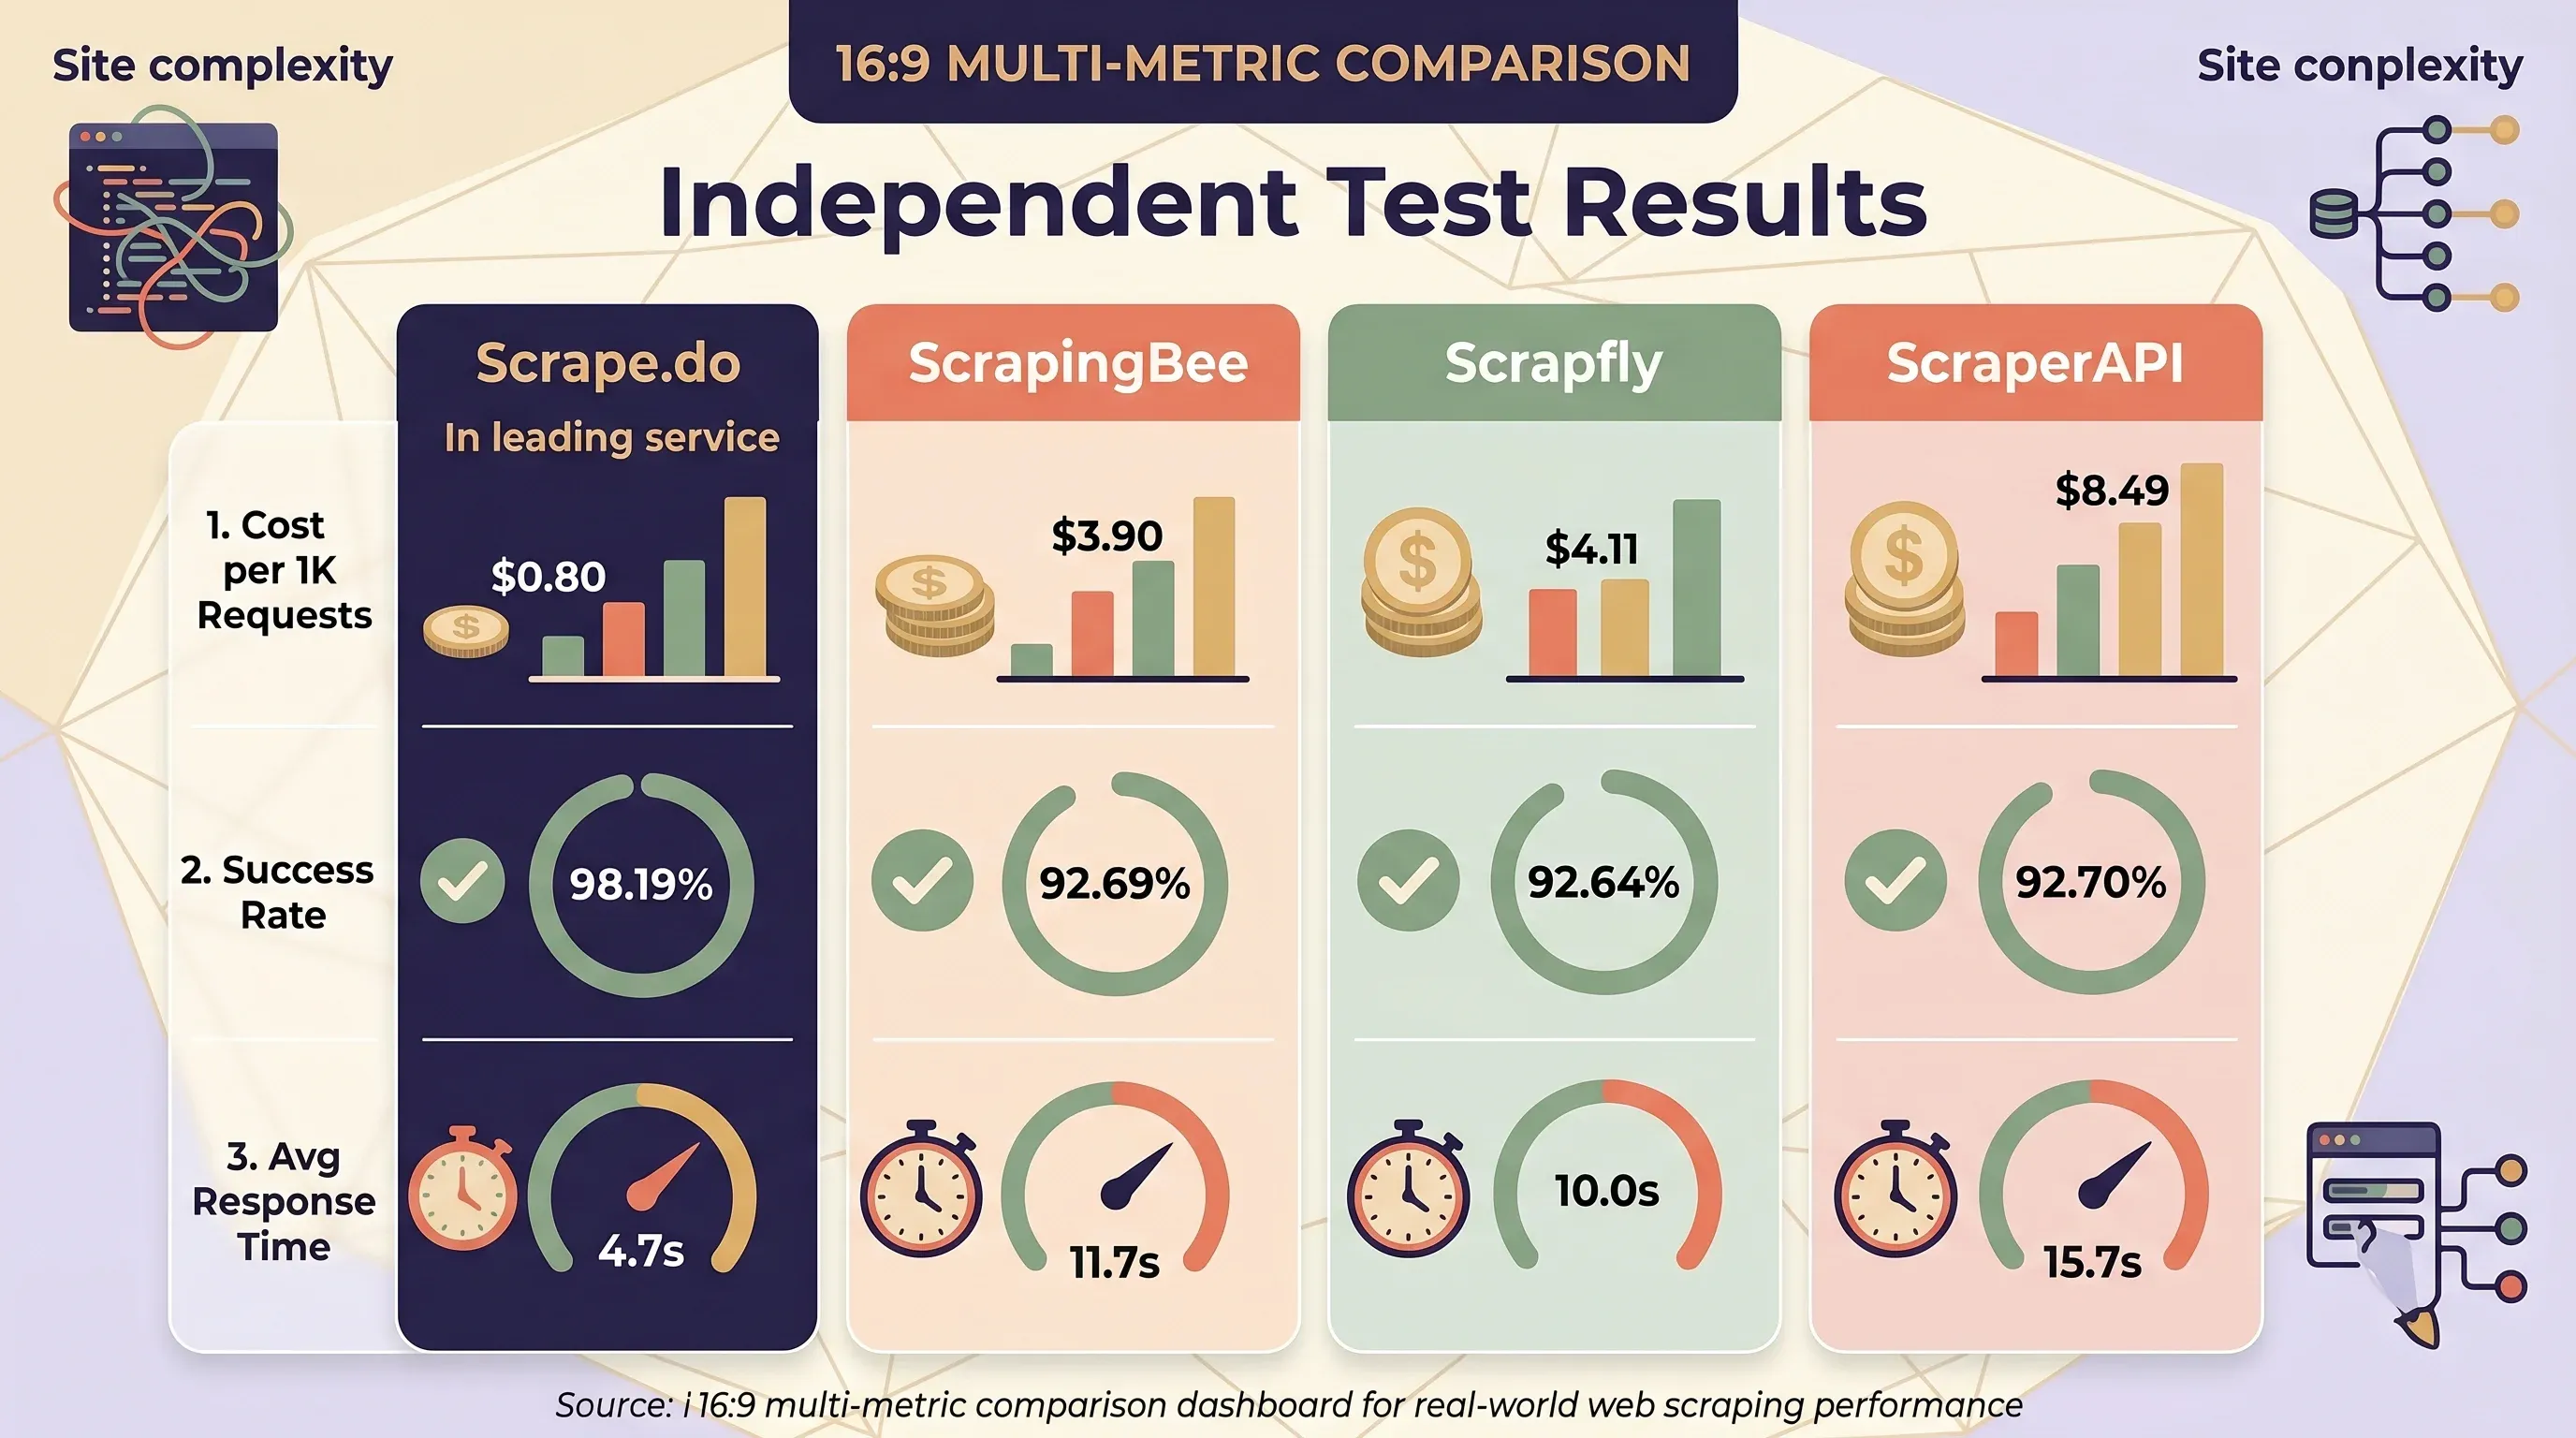
โดยรวมแล้ว ScrapingBee มักจะถูกที่สุดหรือราคาใกล้เคียงถูกที่สุดสำหรับหน้าแบบ static และหน้าแบบ JS-rendered ScraperAPI มักจะมีราคาสูงที่สุดอย่างสม่ำเสมอ — เพราะค่า JS rendering ของเขาคิดเพิ่ม +10 credits เทียบกับ +5 ของทั้ง ScrapingBee และ Scrapfly แต่การทดสอบอิสระจาก Scrape.do ให้ภาพอีกแบบเมื่อมองจากความซับซ้อนของเว็บไซต์จริง:
| บริการ | ต้นทุนเฉลี่ยต่อ 1K requests | อัตราความสำเร็จ | เวลาตอบสนองเฉลี่ย |
|---|---|---|---|
| Scrape.do | $0.80 | 98.19% | 4.7s |
| ScrapingBee | $3.90 | 92.69% | 11.7s |
| Scrapfly | $4.11 | — | — |
| ZenRows | $4.48 | 92.64% | 10.0s |
| ScraperAPI | $8.49 | 92.70% | 15.7s |
โมเดลเครดิตของ Thunderbit: คนละแนวทาง
Thunderbit ใช้โมเดลราคาที่เรียบง่ายกว่ามาก: 1 credit = 1 แถวผลลัพธ์ ไม่มีตัวคูณตาม JS rendering, ประเภท proxy หรือโดเมนเป้าหมาย การสแครป subpage คิด 2 credits ต่อแถว
| แพ็กเกจ | ราคา/เดือน | เครดิต | ต้นทุนต่อแถว |
|---|---|---|---|
| Free | $0 | 6 pages/month | ฟรี |
| Starter | $15 | 500 | $0.030 |
| Pro 1 | $38 | 3,000 | $0.013 |
| Pro 2 | $75 | 6,000 | $0.013 |
| Pro 3 | $125 | 10,000 | $0.013 |
| Pro 4 | $249 | 20,000 | $0.012 |
ผู้ใช้ Thunderbit ที่สแครปสินค้าจำนวน 10,000 รายการจากเว็บไซต์ ecommerce ที่พึ่งพา JS หนัก ๆ จะจ่าย $125/เดือน ไม่ว่าเว็บนั้นจะต้องใช้ JavaScript rendering, premium proxies หรือการบายพาส anti-bot หรือไม่ก็ตาม ส่วน ScrapingBee งานเดียวกันอาจมีค่าใช้จ่ายตั้งแต่ $49 ถึง $599 ตามคอนฟิก ความแน่นอนด้านงบประมาณเป็นเรื่องที่จับต้องได้จริง
CSS Selectors เทียบกับ AI Extraction: ต้นทุนการดูแลที่คุณควรรู้
รีวิว ScrapingBee ส่วนใหญ่มักข้ามประเด็นนี้ไป ทั้งที่จริงแล้วนี่อาจเป็นข้อพิจารณาที่สำคัญที่สุดสำหรับใครก็ตามที่ตั้งใจจะสแครประยะยาวเป็นเดือนหรือเป็นปี
ScrapingBee ใช้ CSS/XPath selectors ในการดึงข้อมูลจาก HTML คุณจะกำหนดกฎการดึงข้อมูลเป็น JSON objects ที่ระบุ CSS selectors แล้ว ScrapingBee จะคืนข้อมูลที่ตรงกัน ฟังดูดีในช่วงแรก ปัญหาคือสิ่งที่ตามมาต่างหาก
ปัญหา selectors พัง
เมื่อเว็บไซต์เป้าหมายเปลี่ยนเลย์เอาต์ — class names, โครงสร้าง DOM, เวอร์ชันของ framework — CSS selectors ของคุณก็พัง งานวิจัยในระบบสแครปที่โตเต็มที่และรันงานกว่า 2,500 งาน active job ชี้ว่าเกิดอัตราพัง 1–2% ต่อสัปดาห์ ต้องแก้ 30–35 จุดต่อสัปดาห์แค่เพื่อให้ extractor ยังทำงานได้ สำหรับองค์กรที่สแครป 50 เว็บไซต์ ภาระดูแลรายปีอยู่ที่ 850–1,300 ชั่วโมง คิดเป็นต้นทุน $64,000–$156,000 ตามอัตราค่าแรงวิศวกรแบบเต็มต้นทุน
ทีมมักประเมินต่ำกว่าความจริงเสมอ โดยทั่วไปมักคาดว่าใช้เวลา maintenance 10–15 ชั่วโมง/เดือน แต่ความจริงมักสูงกว่า 4–6 เท่า (40–90 ชั่วโมง/เดือน) ความล้มเหลวแบบเงียบ ๆ เพียงครั้งเดียว — คือ selector พังแต่ยังคืนข้อมูลว่างโดยไม่มีใครรู้ — อาจทำให้สูญเสียยอดขาย การกู้คืน ranking และเวลาของทีมรวมกันราว $38,000–$57,000
สาเหตุที่พบบ่อย ได้แก่ การเปลี่ยนชื่อ CSS class ตอนอัปเดต framework, มี container element ใหม่ครอบ target, การอัปเกรด React/Vue/Angular ที่เปลี่ยนโครงสร้าง DOM, A/B testing ที่ใช้ dynamic class names และการปกปิดเพื่อกันการสแครป
AI extraction ช่วยลดงานดูแลลง 60–80%
งานศึกษาจาก DataRobot ในปี 2025 พบว่า AI-powered scrapers ต้องการ maintenance น้อยลง 70% เมื่อเทียบกับ scraper แบบ selector หลังเว็บไซต์ถูกออกแบบใหม่ สัดส่วนเวลาแทบจะกลับด้าน:
| ตัวชี้วัด | แบบดั้งเดิม (CSS selectors) | AI-Powered |
|---|---|---|
| การดูแลหลัง redesign | ค่ามาตรฐาน | น้อยลง 70% |
| สัดส่วนเวลา (setup : maintenance) | 20% : 80% | 5% : 95% ตามข้อมูล |
| การลดงานดูแลโดยรวม | ค่ามาตรฐาน | ลดลง 60–80% |
| ความเร็วบนหน้าที่ใช้ JS หนัก | ค่ามาตรฐาน | เร็วขึ้น 30–40% |
เวลาในการตั้งค่า: เขียน selector vs. ให้ AI แนะนำฟิลด์
การตั้งค่า ScrapingBee: ดู source ของหน้า → หา CSS selectors → เขียนกฎ extraction เป็น JSON → ทดสอบและแก้บั๊ก → รับมือ edge cases ของหน้าแต่ละแบบ → เฝ้าระวังความพัง → แก้ selector เมื่อเว็บอัปเดต
การตั้งค่า Thunderbit: เปิดหน้าใน Chrome → คลิก "AI Suggest Fields" → AI อ่านหน้าและเสนอคอลัมน์พร้อม data type ที่เหมาะสม → คลิก "Scrape" ไม่ต้องเขียน selector ไม่ต้องดู source code AI ของ Thunderbit ขับเคลื่อนด้วย foundation models หลายตัว (ChatGPT, Gemini, Claude, DeepSeek R1) ที่อ่านหน้าเว็บเหมือนที่คนมองเห็น
Field AI Prompts ของ Thunderbit เพิ่มอีกชั้นหนึ่ง: แต่ละคอลัมน์สามารถใส่คำสั่ง AI แบบกำหนดเองเพื่อแปลงข้อมูลระหว่างการดึงได้ เช่น จัดรูปแบบวันที่, แปลข้อความ, จัดหมวดหมู่สินค้า, แยกชื่อ, ทำให้หมายเลขโทรศัพท์เป็นมาตรฐาน ซึ่งช่วยตัดขั้นตอน post-processing แยกต่างหากที่ผู้ใช้ ScrapingBee ต้องสร้างเองออกไป
Output แบบมีโครงสร้าง: Raw HTML vs. แถวข้อมูลพร้อมใช้
| มิติ | ScrapingBee (ใช้ selector) | Thunderbit (ใช้ AI) |
|---|---|---|
| Output ค่าเริ่มต้น | Raw HTML | แถวข้อมูลแบบมีโครงสร้างพร้อมคอลัมน์ที่กำหนดชนิดข้อมูล |
| การดึงข้อมูลแบบมีโครงสร้าง | ต้องเขียน CSS/XPath rules หรือใช้ AI add-on (+5 credits) | AI ตรวจจับฟิลด์ให้อัตโนมัติ |
| ประเภทข้อมูลที่รองรับ | Text (ต้อง parse HTML เพิ่ม) | Text, number, date, URL, email, phone, image |
| ความทนต่อการเปลี่ยน layout | ⚠️ ต้องอัปเดต selector เอง | ✅ AI อ่านหน้าใหม่ทุกครั้ง |
| ทักษะทางเทคนิคที่ต้องใช้ | Python/cURL, CSS selectors, ความเข้าใจ HTML | ไม่ต้องมี — ใช้ Chrome extension กับ workflow 2 คลิก |
| งานดูแลระยะยาว | ต่อเนื่อง (อัตราพัง 1–2% ต่อสัปดาห์) | น้อยมาก (AI ปรับตัวอัตโนมัติ) |
ScrapingBee เพิ่มฟีเจอร์ AI extraction (ai_query, ai_extract_rules) เข้ามาช่วยแก้ปัญหาการดูแล selector ได้บางส่วน แต่ฟีเจอร์นี้ก็เพิ่ม +5 credits ต่อ request จากต้นทุนพื้นฐาน และตัวเครื่องมือยังเป็น API-first แบบไม่มี interface เชิงภาพอยู่ดี
ScrapingBee สำหรับคนไม่เขียนโค้ด: ตรวจสอบการใช้งานแบบตรงไปตรงมา
ScrapingBee ไม่ได้สร้างมาสำหรับผู้ใช้ที่ไม่ใช่สายเทคนิค มันคือ API ถ้าคุณเป็นผู้จัดการฝ่ายการตลาดหรือหัวหน้า sales ops ที่อ่านมาถึงตรงนี้ นั่นแหละคือคำตอบ
นี่คือสิ่งที่ผู้ใช้ non-technical จะเจอจริงเมื่อใช้ ScrapingBee:
- เขียน API call ด้วย Python, cURL หรือภาษาอื่น
- เข้าใจพารามิเตอร์ HTTP เช่น
render_js=true,premium_proxy=true,country_code=us - แปลง raw HTML response ด้วยไลบรารีอย่าง BeautifulSoup
- เขียน CSS selectors เพื่อดึงฟิลด์ข้อมูลเฉพาะ
- จัดการ pagination ด้วยตรรกะ crawl ที่เขียนเอง (ScrapingBee รองรับแค่ request ทีละหน้า)
- สร้าง data pipeline เพื่อทำความสะอาด จัดโครงสร้าง และเก็บข้อมูลที่สกัดออกมา
ไม่มี drag-and-drop builder ไม่มี interface แบบจิ้มคลิก และไม่มี preview แบบเห็นภาพว่ากำลังสแครปอะไรอยู่
"มีช่วงที่ต้องเรียนรู้ และเอกสารค่อนข้างหนา ต้องใช้เวลาตั้งแต่หนึ่งวันถึงหนึ่งสัปดาห์ในการอ่านให้จบ" — Arvind K, Proprietor, Financial Services, Capterra
"ระบบของพวกเขาค่อนข้างเฉพาะทางมาก และต้องใช้เวลาพอสมควรกว่าจะเข้าใจโค้ดและโครงสร้างของมัน" — รีวิวบน Capterra
นักพัฒนาชอบสิ่งนี้มาก ผู้รีวิวคนหนึ่งบอกว่า "เป็น API ล้วน ๆ: ทันสมัยและดูดีมาก: ใช้งานได้จริง" แต่คำว่า "ใช้งานง่าย" สำหรับนักพัฒนาที่ประเมิน API กับ "ใช้งานง่าย" สำหรับคนที่อยากสร้างรายชื่อ lead โดยไม่เขียนโค้ดนั้นต่างกันคนละเรื่อง
เมื่อทางเลือกแบบ no-code เหมาะกว่า
Thunderbit Chrome Extension ให้ประสบการณ์อีกแบบแบบคนละเรื่อง:
- เปิดเว็บเพจ ใน Chrome ที่ติดตั้ง extension แล้ว
- คลิก "AI Suggest Fields" — AI สแกนหน้าและเสนอคอลัมน์ (เช่น Product Name, Price, Rating, URL ฯลฯ) พร้อมชนิดข้อมูลที่เหมาะสม
- ตรวจสอบและปรับแต่ง — เพิ่ม ลบ หรือเปลี่ยนชื่อคอลัมน์; ใส่ Field AI Prompts เพื่อแปลงข้อมูล
- คลิก "Scrape" — ข้อมูลจะถูกดึงออกมาเป็นแถวแบบมีโครงสร้าง
- ส่งออก — คลิกครั้งเดียวไปยัง Google Sheets, Airtable, Notion, Excel, CSV หรือ JSON (การส่งออกทั้งหมดฟรี)
ไม่ต้องเรียก API ไม่ต้องเขียน selector ไม่ต้องเขียนโค้ด Thunderbit รองรับ 55 ภาษา ณ เมษายน 2026
สำหรับเว็บไซต์ยอดนิยม Thunderbit ยังมี template scraper แบบใช้งานได้ทันที — เทมเพลตสำเร็จรูปที่ดูแลไว้แล้วสำหรับ Amazon, Zillow, Shopify, LinkedIn, Google Maps, Instagram, eBay, Apollo และอื่น ๆ คุณแทบไม่ต้องรอให้ AI เสนอฟิลด์ด้วยซ้ำ เพราะเทมเพลตพร้อมใช้อยู่แล้ว
นอกจากนี้ Thunderbit ยังมีเครื่องมือ ใช้ฟรีตลอดไป ที่ไม่ต้องมีแพ็กเกจ ได้แก่ email extractor, phone number extractor และ image extractor — เหมาะกับทีมขายและการตลาดที่อยากดึงข้อมูลเร็ว ๆ
กรอบการตัดสินใจ: ใครควรใช้ตัวไหน
| ถ้าคุณคือ… | ตัวเลือกที่เหมาะที่สุด |
|---|---|
| นักพัฒนาที่ถนัด API และ parse HTML | ScrapingBee หรือ ScraperAPI |
| ผู้ใช้สายเทคนิคที่ต้องการ structured data โดยไม่ต้องเขียน selector | Thunderbit API (Extract endpoint) |
| ผู้ใช้งานฝั่งธุรกิจ (ขาย, การตลาด, ecommerce ops) ที่ไม่เขียนโค้ด | Thunderbit Chrome Extension |
| ทีมที่ต้องการ monitoring แบบตั้งเวลาโดยไม่ต้องมี devops | Thunderbit Scheduled Scraper (ตั้งเวลาด้วยภาษาธรรมชาติ) |
| สร้าง LLM/RAG pipelines ที่ต้องการ markdown สะอาด | Thunderbit Distill API หรือ Firecrawl |
| ต้องการคุมงบและไม่อยากเจอตัวคูณเครดิต | Thunderbit (1 credit = 1 row) |
หลังสแครปแล้ว: ข้อมูลของคุณไปไหนต่อ?
การสแครปเป็นแค่ครึ่งเดียวของงาน อีกครึ่ง — คือการพาข้อมูลไปอยู่ในที่ที่ใช้งานได้จริง — คือจุดที่รีวิว ScrapingBee ส่วนใหญ่มักเงียบไป
ScrapingBee: ส่งออกเป็น raw HTML แล้วคุณต้องสร้าง pipeline เอง
ScrapingBee ส่งกลับ raw HTML เป็นค่าเริ่มต้น จากนั้นคุณต้อง:
- Parse HTML ด้วย BeautifulSoup หรือ lxml
- ตัด navigation, footer, scripts และ styles ออก ซึ่งคิดเป็น 80–90% ของเนื้อหาในหน้าเว็บทั่วไป
- ดึงฟิลด์ข้อมูลที่ต้องการ
- แปลงเป็นรูปแบบที่มีโครงสร้าง
- จัดการ pagination และ error state
- เก็บและกระจายข้อมูล
"ScrapingBee ส่งกลับ raw HTML AI agents ต้องการ markdown ที่สะอาด, semantic search และ webhooks" — KnowledgeSDK
ScrapingBee มี return_page_markdown=true และ return_page_text=true เป็นตัวเลือกเสริม รวมถึง Google Search API ที่ส่งกลับ JSON แบบมีโครงสร้าง แต่ workflow หลัก — และประสบการณ์การสแครปแบบทั่วไป — ยังเป็น raw HTML ที่คุณต้องเอาไปประมวลผลเอง
โดยทั่วไปผู้ใช้ต้องพึ่งเครื่องมือเพิ่มอีกหลายตัว: BeautifulSoup/lxml สำหรับ parsing, Pandas สำหรับทำความสะอาดข้อมูล, cron/Airflow สำหรับตั้งเวลา, ตรรกะ crawl แบบเขียนเองสำหรับสแครปหลายหน้า และ cloud storage แยกต่างหาก มันมีงานวิศวกรรมคั่นอยู่เยอะมากระหว่างคำว่า "สแครปแล้ว" กับ "เอาไปใช้ได้จริง"
Thunderbit: Output แบบมีโครงสร้างพร้อมส่งออกในตัว
Thunderbit ส่งกลับแถวข้อมูลแบบมีโครงสร้างพร้อมชนิดข้อมูลที่กำหนดไว้ (text, number, date, URL, email, phone, image) พร้อมส่งออกได้ทันที การส่งออกทั้งหมดฟรีทุกแพ็กเกจ:
| ปลายทางการส่งออก | ค่าใช้จ่าย |
|---|---|
| Excel (.xlsx) | ฟรี |
| Google Sheets | ฟรี (เชื่อมต่อโดยตรง) |
| Airtable | ฟรี (เชื่อมต่อโดยตรง) |
| Notion | ฟรี (เชื่อมต่อโดยตรง) |
| CSV | ฟรี |
| JSON | ฟรี |
สำหรับทีมที่ใช้ Google Sheets หรือ Airtable เป็นศูนย์กลางของ CRM หรือ operations อยู่แล้ว สิ่งนี้ช่วยตัดชั้นงานวิศวกรรมออกไปได้ทั้งก้อน และเมื่อส่งออกไปยัง Notion หรือ Airtable รูปภาพจะถูกอัปโหลดไปยัง image library เพื่อให้เปิดดูแบบ inline ได้ ซึ่งเป็นรายละเอียดเล็ก ๆ ที่สำคัญมากในงานจริง
Ecosystem การเชื่อมต่อของ ScrapingBee
ScrapingBee มี integration จากบุคคลที่สาม เช่น Zapier (เชื่อมต่อแอปกว่า 8,000 รายการ), Make (กว่า 3,000 แอป), n8n และ Microsoft Power Automate เครื่องมือพวกนี้ช่วยเชื่อมช่องว่างระหว่าง raw HTML กับปลายทางที่คุณใช้งานได้ — แต่ก็มาพร้อมต้นทุน ความซับซ้อน และจุดที่อาจล้มเหลวเพิ่มขึ้นอีกชั้น
สำหรับนักพัฒนา: Open API ของ Thunderbit
สำหรับผู้อ่านที่อยากได้ pipeline แบบโปรแกรมเมติก Thunderbit มี Open API ที่มี endpoint หลัก 2 ตัว:
- Distill endpoint — แปลงหน้าเว็บเป็น Markdown สะอาด เหมาะกับ LLM/RAG pipelines (1 credit ต่อการเรียก)
- Extract endpoint — ส่งคืน JSON แบบมีโครงสร้างตาม schema ที่ผู้ใช้กำหนด (20 credits ต่อการเรียก)
- การประมวลผลแบบแบตช์ — สูงสุด 100 URLs ต่อ request
นั่นหมายความว่า Thunderbit รองรับทั้งผู้ใช้ no-code (Chrome Extension) และนักพัฒนา (Open API) ด้วย AI engine เดียวกัน ดังนั้นอย่าถามแค่ว่า "มันสแครปได้ไหม" — ให้ถามต่อว่า "ข้อมูลจะไปต่อที่ไหน"
เช็กความเสถียรปี 2026: ScrapingBee ใช้จริงในโปรดักชันไหวไหม?
เธรดเก่า ๆ บน Reddit (2021–2023) มีข้อร้องเรียนเรื่องความเสถียรของ ScrapingBee แล้วในปี 2026 ยังเป็นแบบนั้นอยู่ไหม? ผมรวบรวมข้อมูลจาก benchmark อิสระ 6 แหล่ง ผลที่ได้คละกัน — และบางทีก็ขัดแย้งกันเอง
Benchmark ทุกสองสัปดาห์ของ Scrapeway (เมษายน 2026)
ภาพรวม: อัตราความสำเร็จ 33.3% — อยู่อันดับ 7 จาก 9 บริการที่ทดสอบ
| เว็บไซต์ | อัตราความสำเร็จ |
|---|---|
| Amazon | 48% |
| 41% | |
| Indeed | 38% |
| Etsy | 21% |
| Booking | 17% |
| Realtor | 0% |
| StockX | 0% |
| Twitter/X | 0% |
| Zillow | 0% |
| Walmart | 0% |
| 0% |
การทดสอบตัวต่อตัวของ Scrapingdog (2025)
| เว็บไซต์ | ScrapingBee | Scrapingdog | ScraperAPI |
|---|---|---|---|
| Amazon | 100% | 100% | 100% |
| Glassdoor | 0% | 100% | 100% |
| eBay | 100% | 100% | 100% |
| Walmart | 40% | 100% | 100% |
| 90% | 100% | 80% |
Benchmark ของ Proxyway (ธันวาคม 2025)
- ความสำเร็จ 84.47% ที่ 2 requests/วินาที
- ความสำเร็จ 72.98% ที่ 10 requests/วินาที — ลดลง 12 จุดเมื่อเจอโหลด
- เวลาตอบสนองเฉลี่ย 25.46 วินาที — ช้าที่สุดในกลุ่มที่ทดสอบ
Benchmark ของ Scrape.do (2025–2026)
- อัตราความสำเร็จรวม 92.69%
- แข็งแรงบนเว็บไซต์เดี่ยว ๆ: Amazon 99.11%, Indeed 99.29%, GitHub 100%, X/Twitter 99.6%
- อ่อนบน Capterra: สำเร็จเพียง 59% และเวลาตอบสนอง 36 วินาที
รูปแบบที่เห็นชัด
ข้อมูลบอกแพตเทิร์นชัดเจนว่า:
- ScrapingBee ทำงานได้ดีบนเว็บไซต์กระแสหลักที่มีการป้องกันระดับปานกลาง — Amazon, eBay, GitHub และ Indeed มักได้อัตราความสำเร็จ 90–100%
- ScrapingBee ล้มเหลวโดยสิ้นเชิงบนเว็บไซต์ที่ป้องกันหนัก — LinkedIn, Zillow, Realtor.com, StockX และ Twitter แสดงผล 0% อย่างต่อเนื่องในหลาย benchmark
- ประสิทธิภาพตกลงชัดเจนเมื่อโหลดเพิ่มขึ้น — จาก 84% ที่ 2 req/s ลดเหลือ 73% ที่ 10 req/s
- ผล benchmark ต่างกันมากตามวิธีทดสอบ — ตั้งแต่ 33.3% (Scrapeway, หลายเว็บไซต์ผสมกัน) ถึง 92.69% (Scrape.do, เป้าหมายระดับปานกลาง)
คะแนน Capterra 4.9/5 ของ ScrapingBee (137 รีวิว) เป็นสัญญาณเชิงบวก แต่คะแนนสูงเรื่องความง่ายในการเริ่มต้นไม่ได้แปลว่าจะเสถียรระยะยาวเมื่อใช้งานจริงในสเกลใหญ่เสมอไป ผู้ใช้ที่ย้ายออกไปมักพูดถึงอัตราความล้มเหลวที่เพิ่มขึ้นและต้นทุนที่สูงขึ้น — ไม่ใช่ความยากในการเริ่มต้น
"ค่อนข้างดีมาก ScrapingBee มีความเสถียร คาดเดาได้ และเชื่อมเข้ากับโปรดักชันได้ง่าย" — ผู้รีวิวที่ยืนยันตัวตน, CEO, Capterra
ScrapingBee แสดง "ความเสถียรที่ไม่สม่ำเสมอ" โดยเฉพาะ "อัตราความสำเร็จ 0% บน Glassdoor" และ "40% บน Walmart"
AI-powered scraping จัดการความเสถียรต่างออกไปอย่างไร
AI ของ Thunderbit อ่านหน้าเว็บที่ถูก render แบบเรียลไทม์ และปรับตัวกับมาตรการกันบอทและการเปลี่ยนเลย์เอาต์ในแต่ละ session โหมดสแครปสองแบบช่วยแก้ปัญหาความเสถียรต่างกัน:
- Cloud scraping — ทำงานบนเซิร์ฟเวอร์คลาวด์ของ Thunderbit รองรับสูงสุด 50 หน้าต่อครั้ง เหมาะกับงานสแครปสาธารณะขนาดใหญ่บนเว็บไซต์อย่าง Amazon, Zillow และ Shopify
- Browser scraping — ทำงานบน Chrome ของผู้ใช้เอง ใช้ session ที่ล็อกอินอยู่ของผู้ใช้ เหมาะกับเว็บที่ต้องล็อกอิน (LinkedIn, private dashboard, แพลตฟอร์ม SaaS) ซึ่งเครื่องมือแบบ API เช่น ScrapingBee เข้าไม่ถึงเนื้อหาหลังการยืนยันตัวตน
Thunderbit ยังมี template scraper แบบใช้งานได้ทันที สำหรับเว็บไซต์ยอดนิยมที่ถูกสร้างไว้และดูแลต่อเนื่อง ทำให้ยังใช้งานได้แม้เว็บจะเปลี่ยนโครงสร้าง สำหรับเว็บไซต์ที่ ScrapingBee แสดงผล 0% (เช่น LinkedIn, Zillow) โหมด browser scraping ของ Thunderbit — ที่ใช้ session ล็อกอินของคุณเอง — เป็นวิธีการที่ต่างไปโดยสิ้นเชิง
ScrapingBee เทียบกับตัวเลือกชั้นนำ: เปรียบเทียบแบบตัวต่อตัว
| มิติ | ScrapingBee | Thunderbit | ScraperAPI | Scrapfly |
|---|---|---|---|---|
| ประเภท | API-only | Chrome Extension + API | API-only | API-only |
| ราคาเริ่มต้น | $49/mo | ฟรี ($0) | $49/mo | $30/mo |
| โมเดลเครดิต | ตัวคูณ (1×–75×) | 1 credit = 1 row (ไม่มีตัวคูณ) | ตัวคูณ (1×–75×) | ตัวคูณ (1×–30×) |
| AI extraction | มี (+5 credits/request) | มีในตัว (AI Suggest Fields) | ไม่มี AI แบบ native | มี |
| ตัวเลือก no-code | ไม่มี (API เท่านั้น) | มี (Chrome Extension) | ไม่มี (API เท่านั้น) | ไม่มี (API เท่านั้น) |
| Output แบบมีโครงสร้าง | ต้องใช้ CSS rules หรือ AI add-on | ค่าเริ่มต้น (คอลัมน์ที่ระบุชนิดข้อมูล) | มี endpoint แบบมีโครงสร้างสำหรับบางเว็บไซต์ | แตกต่างกันไป |
| ปลายทางการส่งออก | Raw HTML/JSON (ต้องสร้างเอง) | Excel, Sheets, Airtable, Notion, CSV, JSON (ฟรีทั้งหมด) | Raw HTML/JSON | Raw HTML/JSON |
| สแครป subpage | ต้องทำเอง (เขียน crawl logic) | มีในตัว (2 credits/row) | ต้องทำเอง | ต้องทำเอง |
| การสแครปตามเวลา | มีแค่ CLI (ไม่มี scheduler บนแดชบอร์ด) | มีในตัว (ภาษาธรรมชาติ) | ไม่มีในตัว | ไม่มีในตัว |
| ฟรีเทียร์ | ทดลอง 1,000 credits | 6 pages/เดือน (ตลอดไป) | 5,000 credits (ทดลองใช้ฟรี 7 วัน) | 1,000 credits |
| JS rendering ค่าเริ่มต้น | เปิดอยู่ (ต้นทุน 5×) | รวมอยู่แล้ว (ไม่คิดเพิ่ม) | ปิด | ปิด |
| เส้นโค้งการเรียนรู้ | สูง (API + selectors) | ต่ำ (workflow 2 คลิก) | สูง (API + selectors) | สูง (API) |
| เหมาะที่สุดสำหรับ | นักพัฒนาที่อยากคุม proxy | ผู้ใช้ธุรกิจ + นักพัฒนา | นักพัฒนาที่ต้องการ structured endpoints | นักพัฒนาที่ต้องการ bypass ASP |
| คะแนน Capterra | 4.9/5 (137 รีวิว) | — | 4.6/5 (62 รีวิว) | 4.9/5 (221 รีวิว) |
ScrapingBee vs. Thunderbit: ความต่างสำคัญ
ความต่างที่ใหญ่ที่สุดสรุปได้เป็นเรื่อง architecture และกลุ่มผู้ใช้:
- API-only เทียบกับ Chrome Extension + API: ScrapingBee ต้องใช้โค้ดสำหรับทุกการโต้ตอบ Thunderbit มี Chrome Extension สำหรับผู้ใช้ no-code และ Open API สำหรับนักพัฒนา — ใช้ AI engine เดียวกัน แต่มีสอง interface
- ดึงข้อมูลแบบ selector เทียบกับ AI: ScrapingBee บังคับให้คุณเขียนและดูแล CSS/XPath selectors เอง Thunderbit ให้ AI เสนอฟิลด์ให้อัตโนมัติและปรับตัวเมื่อเว็บไซต์เปลี่ยน
- Raw HTML เทียบกับแถวข้อมูลมีโครงสร้างพร้อมส่งออกฟรี: ScrapingBee ส่ง HTML กลับมาให้คุณ parse เอง Thunderbit ส่งแถวข้อมูลที่มีชนิดและป้ายกำกับพร้อมให้ ส่งออกไป Excel, Google Sheets, Airtable หรือ Notion ได้ในคลิกเดียว
- Subpage scraping: Thunderbit ให้ AI เข้าไปเก็บข้อมูลจากแต่ละหน้ารายละเอียดแล้วเติมลงตารางหลักได้เลย — มีในตัว ไม่ต้องเขียน crawl logic เอง ส่วน ScrapingBee ต้องเขียน logic นั้นเอง
- Instant templates: Thunderbit มีเทมเพลตสำเร็จรูปสำหรับเว็บไซต์ยอดนิยม (Amazon, Zillow, Shopify, LinkedIn, Google Maps, eBay) ที่ใช้งานได้ทันที ScrapingBee มี API เฉพาะสำหรับ Amazon และ Walmart แต่คุณก็ยังต้องเขียนโค้ดเพื่อใช้งาน
ตัวเลือกอื่นที่น่าสนใจ
- Scrape.do — ต้นทุนอิสระต่ำสุดที่ $0.80/1K requests พร้อมอัตราความสำเร็จ 98.19%; เริ่มต้น $29/mo
- Apify — แพลตฟอร์มแบบ actor-based มีรีวิวบน G2 กว่า 415 รีวิว (4.7/5) แต่ปัญหาเรื่อง "Pricing Issues" คือข้อร้องเรียนอันดับ 1
- Firecrawl — native กับ AI/LLM ส่งกลับ markdown ที่ใช้ token น้อยกว่า raw HTML 67%; core แบบ open-source; เริ่มต้น $16/mo
- Bright Data — ระดับองค์กร มี IP มากกว่า 72M ราย เริ่มต้น $499/mo; ราคาแบบ flat-rate
- ZenRows — มี residential IP 55M ราย มี scraper สำเร็จรูปสำหรับ Amazon/Walmart/Zillow เริ่มต้น $69/mo
เครื่องมือสแครปตัวไหนเหมาะกับทีมของคุณ?
คำแนะนำตามสถานการณ์:
- ถ้าคุณเป็นนักพัฒนาที่กำลังสร้าง pipeline สแครปเองและต้องการคุม proxy แบบละเอียด → ScrapingBee หรือ ScraperAPI คุณจะได้ HTTP parameters แบบละเอียด เลือกประเภท proxy ได้ และควบคุม rendering ได้เต็มที่ แค่ต้องเผื่องบสำหรับตัวคูณเครดิตด้วย
- ถ้าคุณเป็นทีมขายหรือการตลาดที่ต้องการ lead จากเว็บไซต์โดยไม่เขียนโค้ด → Thunderbit Chrome Extension คลิกสองครั้งเพื่อได้ข้อมูลแบบมีโครงสร้าง คลิกครั้งเดียวส่งไป Google Sheets ไม่มี API ไม่มี selector ไม่มี parsing
- ถ้าคุณต้องการข้อมูลมีโครงสร้างจากเว็บไซต์ยอดนิยมอย่างรวดเร็ว → Thunderbit Instant Templates Amazon, Zillow, Shopify, LinkedIn — มีให้พร้อมและดูแลต่อเนื่อง ไม่ต้องตั้งค่า AI
- ถ้าคุณต้องการเฝ้าราคา หรือ inventory ตามเวลาโดยไม่ต้องมี devops → Thunderbit Scheduled Scraper ระบุช่วงเวลาเป็นภาษาธรรมดา (เช่น "ทุกวันจันทร์เวลา 9 โมงเช้า") แล้วปล่อยให้รัน
- ถ้าคุณกำลังสร้าง LLM/RAG pipelines และต้องการ Markdown สะอาดในสเกลใหญ่ → Thunderbit Distill API หรือ Firecrawl ทั้งคู่ส่งกลับ markdown ที่เหมาะกับการใช้งานกับ AI
- ถ้าคุณให้ความสำคัญกับความแน่นอนของงบและไม่อยากเจอตัวคูณเครดิต → Thunderbit 1 credit = 1 row ไม่ว่า JS rendering หรือประเภท proxy จะเป็นแบบไหน
ต้นทุนรวมในการเป็นเจ้าของไม่ได้มีแค่ราคา API แต่รวมถึงเวลาเซ็ตอัป + ชั่วโมงดูแล + งานวิศวกรรม parsing + เวิร์กโฟลว์ส่งออกข้อมูลด้วย ราคาหน้าป้ายของ ScrapingBee ถือว่าแข่งขันได้ แต่ภาพรวมต้นทุนจริงไม่ใช่อย่างนั้น
ข้อสรุปสำคัญจากรีวิว ScrapingBee นี้
5 ประเด็นที่ควรจำไว้:
- ต้นทุนเครดิตพุ่งเร็วเมื่อสเกลใหญ่ขึ้น ราคาเริ่มต้น $49 อาจกลายเป็น $599+ เมื่อต้องใช้ JS rendering และ premium proxies ส่วนโมเดลแบบ 1 credit ต่อ 1 แถวของ Thunderbit ตัดความไม่แน่นอนนี้ออกไป
- CSS selectors มีภาระการดูแลต่อเนื่อง ขณะที่ AI extraction ลดภาระนั้นได้ คาดว่าจะลดงานดูแลได้ 60–80% ด้วยเครื่องมือ AI-powered และไม่มี selector พังเมื่อเว็บอัปเดต
- ผู้ใช้ที่ไม่ใช่นักพัฒนาจะเจอเส้นทางการเรียนรู้ที่ชันกับ ScrapingBee มันเป็นเครื่องมือ API-only ที่ต้องเขียนโค้ด ตรวจ HTML และสร้าง selector เอง ผู้ใช้ธุรกิจควรมองหา no-code alternatives
- การส่งออกข้อมูลต้องใช้วิศวกรรมเพิ่มเติม ScrapingBee ส่ง raw HTML กลับมา คุณต้องสร้าง pipeline เอง ส่วน Thunderbit ส่งออกข้อมูลมีโครงสร้างไปยัง Excel, Sheets, Airtable และ Notion ได้ฟรี
- ความเสถียรดีสำหรับบางเว็บไซต์ แต่ไม่สม่ำเสมอสำหรับบางเว็บ ScrapingBee ทำงานได้ดีบน Amazon และ eBay แต่ให้ผล 0% บน LinkedIn, Zillow และอีกหลายเป้าหมายที่ป้องกันหนัก
ScrapingBee ยังเป็นเครื่องมือที่มีความสามารถสำหรับนักพัฒนาที่ต้องการ HTTP access ผ่าน proxy พร้อมการควบคุมละเอียด แต่โลกของเว็บสแครปในปี 2026 กำลังก้าวไปทางเครื่องมือ AI-powered แบบ no-code — และ Thunderbit ถูกออกแบบมาเพื่อจุดเปลี่ยนนี้โดยตรง ลองใช้ฟรีเทียร์ (6 pages ฟรี หรือมากกว่านั้นผ่านทดลองใช้ฟรี) เพื่อสัมผัสความต่างด้วยตัวคุณเอง
คำถามที่พบบ่อย
ScrapingBee คุ้มค่าในปี 2026 ไหม?
ขึ้นอยู่กับทักษะด้านเทคนิคและขนาดงาน ถ้าคุณเป็นนักพัฒนาที่สแครปหน้า static ในปริมาณปานกลาง ScrapingBee ให้ API ที่ดี เอกสารครบ และซัพพอร์ตตอบไว พร้อม คะแนน Capterra 4.9/5 สำหรับผู้ใช้งานธุรกิจ งานสแครปปริมาณสูง หรือทีมที่ต้องการข้อมูลมีโครงสร้างโดยไม่เขียนโค้ด ทางเลือกแบบ AI-powered เช่น Thunderbit ให้ความคุ้มค่าดีกว่า และต้นทุนรวมในการใช้งานต่ำกว่ามาก
ใช้ ScrapingBee โดยไม่เขียนโค้ดได้ไหม?
ไม่ได้ ScrapingBee เป็นเครื่องมือแบบ API-only ที่ต้องเขียนโค้ด (Python, cURL หรือใกล้เคียง) และเข้าใจพารามิเตอร์ HTTP ไม่มี interface แบบภาพสำหรับสร้างงานสแครป ผู้ใช้ที่ไม่ใช่สายเทคนิคควรพิจารณา no-code options อย่าง Thunderbit Chrome Extension ซึ่งช่วยให้คุณสแครปและส่งออกข้อมูลได้โดยไม่ต้องเขียนโค้ดแม้แต่บรรทัดเดียว
จริง ๆ แล้ว ScrapingBee คิดราคาต่อหน้ากี่บาท?
ขึ้นอยู่กับฟีเจอร์ที่เปิดใช้ หน้า HTML แบบ static ใช้ 1 credit หน้าแบบ JS-rendered (ค่าเริ่มต้น) ใช้ 5 credits หน้าแบบ premium-proxy + JS ใช้ 25 credits หน้าแบบ stealth-proxy ใช้ 75 credits และ AI extraction เพิ่ม +5 credits อีกชั้นหนึ่ง บนแพ็กเกจ Freelance ($49/250K credits) เท่ากับ $0.20 ต่อ 1,000 หน้า static หรือ $14.70 ต่อ 1,000 หน้า stealth-proxy ดูตารางต้นทุนด้านบนเพื่อรายละเอียดทั้งหมด
ตัวเลือกที่ดีที่สุดแทน ScrapingBee ในปี 2026 คืออะไร?
ตัวเลือกเด่น ๆ ได้แก่ Thunderbit (AI-powered, Chrome Extension + API แบบ no-code, 1 credit = 1 row), ScraperAPI (API สำหรับนักพัฒนาพร้อม structured endpoints สำหรับบางเว็บไซต์), Scrapfly (API สำหรับนักพัฒนาพร้อม bypass anti-bot ที่แข็งแกร่ง), Scrape.do (ต้นทุนต่อ request ต่ำสุดในการทดสอบอิสระ) และ Firecrawl (native กับ AI/LLM ส่งกลับ markdown สะอาด) แต่ละตัวมีจุดเด่นต่างกัน — Thunderbit เหมาะกับผู้ใช้ธุรกิจและคนที่ต้องการความแน่นอนด้านงบ, ScraperAPI และ Scrapfly เหมาะกับนักพัฒนาที่ต้องการคุม proxy, Firecrawl เหมาะกับ LLM pipelines
ScrapingBee สแครปเว็บไซต์ที่ใช้ JavaScript หนัก ๆ ได้ไหม?
ได้ แต่ต้องจ่าย 5× ของเครดิตพื้นฐานเมื่อใช้ rotating proxy หรือ 25× เมื่อใช้ premium proxy การเรนเดอร์ JavaScript ถูก เปิดเป็นค่าเริ่มต้น อยู่แล้ว ดังนั้นคุณจึงจ่ายในอัตรา 5× ตั้งแต่แรก เว้นแต่จะปิดมันเอง Thunderbit จัดการ JavaScript rendering ให้อัตโนมัติโดยไม่มีตัวคูณเครดิต — 1 credit ต่อ 1 แถว ไม่ว่าโครงสร้างของหน้าจะเป็นแบบใด
เรียนรู้เพิ่มเติม



