
ถ้าคุณเคยลอง requests.get("https://www.youtube.com/...") แล้วเอาผลลัพธ์ไป parse ด้วย BeautifulSoup เพื่อหา title ของวิดีโอ คุณคงรู้คำตอบอยู่แล้วว่าเจออะไร: <div> ว่าง ๆ เต็มไปหมด และไม่มีข้อมูลที่ใช้ได้จริงเลยแม้แต่ชิ้นเดียว
นี่คือปัญหาที่เจอบ่อยสุดที่ผมเห็นจากนักพัฒนาที่เพิ่งเริ่มลองดึงข้อมูลจาก YouTube ครั้งแรก YouTube เป็นเว็บแบบ single-page application — แทบทุกอย่างถูกเรนเดอร์ฝั่ง client ด้วย JavaScript HTML ที่สคริปต์ Python ของคุณได้รับมาเป็นแค่โครงเปล่า ๆ ส่วน title, จำนวนวิว และ metadata จริง ๆ จะอยู่ใน JSON ก้อนใหญ่ที่ชื่อว่า ytInitialData ซึ่งถูกฉีดเข้ามาโดย JS หลังหน้าเว็บโหลดเสร็จ
เพราะงั้น soup.find("div", class_="ytd-video-renderer") ที่ดูเหมือนจะสมเหตุสมผลมากจึงคืนค่า None เพราะ element นั้นไม่มีอยู่จริงใน response ดิบที่ได้จาก HTTP พอผมเข้าใจจุดนี้ ทุกอย่างก็เริ่มต่อกันติด — และ 4 วิธีด้านล่างคือผลลัพธ์จากการลองผิดลองถูก แกะระบบพัง และอ่าน issue ใน GitHub มากเกินจำเป็น ผมจะพาคุณไล่ทีละวิธี บอกให้ชัดว่าแต่ละแบบเหมาะกับตอนไหน และแถมทางลัดแบบไม่ต้องเขียนโค้ดไว้ท้ายบทความสำหรับคนที่แค่อยากได้ข้อมูล โดยไม่อยากยุ่งกับการตั้งโปรเจกต์
ทำไมต้องดึงข้อมูล YouTube ด้วย Python?
YouTube ไม่ได้เป็นแค่แพลตฟอร์มวิดีโอ — แต่มันคือแหล่งข้อมูลมหาศาลที่มี ผู้ใช้งานรายเดือน 2.58 พันล้านคน ด้วย วิดีโอที่โฮสต์อยู่มากกว่า 5.1 พันล้านรายการ และมีการอัปโหลดคอนเทนต์กว่า 500 ชั่วโมงต่อนาที จึงมีข้อมูลสาธารณะที่มองเห็นได้จำนวนมหาศาลให้ธุรกิจ นักวิจัย และครีเอเตอร์นำไปวิเคราะห์แบบโปรแกรม
ข้อจำกัดคือ analytics ที่ YouTube มีในตัวจะแสดงข้อมูลเฉพาะช่องของ ตัวเอง เท่านั้น ถ้าคุณอยากเข้าใจจังหวะการอัปโหลดของคู่แข่ง ติดตามหัวข้อที่กำลังมาแรงใน niche ของคุณ หรือวิเคราะห์ความเห็นของผู้ชมจากคอมเมนต์ในวิดีโอของคนอื่น คุณก็ต้องดึงข้อมูลออกมา
นี่คือ use case ที่เจอบ่อยที่สุดในโลกจริง:
| Use Case | ใครต้องใช้ | ข้อมูลที่เกี่ยวข้อง |
|---|---|---|
| วิเคราะห์คู่แข่ง | ทีมการตลาด, ทีมคอนเทนต์ | จำนวนวิว, ความถี่ในการอัปโหลด, อัตราการมีส่วนร่วม |
| หาลูกค้าเป้าหมาย | ทีมขาย, งาน outreach แบบ B2B | ข้อมูลติดต่อช่อง, อีเมลธุรกิจในคำอธิบาย |
| วิจัยตลาด | Product manager, นักวิเคราะห์ | หัวข้อที่กำลังเป็นกระแส, sentiment ของผู้ชมจากคอมเมนต์ |
| วางกลยุทธ์คอนเทนต์ | YouTuber, เอเจนซี | ฟอร์แมตที่ทำผลงานดี, รูปแบบ title/tag ที่เหมาะสม |
| SEO / วิจัยคีย์เวิร์ด | ผู้เชี่ยวชาญ SEO | title วิดีโอ, tags, คำอธิบาย, สัญญาณการจัดอันดับ |
| ติดตามแบรนด์ | ทีม PR, ผู้จัดการแบรนด์ | การกล่าวถึงใน title วิดีโอ, คอมเมนต์, คำอธิบาย |
| งานวิจัยเชิงวิชาการ | นักวิจัย, data scientist | ชุดข้อมูลคอมเมนต์สำหรับ sentiment analysis (งานวิจัยปี 2025 ชิ้นหนึ่งทำความแม่นยำได้ 93.1% จากการ fine-tune BERT บนคอมเมนต์ YouTube 45,000 รายการ) |
ตัวอย่างเช่น การวิเคราะห์คู่แข่งระหว่าง DJI vs. GoPro vs. Insta360 พบว่า การเข้าถึงบน YouTube ของ DJI (390 ล้านวิว) สูงกว่าคู่แข่งทั้งสองรวมกัน — ซึ่งเป็น insight ที่มองไม่เห็นจากใน YouTube Studio
ทำไมใช้แค่ requests + BeautifulSoup ถึงดึง YouTube ไม่ได้
ก่อนจะไปดูวิธีที่ใช้งานได้ คุณต้องเข้าใจก่อนว่า ทำไม วิธีที่ดูตรงไปตรงมาถึงล้มเหลว เรื่องนี้ไม่ใช่แค่ทฤษฎี — แต่มันช่วยคุณประหยัดเวลาการ debug ไปได้หลายชั่วโมง
วิธีที่คนส่วนใหญ่นึกถึงจะหน้าตาประมาณนี้:
import requests
from bs4 import BeautifulSoup

response = requests.get("https://www.youtube.com/@somechannel/videos")
soup = BeautifulSoup(response.text, "html.parser")
videos = soup.find_all("a", id="video-title-link")
print(len(videos))  # 0 — ทุกครั้ง
ผลลัพธ์จะเป็นศูนย์เสมอ ตามที่ ScrapeOps' debugging playbook อธิบายไว้ว่า: "หน้าเว็บถูกโหลดแบบไดนามิก ซึ่ง requests lib ไม่รองรับ" ส่วน คู่มือสำหรับมือใหม่ของ Teclado พูดตรงกว่า: "ใช้ requests กับ BeautifulSoup อย่างเดียว คุณรัน JavaScript ไม่ได้"
บทวิเคราะห์ YouTube ของ Scrapfly ปี 2026 อธิบายกลไกไว้อย่างชัดเจน: YouTube ถูกสร้างเป็น Single Page Application (SPA) ดังนั้นเมื่อคุณส่ง HTTP request แบบพื้นฐาน คุณจะได้แค่ HTML shell แรกเริ่ม — เนื้อหาจริงยังไม่ได้ถูกเรนเดอร์ ข้อมูลวิดีโอถูกซ่อนไว้ใน JavaScript objects ที่เบราว์เซอร์จะเป็นตัวรันและ inject เข้า DOM เอง
ข่าวดีคือ YouTube ฝัง ข้อมูลที่ต้องใช้ไว้ใน HTML ดิบจริง เพียงแต่ไม่ได้อยู่ใน DOM element เท่านั้น — มันอยู่ใน JSON blob 2 ก้อนภายใน <script> tags:
ytInitialData— โครงสร้างหน้า รายการวิดีโอ เมตริกการมีส่วนร่วม และ continuation token สำหรับคอมเมนต์ytInitialPlayerResponse— metadata หลักของวิดีโอ เช่น title, description, duration, formats, captions
ทั้งสองส่วนนี้ดึงได้ด้วย requests.get() เพียงครั้งเดียว — ไม่ต้องเปิดเบราว์เซอร์ — ถ้าคุณรู้วิธีแยกและ parse มัน ซึ่งนั่นก็คือ Method 1 ด้านล่าง
4 วิธีดึงข้อมูล YouTube ด้วย Python: เทียบกันแบบชัด ๆ
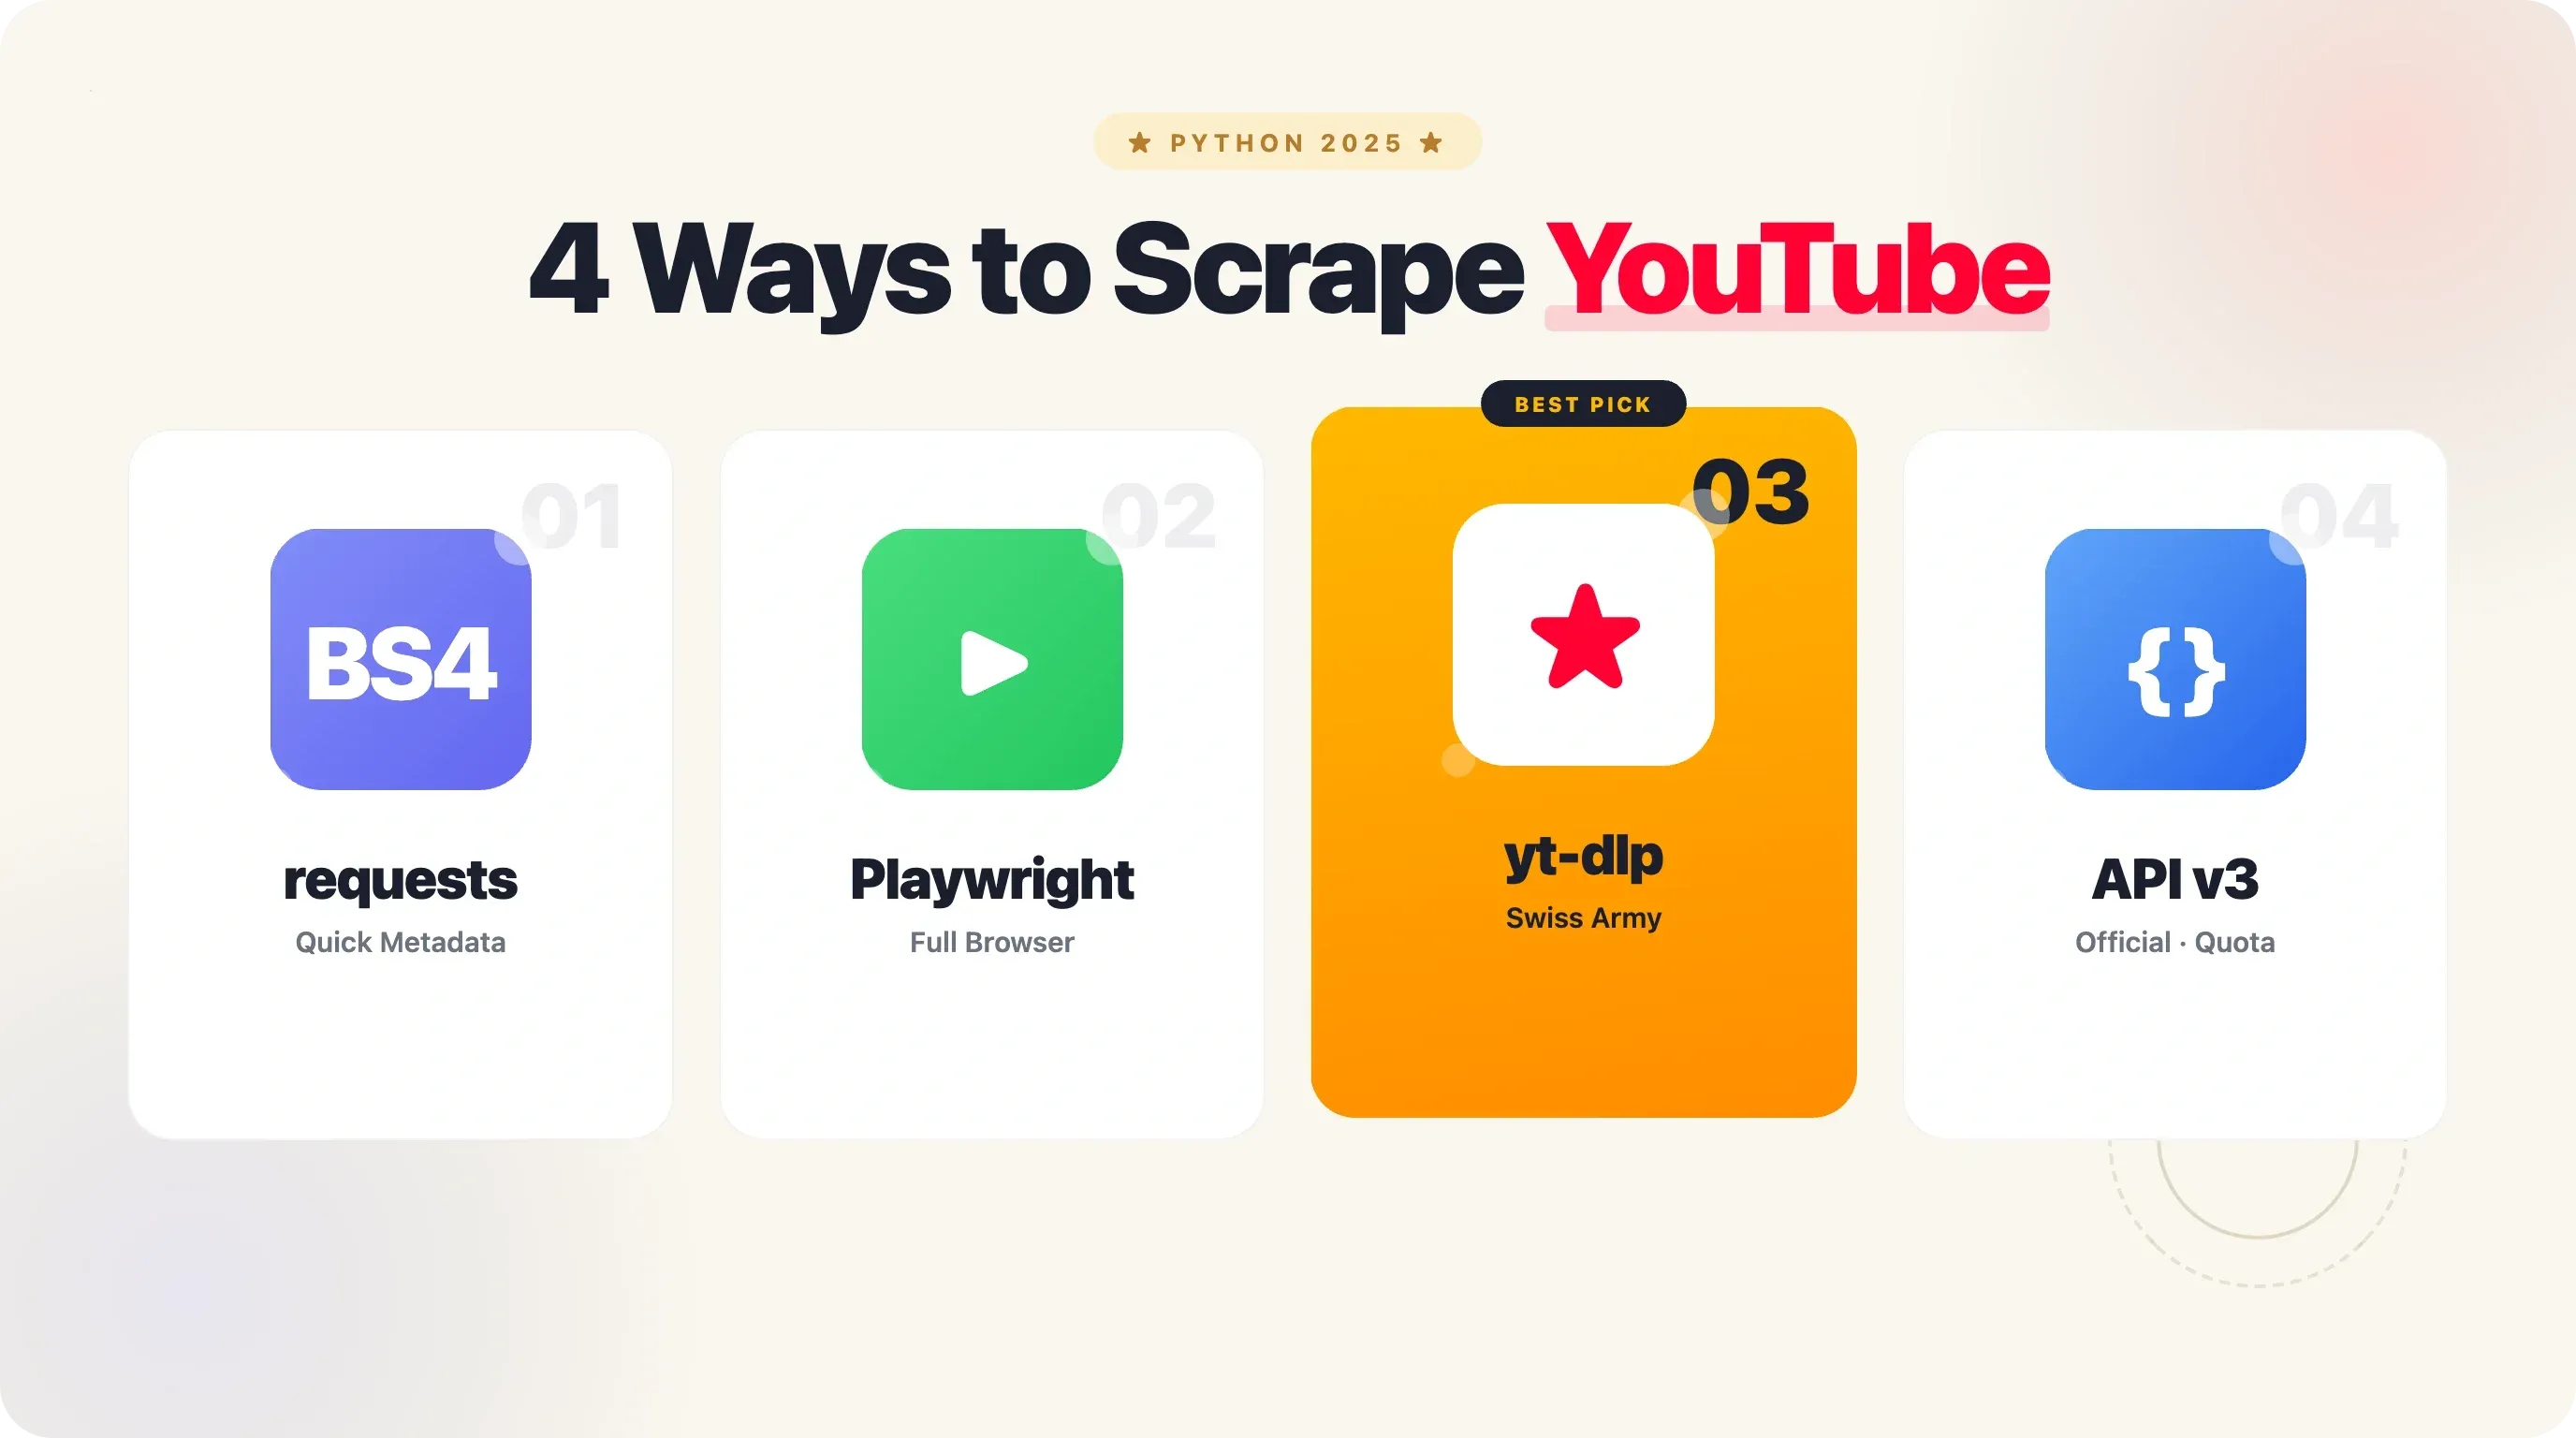
ก่อนจะลงรายละเอียดแต่ละวิธี นี่คือ decision matrix ที่ผมใช้เทียบทุกแบบแล้วว่าตัวไหนเหมาะกับงานจริงบ้าง
| เกณฑ์ | requests + BS4 (ytInitialData) | Selenium / Playwright | yt-dlp | YouTube Data API | ไม่ต้องเขียนโค้ด (Thunderbit) |
|---|---|---|---|---|---|
| ความซับซ้อนตอนตั้งค่า | ต่ำ | กลาง | ต่ำ | กลาง (ต้องมี API key) | ไม่มี |
| รองรับการเรนเดอร์ JS | บางส่วน (parse JSON) | ใช่ | ใช่ | N/A (API มีโครงสร้างอยู่แล้ว) | ใช่ |
| ความเร็ว | เร็ว | ช้า | เร็ว | เร็ว | เร็ว (cloud) |
| ความเสี่ยงโดนบอทบล็อก | กลาง | สูง | ต่ำ | ไม่มี | จัดการให้ |
| โควตา / rate limit | ไม่มี (แต่มีโอกาสโดนบล็อก IP) | ไม่มี (แต่มี detection) | ไม่มี | 10,000 units/วัน | ใช้เครดิต |
| ดึงคอมเมนต์ | ยาก | ทำได้แต่ซับซ้อน | มีในตัว | มีในตัว | แล้วแต่หน้า |
| transcripts | ไม่มี | ซับซ้อน | มี | ไม่มี | ไม่มี |
| เหมาะที่สุดสำหรับ | metadata แบบเร็ว ๆ | search result, หน้าไดนามิก | metadata + คอมเมนต์จำนวนมาก | ข้อมูลโครงสร้างชัดเจนในสเกลใหญ่ | คนไม่เขียนโค้ด, export เร็ว ๆ |
สรุปสั้น ๆ:
ข้อมูลอะไรจาก YouTube ที่ดึงได้จริง และใช้วิธีไหนได้บ้าง?
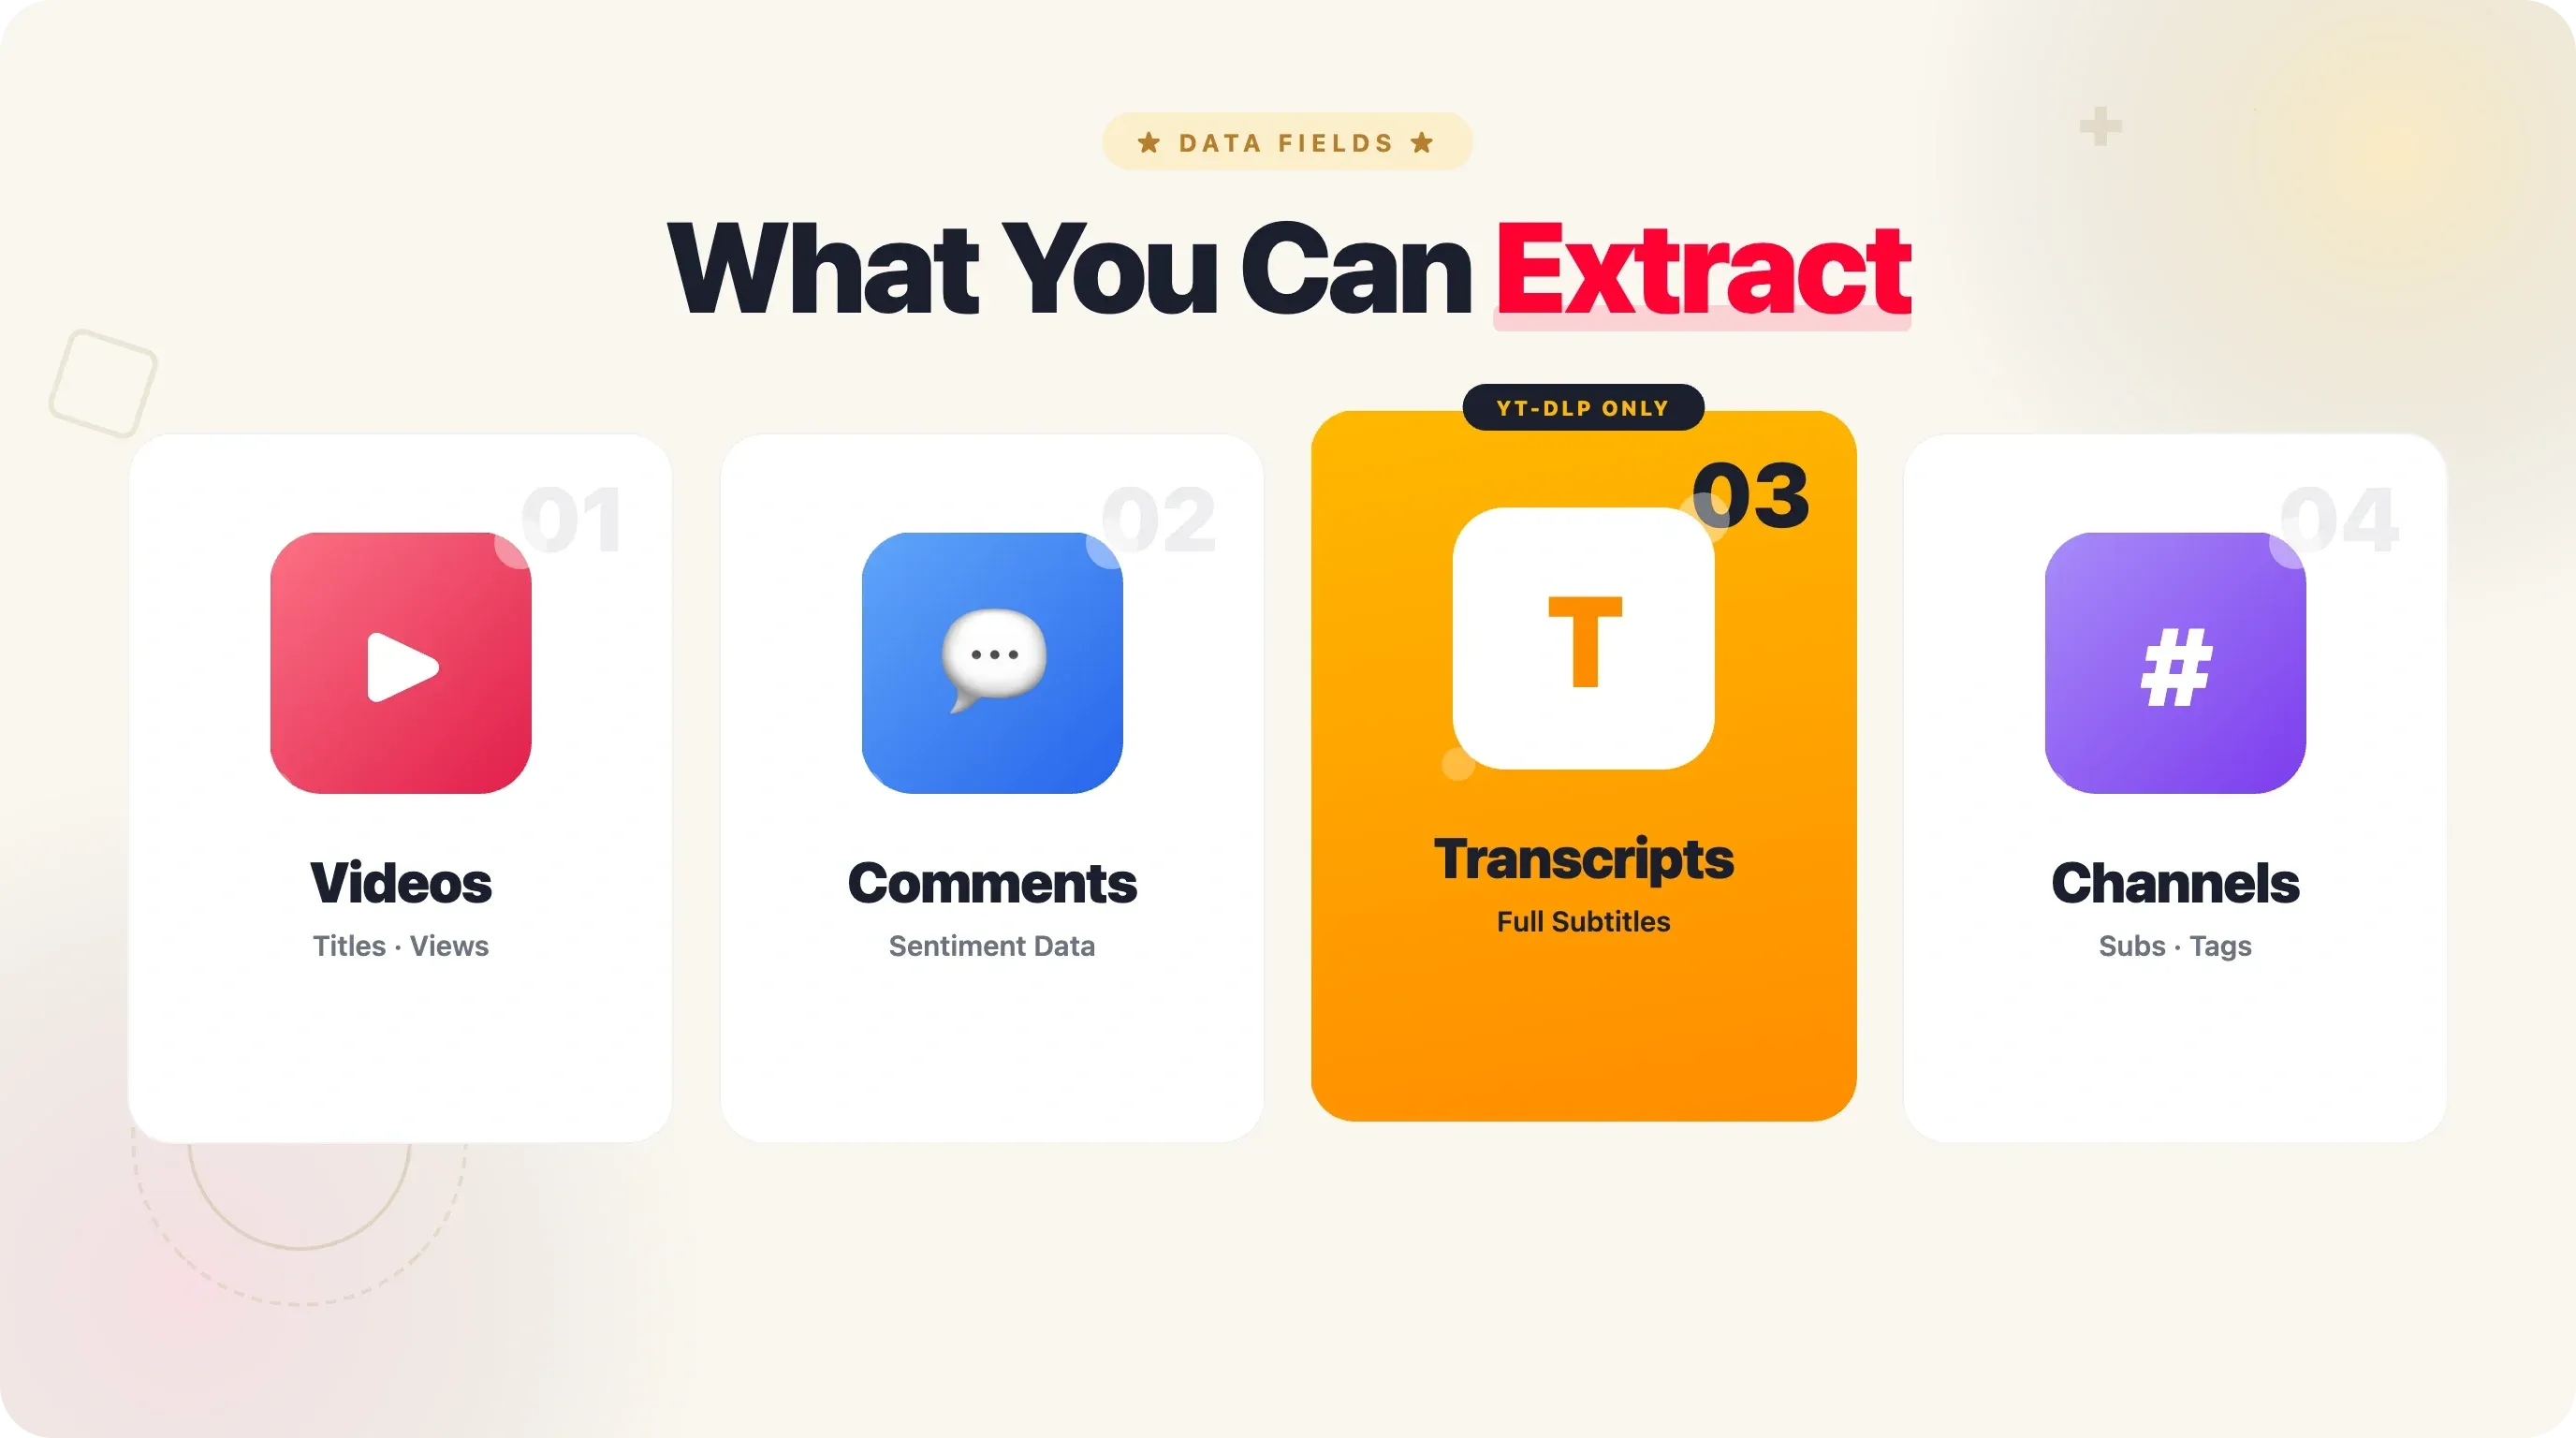
นี่คือ reference table ที่ผมอยากมีตั้งแต่เริ่มต้น ไม่มีวิธีใดวิธีหนึ่งที่ครอบคลุมทุก field ซึ่งเป็นเหตุผลว่าทำไมบทความนี้ถึงมี 4 วิธี
| ฟิลด์ข้อมูล | BS4 (ytInitialData) | Selenium/Playwright | yt-dlp | YouTube API | Thunderbit |
|---|---|---|---|---|---|
| ชื่อวิดีโอ | ✅ | ✅ | ✅ | ✅ | ✅ |
| จำนวนวิว | ✅ | ✅ | ✅ | ✅ | ✅ |
| จำนวนไลก์ | ⚠️ ไม่สม่ำเสมอ | ✅ | ✅ | ✅ | ✅ |
| คอมเมนต์ (ข้อความ) | ❌ | ⚠️ ซับซ้อน | ✅ | ✅ | ⚠️ |
| Transcript/คำบรรยาย | ❌ | ⚠️ | ✅ | ❌ | ❌ |
| Tags | ✅ | ✅ | ✅ | ✅ | ⚠️ |
| URL ของ thumbnail | ✅ | ✅ | ✅ | ✅ | ✅ |
| จำนวน subscriber ของช่อง | ⚠️ | ✅ | ✅ | ✅ | ✅ |
| วันที่อัปโหลด | ✅ | ✅ | ✅ | ✅ | ✅ |
| ระยะเวลาวิดีโอ | ✅ | ✅ | ✅ | ✅ | ✅ |
| ข้อมูลเฉพาะของ Shorts | ❌ | ⚠️ | ✅ | ⚠️ | ⚠️ |
เลือกวิธีตามแถวที่สำคัญกับงานของคุณ ถ้าคุณต้องการคอมเมนต์และ transcripts ให้ใช้ yt-dlp คือคำตอบที่ชัดเจน ถ้าคุณต้องการข้อมูลแบบมีโครงสร้างและสเกลปานกลาง API เหมาะที่สุด ถ้าคุณต้องการข้อมูลภายในสองนาที ให้อ่านต่อไปที่ส่วน Thunderbit
วิธีที่ 1: ดึงข้อมูล YouTube ด้วย Python ผ่าน requests + BeautifulSoup (parse ytInitialData)
วิธีนี้อาศัยข้อเท็จจริงที่ว่า YouTube ฝังข้อมูลของหน้าเว็บทั้งหมดเป็น JSON ไว้ใน HTML ดิบ คุณไม่ต้องใช้เบราว์เซอร์ แค่ต้องรู้ว่าควรหาอะไร
- ระดับความยาก: มือใหม่
- เวลาที่ใช้: ประมาณ 15 นาที
- สิ่งที่ต้องมี: Python 3.10+,
requests,beautifulsoup4
ขั้นตอนที่ 1: ส่ง GET request ไปยังหน้า YouTube
ส่ง request พร้อม User-Agent ที่ดูสมจริง Header มาตรฐาน python-requests/2.x มักโดนบล็อกทันที — คู่มือ headers ของ ScrapeOps ยืนยันว่านี่คือกับดักอันดับหนึ่งของมือใหม่
import requests

HEADERS = {
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/114.0.0.0 Safari/537.36",
    "Accept-Language": "en-US,en;q=0.9",
    "Cookie": "CONSENT=YES+cb",  # ข้ามหน้าขอ consent ของ EU
}

url = "https://www.youtube.com/@mkbhd/videos"
response = requests.get(url, headers=HEADERS)
print(response.status_code)  # ควรเป็น 200
Cookie CONSENT สำคัญมาก — ถ้าไม่มีมัน request จากโซน EU จะถูก redirect ไปที่ consent.youtube.com ซึ่งเป็น HTML ที่ไม่มี ytInitialData อยู่เลย
ขั้นตอนที่ 2: Parse HTML แล้วหา script ที่มี ytInitialData
ใช้ BeautifulSoup หรือ regex เพื่อหา <script> tag ที่มี var ytInitialData =:
import re
import json

# ดึง JSON ของ ytInitialData
match = re.search(
    r"var ytInitialData\s*=\s*({.*?});</script>",
    response.text,
    re.DOTALL
)
if match:
    data = json.loads(match.group(1))
    print("ดึง ytInitialData สำเร็จ")
else:
    print("ไม่พบ ytInitialData — ตรวจสอบ headers/cookies ของคุณ")
ข้อผิดพลาดที่พบบ่อยคือใช้ .*? แบบ non-greedy แล้วตั้งตัวปิดแค่ }; เพราะใน JSON จะมีตัวปิด object ซ้อนกันตลอด ทำให้ตัดข้อมูลก่อนครบ ต้องใช้ };</script> เป็นตัวจบเหมือนที่ Scrapfly scraper ปี 2026 ทำไว้ เพราะมันคือ assignment สุดท้ายใน script block นั้น
ขั้นตอนที่ 3: ไล่โครงสร้าง JSON เพื่อดึงข้อมูลวิดีโอ
JSON ของ YouTube ซ้อนลึกมาก แทนที่จะ hard-code path ที่พังทุกครั้งเมื่อ YouTube จัดโครงสร้างใหม่ (ซึ่งเกิดขึ้นบ่อย — issue tracker ของ yt-dlp บันทึกการเปลี่ยน format หลายครั้งตั้งแต่ปี 2023) ให้ใช้ recursive key search แทน:
def search_dict(partial, search_key):
    stack = [partial]
    while stack:
        cur = stack.pop()
        if isinstance(cur, dict):
            for k, v in cur.items():
                if k == search_key:
                    yield v
                else:
                    stack.append(v)
        elif isinstance(cur, list):
            stack.extend(cur)

# ดึงข้อมูลวิดีโอจากหน้า channel
videos = []
for vr in search_dict(data, "videoRenderer"):
    videos.append({
        "video_id": vr.get("videoId"),
        "title": vr["title"]["runs"][0]["text"],
        "views": vr.get("viewCountText", {}).get("simpleText", "N/A"),
        "published": vr.get("publishedTimeText", {}).get("simpleText", "N/A"),
    })

print(f"พบวิดีโอ {len(videos)} รายการ")
for v in videos[:5]:
    print(f"  {v['title']} — {v['views']}")
วิธี recursive แบบนี้คือแนวทางที่ scrapetube, yt-dlp และ Scrapfly ใช้ร่วมกันในที่สุด — เพราะมันทนต่อการ restructure JSON ของ YouTube ได้ดีกว่า
ขั้นตอนที่ 4: Export ข้อมูลเป็น CSV หรือ Excel
import csv

with open("youtube_videos.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["video_id", "title", "views", "published"])
    writer.writeheader()
    writer.writerows(videos)

print("ส่งออกข้อมูลไปยัง youtube_videos.csv แล้ว")
ควรใช้เมื่อไร และไม่ควรใช้เมื่อไร
เหมาะสำหรับ: ดึง metadata แบบเร็ว ๆ จาก channel หรือ video ไม่กี่หน้า, เครื่องมือ SEO แบบเบา ๆ, งานวิเคราะห์ครั้งเดียวที่ต้องการ title, views และวันที่อัปโหลด
ข้อจำกัด: โครงสร้าง JSON เปลี่ยนบ่อย — ตัวอย่างที่เคยพังมีทั้ง refactor ปุ่มไลก์ (ปี 2023: toggleButtonRenderer → segmentedLikeDislikeButtonViewModel), refactor ส่วนคำอธิบาย (ปี 2023: description.runs[] → attributedDescription.content), และการออกแบบแท็บ Videos ของ channel ใหม่ (ปี 2022–2023: gridRenderer → richGridRenderer). IP จาก datacenter มักถูก soft-block หลัง 50–200 request ไม่มีคอมเมนต์ ไม่มี transcripts
วิธีที่ 2: ดึงข้อมูล YouTube ด้วย Python ผ่าน Selenium หรือ Playwright
ถ้าคุณต้องโต้ตอบกับหน้าเว็บ — เลื่อนดูผลค้นหา คลิกแท็บ ขยายคำอธิบาย — การทำ browser automation คือคำตอบ
- ระดับความยาก: กลาง
- เวลาที่ใช้: ประมาณ 30 นาที
- สิ่งที่ต้องมี: Python 3.10+, Playwright (
pip install playwright && playwright install) หรือ Selenium + ChromeDriver
ผมแนะนำ Playwright มากกว่า Selenium สำหรับโปรเจกต์ใหม่ ๆ เบนช์มาร์กของ TestDino ปี 2026 แสดงให้เห็นว่า Playwright เร็วกว่า Selenium ประมาณ 1.85 เท่าต่อ action, ใช้หน่วยความจำน้อยลงราว 2.1 เท่า และรองรับ parallel ได้มากกว่าประมาณ 4 เท่า Playwright ใช้ WebSocket แบบถาวรผ่าน Chrome DevTools Protocol ขณะที่ Selenium ใช้ WebDriver ผ่าน HTTP จึงมีชั้นแปลคำสั่งเพิ่มขึ้นทุกครั้ง
ขั้นตอนที่ 1: ตั้งค่า Playwright
pip install playwright
playwright install chromium
from playwright.sync_api import sync_playwright

pw = sync_playwright().start()
browser = pw.chromium.launch(headless=False)  # เปิดแบบมีหน้าต่างช่วยลดการตรวจจับบางส่วน
context = browser.new_context()

# ใส่ consent cookie ล่วงหน้าเพื่อข้ามหน้าของ EU
context.add_cookies([{
    "name": "SOCS",
    "value": "CAISNQgDEitib3FfaWRlbnRpdHlmcm9udGVuZHVpc2VydmVyXzIwMjMwODI5LjA3X3AxGgJlbiACGgYIgJnPpwY",
    "domain": ".youtube.com",
    "path": "/",
}])

page = context.new_page()
ขั้นตอนที่ 2: เปิดหน้า YouTube แล้วรอให้เนื้อหาโหลด
page.goto("https://www.youtube.com/@mkbhd/videos")
page.wait_for_selector("a#video-title-link", timeout=15000)
print("หน้าโหลดแล้ว — เห็น video elements แล้ว")
ถ้าคุณกำลัง scrape search results ให้เปลี่ยนไปใช้ https://www.youtube.com/results?search_query=your+query
ขั้นตอนที่ 3: จัดการ infinite scroll เพื่อโหลดวิดีโอเพิ่ม
YouTube ใช้ infinite scroll บนหน้า channel และ search results นี่คือ scrollHeight loop แบบมาตรฐาน ที่ปรับมาจาก คู่มือ scroll ของ Scrapfly:
prev_height = -1
max_scrolls = 20  # จำกัดไว้ — channel ที่มี 10,000 วิดีโอจะเลื่อนไม่จบ
scroll_count = 0

while scroll_count < max_scrolls:
    page.evaluate("window.scrollTo(0, document.body.scrollHeight)")
    page.wait_for_timeout(1500)  # รอให้เนื้อหาใหม่โหลด
    new_height = page.evaluate("document.body.scrollHeight")
    if new_height == prev_height:
        break  # ไม่มีเนื้อหาใหม่โหลดเพิ่ม
    prev_height = new_height
    scroll_count += 1

print(f"เลื่อนทั้งหมด {scroll_count} ครั้ง")
ขั้นตอนที่ 4: ดึงข้อมูลวิดีโอจากหน้าเว็บที่เรนเดอร์แล้ว
video_elements = page.query_selector_all("a#video-title-link")
videos = []

for el in video_elements:
    title = el.inner_text()
    href = el.get_attribute("href")
    video_id = href.split("v=")[-1] if href else None
    videos.append({"title": title, "video_id": video_id, "url": f"https://www.youtube.com{href}"})

print(f"ดึงวิดีโอได้ {len(videos)} รายการ")
ถ้าต้องการ view count และวันที่อัปโหลด คุณจะต้องดึง element ที่อยู่ข้างเคียงมาใช้ด้วย คู่มือของ Crawlee ปี 2025 เตือนไว้ว่า id="video-title-link" ไม่ได้ใช้ได้กับทุกหน้า — YouTube มีหลาย page variant วิธี fallback ที่ทนกว่า คือ a[href*="watch"]
ขั้นตอนที่ 5: Export เป็น CSV หรือ Google Sheets
import csv

with open("youtube_playwright.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["title", "video_id", "url"])
    writer.writeheader()
    writer.writerows(videos)

browser.close()
pw.stop()
ควรใช้เมื่อไร และไม่ควรใช้เมื่อไร
เหมาะสำหรับ: ดึง search results, โต้ตอบกับองค์ประกอบที่ไดนามิก (คลิกแท็บ, ขยายคำอธิบาย), งานที่ต้องการ DOM ที่เรนเดอร์ครบ
ข้อจำกัด: ช้า (~1.5–3 วินาทีต่อวิดีโอใน flow แบบ scroll-extract) ความเสี่ยงโดนบอทตรวจจับสูง — Selenium แบบมาตรฐานตั้ง navigator.webdriver === true ซึ่ง การตรวจจับฝั่ง JS อ่านออกทันที ใช้ทรัพยากรเยอะ (browser 1 instance กิน RAM ราว 200–500 MB) ถ้าจะดึง 100 วิดีโอ อาจใช้เวลา 3–8 นาที แทนที่จะเป็นไม่กี่วินาทีแบบ yt-dlp
วิธีที่ 3: ดึงข้อมูล YouTube ด้วย Python ผ่าน yt-dlp
yt-dlp คือ Swiss Army knife ของการ scrape YouTube เป็น community fork ของ youtube-dl ที่มี ดาวบน GitHub มากกว่า 157,000 ดวง มี nightly release ที่อัปเดตตลอด และรองรับ metadata, คอมเมนต์, transcripts และการดึงข้อมูลแบบ batch ในตัว — ทั้งหมดนี้ไม่ต้องใช้เบราว์เซอร์หรือ API key
- ระดับความยาก: มือใหม่ถึงกลาง
- เวลาที่ใช้: ประมาณ 10 นาที
- สิ่งที่ต้องมี: Python 3.10+,
pip install yt-dlp
ขั้นตอนที่ 1: ติดตั้ง yt-dlp
pip install yt-dlp
ไม่ต้องมี browser driver, ไม่ต้องมี API key, ไม่ต้องมี config file
ขั้นตอนที่ 2: ดึง metadata ของวิดีโอโดยไม่ต้องดาวน์โหลดไฟล์
import yt_dlp

opts = {
    "quiet": True,
    "skip_download": True,      # ไม่เอาไฟล์วิดีโอ — เอาแค่ metadata
    "no_warnings": True,
}

with yt_dlp.YoutubeDL(opts) as ydl:
    info = ydl.extract_info(
        "https://www.youtube.com/watch?v=dQw4w9WgXcQ",
        download=False
    )

print(f"Title: {info['title']}")
print(f"Views: {info['view_count']:,}")
print(f"Likes: {info.get('like_count', 'N/A')}")
print(f"Duration: {info['duration']}s")
print(f"Upload date: {info['upload_date']}")
print(f"Channel: {info['channel']} ({info.get('channel_follower_count', 'N/A')} subs)")
print(f"Tags: {info.get('tags', [])[:5]}")
โดยทั่วไป extract_info จะคืนฟิลด์ประมาณ 80–120 รายการขึ้นอยู่กับสถานะของวิดีโอ: id, title, channel, channel_id, channel_follower_count, view_count, like_count, comment_count, upload_date, duration, tags, categories, description, thumbnails, is_live, availability, automatic_captions, subtitles, chapters, heatmap และอื่น ๆ
ขั้นตอนที่ 3: ดึงคอมเมนต์จากวิดีโอ YouTube
opts = {
    "quiet": True,
    "skip_download": True,
    "getcomments": True,
    "extractor_args": {
        "youtube": {
            "max_comments": ["200", "50", "50", "10"],  # total, parents, replies-per, replies-total
            "comment_sort": ["top"],
        }
    },
}

with yt_dlp.YoutubeDL(opts) as ydl:
    info = ydl.extract_info(
        "https://www.youtube.com/watch?v=dQw4w9WgXcQ",
        download=False
    )

comments = info.get("comments", [])
print(f"ดึงคอมเมนต์มาได้ {len(comments)} รายการ")
for c in comments[:3]:
    print(f"  [{c.get('like_count', 0)} likes] {c['author']}: {c['text'][:80]}...")
การดึงคอมเมนต์ค่อนข้างช้า issue #3532 ของ yt-dlp รายงานว่าความเร็วตอนดึงคอมเมนต์อยู่ราว 30 KB/s — วิดีโอที่มี 100,000 คอมเมนต์อาจใช้เวลาหลายชั่วโมง issue #11849 ยังบันทึกกรณีที่ format URL หมดอายุ (~6 ชั่วโมง) ก่อน pagination คอมเมนต์จะจบ ให้ตั้ง max_comments ให้เข้มงวดสำหรับวิดีโอที่มีขนาดใหญ่
ขั้นตอนที่ 4: ดึง transcripts และ subtitles
ทั้ง YouTube Data API และการ parse ด้วย BS4 ไม่สามารถให้ transcript แบบเต็มได้ นี่คือจุดเด่นเฉพาะของ yt-dlp
opts = {
    "quiet": True,
    "skip_download": True,
    "writesubtitles": True,
    "writeautomaticsub": True,
    "subtitleslangs": ["en", "en-orig"],
    "subtitlesformat": "json3",   # parse ได้ด้วยเครื่อง: start/dur เป็น ms + text
    "outtmpl": "%(id)s.%(ext)s",
}

with yt_dlp.YoutubeDL(opts) as ydl:
    info = ydl.extract_info(
        "https://www.youtube.com/watch?v=dQw4w9WgXcQ",
        download=False
    )

# เข้าถึง subtitle data โดยตรงจาก info dict
auto_captions = info.get("automatic_captions", {})
manual_subs = info.get("subtitles", {})
print(f"ภาษา auto-caption: {list(auto_captions.keys())[:10]}")
print(f"ภาษาคำบรรยายแบบ manual: {list(manual_subs.keys())}")
ฟอร์แมต json3 เหมาะที่สุดสำหรับการ parse ด้วยเครื่อง — แต่ละ segment มี start/dur เป็น milliseconds พร้อม text runs language code ใช้แบบ BCP-47 (en, en-US, zh-Hans, ja, es)
ขั้นตอนที่ 5: ดึงข้อมูลเป็นชุดจากหลายวิดีโอหรือทั้งช่อง
opts = {
    "quiet": True,
    "skip_download": True,
    "extract_flat": "in_playlist",  # เร็ว — เอาแค่ video ID กับ title
    "sleep_interval": 2,
    "max_sleep_interval": 6,
}

with yt_dlp.YoutubeDL(opts) as ydl:
    info = ydl.extract_info(
        "https://www.youtube.com/@mkbhd/videos",
        download=False
    )

entries = info.get("entries", [])
print(f"พบวิดีโอ {len(entries)} รายการในช่อง")
for e in entries[:5]:
    print(f"  {e.get('title', 'N/A')} — {e.get('id')}")
ส่ง channel URL, playlist URL หรือแม้แต่ search query (ytsearch10:python scraping) ไปให้ yt-dlp ได้เลย แล้วมันจะจัดการ pagination ให้ภายใน
ควรใช้เมื่อไร และไม่ควรใช้เมื่อไร
เหมาะสำหรับ: ดึง metadata จำนวนมาก, คอมเมนต์, transcripts, ดาวน์โหลดวิดีโอ, scrape ทั้งช่องที่ต้องการ field ครบ ๆ
ข้อจำกัด: ไม่เหมาะกับการ scrape หน้า search results เท่า Selenium/Playwright สงคราม anti-bot ระหว่างปี 2024–2026 ทำให้การใช้งาน yt-dlp ในสเกลใหญ่ซับซ้อนขึ้น YouTube บาง client เริ่มบังคับ BotGuard attestation และ PO Tokens แล้ว สำหรับ production ให้ติดตั้ง plugin bgutil-ytdlp-pot-provider และใช้ --cookies-from-browser chrome (ด้วยบัญชี throwaway — ทีม yt-dlp เตือนว่าถ้าใช้คุกกี้จากบัญชี Google จริง อาจโดนแบนได้)
วิธีที่ 4: ดึงข้อมูล YouTube ด้วย Python ผ่าน YouTube Data API
YouTube Data API v3 แบบทางการคือวิธีที่เชื่อถือได้และมีโครงสร้างที่สุดในการเข้าถึงข้อมูล YouTube response เป็น JSON ที่สะอาด ฟิลด์มีเอกสารกำกับชัด และไม่มีเกมแมวไล่จับหนูเรื่อง anti-bot แต่มีเงื่อนไขสำคัญที่หลายบทความชอบพูดข้ามไป: ระบบ quota
- ระดับความยาก: กลาง
- เวลาที่ใช้: ประมาณ 20 นาที (รวมการตั้ง API key)
- สิ่งที่ต้องมี: Python 3.10+, Google Cloud project,
pip install google-api-python-client
ขั้นตอนที่ 1: สร้าง YouTube Data API Key
- ไปที่ Google Cloud Console
- สร้างโปรเจกต์ใหม่ หรือเลือกโปรเจกต์ที่มีอยู่
- ไปที่ APIs & Services → Library → ค้นหา "YouTube Data API v3" → กด Enable
- ไปที่ APIs & Services → Credentials → Create Credentials → API Key
- คัดลอก key ไว้ — จะใช้ในโค้ดด้านล่าง
ขั้นตอนที่ 2: เรียก API ครั้งแรก
from googleapiclient.discovery import build

API_KEY = "YOUR_API_KEY_HERE"
youtube = build("youtube", "v3", developerKey=API_KEY)

# ดึงรายละเอียดของวิดีโอหนึ่งรายการ
response = youtube.videos().list(
    part="snippet,statistics,contentDetails",
    id="dQw4w9WgXcQ"
).execute()

video = response["items"][0]
print(f"Title: {video['snippet']['title']}")
print(f"Views: {video['statistics']['viewCount']}")
print(f"Likes: {video['statistics'].get('likeCount', 'hidden')}")
print(f"Comments: {video['statistics'].get('commentCount', 'disabled')}")
print(f"Duration: {video['contentDetails']['duration']}")
print(f"Tags: {video['snippet'].get('tags', [])[:5]}")
Response สะอาด มีชนิดข้อมูลชัด และมีเอกสารกำกับ ไม่ต้องไปงมโครงสร้าง JSON เอง
ขั้นตอนที่ 3: ดึงรายละเอียดวิดีโอ ข้อมูลช่อง และคอมเมนต์
# ค้นหาวิดีโอ
search_response = youtube.search().list(
    part="snippet",
    q="python web scraping tutorial",
    type="video",
    maxResults=10,
    order="viewCount"
).execute()

for item in search_response["items"]:
    print(f"  {item['snippet']['title']} — {item['id']['videoId']}")

# ดึงคอมเมนต์
comments_response = youtube.commentThreads().list(
    part="snippet",
    videoId="dQw4w9WgXcQ",
    maxResults=20,
    order="relevance"
).execute()

for item in comments_response["items"]:
    comment = item["snippet"]["topLevelComment"]["snippet"]
    print(f"  [{comment['likeCount']} likes] {comment['authorDisplayName']}: {comment['textDisplay'][:80]}")
ความจริงเรื่อง quota ของ YouTube API ที่ไม่มีใครบอกคุณ
นี่คือส่วนที่แยกบทความที่ใช้ได้จริงออกจาก tutorial แบบก็อปปี้วาง ค่าเริ่มต้นคือ 10,000 quota units ต่อวัน และรีเซ็ตตอนเที่ยงคืนตามเวลา Pacific นี่คือค่าใช้จ่ายของแต่ละ call:
| API Endpoint | ค่า quota ต่อ call | ผลลัพธ์สูงสุดต่อ call |
|---|---|---|
search.list | 100 units | 50 results |
videos.list | 1 unit | 50 video IDs (batch ได้) |
channels.list | 1 unit | 50 channel IDs |
commentThreads.list | 1 unit | 100 comments |
captions.list | 50 units | N/A |
ลองคำนวณดู ถ้าคุณต้องการ scrape search results 1,000 รายการ:
- Search calls: 1,000 results ÷ 50 ต่อหน้า = 20 calls × 100 units = 2,000 units (20% ของโควตารายวัน — หายไปแล้ว)
- ดึงรายละเอียดวิดีโอ 1,000 รายการนั้น: 1,000 IDs ÷ 50 ต่อ batch = 20 calls × 1 unit = 20 units (ถูกมาก —
videos.listแบบ batch คือพระเอกของงานนี้) - คอมเมนต์ของวิดีโอ 1,000 รายการ (สมมติละ 1 หน้า): 1,000 calls × 1 unit = 1,000 units
รวมทั้งหมดประมาณ 3,020 units สำหรับงาน scrape ขนาดไม่ใหญ่มาก แต่ถ้าวิดีโอเหล่านั้นมีเธรดคอมเมนต์ลึก ๆ (50+ หน้าแต่ละอัน) คุณจะใช้โควตาที่เหลืออีก 7,000 units หมดอย่างรวดเร็ว วิดีโอที่มี 50,000 คอมเมนต์ = ประมาณ 500 หน้า = 500 units ถ้า scrape วิดีโอแบบนี้ 20 รายการ ก็หมดวันพอดี
กระบวนการขอเพิ่ม quota ตาม ลิงก์ขอเพิ่มโควตา ต้องผ่านการตรวจ compliance เต็มรูปแบบ: URL นโยบายความเป็นส่วนตัว, URL ข้อกำหนดการใช้งาน, วิดีโอสาธิตการใช้งานแอป และเหตุผลเชิงตัวเลขที่อธิบาย quota reports จากชุมชนบอกว่าปกติ Google ใช้เวลา 3–5 วันทำการตอบกลับ แต่การอนุมัติเต็มรูปแบบอาจใช้เวลาหลายสัปดาห์ถึงหลายเดือน และหลายคำขอก็ถูกปฏิเสธ โดยเฉพาะเคสแนว “อยากได้ข้อมูลมากขึ้นเพื่อการวิเคราะห์”
ควรใช้ API เมื่อ: ต้องการงานขนาดเล็กถึงกลาง, ต้องการข้อมูลที่มีโครงสร้างและเชื่อถือได้, คอมเมนต์และสถิติของ channel สำคัญ, และคุณรับข้อจำกัด quota ได้
เมื่อไหร่การ scrape เหมาะกว่า: โปรเจกต์สเกลใหญ่ (>10K videos/วัน), ต้องการ field ที่ API ไม่เปิดให้ (transcripts แบบเต็ม — captions.download ต้องใช้ OAuth + สิทธิ์จากเจ้าของวิดีโอ), หรือคุณต้องการมากกว่า 500 search results ต่อ query (นี่คือ hard limit ของ API ถึงแม้ totalResults จะดูมากกว่านั้น)
ทางลัดแบบไม่ต้องเขียนโค้ด: ดึงข้อมูล YouTube ด้วย Thunderbit
ถ้าคุณต้องใช้ Python เพื่อป้อนข้อมูลเข้าท่อ pipeline ก็ใช้วิธี 1–4 ด้านบน แต่ถ้าคุณต้องการข้อมูล YouTube ภายใน 2 นาที — อาจเป็นนักการตลาดที่ดึงสถิติของคู่แข่ง หรือเป็นนักพัฒนาที่แค่อยากได้ข้อมูลเร็ว ๆ โดยไม่ต้องตั้งค่าโปรเจกต์ — ยังมีทางที่เร็วกว่า
Thunderbit คือ Chrome extension แบบ AI web scraper ที่เราสร้างขึ้นมาสำหรับเคสที่การเขียนโค้ดเยอะเกินความจำเป็น มันทำงานบนหน้า YouTube ได้โดยตรงในเบราว์เซอร์ของคุณ
วิธีดึงข้อมูล YouTube ด้วย Thunderbit ใน 3 ขั้นตอน
ขั้นตอนที่ 1: ติดตั้ง Thunderbit Chrome extension แล้วเปิดหน้า channel, หน้า search results หรือหน้า video ของ YouTube
ขั้นตอนที่ 2: คลิก "AI Suggest Fields" ในแถบด้านข้างของ Thunderbit AI จะอ่านหน้าเว็บและแนะนำคอลัมน์ เช่น title วิดีโอ, views, วันที่อัปโหลด, ระยะเวลา, ชื่อช่อง และ URL ของ thumbnail คุณสามารถเพิ่ม ลบ หรือเปลี่ยนชื่อคอลัมน์ได้ตามต้องการ
ขั้นตอนที่ 3: คลิก "Scrape" แล้ว export ไปยัง Google Sheets, Excel, CSV, Airtable หรือ Notion ข้อมูลจะถูกจัดลงในตารางที่สะอาดพร้อมใช้งานทันที
ลองใช้ Thunderbit สำหรับการดึงข้อมูล YouTube
เหมาะกับใคร
- นักการตลาด ที่ต้องการข้อมูลช่องคู่แข่งแต่ไม่เขียนโค้ด
- นักพัฒนา ที่อยากดึงข้อมูลเร็ว ๆ โดยไม่ต้องตั้ง virtual environment และติดตั้ง dependencies
- ใครก็ตามที่ชนกำแพง anti-bot — Thunderbit ดึงข้อมูลใน browser session ที่คุณล็อกอินอยู่ จึงใช้คุกกี้และ PO tokens ของคุณต่อได้ ช่วยเลี่ยงปัญหาการบล็อกที่มักเกิดกับ server-side scrapers
- Thunderbit ยังใช้ subpage scraping เพื่อเข้าไปทีละหน้าวิดีโอและเติมข้อมูลลงตารางให้ละเอียดขึ้นได้อีก เช่น like count, description, tags
ถ้าอยากดูรายละเอียดว่า Thunderbit จัดการกับ YouTube โดยเฉพาะอย่างไร ลองดู Thunderbit YouTube Channel Scraper template และ Thunderbit YouTube channel
เคล็ดลับดึงข้อมูล YouTube ด้วย Python ไม่ให้โดนบล็อก
เคล็ดลับเหล่านี้ใช้ได้กับทั้ง 4 วิธีใน Python YouTube มีมาตรการ anti-bot ที่ ScrapeOps ให้ความยาก 6/10 โดยมีสัญญาณหลัก 3 อย่าง: การวิเคราะห์พฤติกรรม IP, ความจำเป็นในการรัน JS และโครงสร้าง HTML ที่เปลี่ยนบ่อย
ใช้ได้กับทุกวิธี:
- สลับทั้ง User-Agent และ header ชุดเต็ม —
Accept,Accept-Language,Sec-CH-UAclient hints ต้องสอดคล้องกับ UA ที่ประกาศไว้ คู่มือปี 2026 ของ ScraperAPI มีรายการล่าสุด - เว้นช่วงสุ่ม 2–8 วินาทีระหว่าง request อย่าใช้ interval ตายตัว เพราะมันเป็นสัญญาณของ bot
- ใช้ residential proxy สำหรับงานที่มากกว่าการเปิดไม่กี่หน้า Datacenter IP (AWS, GCP, Hetzner) แทบใช้ไม่ได้แล้วสำหรับการ scrape YouTube ในปี 2025–2026
- สลับ session + IP ไปพร้อมกัน YouTube ผูก session กับ IP และถ้า cookie เดิมโผล่บน IP คนละตัวจะดูน่าสงสัย
สำหรับ requests + BS4: ใส่ cookie CONSENT=YES+cb ถ้าไม่มี EU requests จะถูก redirect ไปยังหน้า consent ที่ไม่มีข้อมูล
สำหรับ Selenium/Playwright: บนเซิร์ฟเวอร์ Linux ให้รันแบบ headful ผ่าน xvfb แทน --headless=new เพราะ headless Chrome ยังทิ้ง fingerprint บางอย่างให้ระบบตรวจจับได้ ควรพิจารณาใช้ playwright-stealth ที่ช่วยหลบได้ราว 17 แบบ
สำหรับ yt-dlp: ใช้ตัวเลือก sleep_interval และ max_sleep_interval ติดตั้ง plugin bgutil-ytdlp-pot-provider สำหรับสร้าง PO Token และใช้ --cookies-from-browser chrome กับบัญชีที่ไม่ใช้งานหลัก
สำหรับ API: ติดตามการใช้ quota ผ่าน Google Cloud Console และ batch request ให้มีประสิทธิภาพ videos.list เพียง call เดียวที่ส่ง 50 IDs คั่นด้วย comma มีค่าแค่ 1 unit — ใช้ให้คุ้ม
สำหรับ Thunderbit: ระบบจัดการ anti-bot ให้โดยอัตโนมัติ เพราะการ scrape เกิดขึ้นใน browser session ของคุณ คุณแค่ทำงานเหมือนที่ปกติทำด้วยมือเท่านั้น
การ scrape YouTube ด้วย Python ถูกกฎหมายไหม?
คำตอบคือขึ้นอยู่กับว่าคุณ scrape อะไร ใช้อย่างไร และเอาข้อมูลไปทำอะไรต่อ
ภูมิทัศน์ทางกฎหมายเปลี่ยนไปในปี 2024 กับคดี Meta Platforms v. Bright Data (N.D. Cal., มกราคม 2024) ซึ่ง Judge Chen ตัดสินว่า ToS ของ Meta ห้ามเฉพาะการ scrape ตอนล็อกอินอยู่ ไม่ได้ห้ามการ scrape ข้อมูลสาธารณะตอนล็อกเอาต์ หลังคำตัดสินนี้ การ scrape ข้อมูลที่เข้าถึงได้สาธารณะจึงถือว่า "เสี่ยงน้อยลงมาก" ในอีกด้านหนึ่ง คดี hiQ v. LinkedIn จบลงด้วยคำตัดสินให้ hiQ ต้องจ่าย $500,000 จากการละเมิด ToS, การฝ่าฝืน CFAA (ใช้บัญชีปลอม) และ trespass to chattels — พร้อมคำสั่งห้ามถาวร
YouTube เองมี Terms of Service ที่ระบุชัด: "คุณไม่ได้รับอนุญาตให้เข้าถึงบริการนี้ด้วยวิธีอัตโนมัติ (เช่น robots, botnets หรือ scrapers)" ยกเว้นมีหนังสืออนุญาตล่วงหน้าหรือกฎหมายที่เกี่ยวข้องอนุญาตไว้ วิธีที่ได้รับการรับรองอย่างเป็นทางการคือ YouTube Data API
แนวทางปฏิบัติแบบเป็นรูปธรรม:
- การ scrape ข้อมูลสาธารณะเพื่อการวิจัยส่วนตัวหรือวิเคราะห์ที่ไม่ใช่เชิงพาณิชย์ มักมีความเสี่ยงต่ำกว่า
- API คือทางที่ปลอดภัยที่สุด เพราะได้รับอนุญาตอย่างชัดเจน
- หลีกเลี่ยงการ scrape คอนเทนต์ส่วนตัวหรือคอนเทนต์ที่ต้องล็อกอิน, ดาวน์โหลดวิดีโอที่มีลิขสิทธิ์ไปแจกต่อ, หรือทำผิด GDPR ด้วยข้อมูลส่วนบุคคลจากคอมเมนต์
- คอมเมนต์ YouTube ถือเป็นข้อมูลส่วนบุคคลภายใต้ GDPR Art. 4(1) — ต้องระมัดระวังข้อมูลของเจ้าของข้อมูลใน EU
- งาน scrape เชิงพาณิชย์ควรปรึกษาทีมกฎหมาย
ทั้งหมดนี้ไม่ใช่คำแนะนำทางกฎหมาย สถานการณ์ยังเปลี่ยนเร็ว — มีคลื่นคดี DMCA §1201 จากครีเอเตอร์ฟ้องบริษัท AI ที่ scrape YouTube เพื่อเอาไปใช้ฝึกโมเดล ซึ่งกำลังเปลี่ยนภูมิทัศน์ในปี 2025–2026
ควรใช้วิธีไหนในการดึงข้อมูล YouTube ด้วย Python?
คู่มือช่วยตัดสินใจ:
- ต้องการ metadata เร็ว ๆ จากไม่กี่หน้า? → วิธีที่ 1 (requests + BS4). เร็ว เบา ไม่ต้องติดตั้งอะไรเพิ่มนอกจาก
requestsและbeautifulsoup4 - ต้อง scrape search results หรือโต้ตอบกับหน้าไดนามิก? → วิธีที่ 2 (Selenium/Playwright). เรนเดอร์เบราว์เซอร์เต็มรูปแบบ รองรับ infinite scroll แต่ช้าและมีโอกาสถูกตรวจจับ
- ต้องการ metadata จำนวนมาก, คอมเมนต์ หรือ transcripts? → วิธีที่ 3 (yt-dlp). เครื่องมือที่ทำได้ครอบคลุมที่สุดตัวหนึ่ง — มีเหตุผลที่มันได้ 157K+ stars
- ต้องการข้อมูลที่เชื่อถือได้และมีโครงสร้างในสเกลปานกลาง? → วิธีที่ 4 (YouTube Data API). เป็นทางการ สะอาด แต่ติด quota ที่ 10,000 units/วัน
- ต้องการข้อมูลใน 2 นาทีโดยไม่เขียนโค้ด? → Thunderbit. ใช้งานบนเบราว์เซอร์ ขับเคลื่อนด้วย AI และ export ไป Google Sheets ได้ในไม่กี่คลิก
ไม่มีวิธีไหนครอบคลุมทุก use case ได้หมด เก็บตารางเปรียบเทียบและตารางฟิลด์ข้อมูลข้างบนไว้ — มันจะช่วยคุณประหยัดเวลาในโปรเจกต์ถัดไป และถ้าอยากสำรวจ วิธีการ web scraping อื่น ๆ เรามีคู่มืออีกมากบนบล็อก Thunderbit ตั้งแต่ บทสอน Python scraping ไปจนถึง การ scrape ข้อมูลเข้า Google Sheets
ลองใช้ Thunderbit สำหรับการดึงข้อมูล YouTube Get Started Free
คำถามที่พบบ่อย
ฉันสามารถดึงข้อมูล YouTube ได้โดยไม่ต้องมี API key ไหม?
ได้ วิธีที่ 1 (requests + BS4), วิธีที่ 2 (Selenium/Playwright) และวิธีที่ 3 (yt-dlp) ไม่ต้องใช้ API key มีแค่วิธีที่ 4 (YouTube Data API) ที่ต้องมี Thunderbit ก็ใช้ได้โดยไม่ต้องมี API key เช่นกัน — มัน scrape ตรงในเบราว์เซอร์ของคุณ
วิธีที่เร็วที่สุดในการดึงข้อมูล YouTube ด้วย Python คืออะไร?
ถ้าใช้ Python, yt-dlp และ requests + BS4 คือเร็วที่สุด — ทั้งคู่ไม่ต้องแบก overhead ของเบราว์เซอร์ และดึง metadata ได้ในไม่กี่วินาทีต่อวิดีโอ yt-dlp จะเร็วเป็นพิเศษสำหรับงานแบบ batch เพราะจัดการ pagination ให้เอง สำหรับคนที่ไม่ใช้ Python Thunderbit เร็วที่สุดโดยรวม เพราะแทบไม่ต้องตั้งค่าอะไร
จะดึงคอมเมนต์ YouTube ด้วย Python ได้อย่างไร?
yt-dlp มีการดึงคอมเมนต์ในตัวผ่านตัวเลือก getcomments — เป็นวิธีที่ง่ายที่สุด YouTube Data API ก็รองรับคอมเมนต์ผ่าน commentThreads.list (1 quota unit ต่อ call ได้สูงสุด 100 คอมเมนต์ต่อหน้า) ส่วน Selenium/Playwright ทำได้โดยเลื่อนหน้าและดึง element ของคอมเมนต์ที่เรนเดอร์แล้ว แต่จะช้าและเปราะบาง
สามารถดึงข้อมูล YouTube Shorts ด้วย Python ได้ไหม?
ได้ yt-dlp จัดการ metadata ของ Shorts ได้ดี — มองมันเป็นวิดีโอปกติแต่มี field เฉพาะของ Shorts เพิ่มมา YouTube Data API รองรับบางส่วน (การนับวิวของ Shorts เปลี่ยนไป เมื่อ 30 เมษายน 2025 — ตอนนี้ views นับทุกการเริ่มเล่น/เล่นซ้ำ) ส่วน BS4 และ Selenium/Playwright รองรับ Shorts ได้จำกัด เพราะ shelf ของ Shorts ใช้ DOM โครงสร้างต่างออกไป
ฉันจะ scrape วิดีโอ YouTube ได้วันละกี่รายการ?
ด้วย YouTube Data API คุณถูกจำกัดที่ประมาณ 10,000 quota units/วัน ถ้าใช้ videos.list แบบ batch (50 IDs ต่อ call ใช้ 1 unit) นั่นหมายถึงคุณอาจตรวจสอบสถิติวิดีโอได้สูงสุดถึง 500,000 รายการต่อวัน — แต่ search.list ที่ 100 units ต่อ call จะกินงบเร็วมาก ส่วนวิธี scrape (BS4, Selenium, yt-dlp) ข้อจำกัดเป็นเชิงปฏิบัติ ไม่ใช่เลขตายตัว: โดยทั่วไป IP block มักเริ่มหลังจาก request หลักร้อยถึงหลักพันต่อ IP ต่อวัน ขึ้นอยู่กับ proxy และรูปแบบการส่ง request ของคุณ Thunderbit ใช้ระบบเครดิตตาม แพ็กเกจ
เรียนรู้เพิ่มเติม



