
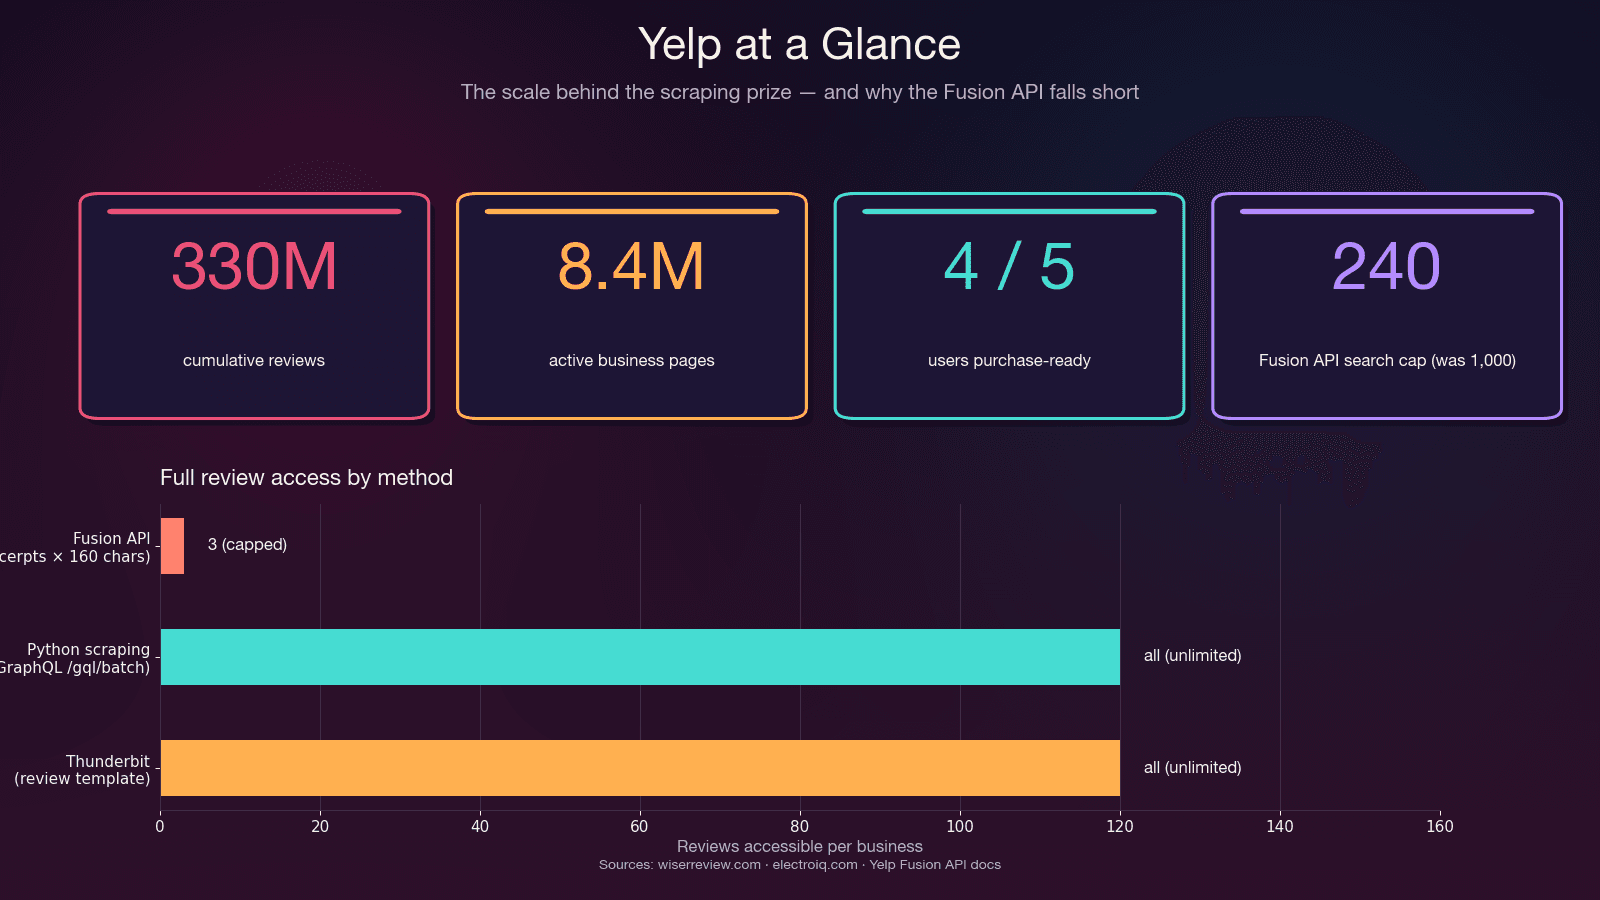
Yelp มีรีวิวสะสม 330 ล้านรายการ ครอบคลุมหน้าธุรกิจที่ยังใช้งานอยู่ 8.4 ล้านหน้า — และการเอาข้อมูลพวกนี้มาใช้ในรูปแบบที่พร้อมใช้งานจริงไม่เคยยากขนาดนี้มาก่อน มาตรการปราบบอตของ Yelp ในช่วงปี 2024–2025 ทำให้คู่มือดึงข้อมูลด้วย Python จำนวนมากใช้การไม่ได้แบบเงียบ ๆ
ถ้าคุณเคยลองรัน Yelp scraper ช่วงหลัง ๆ แล้วเจอแต่ 403, HTML ว่าง ๆ หรือ CAPTCHA ที่เมื่อหกเดือนก่อนยังไม่มีเลย คุณไม่ได้คิดไปเอง ตอนนี้ Yelp ใช้ทั้งการตรวจลายนิ้วมือ TLS/JA3, การสลับชื่อ CSS class แบบทำให้งง, และการให้คะแนนความน่าเชื่อถือของ IP แบบเข้มมาก — นั่นหมายความว่าวิธีเก่า ๆ อย่าง requests + BeautifulSoup ที่ยังถูกแนะนำอยู่ในหลายบทความ จะพังตั้งแต่คำขอแรก ผมใช้เวลาหลายสัปดาห์ลองวิธีต่าง ๆ กับระบบปัจจุบันของ Yelp และคู่มือนี้จะสรุปทุกอย่างที่ใช้งานได้จริงในปี 2025: ทั้ง Fusion API อย่างเป็นทางการ (และเหตุผลว่าทำไมมันอาจไม่พอ), เวิร์กโฟลว์ดึงข้อมูลด้วย Python แบบเต็มรูปแบบพร้อมกลยุทธ์กันบล็อกหลายชั้น, และทางลัดแบบไม่ต้องเขียนโค้ดเพียง 2 คลิกด้วยThunderbit สำหรับคนที่แค่ต้องการข้อมูล ไม่อยากเสียเวลามานั่งไล่บั๊กทั้งวัน
ลองใช้ Thunderbit สำหรับดึงข้อมูล Yelp
ทำไมถึงควรดึงข้อมูล Yelp ด้วย Python และใครได้ประโยชน์จริง
ก่อนจะเขียนโค้ดสักบรรทัด คำถามสำคัญคือ: ข้อมูล Yelp เอาไปใช้ทำอะไรได้จริงในธุรกิจ? แพลตฟอร์มนี้ไม่ใช่แค่เว็บรีวิวร้านอาหาร แต่มันแทบจะเป็นฐานข้อมูลสดของธุรกิจท้องถิ่น ที่มีทั้งข้อมูลติดต่อแบบโครงสร้าง, เรตติ้ง, หมวดหมู่, เวลาทำการ และรีวิวจากลูกค้านับร้อยล้านรายการ
กลุ่มที่ได้ประโยชน์มากที่สุด และสิ่งที่พวกเขามักดึงออกมา มีดังนี้:
| กรณีใช้งาน | ฟิลด์ข้อมูลหลัก | ทำไมถึงสำคัญ |
|---|---|---|
| งานขายและหาลีด | ชื่อธุรกิจ, เบอร์โทร, เว็บไซต์, ที่อยู่, หมวดหมู่, เรตติ้ง | สร้างรายชื่อผู้มุ่งหวังแบบเจาะจงสำหรับ SMB ในพื้นที่ — ผู้ใช้ Yelp 4 ใน 5 คนพร้อมตัดสินใจซื้อเมื่อเข้ามาใช้งาน |
| วิเคราะห์คู่แข่ง | รีวิว, ดาวเฉลี่ย, ปริมาณรีวิว, ความรู้สึกเชิงบวก/ลบ | ติดตามชื่อเสียงคู่แข่ง, หา gap ในบริการ, ดูแนวโน้มตลาด |
| วิจัยตลาด & NLP | ข้อความรีวิวเต็ม, วันที่, เมตาดาต้าของผู้รีวิว | วิเคราะห์ sentiment, topic modeling — รีวิว Yelp เป็นหนึ่งในคอร์ปัส NLP ที่ถูกใช้งานมากที่สุด ในงานวิจัย |
| อสังหาริมทรัพย์ & เลือกทำเล | ความหนาแน่นของธุรกิจ, สัดส่วนหมวดหมู่, คุณภาพรีวิวตามพื้นที่ | เลือกทำเลสำหรับแฟรนไชส์และค้าปลีก — Yelp เองก็ขายLocation Intelligence เป็นสินค้าธุรกิจ B2B อยู่แล้ว |
| อีคอมเมิร์ซ & การปฏิบัติการ | สัญญาณด้านราคา, ข้อร้องเรียนของลูกค้า, เวลาบริการ | ดูว่าคู่แข่งถูกพูดถึงอย่างไร และค้นหารูปแบบการดำเนินงาน |
ประเด็นร่วมกันคือ เป้าหมายจริง ๆ คือ “ข้อมูลที่เป็นโครงสร้าง” และ Python เป็นแค่หนึ่งในเครื่องมือที่จะพาคุณไปถึงตรงนั้น บางคนอยากควบคุมทุกอย่างด้วยโค้ดโดยตรง แต่อีกหลายคนแค่อยากได้สเปรดชีตรายชื่อช่างประปาใน Austin เท่านั้น ทั้งสองแบบมีให้ครบในบทความนี้
Yelp Fusion API vs. การดึงข้อมูลเว็บด้วย Python: ควรเลือกอะไร
คู่มือส่วนใหญ่ข้ามการตัดสินใจข้อนี้ไปเลย แล้วกระโดดเข้าโค้ดทันที โดยไม่เช็กว่าจริง ๆ แล้วYelp Fusion API อย่างเป็นทางการ (ซึ่งตอนนี้เปลี่ยนชื่อเป็น “Yelp Places API”) เพียงพอหรือไม่ จากประสบการณ์ของผม การประเมินตรงนี้ช่วยประหยัดเวลาได้เป็นชั่วโมง เพราะ API นี้ดีมากสำหรับบางงาน แต่ใช้ไม่ได้เลยสำหรับบางงาน
Fusion API ให้ข้อมูลอะไรบ้างจริง ๆ
Fusion API ให้การค้นหาธุรกิจแบบมีโครงสร้าง, รายละเอียดธุรกิจ, autocomplete และ endpoint สำหรับรีวิว มันถูกต้องตามสิทธิ์, มีเอกสารชัดเจน และไม่ต้องไปเล่นเกมหลบระบบกันบอต
แต่ปัญหาอยู่ที่ endpoint ของรีวิว นี่คือสิ่งที่ทีม Yelp ยืนยันไว้บน GitHub:
“Yelp API ไม่ได้ส่งข้อความรีวิวฉบับเต็มมาให้ โดยปกติจะให้มาเพียง 3 ข้อความตัวอย่าง ข้อความละ 160 ตัวอักษร” — คำตอบจากทีม Yelp, GitHub Issue #163
นี่ไม่ใช่บั๊ก แต่มันถูกออกแบบมาแบบนั้นตั้งแต่ต้น API จำกัดไว้ที่ตัวอย่างรีวิว 3 รายการเท่านั้น (7 รายการสำหรับ Premium) และแต่ละรายการก็ถูกตัดเหลือประมาณ 160 ตัวอักษร ไม่มีเมตาดาต้าของรีวิว (เช่น useful/funny/cool votes), ไม่มีประวัติผู้รีวิว, และไม่มีคำตอบจากเจ้าของร้าน อีกทั้งโควตาเรียกใช้งานรายวันสำหรับลูกค้าใหม่ลดลงเหลือ 300–500 ครั้ง/วัน หลังเดือนพฤษภาคม 2023 จากเดิม 5,000 ครั้ง ราคาเริ่มต้นอยู่ที่$29/เดือน
กรอบการตัดสินใจ
| ปัจจัย | Yelp Fusion API | การดึงข้อมูลด้วย Python | Thunderbit (No-Code) |
|---|---|---|---|
| รีวิวแบบเต็ม | ❌ ได้แค่ 3 ตัวอย่าง (~160 ตัวอักษร/รายการ) | ✅ ได้ครบผ่าน GraphQL | ✅ ได้รีวิวที่มองเห็นทั้งหมด |
| ข้อจำกัดการเรียกใช้งาน | 300–500/วัน (ลูกค้าใหม่); 5,000 (บัญชีเดิม) | ควบคุมเอง (ใช้ต้นทุน proxy) | คิดตามเครดิต |
| ความยากในการตั้งค่า | ~15 นาที (API key + SDK) | หลายชั่วโมงถึงหลายวัน | ~2 นาที |
| ฟิลด์ข้อมูลธุรกิจ | ~20 ฟิลด์แบบมีโครงสร้าง | ไม่จำกัด (parse HTML/JSON ได้) | ฟิลด์ที่ AI ช่วยแนะนำ |
| การจัดการ anti-bot | ไม่เกี่ยว (ถูกอนุญาต) | ต้องทำเองทั้งหมด | จัดการให้อัตโนมัติ |
| ความเสี่ยงทางกฎหมาย | ✅ ได้รับอนุญาต | ⚠️ อยู่ในโซนสีเทาตาม ToS | ⚠️ เสี่ยงแบบเดียวกับการ scrape |
| ค่าใช้จ่าย | ขั้นต่ำ $29/เดือน | ฟรี (+ ค่า proxy $0.75–$4/GB) | มีแพ็กเกจฟรี |
| การดูแลรักษา | ต่ำ (API คงที่) | สูง (selector เปลี่ยน, ระบบกันบอตเข้มขึ้น) | ต่ำ (AI ปรับตัวใหม่) |
ใช้ Fusion API ถ้า: คุณต้องการข้อมูลธุรกิจพื้นฐาน, ค้นหาในสเกลเล็ก, หรือการเชื่อมต่อที่ได้รับอนุญาต — และตัวอย่างรีวิว 3 อันต่อธุรกิจเพียงพอแล้ว
ใช้ Python scraping ถ้า: คุณต้องการข้อความรีวิวเต็ม, รีวิวทั้งหมดของธุรกิจหนึ่ง, เมตาดาต้าของรีวิว, ผลลัพธ์มากกว่า 240 รายการต่อการค้นหาหนึ่งครั้ง, หรือถ้างบคุณต่ำกว่า $29/เดือน
ใช้ Thunderbit ถ้า: คุณอยากได้ข้อมูลเร็ว ๆ โดยไม่ต้องเขียนหรือดูแลโค้ด ต่อไปจะมีรายละเอียดในส่วน no-code
ทางลัดแบบไม่ต้องเขียนโค้ด: ดึงข้อมูล Yelp ด้วย Thunderbit (ไม่ต้องใช้ Python)
ก่อนจะลงลึกฝั่ง Python นี่คือทางที่เร็วที่สุดสำหรับคนที่เป้าหมายจริง ๆ คือ “ข้อมูล” ไม่ใช่ “การฝึกเขียนโค้ด” คู่มือของคู่แข่งส่วนใหญ่มักตั้งสมมติฐานว่าคุณต้องใช้ Python ได้ แต่จากงานของผมที่ Thunderbit ผมเห็นคนจำนวนมากที่ค้นคำว่า “scrape Yelp” จริง ๆ แล้วเป็นเซลส์, ผู้จัดการฝ่ายปฏิบัติการ, และเจ้าของธุรกิจขนาดเล็ก ที่แค่อยากได้สเปรดชีตรายชื่อธุรกิจท้องถิ่น ไม่ได้อยากเรียนรู้เรื่อง TLS fingerprinting แบบเร่งด่วน
Thunderbit มีเทมเพลต Yelp สำเร็จรูปอยู่แล้ว:
- Yelp Business Web Scraper — ดึงชื่อธุรกิจ, เรตติ้ง, ข้อมูลติดต่อ, ที่อยู่, เวลาทำการ, หมวดหมู่
- Yelp Review Scraper — ดึงชื่อผู้รีวิว, เนื้อหารีวิว, เรตติ้ง, วันที่, ที่ตั้งของผู้รีวิว
วิธีใช้งานจริง
- เปิดหน้า Yelp search results หรือหน้าธุรกิจใน Chrome
- คลิก AI Suggest Fields ในส่วนขยาย Thunderbit — AI จะอ่านหน้าเว็บแล้วเสนอคอลัมน์ให้ เช่น ชื่อธุรกิจ, เรตติ้ง, จำนวนรีวิว, ช่วงราคา, หมวดหมู่, ที่อยู่, เบอร์โทร, URL
- คลิก Scrape — เสร็จ
ถ้าใช้เทมเพลต Yelp ที่เตรียมไว้แล้ว ยิ่งง่ายกว่าเดิม: เปิดเทมเพลต แล้วกด Scrape ได้เลย
การ scrape หน้าย่อย จะจัดการขั้นตอนเสริมข้อมูลให้อัตโนมัติ — เริ่มจากหน้าผลการค้นหา Yelp แล้วเปิด subpage scraping จากนั้น Thunderbit จะเข้าไปยังแต่ละหน้าธุรกิจเพื่อดึงเวลาทำการ, รีวิวเต็ม, เว็บไซต์, รูปภาพ และสิ่งอำนวยความสะดวกต่าง ๆ โดยไม่ต้องตั้งค่าเพิ่ม
Pagination เป็นแบบอัตโนมัติ — ทั้งแบบคลิกและแบบเลื่อนหน้า รองรับมาให้ในตัวอยู่แล้ว (ถ้าสนใจว่ามันทำงานยังไง ดูคู่มือ pagination ของเราได้)
ส่งออกข้อมูลได้ฟรีทุกแพ็กเกจ — Excel, Google Sheets, Airtable, Notion, CSV, JSON ไม่ต้องใช้ pandas และไม่ต้องเขียนโค้ดบันทึกไฟล์
เปรียบเทียบเวลา
| เวลา | Python Scraper | Thunderbit |
|---|---|---|
| การรันครั้งแรก | หลายชั่วโมงถึงหลายวัน (เขียน selector, จัดการ pagination, proxy, retry logic) | ~30 วินาทีด้วยเทมเพลต Yelp สำเร็จรูป |
| เมื่อ Yelp เปลี่ยน markup | ต้องเขียน selector ใหม่เอง | คลิก AI Suggest Fields อีกครั้ง — ปรับตัวใหม่อัตโนมัติ |
| เมื่อ IP โดนแบน | ต้อง debug, สลับ proxy pool, ทดสอบใหม่ | Cloud mode จัดการ rotation ของ IP ให้ |
| ส่งออกไป Google Sheets | ต้องเขียน OAuth + pandas glue | คลิกเดียว ฟรี |
ถ้าลอง Thunderbit แล้วพบว่าตอบโจทย์ คุณสามารถข้ามส่วนที่เหลือของบทความนี้ได้เลย ถ้าคุณต้องการควบคุมแบบโปรแกรมเต็มรูปแบบ, ฟิลด์ที่กำหนดเอง, หรือสเกลเกินไม่กี่พันเรคคอร์ดต่อเดือน — อ่านต่อได้
ไลบรารี Python สำหรับดึงข้อมูล Yelp: ควรเลือกตัวไหน
“ควรใช้ Scrapy, BS4+requests หรือ Selenium?” เป็นหนึ่งในคำถามที่พบบ่อยที่สุดในกระทู้ r/webscraping ที่คุยเรื่อง Yelp ถึงอย่างนั้น คู่มือส่วนใหญ่ก็แค่หยิบไลบรารีโปรดขึ้นมาแล้วเดินต่อ โดยไม่อธิบายว่าเพราะอะไร นี่คือคำอธิบายแบบตรงไปตรงมา
ความจริงในปี 2025: requests + BeautifulSoup ใช้กับ Yelp ไม่ได้แล้ว
สแต็กที่คู่มือ Yelp แบบคลาสสิกชอบแนะนำ — pip install requests beautifulsoup4 — โดนบล็อกตั้งแต่คำขอแรก ในปี 2025 ไม่ใช่ครั้งที่ 50 แต่ครั้งแรกเลย
เหตุผลคือไลบรารี requests ของ Python ส่งลายนิ้วมือ TLS/JA3 ที่ไม่ตรงกับเบราว์เซอร์จริง Yelp ตรวจจับได้ตั้งแต่ระดับ TLS-handshake ก่อนจะอ่าน User-Agent header เสียอีก ผมทดสอบเรื่องนี้ซ้ำแล้วซ้ำอีก — IP ใหม่, header สมจริง, หน่วงเวลาแบบสุ่ม — ก็ยังเจอ 403 Forbidden ทันทีเมื่อใช้ requests แบบปกติ
ตารางตัดสินใจเลือกไลบรารี
| ไลบรารี | เหมาะที่สุดสำหรับ | รองรับ JS? | กันบอตได้ไหม? | ความยากในการเรียนรู้ | ความเร็ว |
|---|---|---|---|---|---|
requests + BeautifulSoup | ❌ | ❌ | ต่ำมาก | เร็ว (จนกว่าจะโดนบล็อก) | |
httpx async + parsel | ดึงข้อมูลจำนวนมากแบบ async | ❌ | ❌ | ต่ำ | เร็วมาก |
curl_cffi + parsel | เฉพาะ Yelp: ปลอมลายนิ้วมือ TLS | ❌ | ✅ TLS/JA3/HTTP2 | ต่ำ | เร็วมาก |
Scrapy 2.14 | วาง pipeline แบบ crawl เต็มรูปแบบพร้อม pagination | บางส่วน (ผ่าน scrapy-playwright) | AutoThrottle, retry middleware | ปานกลาง-สูง | เร็ว |
Selenium 4.43 / Playwright 1.58 | หน้าเว็บที่พึ่ง JS หนัก, ใช้แก้ CAPTCHA | ✅ | ได้บางส่วน | ปานกลาง | ช้า (~10–30 หน้า/นาที) |
| Thunderbit | ผู้ไม่เขียนโค้ด, ดึงข้อมูลเร็ว | ✅ (ผ่านเบราว์เซอร์) | มีในตัว (Cloud mode) | ต่ำมาก | เร็ว |
ทำไม curl_cffi ถึงเปลี่ยนเกม
ไลบรารีที่เปลี่ยน workflow การดึงข้อมูล Yelp ของผมคือ curl_cffi — binding ของ Python สำหรับ curl-impersonate มันปล่อย TLS/JA3 + HTTP/2 fingerprint เหมือน Chrome จริงทุกประการ และ API ของมันแทบใช้แทน requests ได้เลย
from curl_cffi import requests

r = requests.get(
    "https://www.yelp.com/biz/some-restaurant",
    impersonate="chrome131",
)
print(r.status_code, len(r.text))
การเปลี่ยนแค่นี้ — from curl_cffi import requests พร้อม impersonate="chrome131" — ช่วยข้ามชั้นกันบอตหลักของ Yelp ได้โดยไม่ต้องเปิดเบราว์เซอร์ จากการทดสอบของผม มันต่างกันระหว่างโดน 403 ทันที กับได้ 200 แบบสะอาด ๆ
สแต็กที่ผมแนะนำสำหรับ Yelp ในปี 2025: curl_cffi + parsel + jmespath + residential proxies ถ้าคุณต้องการ pipeline แบบ crawl เต็มรูปแบบพร้อม scheduling ให้หุ้มด้วย Scrapy 2.14 และ downloader middleware ที่ใช้ curl_cffi
การตั้งค่าสภาพแวดล้อม Python เพื่อดึงข้อมูล Yelp
- ระดับความยาก: ปานกลาง
- เวลาที่ใช้: ประมาณ 15 นาทีสำหรับการตั้งค่า, 1–2 ชั่วโมงสำหรับ scraper ที่ใช้งานได้
- สิ่งที่ต้องมี: Python 3.10+ (แนะนำ 3.12), เทอร์มินัล และถ้าทำได้ควรมีผู้ให้บริการ residential proxy
ขั้นตอนที่ 1: สร้าง virtual environment และติดตั้งแพ็กเกจ
python3.12 -m venv .venv
source .venv/bin/activate  # บน Windows: .venv\Scripts\activate
pip install "curl_cffi>=0.11" "parsel>=1.9" "jmespath>=1.0" pandas
แต่ละแพ็กเกจทำอะไร:
curl_cffi— ส่ง HTTP request ด้วย TLS fingerprint ของ Chrome (ตัวช่วยข้าม anti-bot)parsel— ใช้ CSS/XPath selectors สำหรับ parse HTML (ใช้ engine เดียวกับ Scrapy แต่เบากว่า)jmespath— query JSON แบบ declarative (อ่านง่ายกว่าการไล่เข้าดิกชันนารีซ้อนสำหรับ JSON ที่ Yelp ฝังมา)pandas— ส่งออกข้อมูลเป็น CSV/Excel
ถ้าอยากได้เพิ่มอีกนิด:
pip install fake-useragent # หมายเหตุ: repo ถูก archive ในเดือนเมษายน 2026 แต่ยังติดตั้งได้
ทีละขั้นตอน: วิธีดึงข้อมูล Yelp ด้วย Python
นี่คือส่วนหลักของบทเรียน จุดสำคัญที่ทำให้ทุกอย่างทนทานขึ้นคือ: ข้าม CSS selector แล้วดึง JSON ที่ซ่อนอยู่แทน Yelp สุ่มชื่อ CSS class ตอน build (y-css-14xwok2 สัปดาห์นี้, y-css-hcq7b9 สัปดาห์หน้า) ดังนั้น scraper ที่ยึด selector เหล่านี้ไว้จะพังในไม่กี่สัปดาห์ ส่วน payload JSON ที่ฝังไว้ — application/ld+json schema และ react-root-props — จะค่อนข้างนิ่งกว่า
ขั้นตอนที่ 2: ดึงผลการค้นหา Yelp
URL ของการค้นหา Yelp มีรูปแบบที่คาดเดาได้: https://www.yelp.com/search?find_desc={term}&find_loc={location} ข้อมูลผลการค้นหาจะถูกฝังอยู่ในแท็ก <script data-id="react-root-props"> ในรูป JSON ไม่ได้ถูกเรนเดอร์ออกมาปนกับ CSS class ที่ยุ่งเหยิง
import re, json, jmespath
from curl_cffi import requests
from parsel import Selector

HEADERS = {
    "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/124.0.0.0 Safari/537.36",
    "accept": "text/html,application/xhtml+xml,application/xml;q=0.9,"
              "image/avif,image/webp,image/apng,*/*;q=0.8",
    "accept-language": "en-US,en;q=0.9",
    "accept-encoding": "gzip, deflate, br",
    "cookie": "intl_splash=false",
}

def scrape_search(term: str, location: str, max_pages: int = 3):
    results = []
    for page in range(max_pages):
        url = (f"https://www.yelp.com/search?"
               f"find_desc={term}&find_loc={location}&start={page * 10}")
        r = requests.get(url, headers=HEADERS, impersonate="chrome131")
        if r.status_code != 200:
            print(f"Blocked on page {page}: {r.status_code}")
            break
        sel = Selector(text=r.text)
        script = sel.xpath(
            "//script[@data-id='react-root-props']/text()"
        ).get() or ""
        m = re.search(r"react_root_props\s*=\s*(\{.*?\});", script, re.S)
        if not m:
            print(f"No react-root-props found on page {page} — possible soft block")
            break
        data = json.loads(m.group(1))
        businesses = jmespath.search(
            "legacyProps.searchAppProps.searchPageProps"
            ".mainContentComponentsListProps"
            "[?searchResultBusiness].searchResultBusiness.{"
            "name: name, url: businessUrl, rating: rating, "
            "reviews: reviewCount, phone: phone, "
            "neighborhoods: neighborhoods}",
            data,
        ) or []
        results.extend(businesses)
        import time, random
        time.sleep(random.uniform(3, 7))
    return results
คุณควรจะได้ list ของ dict ที่มีชื่อธุรกิจ, URL, เรตติ้ง, และจำนวนรีวิว ถ้า react-root-props หายไปจาก response แปลว่าคุณโดนส่งหน้า block แบบ soft block มาแล้ว ให้สลับ IP แล้วลองใหม่
Header Cookie: intl_splash=false คือวิธีแก้ชั่วคราวมาตรฐานสำหรับ redirect splash ประเทศของ Yelp ถ้าไม่มี header นี้ IP ที่ไม่ใช่ US มักจะไปเจอ splash page ที่ดูเหมือน soft block แต่จริง ๆ ไม่ใช่
ขั้นตอนที่ 3: ดึงข้อมูลจากหน้าธุรกิจ Yelp
แต่ละ URL ธุรกิจจากผลการค้นหาจะนำไปยังหน้ารายละเอียด ซึ่งมีข้อมูลเข้มข้นกว่า จุดดึงที่เสถียรที่สุดคือบล็อก <script type="application/ld+json"> — เพราะมันมี schema.org data ที่ Yelp เก็บไว้เพื่อ SEO และไม่ค่อยทำ obfuscate
def scrape_business(biz_url: str) -> dict:
    url = f"https://www.yelp.com{biz_url}" if biz_url.startswith("/") else biz_url
    r = requests.get(url, headers=HEADERS, impersonate="chrome131")
    if r.status_code != 200:
        return {"url": url, "error": r.status_code}
    sel = Selector(text=r.text)
    biz_id = sel.css('meta[name="yelp-biz-id"]::attr(content)').get()
    for raw in sel.css('script[type="application/ld+json"]::text').getall():
        try:
            data = json.loads(raw)
        except json.JSONDecodeError:
            continue
        for node in (data if isinstance(data, list) else [data]):
            if node.get("@type") in (
                "Restaurant", "LocalBusiness", "FoodEstablishment",
                "HealthAndBeautyBusiness", "HomeAndConstructionBusiness",
            ):
                return {
                    "biz_id": biz_id,
                    "name": node.get("name"),
                    "rating": (node.get("aggregateRating") or {}).get("ratingValue"),
                    "review_count": (node.get("aggregateRating") or {}).get("reviewCount"),
                    "address": node.get("address"),
                    "telephone": node.get("telephone"),
                    "price_range": node.get("priceRange"),
                    "hours": node.get("openingHours"),
                    "url": url,
                }
    return {"biz_id": biz_id, "url": url}
ค่า meta[name="yelp-biz-id"] คือรหัสธุรกิจแบบเข้ารหัสที่คุณต้องใช้สำหรับ endpoint รีวิว เก็บค่านี้ไว้ เพราะจะใช้ในขั้นต่อไป
ขั้นตอนที่ 4: ดึงรีวิว Yelp พร้อม pagination
นี่คือจุดที่ Fusion API สู้ไม่ได้ แต่การ scrape ชนะไปเต็ม ๆ GraphQL batch endpoint ภายในของ Yelp ส่งข้อความรีวิวเต็ม, ข้อมูลผู้รีวิว, วันที่, เรตติ้ง และจำนวนโหวต — ทุกอย่างที่ API ปิดไว้
Endpoint คือ https://www.yelp.com/gql/batch และใช้ documentId แบบคงที่สำหรับ operation GetBusinessReviewFeed การแบ่งหน้าใช้ cursor ที่เข้ารหัสด้วย base64
import base64

GQL_URL = "https://www.yelp.com/gql/batch"
DOC_ID = "ef51f33d1b0eccc958dddbf6cde15739c48b34637a00ebe316441031d4bf7681"

def fetch_reviews(enc_biz_id: str, num_pages: int = 5):
    all_reviews = []
    for page in range(num_pages):
        offset = page * 10
        cursor = base64.b64encode(
            json.dumps({"version": 1, "offset": offset}).encode()
        ).decode()
        payload = [{
            "operationName": "GetBusinessReviewFeed",
            "variables": {
                "encBizId": enc_biz_id,
                "reviewsPerPage": 10,
                "after": cursor,
                "sortBy": "DATE_DESC",
                "language": "en",
            },
            "extensions": {
                "operationType": "query",
                "documentId": DOC_ID,
            },
        }]
        r = requests.post(
            GQL_URL,
            json=payload,
            headers={
                **HEADERS,
                "content-type": "application/json",
                "x-apollo-operation-name": "GetBusinessReviewFeed",
                "apollographql-client-name": "yelp-main-frontend",
            },
            impersonate="chrome131",
        )
        if r.status_code != 200:
            print(f"Review fetch failed at offset {offset}: {r.status_code}")
            break
        data = r.json()
        # ไล่โครงสร้าง response เพื่อดึงรีวิว
        try:
            reviews = data[0]["data"]["business"]["reviews"]["edges"]
            for edge in reviews:
                node = edge.get("node", {})
                all_reviews.append({
                    "reviewer": node.get("author", {}).get("displayName"),
                    "rating": node.get("rating"),
                    "date": node.get("localizedDate"),
                    "text": node.get("text", {}).get("full"),
                })
        except (KeyError, IndexError, TypeError):
            break
        import time, random
        time.sleep(random.uniform(3, 7))
    return all_reviews
แต่ละหน้าจะคืนรีวิวมา 10 รายการ เพิ่มค่า offset ใน cursor ที่เข้ารหัส base64 เพื่อไล่หน้าต่อไปได้ พารามิเตอร์ sortBy รองรับ DATE_DESC (ใหม่สุดก่อน), RATING_ASC, RATING_DESC และอื่น ๆ
ขั้นตอนที่ 5: ส่งออกข้อมูล Yelp ที่ดึงมา
import pandas as pd

# สมมติว่าคุณเก็บ businesses และ reviews ไว้แล้ว
df_businesses = pd.DataFrame(businesses)
df_businesses.to_csv("yelp_businesses.csv", index=False)

df_reviews = pd.DataFrame(all_reviews)
df_reviews.to_csv("yelp_reviews.csv", index=False)

# หรือบันทึกเป็น JSON เพื่อความยืดหยุ่น
import json
with open("yelp_data.json", "w") as f:
    json.dump({"businesses": businesses, "reviews": all_reviews}, f, indent=2)
สำหรับคนที่ใช้ทาง no-code Thunderbit สามารถส่งออกข้อมูลแบบเดียวกันไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้โดยตรง — ไม่ต้องใช้ pandas และไม่ต้องเขียนโค้ดบันทึกไฟล์
แผนรับมือ anti-blocking: ดึงข้อมูล Yelp โดยไม่โดนบล็อก
นี่คือเหตุผลหลักที่ทำให้บทความนี้มีอยู่จริง มาตรการกันบอตของ Yelp เข้มขึ้นมากตั้งแต่ปลายปี 2024 — TLS fingerprinting, การตรวจ IP reputation, CAPTCHA และ behavioral analysis ล้วนถูกนำมาใช้ คู่มือส่วนใหญ่ที่มีอยู่ตอนนี้จึงล้าสมัย เพราะเขียนก่อนการปราบบอตครั้งนี้
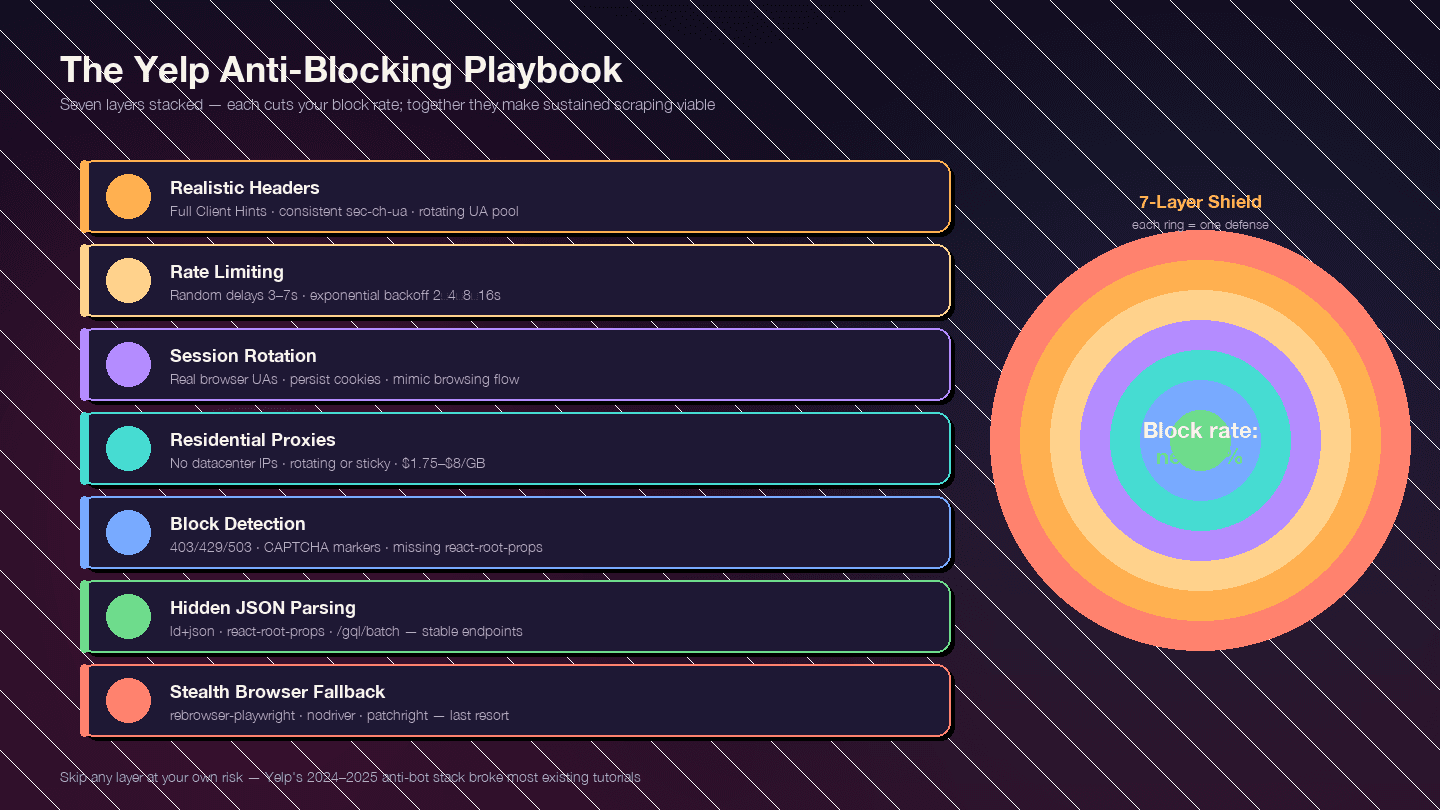
กลยุทธ์ต้องใช้หลายชั้น แต่ละชั้นช่วยลดอัตราการโดนบล็อก และเมื่อรวมกันจะทำให้ดึงข้อมูลต่อเนื่องได้จริง
ชั้นที่ 1: Header ของ request ต้องสมจริง
Header ปกติของ Python requests จะส่ง User-Agent: python-requests/2.x ซึ่งโดนบล็อกทันที แต่แค่ใช้ User-Agent ที่ดูเหมือนเบราว์เซอร์จริงก็ยังไม่พอ Yelp ยังเช็กชุด header Client Hints ทั้งหมดว่าตรงกันหรือไม่
FULL_HEADERS = {
    "authority": "www.yelp.com",
    "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/124.0.0.0 Safari/537.36",
    "accept": "text/html,application/xhtml+xml,application/xml;q=0.9,"
              "image/avif,image/webp,image/apng,*/*;q=0.8",
    "accept-language": "en-US,en;q=0.9",
    "accept-encoding": "gzip, deflate, br",
    "sec-ch-ua": '"Chromium";v="124", "Google Chrome";v="124", "Not-A.Brand";v="99"',
    "sec-ch-ua-mobile": "?0",
    "sec-ch-ua-platform": '"Windows"',
    "sec-fetch-dest": "document",
    "sec-fetch-mode": "navigate",
    "sec-fetch-site": "same-origin",
    "sec-fetch-user": "?1",
    "upgrade-insecure-requests": "1",
    "referer": "https://www.yelp.com/",
    "cookie": "intl_splash=false",
}
ข้อผิดพลาด 3 อย่างที่ทำให้โดนจับได้:
- UA บอกว่าเป็น Chrome แต่
sec-ch-uaหายไป หรือไม่ตรงกับเวอร์ชันใน UA sec-ch-ua-platformบอกว่า "Windows" แต่ UA กลับเป็น macOS- ใช้ UA เดิมเป๊ะเป็นพัน ๆ คำขอจาก IP เดียว — ควรหมุนชุด UA Chrome/Firefox/Safari รุ่นใหม่ 10–20 แบบ
ชั้นที่ 2: จำกัดอัตราและหน่วงเวลาแบบสุ่ม
รูปแบบเวลาที่เดาง่ายคือสัญญาณอันตราย ให้ใส่การหน่วงแบบสุ่มและใช้ exponential backoff เมื่อเจอ error
import random, time

def polite_get(client_get, url, attempt=0):
    r = client_get(url, headers=FULL_HEADERS, impersonate="chrome131")
    if r.status_code in (403, 429, 503):
        if attempt >= 4:
            raise RuntimeError(f"Blocked after {attempt + 1} attempts on {url}")
        backoff = 2 ** (attempt + 1) + random.random()
        print(f"  Got {r.status_code}, backing off {backoff:.1f}s (attempt {attempt + 1})")
        time.sleep(backoff)
        return polite_get(client_get, url, attempt + 1)
    time.sleep(random.uniform(3, 7))
    return r
| พารามิเตอร์ | ค่าที่แนะนำ |
|---|---|
| หน่วงแบบสุ่มระหว่างคำขอ | random.uniform(3, 7) วินาที |
| Backoff เมื่อเจอ 429/403/503 | 2 → 4 → 8 → 16 วินาที, สูงสุด 5 ครั้ง |
| workers พร้อมกันต่อ IP | 1 (serialize ต่อ IP; ใช้ proxies ถ้าจะขนาน) |
| อัตราสูงสุดต่อ residential IP | ประมาณ 1 คำขอ / 5 วินาที (~12 ครั้ง/นาที) |
ชั้นที่ 3: หมุน User-Agent และ session
สลับ User-Agent จากชุดเบราว์เซอร์จริง เก็บ session และ cookie ไว้เพื่อให้พฤติกรรมดูเหมือนการท่องเว็บจริง Yelp ใช้การตรวจแบบ cookie-based ดังนั้นการสร้าง session ใหม่ทุกคำขอจึงดูน่าสงสัย
UA_POOL = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/124.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14_4_1) AppleWebKit/537.36 Chrome/124.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:125.0) Gecko/20100101 Firefox/125.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14.4; rv:125.0) Gecko/20100101 Firefox/125.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14_4_1) AppleWebKit/605.1.15 Safari/17.4.1",
    # เพิ่มอีก 5-10 แบบที่เป็นเวอร์ชันล่าสุด
]
ชั้นที่ 4: หมุน proxy
ถ้าจะใช้งานจริงในปริมาณมาก คุณต้องใช้ residential proxy datacenter proxy และ proxy ฟรีใช้กับ Yelp ไม่ได้ — ชั้นประเมิน IP reputation ของ Yelp จะบล็อก IP จาก AWS, GCP และ DigitalOcean ก่อนเลย
| ผู้ให้บริการ | ราคาเริ่มต้นต่อ GB | หมายเหตุ |
|---|---|---|
| IPRoyal | $1.75/GB | ถูกที่สุด; มีคู่มือ Yelp ที่ถูกอ้างอิงบ่อย |
| Decodo (เดิม Smartproxy) | $3.20–$3.50 | คุ้มที่สุดเมื่อใช้งานปริมาณมาก |
| Bright Data | $4.00 (PAYG) | มี IP pool 150M+ และหน้า Yelp Proxies โดยเฉพาะ |
| Oxylabs | $6.00–$8.00 | ระดับพรีเมียม; มี IP กว่า 10M+ |
| Aluvia (mobile SIM) | $3.00 | ใช้ IP มือถือจากเครือข่าย US จริง ๆ, วางตำแหน่งมาสำหรับ Yelp โดยเฉพาะ |
rotating residential (เปลี่ยน IP ใหม่ทุกคำขอ) เหมาะที่สุดสำหรับ crawl หน้าค้นหาจำนวนมาก sticky sessions (คง IP เดิมไว้ 10 นาที) เหมาะกว่าถ้าคุณต้องเก็บ cookie ต่อเนื่องใน flow ตั้งแต่หน้าธุรกิจ → รีวิว → pagination
ชั้นที่ 5: ตรวจจับและรับมือเมื่อโดนบล็อก
ไม่ใช่ทุกการบล็อกจะหน้าตาเหมือนกัน Yelp มักส่ง shell แบบ generic “page not available” แทน CAPTCHA ซึ่งเป็นเหตุผลที่ scraper แบบง่าย ๆ มักคิดว่าตัวเองได้ข้อมูล ทั้งที่จริงได้แค่ response ว่าง ๆ
BLOCK_MARKERS = (
    "captcha", "px-captcha", "page not available",
    "access denied", "unusual traffic",
)

def is_blocked(resp):
    if resp.status_code in (401, 403, 429, 503):
        return True
    body = resp.text.lower()
    if any(m in body for m in BLOCK_MARKERS):
        return True
    # ถ้าเป็นหน้าค้นหาหรือหน้าธุรกิจ แต่ไม่มี react-root-props
    # แปลว่า Yelp ส่ง block response แบบถูกตัดเนื้อหาออกมา
    if "react-root-props" not in body and "/biz/" in str(resp.url):
        return True
    return False
| สัญญาณ | ความหมาย |
|---|---|
| HTTP 403 | บล็อกแบบแข็ง — IP/headers/TLS ใช้ไม่ได้แล้ว |
| HTTP 429 | จำกัดอัตรา — มักกู้กลับได้ด้วย backoff |
| HTTP 503 | บล็อกทั่วไปหรือระบบลดโหลด |
redirect ไป /error หรือ body เป็น “page not available” | บล็อกแบบอ่อน |
| ว่าง มีแค่ | เป็น challenge page รอ JS |
มี captcha / g-recaptcha / px-captcha ใน body | ยกระดับแล้ว — ต้องใช้ CAPTCHA |
หน้า listing ไม่มี react-root-props | response แบบ block ที่ถูกตัดเนื้อหา |
ชั้นที่ 6: เทคนิค parse ให้ทนทาน — ใช้ JSON ที่ซ่อนอยู่แทน CSS selector
ขอย้ำอีกครั้ง: Yelp สุ่มชื่อ CSS class ตอน build ถ้าคุณยึด h3.y-css-14xwok2 ไว้ สคริปต์จะพังในไม่กี่สัปดาห์เมื่อ Yelp deploy ใหม่เป็น h3.y-css-hcq7b9
payload ที่ ไม่ค่อยเปลี่ยน มีดังนี้:
<script type="application/ld+json">— schema.org structured data (ชื่อ, ที่อยู่, เบอร์โทร, เรตติ้ง, เวลาทำการ)<script data-id="react-root-props">— ข้อมูลผลการค้นหาทั้งหมดในรูป JSONhttps://www.yelp.com/gql/batch— GraphQL endpoint สำหรับรีวิว พร้อมdocumentIdที่ค่อนข้างคงที่
ถ้าคุณ parse CSS classes อยู่ เท่ากับคุณกำลังสร้างบนทราย ดู JSON แทนจะดีกว่า
ชั้นที่ 7: แผนสำรองด้วย stealth browser
ให้ขยับไปใช้ headless browser เฉพาะเมื่อ curl_cffi + residential proxies ยังไม่ผ่าน — โดยปกติจะเป็นตอน Yelp ส่งหน้า challenge แบบ JavaScript หรือ CAPTCHA
สำหรับการดึงข้อมูลธุรกิจ/ค้นหา/รีวิว 95% ของกรณี curl_cffi + hidden JSON + residential proxies จะเร็วกว่า ถูกกว่า และเชื่อถือได้กว่าเบราว์เซอร์ แต่ถ้าคุณต้องใช้เบราว์เซอร์จริง ๆ:
| เครื่องมือ | สถานะ (2025) | หมายเหตุ |
|---|---|---|
| rebrowser-playwright | จุดเริ่มต้นที่แนะนำ | Playwright ที่แพตช์มาให้ใช้แทนกันได้เพื่อแก้ CDP leaks |
| nodriver | ดีที่สุดสำหรับความ stealth บน Chrome | ผู้สืบทอดของ undetected-chromedriver; หลีกเลี่ยง WebDriver protocol โดยตรง |
| patchright | Fork ของ Playwright ที่ยังพัฒนาอยู่ | ผ่านการทดสอบ detection สมัยใหม่ |
| playwright-stealth | เสถียร | แพตช์ navigator.webdriver, ลบ HeadlessChrome ออกจาก UA |
ข้าม vanilla Selenium สำหรับ Yelp ไปเลย มันถูก fingerprint ได้ง่ายเกินไป
เปรียบเทียบ Yelp Fusion API vs. Python scraping vs. Thunderbit แบบเต็ม
| มิติ | Yelp Fusion API | Python Scraping | Thunderbit |
|---|---|---|---|
| ข้อความรีวิวเต็ม | ❌ 3 excerpts × ~160 ตัวอักษร | ✅ ไม่จำกัด (GraphQL) | ✅ มีเทมเพตรีวิวในตัว |
| เมตาดาต้ารีวิว (โหวต, คำตอบเจ้าของร้าน) | ❌ | ✅ | ✅ ผ่านฟิลด์ที่ AI แนะนำ |
| รูปภาพ | ❌ (0 ใน Base) | ✅ ไม่จำกัด | ✅ |
| ผลลัพธ์สูงสุดต่อการค้นหา | 240 (เดิม 1,000 ก่อนปี 2024) | ไม่จำกัด (แบ่งหน้าได้) | ไม่จำกัด |
| โควตารายวัน | 300–500 (ใหม่) / 5,000 (เดิม) | ขึ้นกับงบ proxy | คิดตามเครดิต (Pro ได้ 3,000/เดือน) |
| ความยากในการเริ่ม | ~15 นาที | หลายชั่วโมงถึงหลายวัน | ~2 นาที |
| การจัดการ anti-bot | ไม่เกี่ยว | ปัญหาของคุณเอง | จัดการให้ (Cloud mode) |
| ความเสี่ยงทางกฎหมาย | ต่ำ (ได้รับอนุญาต) | ปานกลาง (อยู่ในโซนสีเทาตาม ToS) | ปานกลาง (แบบเดียวกับ scraping) |
| ค่าใช้จ่าย (เริ่มต้น) | $29/เดือน | proxy ~$0.75–$4/GB + เวลา dev | แพ็กเกจฟรี |
| ค่าใช้จ่าย (ใช้หนัก) | $643+/เดือน | $50–$500/เดือนสำหรับ proxy + เวลา dev | $38–$49/เดือน |
| การส่งออกข้อมูล | JSON | CSV/JSON (คุณต้องเขียนเอง) | Excel / Sheets / Airtable / Notion — ฟรี |
| การดูแลรักษา | ต่ำ | สูง (selector พัง, anti-bot เข้มขึ้น) | ต่ำ (AI ปรับตัวใหม่) |
คำแนะนำด้านกฎหมายและจริยธรรมในการดึงข้อมูล Yelp
ผมไม่ใช่ทนาย และนี่ไม่ใช่คำแนะนำทางกฎหมาย แต่ในช่วงสองปีที่ผ่านมา ภาพรวมทางกฎหมายเปลี่ยนไปมากพอที่คุณควรรู้พื้นฐานก่อนจะทุ่มเวลาไปกับโปรเจกต์ดึงข้อมูล Yelp
สิ่งที่เงื่อนไขการใช้งานของ Yelp ระบุ: การอัปเดต ToS เดือนตุลาคม 2025 ห้ามใช้งาน “robot, spider... หรืออุปกรณ์อัตโนมัติอื่นใด” เพื่อ “เข้าถึง, ดึง, คัดลอก, scrape หรือ index ส่วนใดส่วนหนึ่งของบริการ” อย่างชัดเจน และยังเพิ่มถ้อยคำเกี่ยวกับ “AI Technologies และ/หรือเครื่องมืออัตโนมัติอื่น ๆ” ด้วย
Yelp Support ย้ำอีกครั้ง ว่า: “Yelp ไม่อนุญาตให้ scrape เว็บไซต์”
robots.txt ว่าอย่างไร: robots.txt ของ Yelp มี wildcard User-agent: * / Disallow: / และยังบล็อก GPTBot, ClaudeBot, PerplexityBot, CCBot และ Meta-ExternalAgent โดยเฉพาะ ส่วนที่อนุญาตมีเพียง Googlebot, Bingbot และ crawler ของโซเชียลมีเดียบางตัว
บรรทัดฐานทางกฎหมายที่สำคัญ: ในคดี Meta v. Bright Data (N.D. Cal. ม.ค. 2024) ศาลตัดสินว่าการ scrape ข้อมูลที่เปิดเผยสาธารณะและไม่ได้ล็อกอิน ไม่ได้ละเมิด ToS ของ Meta ประเด็นสำคัญคือ ข้อมูลสาธารณะที่ไม่ได้ล็อกอิน vs. ข้อมูลที่ต้องล็อกอิน ส่วนคดี hiQ v. LinkedIn วางหลักว่า การ scrape ข้อมูลสาธารณะน่าจะไม่ผิด CFAA แต่ hiQ ก็ยังแพ้คดี tort ของรัฐ (trespass to chattels, misappropriation) และถูกตัดสินให้ชดใช้ $500,000
แนวทางปฏิบัติที่ควรทำ:
- ดึงเฉพาะหน้าที่เปิดสาธารณะและไม่ได้ล็อกอิน
- จำกัดอัตราคำขอของคุณ (ช่วงหน่วงในคู่มือนี้ช่วยทั้งเชิงเทคนิคและเชิงจริยธรรม)
- อย่านำข้อความรีวิวดิบที่ระบุชื่อผู้ใช้ไปขายต่อ — เคารพความเป็นส่วนตัวของผู้รีวิว
- ปฏิบัติตามกฎหมายคุ้มครองข้อมูลในพื้นที่ของคุณ (CCPA, GDPR)
- อย่าใช้บัญชีล็อกอินเพื่อ scrape — นั่นข้ามเส้นเรื่องการอนุญาตไปแล้ว
- มองข้อมูลธุรกิจ (ชื่อ/ที่อยู่/เบอร์โทร/เรตติ้ง) เป็นข้อมูลข้อเท็จจริงสาธารณะ; มองข้อความรีวิวว่าเป็นข้อมูลที่อ่อนไหวกว่า
กรุณาปรึกษาผู้เชี่ยวชาญด้านกฎหมายสำหรับกรณีเฉพาะของคุณ
สรุป
มี 3 เส้นทาง แต่มีเป้าหมายเดียว
Yelp Fusion API คือทางเลือกที่ได้รับอนุญาตและดูแลง่าย — แต่จำกัดแค่ตัวอย่างรีวิว 3 รายการและเริ่มที่ $29/เดือน การ scrape ด้วย Python ให้การควบคุมข้อมูลทุกจุดบน Yelp อย่างเต็มที่ แต่ต้องลงทุนจริง: ใช้ curl_cffi เพื่อปลอม TLS fingerprint, ใช้ residential proxies, หน่วงเวลาแบบสุ่ม, parse JSON ที่ซ่อนอยู่, และดูแลต่อเนื่องเมื่อระบบป้องกันของ Yelp เปลี่ยน Thunderbit ช่วยให้คุณจาก “ฉันต้องการข้อมูล Yelp” ไปสู่ “นี่คือสเปรดชีตของฉัน” ได้ในราว 30 วินาที โดยไม่ต้องเขียนโค้ดและไม่ต้องตั้งค่า proxy
สิ่งสำคัญของการกันบล็อกที่ใช้ได้จริงในปี 2025 คือ: header ที่สมจริงพร้อม Client Hints ครบชุด, curl_cffi สำหรับปลอม TLS fingerprint, การหน่วงแบบสุ่มพร้อม exponential backoff, การหมุน residential proxy, และเหนือสิ่งอื่นใดคือการ parse JSON ที่ซ่อนอยู่ (application/ld+json และ react-root-props) แทน CSS selector ที่เปราะบาง
ยังไม่แน่ใจว่าเส้นทางไหนเหมาะกับคุณ? ลองแพ็กเกจฟรีของ Thunderbit ก่อน ถ้ามันตอบโจทย์คุณ ก็ประหยัดเวลาไปได้หลายชั่วโมง แต่ถ้าคุณต้องการควบคุมมากกว่า — pipeline แบบโปรแกรมเต็มรูปแบบ, ฟิลด์กำหนดเอง, เชื่อมต่อ CRM แบบแน่น ๆ — คู่มือ Python ด้านบนก็ครอบคลุมให้แล้ว และถ้าอยากดูภาพรวมเครื่องมือดึงข้อมูลเชิงลึก ลองอ่านบทสรุปของส่วนขยาย Chrome สำหรับ web scraper ที่ดีที่สุด หรือคู่มือดึงข้อมูลจากเว็บไซต์ลง Excel ของเรา
ลองใช้ Thunderbit สำหรับดึงข้อมูล Yelp Get Started Free
คำถามที่พบบ่อย
ฉันสามารถ scrape Yelp ด้วย Python ฟรีได้ไหม?
ได้ — ใช้ไลบรารีฟรีอย่าง curl_cffi, parsel, และ jmespath แต่ถ้าใช้งานในปริมาณจริง (มากกว่าสองสามสิบหน้า) คุณจะต้องใช้ paid residential proxies ซึ่งเริ่มราว$1.75/GB กับ IPRoyal Thunderbit ก็มีแพ็กเกจฟรีที่รองรับ 6 หน้า/เดือน สำหรับการดึงข้อมูลแบบเร็ว ๆ โดยไม่ต้องเขียนโค้ด
Yelp บล็อก scraper ไหม?
บล็อก และค่อนข้างหนักด้วย Yelp ใช้TLS/JA3 fingerprinting, การให้คะแนน IP reputation, CAPTCHA, behavioral analysis และการสลับ CSS class แบบทำให้สับสน requests แบบปกติจะโดนบล็อกตั้งแต่ครั้งแรก กลยุทธ์กันบล็อกแบบหลายชั้นในคู่มือนี้ — ใช้ curl_cffi เพื่อปลอม TLS, header สมจริง, หน่วงแบบสุ่ม และ residential proxies — คือสิ่งที่ยังใช้งานได้ในปี 2025
Yelp Fusion API ดีกว่าการ scrape ไหม?
ขึ้นอยู่กับความต้องการของคุณ API ได้รับอนุญาตและมีความเสี่ยงต่ำ แต่ให้ตัวอย่างรีวิวเพียง 3 รายการ รายการละ ~160 ตัวอักษร, จำกัดผลการค้นหาไว้ที่ 240, และเริ่มต้นที่ $29/เดือน ถ้าคุณต้องการข้อความรีวิวเต็ม, เมตาดาต้ารีวิว, หรือข้อมูลมากกว่าสองสามร้อยเรคคอร์ดต่อวัน การ scrape คือทางเลือกเดียว
จะ scrape รีวิว Yelp ด้วย Python ได้อย่างไร?
ใช้ curl_cffi พร้อม impersonate="chrome131" เพื่อดึงหน้าธุรกิจ, อ่าน business ID ที่เข้ารหัสจาก <meta name="yelp-biz-id">, แล้วส่ง POST ไปที่ https://www.yelp.com/gql/batch ด้วย operation GetBusinessReviewFeed จากนั้นใช้ cursor แบบ base64 ใน after เพื่อแบ่งหน้า โค้ดทีละขั้นอยู่ในส่วน tutorial ด้านบน และrepo ของ Scrapfly Yelp scraper ก็เป็นตัวอย่างอ้างอิงที่ดีเช่นกัน
ฉันสามารถ scrape Yelp โดยไม่ต้องเขียนโค้ดได้ไหม?
ได้ — AI Web Scraper ของ Thunderbit มีเทมเพลตธุรกิจ Yelp และรีวิว Yelp สำเร็จรูป เปิดหน้า Yelp, คลิก AI Suggest Fields, แล้วคลิก Scrape ได้เลย การส่งออกไป Google Sheets, Excel, Airtable และ Notion ฟรีทุกแพ็กเกจ รวมถึงแพ็กเกจฟรีด้วย
เรียนรู้เพิ่มเติม



