
Google News ดึงข่าวจากแหล่งข้อมูลมากกว่า 50,000 แห่ง ทั่วโลก จึงนับเป็นหนึ่งในแหล่งข่าวเรียลไทม์ที่มีข้อมูลแน่นที่สุดบนอินเทอร์เน็ต แต่มีเรื่องหนึ่งที่แทบไม่มีใครบอกคุณตั้งแต่ต้น: Google ปิด News API อย่างเป็นทางการของตัวเองไปตั้งแต่ปี 2011 และไม่เคยทำตัวใหม่ขึ้นมาแทนเลย
ผลก็คือทีม PR ที่ต้องคอยตามว่าแบรนด์ถูกพูดถึงตรงไหนบ้าง ฝ่ายขายที่คอยจับสัญญาณความเคลื่อนไหวในอุตสาหกรรม และนักวิเคราะห์ที่ต้องปั้นแดชบอร์ดข้อมูลคู่แข่ง ต่างก็ติดอยู่ตรงกลางกันหมด คุณอยากได้ข้อมูลข่าวแบบมีโครงสร้าง — พาดหัว แหล่งข่าว วันที่ เนื้อหาข่าว — แต่ Google กลับตั้งใจกันการดึงข้อมูลอัตโนมัติด้วย CAPTCHA, rate limiting และการเปลี่ยนโครงสร้างหน้าเว็บอยู่เรื่อย ๆ ผมใช้เวลาหลายปีสร้างและทดสอบเครื่องมือดึงข้อมูลที่ Thunderbit และบอกได้เลยว่าช่องว่างระหว่างคำว่า “เดี๋ยวขอ scrape Google News แป๊บเดียว” กับการได้ข้อมูลแบบมีโครงสร้างที่เชื่อถือได้จริง ๆ มันกว้างกว่าที่คนส่วนใหญ่คิดเยอะ
คู่มือนี้รวมเครื่องมือดึงข้อมูล Google News ที่ดีที่สุด 10 ตัวเท่าที่ผมเจอ ครอบคลุมทั้งฝั่ง API เครื่องมือแบบไม่ต้องเขียนโค้ด และตัวที่มี free tier ให้ลองก่อน — พร้อมเทียบราคาแบบตรงไปตรงมา แจกแจงเรื่องการรับมือระบบกันบอท และลงรายละเอียดระดับฟิลด์ข้อมูลที่ช่วยให้คุณเลือกเครื่องมือได้จริง
ลองใช้ Thunderbit สำหรับดึงข้อมูล Google News
ทำไม Google News ถึงดึงข้อมูลยาก (และทำไมถึงไม่มี API อย่างเป็นทางการ)
Google ยุติการให้บริการ News API ไปตั้งแต่ปี 2011 หลังจากนั้นทุกเครื่องมือที่เรียกตัวเองว่า “Google News API” ล้วนเป็น wrapper ของบุคคลที่สาม ที่ไป scrape หรือ proxy ผลลัพธ์ของ Google News มาให้คุณอีกทอดหนึ่ง ตัวเลือกที่เป็นทางการและใกล้เคียงที่สุดคือ Custom Search JSON API ซึ่งให้ คิวรีฟรีวันละ 100 ครั้ง และคิดเงิน $5 ต่อ 1,000 คิวรี แต่คุณต้องไปตั้งค่า custom search engine เองก่อน แถมมันก็ไม่ใช่ตัวแทนที่เสียบใช้แทน Google News ได้ทันที
ส่วนกำแพงกัน scraper ของ Google เองก็ไม่ใช่เรื่องเล่น ๆ:
- การจำกัดอัตราการเรียกตาม IP: ยิง Google News ถี่เกินไปเมื่อไหร่ คุณจะเจอ error 429 หรือด่าน CAPTCHA แทบจะทันที
- หน้า consent และหน้าคั่น: ขึ้นอยู่กับว่าคุณอยู่ประเทศไหน Google อาจเสิร์ฟหน้ายินยอมคุกกี้ขึ้นมา แล้ว parser ส่วนใหญ่ก็พังตั้งแต่ต้น
- เนื้อหาที่เรนเดอร์ด้วย JavaScript: เนื้อหาส่วนใหญ่ของ Google News โหลดแบบไดนามิก การยิง HTTP request ธรรมดาจึงได้ HTML กลับมาไม่ครบ
- URL ที่ถูกห่อด้วย redirect: ลิงก์ใน Google News มักวิ่งผ่านชั้น redirect ของ Google เองก่อน แล้วค่อยพาไปหน้าเว็บของสำนักข่าวจริง
- โครงสร้างหน้าเว็บที่ขยับตลอด: Google ปรับวิธีจัดวาง news card, story cluster และ section หัวข้อข่าวอยู่เรื่อย ๆ
เดือนมีนาคม 2025 Google ยังเปลี่ยนไปใช้หน้าสำนักพิมพ์ที่สร้างขึ้นอัตโนมัติทั้งหมด ทำให้แพลตฟอร์มยิ่งไดนามิกกว่าเดิม กระทู้ใน GitHub และ Stack Overflow ก็เต็มไปด้วยนักพัฒนาที่มาแลกวิธีแก้ปัญหาหน้า consent, selector ที่พัง และรูปแบบ URL ที่เปลี่ยนไปมา
แล้วทำไมคนถึงยังดึงข้อมูลจากตรงนี้กันอยู่? เพราะมีการค้นหาบน Google หลายพันล้านครั้งต่อวัน และ 15% ของคำค้นเหล่านั้นเป็นคำที่ Google ไม่เคยเห็นมาก่อน สำหรับงานมอนิเตอร์แบรนด์ วิเคราะห์เทรนด์ จับสัญญาณลูกค้ามุ่งหวัง และวิเคราะห์คู่แข่ง Google News ยังเป็นแหล่งข่าวที่กว้างและยืดหยุ่นเรื่องคำค้นที่สุดแห่งหนึ่งเท่าที่หาได้
RSS vs API vs การดึงข้อมูลแบบไม่ต้องเขียนโค้ด: เลือกวิธีให้เหมาะกับงาน
เครื่องมือดึงข้อมูล Google News ไม่ได้ทำงานเหมือนกันหมด ก่อนจะเลือกเครื่องมือสักตัว ลองทำความเข้าใจแนวทางหลัก ๆ ทั้ง 4 แบบก่อนว่าแบบไหนเหมาะกับสถานการณ์ไหน
| แนวทาง | เหมาะกับ | ข้อจำกัด | ตัวอย่างเครื่องมือ |
|---|---|---|---|
| RSS feed ของ Google News | มอนิเตอร์พาดหัวแบบง่าย ๆ ฟรี ปริมาณไม่มาก | ไม่มีเนื้อหาเต็ม ได้สูงสุดราว 100 รายการ กรองได้จำกัด | โปรแกรมอ่าน RSS ทั่วไป, n8n |
| SERP / News API | มอนิเตอร์คีย์เวิร์ดในสเกลใหญ่ ได้ metadata แบบมีโครงสร้าง | มีค่าใช้จ่ายต่อเนื่อง ส่วนใหญ่ได้แค่พาดหัว + ข้อความตัวอย่าง | SerpApi, Scrapingdog, Newsdata.io |
| ดึงข้อมูลตรง (ไม่ต้องเขียนโค้ด) | เนื้อหาข่าวเต็ม ฟิลด์ข้อมูลกำหนดเอง งานวิจัยครั้งเดียวจบ | ต้องรับมือระบบกันบอท ขยายสเกลได้น้อยกว่า API | Thunderbit, Octoparse, Apify |
| ดึงข้อมูลตรง (เขียนโค้ดเอง) | ควบคุมได้สูงสุด ทำ pipeline เองได้ตามใจ | ดูแลรักษาหนัก ต้องจัดการ CAPTCHA เอง พังบ่อย | Scrapy, BeautifulSoup + Selenium |
บทความคู่แข่งส่วนใหญ่พูดถึงแค่ฝั่ง API กับไลบรารี Python แต่ข้อมูล user intent ที่ผมเห็นเล่าคนละเรื่องเลย คนจำนวนมากที่ค้นคำว่า “เครื่องมือดึงข้อมูล Google News ที่ดีที่สุด” ไม่ใช่นักพัฒนา — เป็นผู้จัดการฝ่าย PR หัวหน้าฝ่ายปฏิบัติการ ทีมขาย คนกลุ่มนี้อยากได้อะไรที่คลิกแล้วจบ ไม่ใช่โปรเจกต์เขียนโค้ด ลิสต์นี้เลยใส่ทั้งส่วนขยายเบราว์เซอร์และแพลตฟอร์มแบบไม่ต้องเขียนโค้ดไว้เคียงกับ API ตัวใหญ่ ๆ
อีกเรื่องที่ควรรู้ไว้: RSS feed ของ Google News ยังใช้ได้ฟรีและมีประโยชน์อยู่ ถ้าคุณแค่อยากตามพาดหัวเบา ๆ คุณสมัครรับ feed ตามหัวข้อหรือคีย์เวิร์ดได้ แล้วจะได้ผลลัพธ์ราว 100 รายการ พร้อมชื่อเรื่อง ลิงก์ และวันที่เผยแพร่ แต่ถ้าต้องการเนื้อหาข่าวเต็ม ชื่อผู้เขียน โทนอารมณ์ของข่าว หรือมากกว่าร้อยรายการ คุณต้องพึ่งเครื่องมือด้านล่างนี้
เราประเมินเครื่องมือดึงข้อมูล Google News กันยังไง
ผมใช้เกณฑ์ชุดเดียวกันกับทุกเครื่องมือในลิสต์นี้:
- ใช้งานง่ายแค่ไหน: ไม่ต้องเขียนโค้ด ต้องเขียนโค้ด หรือเป็น API ล้วน ๆ
- การรับมือระบบกันบอท / CAPTCHA: เรื่องเป็นเรื่องตายสำหรับ Google
- ฟิลด์ข้อมูลที่ดึงได้: พาดหัว แหล่งข่าว วันที่ ข้อความตัวอย่าง URL เนื้อหาข่าวเต็ม ผู้เขียน รูปภาพ โทนอารมณ์
- มี free tier ไหม และติดข้อจำกัดอะไรบ้าง
- ต้นทุนต่อ 1,000 request แบบปรับให้เทียบกันได้: เพราะแต่ละเจ้าเสนอราคาคนละแบบ (ต่อเดือน ต่อเครดิต ต่อ request) ผมเลยปรับทุกอย่างให้เป็นต้นทุนต่อ 1,000 ผลลัพธ์ที่สำเร็จ ที่แพ็กเกจเสียเงินถูกที่สุดของแต่ละเจ้า
- รูปแบบการส่งออก: JSON, CSV, Google Sheets, Airtable, Notion ฯลฯ
- ความสามารถในการขยายสเกล: โควตาต่อวัน rate limit และจำนวนงานที่รันพร้อมกันได้
- เหมาะกับงานแบบไหนที่สุด
เรื่องการปรับราคาให้เทียบกันได้นี่สำคัญกว่าที่คิดเยอะ เครื่องมือตัวหนึ่งคิดเงินต่อ “search” (ซึ่งคืนผลลัพธ์มา 10 รายการ) อีกตัวคิดต่อ “เครดิต” (1 เครดิต = 1 แถว) ส่วนตัวที่สามคิดต่อ “request” (โดยการเรนเดอร์ JavaScript คิดเพิ่ม) ถ้าไม่ปรับให้อยู่ฐานเดียวกัน คุณก็กำลังเอาส้มไปเทียบกับอุรังอุตัง
ภาพรวม 10 เครื่องมือดึงข้อมูล Google News ที่ดีที่สุด
นี่คือตารางเทียบรวมทั้งหมด เดี๋ยวผมจะลงรายละเอียดทีละตัวด้านล่าง แต่ตารางนี้น่าจะช่วยตัดตัวเลือกให้แคบลงได้เร็ว
| เครื่องมือ | ประเภท | Free Tier | ต้นทุนต่อ 1K ผลลัพธ์ (โดยประมาณ) | การรับมือระบบกันบอท | ดึงเนื้อหาข่าวเต็ม | รูปแบบการส่งออก | เหมาะกับใคร |
|---|---|---|---|---|---|---|---|
| Thunderbit | Chrome extension / ไม่ต้องเขียนโค้ดด้วย AI | ฟรี 6 หน้า | ~$6–$30 ต่อ 1K แถว (ตามแพ็กเกจ) | โหมดเบราว์เซอร์ (ใช้เซสชันของคุณ) + โหมดคลาวด์ | ได้ (ดึงข้อมูลหน้าย่อย) | Excel, CSV, Sheets, Airtable, Notion, JSON | ผู้ใช้ที่ไม่ใช่สายเทคนิค ทีมธุรกิจ |
| SerpApi | SERP API | 250 search/เดือน | ~$5–$15 ต่อ 1K ผลลัพธ์ | ระบบเลี่ยงการตรวจจับเฉพาะ SERP | ไม่ได้ (พาดหัว + ข้อความตัวอย่าง) | JSON | นักพัฒนา สาย pipeline API แบบมีโครงสร้าง |
| ScraperAPI | Scraping API ทั่วไป | 5,000 เครดิต (ทดลอง 7 วัน) | ~$0.10–$0.49 ต่อ 1K request | หมุนพร็อกซี เรนเดอร์ JS | ไม่มี parser เฉพาะทาง | JSON, HTML | นักพัฒนางบจำกัด งาน scraping ทั่วไป |
| Apify | แพลตฟอร์ม scraping บนคลาวด์ | แพ็กเกจฟรี (เครดิต $5/เดือน) | ขึ้นกับ actor และ compute ที่ใช้ | เรนเดอร์ JS, headless browser | ขึ้นกับ actor | JSON, CSV, Excel, API | ทีมสายเทคนิค ที่อยากได้เวิร์กโฟลว์สำเร็จรูป |
| Bright Data | scraper / ชุดข้อมูลระดับองค์กร | ฟรี 5,000 เครดิต/เดือน | ~$1.30–$2.50 ต่อ 1K เรกคอร์ด | พร็อกซี แก้ CAPTCHA เรนเดอร์เบราว์เซอร์ | ได้ (ผลิตภัณฑ์ News Scraper) | JSON, CSV | pipeline ระดับองค์กร |
| Octoparse | แพลตฟอร์มไม่ต้องเขียนโค้ดแบบเห็นภาพ | แพ็กเกจฟรี (จำกัด) | ~$9–$25 ต่อ 1K แถว (เฉลี่ยรวมค่าแพ็กเกจ) | รันบนคลาวด์ มีระบบกันบล็อก | ได้ (เทมเพลตมีฟิลด์เนื้อหาข่าว) | CSV, Excel, JSON, ฐานข้อมูล | คนที่ชอบสร้างเวิร์กโฟลว์แบบเห็นภาพ |
| ScrapingBee | Scraping API | เครดิตทดลองใช้ | ผันแปร (คิดตามเครดิต JS แพงกว่า) | Headless Chrome หมุนพร็อกซี แก้ CAPTCHA | ไม่มี parser เฉพาะทาง | JSON, HTML | นักพัฒนาที่ต้องการการเรนเดอร์ JS |
| Oxylabs | SERP / scraper API | ทดลองใช้ได้ถึง 2,000 ผลลัพธ์ | ~$1.00–$2.35 ต่อ 1K ผลลัพธ์ | พร็อกซีกว่า 100 ล้าน IP แก้ CAPTCHA | ไม่ได้ (ข้อมูลระดับ SERP) | JSON | งานสเกลใหญ่ ที่ต้องเจาะรายประเทศ |
| Scrapingdog | SERP API ราคาประหยัด | 200 เครดิตฟรี | ~$0.20 ต่อ 1K request | ระบบเลี่ยงการตรวจจับเฉพาะ SERP | ไม่ได้ (พาดหัว + ข้อความตัวอย่าง) | JSON | นักพัฒนาที่คุมงบเข้ม |
| Newsdata.io | API ข่าวโดยเฉพาะ | 200 request/วัน | ขึ้นกับแพ็กเกจ | ไม่เกี่ยว (ไม่ได้ดึงจาก Google โดยตรง) | ได้ (แพ็กเกจพรีเมียม) | JSON | งานที่ต้องใช้ฟีเจอร์ NLP ด้านข่าว |
มีสองสามอย่างที่เด้งออกมาชัด ต้นทุนต่อ request ถูกที่สุด? Scrapingdog กับ ScraperAPI ตั้งค่าง่ายที่สุดแบบไม่ต้องเขียนโค้ด? Thunderbit กับ Octoparse ความเสถียรระดับองค์กรพร้อมเจาะรายประเทศ? Bright Data กับ Oxylabs
ทีนี้มาดูรายละเอียดทีละตัวกัน
1. Thunderbit — เครื่องมือดึงข้อมูล Google News แบบไม่ต้องเขียนโค้ดที่ดีที่สุดสำหรับผู้ใช้ธุรกิจ
 Thunderbit คือเครื่องมือที่บริษัทของเราสร้างขึ้นเอง ผมขอบอกตรง ๆ ไว้ก่อน แต่ผมก็จะพูดให้ชัดด้วยว่ามันทำอะไรได้และทำอะไรไม่ได้ เพราะผมคิดว่าความตรงไปตรงมามีประโยชน์กว่าการโม้
Thunderbit เป็น Chrome extension ที่ขับเคลื่อนด้วย AI ออกแบบมาสำหรับคนที่ต้องการข้อมูลแบบมีโครงสร้างจากเว็บโดยไม่ต้องเขียนโค้ด เฉพาะเคส Google News เวิร์กโฟลว์จะหน้าตาประมาณนี้:
- เปิดหน้าผลการค้นหา Google News ใน Chrome
- กด "AI Suggest Fields" — AI จะอ่านหน้าเว็บแล้วตรวจจับคอลัมน์ให้อัตโนมัติ เช่น พาดหัว แหล่งข่าว วันที่ ข้อความตัวอย่าง และ URL
- กด "Scrape" เพื่อดึงข้อมูลออกมาเป็นตารางที่มีโครงสร้าง
นั่นคือระดับหน้ารายการข่าว แต่ของจริงสำหรับงานข่าวอยู่ที่ขั้นถัดไป หลังจาก scrape ผลลัพธ์ Google News เสร็จ คุณกด "Scrape Subpages" เพื่อให้มันเข้าไปในแต่ละ URL ข่าว แล้วดึงเนื้อหาข่าวเต็ม ชื่อผู้เขียน รูปภาพ และอื่น ๆ ออกมาต่อได้เลย ตรงนี้แก้ปัญหาที่คนถามกันไม่หยุดในฟอรัม — "ได้ลิงก์มาแล้ว แต่ยังต้องไปไล่เปิดแล้วดึงเนื้อหาจริงอยู่ดี"
Field AI Prompt ให้คุณใส่คำสั่ง AI เพิ่มเองได้ทีละคอลัมน์ เช่น เพิ่มคอลัมน์ "โทนอารมณ์" พร้อมคำสั่งประมาณว่า "จัดว่าข่าวนี้มีท่าทีเชิงบวก เชิงลบ หรือเป็นกลางต่อ [แบรนด์]" แปลว่าคุณกำลังดึงข้อมูล และ เสริมข้อมูลไปพร้อมกันในรอบเดียว เรื่องนี้เครื่องมือฝั่ง API ล้วน ๆ ไม่มีตัวไหนทำให้ได้
Thunderbit รองรับทั้ง Browser Scraping (รันในเซสชัน Chrome ของคุณเอง สืบทอดคุกกี้และสถานะล็อกอินไปด้วย จึงเลี่ยงตัวจุดชนวนการตรวจจับบอทได้หลายแบบ) และ Cloud Scraping (รับได้ทีละ 50 หน้า พร้อมโครงสร้างพื้นฐานกันบอทในตัว) นอกจากนี้ยังตั้ง การดึงข้อมูลตามตารางเวลา ไว้สำหรับงานมอนิเตอร์ข่าวแบบทำซ้ำได้ด้วย
ฟีเจอร์เด่น
- AI Suggest Fields ตรวจจับคอลัมน์พาดหัว แหล่งข่าว วันที่ และ URL ให้อัตโนมัติ
- ดึงข้อมูลหน้าย่อยเพื่อเก็บเนื้อหาข่าวเต็ม ผู้เขียน และรูปภาพ
- Field AI Prompt สำหรับวิเคราะห์โทนอารมณ์ แปลภาษา หรือติดป้ายกำกับตามที่คุณกำหนด
- มีทั้งโหมด Cloud และ Browser
- ตั้งเวลาดึงข้อมูลรายวัน/รายสัปดาห์ได้
- ส่งออกข้อมูลฟรีไปยัง Google Sheets, Airtable, Notion, Excel, CSV, JSON
ราคา
- Free tier: 6 หน้า
- ทดลองใช้ฟรี: 10 หน้า
- แพ็กเกจเสียเงินเริ่มราว $9 ต่อเดือน (คิดตามเครดิต โดย 1 เครดิต = ผลลัพธ์ 1 แถว)
- ต้นทุนต่อ 1K แถวหลังปรับฐาน: ราว $6–$30 แล้วแต่แพ็กเกจ
เหมาะกับใคร
ทีมขาย คน PR ผู้จัดการฝ่ายปฏิบัติการ และใครก็ตามที่ต้องการข้อมูล Google News แบบมีโครงสร้างโดยไม่ต้องแตะโค้ดสักบรรทัด จุดแข็งจะเด่นเป็นพิเศษเมื่อคุณต้องการเนื้อหาข่าวเต็มพ่วงกับฟิลด์ที่ AI ช่วยเสริม เช่น โทนอารมณ์ของข่าว
2. SerpApi — Google News API แบบมีโครงสร้างที่ดีที่สุดสำหรับนักพัฒนา
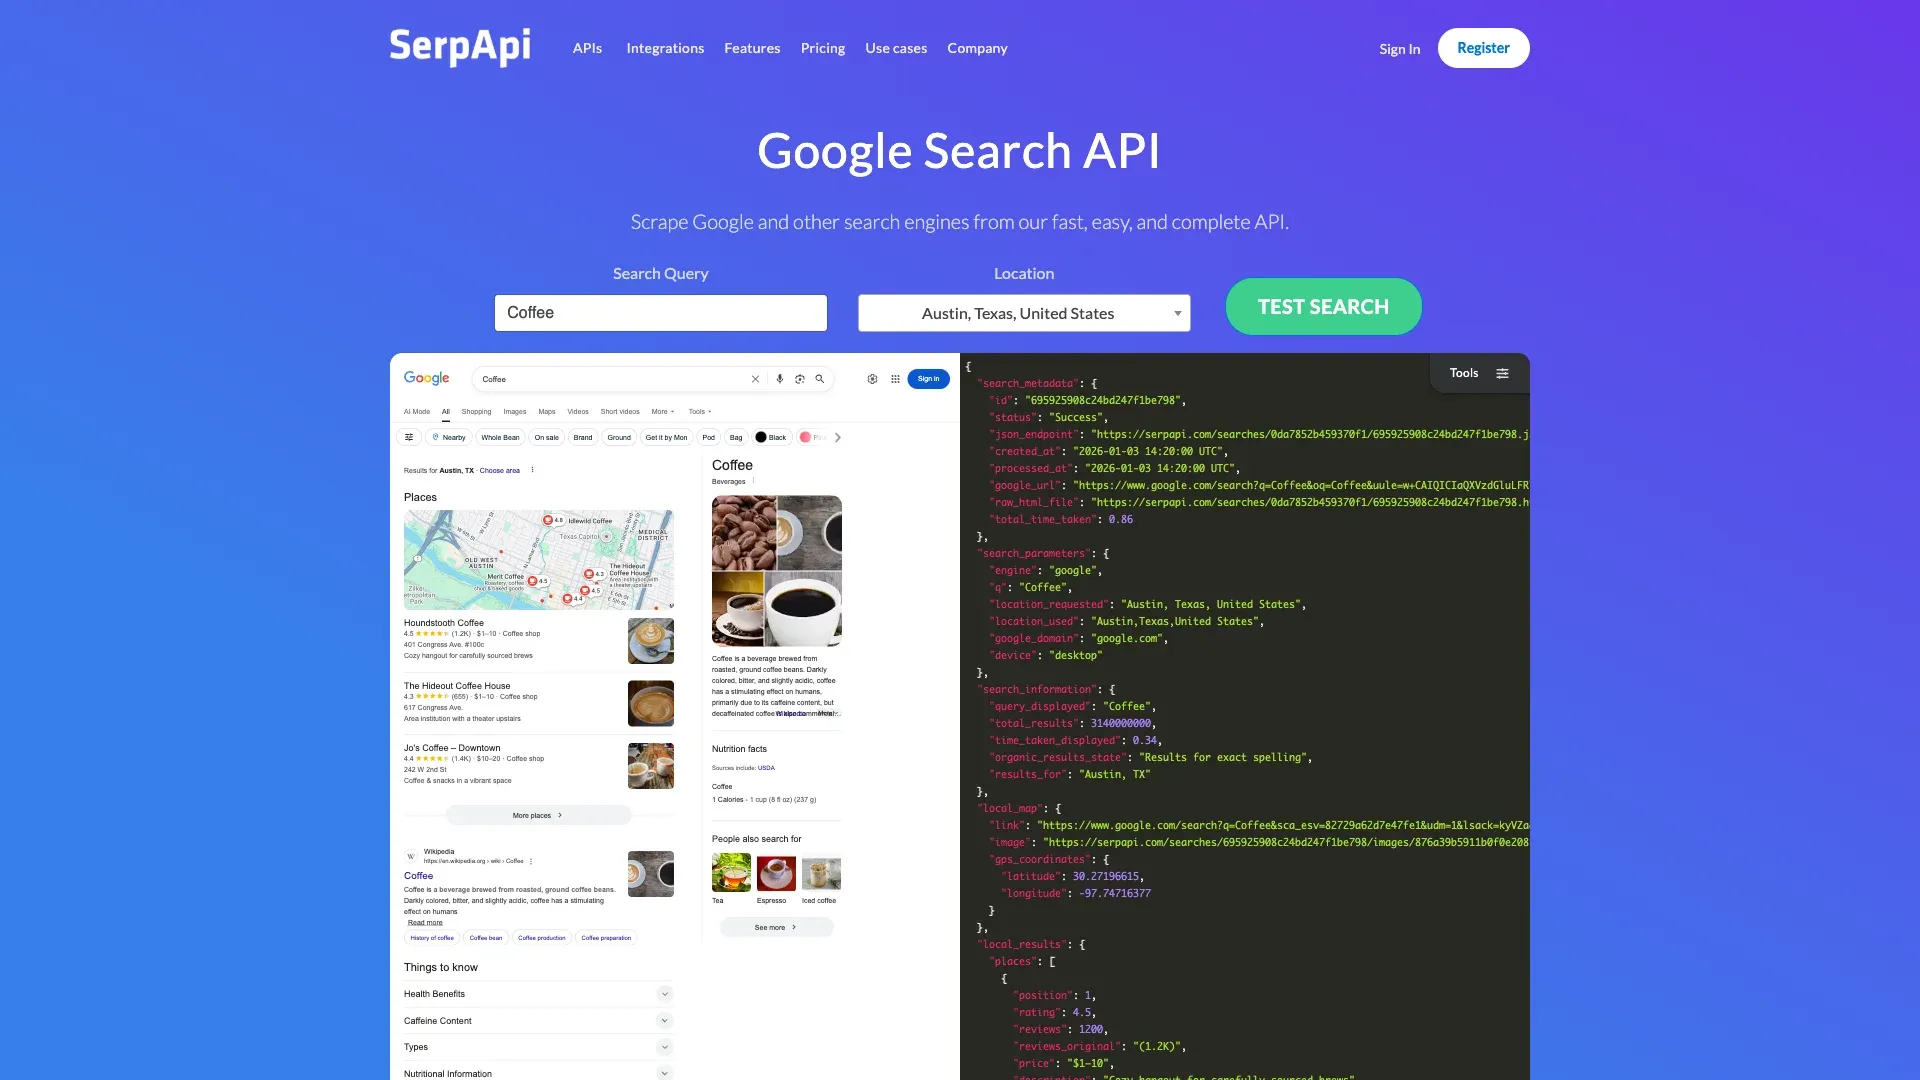 SerpApi คือตัวเลือกแรกถ้าคุณอยากได้ endpoint สำหรับ Google News โดยเฉพาะ ที่คืน JSON สะอาด ๆ มีโครงสร้างชัดเจน มันมี endpoint ที่เกี่ยวข้องอยู่ 2 ตัว ตัวหนึ่งสำหรับ
news.google.com (หน้า Google News) อีกตัวสำหรับแท็บข่าว tbm=nws บนหน้าค้นหา Google ปกติ
เอกสารฝั่งฟิลด์ข้อมูลละเอียดกว่าเจ้าอื่นผิดปกติ คุณจะได้ title, source, authors, link, thumbnail, topic_token, story_token, related_topics และ related_publications ตัว story token กับ topic token นี่มีประโยชน์จริงเวลาต้องกรองข่าวซ้ำที่ถูกจับกลุ่มเข้าด้วยกัน ซึ่งเป็นจุดเจ็บที่เครื่องมือส่วนใหญ่มองข้าม
จากที่ผมใช้มา SerpApi ตอบสนองไว (ปกติไม่เกิน 2 วินาที) และ uptime ก็แน่น ข้อจำกัดหลักคือมันเป็น API ล้วน ๆ คุณจึงต้องเขียนโค้ดหรือหาตัวเชื่อมแบบ no-code มารับข้อมูลต่อ และไม่มีเนื้อหาข่าวเต็ม — ได้แค่พาดหัว ข้อความตัวอย่าง และ metadata
ฟีเจอร์เด่น
- endpoint ค้นหา Google News โดยเฉพาะ คืนค่าเป็น JSON แบบมีโครงสร้าง
- เจาะตามตำแหน่งที่ตั้งและภาษาได้
- ค้นข่าวย้อนหลังผ่านพารามิเตอร์
tbs - รองรับ story token และ topic token สำหรับจัดกลุ่มข่าว
ราคา
- ฟรี: 250 search ต่อเดือน
- Developer: $75 ต่อเดือน สำหรับ 5,000 search
- Production: $150 ต่อเดือน สำหรับ 15,000 search
- ต้นทุนต่อ 1K ผลลัพธ์หลังปรับฐาน: ~$5–$15 (คิดที่ราว 10 ผลลัพธ์ต่อ 1 search)
เหมาะกับใคร
นักพัฒนาที่กำลังสร้างระบบมอนิเตอร์ข่าวอัตโนมัติ และต้องการข้อมูล SERP ที่มีโครงสร้าง เชื่อถือได้ และครอบคลุมฟิลด์ดี
3. ScraperAPI — API ทั่วไปราคาประหยัดที่สุดสำหรับ Google News
 ScraperAPI เป็น scraping API แบบครอบจักรวาล ไม่ได้ทำมาเพื่อ Google News โดยเฉพาะ แต่ที่ใส่ไว้ในลิสต์เพราะมันเป็นวิธีที่ถูกที่สุดวิธีหนึ่งในการยิงหน้า Google News จำนวนมาก ถ้าคุณโอเคกับการเขียน parser เอง
ScraperAPI จัดการเรื่องหมุนพร็อกซี เรนเดอร์ JavaScript และแก้ CAPTCHA ให้หลังบ้าน ผ่าน REST API ง่าย ๆ คุณส่ง URL ไป มันคืน HTML ที่เรนเดอร์แล้วกลับมา ข้อแม้คือไม่มี parser สำหรับ Google News มาให้ คุณต้องแกะฟิลด์เอง (หรือจับคู่กับไลบรารีสำหรับ parse)
ผู้ใช้บางส่วนบอกว่าตอบสนองช้า (7–23 วินาทีใน benchmark) และระบบเครดิตทำให้ request แต่ละแบบกินเครดิตไม่เท่ากัน แต่สำหรับนักพัฒนาที่แกะ HTML ของ Google News เป็นอยู่แล้ว ราคาของ ScraperAPI สู้ยาก
ฟีเจอร์เด่น
- หมุนพร็อกซีอัตโนมัติและเจาะตามพื้นที่ได้
- เรนเดอร์ JavaScript
- คิดตามเครดิต (แพ็กเกจพื้นฐานให้ 100K เครดิต)
- เครดิตทดลองใช้ฟรี 5,000 นาน 7 วัน ไม่ต้องผูกบัตร
ราคา
- ทดลองใช้ฟรี: 5,000 เครดิต (7 วัน)
- Hobby: $49 ต่อเดือน (100,000 เครดิต)
- Startup: $149 ต่อเดือน (1,000,000 เครดิต)
- ต้นทุนต่อ 1K request หลังปรับฐาน: ~$0.10–$0.49 แล้วแต่แพ็กเกจ
เหมาะกับใคร
นักพัฒนาที่คุมงบเข้ม ต้องการชั้นพร็อกซี/เรนเดอร์ราคาถูก และยินดีสร้าง parser สำหรับ Google News เอง
4. Apify — แพลตฟอร์มคลาวด์ที่ดีที่สุดพร้อม Actor สำเร็จรูปสำหรับ Google News
 Apify เป็นแพลตฟอร์ม scraping บนคลาวด์ ที่มีมาร์เก็ตเพลสของ "Actor" — สคริปต์ดึงข้อมูลสำเร็จรูปที่รันได้เลยโดยไม่ต้องเขียนโค้ด มี Google News Scraper actor จากคอมมูนิตี้ให้เลือกอยู่หลายตัว และตัวแพลตฟอร์มก็จัดการเรื่องการรันบนคลาวด์ การตั้งเวลา และที่เก็บข้อมูลให้
คุณเริ่มงานได้ไวมากด้วย actor สำเร็จรูป ข้อแลกเปลี่ยนคือ actor จากคอมมูนิตี้มีคุณภาพและการดูแลไม่เท่ากัน บางตัวพังทันทีที่ Google ปรับหน้าเว็บ แล้วคุณก็ต้องรอเจ้าของ actor มาแก้ให้ โครงสร้างพื้นฐานของ Apify เองนั้นแน่น แต่ประสบการณ์เฉพาะกับ Google News ขึ้นอยู่กับว่าคุณเลือก actor ตัวไหน
ฟีเจอร์เด่น
- มี actor สำหรับ Google News โดยเฉพาะใน Apify Store
- ตั้งเวลารันบนคลาวด์ได้
- เชื่อมต่อผ่าน API และ webhook
- ส่งออกเป็น JSON, CSV, Excel หรือดึงผ่าน API
ราคา
- แพ็กเกจฟรี: $0 ต่อเดือน (เครดิตใช้งาน $5)
- แพ็กเกจเสียเงินเริ่มที่ $29 ต่อเดือน
- ต้นทุนต่อ 1K request หลังปรับฐาน: ผันแปรตาม actor และปริมาณ compute ที่ใช้
เหมาะกับใคร
ทีมสายเทคนิคที่อยากได้เวิร์กโฟลว์ดึงข้อมูลสำเร็จรูปโดยไม่ต้องสร้างเองตั้งแต่ศูนย์ และต้องการการตั้งเวลาบนคลาวด์พร้อมการเชื่อมต่อ API
5. Bright Data — เครื่องมือดึงข้อมูล Google News ระดับองค์กรที่ดีที่สุด
 Bright Data คือตัวหนักฝั่งองค์กร ผลิตภัณฑ์ News Scraper ของเขาระบุชัดว่ารองรับ Google News พร้อมระบบจัดการพร็อกซีอัตโนมัติ เรนเดอร์เบราว์เซอร์เต็มรูปแบบ แก้ CAPTCHA และรับงานเป็นชุดได้ถึง 5,000 URL ฟิลด์ที่ได้มีทั้ง ID, URL, พาดหัว, ผู้เขียน, หัวข้อ และอื่น ๆ
Bright Data ยังขายชุดข้อมูล Google News ที่เก็บไว้ล่วงหน้า เริ่มต้นที่ $2.50 ต่อ 1,000 เรกคอร์ด นับเป็นทางเลือกที่ดีสำหรับทีมที่ไม่อยากไปนั่งดึงข้อมูลสด
สิ่งที่ทำให้เขาต่างจากคนอื่นในเรื่องการรับมือระบบกันบอทคือเครือข่าย residential proxy กว่า 72 ล้าน IP ถ้าคุณต้องดึงข้อมูล Google News จากหลายประเทศในปริมาณมาก Bright Data ช่วยซับความยุ่งยากตรงนี้ไปให้หมด
ฟีเจอร์เด่น
- News Scraper ที่รองรับ Google News
- residential proxy กว่า 72 ล้าน IP พร้อมเจาะตามพื้นที่
- ระบบแก้ CAPTCHA ในตัว
- Web Scraper IDE (แบบเห็นภาพ กึ่งไม่ต้องเขียนโค้ด)
- เลือกจ่ายแบบเติมเงินหรือรายเดือนก็ได้
ราคา
- Free tier: 5,000 เครดิตต่อเดือน
- แบบเติมเงิน: ~$1.50 ต่อ 1K เรกคอร์ด
- Scale: $499 ต่อเดือน (รวม 384K เรกคอร์ด ส่วนเกิน ~$1.30 ต่อ 1K)
เหมาะกับใคร
ธุรกิจขนาดใหญ่และองค์กรที่ต้องการข้อมูล Google News ปริมาณมาก ความเสถียรสูง ครอบคลุมหลายประเทศ พร้อมโครงสร้างด้านการกำกับดูแล
6. Octoparse — เครื่องมือเดสก์ท็อปแบบไม่ต้องเขียนโค้ดที่ดีที่สุดสำหรับ Google News
 Octoparse มีทั้งเทมเพลต Google News Scraper แบบปกติและแบบ Cloud รายการฟิลด์ของเขาโปร่งใสผิดปกติ ได้แก่ คีย์เวิร์ด แหล่งข่าว ชื่อเรื่อง วันที่เผยแพร่ URL เนื้อหาข่าว ผู้เขียน บทคัดย่อ รูปภาพ และฟิลด์ข้อความแจ้งข้อผิดพลาด
เทมเพลตบนคลาวด์ถึงขั้นประกาศอัตราค่าบริการไว้ที่ $0.1 ต่อ 1,000 บรรทัด ในโหมด Run ซึ่งถือว่าโปร่งใสมากสำหรับเครื่องมือแบบไม่ต้องเขียนโค้ด แต่ต้นทุนจริงยังขึ้นอยู่กับว่าคุณต้องใช้แพ็กเกจระดับไหนถึงจะได้ฟีเจอร์ตั้งเวลาบนคลาวด์และระบบกันบล็อก
ตัวสร้างเวิร์กโฟลว์แบบเห็นภาพของ Octoparse เหมาะกับคนที่อยากคุมขั้นตอนการดึงข้อมูลเองแบบละเอียดโดยไม่ต้องเขียนโค้ด เส้นโค้งการเรียนรู้ชันกว่าแนวทางที่ให้ AI จัดการแบบ Thunderbit แต่ผู้ใช้บางกลุ่มก็ชอบความละเอียดแบบนี้มากกว่า
ฟีเจอร์เด่น
- เทมเพลต Google News สำเร็จรูป พร้อมฟิลด์ที่ดึงได้ละเอียด
- สร้างเวิร์กโฟลว์แบบชี้แล้วคลิก
- รันได้ทั้งบนคลาวด์และบนเครื่อง
- ตั้งเวลาและรันซ้ำอัตโนมัติได้
- ส่งออกเป็น CSV, Excel, JSON และเข้าฐานข้อมูล
ราคา
- แพ็กเกจฟรี ฟีเจอร์จำกัด
- แพ็กเกจเสียเงินเริ่มที่ $69 ต่อเดือน
- ต้นทุนหลังปรับฐาน: ~$9–$25 ต่อ 1K แถว (เฉลี่ยรวมค่าแพ็กเกจแล้ว)
เหมาะกับใคร
ผู้ใช้ที่ไม่ใช่สายเทคนิคแต่ชอบเครื่องมือเดสก์ท็อปแบบเห็นภาพ อยากคุมขั้นตอนการดึงข้อมูลเองทีละสเต็ป และต้องดึงข้อมูล Google News แบบทำซ้ำเป็นประจำ
7. ScrapingBee — API ที่ดีที่สุดสำหรับหน้า Google News ที่ใช้ JavaScript หนัก
 ScrapingBee ถนัดเรื่องการเรนเดอร์ด้วย headless browser หมุนพร็อกซี และเจาะผ่านระบบกันบอท เป็นตัวเลือกที่แข็งแรงเมื่อหน้า Google News ต้องรัน JavaScript ให้ครบก่อนถึงจะแสดงผลลัพธ์ แล้วเดี๋ยวนี้ก็เป็นแบบนี้บ่อยขึ้นเรื่อย ๆ
API ใช้ง่ายมาก ส่ง URL ไป ได้ HTML ที่เรนเดอร์แล้วหรือภาพหน้าจอกลับมา ScrapingBee จัดการเรื่องหมุนพร็อกซีและแก้ CAPTCHA ให้เบื้องหลัง แต่เหมือนกับ ScraperAPI ตรงที่ไม่มี parser สำหรับ Google News โดยเฉพาะ คุณต้องแกะฟิลด์เอง
ระบบเครดิตทำให้ request ที่ต้องเรนเดอร์ JavaScript แพงกว่า request HTTP ธรรมดา อย่าลืมเผื่อจุดนี้ตอนประเมินค่าใช้จ่ายสำหรับ Google News
ฟีเจอร์เด่น
- เรนเดอร์ด้วย headless Chrome สำหรับหน้าที่ใช้ JS หนัก
- หมุนพร็อกซีและข้าม CAPTCHA อัตโนมัติ
- รองรับการดึงข้อมูล Google Search / News
- REST API ตรงไปตรงมา คืนค่าเป็น JSON/HTML
ราคา
- แพ็กเกจเริ่มที่ $49 ต่อเดือน
- คิดตามเครดิต (การเรนเดอร์ JS กินเครดิตต่อ request มากกว่า)
- ต้นทุนต่อ 1K request หลังปรับฐาน: ผันแปรตามความต้องการเรนเดอร์
เหมาะกับใคร
นักพัฒนาที่ต้องการการเรนเดอร์ JavaScript ที่ไว้ใจได้และระบบรับมือบอท สำหรับหน้า Google News ผ่าน API ที่ไม่ซับซ้อน
8. Oxylabs — เครื่องมือดึงข้อมูล Google News ที่ดีที่สุดสำหรับผลลัพธ์เจาะรายประเทศ
 Oxylabs มี Google News Scraper API โดยเฉพาะอยู่ในกลุ่มผลิตภัณฑ์ SERP หนุนหลังด้วยพูลพร็อกซีกว่า 100 ล้าน IP ใน 195 ประเทศ จุดขายคือความเสถียรระดับองค์กร บวกกับผลลัพธ์ที่อิงพื้นที่ได้จริง
Oxylabs รองรับผลลัพธ์ JSON แบบมีโครงสร้าง มีทั้งโหมดเรียลไทม์และแบบเป็นชุด และเขียน logic การ parse เองได้ด้วย XPath กับ CSS selector ราคาเฉพาะฝั่ง Google ก็ระบุชัด: ~$1.00 ต่อ 1K ผลลัพธ์ในแพ็กเกจ Micro และลดลงเหลือ ~$0.90 ต่อ 1K ในแพ็กเกจที่สูงขึ้น
การทดลองใช้ฟรีให้คุณได้ถึง 2,000 ผลลัพธ์ ซึ่งพอสำหรับทดสอบว่าคุณภาพข้อมูลตรงกับที่ต้องการหรือเปล่า
ฟีเจอร์เด่น
- SERP Scraper API ที่รองรับ Google News
- พร็อกซีกว่า 100 ล้าน IP ใน 195 ประเทศ
- ส่งข้อมูลกลับเป็น JSON แบบมีโครงสร้าง
- มีทั้งโหมดดึงข้อมูลเรียลไทม์และแบบเป็นชุด
ราคา
- ทดลองใช้ฟรี: ได้ถึง 2,000 ผลลัพธ์
- Micro:
$1.00 ต่อ 1K ผลลัพธ์ Google ($2.35 ต่อ 1K เมื่อเปิดเรนเดอร์ JS) - แพ็กเกจสูงขึ้น: ~$0.90 ต่อ 1K
- มีแพ็กเกจองค์กรแบบปรับตามความต้องการ
เหมาะกับใคร
องค์กรและธุรกิจขนาดกลางที่ต้องการผลลัพธ์ Google News เจาะรายประเทศในสเกลใหญ่ พร้อมความเสถียรสูง
9. Scrapingdog — Google News API ที่คุ้มค่าที่สุด
 Scrapingdog วางตัวเป็นทางเลือกราคาย่อมเยากว่า SerpApi โดยมี endpoint สำหรับ Google News โดยเฉพาะ ผลลัพธ์ JSON แบบมีโครงสร้างจะมีทั้งชื่อเรื่อง แหล่งข่าว วันที่ ข้อความตัวอย่าง และลิงก์
ราคาดุจริง บางแพ็กเกจให้ 200K request ที่ $40 ซึ่งตกราว $0.20 ต่อ 1,000 request เวลาตอบสนองปกติอยู่ราว 2 วินาที และให้เครดิตฟรี 200 เครดิตไว้ทดลอง
ข้อแลกเปลี่ยนคือ Scrapingdog เป็นบริษัทเล็กกว่า เอกสารน้อยกว่า และมีตัวเชื่อมต่อไม่เท่าเจ้าใหญ่ แต่สำหรับสตาร์ทอัพและคนที่คุมงบเข้ม ตัวเลขทางเศรษฐศาสตร์ของมันน่าสนใจมาก
ฟีเจอร์เด่น
- endpoint Google News Scraper API โดยเฉพาะ
- ผลลัพธ์ JSON แบบมีโครงสร้าง (ชื่อเรื่อง แหล่งข่าว วันที่ ข้อความตัวอย่าง ลิงก์)
- ค้นข่าวย้อนหลังผ่านพารามิเตอร์
tbs - เครดิตฟรี 200 เครดิตไว้ทดลอง
ราคา
- ฟรี: 200 เครดิต
- แพ็กเกจเสียเงินเริ่มที่ $40 ต่อเดือน
- ต้นทุนต่อ 1K request หลังปรับฐาน: ~$0.20
เหมาะกับใคร
นักพัฒนาและสตาร์ทอัพที่คุมงบเข้ม แต่ต้องการข้อมูล Google News ปริมาณมากในต้นทุนต่อ request ที่ต่ำที่สุด
10. Newsdata.io — API ข่าวเฉพาะทางที่ดีที่สุด (ไปไกลกว่า Google News)
 Newsdata.io คือ API ข้อมูลข่าวที่สร้างมาเพื่องานนี้โดยเฉพาะ รวบรวมข่าวจากแหล่งข้อมูลกว่า 50,000 แห่งทั่วโลก จริง ๆ มันไม่ใช่เครื่องมือดึงข้อมูล Google News เพราะไม่ได้ไป scrape Google News ตรง ๆ แต่ไปรวบรวมจากสำนักข่าวชุดเดียวกัน (และมากกว่านั้น) ด้วยตัวเอง แล้วคืนเป็น JSON แบบมีโครงสร้าง ค้นได้ทั้งข่าวเรียลไทม์และข่าวย้อนหลัง
แพ็กเกจพรีเมียมมีทั้งการดึงเนื้อหาข่าวเต็ม การวิเคราะห์โทนอารมณ์ และการกรองตามหมวดหมู่ พวกนี้เป็นฟีเจอร์ที่เครื่องมือสาย SERP ส่วนใหญ่ไม่มีให้ในตัว ส่วน free tier ให้ 200 request ต่อวัน ถือว่าใจดีสำหรับการทดลอง
ถ้าเป้าหมายของคุณคือ "อยากได้ข้อมูลข่าวเกี่ยวกับหัวข้อหนึ่ง" มากกว่า "อยากดึงข้อมูลจาก Google News โดยเฉพาะ" Newsdata.io อาจตอบโจทย์กว่าเครื่องมือสาย SERP ทุกตัวในลิสต์นี้
ฟีเจอร์เด่น
- API ค้นข่าวทั้งแบบเรียลไทม์และย้อนหลัง
- ดึงเนื้อหาข่าวเต็ม (แพ็กเกจพรีเมียม)
- วิเคราะห์โทนอารมณ์ของข่าว (แพ็กเกจพรีเมียม)
- กรองตามหมวดหมู่ ภาษา และประเทศ
- free tier 200 request ต่อวัน
ราคา
- ฟรี: 200 request ต่อวัน
- แพ็กเกจเสียเงินเริ่มที่ $199.99 ต่อเดือน
- ต้นทุนต่อ 1K request หลังปรับฐาน: ผันแปรตามแพ็กเกจ
เหมาะกับใคร
ทีมที่ต้องการแหล่งข้อมูลข่าวเฉพาะทาง พร้อมฟีเจอร์ NLP ในตัว (โทนอารมณ์ การจัดหมวดหมู่) และไม่ได้จำเป็นต้องดึงจาก Google News โดยตรง
เทียบเครื่องมือดึงข้อมูล Google News: ระบบกันบอท ฟิลด์ข้อมูล และราคา
เวลาเลือกเครื่องมือดึงข้อมูล Google News มีอยู่ 3 มิติที่สำคัญกว่าเรื่องอื่นทั้งหมด และผมยังไม่เจอคู่มือเล่มไหนที่ไล่ครบทั้ง 3 มิติอย่างเป็นระบบ
แต่ละเครื่องมือรับมือระบบกันบอทของ Google ยังไง
การรับมือระบบกันบอทคือเรื่องที่คนดึงข้อมูล Google News กังวลเป็นอันดับหนึ่ง แต่ละเครื่องมือเลือกวิธีต่างกันแบบนี้:
| กลยุทธ์ | เครื่องมือที่ใช้วิธีนี้ |
|---|---|
| หมุนพร็อกซีในตัว | Bright Data, ScrapingBee, Oxylabs, ScraperAPI |
| มีระบบแก้ CAPTCHA ให้ | Bright Data, ScrapingBee, Oxylabs |
| เรนเดอร์ JS / headless browser | Apify, Octoparse, ScrapingBee |
| ทำงานในเบราว์เซอร์ (ใช้เซสชันของคุณ) | Thunderbit (โหมด Browser Scraping) |
| ระบบเลี่ยงการตรวจจับเฉพาะ SERP | SerpApi, Scrapingdog |
โหมด Browser Scraping ของ Thunderbit น่าอธิบายเพิ่มอีกหน่อย เพราะมันรันอยู่ในเซสชัน Chrome จริงของคุณ มันจึงสืบทอดคุกกี้และสถานะที่ล็อกอินไว้แล้วไปด้วย แปลว่ามันเลี่ยงตัวจุดชนวนการตรวจจับบอทได้หลายอย่างที่ scraper แบบ headless มักไปสะดุด ทั้งหน้า consent ด่าน CAPTCHA และการตรวจ fingerprint ส่วนงานที่ต้องการปริมาณมาก Cloud Scraping ของ Thunderbit รับได้ทีละ 50 หน้า ด้วยโครงสร้างพื้นฐานกันบอทของตัวเอง
เครื่องมือแต่ละตัวคืนฟิลด์ข้อมูลอะไรบ้าง
นี่คือตารางที่ไม่มีใครทำออกมาเผยแพร่ และเป็นตารางที่มีผลกับการเลือกเครื่องมือมากที่สุด บางตัวให้คุณแค่พาดหัวกับลิงก์ ขณะที่บางตัวดึงเนื้อหาข่าวเต็ม ชื่อผู้เขียน ไปจนถึงโทนอารมณ์ของข่าวได้
| เครื่องมือ | พาดหัว | แหล่งข่าว | วันที่ | ข้อความตัวอย่าง | URL ข่าว | เนื้อหาเต็ม | ผู้เขียน | รูปภาพ | โทนอารมณ์ |
|---|---|---|---|---|---|---|---|---|---|
| Thunderbit | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ (ผ่านหน้าย่อย) | ✅ (ผ่าน AI) | ✅ | ✅ (ผ่าน Field AI Prompt) |
| SerpApi | ✅ | ✅ | ✅ | ✅ | ✅ | ❌ | ✅ | ✅ | ❌ |
| ScraperAPI | ✅ (parse เอง) | ✅ (parse เอง) | ✅ (parse เอง) | ✅ (parse เอง) | ✅ (parse เอง) | ❌ | ❌ | ❌ | ❌ |
| Apify | ✅ | ✅ | ✅ | ✅ | ✅ | ขึ้นกับ actor | ขึ้นกับ actor | ✅ | ❌ |
| Bright Data | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ (News Scraper) | ✅ | ✅ | ❌ |
| Octoparse | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ (เทมเพลต) | ✅ | ✅ | ❌ |
| ScrapingBee | ✅ (parse เอง) | ✅ (parse เอง) | ✅ (parse เอง) | ✅ (parse เอง) | ✅ (parse เอง) | ❌ | ❌ | ❌ | ❌ |
| Oxylabs | ✅ | ✅ | ✅ | ✅ | ✅ | ❌ | ❌ | ✅ | ❌ |
| Scrapingdog | ✅ | ✅ | ✅ | ✅ | ✅ | ❌ | ❌ | ❌ | ❌ |
| Newsdata.io | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ (พรีเมียม) | ✅ | ✅ | ✅ (พรีเมียม) |
จุดที่โดดออกมาคือ Thunderbit ดึงเนื้อหาข่าวเต็มผ่าน Subpage Scraping ได้ และ เติมฟิลด์ที่ AI วิเคราะห์ให้ เช่น โทนอารมณ์ ในรอบเดียวกัน ส่วน Newsdata.io ก็มีทั้งโทนอารมณ์และเนื้อหาเต็มเหมือนกัน แต่ให้ผ่าน API ข่าวเฉพาะทาง ไม่ใช่การดึงจาก Google News ขณะที่ SERP API ส่วนใหญ่คืนมาเฉพาะสิ่งที่มองเห็นบนหน้ารายการข่าวของ Google News เท่านั้น คือพาดหัว ข้อความตัวอย่าง และลิงก์
ต้นทุนต่อ 1,000 ผลลัพธ์ หลังปรับให้เทียบกันได้
นี่คือตารางที่ผมอยากได้ตอนนั่งประเมินเครื่องมือ แล้วหาที่ไหนไม่เจอเลย แต่ละเจ้าเสนอราคาคนละแบบ ผมจึงปรับทุกอย่างให้เป็นต้นทุนต่อ 1,000 ผลลัพธ์ที่สำเร็จ ที่แพ็กเกจเสียเงินถูกที่สุดของแต่ละเจ้า
| เครื่องมือ | Free Tier | แพ็กเกจเสียเงินถูกที่สุด | ต้นทุนต่อ 1K ผลลัพธ์ (โดยประมาณ) | หมายเหตุ |
|---|---|---|---|---|
| Thunderbit | ฟรี 6 หน้า / ทดลอง 10 หน้า | เริ่มราว $9/เดือน (คิดตามเครดิต) | ~$6–$30 | 1 เครดิต = 1 แถว รวมการดึงข้อมูลด้วย AI แล้ว |
| SerpApi | 250 search/เดือน | $75/เดือน (5,000 search) | ~$15 | JSON มีโครงสร้าง มี endpoint Google News |
| ScraperAPI | 5,000 เครดิต (ทดลอง 7 วัน) | $49/เดือน (100K เครดิต) | ~$0.49 | ไม่มี parser สำหรับ Google News |
| Apify | แพ็กเกจฟรี (เครดิต $5/เดือน) | $29/เดือน | ผันแปร | ขึ้นกับ actor และ compute |
| Bright Data | ฟรี 5,000 เครดิต/เดือน | แบบเติมเงิน | ~$1.30–$2.50 | ระดับองค์กร มีตัวเลือกซื้อชุดข้อมูลสำเร็จ |
| Octoparse | แพ็กเกจฟรี (จำกัด) | $69/เดือน | ~$9–$25 | เทมเพลตคลาวด์: $0.1 ต่อ 1K บรรทัด (ราคาฐาน) |
| ScrapingBee | เครดิตทดลองใช้ | $49/เดือน | ผันแปร (JS แพงกว่า) | คิดตามเครดิต ไม่มี parser เฉพาะทาง |
| Oxylabs | ได้ถึง 2,000 ผลลัพธ์ | แพ็กเกจ Micro | ~$1.00–$2.35 | เจาะรายประเทศ คืน JSON แบบมีโครงสร้าง |
| Scrapingdog | 200 เครดิต | $40/เดือน | ~$0.20 | ตัวเลือกประหยัด มี endpoint ข่าวโดยเฉพาะ |
| Newsdata.io | 200 request/วัน | $199.99/เดือน | ผันแปรตามแพ็กเกจ | ไม่ได้ดึงจาก Google โดยตรง มีฟีเจอร์ NLP |
สรุปที่ได้จากตารางนี้ Scrapingdog ถูกที่สุดต่อ request แบบทิ้งห่าง แต่คืนมาแค่ข้อมูลระดับ SERP (ไม่มีเนื้อหาเต็ม) ส่วน Bright Data กับ Oxylabs อยู่กลาง ๆ เรื่องราคา แต่มีโครงสร้างพื้นฐานกันบอทที่แข็งแรงที่สุด ขณะที่ Thunderbit แพงกว่าต่อแถวเมื่อเทียบกับ API ที่ถูกที่สุด แต่ก็เป็นตัวเดียวที่ให้ทั้งการดึงเนื้อหาข่าวเต็มและการเสริมข้อมูลด้วย AI โดยไม่ต้องเขียนโค้ดเลย
แล้วคุณควรเลือกเครื่องมือดึงข้อมูล Google News ตัวไหน?
คำแนะนำของผมแยกตามสถานการณ์:
- แค่อยากได้พาดหัวไว้มอนิเตอร์ งบน้อย? → free tier ของ Scrapingdog หรือ Newsdata.io
- ไม่ใช่สายเทคนิค แต่ต้องการเนื้อหาข่าวเต็มพร้อมข้อมูลเสริม? → Thunderbit
- เป็นนักพัฒนาที่กำลังสร้าง pipeline ข่าวแบบมีโครงสร้าง? → SerpApi (ฟิลด์ครบที่สุด) หรือ Scrapingdog (ราคาดีที่สุด)
- องค์กร ปริมาณสูง ต้องเจาะรายประเทศ? → Bright Data หรือ Oxylabs
- อยากได้เวิร์กโฟลว์แบบเห็นภาพบนเดสก์ท็อป? → Octoparse
- ต้องการข้อมูลข่าวที่ไปไกลกว่า Google News พร้อมฟีเจอร์ NLP? → Newsdata.io
- ต้องการชั้นพร็อกซี/เรนเดอร์แบบทั่วไปที่ถูกที่สุด? → ScraperAPI
เครื่องมือที่ใช่ขึ้นอยู่กับ 3 ปัจจัย: ระดับทักษะทางเทคนิคของคุณ ปริมาณงานที่ต้องรับ และคุณต้องการแค่พาดหัวหรือเนื้อหาข่าวเต็ม ถ้ายังไม่แน่ใจ ให้เริ่มจาก free tier ก่อน เครื่องมือเกือบทุกตัวในลิสต์นี้มีให้ แล้วดูว่าคุณภาพข้อมูลรับมือกับงานจริงของคุณได้แค่ไหน
ถ้าอยากลองเส้นทางที่ไวที่สุดแบบไม่ต้องเขียนโค้ด free tier ของ Thunderbit ให้คุณดึงผลลัพธ์ Google News ได้ในไม่กี่คลิก แล้วส่งออกตรงไปยัง Google Sheets หรือ Airtable ได้เลย ถ้าอยากดูขั้นตอนแบบละเอียด แวะไปที่ ช่อง YouTube ของเรา หรือดู เทมเพลตดึงข้อมูลข่าว ก็ได้
ขอให้พาดหัวข่าวของคุณมีโครงสร้างเสมอ เจอ CAPTCHA ให้น้อย และไฟล์ที่ส่งออกสะอาดหมดจด
ลองใช้ Thunderbit สำหรับดึงข้อมูล Google News Get Started Free
คำถามที่พบบ่อย
Google มี News API อย่างเป็นทางการไหม?
ไม่มี Google ยุติ News API ไปตั้งแต่ปี 2011 และไม่เคยทำตัวใหม่มาแทน ตัวเลือกที่เป็นทางการและใกล้เคียงที่สุดคือ Custom Search JSON API ซึ่งให้คิวรีฟรีวันละ 100 ครั้ง และคิดเงิน $5 ต่อ 1,000 คิวรี แต่ต้องตั้งค่า custom search engine ก่อน และไม่ใช่ผลิตภัณฑ์ที่ทำมาเพื่อ Google News โดยเฉพาะ ทุกเครื่องมือที่เรียกตัวเองว่า “Google News API” ในวันนี้ล้วนเป็นบริการของบุคคลที่สามทั้งนั้น
ใช้ RSS feed ของ Google News แทน scraper ได้ไหม?
ได้ ถ้างานของคุณไม่ซับซ้อน RSS feed ของ Google News ให้พาดหัวและลิงก์ฟรี แต่จำกัดอยู่ราว 100 รายการ ไม่มีเนื้อหาข่าวเต็ม และตัวเลือกการกรองก็น้อยมาก ถ้าคุณต้องการข้อมูลที่ลึกกว่านั้น — เนื้อหาข่าวเต็ม ชื่อผู้เขียน การวิเคราะห์โทนอารมณ์ หรือมากกว่า 100 รายการ — คุณต้องใช้ scraper หรือ API สักตัวจากลิสต์นี้
จะดึงเนื้อหาข่าวเต็มจากผลลัพธ์ Google News ได้ยังไง?
หน้ารายการของ Google News แสดงแค่พาดหัวกับข้อความตัวอย่าง ถ้าจะเอาเนื้อหาข่าวเต็ม คุณต้องใช้เครื่องมือที่ตามลิงก์ข่าวเข้าไปแล้วดึงเนื้อหาในหน้านั้นออกมา Subpage Scraping ของ Thunderbit ทำตรงนี้ให้อัตโนมัติหลังจาก scrape หน้ารายการ Google News เสร็จ ส่วนเครื่องมือฝั่ง API อย่าง Newsdata.io มีเนื้อหาเต็มให้ในแพ็กเกจพรีเมียม ขณะที่ SERP API ส่วนใหญ่ (SerpApi, Scrapingdog, Oxylabs) คืนมาเฉพาะสิ่งที่เห็นบนหน้ารายการเท่านั้น
การดึงข้อมูลจาก Google News ผิดกฎหมายไหม?
การดึงข้อมูลที่เปิดให้สาธารณะมองเห็นได้ โดยทั่วไปไม่ถูกตีความว่าเป็นการเข้าถึงโดยไม่ได้รับอนุญาตตามกฎหมายสหรัฐฯ (อ้างอิงบรรทัดฐานคดี hiQ v. LinkedIn) แต่นั่นไม่ได้แปลว่าปลอดภัยในแง่นโยบาย เงื่อนไขการให้บริการของ Google ไม่สนับสนุนการยิงคิวรีอัตโนมัติ และ Google ก็เสิร์ฟ CAPTCHA และบล็อกทราฟฟิก ทันทีที่ตรวจจับพฤติกรรมคล้ายบอท ผู้ใช้ควรอยู่ในขอบเขตข้อมูลสาธารณะ เคารพลิขสิทธิ์ของเนื้อหาข่าว และปรึกษาที่ปรึกษากฎหมายหากจะใช้ในเชิงพาณิชย์ขนาดใหญ่
อะไรที่ทำให้เครื่องมือดึงข้อมูล Google News พังบ่อยที่สุด?
ตัวการประจำคือระบบตรวจจับคิวรีอัตโนมัติ (CAPTCHA และ error 429), ความต่างตามพื้นที่ (ผลลัพธ์เปลี่ยนตามประเทศ/ภาษา), หน้า consent และหน้าคั่น, การเปลี่ยนโครงสร้าง markup ของ news card และการจัดรูปแบบ URL ที่ผ่าน redirect ชั้นข้อมูลที่เสถียรที่สุดคือ metadata ของข่าว (ชื่อเรื่อง แหล่งข่าว วันที่ URL) ส่วนที่เสถียรน้อยที่สุดคือชั้นการแสดงผล ทั้งการจับกลุ่มข่าว ภาพขนาดย่อ และการจัดเรียง section พวกนี้เปลี่ยนกันบ่อยมาก
เรียนรู้เพิ่มเติม




