
Thunderbit är ett AI-drivet Chrome-tillägg för webbskrapning som hjälper affärsanvändare att hämta data från webbplatser med hjälp av AI. Kärnfrågan är den här: det som ser prisvärt ut på ScrapingBee:s prissida kan se helt annorlunda ut när du kör produktionsjobb och ser hur krediterna försvinner i 5× till 75× av grundnivån. Den här recensionen går igenom fem vinklar som de flesta artiklar hoppar över: den faktiska kostnaden i stor skala, selektorbaserad jämfört med AI-baserad extraktion, användbarhet för icke-utvecklare, arbetsflöden efter skrapningen och tillförlitlighetsnivåer för 2026. Om du utvärderar ScrapingBee för ditt team — oavsett om du är utvecklare, ansvarig för säljops eller grundare — är detta den genomgång du behöver.
Vad är ScrapingBee? En snabb överblick
ScrapingBee är ett API för webbskrapning som hanterar proxyrotation, JavaScript-rendering och CAPTCHA-lösning så att utvecklare kan extrahera data från webbplatser utan att bygga sin egen skrapinfrastruktur. Du skickar en HTTP-begäran med parametrar och får tillbaka HTML (eller JSON för vissa slutpunkter). Det finns inget visuellt gränssnitt eller klickbaserat sätt att bygga skrapningar.
Kärnfunktioner inkluderar:
- Roterande och premiumproxies (klassisk, premium, stealth, residential)
- Renderisering i headless-browser (full Chrome, aktiverat som standard)
- Automatisk förbigång av CAPTCHA
- Google Search API (strukturerad JSON: organiska resultat, annonser, kartor, kunskapsgraf, People Also Ask, bilder, nyheter)
- Skärmdumpsfunktion (standard, hela sidan eller riktad mot CSS-selektor)
- Geografisk målstyrning via parametern country_code
- Extraktionsregler med CSS/XPath (deklarativa, JSON-baserade, returnerar strukturerad JSON)
- Dedikerade API:er för skrapning av Amazon, Walmart, YouTube och ChatGPT
- AI-extraktion (tillagd cirka 2024–2025): ai_query, ai_extract_rules, ai_selector-parametrar (+5 krediter per begäran)
- CLI-verktyg (lanserat cirka 2025–2026): batchbearbetning, crawling, sitemap-parsing, berikning av CSV, schemalagda cron-jobb, proxy-eskalering
ScrapingBee grundades 2019 i Frankrike och växte till ungefär $5 miljoner ARR i början av 2026 med över 2 500 kunder (SAP, Zapier, Deloitte, Zillow) — allt bootstrappat av ett team på 4–6 personer. I juni 2025 förvärvade Oxylabs Group ScrapingBee i en affär i åttasiffrigt belopp. Varumärket och ledningen är fortsatt självständiga, och supportteamet har mer än fördubblats för bättre täckning över tidszoner.
En viktig sak att känna till: ScrapingBee har fortfarande inte någon inbyggd visuell builder, drag-and-drop-GUI eller schemaläggare i en webbpanel. Schemaläggning kräver CLI-verktyget, cron-jobb eller tredjepartsautomation (Zapier, Make, n8n). De "no-code"-guider de publicerar handlar om att använda Make- och Zapier-integrationer — inte om ett inbyggt no-code-gränssnitt.
Vem är ScrapingBee egentligen byggt för?
ScrapingBee är utformat för utvecklare som är bekväma med att skriva Python- eller cURL-anrop, läsa HTML och bygga CSS/XPath-selektorer. Dokumentationen är tungt kodfokuserad och lutar åt Python- och cURL-exempel. En recensent på Capterra påpekade att de "inte erbjuder exempel i JavaScript", och en annan beskrev dokumentationen som "omfattande, tar en dag till en vecka att läsa igenom".
Men målgruppen som söker "ScrapingBee review" år 2026 är bredare än backendutvecklare. Den omfattar marknadschefer som bygger leadlistor, säljops-team som berikar CRM-data, ecommerce-team som bevakar konkurrenters priser och grundare som utvärderar verktyg för sina team. I varje avsnitt nedan markerar jag om en funktion eller begränsning främst berör utvecklare, affärsanvändare eller båda.
ScrapingBee:s prisplaner i korthet
Här är ScrapingBee:s aktuella plannivåer (per april 2026):
| Plan | Månadskostnad | API-krediter/månad | Samtidiga förfrågningar |
|---|---|---|---|
| Freelance | $49 | 250 000 | 10 |
| Startup | $99 | 1 000 000 | 50 |
| Business | $249 | 3 000 000 | 100 |
| Business+ | $599 | 8 000 000 | 200 |
| Enterprise | Kontakta försäljning | 41M+ | Anpassat |
Årsfakturering ger en 17 % rabatt. En gratis provperiod ger 1 000 API-krediter utan att kreditkort krävs. Google Search API har nyligen sänkts från 25 till 15 krediter per anrop efter förvärvet.
De där kreditnivåerna ser generösa ut. Men de är inte vad de verkar vara.
Tabellen över kreditmultiplikatorer
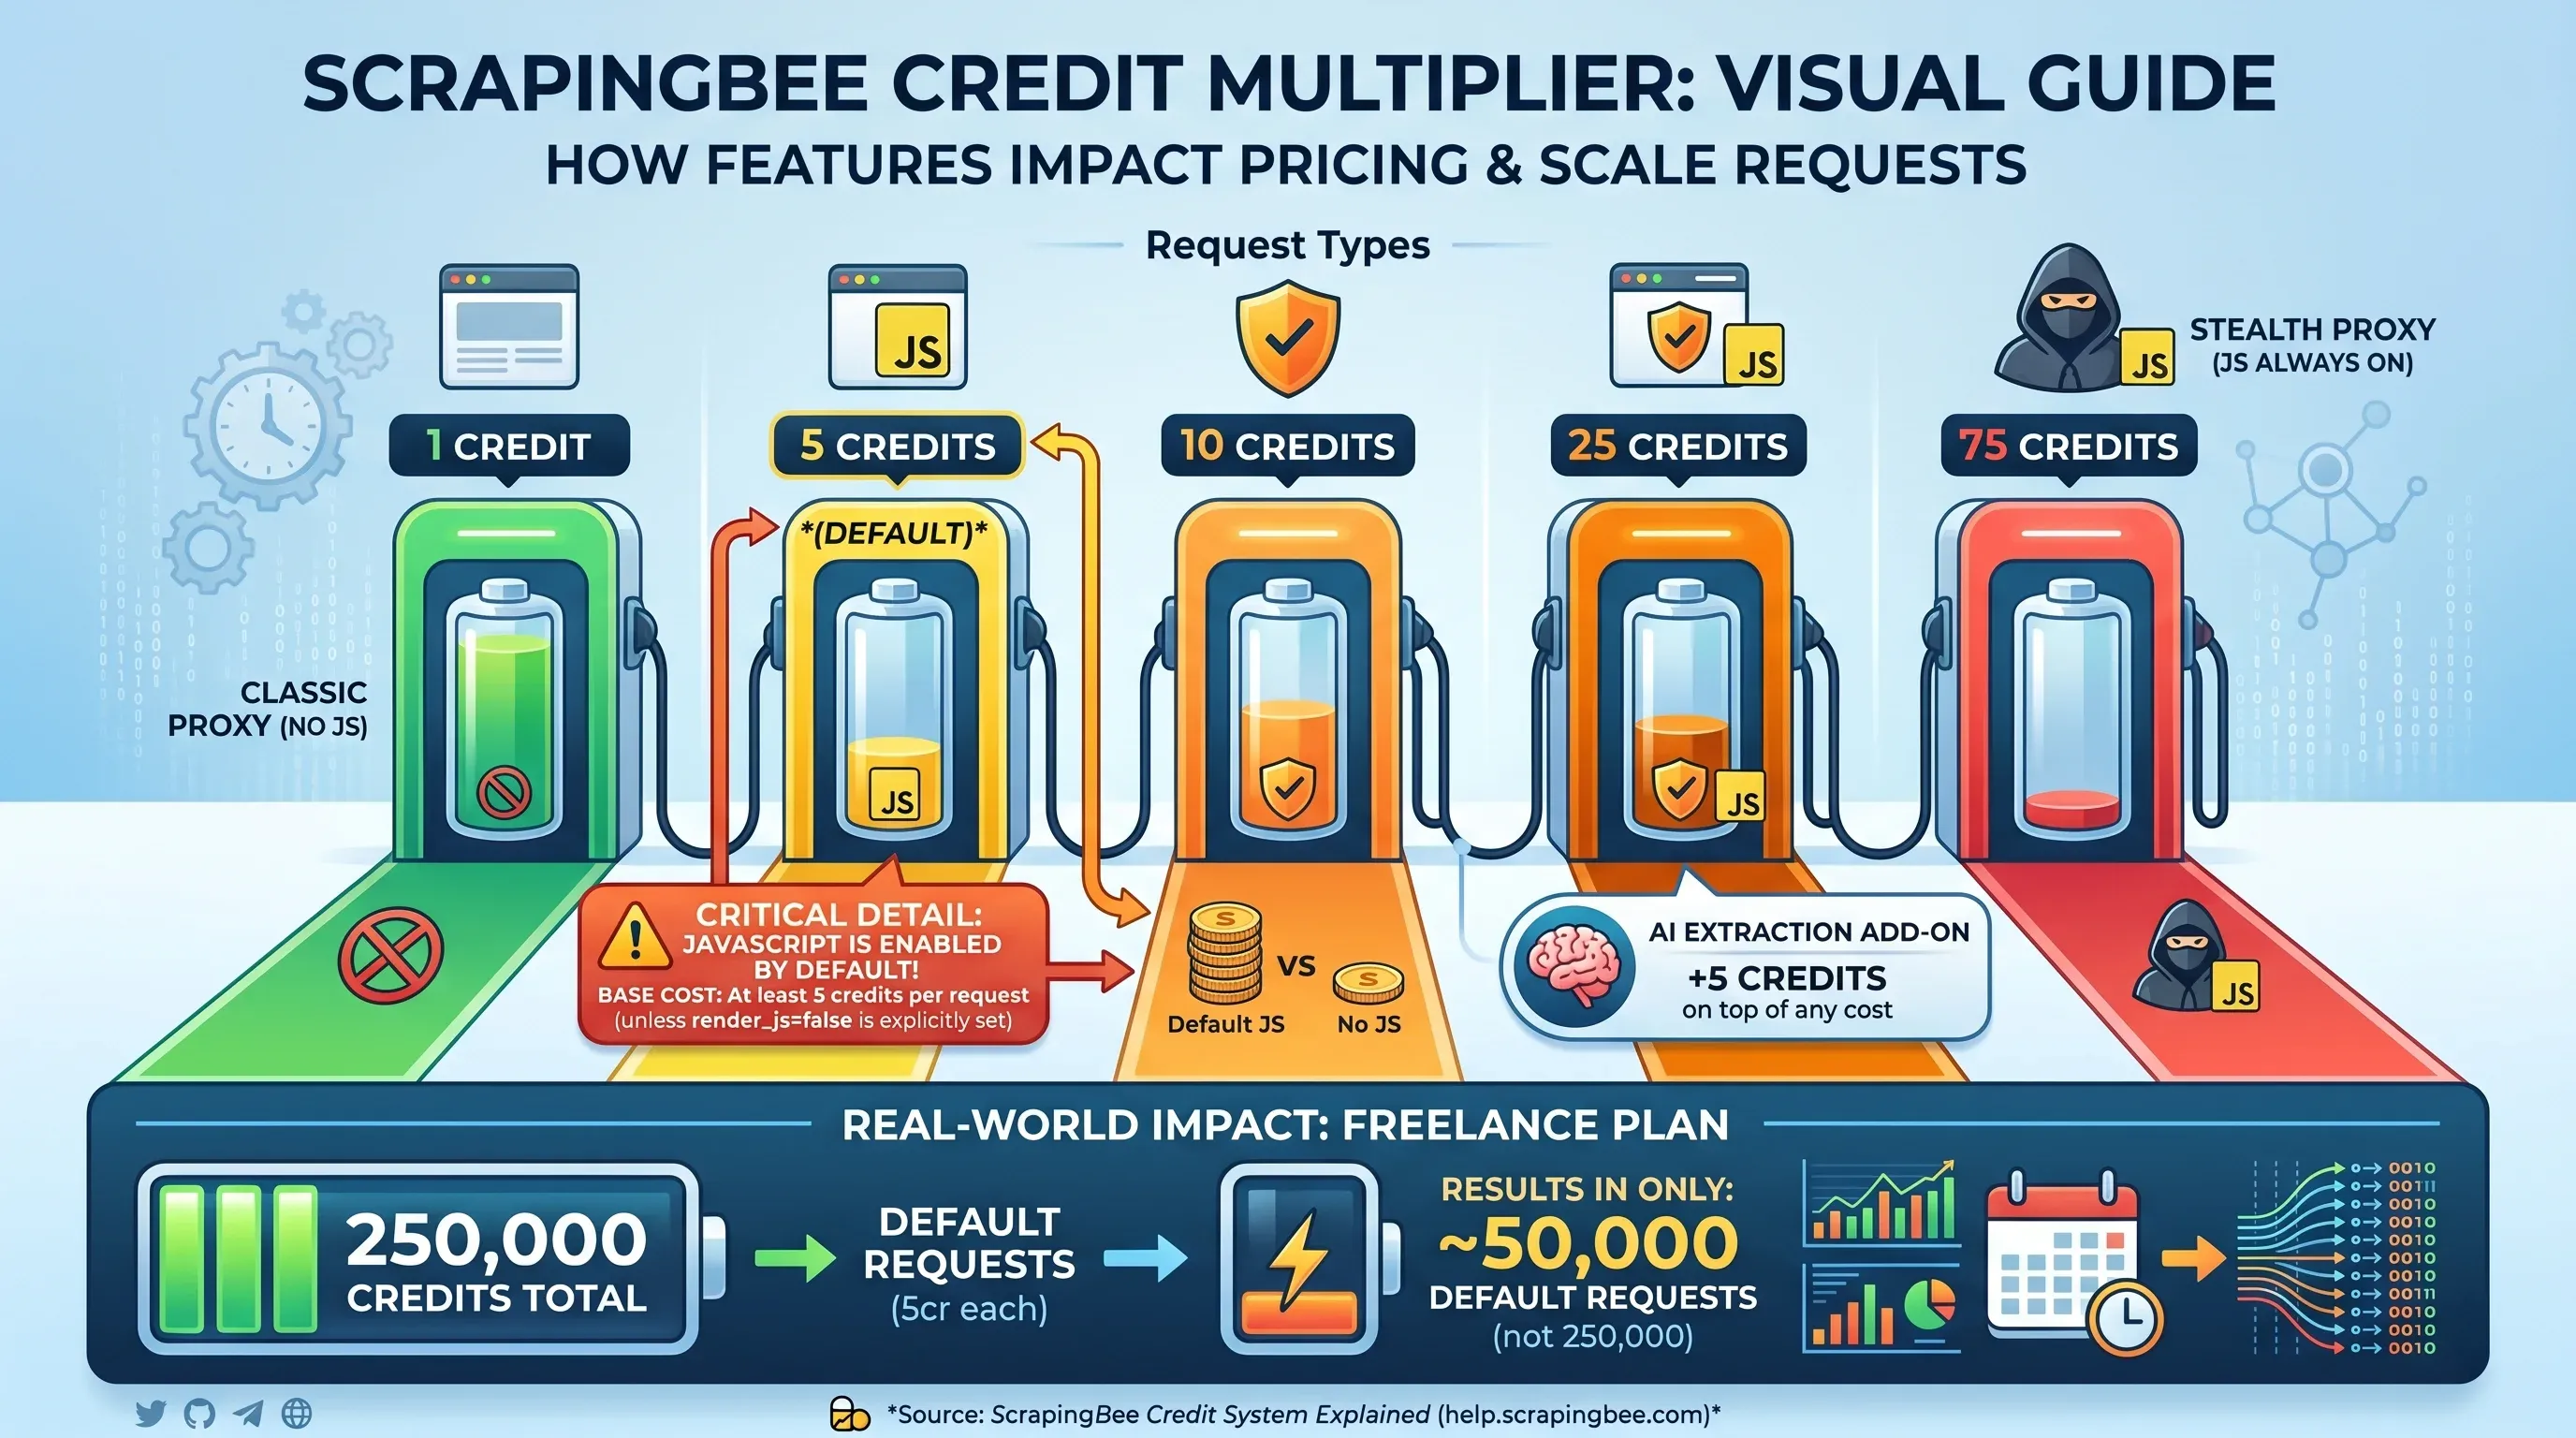
Det är här ScrapingBee:s prissättning blir komplicerad. Det angivna kreditantalet är inte antalet sidor du kan skrapa — det beror på vilka funktioner du aktiverar per begäran:
| Typ av begäran | Krediter per begäran |
|---|---|
Klassisk proxy, ingen JS-rendering (render_js=false) | 1 kredit |
| Klassisk proxy, JS-rendering (standard) | 5 krediter |
| Premiumproxy, ingen JS-rendering | 10 krediter |
| Premiumproxy, JS-rendering | 25 krediter |
| Stealth-proxy (JS alltid på) | 75 krediter |
| AI-extraktion som tillägg | +5 krediter ovanpå |
Viktig detalj: JavaScript-rendering är aktiverat som standard. Om du inte uttryckligen sätter render_js=false kostar varje begäran minst 5 krediter. Det betyder att Freelance-planens 250 000 krediter i praktiken bara räcker till 50 000 standardförfrågningar — inte 250 000.
Den dolda kreditmatematik ingen visar dig
Så här mycket kostar ScrapingBee faktiskt för 10 000 sidor i olika scenarier och plannivåer:
| Scenario | Behov av krediter | Freelance ($49/250K) | Startup ($99/1M) | Business ($249/3M) |
|---|---|---|---|---|
| 10K sidor (statisk HTML, 1 kr) | 10 000 | ✅ Täcks ($0.20/1K) | ✅ Täcks ($0.10/1K) | ✅ Täcks ($0.08/1K) |
| 10K sidor (JS-rendering, 5 kr) | 50 000 | ✅ Täcks ($0.98/1K) | ✅ Täcks ($0.50/1K) | ✅ Täcks ($0.42/1K) |
| 10K sidor (premiumproxy + JS, 25 kr) | 250 000 | ⚠️ Precis vid gränsen ($4.90/1K) | ✅ Täcks ($2.48/1K) | ✅ Täcks ($2.08/1K) |
| 10K sidor (stealthproxy, 75 kr) | 750 000 | ❌ Långt över gränsen | ✅ Täcks knappt ($7.43/1K) | ✅ Täcks ($6.23/1K) |
Samma 10 000 sidor kan alltså kosta allt från $0.20 till $7.43 per tusen beroende på proxy- och renderingsinställningar. Och du vet inte alltid vilken konfiguration du behöver förrän du testar.
Budgetscenario: leadgenerering på 10 000 sidor/månad
Ett säljteam som skrapar 10 000 företagssidor per månad för leadgenerering. De flesta moderna B2B-sajter använder React eller Vue, så JS-rendering krävs:
- Behov av krediter: 50 000 (10K × 5 krediter)
- Freelance-planen ($49): Täcker det med 200K krediter i reserv
- Men om målwebbplatserna kräver premiumproxies: 250 000 krediter — exakt ett Freelance-paks allokering, ingen buffert
- Om stealthproxies krävs: 750 000 krediter — kräver Startup-planen för $99/månad
Budgetscenario: prisbevakning för e-handel på 100 000 sidor/månad
Ett ecommerce-team som bevakar 100 000 produktsidor på konkurrenters webbplatser:
| Konfiguration | Behov av krediter | Nödvändig plan | Månadskostnad |
|---|---|---|---|
| Statisk HTML (1 kr) | 100 000 | Freelance | $49 |
| JS-rendering (5 kr) | 500 000 | Startup | $99 |
| Premiumproxy + JS (25 kr) | 2 500 000 | Business | $249 |
| Stealthproxy (75 kr) | 7 500 000 | Business+ | $599 |
Samma jobb sträcker sig alltså från $49 till $599/månad. Det är inte en avrundningsmiss — det är en 12× kostnadsskillnad beroende på konfiguration.
"$49 som inträdespris är den mest vilseledande siffran på marknaden för scraping-API:er." — Prospeo
"Krediter förbrukas snabbt när man använder JavaScript-rendering eller avancerade funktioner, vilket gör det svårare att motivera för mindre projekt eller team med oförutsägbara skrapvolymer." — Nick S, Manager, Computer Software, Capterra
Och oanvända krediter förs inte över mellan månader.
Hur ScrapingBee:s kostnader står sig mot konkurrenter
Med mellannivåplaner för en rättvis jämförelse:
| Scenario (per 1K sidor) | ScrapingBee ($99/1M) | ScraperAPI ($149/1M) | Scrapfly ($100/1M) |
|---|---|---|---|
| Statisk HTML | $0.10 | $0.15 | $0.10 |
| Sidor med JS-rendering | $0.50 | $1.64 | $0.60 |
| Premium + JS | $2.48 | $3.73 | $3.00 |
| Stealth/ultra-premium + JS | $7.43 | $11.18 | N/A |
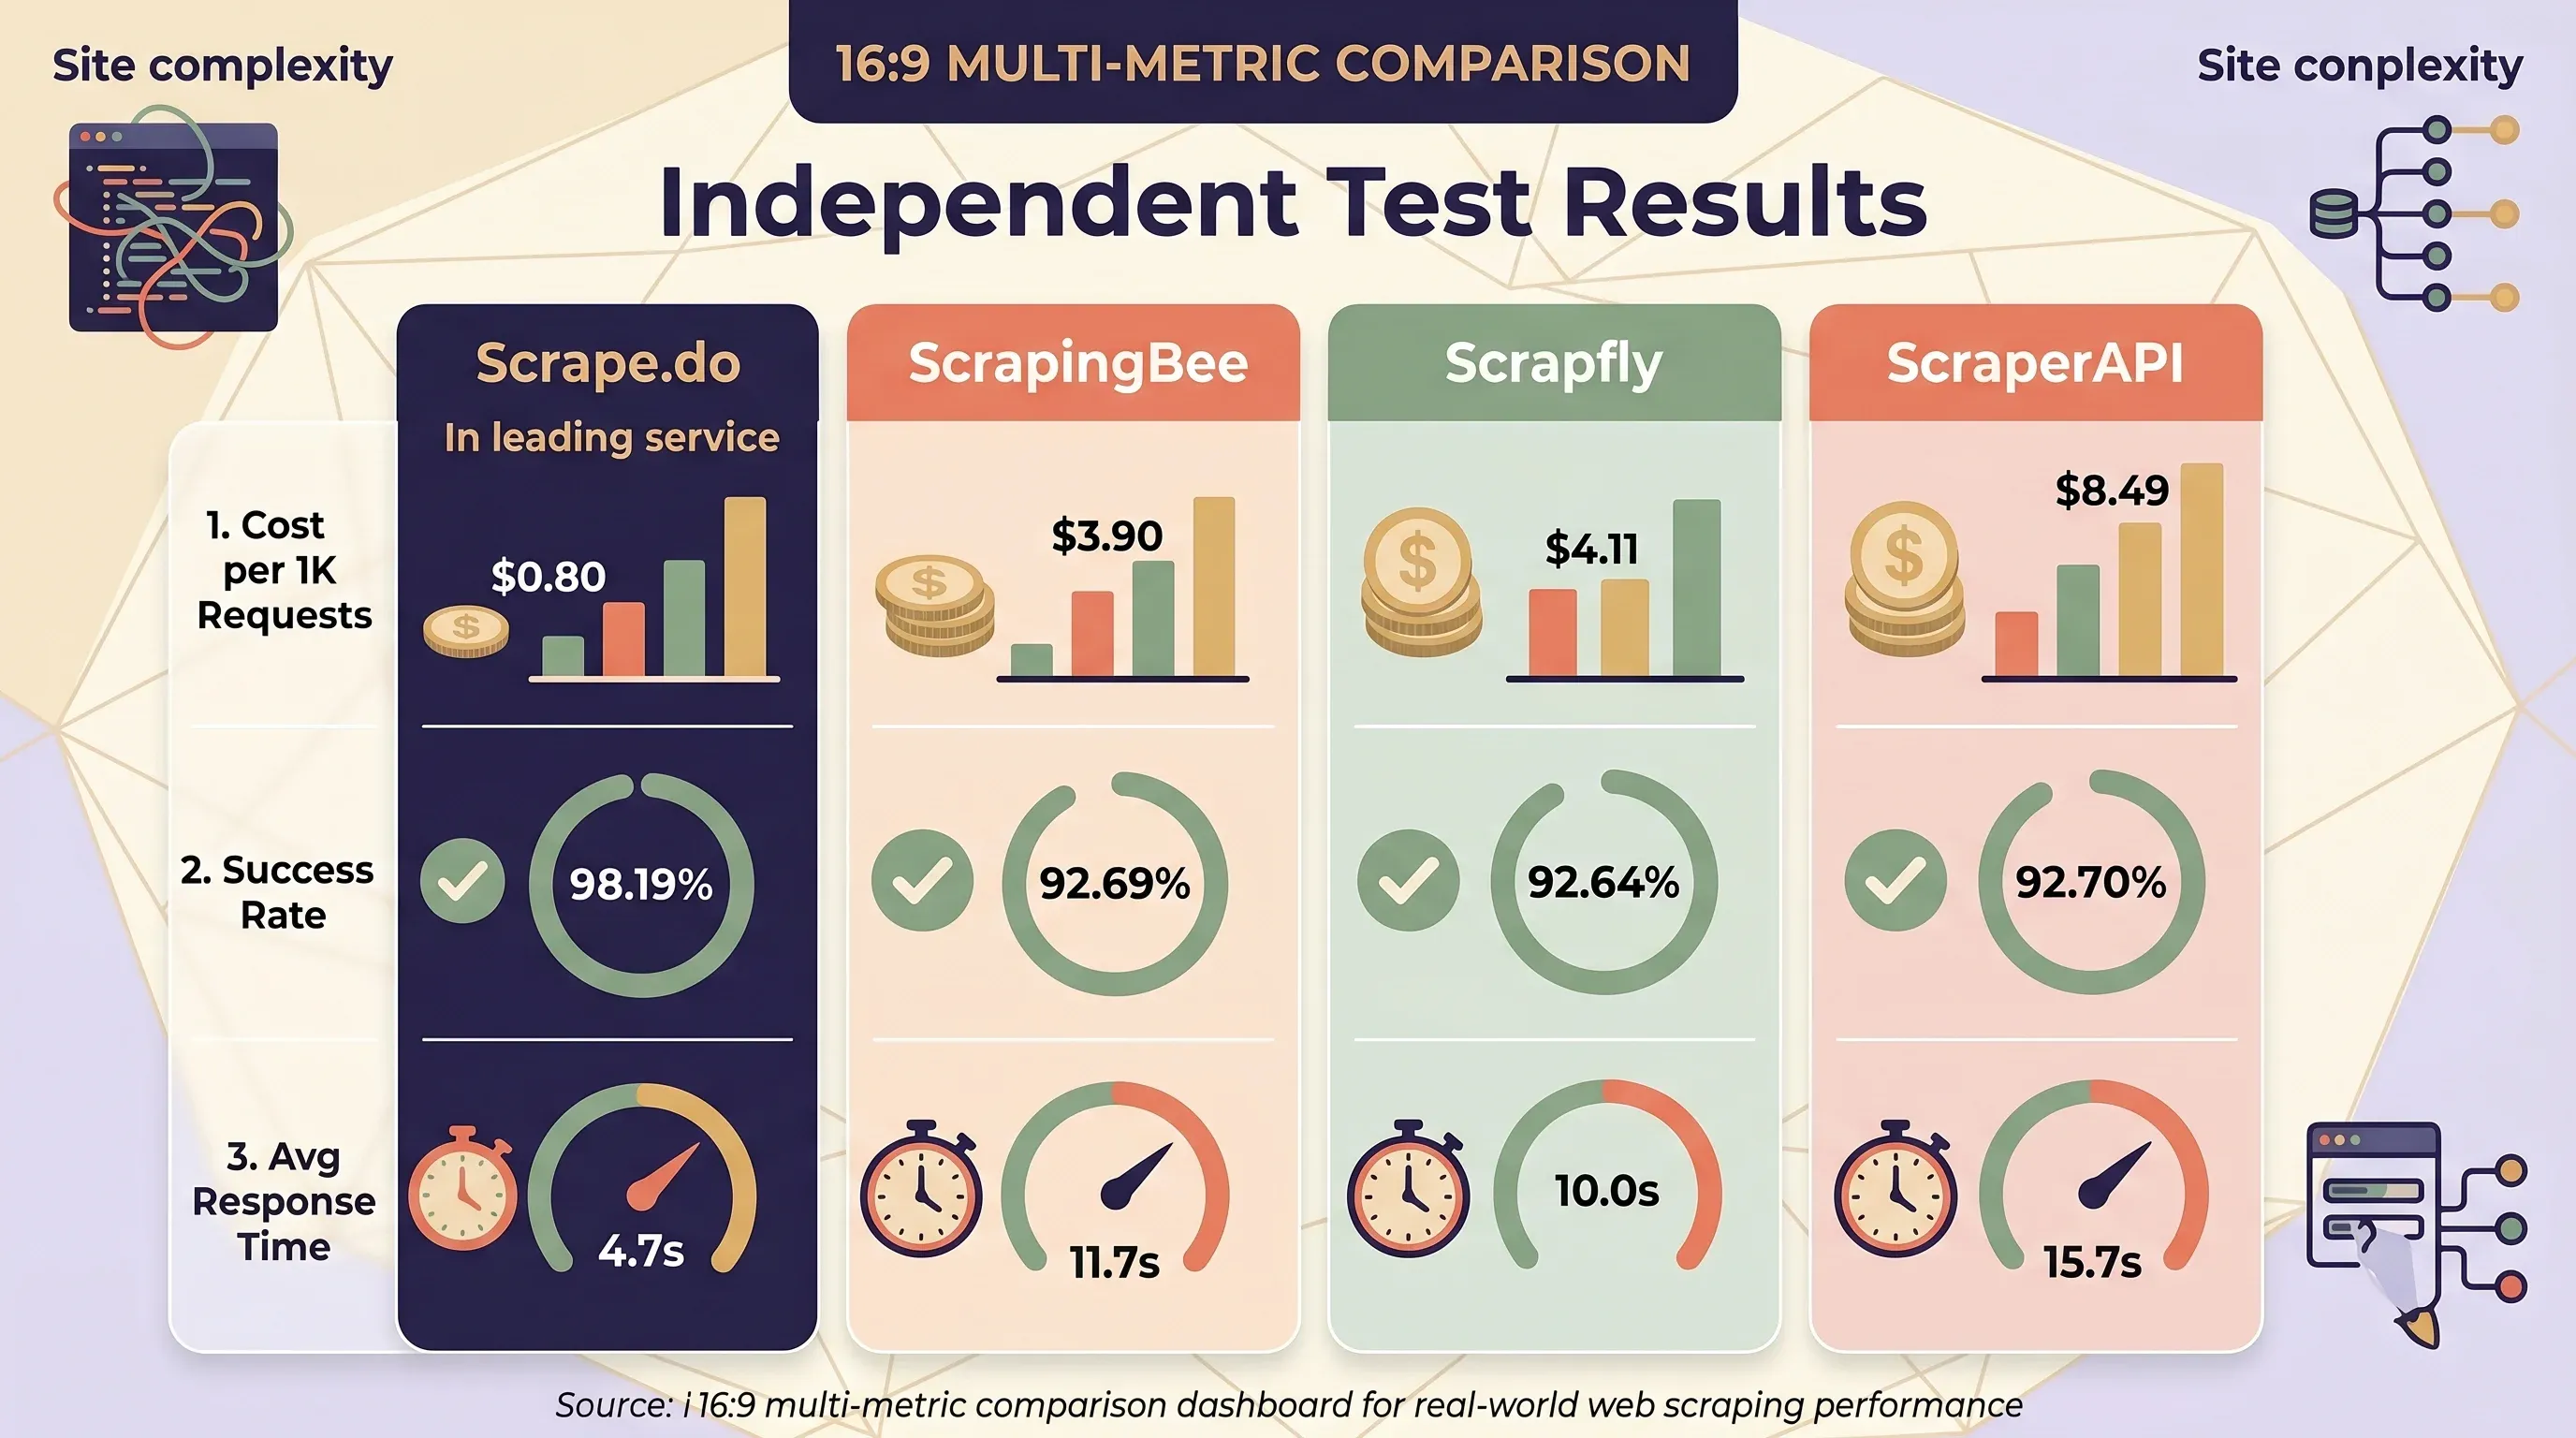
ScrapingBee är generellt billigast eller i nivå med billigast för statiska sidor och JS-renderade sidor. ScraperAPI är konsekvent dyrast — dess JS-rendering kostar +10 krediter jämfört med +5 för både ScrapingBee och Scrapfly. Men oberoende tester från Scrape.do ger en annan bild när verklig webbplatskomplexitet tas med:
| Tjänst | Genomsnittlig kostnad per 1K förfrågningar | Träffsäkerhet | Genomsnittlig svarstid |
|---|---|---|---|
| Scrape.do | $0.80 | 98.19% | 4.7s |
| ScrapingBee | $3.90 | 92.69% | 11.7s |
| Scrapfly | $4.11 | — | — |
| ZenRows | $4.48 | 92.64% | 10.0s |
| ScraperAPI | $8.49 | 92.70% | 15.7s |
Thunderbit:s kreditmodell: ett annat upplägg
Thunderbit använder en betydligt enklare prismodell: 1 kredit = 1 utdata-rad, utan multiplikatorer för JS-rendering, proxytyp eller målwebbplats. Skrapning av undersidor kostar 2 krediter per rad.
| Plan | Månadskostnad | Krediter | Kostnad per rad |
|---|---|---|---|
| Free | $0 | 6 sidor/månad | Gratis |
| Starter | $15 | 500 | $0.030 |
| Pro 1 | $38 | 3 000 | $0.013 |
| Pro 2 | $75 | 6 000 | $0.013 |
| Pro 3 | $125 | 10 000 | $0.013 |
| Pro 4 | $249 | 20 000 | $0.012 |
En Thunderbit-användare som skrapar 10 000 produktlistningar från JS-tunga ecommerce-sajter betalar $125/månad oavsett om sajterna kräver JavaScript-rendering, premiumproxies eller anti-bot-förbigång. Med ScrapingBee kan samma jobb kosta $49 till $599 beroende på konfiguration. Kostnadsförutsägbarhet spelar faktiskt roll.
CSS-selektorer kontra AI-extraktion: underhållskostnaden du bör känna till
De flesta ScrapingBee-recensioner hoppar över detta helt. Det är kanske den viktigaste faktorn för alla som planerar att skrapa i stor skala under månader eller år.
ScrapingBee använder CSS/XPath-selektorer för att extrahera data från HTML. Du definierar extraktionsregler som JSON-objekt med CSS-selektorer, och ScrapingBee returnerar matchande data. Det fungerar bra i början. Problemet är vad som händer sedan.
Problemet med selektorbrott
När en målwebbplats ändrar layout — klassnamn, DOM-struktur, ramverksversion — går dina CSS-selektorer sönder. I mogna skrapsystem som kör över 2 500 aktiva jobb visar forskning en 1–2 % veckovis brottsfrekvens, vilket kräver 30–35 korrigeringar per vecka bara för att hålla extraktorerna igång. För organisationer som skrapar 50 webbplatser uppgår det årliga underhållet till 850–1 300 timmar, vilket kostar $64 000–$156 000 vid fullt belastade ingenjörskostnader.
Team underskattar detta konsekvent. De första uppskattningarna ligger ofta på 10–15 underhållstimmar/månad, men den faktiska verkligheten är 4–6× högre (40–90 timmar/månad). Ett enda tyst fel — där en selektor går sönder men fortsätter returnera tom data utan att någon varnas — kostar uppskattningsvis $38 000–$57 000 i förlorad försäljning, återhämtning av ranking och personaltid.
Vanliga orsaker: CSS-klassnamn byts ut vid ramverksuppdateringar, nya container-element läggs till runt målet, React/Vue/Angular-versioner uppgraderar och omstrukturerar DOM:en, A/B-testning med dynamiska klassnamn och anti-scraping-obfuskering.
AI-driven extraktion minskar underhållet med 60–80 %
En studie från DataRobot 2025 visade att AI-drivna skrapare kräver 70 % mindre underhåll än traditionella selektorbaserade skrapare efter omdesign av webbplatser. Tidsfördelningen vänds i praktiken:
| Mätpunkt | Traditionell (CSS-selektorer) | AI-driven |
|---|---|---|
| Underhåll efter omdesign | Baslinje | 70 % mindre |
| Tidsfördelning (uppsättning : underhåll) | 20% : 80% | 5% : 95% med data |
| Total minskning av underhåll | Baslinje | 60–80 % minskning |
| Hastighet på JS-tunga sidor | Baslinje | 30–40 % snabbare |
Uppsättningstid: skriva selektorer kontra AI-föreslagna fält
ScrapingBee-uppsättning: Inspektera sidkällan → identifiera CSS-selektorer → skriv extraktionsregler som JSON → testa och felsök → hantera edge cases för sidvariationer → övervaka för brott → fixa trasiga selektorer när sajter uppdateras.
Thunderbit-uppsättning: Öppna sidan i Chrome → klicka på "AI Suggest Fields" → AI läser sidan och föreslår kolumner med lämpliga datatyper → klicka på "Scrape." Inga selektorer att skriva, ingen inspektion av källkod. Thunderbit:s AI drivs av flera grundmodeller (ChatGPT, Gemini, Claude, DeepSeek R1) som visuellt läser webbsidor som en människa.
Thunderbit:s Field AI Prompts lägger till ytterligare ett lager: varje kolumn kan ha en egen AI-instruktion som omvandlar data under extraktionen — formaterar datum, översätter text, kategoriserar produkter, delar upp namn, normaliserar telefonnummer. Det eliminerar ett separat efterbehandlingssteg som ScrapingBee-användare måste bygga själva.
Strukturerad utdata: rå HTML kontra färdiga rader
| Dimension | ScrapingBee (selektorbaserad) | Thunderbit (AI-driven) |
|---|---|---|
| Standardutdata | Rå HTML | Strukturerade rader med typade kolumner |
| Strukturerad extraktion | Kräver CSS/XPath-regler eller AI-tillägg (+5 krediter) | AI känner automatiskt igen fält |
| Stödda datatyper | Text (HTML-parsing krävs) | Text, nummer, datum, URL, e-post, telefon, bild |
| Motståndskraft mot layoutändringar | ⚠️ Manuella selektoruppdateringar behövs | ✅ AI läser om sidan på nytt varje gång |
| Tekniska färdigheter som krävs | Python/cURL, CSS-selektorer, förståelse för HTML | Inga — Chrome-tillägg med arbetsflöde i 2 steg |
| Löpande underhåll | Pågående (1–2 % veckovis brottsfrekvens) | Minimalt (AI anpassar sig automatiskt) |
ScrapingBee har lagt till AI-extraktionsfunktioner (ai_query, ai_extract_rules) som delvis adresserar problemet med selektorunderhåll. Men dessa lägger till +5 krediter per begäran ovanpå baskostnaden, och verktyget är fortfarande i grunden API-först utan visuellt gränssnitt.
ScrapingBee för icke-utvecklare: en ärlig användbarhetskontroll
ScrapingBee är inte byggt för icke-tekniska användare. Det är ett API. Du skriver kod för att använda det. Om du är marknadschef eller ansvarig för säljops och läser detta är det hela historien där.
Så här upplever en icke-teknisk användare faktiskt ScrapingBee:
- Skriv ett API-anrop i Python, cURL eller något annat språk
- Förstå HTTP-parametrar som
render_js=true,premium_proxy=true,country_code=us - Tolkar råa HTML-svar med ett bibliotek som BeautifulSoup
- Skriv CSS-selektorer för att extrahera specifika datafält
- Hantera paginering genom att skriva egen crawl-logik (ScrapingBee hanterar bara enskilda sidförfrågningar)
- Bygg en datapipeline för att rensa, strukturera och lagra den extraherade datan
Det finns ingen drag-and-drop-builder. Inget klickbart gränssnitt. Ingen visuell förhandsvisning av det du skrapar.
"Det finns en inlärningskurva. Och dokumentationen är omfattande, tar en dag till en vecka att läsa igenom." — Arvind K, Proprietor, Financial Services, Capterra
"Deras system är väldigt specifikt och det tar ett tag att lära sig deras kod och struktur." — Capterra-recension
Utvecklare älskar detta. En recensent kallade det "helt API-baserat: mycket modernt och elegant: det bara fungerar." Men "lätt att använda" för en utvecklare som utvärderar API:er är något helt annat än "lätt att använda" för någon som försöker bygga en leadlista utan att skriva kod.
När ett no-code-alternativ är mer rimligt
Thunderbit Chrome Extension erbjuder en helt annan upplevelse:
- Öppna en webbsida i Chrome med tillägget installerat
- Klicka på "AI Suggest Fields" — AI skannar sidan och föreslår kolumner (Product Name, Price, Rating, URL osv.) med lämpliga datatyper
- Granska och anpassa — lägg till, ta bort eller byt namn på kolumner; lägg till Field AI Prompts för transformation
- Klicka på "Scrape" — data extraheras till strukturerade rader
- Exportera — med ett klick till Google Sheets, Airtable, Notion, Excel, CSV eller JSON (alla exporter är gratis)
Inga API-anrop, inga selektorer, ingen kod. Thunderbit stöder 55 språk per april 2026.
För vanliga sajter erbjuder Thunderbit också omgående scraper-mallar — förbyggda, underhållna mallar för Amazon, Zillow, Shopify, LinkedIn, Google Maps, Instagram, eBay, Apollo och fler. Du behöver inte ens vänta på att AI ska föreslå fält; mallen är redo direkt.
Dessutom innehåller Thunderbit flera gratis-för-alltid-verktyg som inte kräver någon plan: e-postutdragare, telefonnummerutdragare och bildutdragare — praktiskt för sälj- och marknadsteam som bara behöver snabba datauttag.
Beslutsramverk: vem bör använda vad
| Om du är… | Bäst val |
|---|---|
| Utvecklare som är bekväm med API:er och HTML-parsing | ScrapingBee eller ScraperAPI |
| Teknisk användare som vill ha strukturerad data utan selektorarbete | Thunderbit API (Extract-slutpunkt) |
| Affärsanvändare (sälj, marknad, ecommerce ops) utan kodkunskaper | Thunderbit Chrome Extension |
| Team som behöver schemalagd övervakning utan DevOps | Thunderbit Scheduled Scraper (schemaläggning i naturligt språk) |
| Bygger LLM/RAG-pipelines och behöver ren markdown | Thunderbit Distill API eller Firecrawl |
| Kostnadsmedveten och vill slippa kreditmultiplikatorer | Thunderbit (1 kredit = 1 rad) |
Efter skrapningen: vart tar egentligen din data vägen?
Skrapning är bara halva jobbet. Den andra halvan — att få datan någonstans där den faktiskt blir användbar — är där de flesta ScrapingBee-recensioner blir tysta.
ScrapingBee: rå HTML ut, bygg din egen pipeline
ScrapingBee returnerar rå HTML som standard. Därifrån behöver du:
- Parsea HTML med BeautifulSoup eller lxml
- Ta bort navigation, sidfötter, skript och stilar (som utgör 80–90 % av en typisk sidans innehåll)
- Extrahera specifika datafält
- Konvertera till strukturerade format
- Hantera paginering och felstatusar
- Lagra och distribuera datan
"ScrapingBee returnerar rå HTML. AI-agenter behöver ren markdown, semantisk sökning och webhooks." — KnowledgeSDK
ScrapingBee erbjuder visserligen return_page_markdown=true och return_page_text=true som valfria alternativ, och Google Search API returnerar strukturerad JSON. Men standardflödet — och den generella skrapupplevelsen — är rå HTML som du själv måste bearbeta.
Användare behöver ofta ytterligare verktyg: BeautifulSoup/lxml för parsing, Pandas för datarensning, cron/Airflow för schemaläggning, egen crawl-logik för flersidiga skrapningar och separat molnlagring. Det är mycket ingenjörsarbete mellan "jag skrapade det" och "jag kan använda det".
Thunderbit: strukturerad utdata med inbyggd export
Thunderbit returnerar strukturerade rader med definierade datatyper (text, nummer, datum, URL, e-post, telefon, bild) redo att exporteras. Alla exporter är gratis oavsett plan:
| Exportmål | Kostnad |
|---|---|
| Excel (.xlsx) | Gratis |
| Google Sheets | Gratis (direkt integration) |
| Airtable | Gratis (direkt integration) |
| Notion | Gratis (direkt integration) |
| CSV | Gratis |
| JSON | Gratis |
För team som redan använder Google Sheets eller Airtable som CRM eller operativ hubb tar detta bort ett helt lager av ingenjörsarbete. Vid export till Notion eller Airtable laddas bilder upp till bildbiblioteket så att användare kan se dem direkt i raden — en liten detalj som spelar stor roll i praktiken.
ScrapingBee:s integrations-ekosystem
ScrapingBee erbjuder tredjepartsintegrationer: Zapier (8 000+ appkopplingar), Make (3 000+ appar), n8n och Microsoft Power Automate. Dessa kan bygga en brygga mellan rå HTML och dina målstyrda verktyg — men de lägger till kostnad, komplexitet och ytterligare en felpunkt.
För utvecklare: Thunderbit:s öppna API
För läsare som faktiskt vill ha programmerbara pipelines erbjuder Thunderbit ett öppet API med två centrala slutpunkter:
- Distill-slutpunkt — omvandlar sidor till ren Markdown, perfekt för LLM/RAG-pipelines (1 kredit per anrop)
- Extract-slutpunkt — returnerar strukturerad JSON som matchar ett användardefinierat schema (20 krediter per anrop)
- Batchbearbetning — upp till 100 URL:er per begäran
Det betyder att Thunderbit betjänar både no-code-användare (Chrome Extension) och utvecklare (Open API) från samma AI-motor. Fråga inte bara "kan det skrapa" — fråga "vart tar datan vägen?"
Tillförlitlighetskontroll 2026: håller ScrapingBee i produktion?
Äldre Reddit-trådar (2021–2023) innehåller klagomål om tillförlitlighet hos ScrapingBee. Speglar de fortfarande verkligheten 2026? Jag hämtade data från sex oberoende benchmarktester. Resultaten är blandade — och ibland motsägelsefulla.
Scrapeway:s benchmark varannan vecka (april 2026)
Totalt: 33.3 % träffsäkerhet — plats 7 av 9 testade tjänster.
| Webbplats | Träffsäkerhet |
|---|---|
| Amazon | 48% |
| 41% | |
| Indeed | 38% |
| Etsy | 21% |
| Booking | 17% |
| Realtor | 0% |
| StockX | 0% |
| Twitter/X | 0% |
| Zillow | 0% |
| Walmart | 0% |
| 0% |
Scrapingdog:s jämförelsetest sida vid sida (2025)
| Webbplats | ScrapingBee | Scrapingdog | ScraperAPI |
|---|---|---|---|
| Amazon | 100% | 100% | 100% |
| Glassdoor | 0% | 100% | 100% |
| eBay | 100% | 100% | 100% |
| Walmart | 40% | 100% | 100% |
| 90% | 100% | 80% |
Proxyway:s benchmark (december 2025)
- 84.47 % träffsäkerhet vid 2 förfrågningar/sekund
- 72.98 % träffsäkerhet vid 10 förfrågningar/sekund — ett tapp på 12 procentenheter under belastning
- 25.46 s genomsnittlig svarstid — långsammast i testgruppen
Scrape.do:s benchmark (2025–2026)
- 92.69 % total träffsäkerhet
- Stark på enskilda sajter: Amazon 99.11 %, Indeed 99.29 %, GitHub 100 %, X/Twitter 99.6 %
- Svag på Capterra: bara 59 % träffsäkerhet med svarstider på 36 sekunder
Mönstret
Datan visar ett tydligt mönster:
- ScrapingBee fungerar bra på vanliga, måttligt skyddade sajter — Amazon, eBay, GitHub och Indeed visar konsekvent 90–100 % träffsäkerhet
- ScrapingBee misslyckas helt på hårt skyddade sajter — återkommande 0 % på LinkedIn, Zillow, Realtor.com, StockX och Twitter i flera benchmarktester
- Prestandan försämras tydligt under belastning — 84 % vid 2 req/s faller till 73 % vid 10 req/s
- Benchmarkresultat varierar kraftigt beroende på metod — från 33.3 % (Scrapeway, bred sajtmix) till 92.69 % (Scrape.do, måttliga mål)
ScrapingBee:s Capterra-betyg på 4.9/5 (137 recensioner) är en positiv signal, men höga betyg för enkel initial uppsättning speglar inte alltid långsiktig driftsäkerhet i stor skala. Användare som byter bort tjänsten hänvisar ofta till ökande felfrekvens och stigande kostnader — inte svårigheter att komma igång.
"Väldigt positivt. ScrapingBee har varit stabilt, förutsägbart och lätt att integrera i produktion." — Verifierad recensent, CEO, Capterra
ScrapingBee uppvisade "ojämn tillförlitlighet", särskilt genom att nå "0 % träffsäkerhet på Glassdoor" och "40 % på Walmart."
Hur AI-driven skrapning hanterar tillförlitlighet annorlunda
Thunderbit:s AI läser den renderade sidan i realtid och anpassar sig till anti-bot-skydd och layoutförändringar för varje session. Två skraplägen löser olika tillförlitlighetsutmaningar:
- Molnskrapning — körs på Thunderbit:s molnservrar, hanterar upp till 50 sidor åt gången, bäst för stora offentliga skrapjobb på sajter som Amazon, Zillow och Shopify
- Webbläsarskrapning — körs lokalt i användarens Chrome-webbläsare och använder användarens egen autentiserade session — idealiskt för inloggade sajter (LinkedIn, privata dashboards, SaaS-plattformar) där API-baserade verktyg som ScrapingBee inte kan komma åt innehåll bakom autentisering
Thunderbit erbjuder också omgående scraper-mallar för populära sajter som är förbyggda och underhållna, vilket håller dem fungerande även när sajter ändrar struktur. För de sajter där ScrapingBee visar 0 % träffsäkerhet (LinkedIn, Zillow) är Thunderbit:s webbläsarskrapning — med din egen inloggade session — en helt annan metod.
ScrapingBee kontra de främsta alternativen: jämförelse sida vid sida
| Dimension | ScrapingBee | Thunderbit | ScraperAPI | Scrapfly |
|---|---|---|---|---|
| Typ | Endast API | Chrome Extension + API | Endast API | Endast API |
| Startpris | $49/mån | Gratis ($0) | $49/mån | $30/mån |
| Kreditmodell | Multiplikatorer (1×–75×) | 1 kredit = 1 rad (inga multiplikatorer) | Multiplikatorer (1×–75×) | Multiplikatorer (1×–30×) |
| AI-extraktion | Ja (+5 krediter/begäran) | Inbyggd (AI Suggest Fields) | Ingen inbyggd AI | Ja |
| No-code-alternativ | Nej (endast API) | Ja (Chrome Extension) | Nej (endast API) | Nej (endast API) |
| Strukturerad utdata | Kräver CSS-regler eller AI-tillägg | Standard (typade kolumner) | Strukturerade slutpunkter för vissa sajter | Varierar |
| Exportmål | Rå HTML/JSON (bygg själv) | Excel, Sheets, Airtable, Notion, CSV, JSON (allt gratis) | Rå HTML/JSON | Rå HTML/JSON |
| Skrapning av undersidor | Manuellt (skriv crawl-logik) | Inbyggt (2 krediter/rad) | Manuellt | Manuellt |
| Schemalagd skrapning | Endast CLI (ingen dashboard-schemaläggare) | Inbyggt (naturligt språk) | Ingen inbyggd | Ingen inbyggd |
| Gratisnivå | 1 000 krediter i provperiod | 6 sidor/månad (för alltid) | 5 000 krediter (7-dagars provperiod) | 1 000 krediter |
| JS-rendering som standard | PÅ (5× kostnad) | Ingår (ingen extra kostnad) | AV | AV |
| Inlärningskurva | Hög (API + selektorer) | Låg (2-stegsflöde) | Hög (API + selektorer) | Hög (API) |
| Bäst för | Utvecklare som vill kontrollera proxies | Affärsanvändare + utvecklare | Utvecklare + strukturerade slutpunkter | Utvecklare som vill kringgå anti-bot-skydd |
| Capterra-betyg | 4.9/5 (137 recensioner) | — | 4.6/5 (62 recensioner) | 4.9/5 (221 recensioner) |
ScrapingBee kontra Thunderbit: viktiga skillnader
De största skillnaderna handlar om arkitektur och målgrupp:
- Endast API kontra Chrome Extension + API: ScrapingBee kräver kod för varje interaktion. Thunderbit erbjuder en Chrome Extension för no-code-användare och ett öppet API för utvecklare — samma AI-motor, två gränssnitt.
- Selektorbaserad kontra AI-driven extraktion: ScrapingBee kräver att du skriver och underhåller CSS/XPath-selektorer. Thunderbit:s AI föreslår fält automatiskt och anpassar sig när sajter förändras.
- Rå HTML-utdata kontra strukturerade rader med gratis export: ScrapingBee returnerar HTML som du måste parsa. Thunderbit returnerar typade, etiketterade rader som du kan exportera till Excel, Google Sheets, Airtable eller Notion med ett klick.
- Skrapning av undersidor: Thunderbit:s AI besöker varje detaljsida och berikar huvudtabellen — inbyggt, ingen egen crawl-logik krävs. ScrapingBee kräver att du skriver den logiken själv.
- Omedelbara mallar: Thunderbit har färdiga mallar för populära sajter (Amazon, Zillow, Shopify, LinkedIn, Google Maps, eBay) som fungerar direkt. ScrapingBee har dedikerade API:er för Amazon och Walmart, men du måste fortfarande skriva kod för att använda dem.
Andra viktiga alternativ
- Scrape.do — lägsta oberoende kostnad på $0.80/1K förfrågningar med 98.19 % träffsäkerhet; börjar på $29/mån
- Apify — actor-baserad plattform med 415+ G2-recensioner (4.7/5), men "Pricing Issues" är det vanligaste klagomålet
- Firecrawl — AI/LLM-nativ, returnerar markdown med 67 % färre tokens än rå HTML; open source-kärna; börjar på $16/mån
- Bright Data — företagsklass med 72M+ IP-adresser, börjar på $499/mån; fast pris
- ZenRows — 55M residential IP-adresser, förbyggda skrapare för Amazon/Walmart/Zillow, börjar på $69/mån
Vilket skrapverktyg passar ditt team?
Rekommendationer utifrån scenario:
- Om du är utvecklare och bygger en egen skrappipeline och vill ha detaljerad proxykontroll → ScrapingBee eller ScraperAPI. Du får finjusterade HTTP-parametrar, val av proxytyp och full kontroll över rendering. Budgetera bara för kreditmultiplikatorerna.
- Om du är ett sälj- eller marknadsteam som behöver leads från webbplatser utan att skriva kod → Thunderbit Chrome Extension. Två klick till strukturerad data, ett klick till Google Sheets. Inget API, inga selektorer, ingen parsing.
- Om du snabbt behöver strukturerad data från populära sajter → Thunderbit Instant Templates. Amazon, Zillow, Shopify, LinkedIn — förbyggt och underhållet, ingen AI-setup behövs.
- Om du behöver bevaka priser eller lager enligt schema utan DevOps → Thunderbit Scheduled Scraper. Beskriv intervallet på vanligt språk ("varje måndag klockan 9") och låt det köra.
- Om du bygger LLM/RAG-pipelines och behöver ren Markdown i stor skala → Thunderbit Distill API eller Firecrawl. Båda returnerar markdown optimerad för AI-konsumtion.
- Om kostnadsförutsägbarhet är viktigt och du inte vill ha kreditmultiplikatorer → Thunderbit. 1 kredit = 1 rad, oavsett JS-rendering eller proxytyp.
Total ägandekostnad är inte bara API-priset. Det är uppsättningstid + underhållstimmar + parsingutveckling + arbetsflöde för dataexport. ScrapingBee:s listpris är konkurrenskraftigt; helhetskostnaden är det inte.
Viktiga lärdomar från den här ScrapingBee-recensionen
Fem punkter att komma ihåg:
- Kreditkostnaderna multipliceras snabbt i stor skala. $49 som ingångspris kan bli $599+ när JS-rendering och premiumproxies behövs. Thunderbit:s fasta modell med 1 kredit per rad eliminerar den här osäkerheten.
- CSS-selektorer innebär löpande underhåll som AI-extraktion slipper. Räkna med 60–80 % mindre underhåll med AI-drivna verktyg och noll selektorbrott när sajter uppdateras.
- Icke-utvecklare möter en brant inlärningskurva med ScrapingBee. Det är ett API-only-verktyg som kräver kod, HTML-inspektion och selektorbygge. Affärsanvändare bör titta på no-code-alternativ.
- Dataexport kräver egen ingenjörsprocess. ScrapingBee returnerar rå HTML; du bygger pipelinen. Thunderbit exporterar strukturerad data till Excel, Sheets, Airtable och Notion gratis.
- Tillförlitligheten är bra för vissa sajter men ojämn för andra. ScrapingBee fungerar bra på Amazon och eBay men visar 0 % på LinkedIn, Zillow och flera andra hårt skyddade mål.
ScrapingBee är fortfarande ett kompetent verktyg för utvecklare som vill ha proxyhanterad HTTP-åtkomst med finmaskig kontroll. Men landskapet för webbskrapning 2026 har förskjutits mot AI-drivna no-code-verktyg — och Thunderbit är byggt specifikt för den förändringen. Testa gratisnivån (6 sidor gratis, eller mer med gratisprovet) och se skillnaden själv.
FAQ
Är ScrapingBee värt det 2026?
Det beror på dina tekniska färdigheter och din volym. För utvecklare som skrapar statiska sidor i måttlig skala erbjuder ScrapingBee ett stabilt, väl dokumenterat API med responsiv support och ett Capterra-betyg på 4.9/5. För affärsanvändare, högvolymskrapning eller team som vill ha strukturerad data utan kod ger AI-drivna alternativ som Thunderbit bättre värde och betydligt lägre total ägandekostnad.
Fungerar ScrapingBee utan kod?
Nej. ScrapingBee är ett API-only-verktyg som kräver att du skriver kod (Python, cURL eller liknande) och förstår HTTP-parametrar. Det finns inget visuellt gränssnitt för att bygga skrapningar. Icke-tekniska användare bör överväga no-code-alternativ som Thunderbit Chrome Extension, som låter dig skrapa och exportera data utan att skriva en enda rad kod.
Hur mycket kostar ScrapingBee egentligen per sida?
Det beror på vilka funktioner som är aktiverade. En statisk HTML-sida kostar 1 kredit. En JS-renderad sida (standardläget) kostar 5 krediter. En sida med premiumproxy + JS kostar 25 krediter. En sida med stealth-proxy kostar 75 krediter. AI-extraktion lägger till +5 krediter ovanpå detta. På Freelance-planen ($49/250K krediter) motsvarar det $0.20 per 1 000 statiska sidor eller $14.70 per 1 000 sidor med stealth-proxy. Se kostnadstabellerna ovan för fullständig uppdelning.
Vilka är de bästa alternativen till ScrapingBee 2026?
De främsta alternativen inkluderar Thunderbit (AI-driven, no-code Chrome Extension + API, 1 kredit = 1 rad), ScraperAPI (utvecklar-API med strukturerade slutpunkter för vissa sajter), Scrapfly (utvecklar-API med stark anti-bot-förbigång), Scrape.do (lägsta kostnad per begäran i oberoende tester) och Firecrawl (AI/LLM-nativ, returnerar ren markdown). Var och en har sin egen styrka — Thunderbit för affärsanvändare och kostnadsförutsägbarhet, ScraperAPI och Scrapfly för utvecklarstyrd proxykontroll, Firecrawl för LLM-pipelines.
Kan ScrapingBee skrapa JavaScript-tunga webbplatser?
Ja, men det kostar 5× baskrediterna med roterande proxy eller 25× med premiumproxy. JavaScript-rendering är aktiverat som standard, så du betalar redan 5×-nivån om du inte uttryckligen stänger av det. Thunderbit hanterar JS-rendering automatiskt utan kreditmultiplikatorer — 1 kredit per rad oavsett hur sidan är byggd.
Läs mer



