
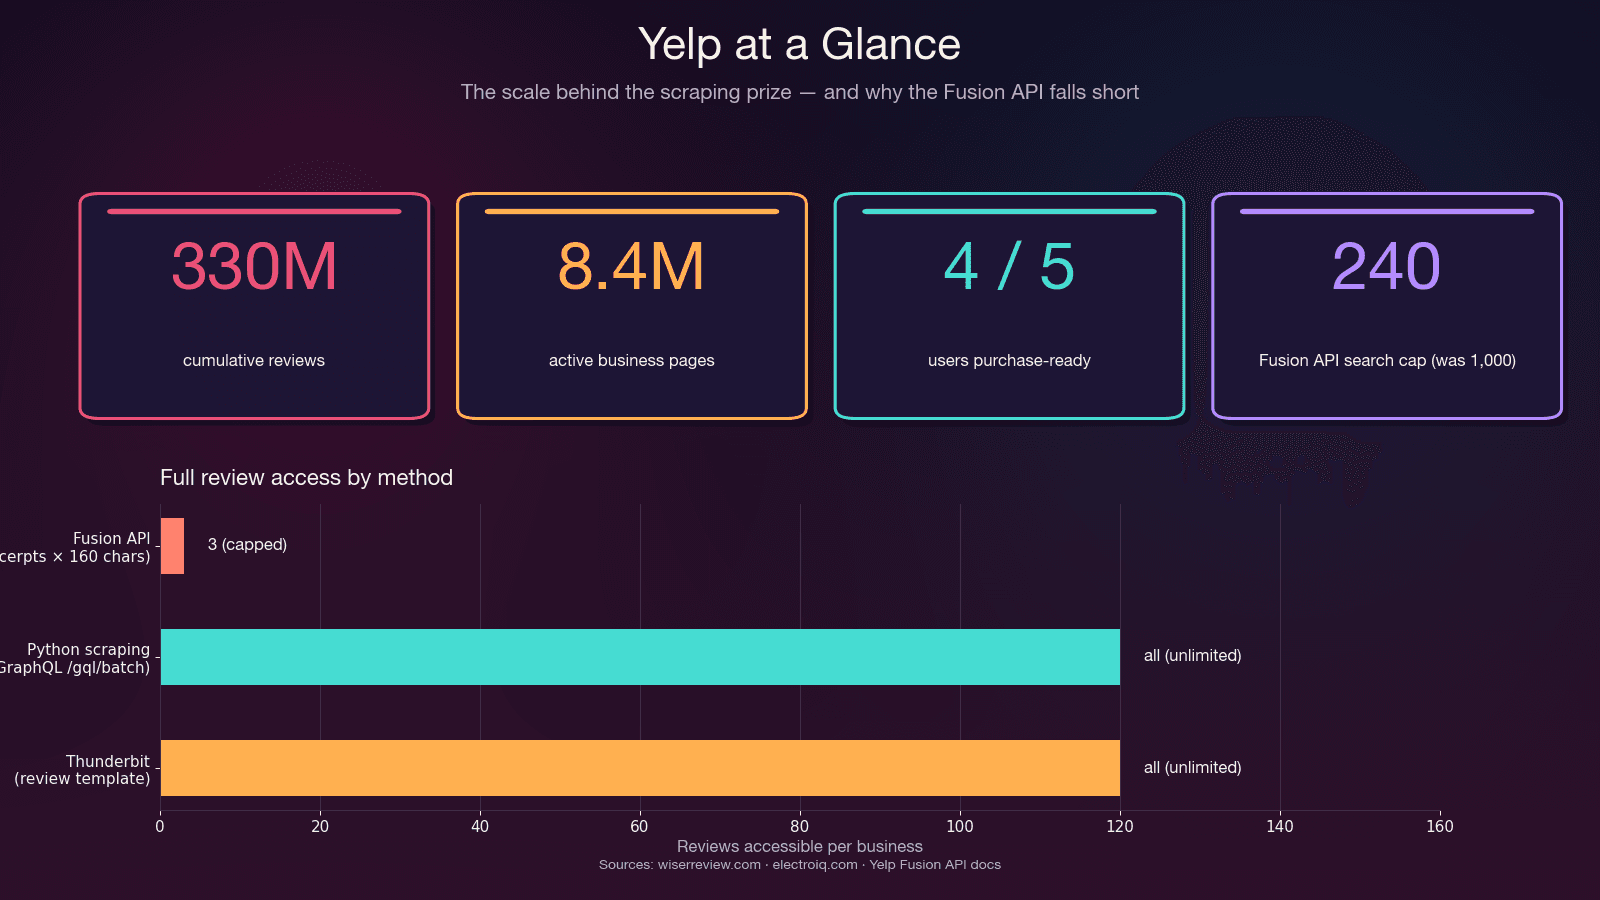
Yelp har 330 miljoner samlade recensioner fördelade över 8,4 miljoner aktiva företagssidor — och att få ut den datan i ett användbart format har aldrig varit svårare. Yelps nedslag mot bottar 2024–2025 har i praktiken slagit sönder de flesta befintliga Python-guider för scraping, utan att säga det rakt ut.
Om du nyligen har försökt köra en Yelp scraper och mötts av en vägg av 403-fel, tomma HTML-svar eller CAPTCHA-rutor som inte fanns där för sex månader sedan, så inbillar du dig inte. Yelp använder nu TLS/JA3-fingeravtryck, roterande obfuskterade CSS-klassnamn och aggressiv poängsättning av IP-rykte — vilket betyder att den gamla requests + BeautifulSoup-metoden som fortfarande rekommenderas i nästan varje guide faller redan vid första anropet. Jag har lagt veckor på att testa olika angreppssätt mot Yelps nuvarande skydd, och i den här guiden går jag igenom allt som faktiskt fungerar 2025: det officiella Fusion API:t (och varför det sannolikt inte räcker), ett komplett Python-arbetsflöde med en flerskiktsstrategi mot blockering, samt ett 2-klicks no-code-alternativ med Thunderbit för dig som bara vill ha datan utan att offra hela helgen på felsökning.
Testa Thunderbit för att skrapa Yelp
Varför skrapa Yelp med Python (och vem har faktiskt nytta av det)
Innan du skriver en enda rad kod: vad är egentligen affärsnyttan med Yelp-data? Plattformen är inte bara en recensionssajt för restauranger — den fungerar i praktiken som en levande databas över lokala företag med strukturerad kontaktinformation, betyg, kategorier, öppettider och hundratals miljoner kundrecensioner.
Här är vilka som tjänar mest på det och vad de brukar hämta ut:
| Användningsområde | Viktiga fält | Varför det spelar roll |
|---|---|---|
| Försäljning & leadgenerering | Företagsnamn, telefon, webbplats, adress, kategori, betyg | Bygg riktade prospektlistor över lokala småföretag — 4 av 5 Yelp-användare är köpredo när de kommer in |
| Konkurrensbevakning | Recensioner, stjärnbetyg, antal recensioner, sentiment | Följ konkurrenters rykte, hitta luckor i tjänsten, spåra trender |
| Marknadsresearch & NLP | Full recensions-text, datum, metadata om recensenter | Sentimentanalys, topic modeling — Yelp-recensioner är ett av de mest använda NLP-korpusen i akademisk forskning |
| Fastigheter & platsval | Företagstäthet, kategori-mix, recensionskvalitet per område | Val av plats för franchise och detaljhandel — Yelp säljer Location Intelligence som en licensierad B2B-produkt just för detta |
| E-handel & drift | Prissignaler, kundklagomål, öppettider | Följ hur konkurrenter bedöms och identifiera driftsmönster |
Det gemensamma temat är enkelt: det verkliga målet är strukturerad data, och Python är bara ett sätt att nå dit. Vissa vill ha full programmatisk kontroll. Andra behöver bara ett kalkylblad med kontaktuppgifter till rörmokare i Austin. Båda spåren täcks här.
Yelp Fusion API vs. Python web scraping: vilket ska du välja?
De flesta guider hoppar över den här avgörande frågan och går direkt till kod utan att ens utvärdera om det officiella Yelp Fusion API:t (numera omprofilerat som "Yelp Places API") hade räckt. Enligt min erfarenhet sparar den bedömningen timmar av onödigt arbete — eftersom API:t är perfekt för vissa saker och helt otillräckligt för andra.
Vad Fusion API:t faktiskt ger dig
Fusion API:t ger strukturerad företagssökning, företagsdetaljer, autocomplete och en endpoint för recensioner. Det är auktoriserat, väldokumenterat och kräver inga anti-bot-trick.
Men det är på recensions-endpointen det faller isär. Här är vad Yelps personal själva har bekräftat på GitHub:
"Yelp API returnerar inte fullständig recensions-text. Som standard ges tre utdrag på 160 tecken." — Svar från Yelp-personal, GitHub Issue #163
Det är inte ett fel — det är avsiktligt. API:t är begränsat till 3 recensionsutdrag (7 på Premium), vart och ett avkortat till ungefär 160 tecken. Ingen recensionsmetadata (nyttig/rolig/cool-röster), ingen historik för recensenten, inga svar från ägaren. Och daglig gräns för nya kunder sänktes till 300–500 anrop/dag efter maj 2023 — ner från 5 000. Startpriset ligger på $29/månad.
Beslutsramen
| Faktor | Yelp Fusion API | Python web scraping | Thunderbit (no-code) |
|---|---|---|---|
| Fullständiga recensioner | ❌ Bara 3 utdrag (~160 tecken vardera) | ✅ Alla recensioner via GraphQL | ✅ Alla synliga recensioner |
| Hastighetsgränser | 300–500/dag (nya); 5 000 (äldre) | Hanteras själv (proxybudget) | Kreditbaserat |
| Uppstartstid | ~15 min (API-nyckel + SDK) | Timmar till dagar | ~2 minuter |
| Företagsfält | ~20 strukturerade fält | Obegränsat (tolka HTML/JSON) | AI-föreslagna fält |
| Hantering av anti-bot | N/A (auktoriserat) | Måste byggas själv | Sköts automatiskt |
| Juridisk risk | ✅ Auktoriserat | ⚠️ Gråzon i villkoren | ⚠️ Samma som scraping |
| Kostnad | Minst $29/mån | Gratis (+ proxykostnader $0,75–$4/GB) | Gratis nivå finns |
| Underhåll | Lågt (API:t är stabilt) | Högt (selectors går sönder, anti-bot skärps) | Lågt (AI anpassar sig igen) |
Välj Fusion API:t om: du behöver grundläggande företagsinfo, småskalig uppslagning eller en auktoriserad integration — och 3 recensionsutdrag per företag räcker.
Välj Python scraping om: du behöver full recensions-text, alla recensioner för ett företag, recensionsmetadata, fler än 240 resultat per sökning eller om budgeten ligger under $29/månad.
Välj Thunderbit om: du vill ha datan snabbt utan att skriva eller underhålla kod. Mer om det i no-code-delen nedan.
Snabbaste genvägen: skrapa Yelp med Thunderbit (ingen Python behövs)
Innan vi går in på Python-delen, här är snabbaste vägen för dig som egentligen bara vill åt datan — inte öva på kod. Alla konkurrentguider utgår från att du kan Python, men i mitt arbete på Thunderbit har jag sett att en stor del av alla som söker på "scrape Yelp" är säljare, operationschefer och småföretagare som bara vill ha ett kalkylblad med lokala företag — inte en crash course i TLS-fingeravtryck.
Thunderbit levereras redan med färdiga Yelp-mallar:
- Yelp Business Web Scraper — hämtar företagsnamn, betyg, kontaktuppgifter, adress, öppettider och kategori
- Yelp Review Scraper — hämtar användarnamn, recensionsinnehåll, betyg, datum och recensentens plats
Så fungerar det i praktiken
- Öppna en Yelp-sida med sökresultat eller en företagssida i Chrome
- Klicka på AI Suggest Fields i Thunderbit-tillägget — AI:n läser sidan och föreslår kolumner (företagsnamn, betyg, antal recensioner, prisnivå, kategori, adress, telefon, URL)
- Klicka på Scrape — klart
Med de färdiga Yelp-mallarna är det ännu enklare: öppna mallen och klicka på Scrape.
Subpage scraping sköter berikningen automatiskt — börja från en Yelp-sida med sökresultat, aktivera subpage scraping, så besöker Thunderbit varje företagssida för att hämta öppettider, fullständiga recensioner, webbplats, bilder och bekvämligheter. Ingen extra konfiguration.
Sidnumrering sker automatiskt — både klickbaserad och scrollbaserad, direkt ur lådan. (Mer om hur det fungerar finns i vår guide om paginering.)
Export ingår gratis i alla nivåer — Excel, Google Sheets, Airtable, Notion, CSV, JSON. Inget pandas, ingen kod för CSV-skrivning.
Tidsjämförelse
| Tid | Python-scraper | Thunderbit |
|---|---|---|
| Första körningen | Timmar till dagar (skriva selectors, hantera paginering, proxies, retry-logik) | ~30 sekunder med den färdiga Yelp-mallen |
| När Yelp ändrar markup | Skriv om selectors manuellt | Klicka på AI Suggest Fields igen — anpassar sig automatiskt |
| När IP blir bannad | Felsök, rotera proxy-pooler, testa om | Cloud mode hanterar IP-rotation |
| Exportera till Google Sheets | Skriv OAuth + pandas-koppling | Ett klick, gratis |
Om du testar Thunderbit först och märker att det täcker dina behov, kan du hoppa över resten av artikeln. Om du behöver full programmatisk kontroll, egna fält eller större volym än några tusen poster per månad — fortsätt läsa.
Python-bibliotek för att skrapa Yelp: vilket ska du välja?
"Ska jag använda Scrapy, BS4+requests eller Selenium?" är en av de vanligaste frågorna i r/webscraping-trådar om Yelp. Ändå väljer nästan varje guide bara sitt favoritbibliotek och går vidare utan att förklara varför. Här är den ärliga genomgången.
Läget 2025: requests + BeautifulSoup är trasigt för Yelp
Stacken som varje klassisk Yelp-guide rekommenderar — pip install requests beautifulsoup4 — blir blockerad redan vid första anropet 2025. Inte vid det 50:e. Vid det första.
Orsaken: Pythons requests-bibliotek skickar ett TLS/JA3-fingeravtryck som inte matchar någon verklig webbläsare. Yelps anti-bot-lager flaggar det redan i TLS-handshake, innan din User-Agent-header ens läses. Jag testade detta upprepade gånger — ny IP, realistiska headers, slumpmässiga fördröjningar — och fick ändå 403 Forbidden direkt med vanliga requests.
Beslutsmatris för bibliotek
| Bibliotek | Bäst för | Hanterar JS? | Anti-bot? | Inlärningskurva | Hastighet |
|---|---|---|---|---|---|
requests + BeautifulSoup | ❌ | ❌ | Väldigt låg | Snabbt (tills det blockeras) | |
httpx async + parsel | Asynkron scraping i stor skala | ❌ | ❌ | Låg | Mycket snabbt |
curl_cffi + parsel | Yelp-specifikt: TLS-imitering | ❌ | ✅ TLS/JA3/HTTP2 | Låg | Mycket snabbt |
Scrapy 2.14 | Fulla crawl-pipelines med paginering | Delvis (via scrapy-playwright) | AutoThrottle, retry middleware | Medel–hög | Snabbt |
Selenium 4.43 / Playwright 1.58 | JS-tunga sidor, CAPTCHA-förbiarbete | ✅ | Delvis | Medel | Långsamt (~10–30 sidor/min) |
| Thunderbit | Icke-kodare, snabb extrahering | ✅ (webbläsare) | Inbyggt (Cloud mode) | Väldigt låg | Snabbt |
Genombrottet med curl_cffi
Biblioteket som förändrade mitt Yelp-arbete är curl_cffi — en Python-binding för curl-impersonate. Det skickar exakt samma TLS/JA3- och HTTP/2-fingeravtryck som riktig Chrome, och API:t är en direkt ersättare för requests:
from curl_cffi import requests

r = requests.get(
    "https://www.yelp.com/biz/some-restaurant",
    impersonate="chrome131",
)
print(r.status_code, len(r.text))
Den enda ändringen — from curl_cffi import requests plus impersonate="chrome131" — tar dig förbi Yelps största anti-bot-lager utan att starta en webbläsare. I mina tester är skillnaden mellan direkt 403 och rena 200-svar.
Min rekommenderade stack för Yelp 2025: curl_cffi + parsel + jmespath + residential proxies. Om du behöver en full crawl-pipeline med schemaläggning, bygg in det i Scrapy 2.14 med en downloader-middleware baserad på curl_cffi.
Så sätter du upp din Python-miljö för att skrapa Yelp
- Svårighetsgrad: Medel
- Tidsåtgång: ~15 minuter för setup, 1–2 timmar för en fungerande scraper
- Du behöver: Python 3.10+ (3.12 rekommenderas), en terminal och eventuellt en leverantör av residential proxies
Steg 1: Skapa en virtuell miljö och installera paket
python3.12 -m venv .venv
source .venv/bin/activate  # På Windows: .venv\Scripts\activate
pip install "curl_cffi>=0.11" "parsel>=1.9" "jmespath>=1.0" pandas
Vad varje paket gör:
curl_cffi— skickar HTTP-anrop med Chromes TLS-fingeravtryck (anti-bot-förbikopplingen)parsel— CSS/XPath-selectors för att tolka HTML (samma motor som Scrapy använder, men lättare)jmespath— deklarativ JSON-fråga (renare än nästlad dict-access för Yelps inbäddade JSON)pandas— export av data till CSV/Excel
Valfritt men användbart:
pip install fake-useragent # Obs: repot arkiverades april 2026 men går fortfarande att installera
Steg för steg: så skrapar du Yelp med Python
Det här är huvudguiden. Den viktigaste insikten som gör allt mer robust: hoppa över CSS-selectors, hämta den dolda JSON:en istället. Yelp randomiserar CSS-klassnamn vid byggtid (y-css-14xwok2 en vecka, y-css-hcq7b9 nästa), så varje scraper som låser sig till dem går sönder inom veckor. De inbäddade JSON-payloads — application/ld+json-schema och react-root-props — är stabila.
Steg 2: Skrapa Yelps sökresultat
Yelps sök-URL:er följer ett förutsägbart mönster: https://www.yelp.com/search?find_desc={term}&find_loc={location}. Data från sökresultaten ligger inbäddad i en <script data-id="react-root-props">-tagg som JSON — inte utspridd i CSS-klass-sörjan.
import re, json, jmespath
from curl_cffi import requests
from parsel import Selector

HEADERS = {
    "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/124.0.0.0 Safari/537.36",
    "accept": "text/html,application/xhtml+xml,application/xml;q=0.9,"
              "image/avif,image/webp,image/apng,*/*;q=0.8",
    "accept-language": "en-US,en;q=0.9",
    "accept-encoding": "gzip, deflate, br",
    "cookie": "intl_splash=false",
}

def scrape_search(term: str, location: str, max_pages: int = 3):
    results = []
    for page in range(max_pages):
        url = (f"https://www.yelp.com/search?"
               f"find_desc={term}&find_loc={location}&start={page * 10}")
        r = requests.get(url, headers=HEADERS, impersonate="chrome131")
        if r.status_code != 200:
            print(f"Blockerad på sida {page}: {r.status_code}")
            break
        sel = Selector(text=r.text)
        script = sel.xpath(
            "//script[@data-id='react-root-props']/text()"
        ).get() or ""
        m = re.search(r"react_root_props\s*=\s*(\{.*?\});", script, re.S)
        if not m:
            print(f"Inga react-root-props hittades på sida {page} — möjlig mjuk blockering")
            break
        data = json.loads(m.group(1))
        businesses = jmespath.search(
            "legacyProps.searchAppProps.searchPageProps"
            ".mainContentComponentsListProps"
            "[?searchResultBusiness].searchResultBusiness.{"
            "name: name, url: businessUrl, rating: rating, "
            "reviews: reviewCount, phone: phone, "
            "neighborhoods: neighborhoods}",
            data,
        ) or []
        results.extend(businesses)
        import time, random
        time.sleep(random.uniform(3, 7))
    return results
Du bör få tillbaka en lista med dicts som innehåller företagsnamn, URL:er, betyg och antal recensioner. Om react-root-props saknas i svaret har du fått en blockerings-shell — byt IP och försök igen.
Headern Cookie: intl_splash=false är en vanlig lösning för Yelps landssplash-omdirigering. Utan den hamnar icke-amerikanska IP:er på en splash-sida som ser ut som ett soft block men inte är det.
Steg 3: Skrapa Yelp-företagssidor
Varje företags-URL från sökresultaten leder till en detaljsida med rikare data. Det mest stabila målområdet för extrahering är <script type="application/ld+json">-blocket — det innehåller strukturerad schema.org-data som Yelp underhåller för SEO och inte obfuskerar.
def scrape_business(biz_url: str) -> dict:
    url = f"https://www.yelp.com{biz_url}" if biz_url.startswith("/") else biz_url
    r = requests.get(url, headers=HEADERS, impersonate="chrome131")
    if r.status_code != 200:
        return {"url": url, "error": r.status_code}
    sel = Selector(text=r.text)
    biz_id = sel.css('meta[name="yelp-biz-id"]::attr(content)').get()
    for raw in sel.css('script[type="application/ld+json"]::text').getall():
        try:
            data = json.loads(raw)
        except json.JSONDecodeError:
            continue
        for node in (data if isinstance(data, list) else [data]):
            if node.get("@type") in (
                "Restaurant", "LocalBusiness", "FoodEstablishment",
                "HealthAndBeautyBusiness", "HomeAndConstructionBusiness",
            ):
                return {
                    "biz_id": biz_id,
                    "name": node.get("name"),
                    "rating": (node.get("aggregateRating") or {}).get("ratingValue"),
                    "review_count": (node.get("aggregateRating") or {}).get("reviewCount"),
                    "address": node.get("address"),
                    "telephone": node.get("telephone"),
                    "price_range": node.get("priceRange"),
                    "hours": node.get("openingHours"),
                    "url": url,
                }
    return {"biz_id": biz_id, "url": url}
Värdet i meta[name="yelp-biz-id"] är det kodade företags-ID:t du behöver för reviews-endpointen. Hämta det här — du använder det i nästa steg.
Steg 4: Skrapa Yelp-recensioner med paginering
Det är här Fusion API:t kommer till korta och scraping verkligen glänser. Yelps interna GraphQL-batch-endpoint returnerar full recensions-text, information om recensenten, datum, betyg och röstantal — allt som API:t håller tillbaka.
Endpointen är https://www.yelp.com/gql/batch, och den använder ett statiskt documentId för operationen GetBusinessReviewFeed. Paginering sker via en base64-kodad cursor.
import base64

GQL_URL = "https://www.yelp.com/gql/batch"
DOC_ID = "ef51f33d1b0eccc958dddbf6cde15739c48b34637a00ebe316441031d4bf7681"

def fetch_reviews(enc_biz_id: str, num_pages: int = 5):
    all_reviews = []
    for page in range(num_pages):
        offset = page * 10
        cursor = base64.b64encode(
            json.dumps({"version": 1, "offset": offset}).encode()
        ).decode()
        payload = [{
            "operationName": "GetBusinessReviewFeed",
            "variables": {
                "encBizId": enc_biz_id,
                "reviewsPerPage": 10,
                "after": cursor,
                "sortBy": "DATE_DESC",
                "language": "en",
            },
            "extensions": {
                "operationType": "query",
                "documentId": DOC_ID,
            },
        }]
        r = requests.post(
            GQL_URL,
            json=payload,
            headers={
                **HEADERS,
                "content-type": "application/json",
                "x-apollo-operation-name": "GetBusinessReviewFeed",
                "apollographql-client-name": "yelp-main-frontend",
            },
            impersonate="chrome131",
        )
        if r.status_code != 200:
            print(f"Hämtning av recensioner misslyckades vid offset {offset}: {r.status_code}")
            break
        data = r.json()
        # Navigera i svaret för att extrahera recensioner
        try:
            reviews = data[0]["data"]["business"]["reviews"]["edges"]
            for edge in reviews:
                node = edge.get("node", {})
                all_reviews.append({
                    "reviewer": node.get("author", {}).get("displayName"),
                    "rating": node.get("rating"),
                    "date": node.get("localizedDate"),
                    "text": node.get("text", {}).get("full"),
                })
        except (KeyError, IndexError, TypeError):
            break
        import time, random
        time.sleep(random.uniform(3, 7))
    return all_reviews
Varje sida returnerar 10 recensioner. Öka offset i den base64-kodade cursoren för att paginera vidare. Parametern sortBy accepterar DATE_DESC (nyast först), RATING_ASC, RATING_DESC och fler.
Steg 5: Exportera din Yelp-data
import pandas as pd

# Anta att du har samlat in företag och recensioner
df_businesses = pd.DataFrame(businesses)
df_businesses.to_csv("yelp_businesses.csv", index=False)

df_reviews = pd.DataFrame(all_reviews)
df_reviews.to_csv("yelp_reviews.csv", index=False)

# Eller spara som JSON för flexibilitet
import json
with open("yelp_data.json", "w") as f:
    json.dump({"businesses": businesses, "reviews": all_reviews}, f, indent=2)
För dig som kör no-code-vägen exporterar Thunderbit samma data direkt till Excel, Google Sheets, Airtable eller Notion — utan pandas eller kod för filskrivning.
Anti-blockeringsspelplanen: så skrapar du Yelp utan att bli blockerad
Det här avsnittet är hela anledningen till att artikeln finns. Yelps anti-bot-skydd har blivit betydligt tuffare sedan slutet av 2024 — TLS-fingeravtryck, IP-rykteskontroller, CAPTCHA och beteendeanalys är alla i spel. De flesta äldre guider är föråldrade eftersom de skrevs innan nedslaget.
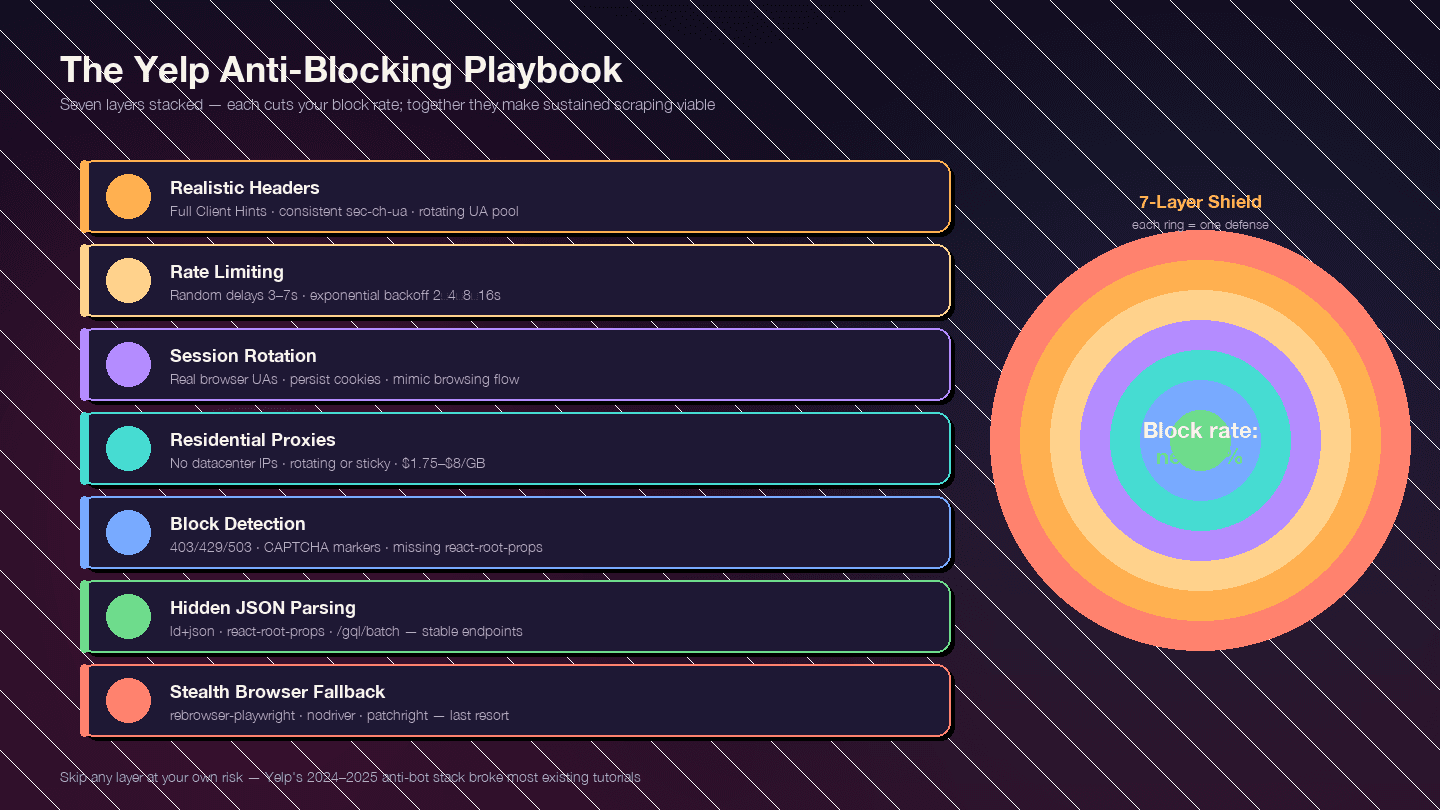
Strategin är lagd i flera nivåer. Varje lager sänker din blockeringsgrad; tillsammans gör de långvarig scraping möjlig.
Lager 1: Realistiska request-headers
Standardheaders i Python requests skickar User-Agent: python-requests/2.x — blockeras direkt. Men även en realistisk User-Agent räcker inte. Yelp kontrollerar hela uppsättningen Client Hints för att se om den är konsekvent.
FULL_HEADERS = {
    "authority": "www.yelp.com",
    "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/124.0.0.0 Safari/537.36",
    "accept": "text/html,application/xhtml+xml,application/xml;q=0.9,"
              "image/avif,image/webp,image/apng,*/*;q=0.8",
    "accept-language": "en-US,en;q=0.9",
    "accept-encoding": "gzip, deflate, br",
    "sec-ch-ua": '"Chromium";v="124", "Google Chrome";v="124", "Not-A.Brand";v="99"',
    "sec-ch-ua-mobile": "?0",
    "sec-ch-ua-platform": '"Windows"',
    "sec-fetch-dest": "document",
    "sec-fetch-mode": "navigate",
    "sec-fetch-site": "same-origin",
    "sec-fetch-user": "?1",
    "upgrade-insecure-requests": "1",
    "referer": "https://www.yelp.com/",
    "cookie": "intl_splash=false",
}
Tre misstag som gör att du flaggas:
- UA säger Chrome men
sec-ch-uasaknas eller motsäger UA-versionen sec-ch-ua-platformsäger "Windows" medan UA-strängen säger macOS- Exakt samma UA över tusentals anrop från en IP — rotera en pool med 10–20 färska Chrome/Firefox/Safari-strängar
Lager 2: Hastighetsbegränsning och slumpade pauser
Förutsägbara tidsmönster är en varningssignal. Lägg till slumpmässiga sömnintervall och exponential backoff vid felstatusar.
import random, time

def polite_get(client_get, url, attempt=0):
    r = client_get(url, headers=FULL_HEADERS, impersonate="chrome131")
    if r.status_code in (403, 429, 503):
        if attempt >= 4:
            raise RuntimeError(f"Blockerad efter {attempt + 1} försök på {url}")
        backoff = 2 ** (attempt + 1) + random.random()
        print(f"  Fick {r.status_code}, backar {backoff:.1f}s (försök {attempt + 1})")
        time.sleep(backoff)
        return polite_get(client_get, url, attempt + 1)
    time.sleep(random.uniform(3, 7))
    return r
| Parameter | Rekommenderat värde |
|---|---|
| Slumpad paus mellan anrop | random.uniform(3, 7) sekunder |
| Backoff vid 429/403/503 | 2 → 4 → 8 → 16 sek, max 5 försök |
| Samtidiga workers per IP | 1 (serialisera per IP; använd proxies för parallellitet) |
| Max hållbar takt per residential IP | ~1 anrop / 5 sek (~12 rpm) |
Lager 3: Rotation av User-Agent och session
Roterar genom en pool av riktiga User-Agent-strängar från webbläsare. Spara sessioner och cookies för att efterlikna verkligt surfande — Yelp använder cookie-baserad detektering, så att skapa en helt ny session för varje anrop är i sig misstänkt.
UA_POOL = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/124.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14_4_1) AppleWebKit/537.36 Chrome/124.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:125.0) Gecko/20100101 Firefox/125.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14.4; rv:125.0) Gecko/20100101 Firefox/125.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14_4_1) AppleWebKit/605.1.15 Safari/17.4.1",
    # Lägg till 5–10 fler färska strängar
]
Lager 4: Proxy-rotation
Vid verklig volym behöver du residential proxies. Datacenter-proxies och gratisproxies fungerar inte på Yelp — Yelps IP-rykteslager ger i förväg 403 till IP-ranges från AWS, GCP och DigitalOcean.
| Leverantör | Startpris $/GB | Kommentarer |
|---|---|---|
| IPRoyal | $1.75/GB | Billigast; kör den mest citerade Yelp-guiden |
| Decodo (fd Smartproxy) | $3.20–$3.50 | Bäst GB/$-förhållande vid volym |
| Bright Data | $4.00 (PAYG) | 150M+ IP-pool; dedikerad sida för Yelp Proxies |
| Oxylabs | $6.00–$8.00 | Premium; 10M+ IP:er |
| Aluvia (mobile SIM) | $3.00 | Riktiga amerikanska mobil-IP:er, positionerat för Yelp |
Roterande residential (ny IP per anrop) fungerar bäst för stora sök-crawls. Sticky sessions (håll samma IP i 10 minuter) är bättre när du vill behålla cookies genom flödet företagssida → recensioner → paginering.
Lager 5: Identifiera och hantera blockeringar
Alla block ser inte likadana ut. Yelp levererar ofta ett generiskt "page not available"-skal i stället för en CAPTCHA, vilket gör att naiva scrapers tror att de får data fast de i själva verket får tomma svar.
BLOCK_MARKERS = (
    "captcha", "px-captcha", "page not available",
    "access denied", "unusual traffic",
)

def is_blocked(resp):
    if resp.status_code in (401, 403, 429, 503):
        return True
    body = resp.text.lower()
    if any(m in body for m in BLOCK_MARKERS):
        return True
    # Om detta är en sök-/företagssida men react-root-props saknas,
    # levererade Yelp ett avskalat block-svar
    if "react-root-props" not in body and "/biz/" in str(resp.url):
        return True
    return False
| Signal | Betydelse |
|---|---|
| HTTP 403 | Hårdkrokad blockering — IP/header/TLS är brända |
| HTTP 429 | Hastighetsbegränsad — ofta återhämtbar med backoff |
| HTTP 503 | Generisk blockering eller lastavlastning |
Omdirigering till /error eller body med "page not available" | Mjuk blockering |
| Tom med bara | Challenge-sida som väntar på JS |
captcha / g-recaptcha / px-captcha i body | Eskalerat — CAPTCHA krävs |
Saknad react-root-props på en listsida | Avskalat block-svar |
Lager 6: Det robusta parsing-tricket — dold JSON framför CSS-selectors
Det tål att upprepas: Yelp randomiserar CSS-klassnamn vid byggtid. En scraper som är låst till h3.y-css-14xwok2 går sönder inom veckor när Yelp släpper en ny version med h3.y-css-hcq7b9.
De payloads som inte flyttar på sig:
<script type="application/ld+json">— schema.org-strukturerad data (namn, adress, telefon, betyg, öppettider)<script data-id="react-root-props">— fullständig sökresultatsdata som JSONhttps://www.yelp.com/gql/batch— GraphQL-endpoint för recensioner med ett stabiltdocumentId
Om du tolkar CSS-klasser bygger du på sand. Tolka JSON i stället.
Lager 7: Fallback med stealth-browser
Gå bara upp till en headless browser när curl_cffi + residential proxies inte kommer igenom — vanligtvis när Yelp visar en JavaScript-challenge eller CAPTCHA.
För 95 % av scraping av företag/sökresultat/recensioner är curl_cffi + dold JSON + residential proxies snabbare, billigare och mer tillförlitligt än en browser. Men när du verkligen behöver en browser:
| Verktyg | Status (2025) | Kommentarer |
|---|---|---|
| rebrowser-playwright | Rekommenderad startpunkt | Drop-in Playwright med patchar som fixar CDP-läckor |
| nodriver | Bäst i klassen för Chrome-stealth | Efterföljare till undetected-chromedriver; undviker WebDriver-protokollet helt |
| patchright | Aktivt underhållen Playwright-fork | Klarar moderna detektionstester |
| playwright-stealth | Moget | Patchar navigator.webdriver, tar bort HeadlessChrome från UA |
Skippa vanlig Selenium för Yelp. Det är för lätt att fingeravtryckssätta.
Yelp Fusion API vs. Python scraping vs. Thunderbit: full jämförelse
| Dimension | Yelp Fusion API | Python scraping | Thunderbit |
|---|---|---|---|
| Fullständig recensions-text | ❌ 3 utdrag × ~160 tecken | ✅ Obegränsat (GraphQL) | ✅ Inbyggd recensionsmall |
| Recensionsmetadata (röster, svar från ägare) | ❌ | ✅ | ✅ Via AI-föreslagna fält |
| Bilder | ❌ (0 på Base) | ✅ Obegränsat | ✅ |
| Maxresultat per sökning | 240 (var 1 000 före 2024) | Obegränsat (med paginering) | Obegränsat |
| Daglig begränsning | 300–500 (nya) / 5 000 (äldre) | Endast proxybudget | Kreditbaserat (3 000/mån på Pro) |
| Uppstartstid | ~15 min | Timmar till dagar | ~2 minuter |
| Hantering av anti-bot | N/A | Ditt problem | Sköts (Cloud mode) |
| Juridisk risk | Låg (auktoriserat) | Medel (gråzon i villkoren) | Medel (samma som scraping) |
| Kostnad (start) | $29/mån | ~$0,75–$4/GB i proxies + utvecklingstid | Gratis nivå |
| Kostnad (tung användning) | $643+/mån | $50–$500/mån i proxies + utvecklingstid | $38–$49/mån |
| Dataexport | JSON | CSV/JSON (du skriver det själv) | Excel / Sheets / Airtable / Notion — gratis |
| Underhåll | Lågt | Högt (selectors går sönder, anti-bot skärps) | Lågt (AI anpassar sig igen) |
Juridiska och etiska tips för att skrapa Yelp
Jag är inte jurist, och detta är inte juridisk rådgivning. Men det juridiska läget har förändrats tillräckligt mycket de senaste två åren för att du bör känna till grunderna innan du lägger tid på ett Yelp-scrapingprojekt.
Vad Yelps användarvillkor säger: Uppdateringen av användarvillkoren i oktober 2025 förbjuder uttryckligen användning av "any robot, spider... or other automated device" för att "access, retrieve, copy, scrape, or index any portion of the Service." Den lade också till formuleringar om "AI Technologies and/or other automated tools."
Yelp Support upprepar: "Yelp tillåter inte någon scraping av webbplatsen."
Vad robots.txt säger: Yelps robots.txt har ett wildcard med User-agent: * / Disallow: / och blockerar specifikt GPTBot, ClaudeBot, PerplexityBot, CCBot och Meta-ExternalAgent. Endast Googlebot, Bingbot och några sociala crawlers är vitlistade.
Det rättsfall som spelar roll: I Meta v. Bright Data (N.D. Cal. jan 2024) slog domstolen fast att scraping av offentligt tillgänglig data som man inte var inloggad på inte bröt mot Metas användarvillkor. Den viktiga skillnaden är: offentlig data utan inloggning vs. data bakom inloggning. Fallet hiQ v. LinkedIn slog fast att scraping av offentlig data sannolikt inte bryter mot CFAA, men hiQ förlorade ändå på delstatliga anspråk (trespass to chattels, misappropriation) och fick en dom på $500 000 mot sig.
Praktiska riktlinjer:
- Skrapa bara offentligt tillgängliga sidor utan inloggning
- Hastighetsbegränsa dina anrop (fördröjningarna i den här guiden fungerar också som etiska rate limits)
- Sälj inte vidare rå recensions-text som är kopplad till namngivna användare — respektera recensenters integritet
- Följ lokala dataskyddslagar (CCPA, GDPR)
- Logga inte in för att skrapa — då passerar du gränsen för auktorisation
- Betrakta företagsinfo (namn/adress/telefon/betyg) som offentliga sakuppgifter; behandla recensions-text som känsligare
Rådfråga en jurist för just din situation.
Avslutning
Tre vägar, ett mål.
Yelp Fusion API:t är det auktoriserade alternativet med lågt underhåll — men det toppar på 3 recensionsutdrag och börjar på $29/månad. Python scraping ger dig full kontroll över varje datapunkt på Yelp, men kräver verklig investering: curl_cffi för TLS-imitering, residential proxies, slumpmässiga fördröjningar, parsing av dold JSON och löpande underhåll när Yelps försvar utvecklas. Thunderbit tar dig från "jag behöver Yelp-data" till "här är mitt kalkylblad" på ungefär 30 sekunder, utan kod och utan proxykonfiguration.
De anti-blockeringsmetoder som faktiskt fungerar 2025: realistiska headers med fulla Client Hints, curl_cffi för att imitera TLS-fingeravtryck, slumpade fördröjningar med exponential backoff, rotation av residential proxies och — framför allt — parsing av dold JSON (application/ld+json och react-root-props) i stället för sköra CSS-selectors.
Osäker på vilken väg som passar? Testa Thunderbits gratisnivå först. Om den täcker dina behov har du sparat timmar. Om du behöver mer kontroll — fulla programmerade flöden, egna fält, tät CRM-integration — täcker Python-guiden ovan det. Och för en djupare titt på landskapet av scrapingverktyg, kolla vår sammanställning av de bästa Chrome-tilläggen för web scraping eller vår guide om att skrapa data från webbplatser till Excel.
Testa Thunderbit för att extrahera Yelp-data Get Started Free
Vanliga frågor
Kan jag skrapa Yelp gratis med Python?
Ja — med gratisbibliotek som curl_cffi, parsel och jmespath. Men vid verklig volym (mer än några dussin sidor) behöver du betalda residential proxies, som börjar runt $1.75/GB hos IPRoyal. Thunderbit erbjuder också en gratisnivå med 6 sidor/månad för snabb no-code-extrahering.
Blockerar Yelp scrapers?
Ja, aggressivt. Yelp använder TLS/JA3-fingeravtryck, IP-ryktepoäng, CAPTCHA, beteendeanalys och roterande obfuskterade CSS-klasser. Vanliga requests blockeras vid första träffen. Den flerskiktade anti-blockeringsstrategin i den här guiden — curl_cffi för TLS-imitering, realistiska headers, slumpade pauser och residential proxies — är det som fungerar 2025.
Är Yelp Fusion API bättre än scraping?
Det beror på vad du behöver. API:t är auktoriserat och har låg risk, men det returnerar bara 3 recensionsutdrag på cirka 160 tecken vardera, begränsar sökresultat till 240 och börjar på $29/månad. Om du behöver full recensions-text, metadata eller mer än några hundra poster per dag, är scraping det enda alternativet.
Hur skrapar jag Yelp-recensioner med Python?
Använd curl_cffi med impersonate="chrome131" för att hämta företagssidan, plocka ut det kodade företags-ID:t från <meta name="yelp-biz-id">, och skicka sedan en POST till https://www.yelp.com/gql/batch med operationen GetBusinessReviewFeed och paginera via en base64-kodad after-cursor. Steg-för-steg-koden finns i handledningen ovan. Scrapflys Yelp scraper-repo är också en bra referensimplementation.
Kan jag skrapa Yelp utan att koda?
Ja — Thunderbits AI Web Scraper levereras med färdiga mallar för Yelp-företag och recensioner. Öppna en Yelp-sida, klicka på AI Suggest Fields, klicka på Scrape. Export till Google Sheets, Excel, Airtable och Notion är gratis i alla nivåer, inklusive gratisplanen.
Läs mer



