
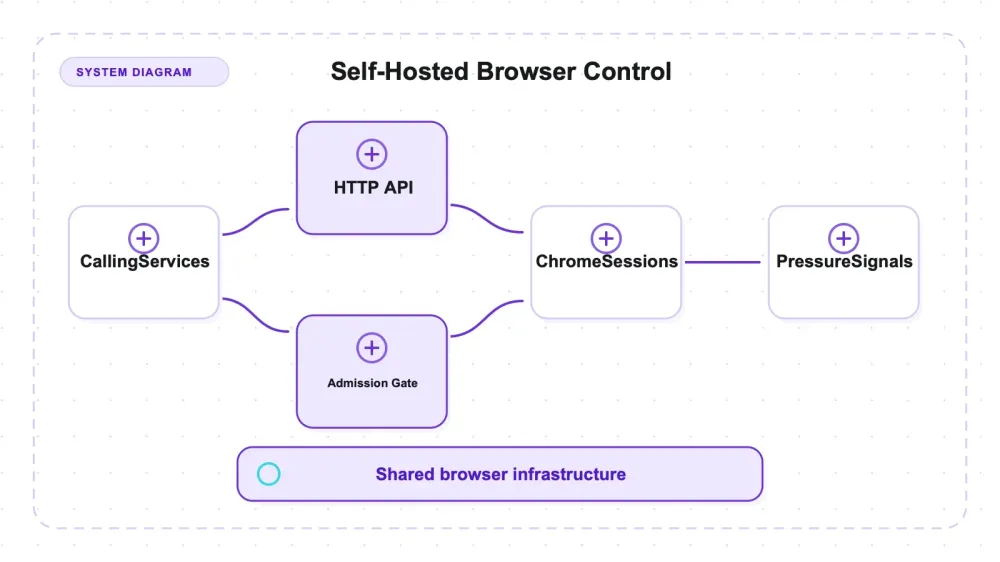
Browserless är headless Chrome paketerat som en tjänst du själv hostar. Docker-containern körs hela tiden, tar emot jobb via HTTP eller WebSocket och använder gemensamma gränser för samtidighet i stället för att importeras i varje anropare. I REST-testerna här hade tjänsten noll Chrome-processer i vila, skapade Chrome-processer när en begäran var aktiv och gick tillbaka till noll efteråt. Det som delas är tjänstekapacitet och köhantering, inte en bekräftad uppsättning förvärmda webbläsarprocesser.
Jag körde v2.55.0 mot ett kontrollerat lokalt testunderlag — uppstart uppdelad i faser, åtkomstkontroll i tre konfigurationer, endpoint-trohet mot känd facitdata, ett 30-sessioners soak-test och timeout-gränsen. Det mest användbara resultatet var operativt snarare än en hastighetsförbättring: gränserna för åtkomst stämde med de svar klienten såg, och de skarpa kanterna handlade främst om driftsättning.
Det mest användbara resultatet var inte ett latenstal. Browserless får inte Chrome att starta snabbare — det lägger en dörrpolicy ovanpå Chrome: ett fast antal sessioner inne, en kö bakom dem och HTTP 429 för alla andra. Den övre gränsen gick från 4 till 8 till 10 när jag ändrade två miljövariabler, och containerns egen redovisning stämde med min klients statuskoder i varje enskild förfrågan.
Vad Browserless faktiskt är
Det är här många går fel. Browserless är inte ett bibliotek du importerar och anropar. Det är en Docker-image — ghcr.io/browserless/chromium — som du kör som en långlivad tjänst. Den förmedlar webbläsarjobb och exponerar dem på två sätt: REST-endpoints (/content, /scrape, /screenshot, /pdf, plus /function och /unblock) samt en CDP/WebSocket-yta som Puppeteer och Playwright kan connect() till.
Jag testade REST-ytan. WebSocket-vägen är verklig och används ofta, men jag mätte den inte.
Versionen som testades var v2.55.0, verifierad den 27 juli 2026.
| Post | Värde |
|---|---|
| Image-version | v2.55.0, publicerad 14 juli 2026 |
| Chrome | 149.0.7827.0 |
| Node | 24.18.0 |
| Basimage | Ubuntu 24.04 |
| GitHub-stjärnor | cirka 13 525, per 27 juli 2026 |
Stjärnantal ändras; se detta som en ögonblicksbild.
Licensgränsen: SSPL-1.0 eller kommersiell
Repositoryt erbjuder Browserless under SSPL-1.0 eller en kommersiell Browserless-licens. Läs den aktuella repository-licensen LICENSE och Browserlesss officiella vägledning för öppen källkod och egen driftsättning innan du väljer väg. Den här artikeln gjorde ingen juridisk analys av kommersiella produkter, stängda applikationer, CI-system, hostade tjänster eller interna driftsättningar, så den placerar inte dessa scenarier i någon licenskategori. Låt juridiskt ansvarig eller den som äger programvarulicenserna bedöma driftsättnings- och distributionsmodellen.
Browserless säljer också hostade planer. Prissättning och definitioner av användningsenheter ändras ofta och ingick inte i detta test med egen drift, så verifiera dem på den officiella sajten i stället för att behandla en daterad tabell här som upphandlingsunderlag.
Så fungerar sessionsmodellen under huven
Den uppmätta REST-vägen betedde sig som webbläsarjobb per begäran, men detta testupplägg spårade inte Browserless interna mekanik tillräckligt djupt för att skilja en ny webbläsarprocess från alla tänkbara strategier för återanvändning av kontext. Det som faktiskt fastställdes är enklare: noll Chrome-processer i vila, 11 processer i Chrome-familjen under en aktiv begäran och noll efter den sekventiella körningen. Inga tecken fanns på någon förvärmd webbläsarpool i den här konfigurationen.
Den långlivade Node-tjänsten släpper in ett begränsat antal webbläsarjobb, lägger ytterligare ett begränsat antal i kö och avvisar resten. Se den modellen för åtkomstkontroll som den arkitektoniska överenskommelse som mäts nedan. Dra inte slutsatser om process- eller kontextåteranvändning av ordet ”pool”; tidsmätningen kan inte bevisa det.
Åtkomstkontrollen styrs av två reglage:
CONCURRENT— hur många sessioner som kör samtidigt.QUEUED— hur många extra förfrågningar som får vänta på en plats.
Containerns /config-endpoint rapporterade standardvärdena CONCURRENT=10, QUEUED=10, TIMEOUT=30000. Allt utöver CONCURRENT + QUEUED avvisas direkt.
Autentisering är inte valfri. Browserless v2 kräver alltid en token — om du inte sätter TOKEN genererar den en slumpmässig sådan och skriver ut den till stdout vid start. Varje REST-anrop har ?token=.
För övervakning får du /pressure (körande, köade, CPU, minne, nyligen avvisade), /sessions och /config. Det finns också en JSON-export för /metrics, men den kräver att METRICS_JSON_PATH är satt och den använde jag inte. Och imagen kör dumb-init som PID 1, vilket är det dokumenterade svaret på klagomålen om zombieprocesser som har följt containeriserad Chrome i åratal.
Installationsverkligheten: ett kommando, och fyra saker ingen nämner i ett kommando
Installationsraden alla citerar är verkligen bara ett docker run. Det som omger den är det du bör planera för.
Imagen är 4,34 GB. Det är siffran som bör styra dina förväntningar, inte uppstartslatensen. Manifestet innehåller både linux/arm64 och linux/amd64; på min arm64-värd drog Docker den inbyggda arm64-varianten. (Chromes user-agent inuti containern ser ändå ut som X11; Linux x86_64 — det är Chromes kosmetiska UA på Linux, inte emulering. uname -m säger aarch64. Folk öppnar buggar om detta.)
Jag använde --shm-size=2g för varje mätning. Testupplägget inkluderade ingen kontrollkörning med Dockers standardvärde för /dev/shm, så den här artikeln kan inte kalla 2 GiB universellt obligatoriskt eller kvantifiera felgränsen. Anpassa storleken efter webbläsarantal och arbetslast.
Tokenen är en driftsättningsfråga, inte en formalitet. Utan den kan vem som helst som når port 3000 styra en webbläsare på ditt nätverk.
Container-nätverk är ditt problem. Mitt testunderlag körde på värden, så containern nådde det via host.docker.internal (colima mappar det med --add-host host.docker.internal:host-gateway). Jag verifierade att containern faktiskt kunde nå testunderlaget med en rå curl innan jag litade på någon mätning.
Min miljö: colima 0.10.3 (6 CPU / 11,6 GiB) med Docker 29.2.1 på macOS 26.5.2 arm64. Testharnessen använde endast Python 3:s standardbibliotek. För PNG och PDF kontrollerades filsignaturer, inte avkodningsvaliditet, dimensioner, sidantal, fullständighet eller visuell trohet.
En minimal motsvarande start använder den låsta imagen, en explicit token och den delade minnesallokering som användes här:
docker run --rm -p 3000:3000 --shm-size=2g \
  -e TOKEN=replace-with-a-secret \
  ghcr.io/browserless/chromium:v2.55.0
När /pressure?token=... svarar, testar en autentiserad POST /content?token=... med en JSON-body som innehåller mål-URL:en REST-vägen. Produktionsanrop behöver också begränsad retry med jitter för 429-svar; att försöka igen direkt innebär bara att man rusar samma fulla kö på nytt.
Uppstartskostnaden, uppdelad
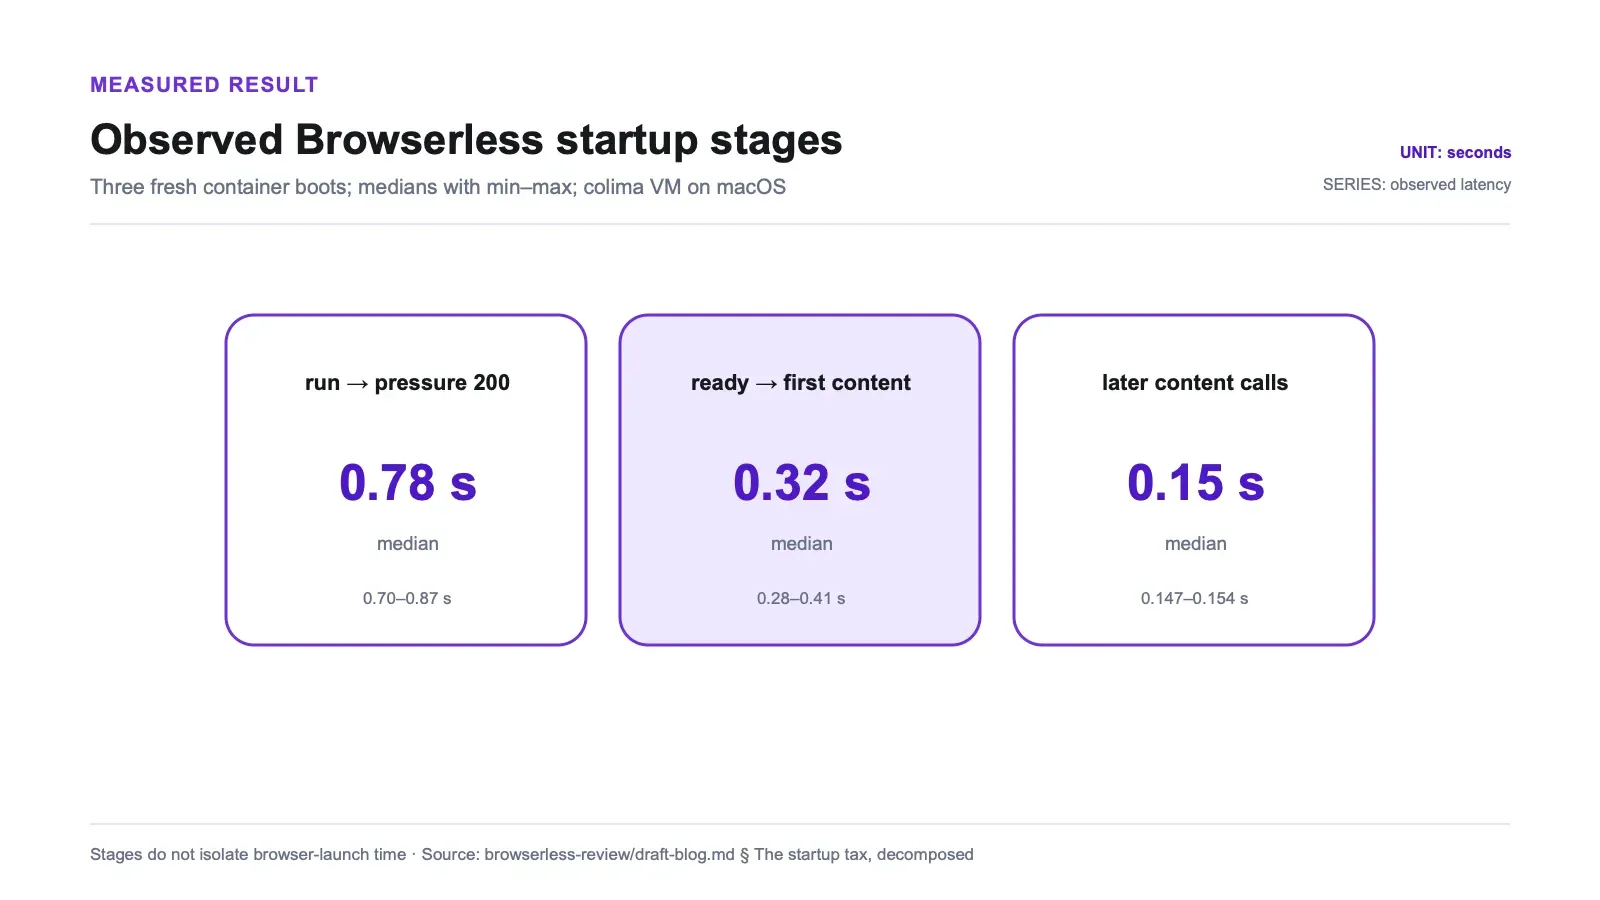
Tre färska docker run-starter, median med min–max:
| Steg | Median | Intervall | Vad det faktiskt är |
|---|---|---|---|
docker run → /pressure returnerar 200 | 0,78 s | 0,70–0,87 s | HTTP-endpointen svarar; webbläsarstart är inte verifierad av denna kontroll |
redo → första /content-renderingen | 0,32 s | 0,28–0,41 s | observerad första begäran: webbläsarjobb + navigering + retur av HTML |
senare /content-anrop | 0,15 s | 0,147–0,154 s | observerad latenstid för senare anrop i samma container |
Mittraden är lätt att läsa in för mycket i. Den mäter inte webbläsarstart isolerat och visar inte att Browserless startar Chrome snabbare än ett bibliotek som körs i processen. Det är en HTTP-rundresa in i en container plus webbläsararbete, navigering och överföring av svar. Den ungefär 0,17 sekunder stora skillnaden mellan första och senare anrop kan omfatta filsystems-, OS-, Chrome-, Node- eller containercacheeffekter. Eftersom Chrome-processerna var noll i vila och testet inte fångade någon CDP-spårning eller process-tidslinje för dessa anrop kan det inte tillskriva skillnaden till återanvändning av webbläsare eller ”amorterad” startkostnad.
Dessutom: detta är siffror från colima-VM på macOS. Linux direkt på hårdvaran kommer att skilja sig. Citerar du inte 0,78 s till din SRE som om det vore portabelt.
Praktiskt: hitta taket från båda håll
Kontraktet CONCURRENT + QUEUED → 429 upprepas överallt men demonstreras nästan ingenstans.
Upplägget: en testväg som sover 5 sekunder på serversidan, så att varje begäran pålitligt upptar en session under känd tid. Skicka sedan CONCURRENT + QUEUED + 4 begäranden samtidigt och se vad som kommer tillbaka — medan en separat samplings-tråd pollar /pressure för att läsa containerns egen redovisning.
| Konfiguration (CONCURRENT, QUEUED) | Skickade | HTTP 200 | HTTP 429 | Serverns peak i /pressure (running / queued / recentlyRejected) |
|---|---|---|---|---|
| (2, 2) | 8 | 4 | 4 | 2 / 2 / 4 |
| (3, 5) | 12 | 8 | 4 | 3 / 5 / 4 |
| (5, 5) | 14 | 10 | 4 | 5 / 5 / 4 |
Tre saker framgick av detta.
Taket är exakt CONCURRENT + QUEUED, varje gång. Lyckade svar blev 4, 8 och 10 — den konfigurerade summan i varje fall. Avvisningarna blev lika många som överskjutandet, vilket var 4 i alla tre körningar.
Taket flyttar sig. Det är inte ett konstant värde inbyggt i imagen; det är vad du än konfigurerar. Att gå 4 → 8 → 10 genom att ändra miljövariabler är det som gör detta användbart snarare än kuriosa.
Och de två signalerna är oberoende. Min klients statuskoder kom från riktiga HTTP-svar; /pressure kom från containerns egen interna redovisning, samplad av en annan tråd. De överensstämde i dessa tre korta körningar. Det gör /pressure till en möjlig produktsignal, inte ett komplett autoskalningsavtal: samplingsfrekvens, återställningssemantik, aggregering över flera repliker och beteende under längre blandade arbetslaster behöver fortfarande verifieras.
En nyans som pass/fail-räkningen döljer. En köad begäran misslyckas inte — den väntar, och den kan vänta länge. Vid (2, 2) med 5-sekundersarbete landade de lyckade svaren någonstans mellan 5,7 s och 11,0 s, median 8,3 s. End-to-end-latensen nådde alltså ungefär två sessioners längd. Testet fångade inte separata tidsstämplar för åtkomst och körning, så det kan inte lägga hela fördröjningen på köväntan.
Så här ser det ut på ett riktigt jobb
Säg att du renderar 4 000 produktsidor till PDF varje natt, och att varje sida tar ungefär 5 sekunder. Du sätter CONCURRENT=5, QUEUED=5. Din genomströmningstak blir 5 sidor per 5 sekunder — en sida per sekund — så jobbet tar ungefär 67 minuter om du håller röret exakt fullt. Det är aritmetik på uppmätt beteende, inte ett benchmark, men det är den aritmetik du bör göra innan du driftsätter.
Varje begäran som kommer in efter att alla körande och köade platser är upptagna kan få 429 direkt; samtidig utsändning garanterar inte vilken ordningsnummer-begäran som förlorar racet. En jobbrunner bör behandla det svaret som backpressure och använda begränsad retry med jitter. Annars riskerar den att tappa sidor medan högre nivåns jobbredovisning fortsätter — en operativ risk, inte ett fel-scenario som demonstrerats av detta testupplägg.
Praktiskt: vad endpoints faktiskt ser
För att testa renderingsnoggrannhet är test-sidan byggd så att dess markörtext döljs för alla som inte kör en riktig webbläsare. Den synliga strängen Runtime Injected Marker 88 sätts ihop från JavaScript-fragment vid laddning, så ingen sammanhängande litteral för den finns i någon byte som servern skickar. En vanlig statisk hämtning av den sidan returnerar 702 byte som innehåller ingen av markörerna.
| Endpoint | Resultat | Byte |
|---|---|---|
/content | runtime-injicerad markör fanns med, plus båda statiska markörerna | 811 |
/scrape på #scrape-me (en JS-injicerad nod) | returnerade SCRAPE_TARGET_VALUE_CC | 422 |
/screenshot | svar med PNG-signatur 89 50 4E 47 | 18 621 |
/pdf | svar med PDF-signatur %PDF- | 40 974 |
| alla fyra, ingen token | HTTP 401 (inte 403) | — |
Att /content returnerar 811 byte med den injicerade markören betyder att en riktig Chromium renderade sidan innan HTML:en kom tillbaka. /scrape hämtade ett värde ur en nod som inte existerar förrän JavaScript körs. Båda fungerade med noll automatiseringskod på klientsidan — en enda autentiserad POST.
Det är den faktiska poängen. I samma testomgång missade en statisk crawler den här typen av innehåll helt, och biblioteken som kör browser i processen (chromedp, rod, Selenium) fångade det först efter att jag skrivit en explicit väntan. Browserless fångade det med en curl-liknande begäran. Du byter automatiseringskod mot driftsättningsvikt.
Två gränser för det påståendet. Bevisen täcker innehållstyperna i mitt testunderlag, inte hela webben. Och /unblock, anti-detektions-endpointen, lämnades medvetet orörd — inget av resultaten ska läsas som ett påstående om anti-bot-förmåga. /function, /download och /performance testades inte heller.
Praktiskt: en kort restkontroll
Containeriserad Chrome har rykte om sig att lämna kvar lik, så jag körde 30 sekventiella sessioner med CONCURRENT=3 och räknade processer inne i containern.
Innan jag litade på något av det kalibrerade jag detektorn. Medan en session pågick läste /proc-uppräknaren 11 processer i Chrome-familjen (browser, zygote, GPU, renderers, utilities). Det är viktigt: det bevisar att instrumentet kan se Chrome, så dess nollvärde efter körningen är en mätning, inte blindhet. Ett läcktest som rapporterar ”0 processer” utan att bevisa att det kan räkna är värdelöst.
Efter 30 sessioner: 0 Chrome-processer, 0 zombies. De enda som fanns kvar var dumb-init, node, Xvfb, start.sh och sh. /sessions visade 0 i vila.
Container-minne, från docker stats (operatörens synliga tal, inte en enskild process RSS):
| Efter N sessioner | 0 | 5 | 10 | 15 | 20 | 25 | 30 |
|---|---|---|---|---|---|---|---|
| Container-minne (MiB) | 294 | 300 | 301 | 302 | 302 | 303 | 303 |
Nettotillväxt över 30 sessioner: cirka 9,5 MB, och den uppmätta kurvan planade ut efter session 10. Det stämmer inte med en enkel linjär läcka per session under detta korta fönster. Node-uppvärmning är en möjlig förklaring, inte något som denna process- och minnesserie kan bevisa.
Omfattning: 30 sekventiella sessioner är ett litet soak-test, inte ett uthållighets- eller samtidighetstest. De långvariga EventEmitter-varningarna i issue-trackerna är sådant som kan dyka upp över timmar och tusentals sessioner, och det körde jag inte. Den stödjda slutsatsen är endast att inga ackumulerade Chrome-processer eller zombies observerades i detta fönster på v2.55.0.
Timeout-gränsen
TIMEOUT är dokumenterad som ett reglage. Jag ville se den slå till.
| Fall | Sidan hålls | Status | Elapsed |
|---|---|---|---|
| Under budget | 2 000 ms | 200 | 2,406 s |
| Över budget | 15 000 ms | 408 | 5,007 s |
Med TIMEOUT=5000 returnerade en session som försökte hålla en sida i 15 sekunder HTTP 408 efter 5,007 s i stället för att hänga. Denna enstaka observation bekräftar tillämpning nära den konfigurerade gränsen. Den avslöjar inte timerimplementationen eller bevisar att en plats frigjordes; ett starkare test skulle upprepa försöket, observera att /sessions och /pressure återgår till vila och sedan bekräfta att en efterföljande begäran tar den frigjorda platsen.
Migreringsfällan: PREBOOT är inert och säger inte till
Av allt jag mätte är det här det resultat jag helst hade velat få serverat före en uppgradering.
Browserless 2.0.0 tog bort PREBOOT och KEEP_ALIVE — ändringsloggen säger att de togs bort för att de var förvirrande, gjorde lite nytta och orsakade buggar. Rimligt. Problemet är vad som händer när en v1-konfiguration klistras över till v2, vilket är det vanligaste sättet folk uppgraderar på.
Jag körde containern med -e PREBOOT=true och mätte den mot standardläget:
| Signal | PREBOOT=true | Standard, flagga ej satt |
|---|---|---|
| Redo-tid | 0,716 s | 0,776 s |
| Kall rendering | 0,314 s | 0,318 s |
| Varm rendering | 0,163 s | 0,150 s |
| Chrome-processer i vila | 0 | 0 |
Alla tider ligger inom standardlägets egen min–max-band — det är brus, inte effekt. Och inget var förvärmt: containern med PREBOOT=true står i vila utan några webbläsare alls, identisk med en utan flaggan. Två signaler till, ingen av dem ett tal:
/configexponerar ingenpreboot-nyckel alls. Nycklarna ärconcurrent,queued,timeout,token,maxCPU,maxMemory,retriesoch liknande.- Inget fel. Ingen varning. Ingenting i container-loggarna.
Så en v1 PREBOOT-konfiguration på v2 är en tyst no-op vid normal start och vanliga loggkontroller. Den saknade /config-nyckeln plus oförändrat beteende är den detekterbara signalen; Browserless ger ingen uttrycklig avvisning eller varning. En migreringskontroll behöver inspektera tillämpad konfiguration i stället för att behandla en grön start som bevis på att varje miljövariabel fick effekt.
KEEP_ALIVE är motsatsen, och de två ska inte klumpas ihop. Den togs bort i samma version, men den är inte tyst — en snabb kontroll av containern visar att den loggar Environment variable of "KEEP_ALIVE" is deprecated and ignored. direkt i stdout. Det är en korrekt operatörsvarning. Jag körde inte KEEP_ALIVE genom samma mätupplägg som PREBOOT, så jag rapporterar det som en kontroll snarare än som en mätning. Men riktningen är tydlig nog för att spela roll: endast PREBOOT är den tysta fällan. Browserless är ärligare om KEEP_ALIVE än vad en generell sammanfattning som ”v2 ignorerar dina v1-flaggor” skulle ge den cred för.
För- och nackdelar
Fördelar
- Åtkomstkontroll som beter sig exakt som dokumenterat och flyttar sig med konfigurationen — bevisat vid tre olika tak, samtidigt i klientens statuskoder och serverns egen redovisning.
/pressurematchade klientens synliga antal körande, köade och avvisade i tre korta körningar; se det som en möjlig indata för autoskalning och larm.- Riktig Chromium-rendering utan någon automatiseringskod på klientsidan: en autentiserad POST exponerade JS-injicerat DOM som en statisk hämtning av samma sida inte kan se.
- Inga ackumulerande Chrome-processer observerade i en 30-sessioners sekventiell körning; efteråt var antalet 0 Chrome-processer och 0 zombies.
- Ett
TIMEOUT-test returnerade 408 vid 5,007 s mot en budget på 5,000 s; städning och frigöring av plats verifierades inte separat. - Autentisering på som standard: alla fyra REST-endpoints returnerar 401 utan token.
- Ett
docker runtill en redo tjänst på cirka 0,78 s, och första rendering 0,32 s därefter.
Nackdelar
- 4,34 GB image. Det är den ärliga huvudkostnaden, och den syns i ditt register, din CI-cache och din kalla driftsättningstid.
- SSPL-1.0 eller kommersiell Browserless-licens. Utvärdera de exakta aktuella villkoren mot din driftsättnings- och distributionsmodell.
PREBOOTfrån v1 accepteras och ignoreras tyst på v2 — inget fel, ingen varning, ingen/config-nyckel.- Du driver en tjänst, inte bara lägger till ett beroende: en container, en token, en nätväg, ett åtkomsttak och uppgraderingsansvar.
- Köade begäranden drev end-to-end-latensen till ungefär två sessioners längd i
(2, 2)-körningen; separat köväntan mättes inte. - Den uppmätta REST-tiden inkluderar ett HTTP-steg och isolerar inte kostnaden för webbläsarstart eller bevisar återanvändning av webbläsare.
Vem borde köra det, och vem borde inte
Browserless är värt sin vikt när fler än en sak behöver en webbläsare. En renderingtjänst som delas av flera appar, ett team som vill ha skärmdumpar och PDF:er bakom en HTTP-endpoint i stället för en Chrome-beroende i varje tjänst, en jobbpipeline som verkligen behöver ett kapacitetsgolv med mätbar backpressure — det är den form som passar. Om du redan kör Docker och någon äger driften är operationshistorien tydlig: förutsägbar åtkomst, observerbar backpressure och inga ackumulerande Chrome-processer eller zombies observerade i den 30-sessioners sekventiella kontrollen.
Det är också rätt val om alternativet är att varje tjänst i din stack installerar sin egen Chromium. Att centralisera det i en container med token och kapacitetstak är ett genuint bra arkitekturbeslut.
Hoppa över det om du skriver ett enda skript. Att dra in 4,3 GB och köra en container för att en enda Python-fil ska hämta en renderad sida är mycket ceremoniel för ett litet jobb — ett webbläsarbibliotek i din process klarar det utan separat driftsättning. Hoppa över det om SSPL-villkoren inte fungerar för din kommersiella produkt och du inte kan lösa det. Hoppa över det om det du egentligen vill ha är en webbläsare som kommer förvärmd utan kallstartskostnad, eftersom PREBOOT inte ger dig det på v2. Och hoppa över det om ditt verkliga problem är anti-bot-hantering, eftersom det ligger i en endpoint som jag medvetet inte testade och inte tänker gå i god för.
Alternativ, inklusive var Thunderbit passar in
Den jämförelse som faktiskt är värd att göra är inte Browserless mot ännu en container. Det handlar om var webbläsaren körs och vem som ansvarar för att hålla den levande.
Relaterad recension: Browsertrix Crawler-recension.
Relaterad recension: chromedp-recension.
| Webbläsarbibliotek (chromedp, rod, Selenium, Playwright) | Browserless egen drift | Thunderbit hanterad extraktion | |
|---|---|---|---|
| Var webbläsaren körs | I din process | I din container | På någon annans infrastruktur |
| Installationskostnad | Paketinstallation | 4,3 GB image + container + token | API-nyckel |
| Tid mätt här | Inte mätt i den här artikeln | 0,32 s första rendering efter HTTP-redo; senare anrop 0,15 s median | Inte mätt i den här artikeln |
| Vad du skriver | Automatiseringskod med explicita väntor | En autentiserad POST | Ett HTTP-anrop |
| Vad du får tillbaka | Det du än skriptat fram | HTML, signaturmatchande PNG/PDF-svar, scrape:ade noder | Produktspecifik strukturerad JSON eller Markdown |
| Kapacitetsgräns | Din maskin | CONCURRENT + QUEUED, därefter 429 | Leverantörens plan |
| Vem som har jour | Du | Du | De |
Om du vill ha en webbläsare i din egen process och inte har något emot att skriva väntelogiken är ett bibliotek lättare och kräver ingen driftsättning. Jag har skrivit om den sidan i jämförelsen mellan Playwright och Puppeteer och den bredare sammanställningen av open source-scrapingprojekt.
Om du inte vill drifta en webbläsare alls är vår egen Thunderbit ett hanterat alternativ. Browserless lämnar tillbaka renderat material som din kod tolkar; Thunderbit kan lämna tillbaka Markdown eller schema-matchad data medan leverantören äger renderingsinfrastrukturen. Den här artikeln benchmarkade inte Thunderbits latenstid, kapacitet, felbeteende, extraktionskvalitet eller kostnad, så tabellen beskriver ansvarsgränser snarare än en prestandajämförelse.
Relaterad läsning från samma testomgång: Crawl4AI-recensionen går igenom en browser-baserad Markdown-pipeline som du kör själv, och översikten över web scraping-verktyg kartlägger den bredare kategorin.
Testa Thunderbit för webbaserad dataextraktion
Slutsats
Bör du köra Browserless? Ja, om flera anropare behöver webbläsararbete, någon kan drifta containern och din licensgranskning godkänner driftsättningsmodellen. I tre syntetiska tester av åtkomstkontroll matchade antalet accepterade förfrågningar CONCURRENT + QUEUED, överskjutande förfrågningar fick 429, och /pressure matchade de klientsynliga siffrorna. I ett separat sekventiellt test med 30 sessioner ackumulerades inga Chrome-processer eller zombies. Ett timeout-test returnerade 408 nära den konfigurerade gränsen. Det är användbara avgränsade observationer, inte universella garantier.
Var ändå ärlig med åtagandet. Det är en 4,34 GB image och en tjänst du driftar, inte ett beroende du lägger till; detta test visade ingen hastighetsjämförelse mot ett webbläsarbibliotek i processen. Det den ger dig är en webbläsare du kan ransonera: ett känt tak och mätbar backpressure. I den 30-sessioners sekventiella kontrollen observerades inga ackumulerande Chrome-processer eller zombies. Kostnaderna är driftsättningsvikt och en licens du måste läsa. Om du renderar några få sidor från ett enda skript lönar sig inte den affären. Om du driver ett renderingslager som flera tjänster är beroende av, gör den det — men kontrollera dina v1-miljövariabler på vägen in, eftersom PREBOOT kommer att stå där och se sysselsatt ut medan den absolut inte gör någonting.
Testa Thunderbit för webbaserad dataextraktion Get Started Free
Vanliga frågor
Gör Browserless headless Chrome snabbare?
Det här testet kan inte svara på det. HTTP-endpointen blev responsiv 0,78 s efter docker run; det första /content-anropet tog sedan 0,32 s och senare anrop i samma container tog ungefär 0,15 s. De siffrorna kombinerar HTTP-rundresa, webbläsararbete, navigering och svaröverföring. Testet isolerade inte starttiden, spårade inte processåteranvändning och publicerade inget jämförbart benchmark i processen. Använd Browserless för en gemensam tjänstgräns och åtkomstkontroll, och benchmarka sedan din egen latenstid.
Vad händer när du överskrider Browserless samtidighetsgräns?
Du får omedelbart HTTP 429. Taket är exakt CONCURRENT + QUEUED, och jag bekräftade det i tre konfigurationer: (2,2) accepterade 4 och avvisade 4, (3,5) accepterade 8 och avvisade 4, (5,5) accepterade 10 och avvisade 4. Serverns /pressure-endpoint rapporterade matchande antal för running, queued och recentlyRejected varje gång. Värt att veta: köade förfrågningar misslyckas inte, de väntar — vid (2,2) med 5-sekundersarbete tog lyckade svar mellan 5,7 s och 11,0 s. Bygg din klient så att 429 behandlas som backpressure med retry och backoff.
Fungerar PREBOOT fortfarande i Browserless v2?
Nej. PREBOOT togs bort i 2.0.0, och v2 accepterar -e PREBOOT=true utan fel eller varning medan den inte gör någonting med det. Jag bekräftade att det var inert på tre sätt: latensen gick inte att skilja från standardläget, en vilande PREBOOT=true-container hade 0 Chrome-processer som väntade, och /config exponerar ingen preboot-nyckel alls. Om du migrerade en v1-konfiguration är dina instanser inte förvärmda. Notera att KEEP_ALIVE, som togs bort i samma version, faktiskt loggar en varning om att den är ”deprecated and ignored” — så det tysta felproblemet är specifikt för PREBOOT.
Är Browserless gratis för kommersiellt bruk? Repositoryt erbjuder SSPL-1.0 eller en kommersiell Browserless-licens, men den här artikeln mappar inte specifika kommersiella eller slutna scenarier till något av alternativen. Läs igenom den aktuella LICENSE och officiella vägledningen för driftsättning, och låt sedan den som ansvarar för programvarulicenser bedöma din driftsättnings- och distributionsmodell.
Lämnar Browserless kvar zombieprocesser i Chrome?
Inga ackumulerades under den korta testperioden. Efter 30 sekventiella sessioner hade containern 0 Chrome-processer och 0 zombies, med bara dumb-init, node, Xvfb, start.sh och sh kvar. Detektorn räknade 11 processer i Chrome-familjen medan en session var aktiv, så den var inte blind. Container-minnet gick från 294 MiB till 303 MiB och planade sedan ut i sampel. Detta är inte ett uthållighetsresultat över flera timmar, med samtidighet eller tusentals sessioner.




