
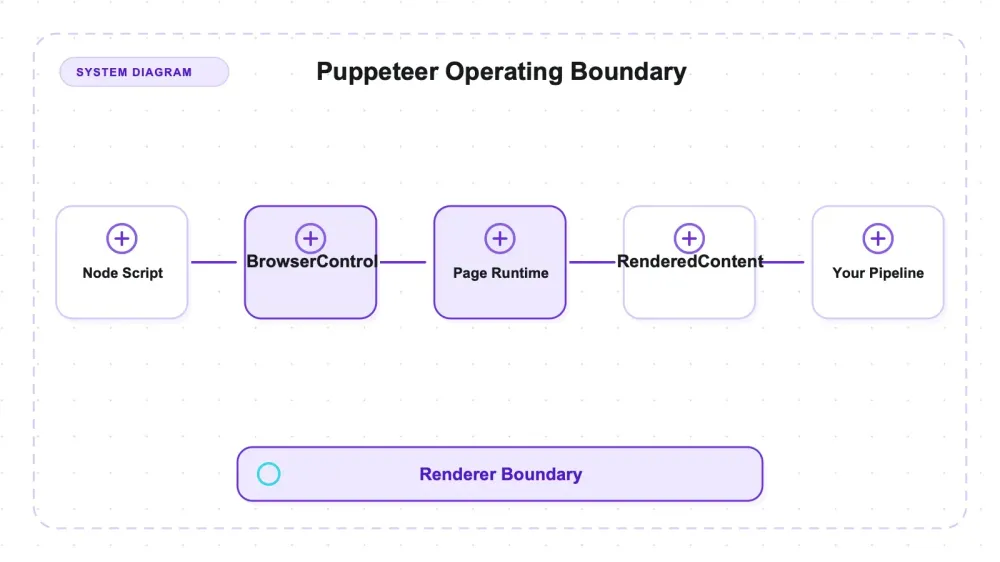
Puppeteer — это Node-библиотека от Google для управления настоящим Chrome из JavaScript: ты пишешь автоматизацию, Chrome DevTools Protocol передаёт команды, а полноценный браузер рендерит страницу, прежде чем ты прочитаешь из неё хоть байт. Проект живёт на GitHub в puppeteer/puppeteer: лицензия Apache-2.0, код на TypeScript и примерно 95,3 тыс. звёзд (95 307 на момент снятия метрик). Официальная позиция намеренно узкая — «JavaScript API для управления Chrome (и экспериментально Firefox)» — и это хорошо показывает, чем он является, а чем не является.
Я прогнал Puppeteer 24.16.0 через тот же набор фикстур и публичных демо, которые используем для каждого инструмента автоматизации браузера: статический каталог с пагинацией, статью, каталог, отрисовываемый JavaScript, JSON API, маршрут с ответом 500, небольшой граф обхода, а также Books to Scrape и Quotes to Scrape. Рендеринг он выполнил аккуратно и без лишней драматургии. Но при этом на моём столе осталась ровно одна незакрытая задача — та же, что остаётся у любого headless-браузерного инструмента. И именно честность по поводу этого пробела сильнее всего отличает полезный обзор от пресс-релиза.
Больше всего меня зацепила не сводка по полноте извлечения, а одна конкретная цифра. На странице, где данные приходят из JSON-endpoint, Puppeteer забрал все 8 записей вообще без парсинга DOM — он вызвал fetch внутри страницы и прочитал объект ответа напрямую. Вместе с нативным рендерингом и рабочими скриншотами это и есть суть инструмента: зрелый Chrome-рендерер, а не краулер-фреймворк, и это различие важно ещё до того, как ты напишешь первую строку кода.
Что такое Puppeteer на самом деле и с кем он конкурирует
Название категории здесь действительно важно, поэтому начнём с него. Puppeteer — это библиотека для автоматизации браузера. Она запускает Chrome, открывает страницы, даёт выполниться JavaScript на странице и возвращает тебе уже отрендеренный результат, который можно читать или сохранять как скриншот. Именно за этим к нему и обращаются вместо HTTP-клиента с HTML-парсером: тебе нужна страница после выполнения скриптов, а не пустая оболочка, которую сервер отдаёт первой.
По своему назначению он конкурирует с другими библиотеками для работы с реальным браузером — Playwright и Selenium — а не с краулер-фреймворками вроде Scrapy и не с инструментами для LLM-Markdown. Если направить Puppeteer на тысячу URL и ожидать, что он сам поставит их в очередь, уберёт дубликаты, аккуратно ограничит скорость и сохранит датасет, ты приносишь рендерер на задачу краулинга. Он прекрасно отрендерит каждую страницу, но не будет управлять обходом. (Это граница ответственности, а не ошибка — к этому я ещё вернусь, потому что именно это нужно понять прежде всего перед использованием инструмента.)
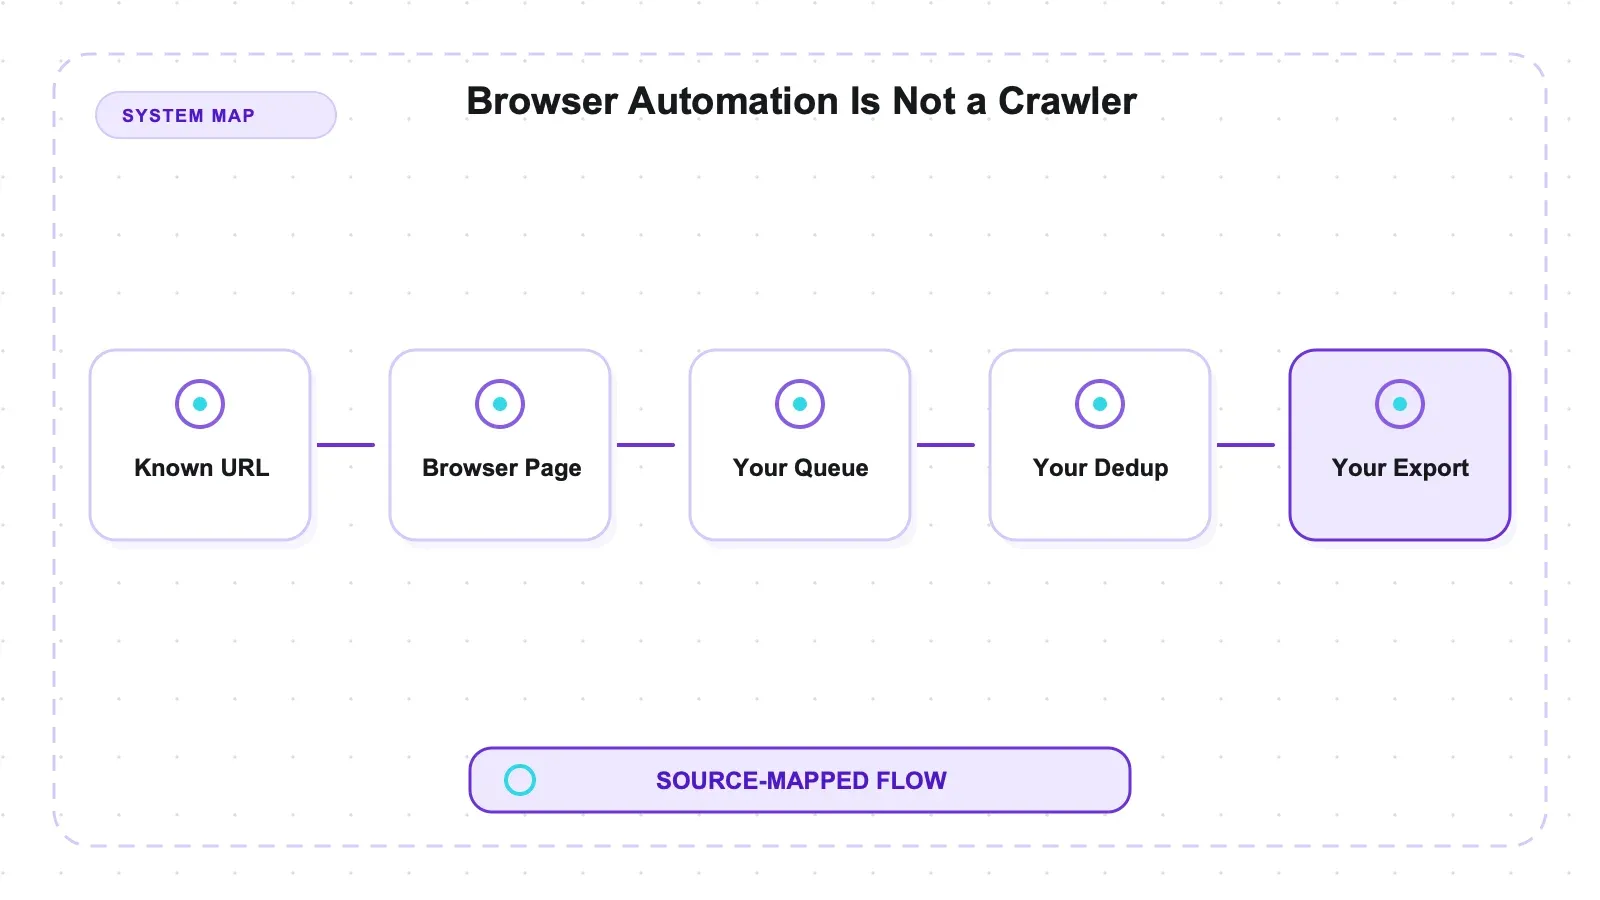
Puppeteer вырос из Chrome-команды Google, поэтому он изначально ориентирован на Chrome и по API ощущается как тонкая, хорошо обкатанная оболочка над протоколом отладки браузера. Инструмент уже достаточно зрелый, чтобы быть «скучным» в хорошем смысле: нужные методы стабильны годами, документация подробная, а экосистема вокруг него очень глубокая.
Нативный рендеринг и паттерн in-page fetch
Из таблицы результатов стоит отдельно вынести два поведения — именно они лучше всего показывают, как инструмент используется на практике.
Во-первых, нативный рендеринг. Каталог на JavaScript — страница, которая собирает сетку товаров на стороне клиента после загрузки — вернул 8/8, а полный скриншот страницы был сохранён на диск. Настройка была минимальной, но предусматривала ожидание нужного контента после goto. Публичная JS-страница Quotes to Scrape таким же способом вернула все десять цитат. Это результаты тестовых фикстур, а не универсальная оценка качества рендеринга.
Во-вторых, фикстура с JSON API загружала товары из /api/dynamic-products. Запуск fetch в том же origin через page.evaluate вернул все восемь записей без парсинга отрисованных строк. Это общий приём работы в браузерном контексте, а не уникальная функция обнаружения данных именно в Puppeteer. Он может заметно упростить извлечение, когда известны endpoint и контракт запроса; но заголовки авторизации, runtime-токены, политика credentials, CORS/CSP, service workers и пагинация всё ещё могут сделать запрос приложения отличным от твоего.
Третий вывод стоит унести дальше не как цифру, а как рамку: Puppeteer — зрелый Chrome-рендерер, а не краулер. Обе части верны, но именно вторую обычно упускают из виду в обзорах.
Как Puppeteer общается с Chrome
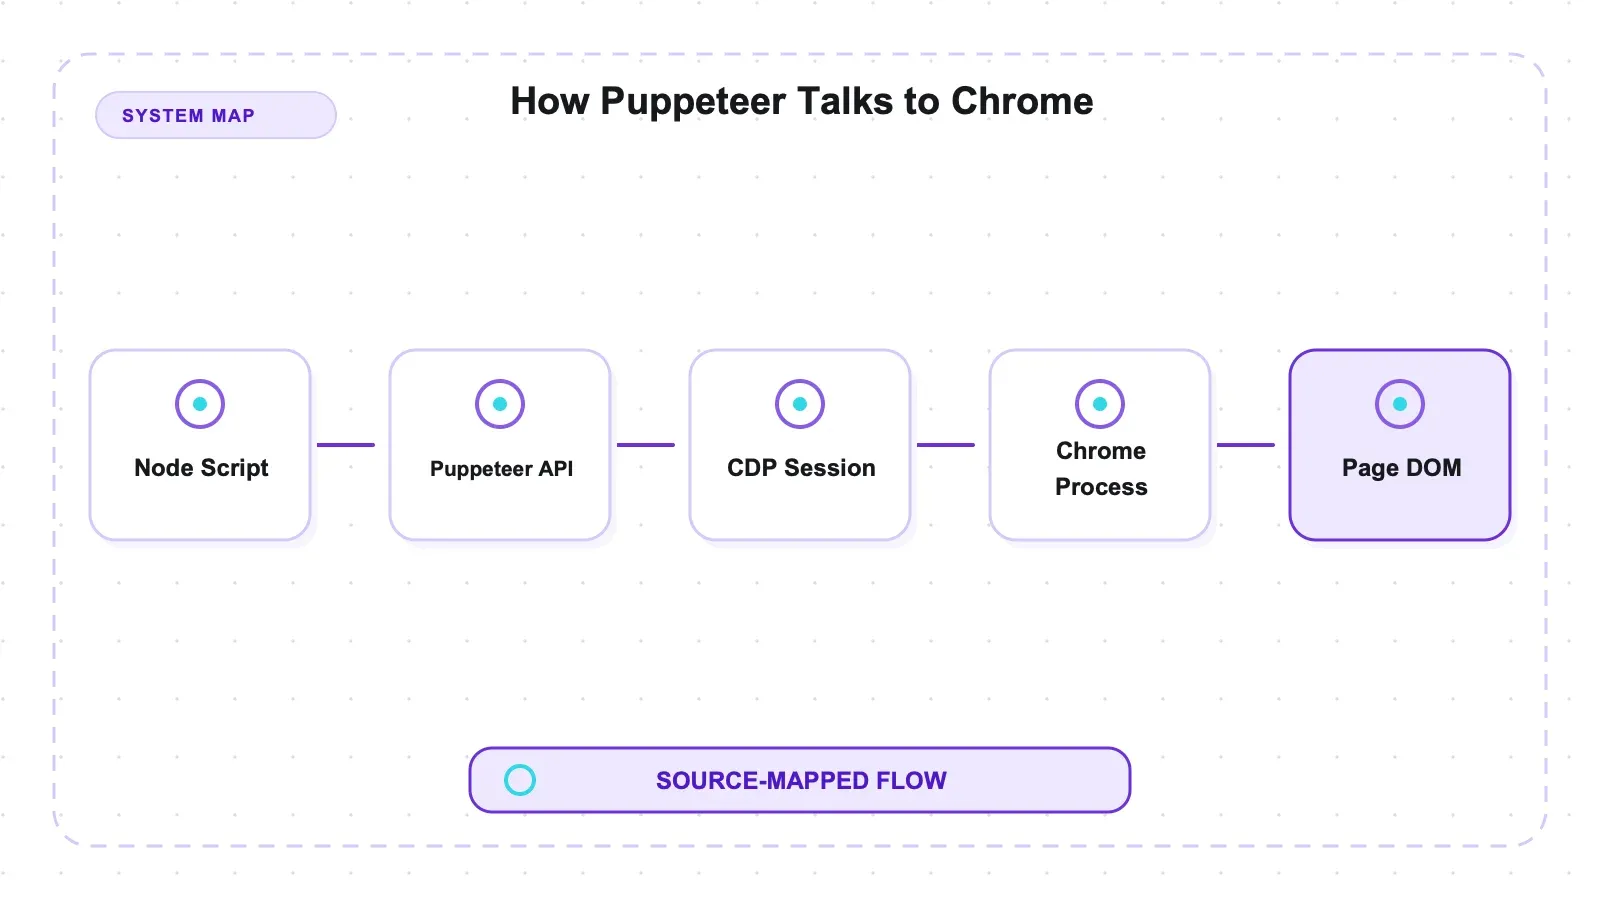
В Chrome Puppeteer использует Chrome DevTools Protocol (CDP) — JSON-поток поверх WebSocket, который применяют браузерные DevTools. puppeteer.launch() запускает Chrome и открывает это соединение; такие вызовы, как goto, $$eval и screenshot, открывают доступ к операциям браузера через более высокий уровень API. Поддержка Firefox идёт по пути WebDriver BiDi, о котором сказано ниже, так что не каждая операция Puppeteer везде является CDP-командой.
page.evaluate выполняет функцию в контексте страницы, поэтому относительный fetch('/api/...') использует origin этой страницы и может переиспользовать подходящие cookies и session state. Но он не воспроизводит автоматически заголовки авторизации, параметры запроса, токены или поведение service worker, созданные приложением. На этой same-origin фикстуре он вернул JSON напрямую; в продакшене контракт реального запроса нужно проверять отдельно.
Именно поэтому Puppeteer тяжёлый. Каждая страница — это настоящая вкладка браузера с полноценным движком рендеринга внутри. Это даёт корректность на JavaScript-насыщенных страницах, но стоит памяти и времени запуска по сравнению с HTTP-only fetch. Бесплатного рендеринга не бывает; CDP лишь делает цену понятной.
Вопрос движка, без обходных формулировок
Есть популярное упрощение, что Puppeteer — это «только Chrome». Для версии, которую я тестировал, это неверно, и исправление этого нюанса меняет сравнение.
| Движок | Как Puppeteer 24.16.0 управляет им | Использовался в этих тестах |
|---|---|---|
| Chrome | Приоритет Chrome через CDP — режим по умолчанию, поэтому существующие автоматизации продолжают работать | да |
| Firefox | Поддержка через WebDriver BiDi документирована начиная с v23 | нет |
| WebKit | Не управляется вовсе | — |
И Chrome for Developers, и Mozilla отдельно писали о поддержке Firefox, когда она появилась. Сборка, которую я запускал, 24.16.0, уже далеко за v23, так что фраза «только Chrome» занижает возможности поставки. Отсутствие WebKit, плюс то, что история кросс-движковой поддержки у Puppeteer моложе, чем у Playwright, — вот реальное ограничение по широте, а не «один движок против трёх».
Путь Firefox/BiDi задокументирован и доступен в версии, которую я тестировал, но мои фикстуры через него не прогонялись, поэтому я сообщаю о возможности, а не о замере. Если поддержка Firefox критична для твоих целей, проверь её на своих страницах, прежде чем принимать решение. Для тех, кому нужен полный head-to-head по движкам и языковому охвату, в нашем сравнении Playwright и Puppeteer оба инструмента проходят те же тесты, и там вопрос «что выбрать» закрывается; здесь речь только о Puppeteer.
Установка и реальность инсталляции: тяжёлая часть — это браузер
Стандартный путь npm install puppeteer скачивает совместимую сборку Chrome for Testing. Это поведение можно отключить или перенаправить через конфигурацию, а сам Puppeteer можно указать на другой исполняемый файл, поэтому совпадение версий зависит от выбранного сценария развёртывания. Самой тяжёлой частью этой установки было именно скачивание браузера; снимок аудита пакетного менеджера не рассматривается как устойчивое свойство безопасности.
Автоматическая поставка браузера — это и реальное удобство, и реальная нагрузка, и стоит назвать обе стороны. Плюс: тебе не нужно искать совместимый браузер или вручную фиксировать версии; npm install сразу даёт рабочую пару. Минус: ты скачиваешь браузер, значит нужно закладывать место на диске и трафик, особенно в CI, где холодный кэш платит эту цену на каждом новом раннере.
Это ещё и заметный контраст с Playwright, где шаги разделены: ты ставишь библиотеку, а затем отдельно запускаешь npx playwright install, чтобы скачать браузерные сборки. Ни один подход не является болезненным; просто они ломаются по-разному. У Puppeteer одна команда может неожиданно удивить размером на платном канале, а у Playwright второй шаг можно просто забыть. Важно понимать, какой сценарий ты запускаешь.
Практические результаты
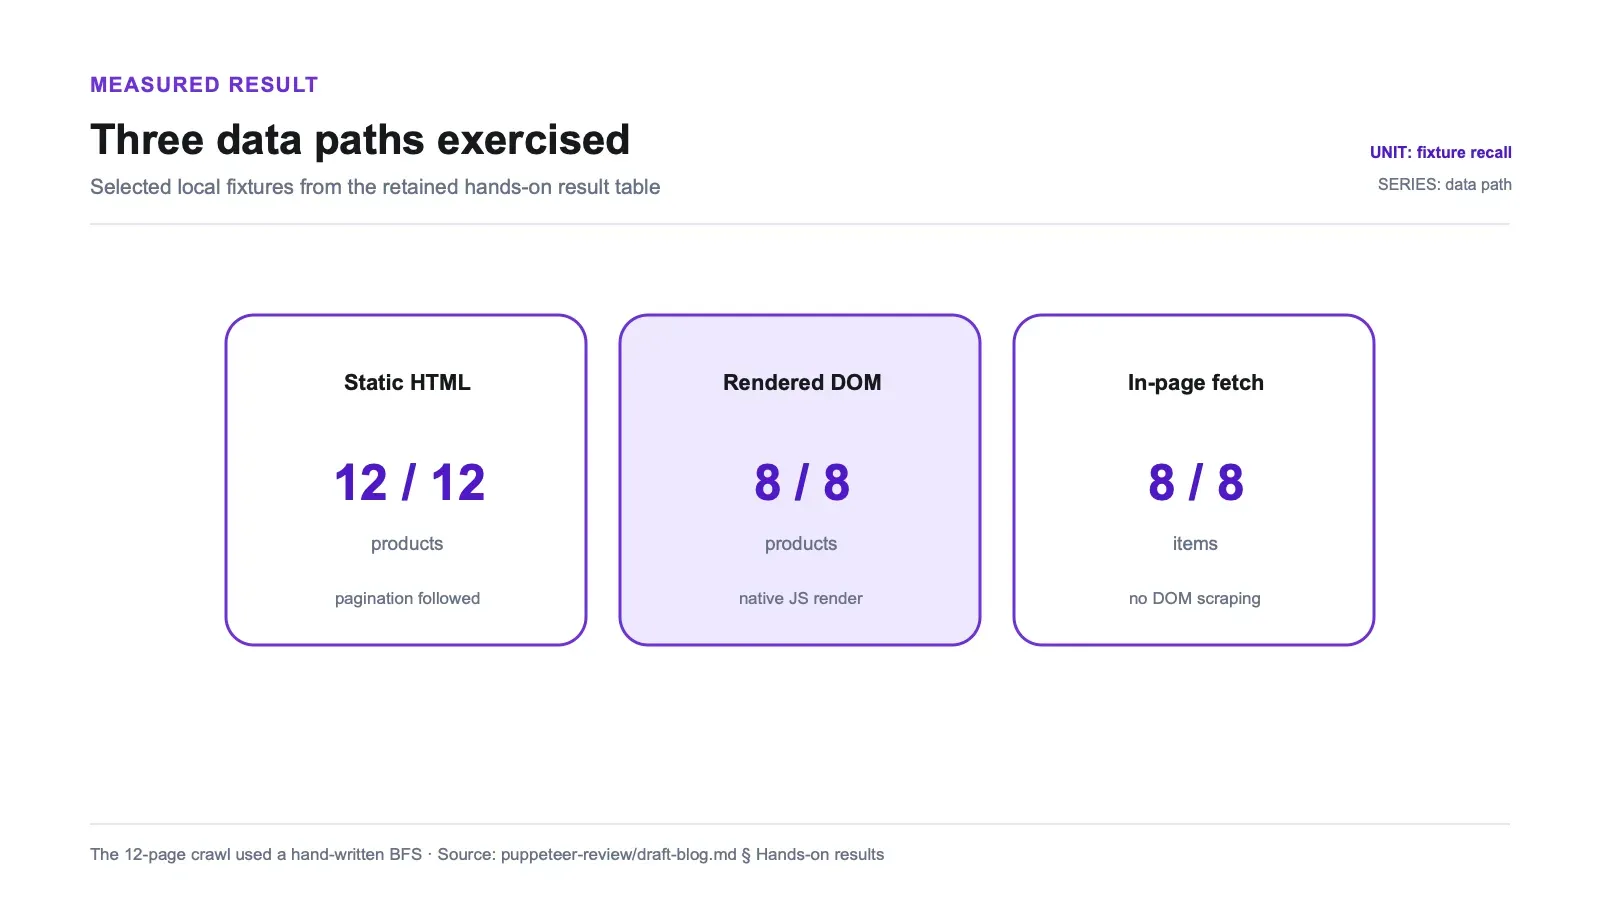
Все тесты выполнялись на локальном fixture-сервере на 127.0.0.1 плюс на двух публичных тренировочных сайтах, в Node v22.22.3, на macOS arm64, с Puppeteer 24.16.0 и встроенным Chrome. Исходные данные для каждой фикстуры были зафиксированы до запуска, поэтому полнота извлечения измеряется относительно заранее определённого ожидаемого набора, а не того, что Puppeteer случайно вывел в консоль.
Публичный исследовательский пакет включает fixture server, test runner и ground truth. Lock-файл зависимостей и сырой сводный отчёт намеренно не вошли в публикационный пакет, потому что строгая security review отклонила данные lock-файла и материалы с endpoint-спецификой окружения. Чтобы воспроизвести безопасную локальную фикстуру, выполни npm install, затем node run_puppeteer_material_tests.mjs внутри tools/puppeteer/tests и сравни результат с опубликованным ground truth. Публичные демо-страницы могут меняться, поэтому локальная фикстура — более стабильная база для проверки ожидаемого количества результатов.
Для точного исторического восстановления зависимостей лучше создать и проверить свежий lock-файл локально, чем считать неопубликованный lock публичным доказательством.
| Тест | Цель | Результат |
|---|---|---|
| Статический каталог + пагинация | локальная фикстура | 12/12, полнота 1.0 |
| Извлечение статьи | локальная фикстура | заголовок + 3/3 абзаца, boilerplate отделён |
| Динамическая JS-страница (нативный рендер) | локальная фикстура | 8/8, полнота 1.0, сохранён полный скриншот |
Динамический JSON API (in-page fetch) | локальная фикстура | 8/8, полнота 1.0, без парсинга DOM |
| Обработка HTTP 500 | локальная фикстура | статус 500 можно проверить, исключение не выбрасывается |
| Граф обхода (ручной BFS) | локальная фикстура | 12 страниц, глубины {0:1, 1:4, 2:7} |
| Books to Scrape | публичное демо | 20 товаров |
| Quotes JS | публичное демо | 10 цитат, отрендерено нативно |
Некоторые пункты заслуживают отдельного пояснения.
Авторский код пагинации восстановил все 12 ожидаемых элементов каталога. Селектор статьи извлёк заголовок и три ожидаемых абзаца; окружающий boilerplate по-прежнему оставался доступен в DOM. Puppeteer предоставил отрендеренный DOM, а вот логика селекторов — не сам Puppeteer — определяла, что считается контентом статьи.
На протестированном маршруте HTTP 500 вызов goto вернул объект ответа с инспектируемым статусом 500 и не выбросил исключение. Это ничего не говорит о таймаутах, DNS-сбоях, крашах браузера, detached frames и других ошибках навигации — их всё равно нужно обрабатывать явно.
Граф обхода лучше всего показывает всю картину. Чтобы пройти внутренние ссылки фикстуры на 12 страниц, отслеживая глубину и не посещая URL повторно, понадобился ручной breadth-first search — потому что у Puppeteer нет встроенной очереди краулинга. Он нашёл все 12 страниц на глубинах {0:1, 1:4, 2:7}, то есть мой BFS сработал. Но BFS был моим. Puppeteer только рендерил каждую страницу; логика обхода сайта была написана мной. Для двенадцати страниц это десяток строк и не проблема. Для тысяч URL с дедупликацией, повторными попытками и задержками в духе вежливого краулинга эти десять строк превращаются в проект.
Одно замечание я повторю, потому что им легко злоупотребить: в артефактах есть per-test timing, но это замеры одного прогона на одной машине, а не бенчмарки. Я не сравниваю скорость Puppeteer с чем-либо ещё на основании одного ноутбука и одного запуска. Эти цифры подтверждают полноту извлечения и поведение на восьми типах страниц — но не заявляют рекорд по таймеру.
Что я не тестировал
Чтобы результаты не читались шире, чем есть, вот что осталось за рамками прогона, а значит и за рамками этих чисел:
| Вне тестового прогона | Статус |
|---|---|
| Firefox через WebDriver BiDi | Документировано, доступно в 24.16.0, но здесь не запускалось |
| Прокси и перехват запросов | Не тестировались; обе функции поддерживаются, но я их не прогонял |
| Масштаб параллельных страниц | Я запускал малый объём; поведение браузерного пула под реальной конкуренцией не измерялось |
| Повторный запуск на последней версии | Я тестировал 24.16.0; на npm latest — 25.3.0, то есть уже на одну major-версию выше, по состоянию на 2026-07-09. API, которые я использовал (launch, goto, $$eval, screenshot, in-page fetch), стабильны в диапазоне 24→25, но честнее будет прогнать всё ещё раз на 25.3.0, прежде чем опираться на точные цифры |
Это не минусы, а границы того, что один прогон фикстур может честно утверждать.
Плюсы и минусы
Плюсы:
- Нативный рендеринг JavaScript с явным ожиданием контента: 8/8 на динамической фикстуре и все десять цитат на публичном демо, плюс скриншоты.
- Авторские селекторы пагинации и статьи извлекли ожидаемые элементы фикстуры.
- In-page
fetchвернул все восемь записей с известного same-origin endpoint без парсинга DOM. - Протестированный HTTP 500 вернулся как инспектируемый ответ без исключения.
- Стандартная установка скачивает совместимую сборку Chrome for Testing; при этом можно указать другой исполняемый файл или пропустить загрузку.
- Зрелый API с фокусом на Chrome поверх CDP, глубокая экосистема и подробная документация. Apache-2.0.
- Шире, чем кажется по репутации: документированная поддержка Firefox через WebDriver BiDi начиная с v23.
Минусы:
- Нет встроенной очереди краулинга, генерации датасета или throttling — для обхода на масштабе нужен свой код или обёртка.
- Нет движка WebKit, а история кросс-движковой поддержки моложе, чем у Playwright.
- Вес реального браузера: нужно скачивать Chrome, плюс есть память на каждую страницу по сравнению с HTTP-only инструментами.
- Основан на Node; если нужен другой язык, придётся строить и поддерживать мост.
- Версия, которую я запускал (24.16.0), отстаёт от npm latest (25.3.0) на major-версию — перед доверием к точным цифрам стоит проверить свежий релиз.
Для кого он подходит, а кому лучше пройти мимо
Puppeteer стоит брать, если ты живёшь в Node, твои цели нормально рендерятся в Chrome (а это большинство случаев) и тебе нужна зрелая, сфокусированная библиотека, которая превращает «страницу после выполнения JavaScript» в нечто, что можно читать и сохранять как скриншот. Для извлечения данных со набора динамических страниц, для доступа к JSON API с использованием сессии самой страницы или для сохранения рендеренных скриншотов в качестве доказательства это очень сильный и спокойный default. Опция Firefox через BiDi есть, если со временем она тебе понадобится, а экосистема означает, что большинство проблем уже кто-то проходил до тебя.
Дважды подумай, если твоя задача — это именно оркестрация краулинга, а не рендеринг. Если тебе нужно обойти сотни или тысячи URL с дедупликацией, повторными попытками и ограничением частоты, одного Puppeteer будет недостаточно — придётся заново собирать краулер вручную, а это не его уровень. Полностью отказывайся от headless-браузера, если твоим страницам вообще не нужен JavaScript для раскрытия данных: когда HTTP-запрос и парсер и так возвращают контент, полноценный браузер — это дорогая избыточность, которая только съедает память и время настройки. И если тебе нужна точность WebKit или клиент не на JavaScript, это просто не тот инструмент.
Альтернативы и где место Thunderbit
Сначала честная рамка: Puppeteer бесплатный, Apache-2.0, self-hosted, и ты отвечаешь за всё — за браузерный флот, за код краулинга, который сверху прикрутишь, и за постоянную гонку вооружений с антибот-защитой. Для многих проектов именно такая модель владения и нужна, и никакой managed-сервис не отрендерит авторизованную страницу дешевле, чем браузер, который у тебя уже есть.
В open source полезно сравнивать инструменты не по бренду, а по задаче. Для задач краулинга на масштабе Crawlee — естественный компаньон: его PuppeteerCrawler оборачивает Puppeteer в request queue, dataset и throttling, которых библиотеке намеренно не хватает, так что ты сохраняешь рендеринг и получаешь оркестрацию. Если твоя цель — чистый Markdown для LLM-пайплайна, а не отрендеренный DOM, Crawl4AI тоже управляет реальным браузером и выдаёт именно такой результат. Если браузер вообще не нужен, HTTP-first фреймворк вроде Scrapy — это уже другая, более лёгкая категория. Если выбираешь сразу между несколькими вариантами, наш обзор open-source scraper-ов раскладывает эти категории рядом.
Managed-сервис вроде Thunderbit выносит операцию браузера и извлечение данных за API. В рамках этих тестов Puppeteer через него не прогонялся, поэтому этот обзор не делает прямых выводов о рендеринге, блокировках, качестве извлечения или стоимости. Граница выбора здесь — операционная ответственность: ты сам поддерживаешь браузер и код обхода или платишь провайдеру за часть этой инфраструктуры.
С Puppeteer нет платы за использование у вендора, но compute, bandwidth, обслуживание браузера, оркестрация и эксплуатация остаются на твоей стороне. Managed-подход, напротив, берёт оплату за использование и переносит часть этой ответственности к поставщику. В этом эксперименте результаты не сравнивались.
Попробовать Thunderbit для извлечения веб-данных
Итог
Puppeteer 24.16.0 стоит рассматривать, если ты работаешь в Node и тебе нужна автоматизация браузера с приоритетом Chrome. Авторские фикстуры извлекли 12 статических элементов, 8 динамических элементов и 10 цитат из публичного демо; известный same-origin API вернул восемь записей через page.evaluate; скриншоты работали; а тестовый HTTP 500 оставался доступным для проверки. Но эти результаты относятся к конкретным фикстурам и к уже не последней major-версии, а не к полноте извлечения вообще.
Однако важно правильно оценивать рамки. Puppeteer — это рендерер, а не краулер: мой обход 12 страниц потребовал ручного BFS, потому что встроенной очереди нет, и на масштабе этот пробел превращается в реальную работу — либо отдай её Crawlee, либо пиши инфраструктуру сам. Он ориентирован на Chrome, с документированной поддержкой Firefox через BiDi, но без WebKit, так что это не инструмент для широкой кросс-движковой совместимости. Он несёт вес настоящего браузера. И я тестировал 24.16.0, тогда как текущая latest-версия — 25.3.0, так что перед тем как доверять точным цифрам, прогони свежую версию ещё раз. Если понимать эти четыре вещи заранее, Puppeteer оказывается отличной библиотекой для автоматизации Chrome. Если ждать от него, что он сам проползёт сайт, ты в итоге напишешь тот краулер, который думал просто скачать.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Часто задаваемые вопросы
Умеет ли Puppeteer рендерить JavaScript-страницы, или нужен плагин?
Он рендерит их нативно, без плагинов. На моей динамической фикстуре он вернул 8 из 8 товаров, собранных на клиенте, с полнотой 1.0 и полностраничным скриншотом, а публичная JS-страница Quotes to Scrape так же вернула все 10 цитат — обычный goto, а потом чтение отрендеренного DOM. Поскольку Puppeteer управляет настоящим Chrome через DevTools Protocol, скрипты страницы реально выполняются до того, как ты что-либо читаешь.
Можно ли в Puppeteer забрать JSON API без парсинга HTML?
Да, если endpoint и контракт запроса это позволяют. page.evaluate может сделать запрос из origin страницы и может переиспользовать подходящие cookies, но он не воспроизводит автоматически заголовки приложения, токены, параметры или поведение service worker. На same-origin фикстуре он вернул все восемь записей без парсинга DOM.
Puppeteer — это веб-краулер? Нет — это библиотека автоматизации браузера, а не краулер-фреймворк. Встроенной очереди запросов, генератора датасетов или throttling нет, поэтому мой обход 12 страниц (глубины {0:1, 1:4, 2:7}) потребовал ручного breadth-first search. Это граница области применения, а не недостаток. Для краулинга на масштабе используй вместе с обёрткой вроде Crawlee PuppeteerCrawler, которая добавляет очередь и датасет-логику, отсутствующую в самом Puppeteer.
Puppeteer — это только Chrome? Уже нет. Он по-прежнему ориентирован на Chrome через CDP, но начиная с v23 у него есть документированная поддержка Firefox через WebDriver BiDi, и версия, которую я тестировал (24.16.0), уже значительно новее. Чего он не управляет — так это WebKit, а его история кросс-движковой поддержки моложе, чем у Playwright; именно это, а не «только Chrome», и есть точное ограничение. Здесь я использовал только Chrome, поэтому поддержку Firefox через BiDi описываю как задокументированную возможность, а не как измеренный результат.
Что именно скачивается при установке Puppeteer?
По умолчанию npm install puppeteer скачивает совместимую сборку Chrome for Testing. Загрузку можно пропустить или перенаправить, а также указать другой исполняемый файл, поэтому соответствие версий зависит от сценария развёртывания. Закладывай место на диске и трафик под браузер, особенно на CI-раннерах без кэша. В этом обзоре тестировалась версия 24.16.0; перед публикацией стоит ещё раз прогнать основные фикстуры на актуальном релизе.




