
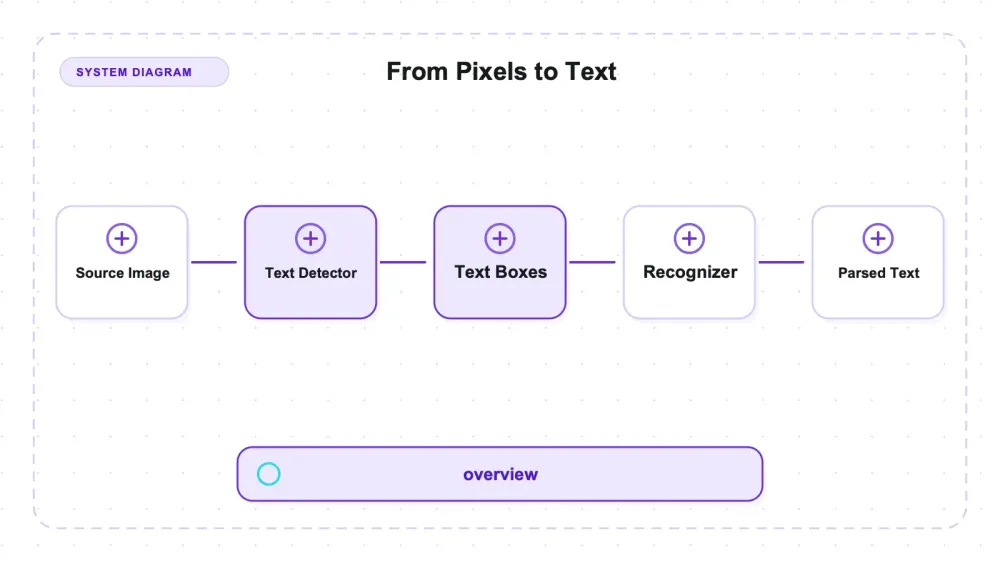
EasyOCR — это готовая к работе OCR-библиотека JaidedAI для Python: pip install easyocr, две строки кода — и текст, встроенный в изображение, возвращается в виде строк. Библиотека распространяется под лицензией Apache-2.0, заявляет поддержку 80+ языков и работает как конвейер из двух моделей PyTorch: детектор CRAFT обводит рамками всё, что считает текстом, а распознаватель читает символы внутри каждого блока. Предобученные веса скачиваются автоматически при первом запуске. По сути это self-hosted альтернатива Tesseract и PaddleOCR, а не облачный OCR API с оплатой за страницу.
Базовый API очень короткий: Reader(['en']), затем readtext(). Но деплой оказывается куда тяжелее — около 2 ГБ PyTorch в этой среде и примерно 1 ГБ пикового resident memory у свежего процесса. Я отрендерил 36 английских PNG-файлов, прогнал easyocr 1.7.2 на CPU и оценивал результат посимвольно по сравнению с сгенерированным эталоном. Наибольшие провалы CER были связаны с размером текста и ориентацией; дашборд также показал проблемы с короткими токенами и распознаванием знака доллара.
Самый показательный из этих сбоев связан с параметром, который советуют чаще всего. У rotation_info на issue tracker репутация главного решения для повернутых изображений, поэтому я дал ему три копии одной и той же фразы, повернутые по ортогональным осям. При 270° он сработал именно так, как обещано: character error rate упал с 0.83 до 0.10. При 180° он сработал лишь частично: 0.85 до 0.67, при этом фраза частично пропала. При 90° стало хуже: 0.81 до 0.92, а распознаватель начал выдавать зеркальный текст. Один и тот же параметр, один и тот же список углов, три разных результата — так что включение этой опции не означает, что «поворот теперь обработан». На тех же 36 файлах также проявился жесткий порог по размеру шрифта, систематическая ошибка в распознавании $ и одно мое предсказание, которое оказалось полностью неверным.
Две модели под одним пальто
EasyOCR — это не одна модель. Это конвейер из двух, и понимание того, на каком этапе произошел сбой, меняет способ отладки.
Первый этап — CRAFT, то есть детектор. Его задача — только локализация: определить, где на изображении вообще есть текст, и вернуть рамки. Он не читает ни одного символа. Второй этап — CRNN recognizer: извлечение признаков ResNet, затем BiLSTM, затем жадное декодирование CTC — именно он читает символы внутри каждой рамки. Обе части работают на PyTorch. На CPU распознаватель по умолчанию запускается с динамической int8-квантованием, поэтому он быстрее и легче, чем подсказывает голый размер параметров.
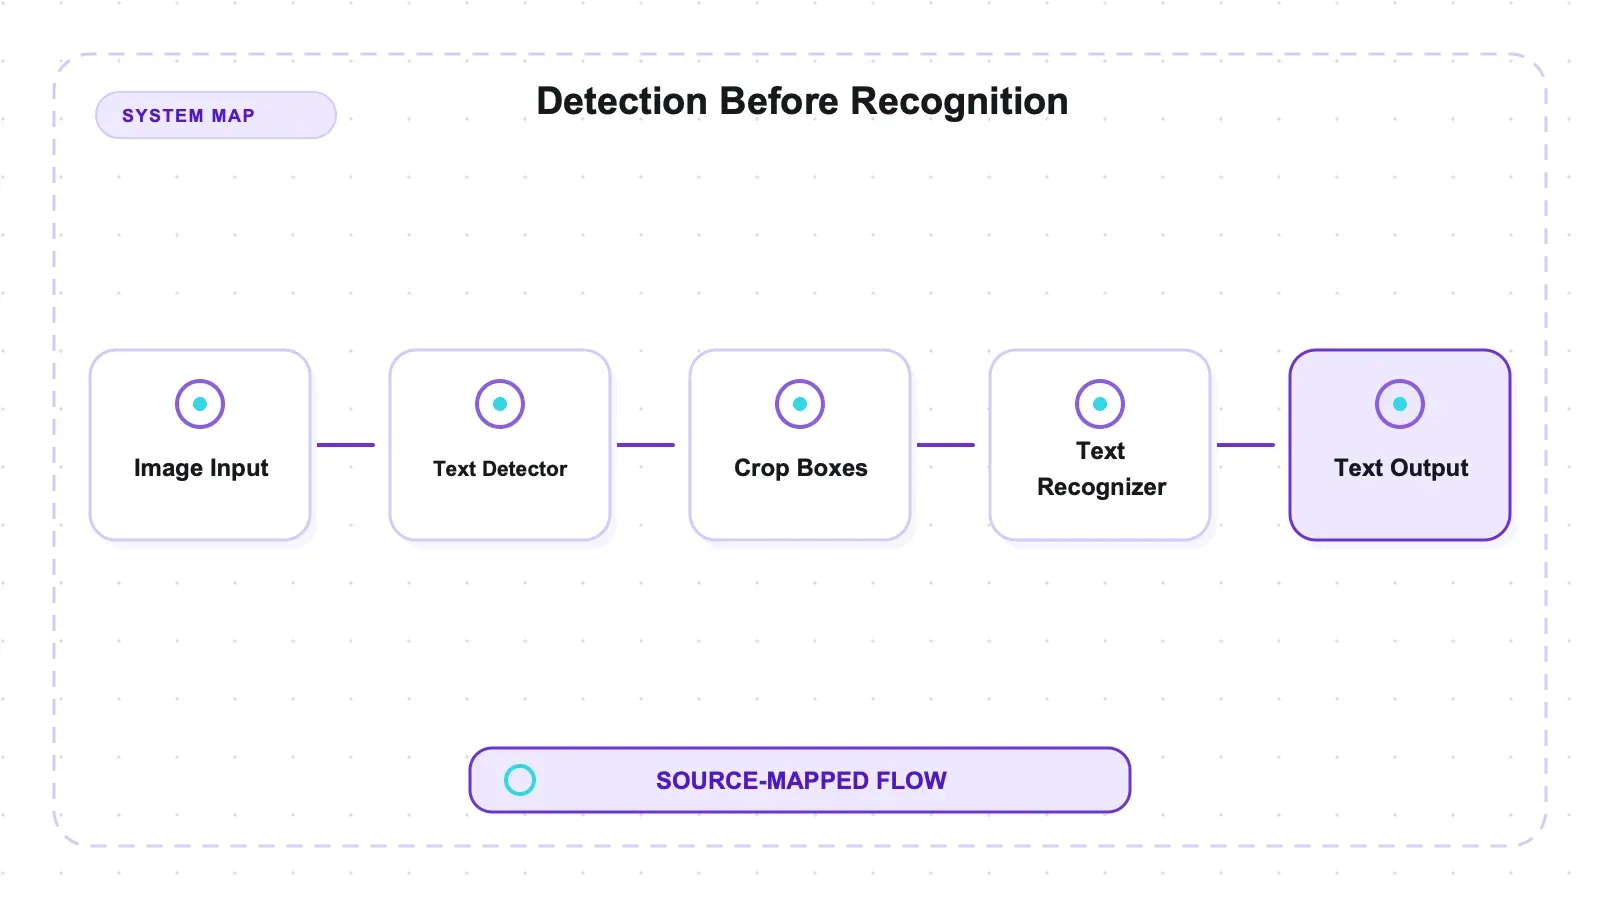
Практический вывод такой: у EasyOCR есть два совершенно разных режима отказа, и лечатся они по-разному. Если детектор вообще не нарисовал рамку, никакая настройка распознавателя не поможет — символы просто не попали в конвейер. Если рамка есть, но строка распознана неверно, это уже проблема recognition, и тут может помочь препроцессинг. Почти в каждом треде вида «EasyOCR пропустил мой текст», который я видел, эти два случая смешивают.
Текущее состояние проекта, проверено 27 июля 2026 года: 29 825 звезд, 528 открытых issues, Apache-2.0 и v1.7.2 от сентября 2024 года, а последняя отправка в master была в декабре 2025-го. Эти даты не доказывают ни архитектурной стабильности, ни здоровья поддержки. Перед внедрением проверьте совместимость с вашим Python/PyTorch-стеком, актуальность реакции мейнтейнеров и issues, относящихся к вашим входным данным.
OCR часто ассоциируют с обходом CAPTCHA, но в этом обзоре речь не о таком сценарии. Ничего не тестировалось на обходе антибот-защиты, и этот материал ничего подобного не одобряет. Здесь задача — читать текст из изображений и скриншотов, которые вам разрешено читать.
Что я измерял, и чего эти цифры не показывают
Набор тестов — это 36 PNG, которые я сгенерировал сам: 35 однострочных изображений, покрывающих семь шрифтов, восемь размеров, семь уровней контраста, семь углов наклона, три ортогональных поворота и три фона, плюс один синтетический скриншот дашборда с 19 отдельно размеченными элементами. Каждое изображение было построено из одной и той же строки (Sphinx of black quartz, judge my vow. 1234567890 — 48 символов, смешанный регистр, цифры, пунктуация) в том же проходе, где записывалась эталонная разметка, так что картинка и подпись физически не могут «разъехаться».
Точность измерялась через character error rate (CER): расстояние Левенштейна по символам, деленное на длину эталона. CER 0 означает идеальное чтение. CER 0.10 означает, что примерно каждый десятый символ ошибочен. В заголовке я привожу CER с учетом регистра, а рядом — без учета регистра, потому что выяснилось, что большая часть «ошибки» сидит именно в регистре.
Границы важнее чисел:
- Только английский. Распознаватель
english_g2. EasyOCR заявляет 80+ языков; я тестировал один. Это ничего не говорит о нелатинских письменностях, а именно там обычно и живут академические сравнения OCR. - Только синтетика. Отрисованный текст, не фотографии. Никакого шума камеры, JPEG-артефактов, освещения или перспективы.
- Без рукописного текста. Сам проект прямо указывает, что handwriting пока не поддерживается.
- Только CPU. macOS arm64,
gpu=False. На машине был доступен MPS, но EasyOCR использует CPU на всем, что не CUDA. Производительность GPU не измерялась, поэтому здесь нет ни одного GPU-числа. - Одна машина, одна версия. easyocr 1.7.2, torch 2.13.0, Python 3.12.
Итого: это контролируемые кривые с одной переменной, которые показывают, где именно начинает ломаться качество на чистом отрисованном латинском тексте. Это не реальный производственный бенчмарк и не замена ему.
Проверить это можно не только по моим словам: генератор фикстур и точные строки лежат в tests/build_fixtures.py и tests/fixtures/ground_truth.json; распознавание, тайминг и сбор ресурсов — в tests/run_easyocr.py; а tests/metrics.py считает итоговые error rate из сырого вывода. Получившиеся записи распознавания и агрегированные метрики сохранены в artifacts/raw/. Повторный запуск полезен, чтобы проверить эту конкретную машину и версию. Но он всё равно не отвечает на вопрос, как EasyOCR поведет себя на фото с телефона, других языках, макетах или в вашем собственном пайплайне препроцессинга — для production-решения нужны репрезентативные входы, а не эти фикстуры как сертификат.
Одна ловушка в harness почти привела к неверному заголовочному числу. В первом проходе метрик я получил CER 0.375 на чистом черном Arial — ужасный результат для самого простого входа. Но проблема была не в EasyOCR. Детектор разделил одну визуальную строку на рамку со словами и рамку с цифрами, а мой наивный merge «сортировать по y, потом по x» ставил цифры впереди. После исправления на line-aware grouping (группировка рамок по вертикальному перекрытию с последующим чтением слева направо) чистые шрифты стали давать примерно 0.04–0.10. Если вы строите собственную оценку OCR, эта ловушка поджидает и вас.
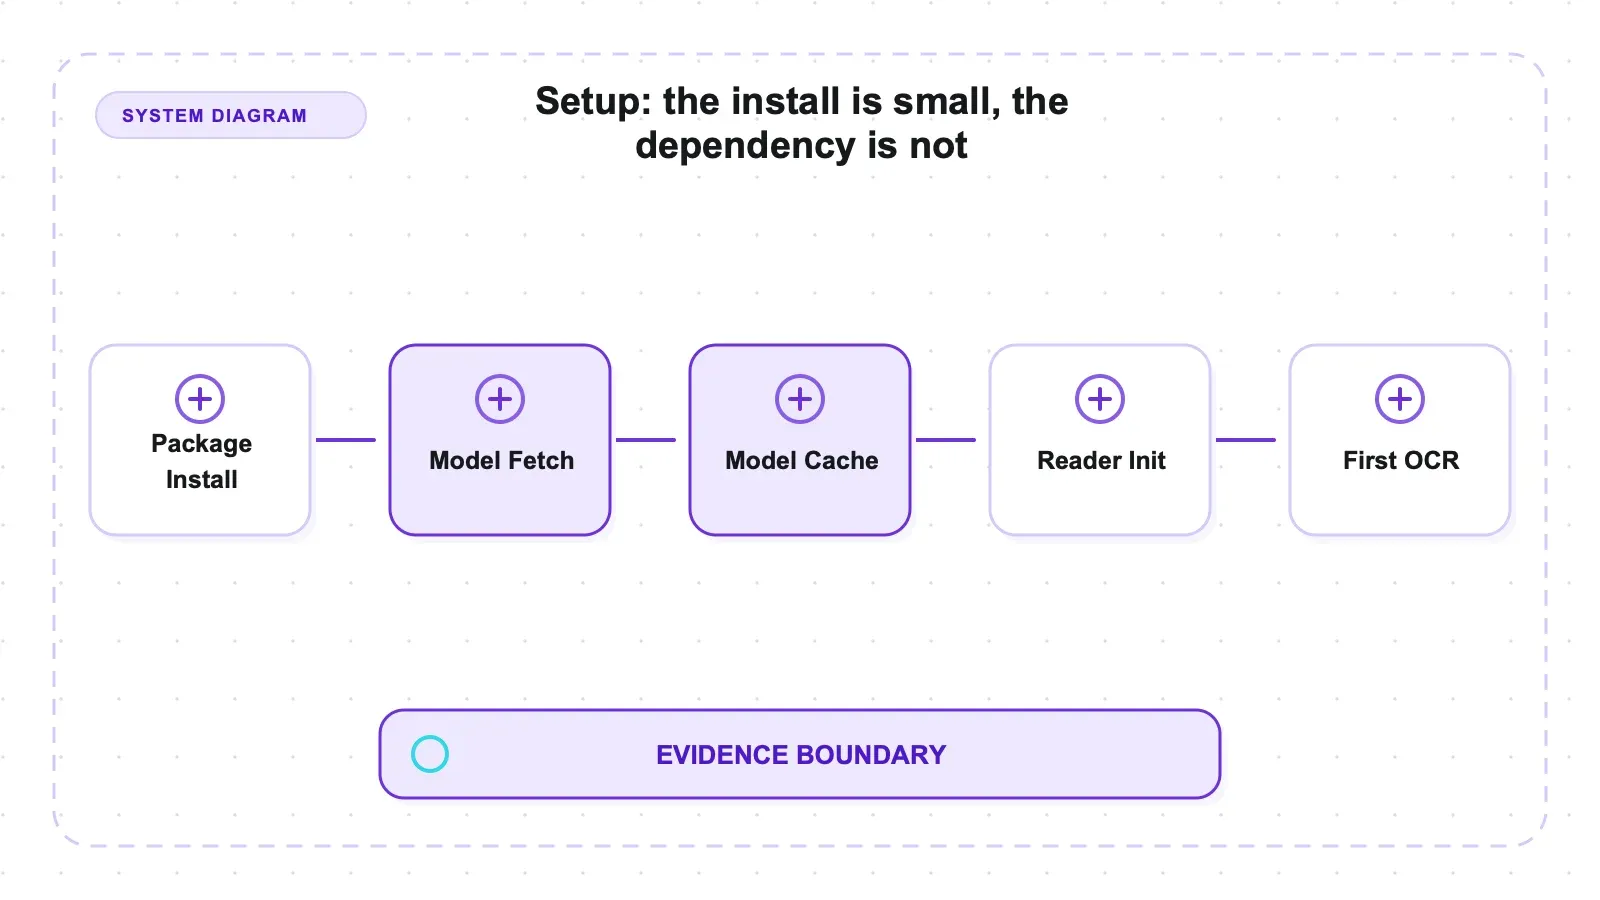
Установка: пакет небольшой, зависимость — нет
pip install easyocr
Вот и всё. Но это честно только наполовину. Сам пакет действительно крошечный, а вот что он тянет за собой — это PyTorch, примерно 2 ГБ. Затем при первом вызове readtext() EasyOCR незаметно скачивает веса в ~/.EasyOCR/model/ — 93.7 MiB всего, из них 79.30 MiB на детектор CRAFT (craft_mlt_25k.pth) и 14.44 MiB на английский распознаватель (english_g2.pth).
В учебниках об этом обычно не предупреждают, так что: при первом запуске нужен доступ в сеть, а каждый контейнерный деплой либо встраивает эти веса в образ, либо платит за скачивание на cold start. После кэширования всё работает офлайн.
Холодная инициализация Reader() — загрузка моделей с диска в RAM плюс проход динамической квантования int8 — занимала 1.3–1.7 секунды в разных запусках. После этого:
import easyocr
reader = easyocr.Reader(['en'], gpu=False)
result = reader.readtext('screenshot.png')
И всё работает. Две строки, ничего настраивать не нужно, не нужно искать checkpoint. Название «easy» на этом этапе вполне оправдано — вся боль сидит в весе зависимостей, а не в API.
Порог на чистом тексте: почти идеальные символы, но с ошибками в регистре
Семь системных шрифтов, черный текст на белом фоне, 32 px, одна и та же строка каждый раз:
| Шрифт | CER (с учетом регистра) | CER (без учета регистра) |
|---|---|---|
| Georgia | 0.0625 | 0.0000 |
| Times | 0.0417 | 0.0417 |
| Comic Sans | 0.0417 | 0.0208 |
| Arial | 0.0833 | 0.0208 |
| Verdana | 0.0833 | 0.0208 |
| Impact | 0.0833 | 0.0208 |
| Courier | 0.1042 | 0.0417 |
| Среднее | 0.0714 | 0.0238 |
Средний CER — 0.071, а если нормализовать регистр, то падает до 0.024. Это и есть главный вывод. EasyOCR не теряет символы на чистом латинском тексте — он правильно угадывает форму, но ошибается в регистре.
В частности, слово vow в нижнем регистре он в шести из семи шрифтов превращает в VOW (Comic Sans компромиссно дает Vow). Impact в придачу меняет of на Of. Еще одна повторяющаяся ошибка — пунктуация: финальная точка в конце предложения в нескольких шрифтах возвращается как : или _. Georgia дает идеальное чтение, если не обращать внимания на регистр.
Это действительно полезно понимать. Если дальше у вас fuzzy matching, поиск по ключевым словам или подача текста в LLM, смена регистра почти ничего не стоит. Если же следующий шаг — точное сравнение строки с ключом в базе, то это уже ломает всё. Нормализуйте регистр до сравнения, и половина кажущейся ошибки EasyOCR исчезает.
Courier оказался худшим (0.1042) тоже неслучайно: моноширинные шрифты делают интервалы между символами неестественно широкими, а CTC-декодеру, который обучался на типичном межсимвольном расстоянии, это тяжелее.
Резкий порог по размеру совпадает ровно с тем, что написано в документации
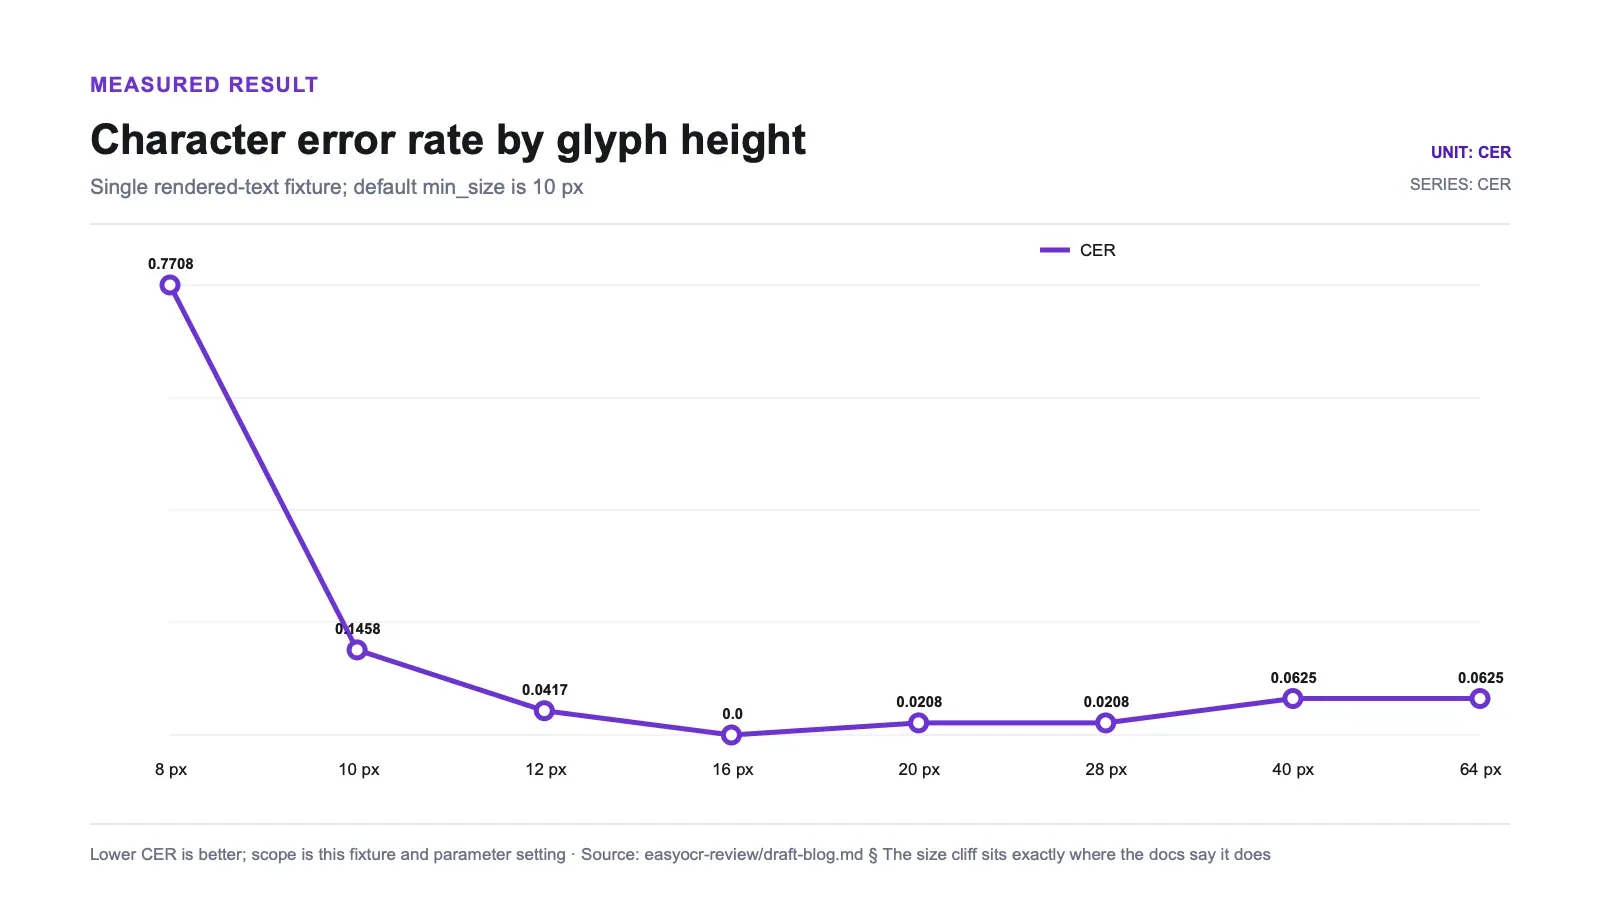
У readtext() есть документированный параметр min_size=10, который отбрасывает рамки высотой менее 10 пикселей. Большинство просто пролистывает его. А зря — это, пожалуй, самое важное число в API для тех, кто извлекает данные из скриншотов или PDF. Вот что происходит при изменении высоты символов:
| Отрисованная высота, px | CER | Что произошло |
|---|---|---|
| 8 | 0.7708 | Обвал — рамки попали ниже фильтра min_size и были отброшены; сохранились только фрагменты |
| 10 | 0.1458 | Деградация — прямо на пороге детектор разбил строку на 3 рамки |
| 12 | 0.0417 | Восстановление |
| 16 | 0.0000 | Идеальное чтение |
| 20 | 0.0208 | Чисто |
| 28 | 0.0208 | Чисто |
| 40 | 0.0625 | Чисто (снова проявляется ошибка регистра) |
| 64 | 0.0625 | Чисто (ошибка регистра) |
Прыжок с 0.04 до 0.77 между 12 px и 8 px — это не плавное ухудшение. Это фильтр, который делает именно то, что у него написано в документации, и в результате текст ниже примерно 10 px для стандартного EasyOCR фактически становится невидимым.
Оптимальная зона — 12–28 px, а полный CER 0 достигается при 16 px. Выше 40 px CER немного растет — не потому, что символы теряются, а потому, что возвращается замена vow → VOW. Большой текст не сложнее читать; он просто уже не получает выгоду от того межсимвольного расстояния, при котором 16 px срабатывали идеально.
Если вы извлекаете текст из скриншотов, сначала проверьте высоту символов, а уже потом обвиняйте модель. Дашборд, снятый в 1× на HiDPI-дисплее, или PDF-страница, растеризованная в 72 DPI, очень часто опускают основной текст ниже 10 px. Сделайте захват в 2× или увеличьте изображение перед OCR — и вы сразу избежите целого класса жалоб «EasyOCR проигнорировал половину страницы». Если это невозможно, уменьшайте min_size, но ожидайте шум, потому что сам фильтр существует именно для подавления мусорных детекций.
Поворот: 10° терпимости и несимметричное решение
Сначала — наклон. Малые углы, Arial 32 px, стандартные настройки против rotation_info=[90,180,270]:
| Угол наклона | CER (по умолчанию) | CER (с rotation_info) |
|---|---|---|
| 0° | 0.0833 | 0.0833 |
| 5° | 0.0417 | 0.0417 |
| 10° | 0.0208 | 0.0833 |
| 15° | 0.2917 | 0.3750 |
| 20° | 0.7500 | 0.7708 |
| 30° | 0.8958 | 0.8750 |
| 45° | 0.8958 | 0.8750 |
Стандартный EasyOCR спокойно переваривает наклон примерно до 10° (CER ≤ 0.083), начинает шататься на 15° и разваливается уже к 20°. rotation_info не помогает при наклоне, и это логично: он просто повторяет попытку на углах из списка, а 15° — это не 90, 180 или 270. При 10° он даже немного ухудшил результат (0.021 → 0.083), потому что неверный повтор может выиграть по confidence.
А вот ортогональные повороты ведут себя странно:
| Поворот | CER (по умолчанию) | CER (с rotation_info) | Восстановилось? |
|---|---|---|---|
| 90° | 0.8125 | 0.9167 | Нет — стало хуже |
| 180° | 0.8542 | 0.6667 | Частично |
| 270° | 0.8333 | 0.1042 | Да |
Один и тот же параметр. Один и тот же список углов. Три разных результата.
При 270° rotation_info делает ровно то, что обещает issue thread: CER падает с 0.83 до 0.10, и чтение становится реально пригодным. При 180° он работает лишь наполовину — CER улучшается до 0.67, но фраза my vow. полностью выпадает. При 90° становится хуже: с 0.81 до 0.92, и сырой вывод объясняет почему: распознаватель возвращает зеркальные строки. VOW превращается в MOA. quartz становится zuuenb. Если прочитать это в зеркале, оно корректно — забавный фокус, но бесполезный для пайплайна данных.
Я сверялся с сырыми предсказаниями, а не только с агрегированными метриками, потому что первой гипотезой было «у меня сломался порядок объединения». Но нет — именно так EasyOCR и вернул результат.
Механизм здесь — гипотеза, а не измерение; эксперимент с конвенцией поворота не проводился. Pillow рисует положительные углы против часовой стрелки, так что только изображение, отрендеренное под 270°, случайно совпадает с ориентацией повторной попытки, которую распознаватель обрабатывает хорошо, а в случае 90° лучшая по confidence повторная попытка попадает в перевернутую ориентацию. Как бы там ни было, практический вывод от этого не зависит:
Эта фикстура показывает, что rotation_info нельзя считать симметрично работающим для разных ориентаций. Проверяйте именно те повороты, которые бывают в ваших входных данных; нормализация ориентации до вызова — возможная мера, а не обязательное требование, доказанное тремя отрендеренными примерами.
Предсказание, в котором я ошибся
Изначально я ожидал, что слабый контраст станет ахиллесовой пятой EasyOCR. Бледно-серый текст на белом фоне — классический сценарий OCR-ошибок, и для него даже есть описанный способ спасения: contrast_ths=0.1 с adjust_contrast=0.5, который заново прогоняет низкоконтрастные блоки через усиленную копию и оставляет более уверенный результат.
Но этот механизм ни разу не включился — просто потому, что в нем не было необходимости.
| Серый цвет текста | Контраст Вебера | CER (по умолчанию) | CER (adjust_contrast=1.0) |
|---|---|---|---|
| 0 (черный) | 1.000 | 0.0833 | 0.0833 |
| 64 | 0.749 | 0.0833 | 0.0833 |
| 110 | 0.569 | 0.0833 | 0.0833 |
| 150 | 0.412 | 0.1042 | 0.1042 |
| 180 | 0.294 | 0.0625 | 0.0625 |
| 200 | 0.216 | 0.0417 | 0.0417 |
| 220 | 0.137 | 0.0417 | 0.0417 |
CER ни разу не выходит из «чистой» зоны, вплоть до Weber 0.14 — серый 220 на белом, настолько бледный, что мне пришлось прищуриться, чтобы убедиться, что текст вообще есть. И колонка с усилением контраста везде идентична колонке по умолчанию, потому что по умолчанию всё уже и так сработало.
Фоны показали ту же картину. Черный текст везде:
| Фон | CER |
|---|---|
| Однотонная светло-синяя панель | 0.083 |
| Вертикальный градиент | 0.021 |
| Гауссов шум (μ200, σ22) | 0.000 |
Идеальное чтение на самой шумной фикстуре из набора.
Но область применения здесь узкая: это низкий контраст на однотонном фоне без шума, а не сфотографированный чек с шумом сенсора и JPEG-сжатием. В этом наборе сильнее всего ломали систему геометрия и короткие токены; протестированные варианты по цвету и синтетическому шуму — нет.
Реальный сценарий: вытаскиваем числа из скриншота дашборда
Именно так обычно выглядит основная масса OCR-задач в Python. Кто-то присылает скриншот внутреннего дашборда, или вы строите Python scraping pipeline для аналитической страницы с графиками, где числа существуют только как отрисованные пиксели, и вам нужны значения как данные.
Я отрендерил окно «Sales Dashboard» — темный хедер с заголовком и круглым бейджем-аватаром, три KPI-панели, три кнопки, таблицу 2×3 — и разметил все 19 текстовых элементов их точными строками и пиксельными рамками, после чего сопоставил вывод EasyOCR с этими объектами по пересечению рамок.
Recall детекции: 16 из 19. Три пропуска:
- однобуквенный бейдж «A»
- ячейка таблицы «Q1»
- ячейка таблицы «Q2»
А вот «Q3» детектировался. Один и тот же шрифт, один и тот же размер, один и тот же столбец — детектор оставил один двухсимвольный токен и пропустил два других. Детекция в визуально очень похожих ячейках была непоследовательной. Поскольку в этих прогонах результаты были детерминированными, это не похоже на случайный эффект «подброса монетки». Схожая проблема качества скриншотов обсуждается в #460.
На тех 16 элементах, которые он все-таки нашел, текст был почти идеальным: средний CER 0.027, при этом 13 из 16 были распознаны без ошибок. Заголовки, подписи, кнопки («Save», «Cancel», «Export CSV»), заголовки столбцов и числа с запятыми возвращались с CER 0. 1,284 было распознано правильно, включая запятую.
Три неточных результата — это одна и та же ошибка. Суммы в долларах:
| Эталон | EasyOCR прочитал |
|---|---|
$57,912 | S57,912 |
$18,330 | S18,330 |
$25,178 | S25,178 |
$12,004 | $12,004 (верно) |
Три из четырех знаков доллара превратились в заглавную S. Визуально это можно понять, но для извлечения данных это означает, что каждое валютное поле находится в одном символе от мусора, а наивный float() на этом упадет.
Если в вашем screenshot-пайплайне есть короткие подписи или валюты, проверьте возможные меры: увеличение масштаба, padding у crop, ограничения по ожидаемому формату поля или постобработку с учетом символов. Здесь ничего из этого не бенчмаркалось, и regex, который заменяет начальную S, может испортить корректные значения. Исправления применяйте только там, где это безопасно по схеме и правилам валидации.
Сколько стоит запуск
Цифры на той же машине (macOS arm64, CPU, один хост, измерение под возможной параллельной нагрузкой — воспринимайте это как форму, а не как универсальный бенчмарк):
| Метрика | Значение |
|---|---|
| Веса модели на диске | 93.7 MiB (79.30 детектор + 14.44 распознаватель) |
| Пиковый resident memory, свежий CPU-процесс | 984.5 MiB |
Холодная инициализация Reader() | 1.3–1.7 с |
| Теплая задержка, одна чистая строка из 48 символов (p50) | ~0.062 с (p25–p75: 0.059–0.067 с, n=20) |
detail=0 против detail=1 | почти одинаково (0.062 против 0.063 с по медиане) |
Главная цена здесь не в 94 МБ весов, а в примерно 1 ГБ resident memory на каждый worker-процесс поверх примерно 2 ГБ установки torch. Именно это решает, влезет ли всё в контейнер, и именно это обычно никто не озвучивает.
Скорость на простом кейсе нормальная. Warm-режим ниже 0.1 с для чистой однострочной строки на CPU — это вполне рабочий сценарий. Но это и есть простой кейс: одна короткая высококонтрастная строка. Жалобы вида "EasyOCR takes tens of seconds on CPU" относятся к большим многообластным документам в полном размере canvas, и я этого не воспроизводил — это другой workload, и я просто ссылаюсь на него, а не утверждаю, что повторил.
Небольшой миф, который стоит развеять: detail=0 не ускоряет EasyOCR. Он просто убирает из результата рамки и confidence-score. Вычисления уже выполнены. Разница в медиане — около миллисекунды, то есть шум.
Плюсы и минусы
Плюсы
- Распознавание символов на чистом отрисованном латинском тексте практически идеальное — средний CER 0.071 с учетом регистра и 0.024 без учета, а полный CER 0 достигается уже при 16 px.
- По-настоящему двухстрочный API.
Reader(['en']), затемreadtext(), без настройки и выбора моделей. - Намного устойчивее к низкому контрасту, чем принято думать: на чистом тексте не было обвала даже при Weber 0.14, а шумный/градиентный/цветной фон не ухудшал результат (файл с гауссовым шумом был прочитан идеально).
- Почти идеален на элементах скриншота, которые удалось детектировать: средний CER 0.027, 13 из 16 без ошибок, включая числа с запятыми.
- Детерминированность. Все численные результаты здесь были байт-в-байт одинаковыми в двух независимых прогонах процесса; менялось только время.
- Apache-2.0 и self-hosted, без платы за использование у вендора; расходы — это вычисления, память, хранение и очереди.
Минусы
- Жесткий провал ниже документированного порога
min_size=10— CER 0.77 при 8 px. Мелкий UI-текст по умолчанию просто не виден. - Устойчивость к наклону заканчивается примерно на 10° и рушится к 20°.
rotation_info— несимметричное решение: 270° восстанавливается, 180° — частично, а 90° становится хуже и возвращает зеркальный текст.- Детектор теряет изолированные короткие токены — однобуквенный бейдж и две ячейки по 2 символа, хотя соседние блоки остаются.
- Систематическая ошибка
$→Sна валютных значениях (3 из 4). - Около 1 ГБ resident memory на процесс плюс зависимость torch примерно на 2 ГБ.
- Последний релиз — сентября 2024 года; проект скорее стабилен, чем активно развивается.
Кому стоит использовать, а кому лучше отказаться
Проверяйте EasyOCR, если ваши входы — это чистый, ровный, отрисованный текст разумного размера: скриншоты, UI-кадры, растеризованные PDF или сгенерированные отчеты, и вам нужен self-hosted Python-пайплайн без платы за использование у вендора. Результаты на синтетическом английском CPU относятся именно к этому сценарию; фотографии, рукописный текст и другие письменности требуют отдельного тестирования.
Лучше отказаться, если ваши входы описываются чем-то из этого. Фотографии — мои числа относятся к синтетическому отрисованному тексту и ничего не говорят о шуме камеры, перспективе или освещении. Рукописный текст — сам проект этого не обещает. Нелатинские письменности — EasyOCR поддерживает 80+ языков, но я тестировал один, а академические сравнения здесь важнее синтетического английского sweep. Как угодно повернутые входы — если только вы не делаете собственную нормализацию ориентации заранее. Деплой с жестким ограничением памяти — гигабайт на worker быстро превращается в проблему.
Перед выбором OCR сначала посмотрите на DOM и сетевые ответы. Если нужные значения уже существуют как структурированный текст, извлечение из исходника избавляет вас от ошибок детекции и распознавания OCR. OCR нужен там, где единственное доступное представление — пиксели.
Альтернативы и место нашего стека
EasyOCR — Apache-2.0 и self-hosted, без платы за использование у вендора, но с реальной стоимостью вычислений и эксплуатации. PaddleOCR, Tesseract и vision-language-модели через этот бенчмарк не прогонялись, поэтому сравнения лоб-в-лоб здесь нет.
Более интересное сравнение — не OCR против OCR, а вопрос, нужен ли OCR вообще.
Большая часть работы по извлечению данных из скриншотов, которую я вижу, — это обходной путь вокруг страницы, которую сложно спарсить: таблица, отрисованная JavaScript, дашборд за логином, сайт, который сопротивляется. Делать скриншот и прогонять его через OCR кажется самым простым путем, но на деле вы выбрасываете нормально структурированные данные, а затем еще и платите «налог на знак доллара», чтобы получить их худшую версию обратно.
Примечание автора: Thunderbit — наш managed-вариант для извлечения данных со страниц. Через эти image fixtures он не прогонялся. Важная граница здесь — форма исходных данных: если на веб-странице есть структурированные данные, используйте DOM/network extraction; если же источник только пиксели, тогда оценивайте OCR.
Связанное чтение из того же тестового стенда: полное сравнение open-source scraper-ов, обзор Crawl4AI и более широкий взгляд на AI-driven extraction для страниц, которые сопротивляются селекторам.
Попробовать Thunderbit для извлечения веб-данных
Вердикт
Стоит ли использовать EasyOCR? Да, если ваши изображения ровные, символы высотой хотя бы 12 пикселей, а текст — на латинице. В этих границах он очень хорош: средний CER 0.071 на чистом тексте, 0.024 после нормализации регистра, идеальное чтение при 16 px и лучшая устойчивость к контрасту, чем подсказывает его репутация. API действительно в две строки, а вывод детерминирован, что при отладке пайплайна важнее, чем многие признают.
За пределами этих границ он ломается предсказуемо и в конкретных местах. Текст ниже 10 px исчезает в фильтре min_size. Наклон больше 20° рушит чтение. rotation_info исправляет одно ортогональное положение, частично другое и делает третье хуже, выдавая зеркальный текст. Одиночные буквы и двухсимвольные токены выпадают из детектора, хотя соседние блоки остаются. Знаки доллара превращаются в букву S.
Ошибки в фикстурах возникали на обоих этапах: и из-за пропущенных или неправильно ориентированных рамок на стороне геометрии, и из-за путаницы со знаком доллара на стороне распознавания. Считайте увеличение масштаба, нормализацию ориентации, padded crops и исправление символов с учетом схемы не универсальными решениями, а кандидатами на проверку.
Только не тестируйте это так, как едва не сделал я, — с поломанным evaluation harness и числом, смысл которого вы не понимаете. Генерируйте собственные фикстуры, точно знайте свой ground truth и найдите свой собственный обрыв.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Часто задаваемые вопросы
Достаточно ли точен EasyOCR для продакшн-извлечения текста со скриншотов?
На синтетическом дашборде совпавшие элементы дали средний CER 0.027, причем 13 из 16 были распознаны без ошибок. Три из 19 элементов не были детектированы, а три из четырех знаков доллара превратились в S. Приемлемо ли это — и помогут ли увеличение масштаба или исправление по схеме — нужно проверять на ваших макетах.
Какой минимальный размер шрифта читает EasyOCR?
Практически — примерно 12 пикселей высоты символа. Параметр readtext() min_size=10 отбрасывает рамки ниже 10 px, и эффект здесь не плавный, а ступенчатый: CER был 0.77 при 8 px, 0.15 при 10 px, 0.04 при 12 px и 0 при 16 px. В моем sweep чистая зона была 12–28 px. Если у вас скриншот с HiDPI, снятый в 1×, или PDF, растеризованный в 72 DPI, лучше увеличить изображение до OCR, чем уменьшать min_size, потому что этот фильтр нужен именно для подавления мусорных детекций.
Исправляет ли rotation_info повернутые изображения в EasyOCR?
Не всегда и несимметрично. При rotation_info=[90,180,270] на трех копиях одной и той же фразы, повернутых по ортогональным осям, изображение 270° восстановилось почти идеально (CER 0.83 → 0.10), 180° — лишь частично (0.85 → 0.67, при этом фраза частично пропала), а 90° стало хуже (0.81 → 0.92) и вернуло зеркальный текст вроде VOW → MOA. На небольшие углы наклона он тоже не влияет, потому что повторяет попытку только на указанных углах. Лучше сначала выровнять ориентацию, а уже потом вызывать EasyOCR.
Сколько памяти и диска нужно EasyOCR?
Веса занимают 93.7 MiB и при первом использовании скачиваются в ~/.EasyOCR/model/ — 79.30 MiB на детектор и 14.44 MiB на английский распознаватель. Пиковый resident memory в измеренном свежем CPU-процессе был 984.5 MiB, поверх примерно 2 ГБ установки torch. Холодная инициализация reader-а занимала 1.3–1.7 секунды; одна чистая строка затем обрабатывалась с p50 около 0.062 секунды на этой машине. detail=0 меняет форму ответа, но не измеренное время выполнения.
Бесплатен ли EasyOCR для коммерческого использования и поддерживается ли он сейчас? Да, он под лицензией Apache-2.0, а значит разрешен и для коммерческого использования. По состоянию на 27 июля 2026 года в репозитории 29 825 звезд и 528 открытых issues, последний релиз — v1.7.2 от сентября 2024 года, а последняя отправка в master была в декабре 2025-го. Это скорее признак стабильности, чем заброшенности — архитектура давно не менялась, а активность сместилась в issue tracker. Перед использованием обязательно проверьте актуальные лицензию и состояние релизов сами.




