
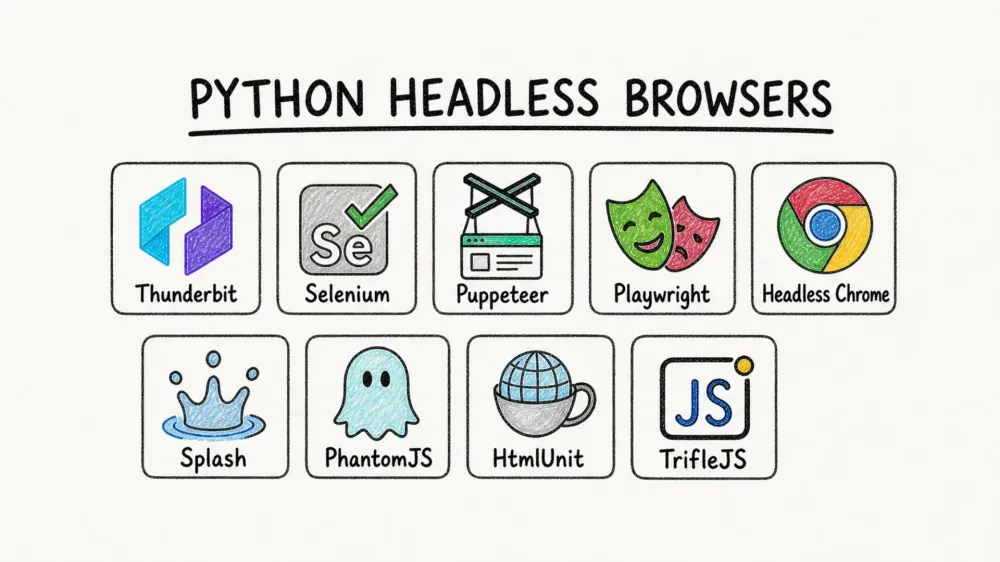
Веб сегодня — это не аккуратная цифровая библиотека, а скорее дикая, постоянно меняющаяся среда данных. В 2026 году, если ты пытаешься собирать данные с современных сайтов, ты сталкиваешься не просто со стеной JavaScript, а с настоящей крепостью. Я на собственном опыте видел, как традиционные инструменты парсинга ломаются под нагрузкой динамического контента, бесконечной прокрутки и антибот-защиты. Именно поэтому рост популярности python headless browser — это не просто очередной тренд, а настоящая революция для всех, кому нужен надёжный и масштабируемый сбор веб-данных.
И это важно не только для разработчиков. По состоянию на 2025 год 73% компаний используют автоматизированное извлечение веб-данных для бизнес-аналитики, а более 94% сайтов уже зависят от рендеринга JavaScript на стороне клиента. Независимо от того, работаешь ли ты в продажах, e-commerce или операциях, правильный python headless browser — это разница между «данные у тебя под рукой» и «данные вне досягаемости». Давай без лишнего шума разберёмся по делу: я протестировал, сравнил и использовал эти инструменты в реальных задачах, и сейчас расскажу про 10 лучших python headless browser для современного парсинга — с особым акцентом на то, как AI меняет правила игры для тех, кто не пишет код.
Почему Python headless browser стал незаменим для современного парсинга?
Извлекайте данные с любого сайта с помощью AI Get Started Free
Сначала разберём термин: python headless browser — это обычный веб-браузер, которым ты управляешь с помощью Python-кода, но без окна на экране. Он открывает страницы, выполняет JavaScript, нажимает кнопки, заполняет формы — и всё это скрытно, в фоне. Представь себе браузер-призрак, который без устали работает, пока ты спокойно пьёшь кофе.
Почему это важно? Потому что современные сайты создаются в первую очередь для людей, а не для ботов. Они прячут данные за JavaScript, требуют авторизацию и ожидают, что ты будешь взаимодействовать с ними как реальный пользователь. Обычные скраперы, которые просто забирают HTML, часто видят только пустую оболочку. Headless-браузеры, напротив, имитируют поведение настоящего пользователя — ждут AJAX-запросы, прокручивают бесконечные ленты и получают контент именно в том виде, в каком ты видишь его в Chrome или Firefox (LiveProxies).
Но это ещё не всё:
- Скорость и эффективность: headless-браузеры не отрисовывают интерфейс, поэтому работают быстрее и потребляют меньше памяти — отлично подходит для парсинга в больших объёмах (LiveProxies).
- Поддержка динамического контента: они выполняют JavaScript, поэтому ты получаешь реальные, уже отрендеренные данные, а не сырой HTML.
- Мощная автоматизация: нужно войти в аккаунт, пройти по страницам или закрыть всплывающее окно? Python headless browser справится со всем этим.
- Масштабируемость: можно запускать сотни экземпляров в облаке, собирать тысячи страниц параллельно и не перегружать систему.
Для бизнеса это значит, что ты наконец можешь собирать лиды, отслеживать конкурентов или мониторить цены — даже если сайт построен как Форт-Нокс. А с современными AI-инструментами для этого уже не обязательно быть программистом.
Как мы выбирали лучшие Python headless browser
Я не просто бросал дротики в список названий браузеров. Вот на что я обращал внимание:
- Производительность и скорость: справляется ли инструмент с современными сайтами на JavaScript быстро и стабильно?
- Поддержка браузеров: работает ли он с Chrome, Firefox, WebKit или даже с устаревшими движками вроде IE?
- Простота использования: подходит ли он тем, кто не пишет код, или требует степени по Python?
- AI и no-code функции: могут ли бизнес-пользователи автоматизировать сбор данных с помощью AI без написания скриптов?
- Сообщество и поддержка: есть ли активное комьюнити, хорошие документы и регулярное развитие?
- Уникальные возможности: есть ли что-то особенное — например, готовые шаблоны, облачный парсинг или переход по подстраницам?
Я видел, как команды неделями мучились с настройкой, а потом упирались в проблему, когда менялся макет сайта. Лучшие инструменты не просто работают — они адаптируются, масштабируются и реально упрощают жизнь.
10 лучших Python headless browser для современного парсинга
Ниже — мой итоговый список с разбором того, чем каждый инструмент хорош, а где у него слабые места.
1. Thunderbit
 Thunderbit — это тот python headless browser, который мне хотелось бы иметь много лет назад. Это не просто инструмент для автоматизации браузера, а AI-powered web scraper Chrome Extension, созданный для бизнес-пользователей, которым нужен результат, а не головная боль.
Почему Thunderbit выделяется:
- AI-настройка полей: просто открой расширение — один клик — и AI Thunderbit сам определит структуру страницы, выберет поля и запустит сбор данных за тебя (Thunderbit Docs).
- Готовые шаблоны данных: для популярных сайтов (Amazon, Zillow, LinkedIn и других) есть шаблоны в один клик — настройка не нужна.
- Парсинг подстраниц и пагинации: Thunderbit умеет переходить по вложенным страницам, работать с бесконечной прокруткой и собирать всё в одну таблицу.
- Промпты на естественном языке: просто опиши, что тебе нужно, обычным английским — AI Thunderbit сделает остальное.
- Сбор в облаке или в браузере: запускай парсинг локально или в облаке (до 50 страниц одновременно для ускорения).
- Код не нужен: серьёзно — если ты умеешь пользоваться браузером, ты уже умеешь пользоваться Thunderbit.
- Бесплатный экспорт данных: выгружай результаты в Excel, Google Sheets, Notion или Airtable одним кликом.
Я видел, как Thunderbit экономит часы командам продаж и операционных отделов — он собирает лиды, отслеживает цены и агрегирует карточки товаров без единой строчки кода. Им пользуются более 200 000 пользователей по всему миру, и отзыв почти всегда один: «Не верится, что это настолько просто».
Лучше всего подходит для: нетехнических пользователей, бизнес-команд и всех, кто хочет, чтобы AI взял на себя всю сложную работу.
Попробовать Thunderbit AI Web Scraper бесплатно
2. Selenium
 Selenium — это классика браузерной автоматизации. Если ты когда-нибудь гуглил «python headless browser», то наверняка натыкался на Selenium WebDriver.
Плюсы:
- Поддержка всех основных браузеров: Chrome, Firefox, Safari, Edge и даже Internet Explorer (для смельчаков).
- Огромное сообщество: масса обучающих материалов, плагинов и ответов на Stack Overflow.
- Высокая гибкость: можно автоматизировать почти любое действие пользователя — клики, формы, навигацию.
Минусы:
- Сложная настройка: придётся возиться с драйверами браузеров и следить за совместимостью версий.
- Медленнее современных инструментов: протокол WebDriver добавляет накладные расходы, а масштабирование на сотни браузеров становится неудобным.
- Многословный API: кода обычно нужно больше, чем в Playwright или Puppeteer.
Лучше всего подходит для: команд с уже накопленной экспертизой Selenium, кроссбраузерного тестирования и устаревших процессов автоматизации.
3. Puppeteer
 Puppeteer — это высокоуровневая библиотека Google для автоматизации Chrome/Chromium. Хотя она нативно рассчитана на Node.js, пользователи Python тоже могут работать с ней через Pyppeteer.
Плюсы:
- Оптимизирован для Chrome: быстрый, эффективный и тесно связан с Chrome DevTools.
- Асинхронный API: отлично подходит для современных сайтов с тяжёлым JavaScript.
- Много функций: скриншоты, экспорт в PDF, перехват сетевых запросов.
Минусы:
- Только Chromium: нет поддержки Firefox и Safari.
- Нативно для Node.js: Python-разработчикам приходится использовать Pyppeteer (который сейчас уже не поддерживается — см. ниже).
Лучше всего подходит для: разработчиков, которым нужна быстрая и надёжная автоматизация Chrome без необходимости в кроссбраузерной поддержке.
4. Playwright
 Playwright — более новый игрок на рынке, созданный Microsoft, и для продвинутого парсинга он быстро стал моим основным выбором.
Плюсы:
- Поддержка нескольких браузеров: автоматизация Chromium, Firefox и WebKit через один API.
- Автоожидание: больше не нужно гадать, когда страница готова — Playwright подождёт сам.
- Параллельность: можно запускать несколько браузерных контекстов одновременно и получать очень высокую скорость.
- Python-first: нативные Python bindings, доступны и async, и sync варианты.
Минусы:
- Более тяжёлая установка: в комплекте идут несколько браузеров, поэтому setup ощущается чуть тяжелее.
- Всё ещё нужен код: для нетехнических пользователей он не так удобен, как Thunderbit.
Лучше всего подходит для: разработчиков, которым нужна современная и надёжная автоматизация, особенно для сложных динамических веб-приложений.
5. Headless Chrome
 Headless Chrome — это движок, на котором работают многие инструменты из этого списка. Им можно управлять напрямую через Chrome DevTools Protocol (CDP), получая максимум гибкости.
Плюсы:
- Современная поддержка веба: если сайт работает в Chrome, он будет работать и в headless Chrome.
- Тонкая настройка: доступ практически ко всем деталям браузера.
Минусы:
- Крутая кривая обучения: нужно разбираться в CDP или использовать библиотеку-обёртку.
- Только Chrome: кроссбраузерной поддержки нет.
Лучше всего подходит для: экспертов, которые строят кастомные пайплайны автоматизации или интегрируют Chrome на низком уровне.
6. Pyppeteer
 Pyppeteer — это неофициальный Python-порт Puppeteer. Он принёс асинхронную автоматизацию Chrome в Python, но есть нюанс.
Плюсы:
- API в стиле Puppeteer: если ты знаком с Puppeteer, освоишься быстро.
- Быстрая автоматизация Chrome: хорошо подходит для динамических сайтов.
Минусы:
- Не поддерживается: оригинальный проект больше не обновляется (разработчики советуют переходить на Playwright).
- Только Chromium: нет Firefox и Safari.
Лучше всего подходит для: старых проектов, которые уже используют Pyppeteer. Для новых проектов лучше выбрать Playwright.
7. Splash
 Splash — это лёгкий скриптуемый headless-браузер с HTTP API, созданный командой Scrapinghub (сейчас Zyte).
Плюсы:
- Лёгкий: использует QtWebKit, поэтому потребляет меньше ресурсов, чем Chrome.
- HTTP API: управлять им можно из любого языка, не только из Python.
- Отлично для Scrapy: легко интегрируется со Scrapy spiders для рендеринга JavaScript.
Минусы:
- Старый движок WebKit: может плохо справляться с самым современным JavaScript.
- Нужен Lua: для продвинутых сценариев придётся немного изучить Lua.
Лучше всего подходит для: пользователей Scrapy, которым иногда нужен JS-рендеринг, или для лёгких задач серверного рендеринга.
8. PhantomJS
 PhantomJS — это первый популярный скриптуемый headless-браузер на базе WebKit. Он был пионером, но сегодня в основном устарел.
Плюсы:
- Простое скриптование: легко автоматизировать с помощью JavaScript.
- Поддержка старых сайтов: ещё может работать с устаревшими статическими ресурсами.
Минусы:
- Не поддерживается: обновлений нет с 2016 года.
- Устаревший движок: не справляется с современными сайтами с тяжёлым JavaScript.
- Риски безопасности: свежих патчей нет.
Лучше всего подходит для: поддержки старых скриптов. Для новых проектов лучше переходить на Playwright или Puppeteer.
9. HtmlUnit
 HtmlUnit — это headless-браузер на Java, который имитирует поведение браузера. Он быстрый и лёгкий, но это не полноценный браузерный движок.
Плюсы:
- Чистый Java: отлично подходит для Java-ориентированных сред.
- Быстрый на статических страницах: не нужно запускать полноценный браузер.
Минусы:
- Слабая поддержка JavaScript: тяжело справляется с современными динамическими сайтами.
- Не нативен для Python: требуется прослойка интеграции (например, Selenium HtmlUnitDriver).
Лучше всего подходит для: Java-проектов, тестирования старых приложений или парсинга простых страниц, отрендеренных на сервере.
10. TrifleJS
 TrifleJS — это headless-браузер для Internet Explorer (IE), предназначенный для автоматизации старых веб-приложений в Windows.
Плюсы:
- Автоматизация IE: подходит для старых внутренних систем или приложений, которые работают только в IE.
- API в стиле PhantomJS: при миграции скриптов PhantomJS нужно минимум изменений.
Минусы:
- Только Windows: кроссплатформенности нет.
- Устарел: IE уже снят с поддержки, а TrifleJS — нишевый и редко обновляется.
Лучше всего подходит для: узкоспециализированных устаревших сценариев, где всё ещё требуется автоматизация IE.
Таблица сравнения: Python headless browser в одном взгляде
| Инструмент | Поддержка браузеров | Производительность и масштаб | Простота использования | AI/no-code функции | Сообщество и поддержка | Лучше всего для |
|---|---|---|---|---|---|---|
| Thunderbit | Chrome (расширение/облако) | Высокая (параллельно в облаке) | Самый простой — без кода | Да (AI, шаблоны) | Активно растёт | Нетехнические пользователи, продажи/операции, быстрый сбор данных |
| Selenium | Все основные браузеры | Средняя | Средняя (настройка) | Нет | Огромное, зрелое | Кроссбраузерность, legacy, тестовая автоматизация |
| Puppeteer | Chromium/Chrome | Очень высокая | Высокая (для разработчиков) | Нет | Большое (Node.js) | Только Chrome, разработчики, быстрая автоматизация |
| Playwright | Chromium, Firefox, WebKit | Очень высокая (много контекстов) | Высокая (для разработчиков) | Нет | Быстро растёт | Продвинутый, мультибраузерный, современный парсинг |
| Headless Chrome | Chrome/Edge | Очень высокая | Низкая (ручной CDP) | Нет | Н/Д (базовый движок) | Кастомные решения, эксперты, низкоуровневый контроль |
| Pyppeteer | Chromium/Chrome | Высокая | Средняя (async) | Нет | Небольшое, не поддерживается | Устаревшие Pyppeteer-скрипты |
| Splash | QtWebKit | Средняя | Средняя (API/Lua) | Нет | Нишевое (Scrapy/Zyte) | Пользователи Scrapy, лёгкий JS-рендеринг |
| PhantomJS | WebKit (старый) | Низкая (сейчас устарел) | Средняя (JS) | Нет | Неактивное | Только legacy |
| HtmlUnit | Эмулируемый (Java) | Средняя/высокая (статикa) | Низкая (Java) | Нет | Небольшое, Java-центричное | Java-процессы, простые/статичные страницы |
| TrifleJS | Internet Explorer (Trident) | Низкая/средняя | Средняя (JS, Windows) | Нет | Очень маленькое, legacy | Устаревшая автоматизация только для IE |
Как выбрать подходящий Python headless browser для вашего бизнеса
Что такое data scraping и как его выполнять в 2025 году Get Started Free
Вот моя короткая шпаргалка по выбору инструмента:
- Нужен быстрый no-code парсинг с поддержкой AI? Выбирай Thunderbit. Это самый простой способ для тех, кто не пишет код, получать надёжные данные — особенно для отделов продаж, e-commerce и исследований.
- Нужен максимальный контроль и поддержка разных браузеров? Playwright — лучший вариант. Он надёжный, современный и рассчитан на масштабирование.
- Уже используете Selenium? Тогда оставайся на Selenium — он по-прежнему отлично подходит для legacy- и мультибраузерных сценариев.
- Делаете автоматизацию только под Chrome и вы разработчик? Puppeteer (или Playwright) — быстрый и мощный выбор.
- Парсите простые статические страницы в Java-среде? HtmlUnit лёгкий и удобно интегрируется.
- Поддерживаете старые скрипты или приложения только для IE? PhantomJS и TrifleJS — ваши варианты, если других уже не осталось.
И помни: лучший инструмент — тот, который подходит твоему рабочему процессу, навыкам команды и задачам бизнеса. Иногда оптимально комбинировать решения: Thunderbit — для быстрых задач, Playwright — для тяжёлой работы, Selenium — для старых систем.
Часто задаваемые вопросы
1. Что такое python headless browser и зачем он нужен для парсинга?
Python headless browser — это веб-браузер, которым ты управляешь через Python-код, но он работает без интерфейса. Он незаменим для парсинга современных сайтов с тяжёлым JavaScript, потому что умеет выполнять скрипты, обрабатывать пользовательские действия и извлекать полностью отрендеренный контент — чего обычные HTML-скраперы делать не могут.
2. Какой python headless browser лучше всего подходит для нетехнических пользователей?
Thunderbit — лучший выбор для тех, кто не пишет код. Он использует AI для автоматизации настройки, предлагает готовые шаблоны и позволяет собирать данные в один клик или просто описав нужную информацию одним предложением — без программирования.
3. Чем отличаются Playwright и Puppeteer для пользователей Python?
Playwright поддерживает несколько браузеров (Chromium, Firefox, WebKit) и имеет полноценные Python bindings, поэтому отлично подходит для сложной автоматизации. Puppeteer работает только с Chrome и изначально создан для Node.js, хотя Python-пользователи могут использовать Pyppeteer (но он уже не поддерживается). Для новых Python-проектов Playwright — более удачный выбор.
4. Остаётся ли Selenium актуальным для современного веб-парсинга?
Да — Selenium по-прежнему широко используется, особенно для кроссбраузерного тестирования и legacy-автоматизации. Но он медленнее и сложнее в настройке, чем новые инструменты вроде Playwright или Thunderbit, и менее эффективен при больших объёмах парсинга.
5. Когда стоит использовать устаревшие инструменты вроде PhantomJS, HtmlUnit или TrifleJS?
Только для поддержки или миграции старых процессов. PhantomJS и TrifleJS уже устарели, а HtmlUnit лучше всего подходит для Java-сред и простых страниц. Для новых проектов лучше выбирать современные инструменты с активной поддержкой.
Если хочешь увидеть, как выглядит современный AI-парсинг на практике, попробуй Thunderbit. А для более глубоких материалов по веб-автоматизации загляни в блог Thunderbit. Удачного парсинга — пусть твои данные всегда будут свежими, а браузеры навсегда останутся headless.
Попробуйте Thunderbit AI Web Scraper уже сегодня Get Started Free
Узнать больше



