
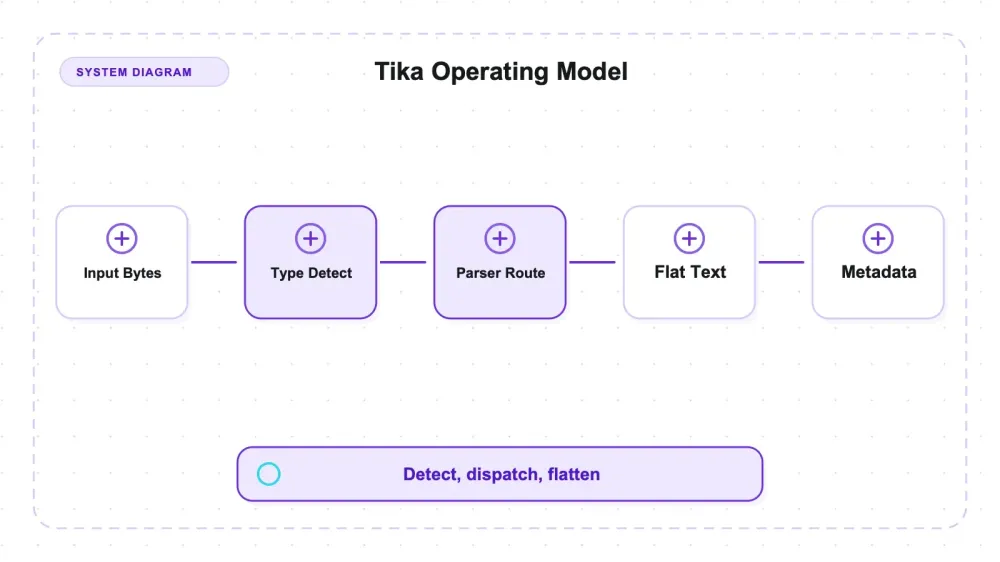
Apache Tika — это набор инструментов Apache Software Foundation для разбора документов: передай ему файл почти любого типа, и он вернёт обычный текст плюс нормализованный словарь метаданных. В README проекта заявлено более тысячи поддерживаемых форматов, и достигается это за счёт того, что Tika сам включает специализированные библиотеки — PDFBox для PDF, Apache POI для документов Office, jsoup для HTML, ODF reader для ODT — так что всё поставляется одним fat jar без необходимости что-либо дополнительно скачивать во время разбора. В data pipeline это не самый заметный, но крайне важный первый этап: компонент перед поисковым индексом, набором для e-discovery или корпусом для LLM, который превращает разнородную стопку файлов в единообразный формат. По сути, у него две задачи: понять, что собой представляет поток байтов, а затем извлечь из него текст и метаданные.
Это самый нетребовательный инструмент, который я настраивал за очень долгое время. Один jar, java -jar tika-app-3.3.2.jar --text file.pdf, без конфигурационного файла, без весов модели, без постустановочных шагов — и он спокойно запустился на новейшем JDK, на котором в тот же день другие Java-инструменты на том же хосте просто падали. Но меня интересовала не сама заявка про каталог форматов; вопрос был уже и проверяемее. Что Tika делает, когда входной файл врёт о себе? Поэтому я собрал контролируемый набор тестовых файлов, где каждый блок контента содержал уникальный маркер, отрендерил один и тот же логический документ в девяти форматах-контейнерах, а затем атаковал всё это неправильными расширениями, отсутствующими расширениями, файлами без имени, пустыми файлами и бинарниками, записанными лишь наполовину.
Самое интересное поведение проявляется именно на этапе определения типа. Я переименовал PDF в .txt и спросил Tika, что это за файл; он ответил application/pdf. Потом я полностью убрал имя файла, передал сырые байты через stdin и получил тот же ответ. Для пяти форматов, которые можно распознать по содержимому, это сработало во всех 20 уникальных логических условиях: три условия с именем файла плюс одно условие без имени для каждого формата. В harness потоковый случай запускался три раза под разными ярлыками, что дало 30 успешных сырых запусков, но эти повторы не являются независимыми доказательствами. PDF и RTF имеют узнаваемые сигнатуры байтов; DOCX распознаётся по контейнеру; HTML и XML можно определить по разметке или корневому содержимому. Механизмы разные, результат в этом наборе один и тот же: расширение не перебило содержимое. А ещё есть режим для текстовых форматов, где Markdown превращается в text/plain в тот момент, когда имя файла неверное или отсутствует. В этом случае вся его идентичность держалась на .md.
Два ограничения к каждому числу ниже. Я тестировал Apache Tika 3.3.2 — проверка от 27 июля 2026 года показала, что это всё ещё последняя стабильная версия; ветка 4.0.0 существует только в альфа- и бета-сборках на Maven Central. У проекта было примерно 3,9 тыс. звёзд на GitHub на момент проверки 27 июля 2026 года, а лицензия — Apache-2.0, то есть максимально спокойная для коммерческого использования. И OCR я вообще не тестировал. Ни одной отсканированной страницы, ни одного PDF только с изображениями. На машине, где я всё запускал, не установлены Tesseract и poppler, так что все пути OCR были заблокированы ещё до старта. Здесь нет OCR-метрик просто потому, что OCR-метрик здесь нет.
Что такое Tika, если перестать читать маркетинговое описание на коробке
Распространённое заблуждение — считать Apache Tika конвертером документов: подаёте DOCX, получаете обратно чистый Markdown с сохранёнными заголовками и таблицами. Это не так, и чем раньше это становится ясно, тем лучше выглядит сам инструмент.
В тесте здесь есть три ключевых этапа: detector типа содержимого, диспетчер, который передаёт байты нужному парсеру, и обработчик вывода CLI --text, который выдаёт плоский текст вместе с отдельно доступными метаданными. В этом контракте вывода нет объектов Title, нет ListItem, нет воссозданной сетки таблицы. У Tika есть и другие обработчики, а также API, включая XHTML/SAX-ориентированный вывод; я их не тестировал. Поэтому все выводы о структуре ниже относятся именно к tika-app --text, а не к утверждению, что у тулкита вообще нигде нет структурированного потока событий.
Это звучит как ограничение, и в одном смысле так и есть. Но это также значит, что Tika ничего не нужно угадать неправильно — а именно на такой обмен делают ставку его более шумные аналоги в обратную сторону.
Само определение типа идёт в документированном порядке: сначала сигнатуры байтов, затем проверка корневого элемента XML, затем шаблон имени файла, и только потом заданный вами тип (документация Tika по detection описывает это именно так). И лишь после определения типа диспетчер передаёт байты соответствующему встроенному парсеру — PDFBox, POI, jsoup, TextAndCSVParser для семейства текстовых форматов.
Это разделение на detect и parse — не внутренняя мелочь. Именно поэтому файл, слишком повреждённый для разбора, всё равно может быть правильно типизирован. И именно это оказывается самым практичным трюком Tika, когда всё начинает ломаться.
Настройка: один jar, одна команда и JVM без капризов
Установка — это просто скачивание. tika-app-3.3.2.jar из Maven Central весит около 67 МБ — это fat jar со всеми парсерами внутри — и дальше всё сводится к java -jar tika-app-3.3.2.jar --text file.pdf. Ни конфигурационного файла, ни весов модели, ни постустановочных шагов, ни цепочки brew install, которую надо проходить по кругу.
С JDK всё оказалось неожиданно приятно. Я запускал весь набор на OpenJDK 26.0.1, на свежей non-LTS-сборке, и --version, --text, --metadata и --detect все возвращали exit 0 без каких-либо претензий к совместимости. Это стоит отдельно отметить, потому что в тот же день и на том же хосте я проверял Apache Nutch, и его цикл обхода вообще не запускался на JDK 26 — ему нужен LTS на уровне 21 или ниже из-за удаления SecurityManager в новых JDK. Tika это не волновало. Если вы избегали JVM-инструментов именно из-за такого рода проблем, здесь это вас не укусит.
Два честных вывода по настройке. CLI поднимает свежую JVM на каждый запуск, так что cold start здесь реален — 131 запуск в моём harness заняли около минуты, в основном на прогрев JVM. Если вы обрабатываете файлы в больших объёмах, вам нужен библиотечный режим или серверный режим, а не shell-цикл поверх jar. И у истории про «без зависимостей» есть жёсткая граница: извлечение текста из PDF-слоя не требует внешних компонентов, но для OCR нужны tesseract и poppler. PDF с текстовым слоем, DOCX, ODT, RTF, HTML, XML, TXT, Markdown, CSV — всё это разбиралось на хосте, где не было ничего из этого списка. Отсканированные документы — уже нет, и я не делал вид, что это иначе.
Этот контраст особенно заметен рядом с родственной библиотекой, которую я тестировал в тот же день, unstructured: путь для электронных PDF был полностью заблокирован, потому что при импорте PDF-модуля подтягивается стек инференса (torch и т. п.) ещё на этапе загрузки — до выбора стратегии, так что даже стратегия fast не может импортироваться без него. Tika же вытащил текстовый слой того же PDF обычным java -jar.
Тест на лживое расширение: определение MIME-типа, которое игнорирует то, как вы назвали файл
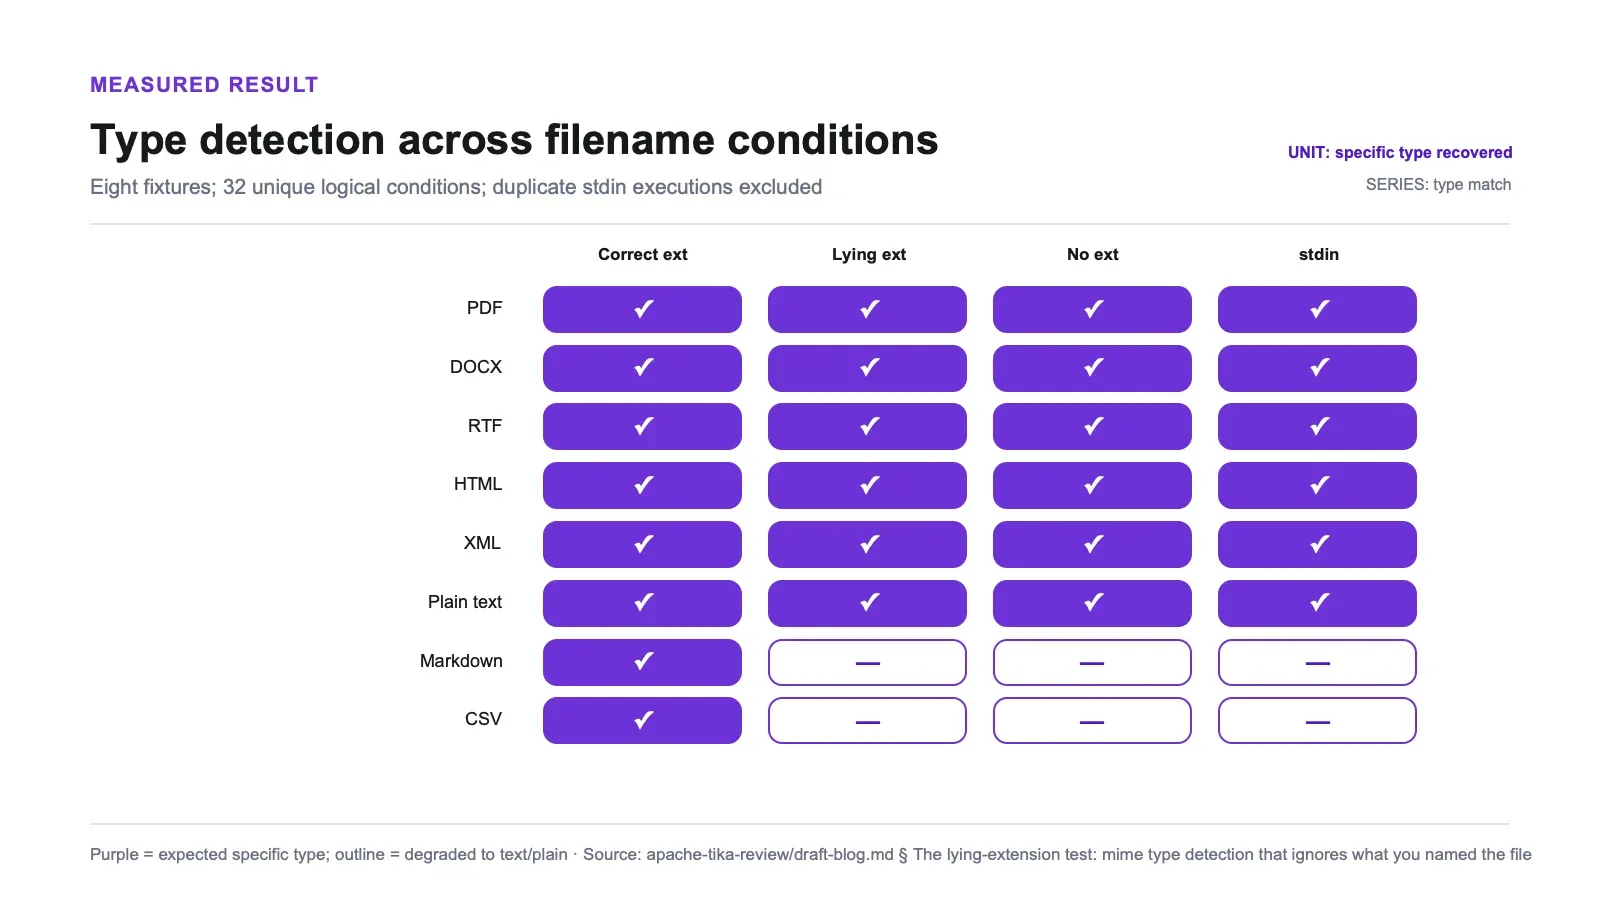
Восемь форматов, каждый показан с корректным расширением, намеренно неправильным расширением или вообще без расширения, плюс поток байтов без имени файла через stdin. Это 32 уникальных логических условия. В исходном harness тот же поток байтов ещё и один раз прогонялся под каждым именем файла, что дало 48 сырых запусков; три строки для потока сводятся к одному условию, потому что у stdin нет имени файла.
| Fixture | Истинный тип | Переименован в | Правильное расширение | Лживое расширение | Без расширения | Сырой поток без имени файла |
|---|---|---|---|---|---|---|
application/pdf | .txt | ✅ | ✅ | ✅ | ✅ | |
| DOCX | OOXML wordprocessingml | .jpg | ✅ | ✅ | ✅ | ✅ |
| RTF | application/rtf | .html | ✅ | ✅ | ✅ | ✅ |
| HTML | text/html | .csv | ✅ | ✅ | ✅ | ✅ |
| XML | application/xml | .txt | ✅ | ✅ | ✅ | ✅ |
| Обычный текст | text/plain | .pdf | ✅ | ✅ | ✅ | ✅ |
| Markdown | text/markdown | .pdf | ✅ | ❌ text/plain | ❌ text/plain | ❌ text/plain |
| CSV | text/csv | .txt | ✅ | ❌ text/plain | ❌ text/plain | ❌ text/plain |
(Столбец с потоком объединяет все три условия по расширению, потому что без имени файла нечего сопоставлять по glob.)
Пять форматов, которые можно определить по содержимому — PDF, DOCX, RTF, HTML и XML — попали в истинный тип в 20 из 20 уникальных условий (и в 30 из 30 сырых запусков harness, если учитывать повторяющиеся потоковые прогоны). PDF, названный report.txt, всё равно остался PDF. DOCX, названный photo.jpg, всё равно остался DOCX. Имя файла не понадобилось ни одному из них. Это не значит, что все пять используют только фиксированные сигнатуры байтов: у PDF и RTF есть узнаваемые заголовки, DOCX — ZIP-контейнер, а HTML/XML определяются по разметке или корневому содержимому. В этих тестах лживое расширение не победило.
Дальше — режим текстовых форматов. Markdown распознался как text/markdown только когда расширение .md было на месте и читалось. Переименуйте его, уберите расширение или отправьте как поток — и в этом тесте он деградировал до text/plain. CSV в этой специально маленькой сетке вёл себя так же: text/csv появлялся только из glob по .csv. Если считать уникальные условия, Markdown и CSV каждый получили свой специфический тип в одном из четырёх случаев; обычный текст и так был text/plain, так что ему не с чем было «схлопываться». Сырые 48 запусков harness по-прежнему полезны как запись о повторяемости, но не как увеличенный знаменатель.
Одна деталь играет Tika на руку: лживое расширение тоже не побеждает. Мой Markdown-файл, переименованный в .pdf, вернулся как text/plain, а не как application/pdf. Tika не поверил лжи; он просто не смог подтвердить правду. Переход к родительскому типу — гораздо лучше, чем уверенно вернуть неверный тип, а то, что text/markdown является задокументированным подтипом text/plain, делает такой fallback принципиальным, а не случайным.
Есть оговорка именно по CSV. У Tika есть статистический детектор CSV, и во время разбора — это подтверждается тем, что TextAndCSVParser появляется в цепочке X-TIKA:Parsed-By — мой маленький грид 2 столбца на 3 строки определялся как text/plain, а не как text/csv. Это единичное наблюдение на намеренно минимальном fixture. Более крупный CSV или CSV с кавычками вполне может задействовать детектор. Я не утверждаю, что content-detection CSV сломано; я утверждаю, что на этой сетке text/csv было получено именно благодаря расширению.
Почему это важно в реальном upload pipeline
Практический сценарий — router для загрузок. Допустим, вы принимаете файлы от пользователей и маршрутизируете их по типу: PDF — в invoice parser, таблицы — в импортёр ledger, всё остальное — в текстовый индекс. Если доверять расширению, PDF с именем notes.txt попадёт не в ту ветку — и это ещё безобидный случай; враждебный вариант — это polyglot-файл с «безопасным» расширением.
Для бинарных и разметочных fixtures, которые я тестировал, Tika выбирал маршрут по содержимому даже после того, как имя файла исчезало. Это полезно, когда blob store или HTTP body handler это имя уже выбросили. Но этот результат не покрывает весь хвост редких случаев, неоднозначные файлы или polyglot. А протестированные текстовые форматы вели себя иначе: когда pipeline убирал имена файлов, Markdown и CSV приходили как text/plain, поэтому правила, завязанные на их конкретные media types, переставали срабатывать. Оригинальное имя файла лучше сохранять рядом как sidecar-метаданные, а не надеяться, что content detection восстановит его сам.
Пожилое содержимое уцелело. --text же «сгладил» структуру.
Второй измеряемый параметр — fidelity, и он делится на две части очень чётко. Я отрендерил один канонический документ (заголовки, два абзаца основного текста, маркированный список, нумерованный список, завершающий абзац) в HTML, Markdown, plain text, DOCX, PDF, RTF, ODT и XML, плюс табличный документ в HTML, Markdown, text, DOCX, CSV и XML. Всего четырнадцать рендеров-контейнеров. Каждый блок содержит уникальный токен — zztitle1, zzitem3, zztblcell_beta и так далее — так что «сохранилось» versus «пропало» здесь это точная проверка по подстроке, а не субъективная оценка.
Recall по маркерным токенам составил 1.000 во всех четырнадцати рендерах. Не пропал ни один подложенный токен: каждая помеченная ячейка таблицы, каждый элемент списка и каждый заголовок присутствовали. Три локальных повтора на каждый контейнер после прогрева дали byte-identical вывод --text. Этот oracle ничего не говорит о непомеченных символах, порядке, пробелах, Unicode normalization, повторяющемся содержимом, ссылках, колонтитулах, сносках или встроенных объектах. Это проверка наличия блоков, а не доказательство полной fidelity документа.
Плоский текстовый вывод отбрасывает большую часть исходной структуры.
Вот как табличный HTML-документ выходит из --text:
	Tool	Throughput

	zztblcell_alpha	120

	zztblcell_beta	95
Строки, разделённые табами. Строка заголовка не помечается как заголовок. Нет сетки, нет границ ячеек, кроме таба, нет способа понять, что это вообще был <table>. Таблица DOCX схлопывается точно так же.
Списки ведут себя тоньше, и всё зависит от того, чем именно был исходный объект:
| Что было маркером списка в исходнике | Контейнеры | Что возвращает --text |
|---|---|---|
Буквальный символ — во всех этих рендерах - был записан как обычный текст | plain text, Markdown, RTF, ODT, PDF | - сохраняется, потому что Tika просто пропускает символы дальше |
Настоящая структура — HTML <li>, стиль DOCX List Bullet | HTML, DOCX | маркер полностью исчезает, и остаётся только текст пункта: строка с отступом в HTML, обычная неоформленная строка в DOCX |
Tika никогда не рисует заново маркер, если он не пришёл к нему как текст. Одинаковое содержимое, но разный вид вывода.
Случай с Markdown показывает это особенно ясно. Дайте Tika .md-файл с pipe table, и вертикальные черты вернутся буквально как есть, что выглядит как сохранение структуры. Но это не так. Tika обработал это как текст и просто вернул байты. Ничто не поняло, что это была таблица.
Итак, измеряемый контракт уже: все подложенные маркеры сохранились, но --text не сохранил типизированные элементы и не воссоздал сетку таблицы. Называть это дефектом парсера было бы мимо цели. Плоское извлечение намеренно избегает задачи классификации элементов; зато оно не может удовлетворить downstream-потребителя, которому нужны именно такие типы элементов. Если вам нужны типизированные блоки или восстановленные таблицы, --text — лишь один компонент стека, а не весь стек. Другие обработчики Tika могут показывать больше структуры, но в этот прогон они не входили.
Стандартная оговорка ко всем числам fidelity: они получены на контролируемых синтетических fixtures, на одной машине, одной версии и одном JDK. Они показывают, что помеченные блоки присутствовали в выходе. Они не доказывают посимвольное сохранение или точность на грязном реальном корпусе.
Метаданные: нормализованные и на удивление не склонные выдумывать лишнее
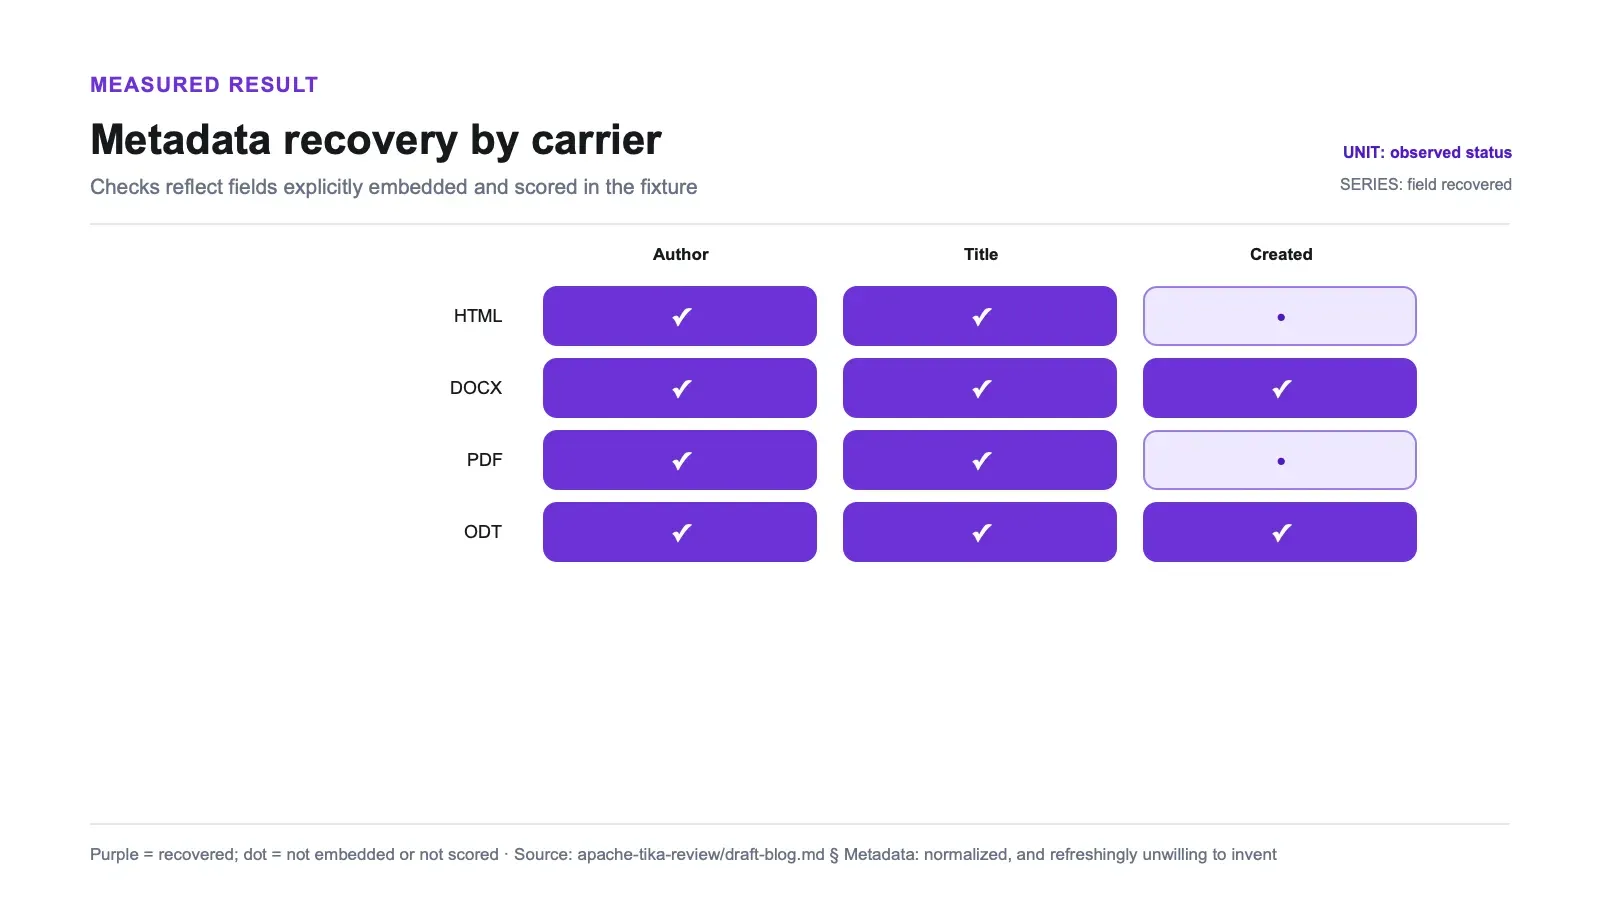
Я встраивал известные значения автора, заголовка и даты создания в каждый контейнер, где есть слой метаданных, а потом проверял, что вернулось обратно.
| Контейнер | author → dc:creator | title → dc:title | created → dcterms:created |
|---|---|---|---|
HTML (<meta name=author>, <title>) | ✅ | ✅ | не встроено |
| DOCX (core properties) | ✅ | ✅ | ✅ точное 2021-03-15T09:30:00Z |
| PDF (info dict) | ✅ | ✅ | присутствует, но это была собственная временная метка генератора — не засчитана |
ODT (meta.xml) | ✅ | ✅ | ✅ точное 2021-03-15T09:30:00Z |
| TXT / MD / CSV / RTF / XML | слой метаданных отсутствует | — | — |
Автор и заголовок были извлечены на 4 из 4 контейнеров с метаданными — и, что особенно приятно, они нормализованы. HTML <meta name="author">, core property DOCX, /Author в PDF и элемент dc:creator в ODT всё приходят под одним и тем же ключом dc:creator. Ты пишешь одного consumer, а не четырёх.
created — это честное расхождение. DOCX и ODT вернули мой точный встроенный timestamp 2021 года. PDF тоже вернул дату создания, но это была дата, которую поставила библиотека-генератор при сборке, а не то значение, которое я хотел встроить, поэтому я засчитываю её как «присутствует», а не как «восстановлено». А форматы без слоя метаданных не показали вообще ничего — и это правильный ответ. Tika не угадывает автора по тексту тела.
Ломаем его специально и получаем из этого полезный triage-трюк
Четыре враждебных входа. Пустой файл. Валидный заголовок PDF с отрезанным телом. Обрезанный ZIP DOCX. И UTF-8-файл с многобайтными символами без BOM и без объявления кодировки. Это локальные формы fixtures, а не пороги Tika.
Исходный harness, сгенерированные fixtures, сырые JSON, checksum jar и манифест окружения здесь публично не приложены, поэтому сторонний читатель не сможет независимо воспроизвести точные знаменатели. Считай таблицы здесь наблюдениями, а не доказательствами, которые можно проверить третьей стороной.
| Вход | --text / --json | Что он выбросил | --detect |
|---|---|---|---|
| Файл 0 байт | exit 1, пустой stdout | ZeroByteFileException: InputStream must have > 0 bytes | exit 0 → text/plain с именем файла, application/octet-stream из потока |
| Обрезанный PDF | exit 1, пустой stdout | TikaException: TIKA-198: Illegal IOException from PDFParser | exit 0 → application/pdf |
| Обрезанный DOCX | exit 1, пустой stdout | POI FATAL: "XML document structures must start and end within the same entity" | exit 0 → тип OOXML |
| UTF-8, без BOM, без объявления | exit 0 | ничего | exit 0 → text/plain, charset UTF-8 |
Извлечение падает громко, и по внешнему виду эти падения похожи друг на друга. Пустой файл, обрезанный PDF и обрезанный DOCX каждый дали exception, exit 1 и пустой stdout. CLI не прячет ошибку в аккуратный пустой результат. Для процесса это безопасно — без зависаний, без segfault — но вызывающему коду нужно смотреть на exit status и stderr, а не только на пустую строку.
Detection отделён от parsing. Для обоих обрезанных бинарников --detect вернул exit 0 с ожидаемым типом по целому началу файла; затем парсер упал на сломанном теле. Поэтому pipeline может использовать detection как отдельный сигнал для triage до или после неудачного разбора. Хороша ли стратегия detect-first по умолчанию, зависит от режима развёртывания: этот тест не сравнивал detect-first с parse-only, а две свежие CLI JVM могут быть неправильной платой на больших объёмах.
Определение кодировки работает. UTF-8-файл без BOM и без объявления был декодирован как UTF-8, и 日本語テスト прошёл без искажений. Небольшая оговорка для тех, кто смотрит на словари метаданных: мои чисто ASCII fixtures показывают charset=ISO-8859-1, что неотличимо от UTF-8 на ASCII-байтах. Это не ошибка, а ничья.
Tika рядом с unstructured: те же типы файлов, но разные задачи
Оба инструмента я запускал в одной исследовательской сессии, но это скорее таксономия output contract, чем симметричный benchmark. Инструменты оценивались по разным результатам.
Связанный обзор: Обзор Unstructured.
| Apache Tika | unstructured | |
|---|---|---|
| Что я измерял | fidelity содержимого: что-то потерялось или нет? | fidelity классификации элементов: каждому блоку присвоен правильный тип? |
| Результат | все подложенные маркеры присутствуют во всех четырнадцати рендерах | в отдельном тесте на классификацию обычная текстовая таблица дала recall по Table = 0.000, а один заголовок с глаголом был классифицирован как narrative text |
| Возвращаемые типизированные элементы | нет — структура тоже не возвращалась | Title, NarrativeText, ListItem, Table — именно то, чего Tika не делает |
| OCR | заблокирован на моём хосте, отсутствует tesseract | заблокирован на моём хосте, отсутствует tesseract |
Плоский вывод, сохраняющий маркеры, против типизированных элементов с наблюдаемыми ошибками классификации. Выбирай то, что нужно downstream-потребителю. Если это поисковый индекс или контекстное окно LLM, плоского текста может быть достаточно. Если потребитель опирается на тип элемента, путь Tika --text этот контракт обеспечить не может.
Ни у одного из нас нет чисел по отсканированным документам.
Плюсы и минусы
Плюсы
- Определение типа игнорировало лживые имена файлов в 20/20 уникальных условий для пяти форматов, распознаваемых по содержимому; повторные прогоны с потоком тоже совпали.
- Каждый подложенный маркер сохранился во всех 14 рендерах, включая помеченные ячейки таблиц и элементы списков.
- Повторяемость подтвердилась на трёх локальных перезапусках: каждый контейнер возвращал byte-identical текст в этом окружении.
- Метаданные нормализованы между форматами —
dc:creator/dc:title/dcterms:createdнезависимо от исходного формата, восстановлены на 4/4 контейнерах с метаданными. - Действительно без внешних зависимостей для протестированных форматов: PDF с текстовым слоем, DOCX, ODT, RTF, HTML все разбираются из одного jar без внешних бинарников.
- Чисто работает на OpenJDK 26 — нет ограничения только для LTS.
- Detection остаётся корректным (exit 0) на обрезанных бинарниках, давая надёжный сигнал для triage, когда parsing падает.
- Apache-2.0, зрелый, активно поддерживаемый проект.
Минусы
- Идентичность Markdown и CSV полностью зависит от расширения файла; 10 из 18 ячеек без сигнатуры схлопнулись в
text/plain, как только имя файла исчезло или стало неверным. --textне возвращает типы элементов; таблицы превращаются в строки, соединённые табами, а структурные маркеры списков исчезают.- Извлечение бросает необработанные ошибки на пустых и повреждённых входах; в этих двух случаях внешний вид ошибки одинаков, если смотреть только на вызов extraction.
- Jar на 67 МБ плюс cold start JVM на каждый запуск в CLI-режиме.
- OCR и PDF со сканами здесь вообще не тестировались — tesseract и poppler отсутствовали, так что никаких утверждений по этому пути я не делаю.
- Все числа здесь — синтетическая ground truth на одной машине и одной версии. Точность на реальном корпусе, зашифрованные файлы, вложенные/рекурсивные документы и производительность на больших объёмах не измерялись.
Кому стоит использовать, а кому — нет
Tika подходит, когда у тебя есть уже имеющиеся файлы, а результат должен быть текстом плюс метаданными, которые можно индексировать машиной. Поисковая индексация, e-discovery, обработка архивов, подача корпуса в LLM, построение слоя валидации типов контента для upload pipeline. Его удобно использовать как первый этап triage и нормализации перед чем-то более умным: определить протестированные типы, извлечь плоский текст и передать дальше вместе с явными проверками того содержимого, которое pipeline не может позволить себе потерять.
Пропусти его — точнее, не останавливайся на --text — если тебе нужны типизированные элементы, восстановленные таблицы или макет документа. Пропусти его и в том случае, если твои документы — это сканы, по крайней мере пока ты не установишь tesseract и не снимешь собственные цифры, потому что у меня их нет. Для работы с большими объёмами стоит сравнить библиотечный или серверный режим с CLI на репрезентативных документах. В этом small-file harness запуск процесса был заметен, но throughput и стоимость ресурсов не измерялись.
То, что чаще всего подводит людей: если storage layer вырезает имена файлов, а ты работаешь с Markdown или CSV, не надейся, что Tika различит их от обычного текста. Сохраняй оригинальное имя.
Альтернативы и место Thunderbit
Сначала честная рамка, потому что здесь корректное сравнение идёт по входам, а не по качеству. Tika — это бесплатный self-hosted toolkit на Apache-2.0 для разбора файлов. Файлов, которые уже лежат у тебя на диске или в bucket. Он не ходит за страницами, не исполняет JavaScript, не борется с антибот-защитой и не притворяется, что умеет это.
Именно на этой границе в архитектуру может войти managed web extraction service, включая наш собственный Thunderbit: он забирает живые страницы, а Tika разбирает файлы, которые уже есть у тебя. Эта статья не сравнивала эти сервисы с Tika, и они не являются взаимозаменяемыми для одного и того же входа.
Чистое разделение выглядит так: Tika — для документов, которые уже у тебя есть; managed extraction API — для веб-страниц, которые надо сначала получить. Многие пайплайны используют оба инструмента: crawл и extract на веб-стороне, Tika — для PDF и DOCX-вложений, которые возвращаются обратно.
Если ты сравниваешь более широкий open-source ландшафт, я уже писал полное сравнение open-source scraper-ов, обзор самых полезных scraping-проектов на GitHub, практический обзор Crawl4AI про браузерный Markdown-подход и более широкий сводный материал по scraping tools. Для no-code пути есть также пошаговый разбор, как сделать scraping сайта с помощью AI.
Попробовать Thunderbit для извлечения веб-данных
Итог
Стоит ли использовать Apache Tika? Да, если твоя задача — превращать разнородные файлы в плоский текст и нормализованные метаданные, и ты проверяешь поля или маркеры, которые твой pipeline не может позволить себе потерять.
Сильнейшая часть этого прогона — детектор. Он вернул ожидаемый тип в 20 из 20 уникальных условий для пяти форматов, распознаваемых по содержимому, включая потоки без имени файла. Каждый подложенный маркер сохранился во всех четырнадцати рендерах, а вывод повторялся побайтно в трёх локальных перезапусках. Полезные доказательства. Но всё же синтетические. Запуск из одного jar на этом JDK, без внешних бинарников для протестированных non-OCR путей, сделал развёртывание приятно скучным.
Но размер имеет значение. Каждая таблица, которую ты ему подаёшь, возвращается строками, соединёнными табами. Каждый структурный маркер списка исчезает. Markdown и CSV теряют свою идентичность в тот момент, когда имя файла пропадает. Пустые и повреждённые файлы бросают одинаковый по форме сбой, и чтобы отличить их друг от друга, понадобится отдельный вызов detect. А по OCR — вопросу, который волнует многих пользователей Tika больше всего, — мне нечего предложить: я не смог его запустить и не буду ничего оценивать на глаз.
В этих пределах Tika делает незаметную, но очень надёжную работу. Он читает байты, а не ярлык на коробке. Только не спрашивай его, какой формы эти байты были изначально.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Часто задаваемые вопросы
Корректно ли Apache Tika определяет тип файла, если расширение неверное?
Для пяти протестированных форматов, распознаваемых по содержимому, — да. PDF, DOCX, RTF, HTML и XML определялись как ожидаемые media types во всех 20 уникальных логических условиях (30 сырых запусков с повторяющимися потоковыми прогонами), включая вводящее в заблуждение расширение, отсутствие расширения и поток без имени файла. PDF с именем .txt всё равно определялся как application/pdf. Markdown и небольшой CSV-образец зависели от информации об имени файла и деградировали до text/plain, когда её не было или она была неверной.
Сохраняет ли Tika таблицы и структуру документа?
Не в том режиме --text, который тестировался здесь. Табличные сетки возвращались как строки, соединённые табами, без семантики ячеек или заголовков, а структурные маркеры списков (HTML <li>, стиль DOCX List Bullet) исчезали. Каждый подложенный маркер сохранился во всех 14 рендерах-контейнерах, но это не доказывает полной fidelity содержимого, а --text не возвращает типы элементов. Если нужны типизированные элементы или восстановленные таблицы, тестируй другой обработчик вывода Tika или используй рядом другой инструмент.
Может ли Apache Tika делать OCR для отсканированных PDF? Tika поддерживает OCR через Tesseract, но я это не тестировал, и ни один из этих результатов не является утверждением про OCR. На моём тестовом хосте не было Tesseract и poppler, поэтому все пути OCR и scanned-image были заблокированы ещё до запуска. Здесь нет ни одной OCR-метрики. Если OCR — твой сценарий, установи tesseract и проверь его сам; эту часть Tika здесь следует считать непроверенной.
Что делает Tika с пустыми или повреждёнными файлами?
Он падает громко, а не молча. Файл на 0 байт вызывает ZeroByteFileException; обрезанный PDF вызывает TikaException из PDFParser; обрезанный DOCX вызывает XML-ошибку POI. Во всех трёх случаях exit 1 и пустой stdout, поэтому на уровне самого вызова extraction пустой и повреждённый файл не отличить. Однако detection остаётся надёжным — --detect возвращал exit 0 с правильным типом и для обрезанных бинарников, что делает его хорошим triage-шагом до того, как вы потратите ресурсы на parse.
Что не покрывало тестирование Tika? Четыре вещи, и я их называю прямо. OCR и отсканированные изображения — заблокированы, не тестировались. Точность на реальном корпусе — все результаты получены на контролируемых синтетических fixtures с подложенными маркерами, то есть это измерение fidelity по известным меткам, а не точности на грязных реальных документах. Стоимость ресурсов, throughput и пиковая память — я их не измерял. И длинный хвост заявления про «тысячу типов файлов»: я тестировал девять репрезентативных форматов без внешних зависимостей, а не полный каталог. Всё здесь — это Tika 3.3.2 на OpenJDK 26.0.1, macOS arm64, одна машина.




