Raspador do TechCrunch













Desbloqueie os dados do TechCrunch em dois cliques
Extração simples do TechCrunch em dois cliques
Copiar manualmente títulos de artigos, autores, datas de publicação ou o conteúdo completo do TechCrunch é cansativo. O Thunderbit elimina totalmente esse trabalho manual. Basta apontar para os dados de que você precisa, e a IA faz o resto. Em dois cliques, você já está extraindo dados estruturados sem escrever uma única linha de código nem lidar com configurações complicadas.
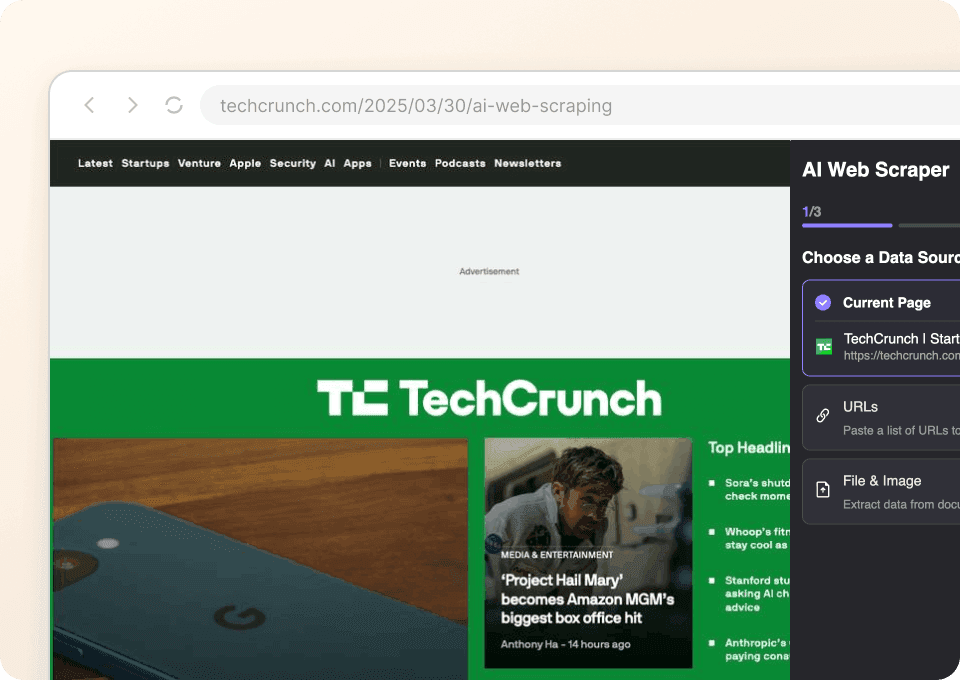
Obtenha dados limpos do TechCrunch, instantaneamente
Extrair HTML bruto do TechCrunch não resolve — o que você precisa são dados limpos e estruturados. O Thunderbit limpa e formata os dados automaticamente durante a extração, para que você possa analisar categorias de artigos, acompanhar autores ou comparar datas de publicação imediatamente. Exporte direto para Google Sheets, Notion ou Airtable e comece a trabalhar com dados organizados na hora — sem limpeza manual.

Extraia qualquer site, não só o TechCrunch
Por que aprender uma ferramenta nova para cada site? O Thunderbit funciona praticamente em qualquer página, incluindo o TechCrunch. Com mais de 50 modelos prontos, você começa ainda mais rápido. Seja para coletar conteúdo de artigos, perfis de autores ou tags de publicação, o Thunderbit é a solução única para extração de dados web em toda a internet.
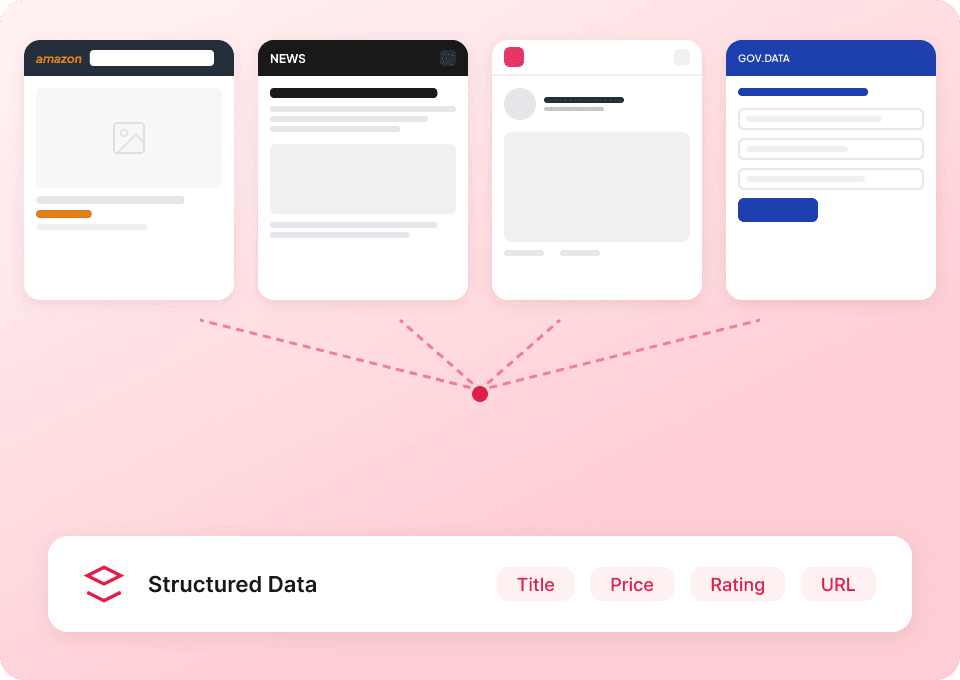
Com dificuldade para extrair dados do TechCrunch com eficiência?
Veja como o Thunderbit simplifica a extração de dados do TechCrunch em comparação com os métodos tradicionais.
Raspadores tradicionais
O jeito antigo de fazer as coisasThunderbit
A abordagem mais inteligente




Perguntas frequentes
Relacionados casos de uso
Explore mais casos de uso do web scraper da Thunderbit.

Raspador 4PDA
O Raspador Web 4PDA da Thunderbit permite extrair dados de artigos de notícias e postagens de fórum do 4PDA usando IA. Colete rapidamente títulos de artigos, datas de publicação, autores e conteúdos de postagens para pesquisa, análise ou acompanhamento de discussões tecnológicas. Perfeito para entusiastas de tecnologia, pesquisadores e profissionais de marketing que buscam dados estruturados do 4PDA.
Saiba mais ->
Raspador Ptt
O Raspador Web Ptt da Thunderbit permite extrair informações de fóruns e postagens do Ptt com sugestões inteligentes de campos baseadas em IA. Colete nomes de fóruns, URLs, popularidade, títulos de postagens, autores e comentários para pesquisas, marketing ou análise de conteúdo. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que precisam de dados estruturados do Ptt.
Saiba mais ->
Raspador de Mercado de Pizza
O Raspador Web de Pizza Marketplace da Thunderbit permite extrair dados das listas de notícias e diretórios de fornecedores do Pizza Marketplace. Com sugestões inteligentes de campos via IA, colete rapidamente títulos de notícias, datas de publicação, autores, nomes de fornecedores, localizações e contatos para pesquisas, marketing ou análises.
Saiba mais ->
Raspador Failory
O Raspador Failory da Thunderbit permite extrair dados estruturados do cemitério de startups e dos artigos de notícias do Failory. Utilize sugestões inteligentes de campos com IA para coletar nomes de startups, anos, motivos de falha, títulos de artigos, autores e muito mais para pesquisas ou análises. Perfeito para empreendedores, investidores e pesquisadores que buscam insights valiosos do Failory.
Saiba mais ->
Scraper do Investing.com
Extraia dados de ações — símbolos, preços, volume e valor de mercado — do Investing.com em 2 cliques e exporte diretamente para Google Sheets, Notion ou Excel. Abra qualquer página do Investing.com e deixe a IA identificar os campos para você.
Saiba mais ->
Scraper de Substack
Extraia contagens de assinantes do Substack, títulos de artigos e descrições de publicações em 2 cliques — depois exporte para Excel, Google Sheets ou Notion. Sem precisar de código; a IA do Thunderbit faz a estruturação para você.
Saiba mais ->Pronto para turbinar sua extração de dados?
Junte-se a mais de 200.000 profissionais que já usam a Thunderbit para automatizar seus fluxos de web scraping.
O teste grátis oferece créditos ilimitados para 8 páginas web.



