Scraper de Substack













Desbloqueie os dados do Substack com o Thunderbit
Envie dados do Substack diretamente para seus aplicativos
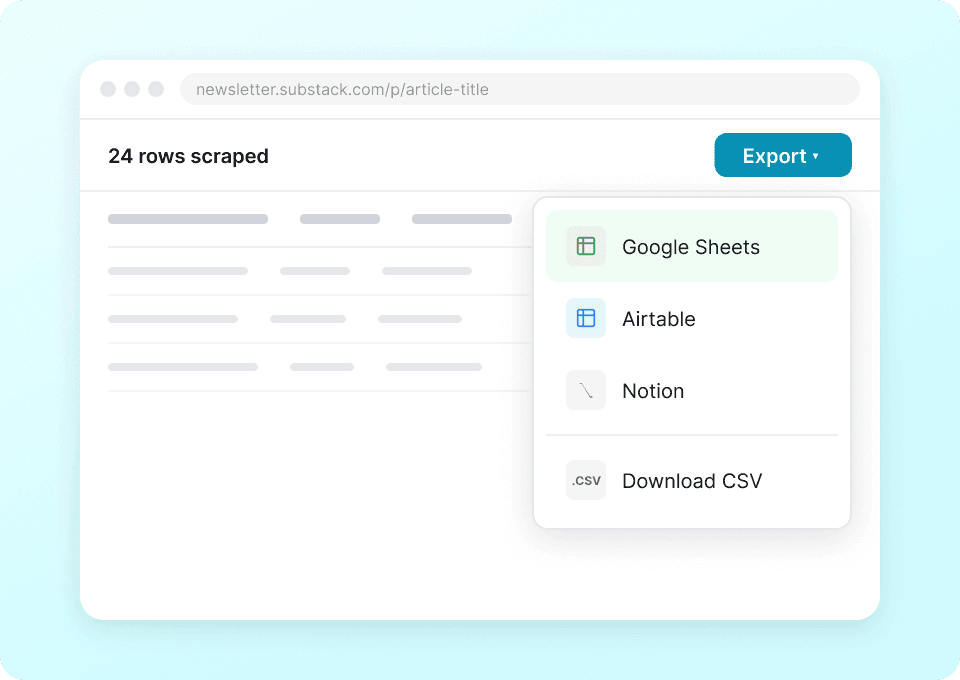
Pare de copiar e colar manualmente detalhes de publicações do Substack, como nomes de autores, títulos de artigos e contagens de assinantes. Com o Thunderbit, um único clique envia os dados extraídos diretamente para Google Sheets, Notion ou Airtable — assim, você pode analisar tendências de publicações e desempenho de conteúdo sem o trabalho manual repetitivo.
Um único scraper para o Substack e muito mais
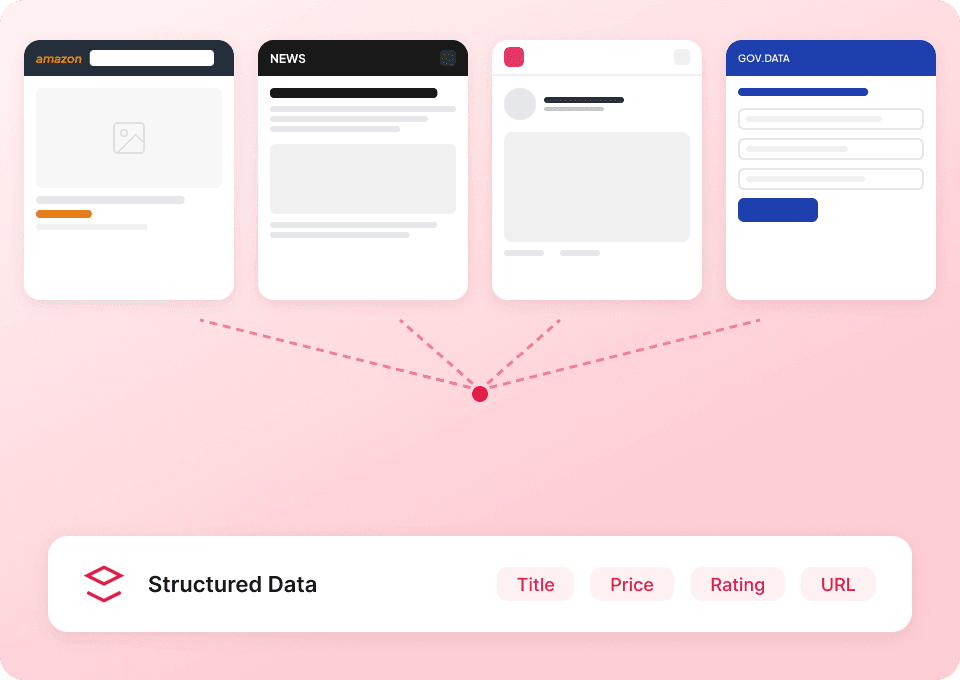
Você não precisa usar uma ferramenta diferente para cada site. O Thunderbit funciona no Substack desde o primeiro uso e inclui mais de 50 modelos prontos para outras plataformas populares. Extraia descrições de publicações, conteúdo de artigos e muito mais — depois use a mesma ferramenta para coletar dados de qualquer outro lugar na web.
Veja a história completa do Substack
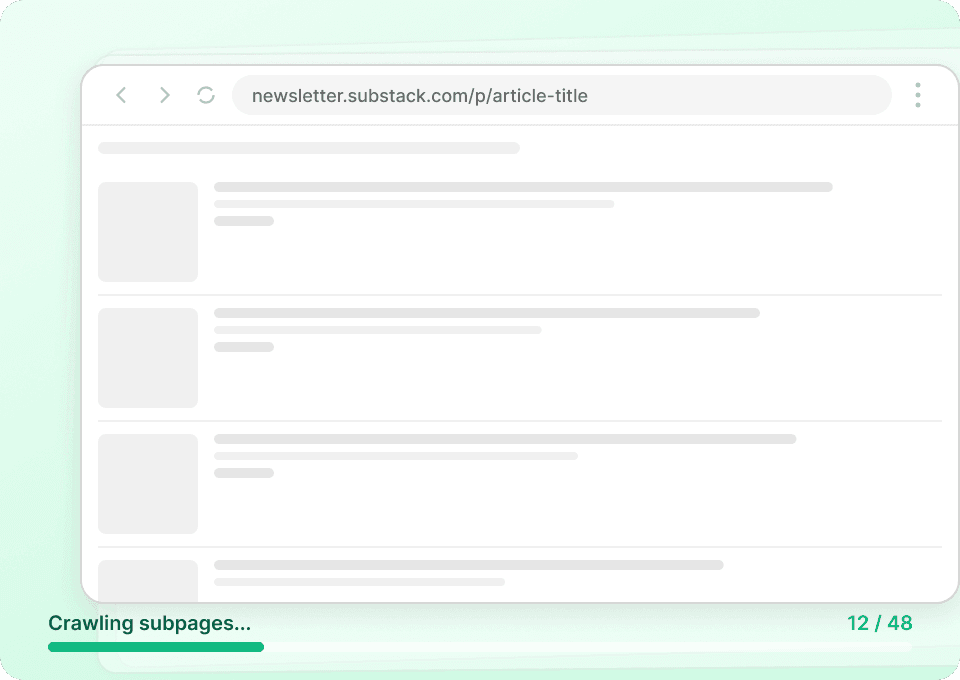
As páginas de listagem do Substack mostram apenas resumos. O Thunderbit visita automaticamente cada subpágina de artigo para capturar o conteúdo completo, entregando um conjunto de dados completo em uma única passada. Capture títulos de artigos, nomes de autores, nomes de publicações e o texto integral dos artigos — tudo sem abrir nenhuma página manualmente.
Está difícil extrair dados do Substack de forma eficiente?
Veja por que o Thunderbit supera scrapers tradicionais para dados do Substack.
Scrapers tradicionais
O jeito antigo de fazer as coisasThunderbit
A abordagem mais inteligente




Perguntas frequentes
Relacionados casos de uso
Explore mais casos de uso do web scraper da Thunderbit.

Raspador 4PDA
O Raspador Web 4PDA da Thunderbit permite extrair dados de artigos de notícias e postagens de fórum do 4PDA usando IA. Colete rapidamente títulos de artigos, datas de publicação, autores e conteúdos de postagens para pesquisa, análise ou acompanhamento de discussões tecnológicas. Perfeito para entusiastas de tecnologia, pesquisadores e profissionais de marketing que buscam dados estruturados do 4PDA.
Saiba mais ->
Raspador Ptt
O Raspador Web Ptt da Thunderbit permite extrair informações de fóruns e postagens do Ptt com sugestões inteligentes de campos baseadas em IA. Colete nomes de fóruns, URLs, popularidade, títulos de postagens, autores e comentários para pesquisas, marketing ou análise de conteúdo. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que precisam de dados estruturados do Ptt.
Saiba mais ->
Raspador de Mercado de Pizza
O Raspador Web de Pizza Marketplace da Thunderbit permite extrair dados das listas de notícias e diretórios de fornecedores do Pizza Marketplace. Com sugestões inteligentes de campos via IA, colete rapidamente títulos de notícias, datas de publicação, autores, nomes de fornecedores, localizações e contatos para pesquisas, marketing ou análises.
Saiba mais ->
Raspador Failory
O Raspador Failory da Thunderbit permite extrair dados estruturados do cemitério de startups e dos artigos de notícias do Failory. Utilize sugestões inteligentes de campos com IA para coletar nomes de startups, anos, motivos de falha, títulos de artigos, autores e muito mais para pesquisas ou análises. Perfeito para empreendedores, investidores e pesquisadores que buscam insights valiosos do Failory.
Saiba mais ->
Scraper do Investing.com
Extraia dados de ações — símbolos, preços, volume e valor de mercado — do Investing.com em 2 cliques e exporte diretamente para Google Sheets, Notion ou Excel. Abra qualquer página do Investing.com e deixe a IA identificar os campos para você.
Saiba mais ->
Raspador do TechCrunch
Extraia artigos do TechCrunch, atualizações de startups, títulos, links, datas, autores e resumos em 2 cliques — sem precisar programar. Exporte instantaneamente para Excel, Google Sheets ou Notion e transforme notícias brutas em dados estruturados e prontos para ação.
Saiba mais ->Pronto para turbinar sua extração de dados?
Junte-se a mais de 200.000 profissionais que já usam a Thunderbit para automatizar seus fluxos de web scraping.
O teste grátis oferece créditos ilimitados para 8 páginas web.



