Extrator de Artigos para Texto, Autores e Datas













Colete dados de artigos mesmo com mudanças no layout da página
Leia campos pelo significado, agende execuções recorrentes e use o mesmo fluxo de trabalho em sites públicos.
Adapte-se quando o layout do artigo mudar
O Thunderbit lê títulos visíveis, assinaturas, datas, resumos e texto do artigo com base no significado. O fluxo de trabalho depende menos de posições fixas na página quando um site de notícias altera o layout.
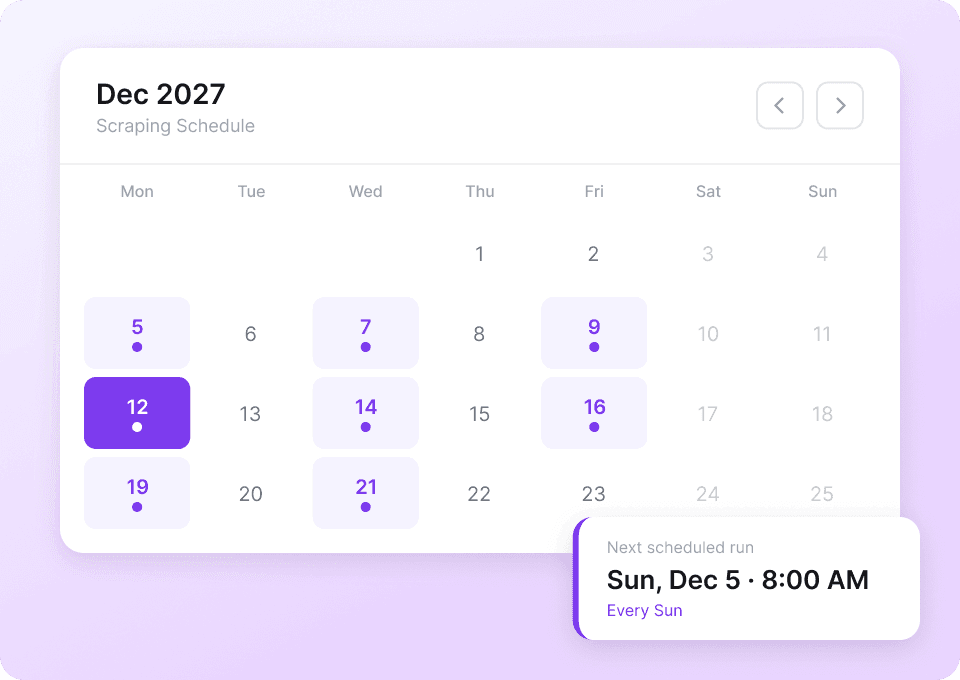
Execute a coleta de artigos em um cronograma
Defina uma execução recorrente para uma página pública de notícias, blog ou seção que você costuma visitar. O Thunderbit pode coletar os artigos visíveis mais recentes e enviar novas linhas para o arquivo ou app de sua escolha.
Use um único fluxo em qualquer site público
Use o mesmo fluxo de trabalho em qualquer site público com artigos. Nomeie os campos de que precisa e deixe o Thunderbit organizar cada página nas mesmas colunas.
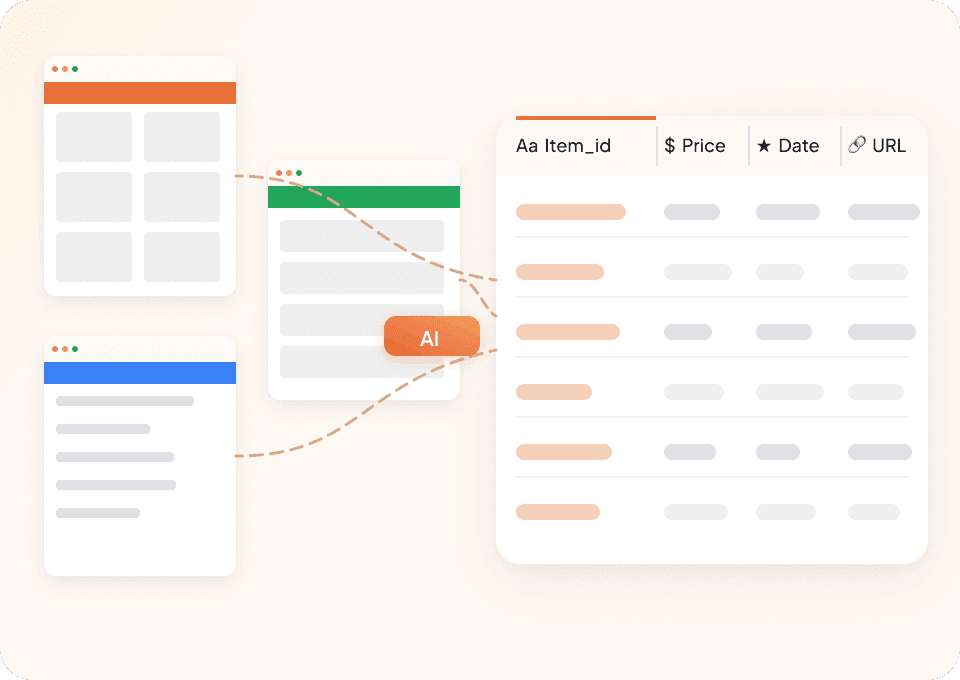
Um único fluxo de artigos para diferentes layouts de página
Seletores fixos seguem posições. A IA do Thunderbit procura os campos do artigo que você definiu.
Um mapa de seletores para cada publicador
Cada design de página precisa de manutenção separadaCampos do artigo organizados pelo Thunderbit
O registro solicitado permanece consistenteQuais dados você pode extrair de um artigo?
Escolha entre 30 campos visíveis de conteúdo, autor, publicador, data, links, tópicos, mídia e metadados da página.
- Título
- Título Alternativo
- Corpo do Artigo
- Resumo do Artigo
- Nome do Autor
- URL do Autor
- Organização do Autor
- Nome do Publicador
- URL do Publicador
- Data de Publicação
- Data de Modificação
- Seção do Artigo
- Palavras-chave
- Contagem de Palavras
- Idioma
- URL Canônica
- URL da Entidade Principal
- URL da Imagem
- Legenda da Imagem
- Crédito da Imagem
- URL do Vídeo
- URL do Áudio
- Linha de Dateline
- Tópicos sobre
- Menções
- Links de Citação
- URL da Licença
- Links de Artigos Relacionados
- Título da Página
- Meta Description
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.


Perguntas sobre a coleta de artigos públicos
Sites de notícias usam layouts e detalhes de página diferentes, então os campos obtidos dependem da página do artigo que você capturar.
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

Raspador 4PDA
O Raspador Web 4PDA da Thunderbit permite extrair dados de artigos de notícias e postagens de fórum do 4PDA usando IA. Colete rapidamente títulos de artigos, datas de publicação, autores e conteúdos de postagens para pesquisa, análise ou acompanhamento de discussões tecnológicas. Perfeito para entusiastas de tecnologia, pesquisadores e profissionais de marketing que buscam dados estruturados do 4PDA.
Saiba mais ->
Raspador Ptt
O Raspador Web Ptt da Thunderbit permite extrair informações de fóruns e postagens do Ptt com sugestões inteligentes de campos baseadas em IA. Colete nomes de fóruns, URLs, popularidade, títulos de postagens, autores e comentários para pesquisas, marketing ou análise de conteúdo. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que precisam de dados estruturados do Ptt.
Saiba mais ->
Raspador de Mercado de Pizza
O Raspador Web de Pizza Marketplace da Thunderbit permite extrair dados das listas de notícias e diretórios de fornecedores do Pizza Marketplace. Com sugestões inteligentes de campos via IA, colete rapidamente títulos de notícias, datas de publicação, autores, nomes de fornecedores, localizações e contatos para pesquisas, marketing ou análises.
Saiba mais ->
Raspador Failory
O Raspador Failory da Thunderbit permite extrair dados estruturados do cemitério de startups e dos artigos de notícias do Failory. Utilize sugestões inteligentes de campos com IA para coletar nomes de startups, anos, motivos de falha, títulos de artigos, autores e muito mais para pesquisas ou análises. Perfeito para empreendedores, investidores e pesquisadores que buscam insights valiosos do Failory.
Saiba mais ->
Scraper do Investing.com
Extraia dados de ações — símbolos, preços, volume e valor de mercado — do Investing.com em 2 cliques e exporte diretamente para Google Sheets, Notion ou Excel. Abra qualquer página do Investing.com e deixe a IA identificar os campos para você.
Saiba mais ->
Scraper de Substack
Extraia contagens de assinantes do Substack, títulos de artigos e descrições de publicações em 2 cliques — depois exporte para Excel, Google Sheets ou Notion. Sem precisar de código; a IA do Thunderbit faz a estruturação para você.
Saiba mais ->Pronto para turbinar sua extração de dados?
Junte-se a mais de 200.000 profissionais que já usam a Thunderbit para automatizar seus fluxos de web scraping.
O teste grátis oferece créditos ilimitados para 8 páginas web.



