Scraper TechCrunch













Odblokuj dane z TechCrunch w dwa kliknięcia
Proste scrapowanie TechCrunch w dwóch kliknięciach
Ręczne kopiowanie tytułów artykułów, autorów, dat publikacji czy pełnej treści z TechCrunch jest czasochłonne i męczące. Thunderbit pozwala całkowicie pominąć tę pracę. Po prostu wskaż potrzebne dane, a AI zrobi resztę. Dwa kliknięcia wystarczą, aby pobierać uporządkowane dane bez pisania ani jednej linijki kodu i bez skomplikowanej konfiguracji.
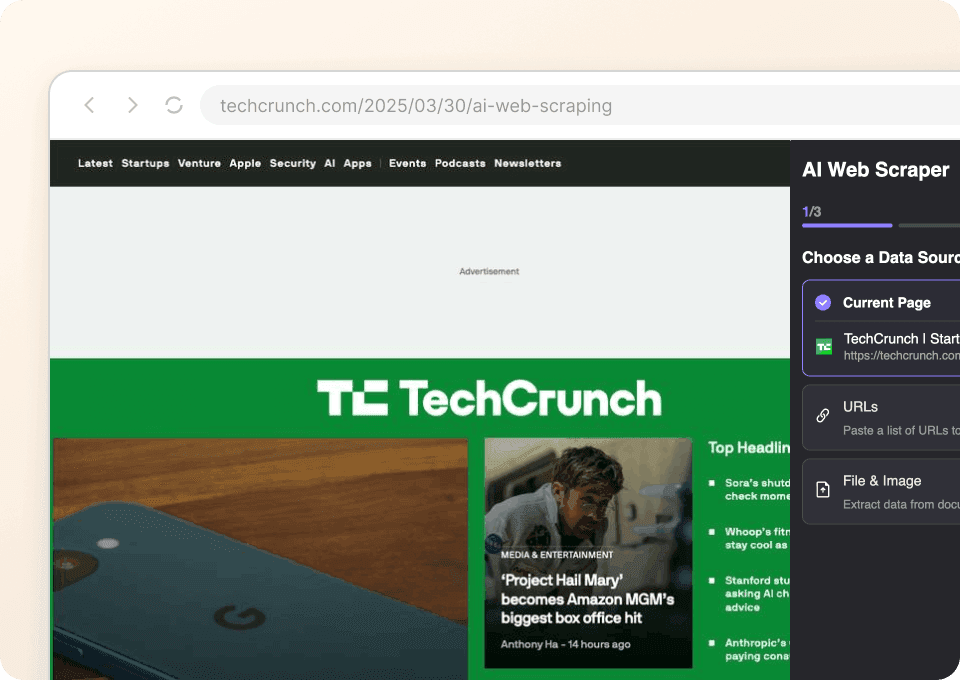
Otrzymuj czyste dane z TechCrunch od razu
Pobieranie surowego HTML z TechCrunch niewiele daje — potrzebujesz czystych, uporządkowanych danych. Thunderbit automatycznie czyści i formatuje informacje podczas ekstrakcji, dzięki czemu od razu możesz analizować kategorie artykułów, śledzić autorów lub porównywać daty publikacji. Eksportuj bezpośrednio do Google Sheets, Notion lub Airtable i pracuj na uporządkowanych danych od razu — bez ręcznego porządkowania.

Scrapuj dowolną stronę, nie tylko TechCrunch
Po co uczyć się nowego narzędzia dla każdej witryny? Thunderbit działa praktycznie na każdej stronie, w tym na TechCrunch. Dzięki ponad 50 gotowym szablonom możesz zacząć jeszcze szybciej. Niezależnie od tego, czy zbierasz treści artykułów, profile autorów czy tagi publikacji, Thunderbit jest jednym rozwiązaniem do ekstrakcji danych z całej sieci.
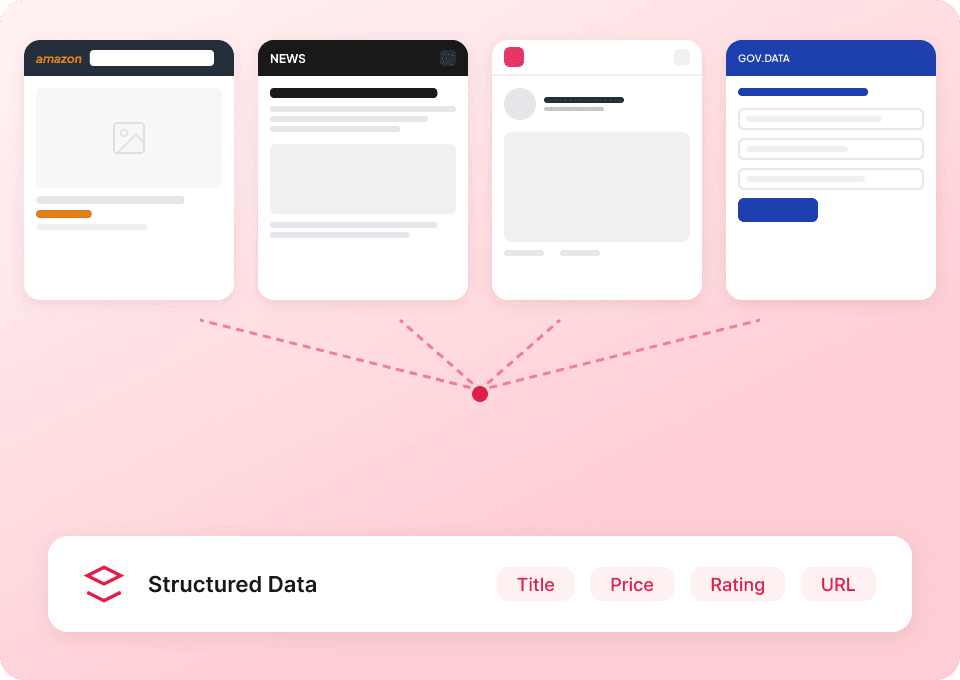
Masz problem z efektywnym scrapowaniem TechCrunch?
Zobacz, jak Thunderbit upraszcza ekstrakcję danych z TechCrunch w porównaniu z tradycyjnymi metodami.
Tradycyjne scrapery
Stary sposób działaniaThunderbit
Mądrzejsze podejście
Najczęściej zadawane pytania
Powiązane przypadki użycia
Poznaj więcej zastosowań web scrapera Thunderbit.

Investing.com scraper
Wyciągaj dane giełdowe — symbole, ceny, wolumen i kapitalizację rynkową — z Investing.com w 2 kliknięcia, a następnie eksportuj je bezpośrednio do Google Sheets, Notion lub Excela. Otwórz dowolną stronę Investing.com, a AI sama rozpozna potrzebne pola.
Dowiedz się więcej ->
Substack scraper
Wyciągaj liczbę subskrybentów Substack, tytuły artykułów i opisy publikacji w 2 kliknięcia — a potem eksportuj dane do Excela, Google Sheets lub Notion. Bez kodowania; AI Thunderbit zajmuje się strukturyzacją za Ciebie.
Dowiedz się więcej ->
Łatwy scraper ESPN
Śledź nazwiska sportowców, daty meczów i wyniki z ESPN w 2 kliknięciach dzięki AI Thunderbit — bez kodowania i bez konfiguracji. Eksportuj dane bezpośrednio do Excel, Google Sheets lub Notion i zacznij od razu wykorzystywać swoje dane sportowe.
Dowiedz się więcej ->
PubMed Scraper
PubMed Scraper od Thunderbit pomaga wyodrębniać uporządkowane dane z wyników wyszukiwania PubMed i stron artykułów z użyciem AI. Pobieraj trendy w badaniach medycznych, dowody z badań klinicznych, abstrakty, autorów, afiliacje, daty publikacji i linki, a następnie eksportuj wszystko do Excel, Google Sheets, Airtable lub Notion.
Dowiedz się więcej ->
Narzędzie do wyodrębniania artykułów: tekst, autorzy i daty
Zbieraj nagłówki, imiona i nazwiska autorów, daty, streszczenia, treść artykułów, linki i multimedia z publicznych stron z artykułami. Zachowuj wszystkie informacje o każdym artykule w jednym przejrzystym wierszu, nawet gdy serwisy informacyjne korzystają z różnych układów.
Dowiedz się więcej ->
Pobieranie wiadomości: połącz nagłówki z pełnymi szczegółami artykułów
Zbierz nagłówki ze stron tematycznych, działów lub wyników wyszukiwania, a następnie otwórz linki do artykułów, aby pobrać widoczne podpisy autorów, daty publikacji, streszczenia, sekcje i adresy źródłowe. Przed uruchomieniem powiedz Thunderbit prostym językiem, które szczegóły artykułu są dla Ciebie najważniejsze.
Dowiedz się więcej ->Gotowy, by przyspieszyć ekstrakcję danych?
Dołącz do ponad 200 000 profesjonalistów, którzy już używają Thunderbit do automatyzacji procesów web scrapingu.
Darmowy okres próbny zapewnia nielimitowane kredyty na 8 stron.



