Narzędzie do wyodrębniania artykułów: tekst, autorzy i daty













Zbieraj dane z artykułów mimo zmieniających się układów stron
Odczytuj pola na podstawie znaczenia, planuj cykliczne uruchomienia i korzystaj z tego samego procesu na publicznych stronach.
Dostosuj się do zmian w układzie artykułów
Thunderbit odczytuje widoczne nagłówki, podpisy autorów, daty, streszczenia i treść artykułów na podstawie znaczenia. Ten proces mniej zależy od sztywnych pozycji na stronie, gdy serwis informacyjny zmienia układ.
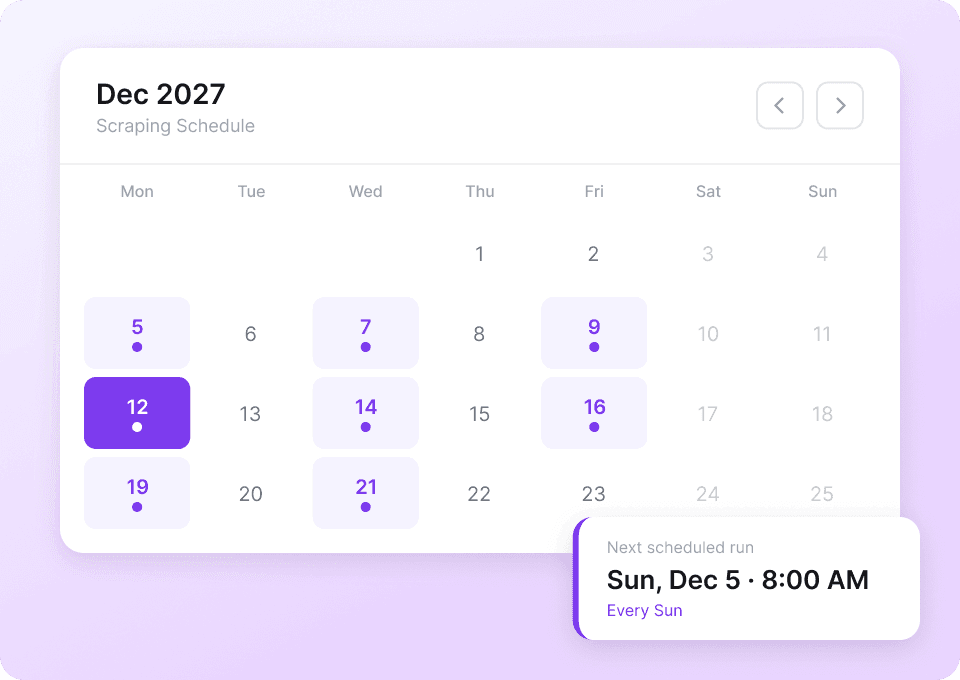
Uruchamiaj pobieranie artykułów zgodnie z harmonogramem
Ustaw cykliczne uruchomienie dla publicznej strony wiadomości, bloga lub sekcji, którą regularnie odwiedzasz. Thunderbit może zbierać najnowsze widoczne artykuły i wysyłać nowe wiersze do wybranego pliku lub aplikacji.
Użyj jednego procesu na dowolnej publicznej stronie
Stosuj ten sam proces na dowolnej publicznej stronie z artykułami. Nazwij potrzebne pola, a Thunderbit umieści dane z każdej strony w tych samych kolumnach.
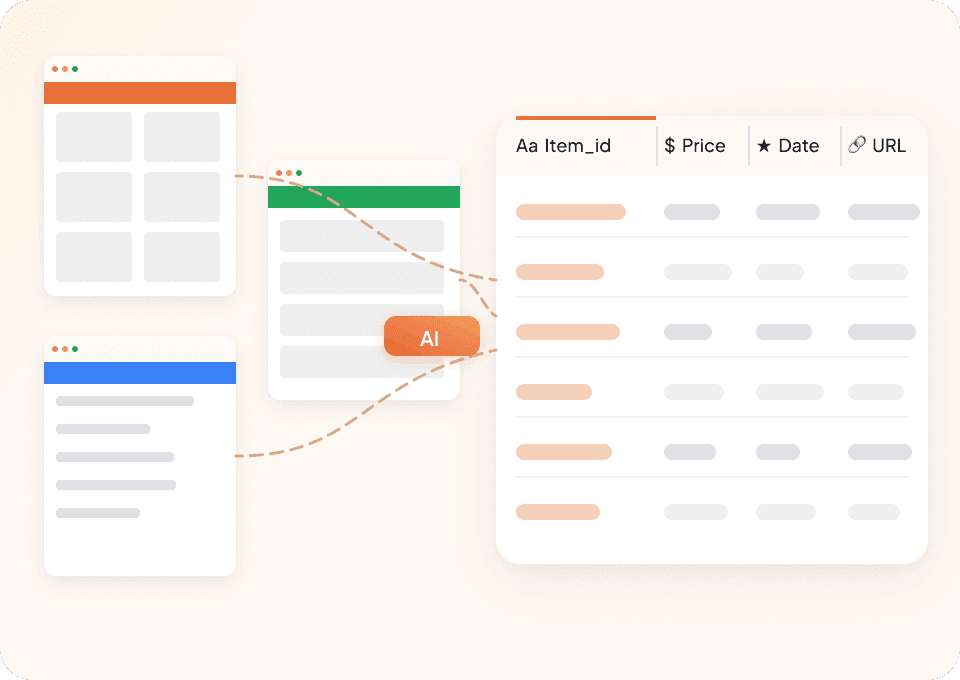
Jeden proces dla artykułów w różnych układach stron
Sztywne selektory opierają się na pozycjach. AI Thunderbit szuka wskazanych przez Ciebie pól artykułu.
Mapa selektorów dla każdego wydawcy
Każdy projekt strony wymaga osobnej konserwacjiPola artykułu uporządkowane przez Thunderbit
Żądany rekord pozostaje spójnyJakie dane możesz wyodrębnić z artykułu?
Wybieraj spośród 30 widocznych pól dotyczących treści, autora, wydawcy, daty, linków, tematów, multimediów i metadanych strony.
- Nagłówek
- Alternatywny nagłówek
- Treść artykułu
- Streszczenie artykułu
- Imię i nazwisko autora
- URL autora
- Organizacja autora
- Nazwa wydawcy
- URL wydawcy
- Data publikacji
- Data modyfikacji
- Sekcja artykułu
- Słowa kluczowe
- Liczba słów
- Język
- Kanoniczny URL
- URL głównego bytu
- URL obrazu
- Opis obrazu
- Źródło obrazu
- URL wideo
- URL audio
- Dateline
- Tematy
- Wzmianki
- Linki cytowań
- URL licencji
- Powiązane linki do artykułów
- Tytuł strony
- Meta description
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.

Pytania o pobieranie publicznych artykułów
Serwisy informacyjne używają różnych układów i szczegółów strony, więc uzyskane pola zależą od konkretnej strony artykułu, którą przechwytujesz.
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

Investing.com scraper
Wyciągaj dane giełdowe — symbole, ceny, wolumen i kapitalizację rynkową — z Investing.com w 2 kliknięcia, a następnie eksportuj je bezpośrednio do Google Sheets, Notion lub Excela. Otwórz dowolną stronę Investing.com, a AI sama rozpozna potrzebne pola.
Dowiedz się więcej ->
Substack scraper
Wyciągaj liczbę subskrybentów Substack, tytuły artykułów i opisy publikacji w 2 kliknięcia — a potem eksportuj dane do Excela, Google Sheets lub Notion. Bez kodowania; AI Thunderbit zajmuje się strukturyzacją za Ciebie.
Dowiedz się więcej ->
Scraper TechCrunch
Wyodrębnij artykuły TechCrunch, aktualizacje ze świata startupów, tytuły, linki, daty, autorów i podsumowania w 2 kliknięcia — bez kodowania. Eksportuj od razu do Excel, Google Sheets lub Notion i zamieniaj surowe wiadomości w uporządkowane, praktyczne dane.
Dowiedz się więcej ->
Łatwy scraper ESPN
Śledź nazwiska sportowców, daty meczów i wyniki z ESPN w 2 kliknięciach dzięki AI Thunderbit — bez kodowania i bez konfiguracji. Eksportuj dane bezpośrednio do Excel, Google Sheets lub Notion i zacznij od razu wykorzystywać swoje dane sportowe.
Dowiedz się więcej ->
PubMed Scraper
PubMed Scraper od Thunderbit pomaga wyodrębniać uporządkowane dane z wyników wyszukiwania PubMed i stron artykułów z użyciem AI. Pobieraj trendy w badaniach medycznych, dowody z badań klinicznych, abstrakty, autorów, afiliacje, daty publikacji i linki, a następnie eksportuj wszystko do Excel, Google Sheets, Airtable lub Notion.
Dowiedz się więcej ->
Pobieranie wiadomości: połącz nagłówki z pełnymi szczegółami artykułów
Zbierz nagłówki ze stron tematycznych, działów lub wyników wyszukiwania, a następnie otwórz linki do artykułów, aby pobrać widoczne podpisy autorów, daty publikacji, streszczenia, sekcje i adresy źródłowe. Przed uruchomieniem powiedz Thunderbit prostym językiem, które szczegóły artykułu są dla Ciebie najważniejsze.
Dowiedz się więcej ->Gotowy, by przyspieszyć ekstrakcję danych?
Dołącz do ponad 200 000 profesjonalistów, którzy już używają Thunderbit do automatyzacji procesów web scrapingu.
Darmowy okres próbny zapewnia nielimitowane kredyty na 8 stron.



