PubMed Scraper od Thunderbit pomaga zamieniać strony PubMed w czyste, uporządkowane zbiory danych z użyciem AI. Możesz wyodrębniać trendy w badaniach medycznych, dowody z badań klinicznych, abstrakty, autorów, afiliacje, daty publikacji, PMID oraz linki do artykułów, a następnie eksportować dane do Excel, Google Sheets, Airtable lub Notion. Wystarczy otworzyć PubMed w Chrome, pozwolić AI zasugerować najlepsze kolumny i uruchomić scraping.
🧬 Czym jest PubMed Scraper
PubMed Scraper to AI Web Scraper stworzony dla PubMed | US National Library of Medicine. Dzięki Thunderbit (rozszerzeniu Chrome do web scrapingu z AI) możesz wejść na dowolną stronę wyników PubMed, kliknąć AI Suggest Columns, a potem Scrape, aby pobrać uporządkowane dane bez pisania kodu.
🔎 Co można wyciągnąć z PubMed
PubMed zawiera mnóstwo wartościowych metadanych biomedycznych, ale nie zawsze są one od razu gotowe do analizy. AI Web Scraper od Thunderbit (https://thunderbit.com/) pomaga zbierać i porządkować wpisy z PubMed, a także wzbogacać je o szczegóły na poziomie artykułu dzięki Subpage Scraping (otwieraniu każdej strony artykułu i dopisywaniu pól takich jak abstrakt, afiliacje, DOI i inne).
Poniżej znajdziesz dwa popularne workflow, które możesz uruchomić w kilka minut.
📈 Scrape PubMed Trending Medical Research Monitoring
Użyj tego workflow, aby śledzić, co jest aktualnie na czasie w badaniach medycznych na stronie trendów PubMed. Sprawdza się świetnie do bieżącego monitoringu, tworzenia wewnętrznych digestów, obserwowania publikacji konkurencji albo zasilania pipeline’u do monitorowania literatury.
Przykładowa strona docelowa: PubMed Trending
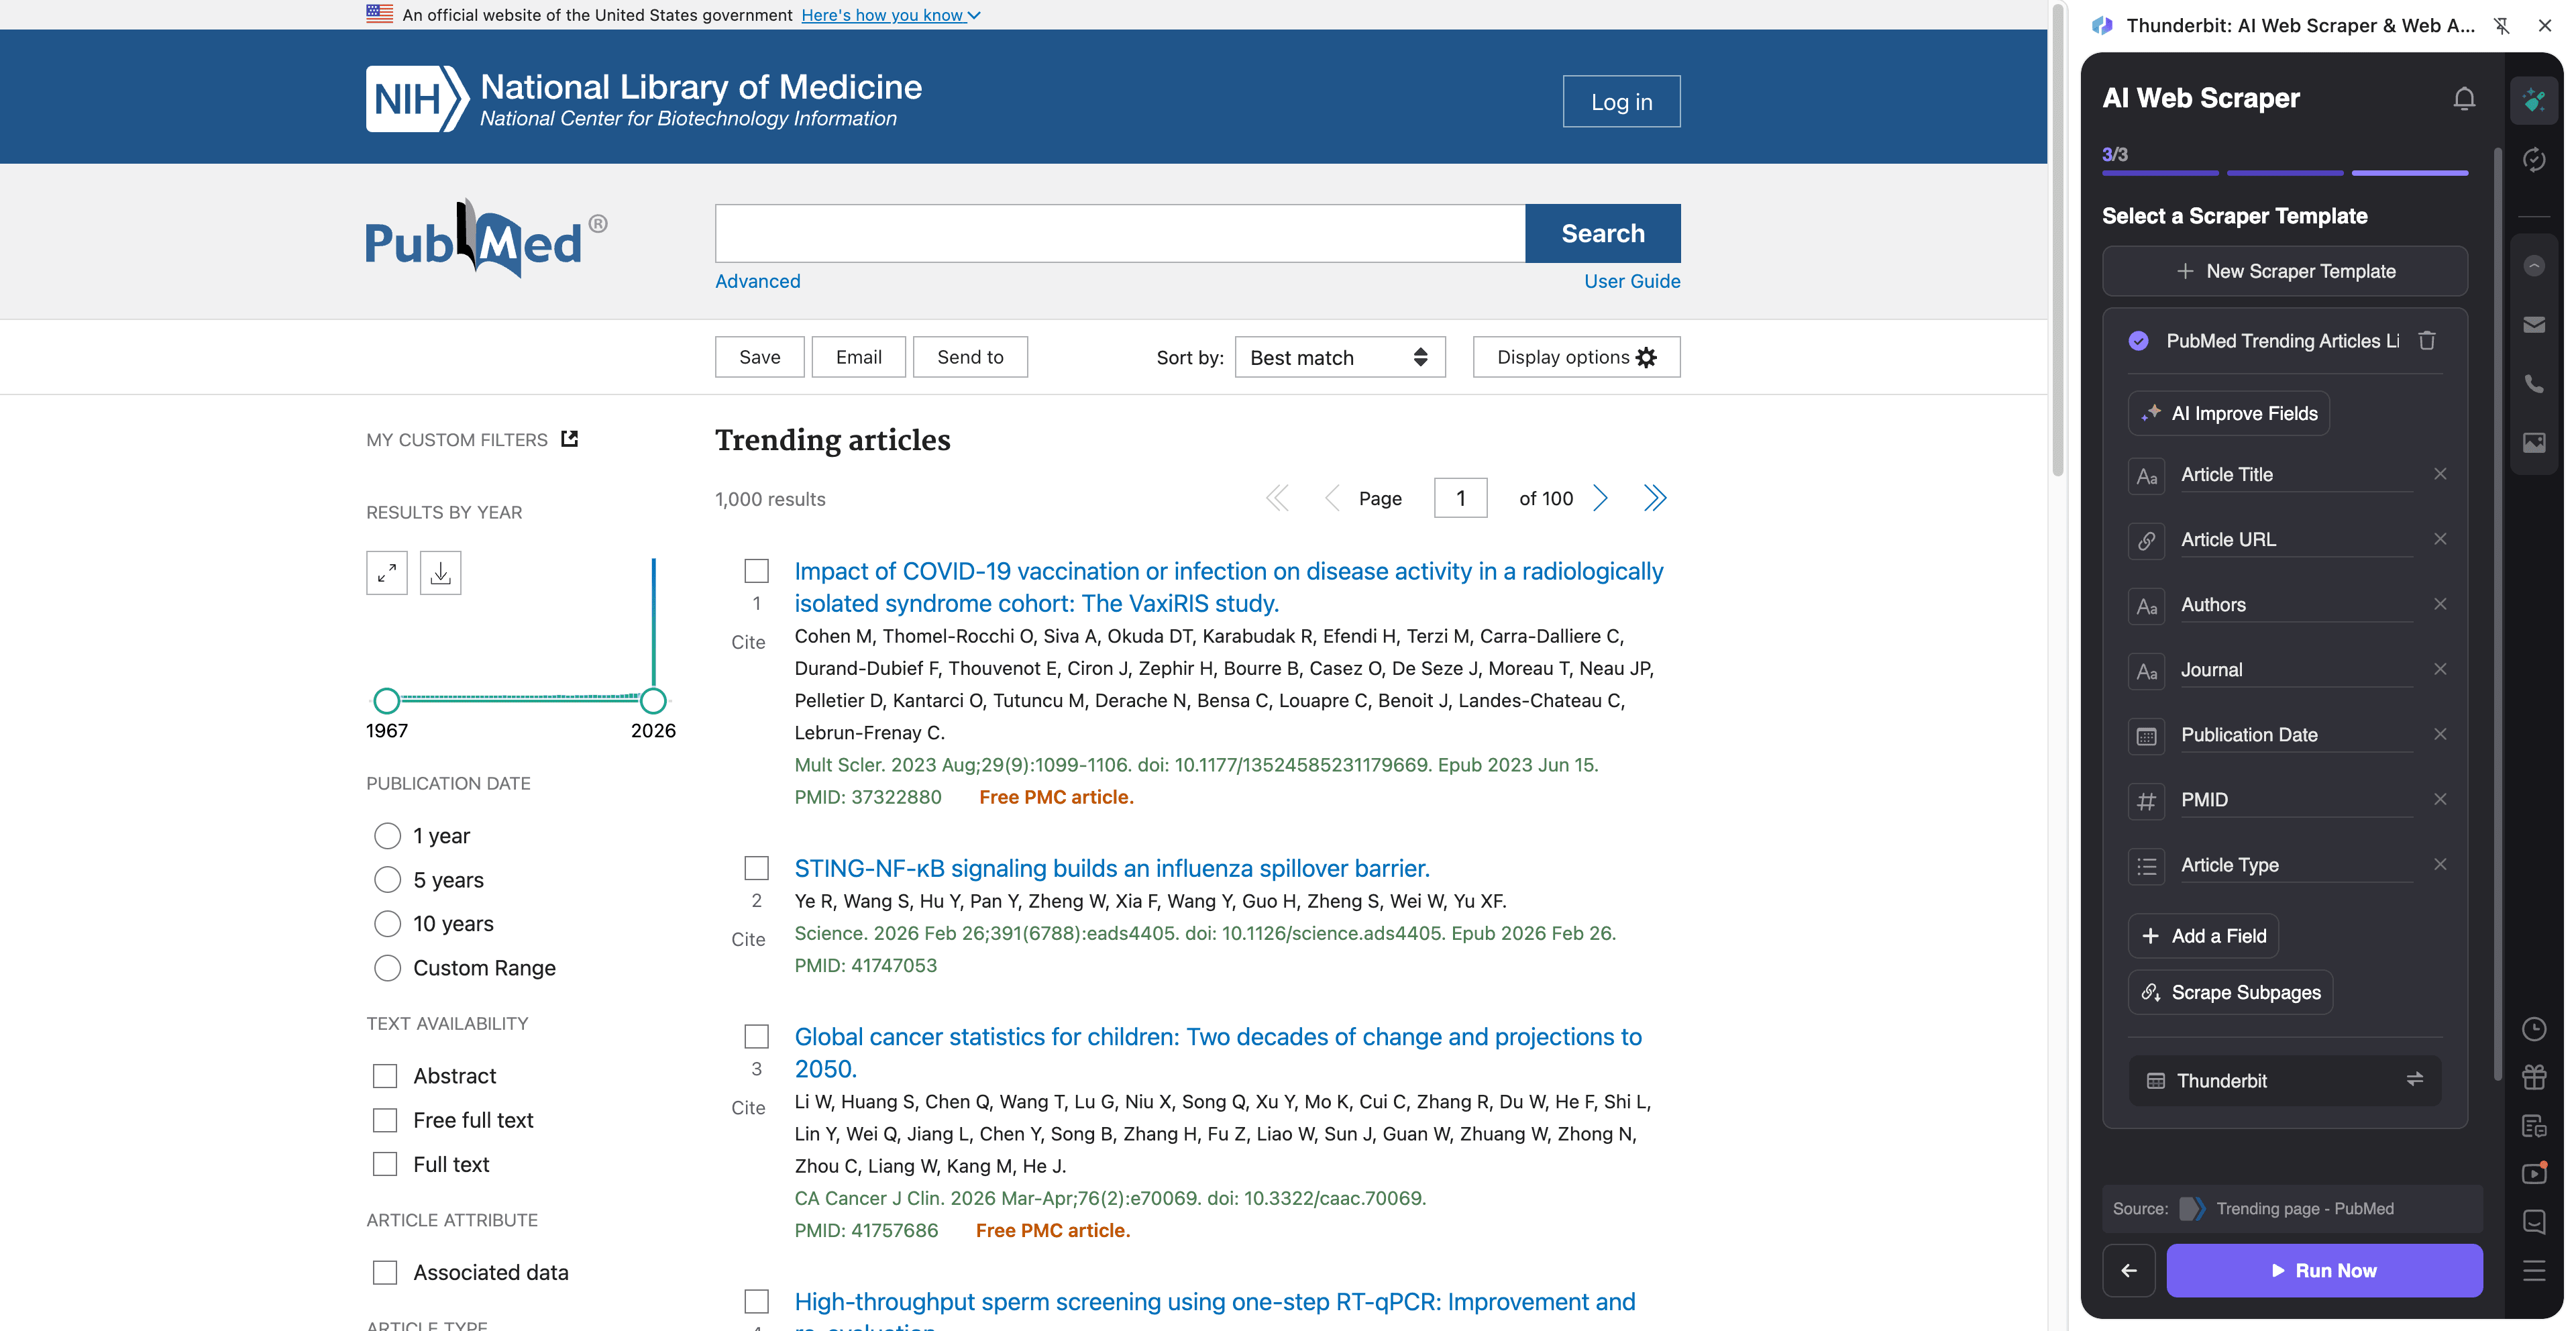
Kroki:
- Pobierz Thunderbit Chrome Extension i załóż konto.
- Wejdź na stronę docelową, np. PubMed Trending.
- Kliknij AI Suggest Columns, aby AI zaproponowała najlepsze nazwy kolumn i typy danych.
- Kliknij Scrape, aby pobrać dane, a potem wyeksportuj je do Excel, Google Sheets, Airtable lub Notion.
Nazwy kolumn
| Kolumna | Opis |
|---|---|
| 🧾 Tytuł artykułu | Tytuł trendującego artykułu z PubMed. |
| 🔗 URL artykułu | Bezpośredni link do rekordu na PubMed. |
| 🆔 PMID | Identyfikator PubMed dla rekordu (przydatny jako stabilny klucz). |
| 🏛️ Czasopismo | Nazwa czasopisma, w którym opublikowano artykuł. |
| 📅 Data publikacji | Data publikacji widoczna na liście. |
| ✍️ Autorzy | Ciąg nazw autorów pokazany na karcie wyniku. |
| 🧪 Typ artykułu | Typ publikacji, jeśli jest dostępny (np. Review, Clinical Trial). |
| 🏷️ Słowa kluczowe / tematy | Widoczne tagi tematów lub słowa kluczowe na liście (jeśli są). |
| 📝 Fragment / podsumowanie | Krótki fragment tekstu pokazany na liście (jeśli jest). |
| 🧷 DOI | DOI, jeśli dostępny (najlepiej często pobierany przez scraping podstron). |
| 🧑🔬 Afiliacje | Afiliacje autorów (zazwyczaj wyodrębniane przez scraping podstron). |
| 📄 Abstrakt | Treść abstraktu (zazwyczaj wyodrębniana przez scraping podstron). |
🧫 Scrape PubMed Clinical Trial Evidence Extraction
Użyj tego workflow, aby wyodrębniać dowody związane z badaniami klinicznymi z wyników wyszukiwania PubMed, a następnie wzbogacić każdy wiersz, odwiedzając stronę artykułu i pobierając abstrakt, sygnały dotyczące trialu oraz metadane potrzebne do analizy.
Przykładowa strona docelowa: Clinical trial search results
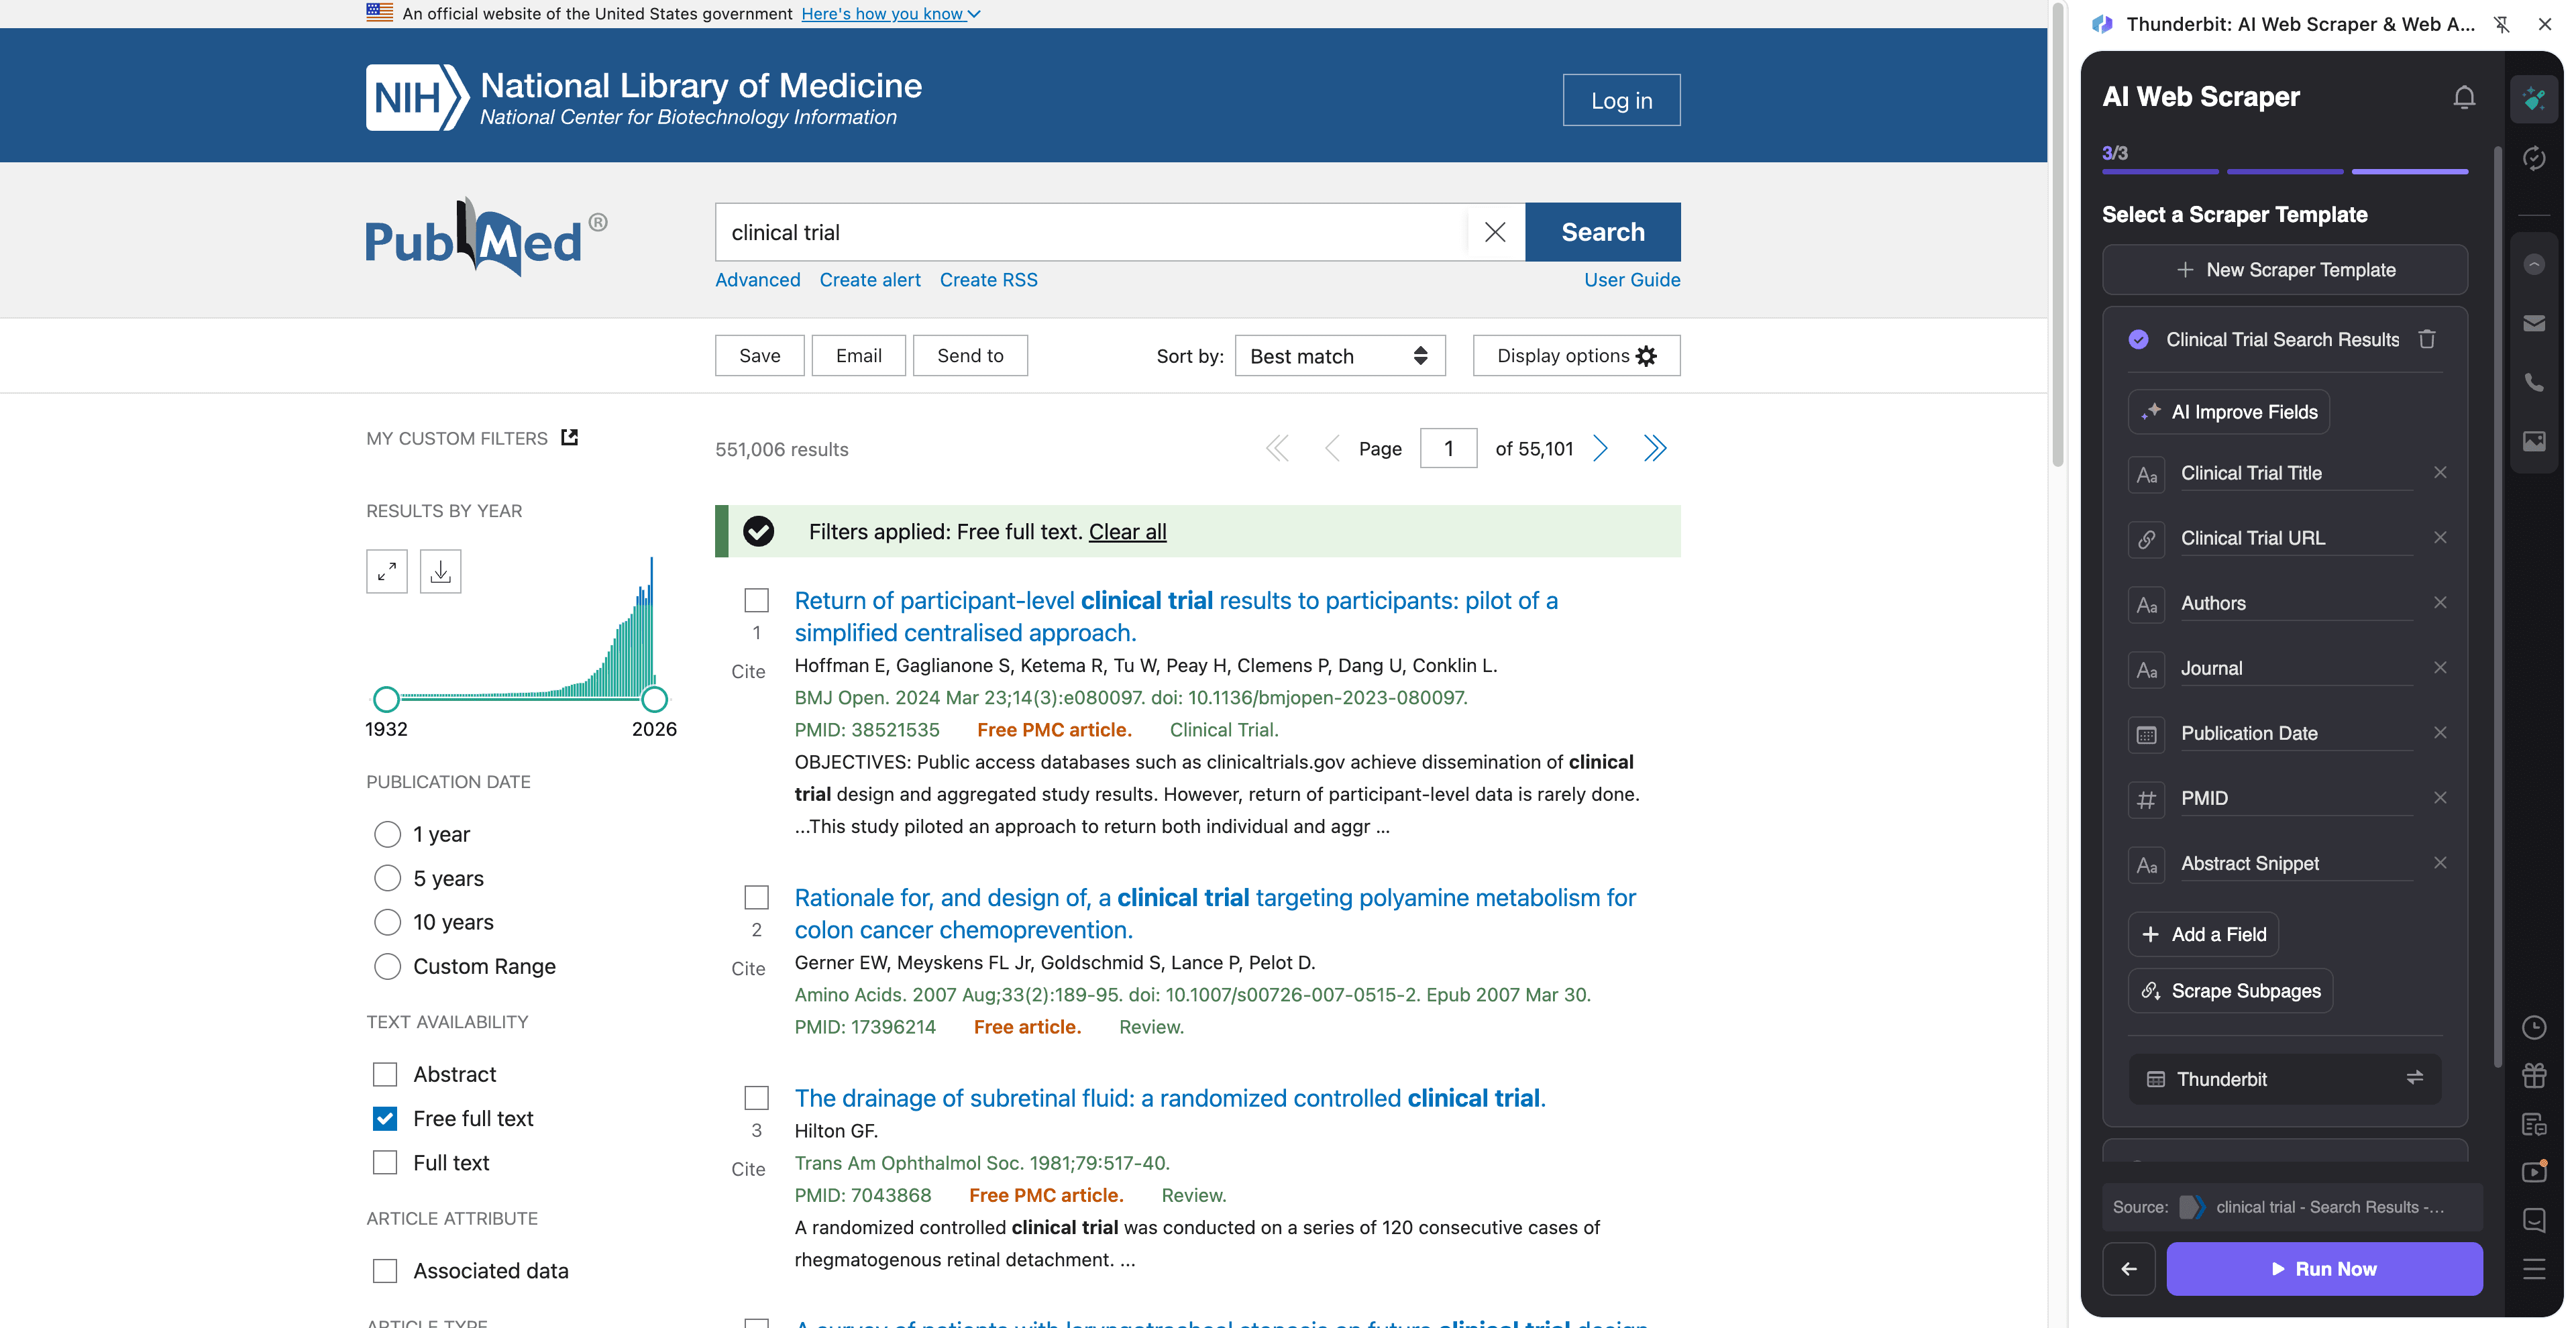
Kroki:
- Pobierz Thunderbit Chrome Extension i załóż konto.
- Wejdź na stronę docelową, np. Clinical trial search results.
- Kliknij AI Suggest Columns, aby wygenerować proponowane pola (możesz je zmienić lub dodać własne).
- Kliknij Scrape, aby zebrać wyniki, a następnie użyj Scrape Subpages, aby wzbogacić każdy wiersz o abstrakt, afiliacje, DOI i inne dane.
Nazwy kolumn
| Kolumna | Opis |
|---|---|
| 🧾 Tytuł | Tytuł artykułu z wyników wyszukiwania. |
| 🔗 URL PubMed | Link do strony artykułu na PubMed do wzbogacania danych z podstrony. |
| 🆔 PMID | Identyfikator PubMed do deduplikacji i odwołań. |
| 🧑⚕️ Autorzy | Autorzy wymienieni w podglądzie wyniku. |
| 🏛️ Czasopismo | Nazwa czasopisma i informacje cytowania widoczne w wynikach. |
| 📅 Data | Data publikacji (lub data ePub) widoczna na liście. |
| 🧪 Typ publikacji | Sygnały takie jak Clinical Trial, Randomized Controlled Trial, Meta-Analysis (często czytelniejsze na stronie artykułu). |
| 🧾 Abstrakt | Pełny tekst abstraktu (najlepiej przez scraping podstron). |
| 🧬 Terminy MeSH | Medical Subject Headings, jeśli dostępne (często na stronie artykułu). |
| 🧷 DOI | DOI do linkowania do strony wydawcy i narzędzi do zarządzania bibliografią. |
| 🏥 Afiliacje | Afiliacje autorów do analizy instytucji (scraping podstron). |
| 🌍 Kraj / instytucja | Wyodrębniane z afiliacji za pomocą Field AI Prompts (opcjonalnie). |
| 🔍 Słowa kluczowe dotyczące badań klinicznych | Flagi nadawane przez AI, np. „randomized”, „double-blind”, „placebo” (opcjonalnie przez Field AI Prompt). |
| 📎 Linki do pełnego tekstu | Linki wychodzące do wydawcy lub darmowego pełnego tekstu, jeśli są dostępne. |
🎯 Dlaczego warto używać narzędzia PubMed
Scraping PubMed to przede wszystkim szybkość, spójność i możliwość wykorzystania danych badawczych w całym procesie pracy. Zamiast kopiować cytowania jedno po drugim, możesz zbudować uporządkowany zbiór danych, który da się filtrować, tagować i udostępniać.
Najczęstsze powody, dla których zespoły korzystają ze scrapingu PubMed:
- Zespoły medical affairs i pharma: śledzenie nowych publikacji w danym obszarze terapeutycznym, monitorowanie badań konkurencji i tworzenie tabel dowodowych do wewnętrznych przeglądów.
- Biotech i kliniczne zespoły operacyjne: zbieranie publikacji związanych z badaniami klinicznymi, mapowanie instytucji i badaczy oraz prowadzenie żywej bibliografii.
- Marketing medyczny i zespoły contentowe: identyfikowanie trendujących tematów, czasopism o dużym wpływie i nowych słów kluczowych do planowania treści.
- Badacze akademiccy i bibliotekarze: budowanie zbiorów do przeglądów literatury, deduplikacja po PMID i eksport do arkuszy do dalszej selekcji.
- Zespoły data: tworzenie uporządkowanych danych wejściowych do analiz, dashboardów lub wewnętrznych baz wiedzy.
Thunderbit szczególnie pomaga wtedy, gdy potrzebujesz czegoś więcej niż tylko listy wyników. Dzięki Subpage Scraping możesz pobierać na dużą skalę abstrakty, afiliacje, DOI, terminy MeSH i linki do pełnych tekstów.
🧩 Jak używać rozszerzenia Chrome do PubMed
- Zainstaluj Thunderbit Chrome Extension: pobierz je z Chrome Web Store i utwórz konto.
- Wejdź na stronę PubMed: otwórz PubMed, stronę trendów, np. Trending, albo zapytanie takie jak clinical trial results.
- Uruchom scraper oparty na AI: kliknij AI Suggest Columns, aby wygenerować pola, dopasuj typy danych (text/date/url) i dodaj opcjonalne Field AI Prompts (do etykietowania, formatowania lub wyodrębniania sygnałów dotyczących triali).
- Zeskrob dane i wyeksportuj je: kliknij Scrape. Jeśli potrzebujesz abstraktów/afiliacji/MeSH, uruchom Scrape Subpages, aby wzbogacić każdy wiersz, a następnie eksportuj do Excel, Google Sheets, Airtable lub Notion.
Przydatne materiały, jeśli budujesz powtarzalny workflow:
- Jak zeskrobać dowolną stronę internetową z użyciem AI
- Czym jest data scraping i jak zrobić to w 2025 roku
- Jak zeskrobać dane ze strony do Excela z użyciem AI
- Czym jest list crawling i jak zrobić to z użyciem AI
💳 Cennik PubMed
Thunderbit korzysta z prostego systemu kredytów:
- 1 kredyt = 1 wiersz wynikowy w tabeli rezultatów (na przykład jeden rekord PubMed).
- Eksport danych jest darmowy: pobierz CSV/JSON albo wyślij dane do Excel, Google Sheets, Airtable lub Notion.
Możesz zacząć od:
- Darmowy plan: zeskrob 6 stron miesięcznie (limit oparty na liczbie stron w Free).
- Darmowy okres próbny: zeskrob 10 stron za darmo, co idealnie nadaje się do testowania stron PubMed Trending i kilku stron z wynikami badań klinicznych.
Jeśli korzystasz ze scrapingu regularnie (cotygodniowy monitoring, aktualizacje dowodów lub duże zapytania), płatne plany zapewniają więcej kredytów. Plan roczny zwykle jest bardziej opłacalny, ponieważ obejmuje zniżkę w porównaniu z płatnością miesiąc do miesiąca.
Opcje znajdziesz na stronie Thunderbit Pricing.
❓ FAQ
-
Czym jest AI Powered PubMed Scraper?
AI Powered PubMed Scraper to workflow w Thunderbit, który pobiera uporządkowane dane z wyników wyszukiwania PubMed i stron artykułów. Możesz użyć AI do sugerowania kolumn, zeskrobania listy wyników i wzbogacenia każdego wiersza przez otwarcie podstron artykułów, aby pobrać abstrakty, afiliacje, DOI i inne informacje. -
Czym jest Thunderbit?
Thunderbit to rozszerzenie Chrome do web scrapingu z AI, stworzone z myślą o workflow biznesowych i badawczych, w których potrzebujesz uporządkowanych danych ze stron internetowych. Pomaga szybko wyodrębniać, etykietować i eksportować dane bez budowania ani utrzymywania skryptów do scrapingu. -
Czy można zeskrobać strony PubMed Trending i zwykłe wyniki wyszukiwania?
Tak. Możesz zeskrobać stronę PubMed Trending, standardowe wyszukiwania po słowach kluczowych oraz filtrowane strony wyników (np. zapytania skupione na badaniach klinicznych). AI Thunderbit dopasowuje się do różnych układów, analizując stronę i proponując pola. -
Czy Thunderbit potrafi wyodrębnić abstrakty, afiliacje i terminy MeSH?
Tak, i właśnie tutaj najlepiej sprawdza się Subpage Scraping. Najpierw możesz zeskrobać listę wyników, a potem pozwolić Thunderbit otworzyć każdą stronę rekordu PubMed, aby pobrać tekst abstraktu, afiliacje, terminy MeSH, DOI i inne metadane do tej samej tabeli. -
Jak działa paginacja i infinite scroll w PubMed?
Thunderbit obsługuje scraping z paginacją, w tym nawigację typu „następna strona”. Jeśli PubMed zmienia sposób ładowania wyników, ekstrakcja oparta na AI jest bardziej odporna niż sztywne selektory, ponieważ przy każdym uruchomieniu ponownie odczytuje strukturę strony. -
Do jakich formatów mogę eksportować dane z PubMed?
Możesz eksportować do CSV lub JSON albo wysłać zbiór danych do Excel, Google Sheets, Airtable lub Notion. Jest to przydatne przy screeningu, tworzeniu tabel dowodowych, dashboardów i udostępnianiu wyników współpracownikom. -
Ile rekordów PubMed mogę zeskrobać za darmo?
W planie Free możesz zeskrobać 6 stron miesięcznie, co często wystarcza do niewielkich zadań monitoringowych. W darmowym okresie próbnym możesz zeskrobać 10 stron za darmo, aby sprawdzić konfigurację kolumn i strategię wzbogacania danych z podstron. -
Czy mogę dostosować kolumny do konkretnych potrzeb ekstrakcji dowodów?
Tak. Możesz zmieniać nazwy kolumn, ustawiać typy danych (text/date/url) i dodawać Field AI Prompts, aby wyodrębniać lub etykietować informacje takie jak słowa kluczowe dotyczące projektu badania, populacja, interwencja, komparator, wyniki czy kraj na podstawie afiliacji. Dzięki temu wyjdziesz poza zwykły scraping do bardziej uporządkowanego przygotowania dowodów. -
Czy scraping PubMed jest dozwolony?
PubMed to publiczne źródło, a wiele zespołów zbiera metadane bibliograficzne do badań i analiz. Nadal jednak warto przestrzegać obowiązujących przepisów, zasad serwisu i dobrych praktyk odpowiedzialnego scrapingu, zwłaszcza przy dużych i częstych zadaniach.
📚 Dowiedz się więcej
- Pobierz rozszerzenie: Thunderbit Chrome Extension Download Page
- Przeglądaj poradniki na Thunderbit Blog
- Poznaj podstawy: Czym jest data scraping i jak zrobić to w 2025 roku
- Buduj workflow do list: Czym jest list crawling i jak zrobić to z użyciem AI
- Eksportuj do arkuszy: Jak zeskrobać dane ze strony do Excela z użyciem AI
- Jeśli w badaniach operacyjnych scrapujesz też PDF-y: Jak wyodrębnić dane z PDF z użyciem AI