Substack scraper













Odblokuj dane Substack dzięki Thunderbit
Wysyłaj dane z Substack bezpośrednio do swoich aplikacji
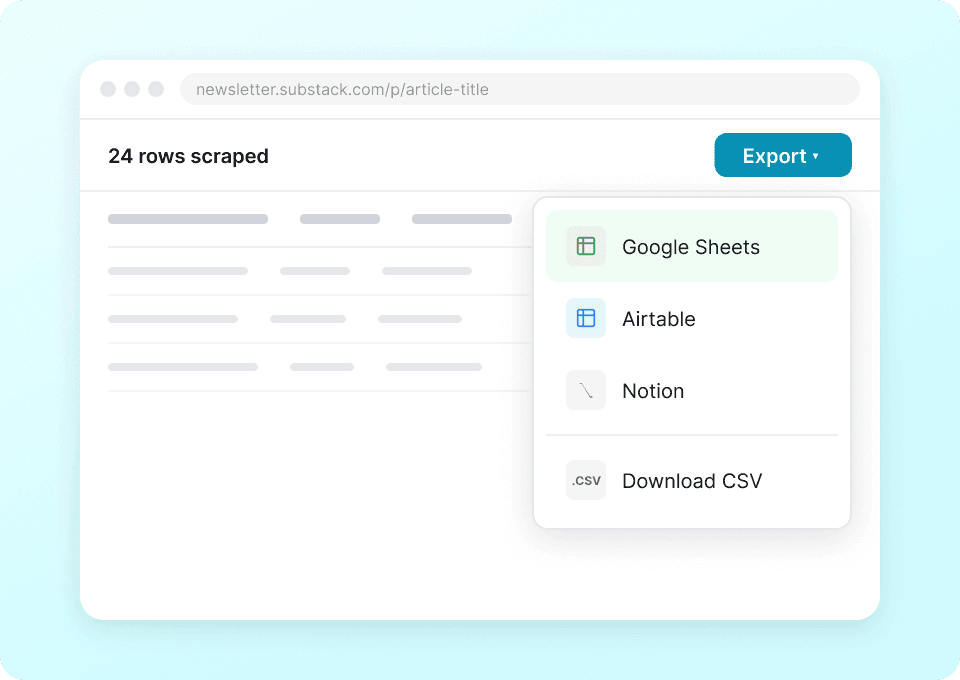
Koniec z ręcznym kopiowaniem i wklejaniem szczegółów publikacji z Substack, takich jak nazwy autorów, tytuły artykułów i liczba subskrybentów. Z Thunderbit jednym kliknięciem wyślesz wyodrębnione dane prosto do Google Sheets, Notion lub Airtable — dzięki czemu możesz analizować trendy publikacji i skuteczność treści bez żmudnej pracy ręcznej.
Jeden scraper do Substack i nie tylko
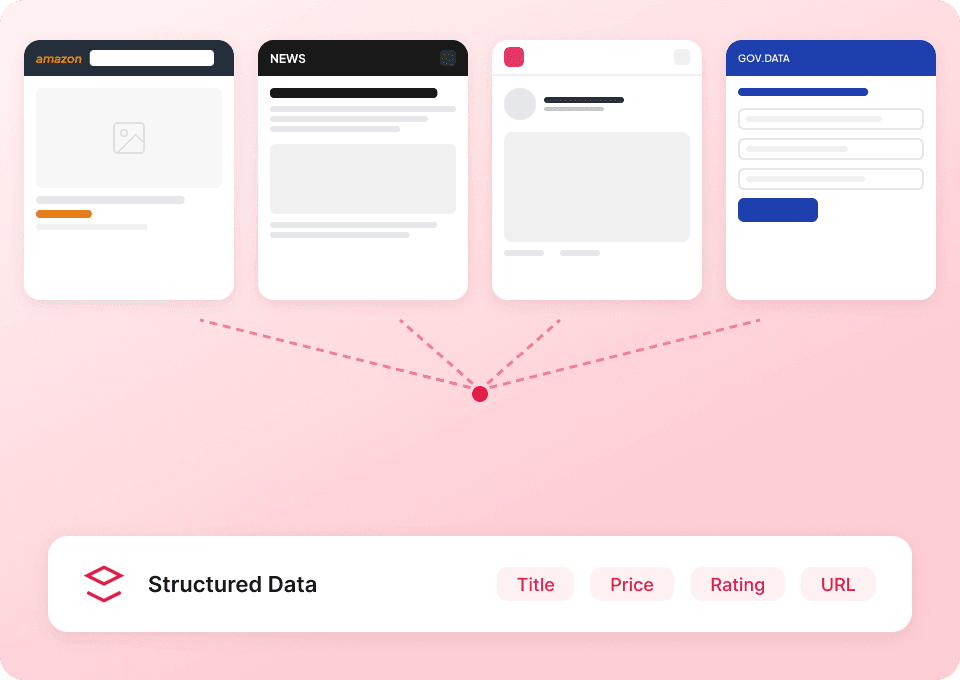
Nie musisz używać osobnego narzędzia dla każdej strony. Thunderbit działa na Substack od razu po instalacji i zawiera ponad 50 gotowych szablonów dla innych popularnych platform. Wyciągaj opisy publikacji, treści artykułów i więcej — a potem użyj tego samego narzędzia do pobierania danych z dowolnego innego miejsca w sieci.
Poznaj pełny obraz Substack
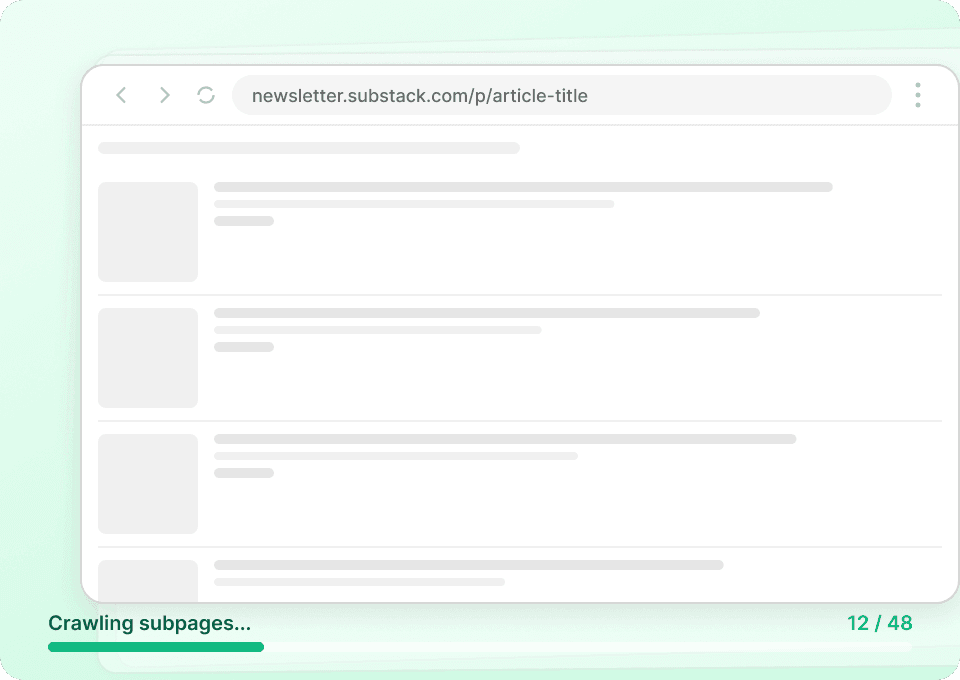
Strony list publikacji w Substack pokazują tylko skróty. Thunderbit automatycznie odwiedza każdą podstronę artykułu, aby pobrać pełną treść i dostarczyć Ci kompletny zestaw danych w jednym przebiegu. Zbierz tytuły artykułów, nazwiska autorów, nazwy publikacji i pełny tekst wpisów — bez ręcznego otwierania choć jednej strony.
Masz problem z efektywnym scrapowaniem Substack?
Zobacz, dlaczego Thunderbit wypada lepiej niż tradycyjne scrapery w pracy z danymi Substack.
Tradycyjne scrapery
Stare podejście do tematuThunderbit
Sprytniejsze podejście

Najczęściej zadawane pytania
Powiązane przypadki użycia
Poznaj więcej zastosowań web scrapera Thunderbit.

Investing.com scraper
Wyciągaj dane giełdowe — symbole, ceny, wolumen i kapitalizację rynkową — z Investing.com w 2 kliknięcia, a następnie eksportuj je bezpośrednio do Google Sheets, Notion lub Excela. Otwórz dowolną stronę Investing.com, a AI sama rozpozna potrzebne pola.
Dowiedz się więcej ->
Scraper TechCrunch
Wyodrębnij artykuły TechCrunch, aktualizacje ze świata startupów, tytuły, linki, daty, autorów i podsumowania w 2 kliknięcia — bez kodowania. Eksportuj od razu do Excel, Google Sheets lub Notion i zamieniaj surowe wiadomości w uporządkowane, praktyczne dane.
Dowiedz się więcej ->
Łatwy scraper ESPN
Śledź nazwiska sportowców, daty meczów i wyniki z ESPN w 2 kliknięciach dzięki AI Thunderbit — bez kodowania i bez konfiguracji. Eksportuj dane bezpośrednio do Excel, Google Sheets lub Notion i zacznij od razu wykorzystywać swoje dane sportowe.
Dowiedz się więcej ->
PubMed Scraper
PubMed Scraper od Thunderbit pomaga wyodrębniać uporządkowane dane z wyników wyszukiwania PubMed i stron artykułów z użyciem AI. Pobieraj trendy w badaniach medycznych, dowody z badań klinicznych, abstrakty, autorów, afiliacje, daty publikacji i linki, a następnie eksportuj wszystko do Excel, Google Sheets, Airtable lub Notion.
Dowiedz się więcej ->
Narzędzie do wyodrębniania artykułów: tekst, autorzy i daty
Zbieraj nagłówki, imiona i nazwiska autorów, daty, streszczenia, treść artykułów, linki i multimedia z publicznych stron z artykułami. Zachowuj wszystkie informacje o każdym artykule w jednym przejrzystym wierszu, nawet gdy serwisy informacyjne korzystają z różnych układów.
Dowiedz się więcej ->
Pobieranie wiadomości: połącz nagłówki z pełnymi szczegółami artykułów
Zbierz nagłówki ze stron tematycznych, działów lub wyników wyszukiwania, a następnie otwórz linki do artykułów, aby pobrać widoczne podpisy autorów, daty publikacji, streszczenia, sekcje i adresy źródłowe. Przed uruchomieniem powiedz Thunderbit prostym językiem, które szczegóły artykułu są dla Ciebie najważniejsze.
Dowiedz się więcej ->Gotowy, by przyspieszyć ekstrakcję danych?
Dołącz do ponad 200 000 profesjonalistów, którzy już używają Thunderbit do automatyzacji procesów web scrapingu.
Darmowy okres próbny zapewnia nielimitowane kredyty na 8 stron.



