Pobieranie wiadomości: połącz nagłówki z pełnymi szczegółami artykułów





Połącz nagłówki wiadomości z pełnymi artykułami
Zamień listę nagłówków w rekordy artykułów z kontekstem źródłowym.
Otwieraj artykuły, aby pobrać pełne szczegóły
Zacznij od strony tematycznej, działu lub wyników wyszukiwania. Thunderbit może odwiedzić każdy podlinkowany materiał i dodać tam widoczny podpis autora, czas publikacji, sekcję, streszczenie oraz adres URL artykułu.
Przetwarzaj listę adresów URL artykułów
Wklej linki wybrane przez redaktora lub badacza. Każdy dostępny materiał stanie się osobnym wierszem, a źródło i szczegóły publikacji pozostaną przypisane do właściwego nagłówka.
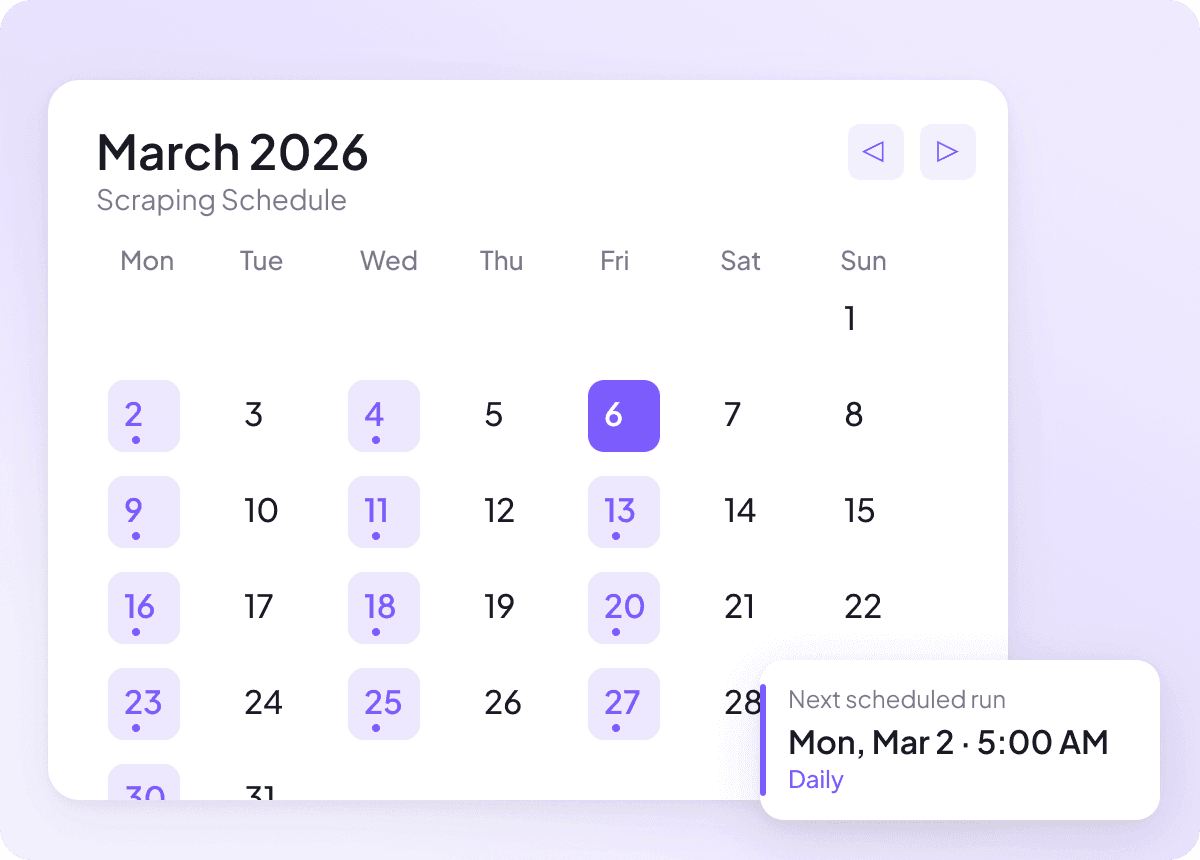
Odświeżaj listę obserwowanych wiadomości
Zaplanuj ponowne uruchomienie tych samych stron źródłowych w późniejszym terminie. Nowa tabela pokaże materiały i szczegóły nagłówków widoczne w tym momencie.
Zbuduj listę obserwowanych wiadomości bez tworzenia własnego scrapera
Przejdź od nagłówków do autora, daty, sekcji i szczegółów źródła w jednej tabeli.
Ręczne listy lub narzędzia selektorów
Więcej konfiguracji dla każdego źródłaAgent AI Thunderbit
Otwórz stronę z wiadomościami i zacznijPola artykułów i list w zakresie
Pobierane tylko wtedy, gdy są widoczne w Twojej sesji.
- headline
- article_url
- outlet_name
- author_name
- author_profile_url
- byline
- publication_date
- publication_time
- updated_date
- updated_time
- section
- subsection
- tags
- summary
- lead_paragraph
- body_text_snippet
- dateline_location
- estimated_read_time
- image_url
- image_caption
- image_credit
- video_url
- video_title
- video_duration
- gallery_image_count
- comment_count
- share_count
- related_titles
- related_urls
- publisher_logo_url
Watch news researchers build a usable watchlist
In user videos, news teams show how they match headlines with article details and check each row.

Pytania o przejście od nagłówków do kontekstu
Krótkie odpowiedzi dotyczące list wiadomości i artykułów.
Continue from headlines to source research
Collect author pages, press releases, publication archives, or topic feeds that support the same news question.
Investing.com scraper
Wyciągaj dane giełdowe — symbole, ceny, wolumen i kapitalizację rynkową — z Investing.com w 2 kliknięcia, a następnie eksportuj je bezpośrednio do Google Sheets, Notion lub Excela. Otwórz dowolną stronę Investing.com, a AI sama rozpozna potrzebne pola.
Dowiedz się więcej ->
Substack scraper
Wyciągaj liczbę subskrybentów Substack, tytuły artykułów i opisy publikacji w 2 kliknięcia — a potem eksportuj dane do Excela, Google Sheets lub Notion. Bez kodowania; AI Thunderbit zajmuje się strukturyzacją za Ciebie.
Dowiedz się więcej ->
Scraper TechCrunch
Wyodrębnij artykuły TechCrunch, aktualizacje ze świata startupów, tytuły, linki, daty, autorów i podsumowania w 2 kliknięcia — bez kodowania. Eksportuj od razu do Excel, Google Sheets lub Notion i zamieniaj surowe wiadomości w uporządkowane, praktyczne dane.
Dowiedz się więcej ->
Łatwy scraper ESPN
Śledź nazwiska sportowców, daty meczów i wyniki z ESPN w 2 kliknięciach dzięki AI Thunderbit — bez kodowania i bez konfiguracji. Eksportuj dane bezpośrednio do Excel, Google Sheets lub Notion i zacznij od razu wykorzystywać swoje dane sportowe.
Dowiedz się więcej ->
PubMed Scraper
PubMed Scraper od Thunderbit pomaga wyodrębniać uporządkowane dane z wyników wyszukiwania PubMed i stron artykułów z użyciem AI. Pobieraj trendy w badaniach medycznych, dowody z badań klinicznych, abstrakty, autorów, afiliacje, daty publikacji i linki, a następnie eksportuj wszystko do Excel, Google Sheets, Airtable lub Notion.
Dowiedz się więcej ->
Narzędzie do wyodrębniania artykułów: tekst, autorzy i daty
Zbieraj nagłówki, imiona i nazwiska autorów, daty, streszczenia, treść artykułów, linki i multimedia z publicznych stron z artykułami. Zachowuj wszystkie informacje o każdym artykule w jednym przejrzystym wierszu, nawet gdy serwisy informacyjne korzystają z różnych układów.
Dowiedz się więcej ->Gotowy, by przyspieszyć ekstrakcję danych?
Dołącz do ponad 200 000 profesjonalistów, którzy już używają Thunderbit do automatyzacji procesów web scrapingu.
Darmowy okres próbny zapewnia nielimitowane kredyty na 8 stron.


