
Za każdym razem, gdy synchronizujesz CRM, pobierasz aktualizacje wysyłki albo łączysz dwa narzędzia SaaS, za kulisami ciężką pracę wykonuje REST API. Większość ludzi nigdy się nad tym nie zastanawia — aż do momentu, gdy coś przestaje działać.
I tu pojawia się zabawny paradoks: nawet wśród programistów panuje spore zamieszanie wokół tego, co właściwie sprawia, że API jest „RESTful”. Termin ten bywa używany tak luźno, że jeden z wątków na Redditcie ujął to bez ogródek: „Nie sądzę, żebym zbudował choć jedno naprawdę RESTful API zgodne z definicją Roya Fieldinga.” A mówi to programista, nie osoba biznesowa. Sam koncept wywodzi się z pracy doktorskiej Roya Fieldinga z 2000 roku na UC Irvine, gdzie opisał REST jako styl architektoniczny — zbiór ograniczeń projektowych — a nie protokół, produkt czy specyfikację do pobrania.
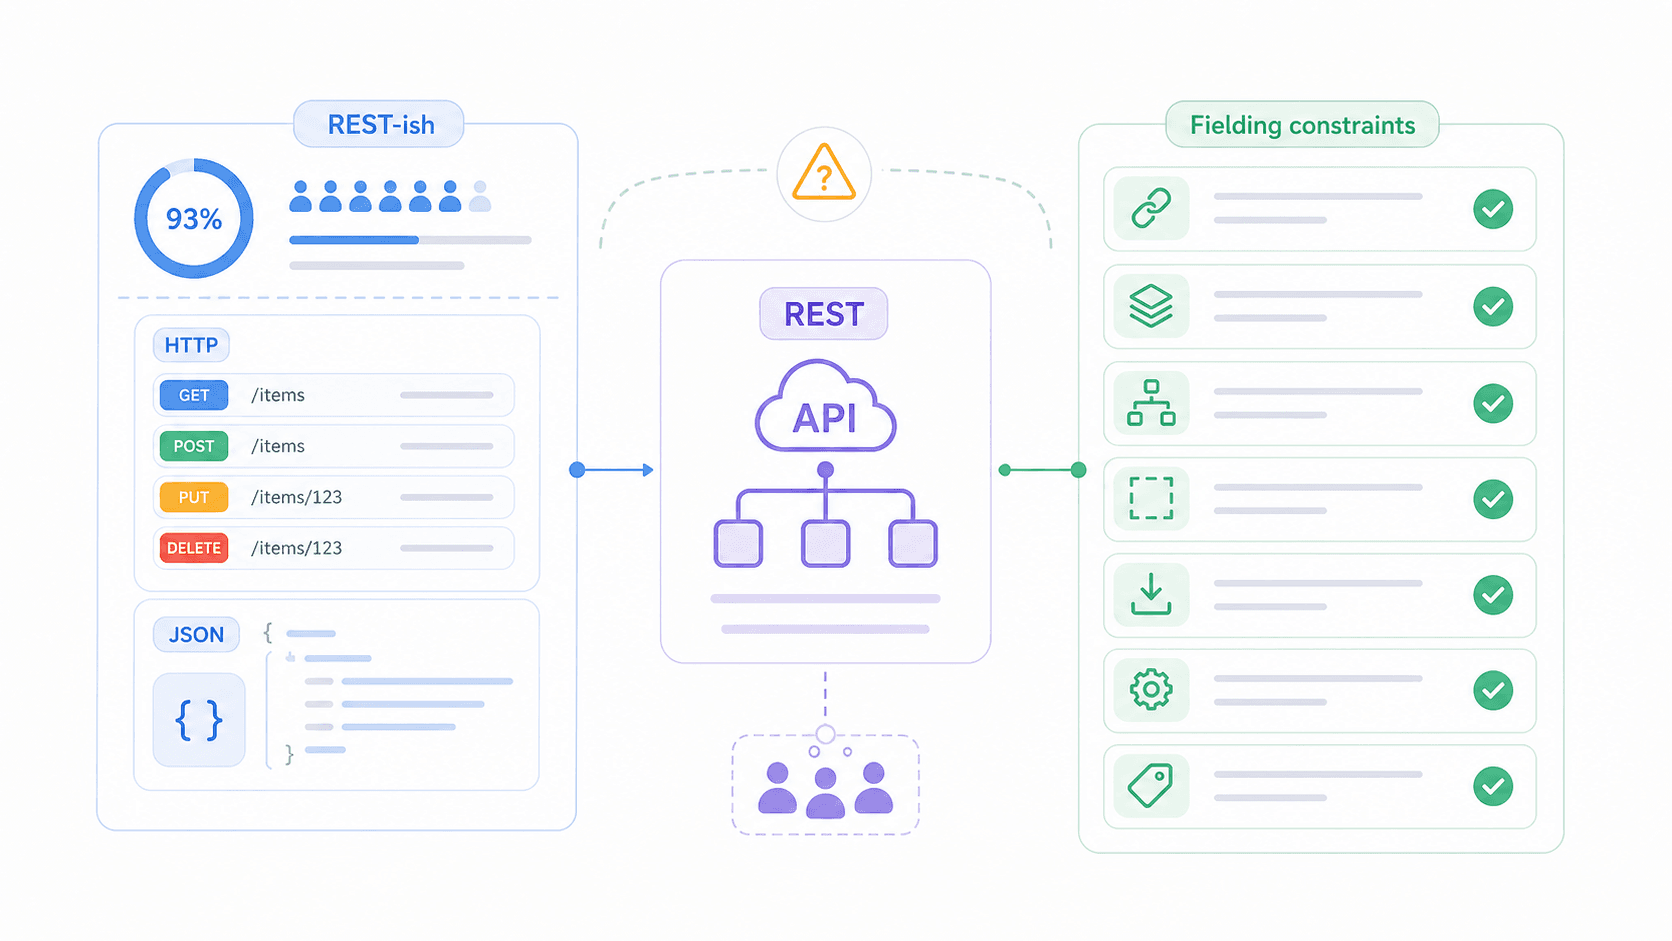
A jednak według Postman 2025 State of the API Report użycie REST sięga 93% wśród specjalistów API. Czyli prawie wszyscy z niego korzystają, ale zaskakująco wiele zespołów nie rozumie, czego tak naprawdę wymaga. W tym artykule przejdziemy przez 6 podstawowych cech REST API prostym językiem, pokażemy, które z nich zespoły najczęściej robią źle, przedstawimy model dojrzałości do samooceny i porównamy REST z alternatywami — SOAP, GraphQL i gRPC.
Czym jest REST API? (Definicja prostym językiem)
REST (Representational State Transfer) to zestaw zasad projektowych określających, jak systemy oprogramowania powinny komunikować się przez sieć.
Dokładniej: to styl architektoniczny definiujący ograniczenia — takie jak bezstanowość, cacheowalność i jednolity interfejs — które kształtują sposób, w jaki klienci (przeglądarka, aplikacja mobilna lub narzędzie automatyzujące) wchodzą w interakcję z serwerami (gdzie znajdują się dane). REST zwykle działa przez HTTP i zazwyczaj zwraca JSON, ale sam REST nie jest związany z żadnym konkretnym protokołem ani formatem danych.
Najłatwiej wyobrazić sobie to jak zasady dobrego wychowania na kolacji. REST nie mówi, jakie danie podać ani jakim językiem mówić — określa, jak przekazywać potrawy, jak prosić o dokładkę i jak dać znać, że już skończyłeś. Dwa systemy, które trzymają się tych samych zasad, mogą komunikować się przewidywalnie, nawet jeśli nigdy wcześniej się nie „spotkały”.
Czym REST NIE jest: REST nie jest produktem, który instalujesz. Nie jest też protokołem takim jak HTTP czy SOAP. A samo określenie API jako „RESTful” nie oznacza, że w pełni spełnia oryginalne ograniczenia Fieldinga — zwykle znaczy jedynie, że API używa adresów zasobów i metod HTTP. Różnica między „REST-ish” a „naprawdę RESTful” jest jednym z największych źródeł nieporozumień w branży i za chwilę to rozłożymy na czynniki pierwsze.
6 cech REST API w skrócie
Zanim przejdziemy do szczegółów, oto szybka ściągawka. Fielding zdefiniował 6 ograniczeń, które API powinno spełniać, aby można je było uznać za RESTful. Pięć jest obowiązkowych; jedno jest opcjonalne.
| Ograniczenie | Główna idea | Najważniejsza korzyść | Konkretny przykład |
|---|---|---|---|
| Klient–serwer | Oddzielenie interfejsu od przechowywania danych | Frontend i backend mogą rozwijać się niezależnie | Aplikacja React SPA wywołująca REST API |
| Bezstanowość | Każde żądanie niesie cały potrzebny kontekst | Łatwiejsze skalowanie poziome, brak zależności od sesji | Token uwierzytelniający wysyłany w każdym nagłówku żądania |
| Cacheowalność | Odpowiedzi określają, czy można je buforować | Mniejsze opóźnienia i mniejsze obciążenie serwera | Cache-Control: max-age=3600 w odpowiedzi GET |
| Jednolity interfejs | Standaryzowana interakcja z zasobami | Przewidywalna, łatwa do nauczenia powierzchnia API | GET /users/42, DELETE /users/42 |
| System warstwowy | Klient nie wie, czy komunikuje się bezpośrednio z serwerem | Umożliwia wstawienie CDN, bramy i load balancera | Klient → CDN → API Gateway → serwer aplikacji |
| Code-on-Demand (opcjonalnie) | Serwer może wysłać wykonywalny kod, by rozszerzyć klienta | Rozszerzenie funkcji klienta na żądanie | API zwracające fragment widżetu JavaScript |
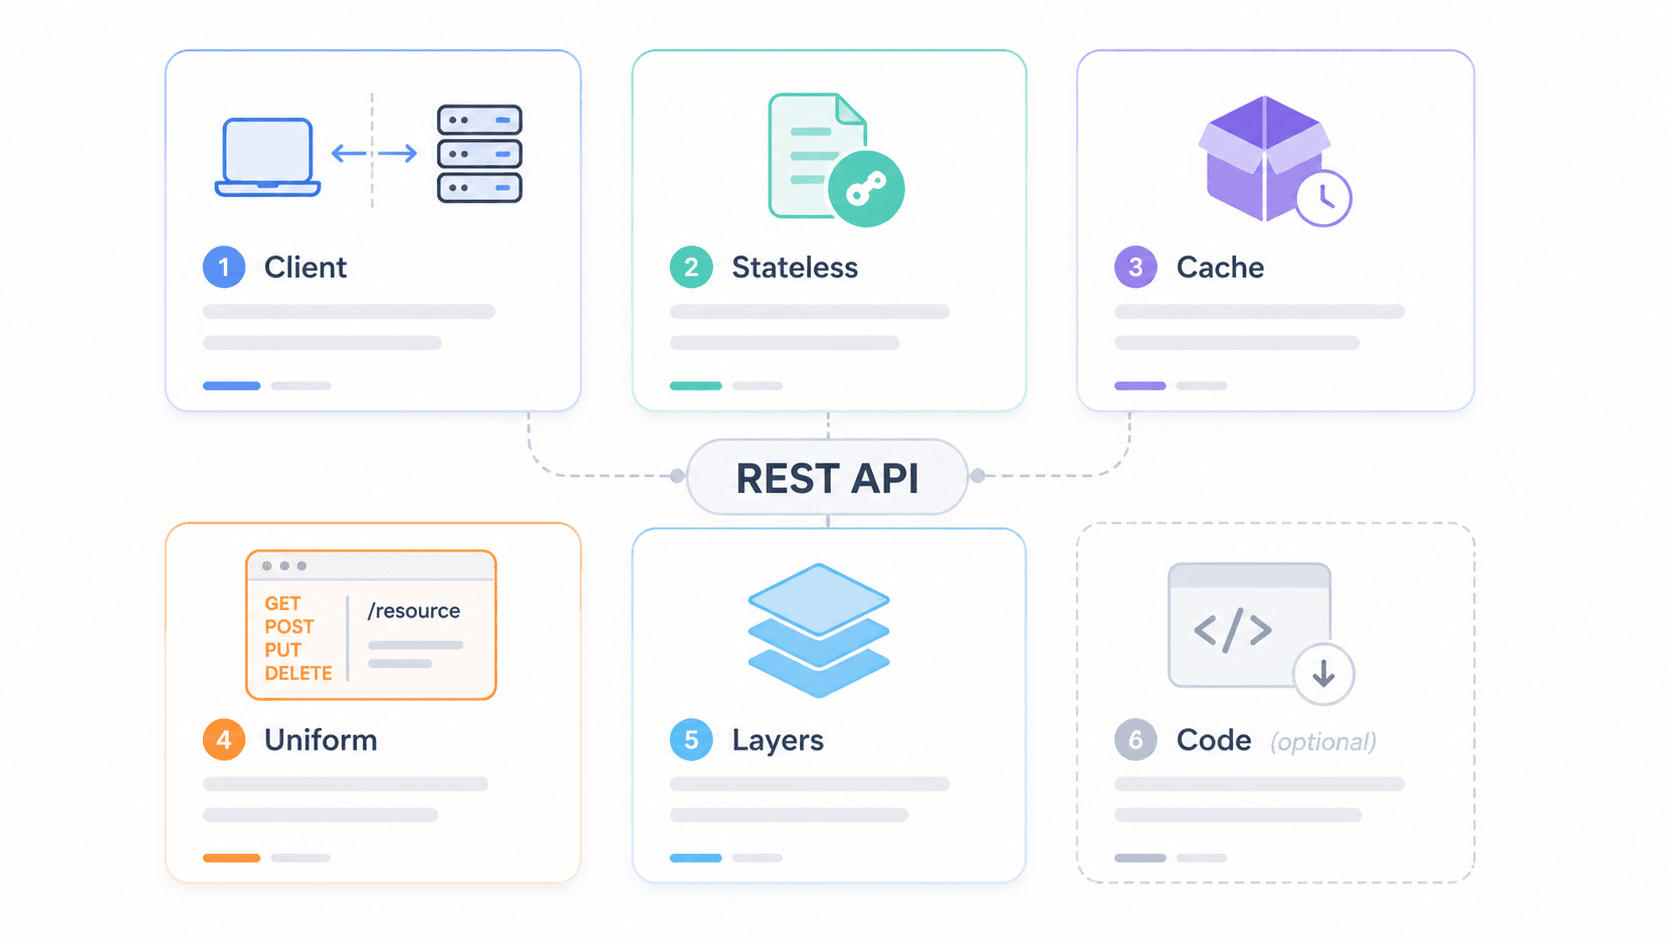
Aby zobaczyć, jak te ograniczenia współpracują w rzeczywistym systemie, wyobraź sobie taką warstwową architekturę:
Klient / aplikacja mobilna
        ↓
CDN / cache brzegowy (np. Cloudflare)
        ↓
API Gateway (limity, uwierzytelnianie, CORS)
        ↓
Load balancer
        ↓
Serwery aplikacyjne
        ↓
Baza danych / usługi wewnętrzne
Klient komunikuje się tylko z warstwą CDN. Nie ma pojęcia, ile warstw znajduje się za nią. To właśnie działanie systemu warstwowego — i jednocześnie miejsce, w którym bez wiedzy klienta zachodzą bezpieczeństwo, cache i skalowanie.
A teraz szczegółowy opis.
Cechy REST API wyjaśnione po kolei
Separacja klient–serwer
Pierwsze ograniczenie Fieldinga: klient (z czym użytkownik wchodzi w interakcję) i serwer (gdzie znajdują się dane i działa logika) muszą być oddzieleni. Nazwał to separacją odpowiedzialności.
Dlaczego ma to znaczenie w praktyce? Bo dzięki temu aplikacja bankowości mobilnej może przejść całkowity redesign wizualny, a bank nie musi dotykać bazy kont ani silnika transakcyjnego. Na przykład Salesforce Marketing Cloud REST API udostępnia kontakty, kampanie, journeys i powiadomienia push przez punkty końcowe zasobów. Niezależnie od tego, czy budujesz własny dashboard, aplikację mobilną, czy łączysz narzędzie zewnętrzne, backend pozostaje ten sam.
Dla zespołów biznesowych przekłada się to na szybsze iteracje. Projektanci frontendu i inżynierowie backendu nie muszą pracować w tym samym cyklu wdrożeniowym. Dopóki kontrakt API jest stabilny, obie strony mogą działać niezależnie.
Bezstanowość
Brak pamięci między żądaniami. Każde wywołanie od klienta do serwera musi zawierać wszystkie informacje potrzebne do jego obsłużenia — serwer nie zachowuje nic z poprzednich interakcji.
Lubię porównywać to do dzwonienia na infolinię, gdzie za każdym razem trzeba od nowa tłumaczyć swój problem. Uciążliwe? Jasne. Ale korzyść jest ogromna: dowolny dostępny konsultant może ci pomóc, a centrum obsługi może dodać 500 kolejnych osób bez przebudowy całego systemu. To właśnie skalowanie poziome.
W ujęciu technicznym bezstanowość oznacza brak sticky sessions. Load balancer może skierować następne żądanie do dowolnego zdrowego serwera. Jeśli jeden serwer padnie, inny przejmie ruch bez zakłóceń. W swojej rozprawie Fielding wprost zauważa, że bezstanowość poprawia widoczność (narzędzia monitorujące mogą analizować każde żądanie osobno), niezawodność (awarie nie psują współdzielonego stanu sesji) oraz skalowalność (serwery mogą zwalniać zasoby między żądaniami).
Praktyczny haczyk: w realnych systemach nadal istnieją tokeny uwierzytelniające, koszyki zakupowe i przepływy OAuth. Nie chodzi o to, że nigdzie nie ma stanu — chodzi o to, że serwer nie przechowuje stanu sesji klienta w swojej pamięci między żądaniami. Zamiast tego robią to tokeny, bazy danych i współdzielone cache.
Cacheowalność
Czy tę odpowiedź można ponownie wykorzystać? Na to odpowiada cacheowalność. Odpowiedzi powinny jasno deklarować, czy można je buforować, a jeśli tak — klienci i pośrednicy, tacy jak CDN, ponownie używają ich dla równoważnych przyszłych żądań, zmniejszając obciążenie serwera i przyspieszając działanie.
Mechanizm HTTP jest prosty: nagłówki takie jak Cache-Control, ETag, Last-Modified i Expires mówią cache, jak długo odpowiedź jest ważna i kiedy należy ją sprawdzić ponownie. Dla osoby biznesowej można to traktować jak etykietę na odpowiedzi: „ta odpowiedź jest dobra przez następną godzinę” albo „zawsze pytaj mnie o świeżą wersję”.
Wpływ na wydajność jest realny. Testy Cloudflare Regional Tiered Cache wykazały poprawę czasów odpowiedzi cache hit w ogonie rozkładu o 50–100 ms. A sama rozprawa Fieldinga dokumentuje, jak ruch w sieci wzrósł z 100 000 żądań dziennie w 1994 roku do 600 000 000 żądań dziennie w 1999 roku — a cache było kluczowym czynnikiem projektowym.
Co zwykle można cache’ować: katalogi produktów, publiczne treści blogowe, listy krajów/walut, dokumentację API.
Czego zwykle nie cache’uje się: osobistych dashboardów, sum koszyka, sald bankowych, raportów administracyjnych.
Jednolity interfejs
To ograniczenie Fielding sam nazwał centralną cechą, która odróżnia REST od innych stylów architektonicznych. Standaryzuje sposób interakcji klienta z zasobami, dzięki czemu API staje się przewidywalne.
W tej kategorii mieszczą się cztery pod-ograniczenia:
- Identyfikacja zasobów: Każdy zasób ma stabilny URI.
/customers/123to klient./orders/456to zamówienie. - Modyfikacja przez reprezentacje: Klienci pracują z reprezentacjami zasobów (JSON, XML, HTML), a nie z wewnętrznymi obiektami serwera.
- Samoopisujące się komunikaty: Żądania i odpowiedzi niosą wystarczająco dużo metadanych — metodę, kod statusu, typ treści, szczegóły błędu — by każdy pośrednik lub klient mógł je zrozumieć.
- HATEOAS (Hypermedia as the Engine of Application State): Odpowiedzi zawierają linki do powiązanych działań i zasobów, dzięki czemu klient może odkrywać, co robić dalej, bez twardego zakodowania każdego endpointu.
Mapowanie metod HTTP jest najbardziej widoczną częścią jednolitego interfejsu:
| Metoda HTTP | Znaczenie CRUD | Bezpieczna? | Idempotentna? | Przykład |
|---|---|---|---|---|
| GET | Odczyt | Tak | Tak | GET /products/42 |
| POST | Utworzenie / akcja | Nie | Nie | POST /orders |
| PUT | Zastąpienie całego zasobu | Nie | Tak | PUT /users/42 |
| PATCH | Częściowa aktualizacja | Nie | Nie zawsze | PATCH /users/42 |
| DELETE | Usunięcie | Nie | Tak | DELETE /sessions/abc |
Wytyczne Google Cloud dotyczące HTTP wprost mówią, że GET powinno być bezpieczne, a GET, PUT i DELETE powinny być idempotentne. Znane API od GitHub, Stripe i Spotify trzymają się tych wzorców bardzo konsekwentnie, dlatego programista, który nauczy się jednego, może szybko odnaleźć się w innym.
System warstwowy
Twój klient nie wie, czy komunikuje się z serwerem źródłowym, cache CDN, API Gateway czy load balancerem. I właśnie o to chodzi — każdy komponent widzi tylko sąsiednią warstwę.
To umożliwia:
- CDN-y takie jak Cloudflare stojące przed API i przyspieszające odpowiedzi przez cache
- Bramy API (AWS API Gateway, Kong, Apigee) obsługujące uwierzytelnianie, limity i quota
- Load balancery rozdzielające bezstanowe żądania między wiele serwerów aplikacyjnych
Raport Postman 2025 podaje, że 47% organizacji używa AWS API Gateway, 26% korzysta z bramy Azure, a 31% używa kilku bram jednocześnie. Architektura warstwowa nie jest teorią — tak właśnie działają systemy produkcyjne.
Cena tego podejścia? Każda warstwa dodaje niewielkie opóźnienie. Fielding argumentował jednak, że współdzielony cache w warstwach pośrednich w większości rzeczywistych systemów z nawiązką rekompensuje ten narzut.
Code-on-Demand (opcjonalnie)
To jest wyjątek od reguły. Code-on-Demand to jedyne opcjonalne ograniczenie REST: serwer może wysłać wykonywalny kod — na przykład JavaScript — aby dynamicznie rozszerzyć funkcje klienta.
Najczęstszy przykład z życia to po prostu strona internetowa ładująca JavaScript z serwera. Ale w typowych JSON REST API używanych przez aplikacje mobilne, zadania backendowe czy narzędzia automatyzujące, code-on-demand praktycznie się nie pojawia. Klienci API zazwyczaj nie chcą wykonywać dowolnego kodu zdalnego serwera.
Dla większości czytelników to przypis. Istnieje w modelu Fieldinga dla kompletności, ale nie będzie miało większego znaczenia w codziennej ocenie API.
Co większość osób robi źle: czy większość REST API jest naprawdę RESTful?
Oto część, o której nikt nie lubi mówić: większość produkcyjnych API, które nazywają się „RESTful”, to w rzeczywistości HTTP JSON API z konwencjami w stylu REST. Używają adresów zasobów, metod HTTP i kodów statusu — i tyle. W wątku na Redditcie r/softwarearchitecture programiści przyznawali, że nigdy nie zbudowali naprawdę REST API zgodnego z Fieldingiem. Inna dyskusja na r/learnprogramming przerodziła się w spór o to, czy w ogóle da się uzgodnić, co znaczy „RESTful”.
Badanie z 2026 roku, w którym przeprowadzono wywiady z 16 ekspertami REST API, wykazało, że choć wytyczne poprawiają użyteczność, programiści wykazują duży opór wobec sztywnych zasad REST — wskazując na obszerność wytycznych i słabe dopasowanie do specyfiki organizacji jako bariery.
Gdzie więc te ograniczenia lądują w praktyce?
| Ograniczenie | Adopcja w praktyce | Dlaczego |
|---|---|---|
| Klient–serwer | ✅ Prawie powszechne | Fundamentalne dla architektury webowej; trudno tego uniknąć |
| Bezstanowość | ✅ Prawie powszechna | Wymagana do skalowania poziomego; standard branżowy |
| Jednolity interfejs (podstawowy) | ✅ Częste | URI zasobów + czasowniki HTTP to domyślny wzorzec |
| Cacheowalność | ⚠️ Niespójna | Wiele zespołów całkiem pomija nagłówki Cache-Control |
| System warstwowy | ⚠️ Domyślny | CDN-y i bramy istnieją, ale nie zawsze są projektowane świadomie |
| HATEOAS | ❌ Rzadkie | Większość klientów hardkoduje endpointy; odkrywanie oparte na linkach zwiększa złożoność |
| Code-on-Demand | ❌ Bardzo rzadkie | Z definicji opcjonalne; prawie nigdy nie jest implementowane w JSON API |
Dlaczego zespoły pomijają HATEOAS: programiści po stronie klienta wolą czytać dokumentację OpenAPI i korzystać z SDK niż dynamicznie podążać za linkami w czasie działania. HATEOAS wymaga stabilnych typów mediów, definicji relacji linków i modelowania przepływów pracy — koszt początkowy jest wysoki, a korzyść dla większości zespołów nie jest oczywista.
Pragmatyczny wniosek: API nie musi być w 100% zgodne z Fieldingiem, żeby było użyteczne. Ale wiedza o tym, które ograniczenia pominąłeś — i co tracisz, pomijając je — pomaga podejmować lepsze decyzje projektowe i integracyjne.
Richardson Maturity Model: jak bardzo RESTful jest twoje API?
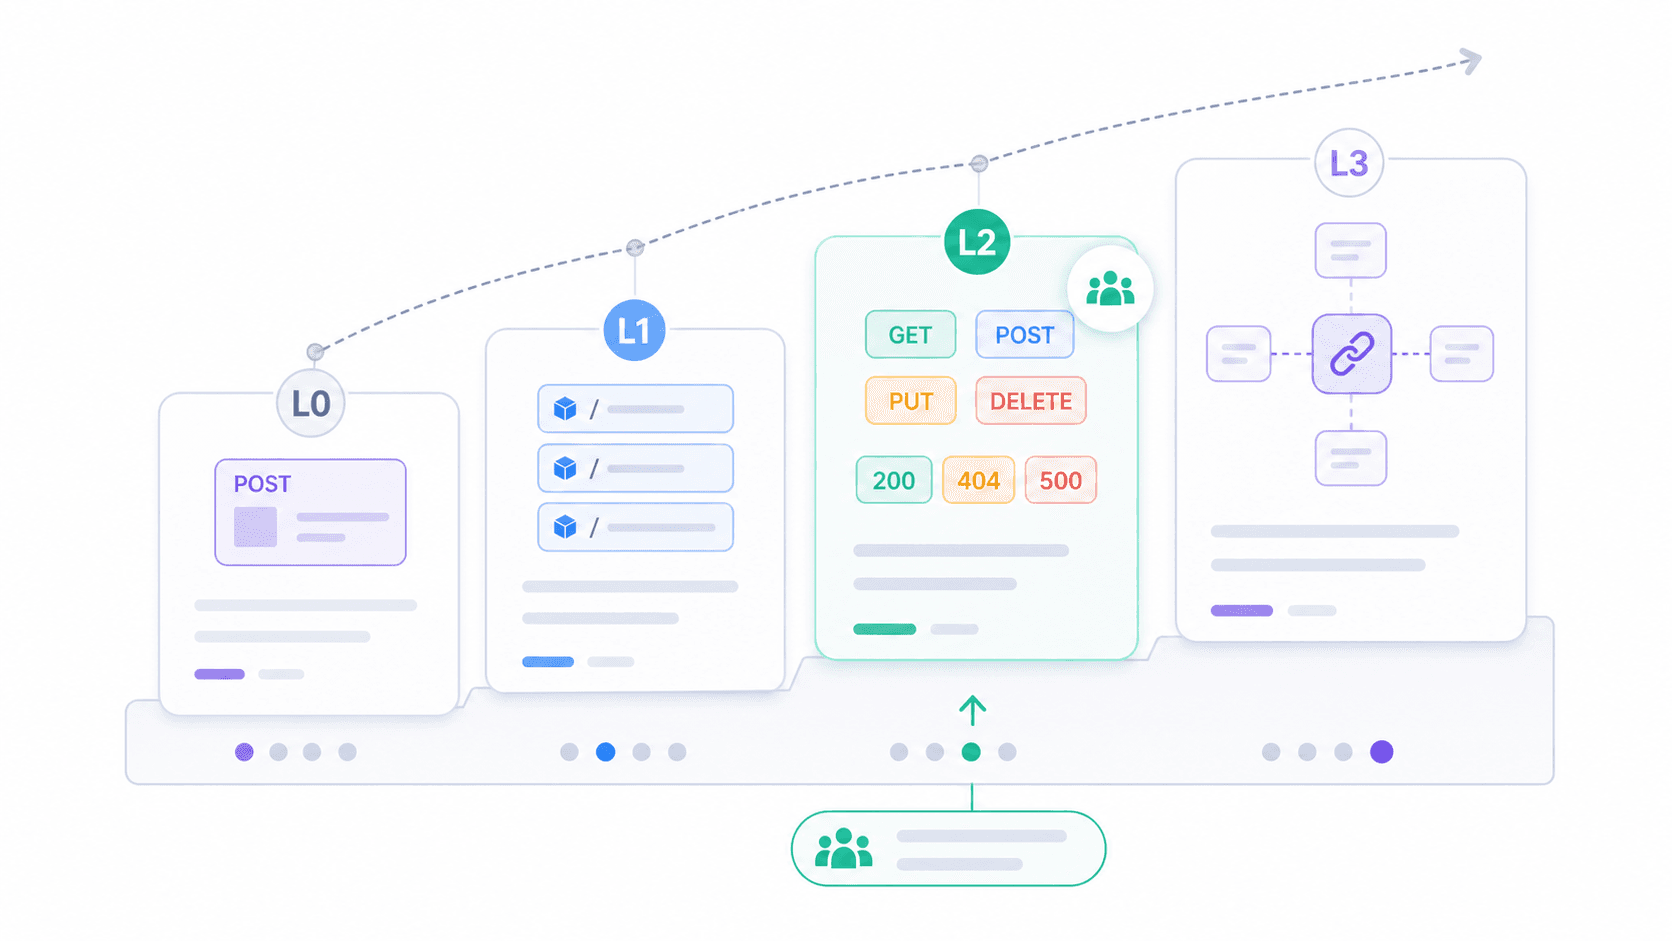
Jeśli binarne pytanie „czy to jest RESTful, czy nie?” wydaje się mało pomocne, Richardson Maturity Model oferuje bardziej praktyczne podejście. Zaproponowany przez Leonarda Richardsona i opisany przez Martina Fowlera, dzieli dojrzałość REST na cztery poziomy.
| Poziom | Nazwa | Opis | Przykład z życia |
|---|---|---|---|
| 0 | Bagno POX | Jeden URI, jedna metoda HTTP (zwykle POST) | Starsze endpointy SOAP-over-HTTP; POST /api z { "action": "getUser" } |
| 1 | Zasoby | Wiele URI (po jednym na zasób), ale nadal głównie POST | POST /users/123/getProfile, POST /orders/456/cancel |
| 2 | Czasowniki HTTP | Poprawne użycie GET, POST, PUT, DELETE + właściwe kody statusu | Większość produkcyjnych API „REST” dziś |
| 3 | Hipermedia (HATEOAS) | Odpowiedzi zawierają linki do powiązanych działań/zasobów | Spring Data REST, API oparte na HAL; w praktyce bardzo mało publicznych API |
Większość API, z którymi spotkasz się w praktyce, znajduje się na poziomie 2. Używają zasobów, czasowników i kodów statusu poprawnie. To wystarcza, by były praktyczne, interoperacyjne i dobrze wspierane przez narzędzia. Poziom 3 to pełna wizja Fieldinga, ale adopcja pozostaje niewielka.
Na jakim poziomie jest twoje API? Zadaj sobie pytania:
- Czy API ma jeden endpoint do wszystkiego? (Poziom 0)
- Czy każdy obiekt biznesowy ma własny URI? (Poziom 1+)
- Czy metody HTTP i kody statusu są używane poprawnie? (Poziom 2)
- Czy odpowiedzi mówią klientowi, co może zrobić dalej, bez polegania na zewnętrznej dokumentacji? (Poziom 3)
Ten model to najpraktyczniejsze narzędzie, jakie znalazłem, by przeciąć spór „REST czy nie REST”. Zamiast binarnej oceny daje spektrum.
Najczęstsze błędy REST API (i jak ich unikać)
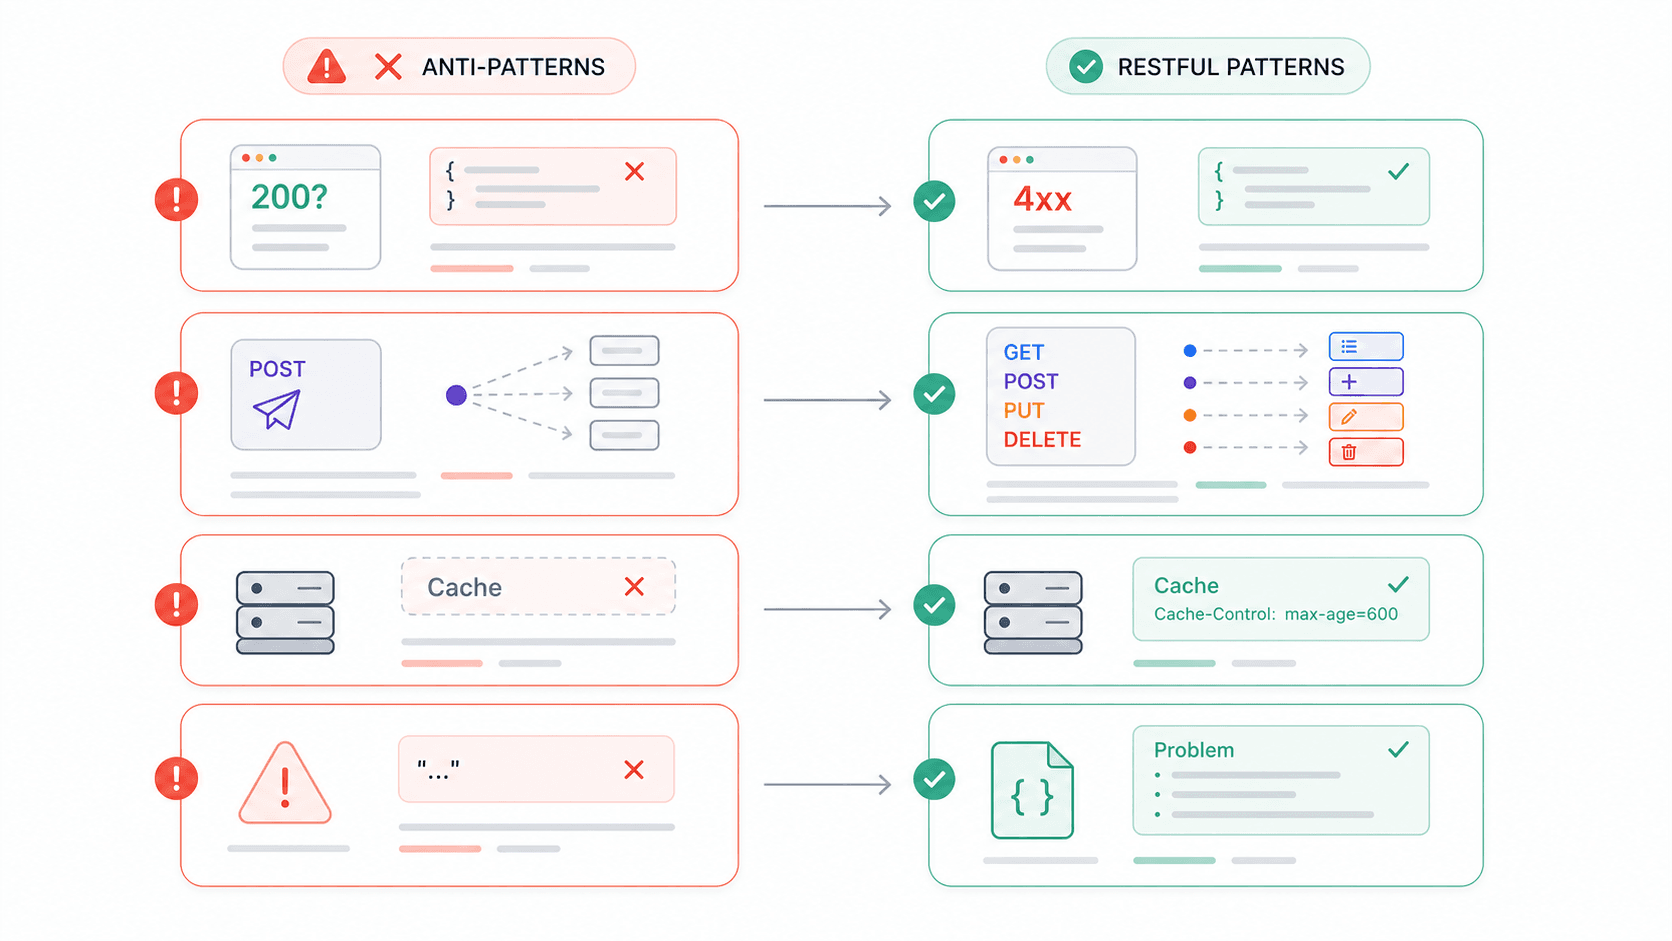
Spędziłem wystarczająco dużo czasu na integracjach z zewnętrznymi API, żeby mieć własną listę frustracji. A sądząc po forach programistycznych, nie jestem w tym sam. Oto antywzorce, które pojawiają się najczęściej — i każdy z nich bezpośrednio narusza jedno z ograniczeń REST.
| Antywzorzec | Dlaczego łamie REST | Co zrobić zamiast tego |
|---|---|---|
HTTP 200 z treścią błędu ({ "error": "Invalid username" }) | Narusza samoopisujące się komunikaty; klient nie może ufać kodom statusu | Używaj właściwych kodów 4xx/5xx + ustrukturyzowanej treści błędu (np. application/problem+json) |
| POST do wszystkiego | Ignoruje jednolity interfejs; traci semantykę bezpieczeństwa/idempotencji | Mapuj CRUD na GET/POST/PUT(PATCH)/DELETE |
Brak nagłówków Cache-Control | Całkowicie marnuje ograniczenie cacheowalności | Ustaw jawne dyrektywy cache — nawet no-store dla danych wrażliwych |
| Niejasne błędy („błąd 409”) | Ludzie i maszyny nie wiedzą, co poszło nie tak | Podaj typ błędu, komunikat dla człowieka i link do dokumentacji |
| Brak wymuszenia HTTPS | Tokeny bearer i klucze API lecą jawnym tekstem | Wymuszaj TLS wszędzie; Google APIs domyślnie używają tylko HTTPS |
| Wersjonowanie w treści żądania | Łamie identyfikację zasobów; bramy i cache nie mogą poprawnie routować | Użyj wersjonowania w ścieżce URI (/v1/) albo wersjonowania przez nagłówek Accept |
Zalando RESTful API Guidelines wymagają oficjalnych kodów statusu HTTP i zalecają Problem JSON dla odpowiedzi błędów. Adidas API Guidelines określają, że Problem Detail powinien być używany tylko dla 4xx/5xx, nigdy mieszany z 2xx. To nie są akademickie preferencje — to standardy produkcyjne od zespołów, które obsługują API na dużą skalę.
W wątku na Redditcie r/learnprogramming jeden z programistów naprawdę pytał, czy przy błędach można zawsze zwracać HTTP 200. Sam fakt, że takie pytanie nadal pojawia się w 2026 roku, pokazuje, jak trwałe są te antywzorce.
REST vs SOAP vs GraphQL vs gRPC: jak wypadają cechy REST API
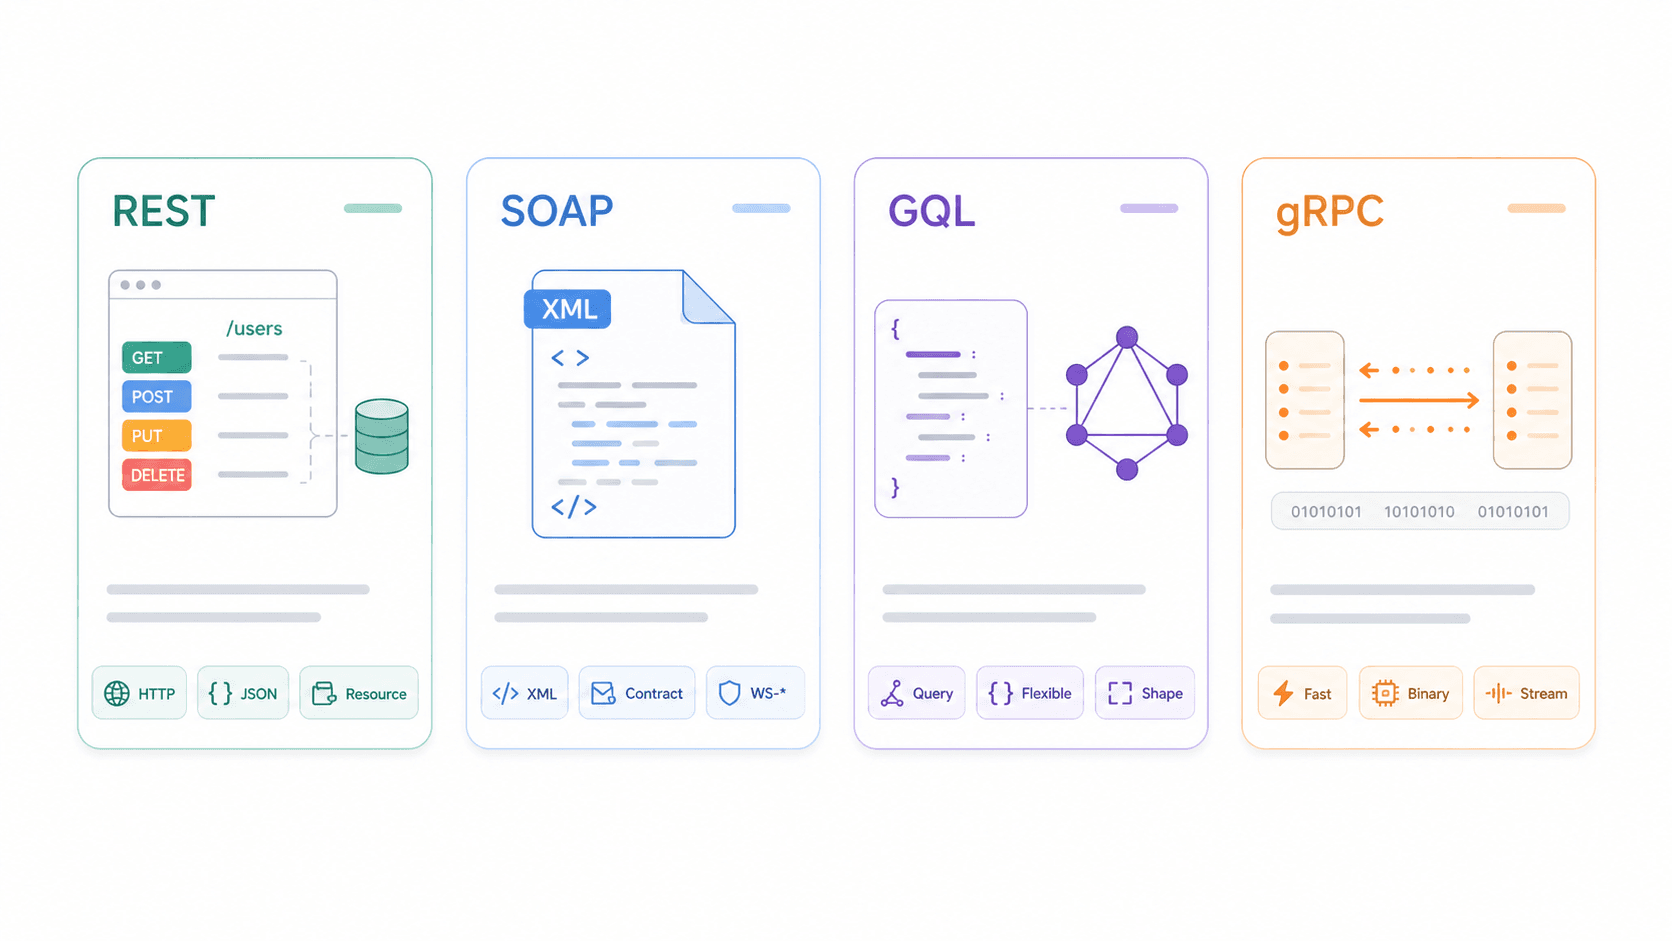
Zrozumienie REST w oderwaniu od innych rozwiązań jest przydatne. Ale lepiej zrozumieć go na tle alternatyw.
| Wymiar | REST | SOAP | GraphQL | gRPC |
|---|---|---|---|---|
| Protokół / transport | Styl architektoniczny, zwykle HTTP | Protokół komunikatów oparty na XML; HTTP, SMTP itd. | Język zapytań / runtime, zwykle przez HTTP | Framework RPC nad HTTP/2 |
| Format danych | Zwykle JSON, także XML/HTML | Tylko XML (kontrakty WSDL) | JSON dopasowany do kształtu zapytania | Protocol Buffers (binarnie) |
| Cache | ✅ Natywny cache HTTP przy dobrym projekcie | ❌ Złożony; słabo współgra z cache HTTP | ⚠️ Trudniejszy (POST + pojedynczy endpoint + zmienność zapytań) | ❌ Nie jest projektowany pod cache HTTP |
| Obsługa czasu rzeczywistego | ❌ Polling/webhooki | ❌ Wzorce komunikacji enterprise | ✅ Subskrypcje | ✅ Streaming, niskie opóźnienia |
| Krzywa uczenia się | Niska do średniej | Wysoka | Średnia | Średnia do wysokiej |
| Najlepsze zastosowanie | Publiczne API, CRUD, integracje web/mobile | Enterprise/legacy, ścisłe kontrakty, compliance | Złożone zapytania, elastyczne frontendy, aplikacje mobilne | Komunikacja mikroserwis–mikroserwis, wysoka wydajność wewnętrzna |
Porównanie stylów architektonicznych API od Postmana zaleca wybór na podstawie kompatybilności, kształtu danych, rodzaju operacji i narzędzi używanych przez zespoły.
Kiedy co wybrać:
- REST wygrywa, gdy potrzebujesz szerokiej kompatybilności, prostych operacji CRUD i cache HTTP. To domyślny wybór dla publicznych API oraz integracji web/mobile.
- SOAP nadal ma sens w systemach enterprise ze ścisłymi kontraktami, wymaganiami WS-Security lub starszymi integracjami, które jeszcze długo nie znikną.
- GraphQL błyszczy wtedy, gdy frontend potrzebuje elastycznych, zagnieżdżonych zapytań i chcesz uniknąć nadmiernego lub zbyt małego pobierania danych — co jest częste w złożonych aplikacjach mobilnych.
- gRPC jest stworzone do wewnętrznej komunikacji mikroserwisów, gdzie niższe opóźnienia i binarna serializacja są ważniejsze niż kompatybilność z przeglądarką.
Jako przykład z życia: Open API Thunderbit używa prostych endpointów POST (/distill i /extract), treści żądań i odpowiedzi w JSON, uwierzytelniania tokenem bearer oraz standardowych kodów HTTP (400, 401, 402, 408, 422, 429, 500, 502, 503, 504). Pokazuje cechy REST w produkcyjnym produkcie AI, bez potrzeby kontraktów SOAP czy złożoności gRPC. Nie jest to pokaz HATEOAS — ale praktyczne API poziomu 2, które łatwo zintegrować zarówno zespołom biznesowym, jak i deweloperskim.
Dlaczego cechy REST API mają znaczenie dla zespołów biznesowych
Sales, Operations, Ecommerce — żaden z tych zespołów nie pisze kodu API. Ale to właśnie wy wybieracie dostawców, łączycie narzędzia i budujecie automatyzacje — a jakość REST API bezpośrednio wpływa na to, jak bolesne (albo bezbolesne) będą te integracje.
Integracja narzędzi: Gdy CRM synchronizuje się z platformą automatyzacji marketingu, projekt REST API decyduje o tym, czy synchronizacja będzie niezawodna, czy krucha. Salesforce Marketing Cloud REST API obsługuje kontakty, kampanie, journeys i powiadomienia push przez przewidywalne endpointy zasobów. Jeśli te endpointy trzymają się konwencji REST, zespół RevOps może automatyzować procesy bez własnych obejść.
Operacje e-commerce: Zasoby fulfillment w Shopify REST zarządzają zamówieniami fulfillment, numerami śledzenia i stanami wysyłki. Aplikacje wysyłkowe i narzędzia fulfillment zależą od tej warstwy. Gdy API jest dobrze zaprojektowane — właściwe kody statusu, cacheowalne dane katalogowe, jasne komunikaty błędów — pipeline logistyczny działa płynnie. Gdy nie jest, pojawiają się tajemnicze awarie o 2 w nocy.
Ocena dostawców: Znajomość 6 ograniczeń daje praktyczną checklistę:
- Czy API używa standardowych kodów statusu, czy każda awaria wygląda jak 200 OK?
- Czy błędy są wystarczająco konkretne, by narzędzie automatyzacji mogło się po nich podnieść?
- Czy dokumentacja jasno opisuje limity, paginację i uwierzytelnianie?
- Czy typowe odpowiedzi można cache’ować, by zmniejszyć obciążenie?
Ekstrakcja danych i automatyzacja: Narzędzia takie jak Thunderbit wykorzystują architekturę opartą na REST, aby umożliwić użytkownikom biznesowym wyciąganie uporządkowanych danych ze stron internetowych, PDF-ów i obrazów — a następnie eksport do Google Sheets, Airtable, Notion lub Excela. Rozszerzenie Chrome AI Web Scraper Thunderbit upraszcza złożoność do interfejsu z 2 kliknięciami, ale pod spodem to właśnie zasady REST — bezstanowe żądania, odpowiedzi JSON, standardowe błędy — sprawiają, że warstwa integracji jest niezawodna.
Jeszcze jeden ważny sygnał: raport Postman 2025 wykazał, że tylko 24% programistów aktywnie projektuje API z myślą o agentach AI, a 51% obawia się nieautoryzowanych lub nadmiernych wywołań API ze strony agentów AI. Wraz z tym, jak automatyzacja i workflow oparte na AI stają się standardem w zespołach biznesowych, przewidywalne wzorce REST, klucze API o najmniejszych uprawnieniach i limity wywołań nie są już tylko problemem programistów — stają się czynnikami ryzyka operacyjnego.
Jak Thunderbit stosuje zasady REST dla użytkowników biznesowych
Zbudowaliśmy Thunderbit z założeniem, że większość naszych użytkowników nigdy nie będzie czytać specyfikacji REST — i nie powinna musieć. Ale decyzje projektowe, które sprawiają, że Thunderbit jest łatwy w użyciu, wyrastają z tych samych cech REST, o których mówi ten artykuł.
Krótki opis działania w praktyce:
- Zainstaluj rozszerzenie Chrome z Chrome Web Store i otwórz dowolną stronę, PDF lub obraz, z którego chcesz wyodrębnić dane.
- Kliknij „AI Suggest Fields” — AI Thunderbit odczyta stronę i zaproponuje uporządkowaną tabelę kolumn: nazwy produktów, ceny, e-maile, cokolwiek zawiera strona.
- Dopasuj kolumny, jeśli trzeba, a następnie kliknij „Scrape”. Thunderbit automatycznie obsłuży paginację, podstrony i dynamiczną treść.
- Wyeksportuj dane do Google Sheets, Airtable, Notion, CSV lub Excela — za darmo, bez paywalla.
Dla programistów i workflow automatyzacyjnych Open API Thunderbit udostępnia /distill (czysta ekstrakcja Markdown) i /extract (strukturalna ekstrakcja danych) jako endpointy POST w stylu REST z treściami JSON i standardowymi kodami błędów HTTP. W ujęciu Richardson Maturity Model to solidny poziom 2 — zasoby, właściwe metody, sensowne kody statusu.
Jeśli zgłębiasz web scraping lub szerzej ekstrakcję danych, napisaliśmy też bardziej szczegółowe przewodniki o AI web scraping, web scrapingu bez kodowania oraz czym właściwie jest web scraping.
Najważniejsze wnioski
- REST to styl architektoniczny, nie protokół. Definiuje 6 ograniczeń — klient–serwer, bezstanowość, cacheowalność, jednolity interfejs, system warstwowy i opcjonalny code-on-demand — które prowadzą projektowanie API.
- Większość „RESTful” API nie jest w pełni RESTful. Większość znajduje się na poziomie 2 Richardsona (zasoby + czasowniki HTTP + kody statusu). HATEOAS i code-on-demand są wdrażane rzadko.
- Richardson Maturity Model to najlepsze narzędzie do samooceny. Zastępuje binarne pytanie „REST czy nie” praktycznym spektrum (poziomy 0–3).
- Typowe błędy — HTTP 200 przy błędach, POST do wszystkiego, brak nagłówków cache — nadal są bardzo powszechne. Znajomość ograniczeń pomaga je zauważyć i naprawić.
- REST vs SOAP vs GraphQL vs gRPC nie chodzi o to, co „najlepsze”, tylko co pasuje. REST dominuje w publicznych API i integracjach CRUD. GraphQL pasuje do złożonych frontendów. gRPC świetnie sprawdza się w wewnętrznych mikroserwisach. SOAP trwa w kontekście enterprise/legacy.
- Zespoły biznesowe korzystają na rozumieniu cech REST przy ocenie dostawców, łączeniu narzędzi i budowaniu automatyzacji. Narzędzia takie jak Thunderbit stosują zasady REST, aby ułatwić ekstrakcję danych bez wymagania wiedzy technicznej.
FAQ
Jakie są 6 cech REST API?
6 ograniczeń REST to: (1) separacja klient–serwer, (2) bezstanowość, (3) cacheowalność, (4) jednolity interfejs, (5) system warstwowy i (6) code-on-demand (opcjonalnie). Pierwsze pięć jest obowiązkowe, aby API można było uznać za RESTful według oryginalnej definicji Fieldinga.
Jaka jest różnica między REST a RESTful?
REST to styl architektoniczny — zbiór ograniczeń projektowych zdefiniowanych przez Roya Fieldinga. „RESTful” opisuje API, które przestrzega tych ograniczeń. W praktyce wiele API określanych jako „RESTful” spełnia je tylko częściowo, zwykle implementując zasoby, metody HTTP i kody statusu, ale pomijając HATEOAS i code-on-demand.
Czy wszystkie REST API przestrzegają każdej reguły REST?
Nie. Większość produkcyjnych API stosuje separację klient–serwer, bezstanowość i podstawowy jednolity interfejs (zasoby + czasowniki HTTP). Cacheowalność i system warstwowy są wdrażane niespójnie. HATEOAS jest rzadkie, a code-on-demand niemal nigdy nie występuje w JSON API.
Jaka jest różnica między REST a GraphQL?
REST udostępnia zasoby przez wiele endpointów i standardowe metody HTTP (GET, POST, PUT, DELETE). GraphQL zwykle korzysta z jednego endpointu, w którym klient dokładnie określa, jakich pól potrzebuje w zapytaniu. REST ma mocniejszy natywny cache HTTP; GraphQL daje większą elastyczność przy złożonych, zagnieżdżonych danych i ogranicza over-fetching.
Czym jest HATEOAS i czy ktoś naprawdę z tego korzysta?
HATEOAS (Hypermedia as the Engine of Application State) oznacza, że odpowiedzi API zawierają linki informujące klienta, jakie akcje są dostępne dalej — dzięki temu klient może poruszać się po API bez hardkodowania każdego endpointu. To centralny element wizji REST Fieldinga (poziom 3 Richardsona), ale w praktyce bardzo niewiele publicznych API to implementuje. Większość zespołów zatrzymuje się na poziomie 2 i polega zamiast tego na dokumentacji oraz SDK.
Wypróbuj Thunderbit do AI Web Scraping
Wypróbuj Thunderbit do AI Web Scraping Get Started Free
Dowiedz się więcej



