
Jeśli kiedykolwiek szukałeś narzędzia do web scrapingu i trafiłeś zarówno na Thunderbit, jak i Bright Data, pewnie od razu zauważyłeś, że to wcale nie wyglądają jak podobne produkty. I słusznie — bo nimi nie są.
Jedno to oparte na AI rozszerzenie do przeglądarki dla użytkowników biznesowych, którzy chcą w kilka minut wyciągnąć uporządkowane dane ze strony internetowej. Drugie to modułowa platforma infrastruktury danych webowych z siecią proxy obejmującą ponad 195 krajów, wieloma API do scrapowania, zarządzanymi przeglądarkami i certyfikatami zgodności dla firm. Pojawiają się w tych samych wynikach wyszukiwania, ale rozwiązują zupełnie inne problemy dla zupełnie innych odbiorców. Spędziłem sporo czasu, analizując oba narzędzia — jak działają, ile kosztują, w czym są mocne, a gdzie mają ograniczenia — i celem tego porównania jest pomóc Ci ustalić, które z nich naprawdę pasuje do Twoich potrzeb. Nie do listy życzeń. Do Twojego rzeczywistego procesu pracy.
Thunderbit vs Bright Data w skrócie
Zanim przejdziemy do szczegółów, oto szybki przegląd.
| Obszar | Thunderbit | Bright Data |
|---|---|---|
| Typ produktu | Wtyczka AI do przeglądarki + aplikacja webowa + API | Platforma infrastruktury danych webowych (proxy, API, scrapery, zestawy danych) |
| Główny użytkownik | Użytkownicy biznesowi, sales ops, marketerzy, freelancerzy | Programiści, inżynierowie danych, zespoły danych w firmach |
| Model wdrożenia | Zainstaluj rozszerzenie, otwórz stronę, uruchom scrapowanie | Wybierz produkt, skonfiguruj poświadczenia/scraper, uruchom |
| Przyjazność bez kodowania | Główny proces działa bez kodu | Ma ścieżki no-code (Scraper Studio AI Agent, gotowe kolektory, datasets), ale głębsze funkcje wymagają technicznej konfiguracji |
| Model cenowy | Kredyty (wiersze) dla rozszerzenia; jednostki API dla API | Opłaty za żądanie, rekord, GB lub IP — zależnie od produktu |
| Podejście do skalowania | Strona po stronie lub harmonogram; API dla większych zadań | API o wysokiej współbieżności, zarządzane przeglądarki, sieci proxy |
| Eksport/dostarczenie | Google Sheets, Excel, Airtable, Notion, CSV, JSON | JSON, NDJSON, CSV, XLSX, Parquet, HTML, Markdown + API, webhook, storage w chmurze, SFTP, email, hurtownie danych |
| Najlepsze zastosowanie | Doraźne ekstrakcje, listy leadów, szybki research, monitoring o umiarkowanej skali | Duże pipeline’y, źródła z silną ochroną anty-bot, zgodność korporacyjna, ciągłe strumienie danych |
Czytaj dalej, aby zobaczyć pełne porównanie — funkcje, ceny, praktyczne zastosowania i macierz decyzji na końcu.
Czym jest Thunderbit?

Thunderbit to agentowe narzędzie do scrapowania stron i automatyzacji stworzone z myślą o użytkownikach biznesowych. Głównym interfejsem jest rozszerzenie do przeglądarek Chrome/Edge, uzupełnione o aplikację webową, Open API, MCP Server do workflow z agentami AI oraz CLI.
Thunderbit to agentowe narzędzie do web scrapingu: na zgodnej i dozwolonej stronie kliknij One Click Extract, a agent sam rozpozna, odczyta i przeanalizuje stronę, by zdecydować, co wyciągnąć. Run Now uruchamia zadanie od razu, ale jeśli nic nie zrobisz, proces i tak startuje automatycznie — więc domyślnie wystarczy jeden świadomy klik, bez kodu, selektorów czy konfiguracji schematu.
Podstawowy proces jest prosty: otwierasz stronę w przeglądarce i klikasz One Click Extract. Agent wykrywa, odczytuje i analizuje stronę; Run Now może wystartować natychmiast, a w przeciwnym razie ekstrakcja zaczyna się automatycznie, po czym możesz wyeksportować dane do Google Sheets, Excel, Airtable lub Notion. Możesz też użyć Cloud Mode dla publicznych stron, ustawić cykliczne harmonogramy oraz korzystać z gotowych szablonów dla popularnych witryn. AI nie tylko podpowiada pola — może też przekształcać, tłumaczyć, kategoryzować, podsumowywać lub formatować wartości w trakcie ekstrakcji dzięki Field AI Prompts.
Thunderbit ma również Open API obsługujące Distill (surową zawartość strony), ustrukturyzowany Extract, asynchroniczne batch’e, kontrolę renderowania, targetowanie kraju i webhooki. Ale podstawowe doświadczenie — to, z czego korzysta większość użytkowników — to no-code’owy workflow w przeglądarce.
Czym jest Bright Data?
Bright Data to szeroka platforma infrastruktury i dostarczania danych publicznych z internetu. To nie jedno narzędzie, lecz modułowy ekosystem, w którym wybierasz produkt lub produkty pasujące do Twoich potrzeb zbierania danych.
Rodziny produktów obejmują:
- Unlocker API — odblokowany dostęp do HTML/JSON dla chronionych stron
- SERP API — ustrukturyzowane wyniki wyszukiwarek
- Browser API / Agent Browser — zarządzany Chromium przez Puppeteer, Playwright lub Selenium
- Crawl API — cloud crawling, parsowanie i dostarczanie danych
- Scraper APIs — gotowe, ustrukturyzowane kolektory dla popularnych domen
- Scraper Studio — AI Agent (no-code) lub JavaScript IDE do własnych scraperów
- Datasets i Data Firehose — gotowe lub ciągłe strumienie danych
- Sieci proxy — residential (Bright Data deklaruje ponad 400 mln miesięcznych residential IP w 195+ krajach), datacenter, ISP i mobile
- MCP Server — do workflow opartych na agentach
Baza klientów Bright Data jest wyraźnie nastawiona na zespoły enterprise i developerów. Firma dokumentuje ISO 27001/27017/27018, SOC 2 Type II (pod NDA), publiczny SOC 3, CSA STAR oraz procesy KYC i przeglądu use case’ów. Platforma została zaprojektowana dla zespołów, które potrzebują zaawansowanej kontroli nad proxy, przeglądarkami, geolokalizacją, sesjami i zgodnością na dużą skalę.
Rozszerzenie do przeglądarki kontra infrastruktura proxy: dwa różne podejścia do scrapingu
Większość artykułów porównawczych całkowicie pomija różnicę architektoniczną — a to właśnie ona decyduje, którego narzędzia potrzebujesz.
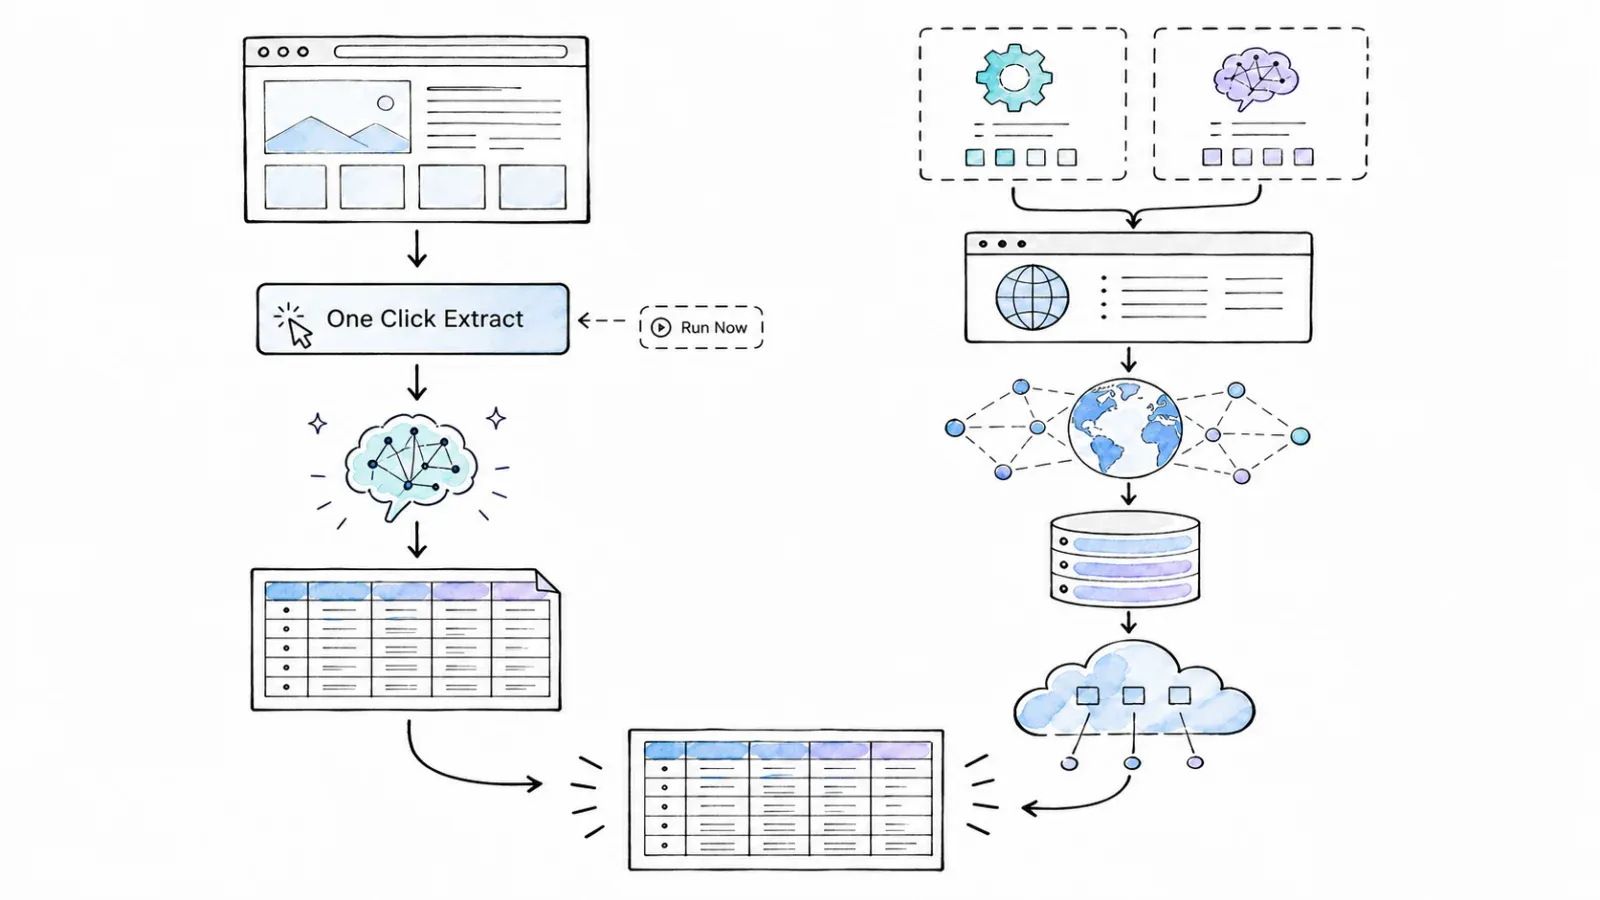
Model Thunderbit: instalujesz rozszerzenie do przeglądarki, przechodzisz na stronę, z której chcesz pobrać dane, i wyciągasz ustrukturyzowane informacje z tego, co widzisz. AI podpowiada kolumny. Scraping odbywa się z bieżącej strony (Browser Mode może korzystać z aktualnej sesji przeglądarki na zgodnych stronach) albo przez Cloud Mode dla stron publicznych. Można to traktować jak inteligentną warstwę „kopiuj-wklej” na Twoją przeglądarkę — taką, która rozumie tabele, listy i strukturę strony.
Model Bright Data: wybierasz produkt z modułowej platformy, konfigurujesz poświadczenia i logikę scrapera (albo używasz AI Agenta do jej wygenerowania), a następnie uruchamiasz ekstrakcję przez infrastrukturę chmurową Bright Data. Żądania mogą być routowane przez miliony IP, zarządzane przeglądarki obsługują renderowanie i wyzwania anty-bot, a dane trafiają przez API, webhook, storage w chmurze lub inne miejsca docelowe. To bardziej infrastruktura „hydrauliczna” dla zbierania danych na dużą skalę — wybierasz rury, ciśnienie i miejsce dostarczenia.
Tak wyglądają te architektury w porównaniu:
| Obszar | Thunderbit | Bright Data |
|---|---|---|
| Środowisko wykonania | Przeglądarka użytkownika (Browser Mode) lub chmura (Cloud Mode) | Infrastruktura chmurowa Bright Data |
| Wymagane przygotowanie | Zainstaluj rozszerzenie, otwórz stronę | Wybierz produkt, utwórz konto, skonfiguruj poświadczenia/scraper |
| Podejście do anty-bota | Zarządzane renderowanie na wspieranych stronach | Rotacja proxy, Unlocker, Browser API, obsługa CAPTCHA, zarządzanie fingerprintem |
| Główna interakcja | Wizualna, w przeglądarce, wspierana przez AI | Programistyczna (API/SDK) lub Scraper Studio (AI Agent/IDE); dodatkowo panel dla części produktów |
| Model skalowania | Strona po stronie, zadania cykliczne lub batch’e API | Żądania API o wysokiej współbieżności, zarządzane przeglądarki, sieci proxy |
Żadne z tych podejść nie jest uniwersalnie lepsze. Służą różnym problemom i różnym ludziom. Jeśli chcesz po prostu pobrać tabelę z strony, którą właśnie oglądasz, model Thunderbit doprowadzi Cię do celu szybciej. Jeśli musisz przepuścić 50 000 żądań przez rotujące residential IP z zarządzanym renderowaniem przeglądarki, model Bright Data został stworzony dokładnie do tego.
Doświadczenie no-code: jak każde z narzędzi wygląda dla użytkownika biznesowego
Jak wygląda realne doświadczenie dla osoby, która nigdy nie dotykała API? Bo wiele osób porównujących te narzędzia to nie programiści — tylko marketerzy, menedżerowie sales ops, freelancerzy zbierający dane albo właściciele małych firm.
Thunderbit: stworzone z myślą o przeglądarce
Workflow Thunderbit dla osoby nietechnicznej wygląda tak:
- Zainstaluj rozszerzenie z Chrome Web Store.
- Przejdź na stronę, z której chcesz pobrać dane (katalog, listing produktów, wyniki wyszukiwania itd.).
- Kliknij rozszerzenie i uruchom One Click Extract. AI odczyta stronę i zaproponuje kolumny (np. „Company Name”, „Price”, „Rating”).
- Sprawdź, zmień nazwę, dodaj lub usuń kolumny. Możesz też dodać Field AI Prompts, aby przekształcać dane w trakcie ekstrakcji — np. tłumaczyć na inny język, kategoryzować, podsumowywać, formatować numery telefonów itd.
- Skonfiguruj paginację lub wzbogacanie podstron, jeśli potrzebujesz danych z wielu stron albo stron szczegółowych.
- Run Now jest opcjonalne. Kliknij, aby uruchomić od razu; w przeciwnym razie proces startuje automatycznie. Wybierz Browser Mode (korzysta z bieżącej sesji) albo Cloud Mode (dla stron publicznych).
- Eksportuj bezpośrednio do Google Sheets, Excel, Airtable, Notion, CSV lub JSON.
Wszystko dzieje się w przeglądarce. Bez kluczy API, bez konfiguracji proxy, bez kodowania. Widzisz stronę, widzisz dane, eksportujesz je. Dla kogoś, kto po prostu potrzebuje listy leadów albo tabeli cen konkurencji, trudno o mniejszy próg wejścia.
Mimo to są obszary, które wymagają odrobiny myślenia: dopracowanie Field AI Prompts dla złożonego formatowania, radzenie sobie ze stronami o nietypowej strukturze oraz zrozumienie, kiedy dostępny jest Cloud Mode, a kiedy trzeba użyć Browser Mode.
Bright Data: infrastruktura z punktami wejścia no-code
Bright Data nie jest wyłącznie dla programistów — to częste, ale błędne założenie. Firma rzeczywiście oferuje ścieżki bez kodowania:
- Scraper Studio AI Agent: podajesz docelowy URL i opisujesz, czego potrzebujesz, zwykłym językiem. AI zadaje pytania doprecyzowujące, proponuje schemat, generuje scraper i pozwala go testować, publikować oraz harmonogramować — wszystko z poziomu dashboardu. W dokumentacji Bright Data szacuje się, że wygenerowanie scrapera zajmuje około 10–15 minut.
- Gotowe Scraper APIs: wybierasz wspierany kolektor dla popularnej domeny, podajesz parametry i uruchamiasz go z panelu lub przez API. Ustrukturyzowane rekordy wracają bez budowania niczego od zera.
- Datasets: wybierasz gotowy dataset, definiujesz sposób próbkowania/dostarczania/odświeżania i otrzymujesz dane bez tworzenia scrapera.
- Panel Crawl API: wpisujesz domeny lub URL-e, konfigurujesz wynik, uruchamiasz crawl i pobierasz rezultaty przez download, webhook lub storage.
Ale uczciwie trzeba powiedzieć: większość zaawansowanych funkcji Bright Data — Unlocker, Browser API, surowe strefy proxy, SERP API, własne scrapersy w IDE — wymaga wyboru produktu, zarządzania poświadczeniami i co najmniej pewnej konfiguracji technicznej. Warstwa no-code istnieje, ale opiera się na platformie stworzonej pierwotnie dla inżynierów.
| Aspekt | Thunderbit | Bright Data |
|---|---|---|
| Kroki do pierwszej ekstrakcji | Zainstaluj rozszerzenie → otwórz stronę → AI Suggest → Scrape → eksport | Utwórz konto → wybierz produkt → skonfiguruj lub użyj AI Agenta → uruchom → pobierz |
| Wymagana wiedza techniczna | Brak dla podstawowej ekstrakcji; trochę dla zaawansowanych promptów | Brak dla AI Agent/datasets; umiarkowana do wysokiej dla API, proxy i IDE |
| Czas do pierwszego wyniku | Minuty (według workflow opisanego przez dostawcę) | Zależnie od produktu; AI Agent według dostawcy: 10–15 min; ścieżki API/proxy zwykle dłuższe |
Czas do pierwszego scrapowania: jak szybko można dostać dane?
„Bright Data jest bardziej skomplikowane w konfiguracji” — przeczytasz to w niemal każdym artykule porównawczym, ale prawie nikt nie podaje konkretów. Nie robiłem kontrolowanego testu na identycznym celu, więc nie będę wymyślać liczb. Mogę jednak porównać opisane workflow dla typowego zadania: pobierania list produktów z publicznej strony e-commerce.
Thunderbit: udokumentowany workflow
| Krok | Co się dzieje |
|---|---|
| 1. Instalacja rozszerzenia | Jednorazowo, ok. 1 minuta |
| 2. Wejście na stronę | Otwierasz docelowy URL w przeglądarce |
| 3. One Click Extract | Jeden klik; agent wykrywa, odczytuje i analizuje stronę |
| 4. Przegląd/edycja pól | Zmiana nazwy, dodanie, usunięcie lub dodanie promptów |
| 5. Konfiguracja paginacji | Włączasz, jeśli potrzebne |
| 6. Automatyczny start | Run Now uruchamia natychmiast; w przeciwnym razie proces startuje sam |
| 7. Eksport | Jeden klik do Sheets, Excel, Airtable, Notion, CSV lub JSON |
Wymagania: przeglądarka Chrome lub Edge, zainstalowane rozszerzenie Thunderbit, konto Thunderbit (dostępny darmowy plan).
Bright Data: udokumentowane workflow (dwie ścieżki)
Scraper Studio AI Agent (no-code):
| Krok | Co się dzieje |
|---|---|
| 1. Utworzenie konta | Rejestracja, weryfikacja tożsamości |
| 2. Otwarcie Scraper Studio | Przejście do panelu Studio |
| 3. Podanie URL + opisu | Opisujesz AI, czego chcesz, zwykłym językiem |
| 4. Automatyczne przygotowanie | Agent ustala plan ekstrakcji; opcjonalne kontrolki doprecyzowują specjalistyczny wynik |
| 5. Test scrapera | Uruchamiasz test i sprawdzasz wynik |
| 6. Publikacja + uruchomienie | Harmonogram lub ręczne wywołanie |
| 7. Pobranie danych | Pobierasz z panelu, API, webhooka lub storage |
Scraper API (gotowy kolektor):
| Krok | Co się dzieje |
|---|---|
| 1. Utworzenie konta | Rejestracja, weryfikacja tożsamości |
| 2. Wybór kolektora | Wybierasz wspieraną domenę z katalogu |
| 3. Podanie danych wejściowych | URL-e, frazy wyszukiwania lub parametry |
| 4. Uruchomienie | Z panelu lub przez API |
| 5. Pobranie danych | Ustrukturyzowane rekordy przez panel, API lub miejsce dostarczenia |
Wymagania: konto Bright Data (dla części produktów dostępne darmowe limity), wybór produktu oraz — dla ścieżek API/proxy — wygenerowanie i konfiguracja klucza API.
Wniosek: Thunderbit jest zbudowane z myślą o szybkim uzyskaniu wartości przy zadaniach doraźnych — pobierasz dane ze strony, którą już masz otwartą, przy minimalnej liczbie decyzji. Ścieżka AI Agenta w Bright Data jest realna, ale platforma nadal wymaga wyboru produktu, zrozumienia jednostki rozliczeniowej i poruszania się po większym dashboardzie. Jednorazowe zadanie? Ścieżka Thunderbit jest krótsza. Budowanie trwałego, harmonogramowanego scrapera z dostarczaniem do hurtowni danych? Wtedy Studio Bright Data ma więcej sensu jako inwestycja.
Thunderbit vs Bright Data: porównanie funkcja po funkcji
| Funkcja | Thunderbit | Bright Data |
|---|---|---|
| agentowa analiza strony | One Click Extract + opcjonalne Field AI Prompts | Scraper Studio AI Agent (język naturalny → schemat → scraper) |
| Wzbogacanie podstron | Obsługiwane (dane ze stron szczegółowych łączone z główną tabelą) | Obsługiwane przez własne workflow Studio/Browser/Crawl oraz niektóre gotowe kolektory |
| Obsługa paginacji | Paginacja i infinite scroll są wspierane | Obsługiwane w Studio, Crawl API i gotowych kolektorach |
| Ekstrakcja według harmonogramu | Harmonogram cykliczny (Starter: do 5; Pro: do 25, minimalna częstotliwość 5 min) | Studio: harmonogram godzinowy/dzienny/tygodniowy/własny; monitoring i alerty operacyjne |
| Miejsca eksportu | Google Sheets, Airtable, Notion, Excel, CSV, JSON | JSON, NDJSON, CSV, XLSX, Parquet, HTML, Markdown + API, webhook, storage w chmurze, SFTP, email, hurtownie danych |
| Wykonanie w przeglądarce vs w chmurze | Browser Mode (bieżąca sesja) i Cloud Mode (strony publiczne, do 50 naraz według deklaracji dostawcy) | Tylko chmura; zarządzane przeglądarki, żądania routowane przez proxy |
| Infrastruktura proxy/IP | Zarządzana na wspieranych powierzchniach; API ma kontrolę renderowania/kraju/nagłówków/cookies | Residential (400M+ miesięcznych IP według dostawcy), datacenter, ISP, mobile; kontrola geo/sesji/ASN/operatora |
| Obsługa anty-bot | Zarządzane renderowanie/anty-bot na wspieranych stronach i w API | Unlocker, Browser API, proxy, CAPTCHA, fingerprint i mechanizmy retry |
| Gotowe scrapery/szablony | Szablony stron + dedykowane ekstraktory email/telefon/obraz | Gotowe Scraper APIs dla popularnych domen (liczby podawane przez dostawcę różnią się zależnie od powierzchni; oficjalne strony wspominają od 100+ do 600+) |
| Dostęp do API | Open API: Distill, Extract, Suggest Fields, asynchroniczne batch’e, webhooki | Wiele produktów API: Crawl, Unlocker, Browser, Scraper, SERP, Datasets, Proxies |
| Wsparcie MCP/agentów | Oficjalne open-source MCP + CLI | Oficjalny hostowany MCP, Agent Browser, Search & Extract |
| Ekstrakcja dokumentów/obrazów | Dokumentowane narzędzia do PDF i obrazów | Nie jest to główny fokus; część parsowania danych w Crawl/Studio |
| Obsługa wielu języków | Field AI Prompts mogą tłumaczyć podczas ekstrakcji | Język wyniku zależy od źródła; brak wbudowanego tłumaczenia „on extract” |
| Certyfikacje zgodności | Role GDPR/CCPA, DPA na życzenie, TLS/AES; publicznie nie znaleziono SOC 2 | ISO 27001/27017/27018, SOC 2 Type II (pod NDA), publiczny SOC 3, CSA STAR, KYC |
W czym wyróżnia się Thunderbit
- One Click Extract i wizualny workflow w przeglądarce. Widzisz stronę, widzisz kolumny wykryte przez agenta, poprawiasz je i uruchamiasz scrapowanie. Pętla informacji zwrotnej jest natychmiastowa.
- Ekstrakcja jednym kliknięciem z nazwanymi szablonami dla popularnych serwisów oraz dedykowanymi ekstraktorami emaili, telefonów i obrazów.
- Bezpośredni eksport do narzędzi biznesowych — Google Sheets, Airtable, Notion, Excel — bez pośrednich kroków.
- Field AI Prompts, które przekształcają, tłumaczą, kategoryzują lub formatują dane podczas ekstrakcji. To naprawdę przydatne dla użytkowników biznesowych, którzy potrzebują czystych, gotowych do użycia danych.
- Szybki czas do wartości przy jednorazowych i okazjonalnych zadaniach scrapingu. Jeśli potrzebujesz tabeli ze strony „na już”, Thunderbit jest bardzo trudne do pobicia.
W czym wyróżnia się Bright Data
- Ogromna infrastruktura proxy. Bright Data deklaruje ponad 400 mln miesięcznych residential IP w 195+ krajach, a także sieci datacenter, ISP i mobile. Jeśli potrzebujesz żądań z targetowaniem geograficznym, kontrolą sesji lub dużą różnorodnością IP, to masz tu znacznie większy arsenał.
- Produkty do walki z anty-bot i odblokowywania treści. Unlocker, Browser API, obsługa CAPTCHA, zarządzanie fingerprintem i logika retry są stworzone z myślą o mocno chronionych stronach (Cloudflare, DataDome, PerimeterX itd.). Skuteczność zależy od celu i czasu, ale zestaw narzędzi jest znacznie szerszy.
- Ekstrakcja o wysokiej współbieżności, oparta na API i skalowana. FAQ Scraper Studio dokumentuje do 1 000 równoległych batch jobów na scraper przed kolejkowaniem. Wiele API produktów wspiera złożone architektury pipeline’ów.
- Gotowe Scraper APIs dla popularnych domen, a także datasets, Data Firehose i zarządzane pozyskiwanie danych dla zespołów, które wolą dostawę danych niż sam scraping.
- Certyfikacje zgodności dla enterprise. ISO 27001, SOC 2 Type II (pod NDA), SOC 3, CSA STAR i KYC są udokumentowane i istotne dla branż regulowanych oraz zakupów korporacyjnych.
Thunderbit vs Bright Data: ceny — ile naprawdę zapłacisz?
Cennik to tutaj jedna z najtrudniejszych kwestii do uczciwego wyjaśnienia. Oba narzędzia rozliczają użycie zupełnie inaczej, więc proste porównanie „za stronę” nie ma sensu.
Cennik Thunderbit (stan na sierpień 2026)
No-code’owe rozszerzenie Thunderbit działa w systemie kredytów. Standardowe scrapowanie kosztuje 1 kredyt za wyjściowy wiersz; wzbogacanie podstron kosztuje 2 kredyty na wiersz; Personal Data Enrichment kosztuje 30 kredytów za skuteczne zapytanie.
| Plan | Cena miesięczna | Kredyty/miesiąc |
|---|---|---|
| Free | $0 | 6 stron/miesiąc, maks. 30 kredytów/strona |
| Starter | $15/miesiąc | 500/miesiąc |
| Pro Tier 1 | $38/miesiąc | 3 000/miesiąc |
| Pro Tier 2 | $75/miesiąc | 6 000/miesiąc |
| Pro Tier 3 | $125/miesiąc | 10 000/miesiąc |
| Pro Tier 4 | $249/miesiąc | 20 000/miesiąc |
| Business | Niestandardowy | Niestandardowy |
Rozliczenie roczne jest znacznie tańsze (np. Starter spada do $108/rok za 5 000 kredytów rocznie).
Open API ma osobny licznik: Distill kosztuje 1 jednostkę API na stronę; Extract kosztuje 20 jednostek na stronę. Plany API zaczynają się od $16/miesiąc (rozliczane rocznie) za 60 000 jednostek/rok.
Cennik Bright Data (stan na sierpień 2026)
Cennik Bright Data różni się zależnie od produktu i sposobu naliczania. Oto podstawowe stawki pay-as-you-go dla kluczowych produktów:
| Produkt | Darmowy limit | Cena startowa PAYG | Jednostka rozliczeniowa |
|---|---|---|---|
| Unlocker API | 5 tys. żądań/miesiąc | $1.50 / 1 tys. skutecznych żądań | Skuteczne żądania |
| SERP API | 5 tys. żądań/miesiąc | $1.50 / 1 tys. skutecznych żądań | Skuteczne żądania |
| Scraper APIs | 5 tys. rekordów/miesiąc | $1.50 / 1 tys. dostarczonych rekordów | Rekordy |
| Scraper Studio | 5 tys. ładowań stron/miesiąc | $1.50 / 1 tys. ładowań stron | Ładowania stron |
| Browser API | Trial różni się | $8 / GB | Przesłany transfer |
| Residential proxies | PAYG | $8 / GB | Transfer danych |
| Datasets | Próbki różnią się | Od $250 / 100 tys. rekordów | Rekordy + zakres odświeżania |
Globalna nawigacja Bright Data czasem pokazuje niższe wartości „od”, które dotyczą wysokich progów wolumenu albo promocji. Zawsze sprawdzaj aktualną stronę cennika dla konkretnego produktu, który analizujesz.
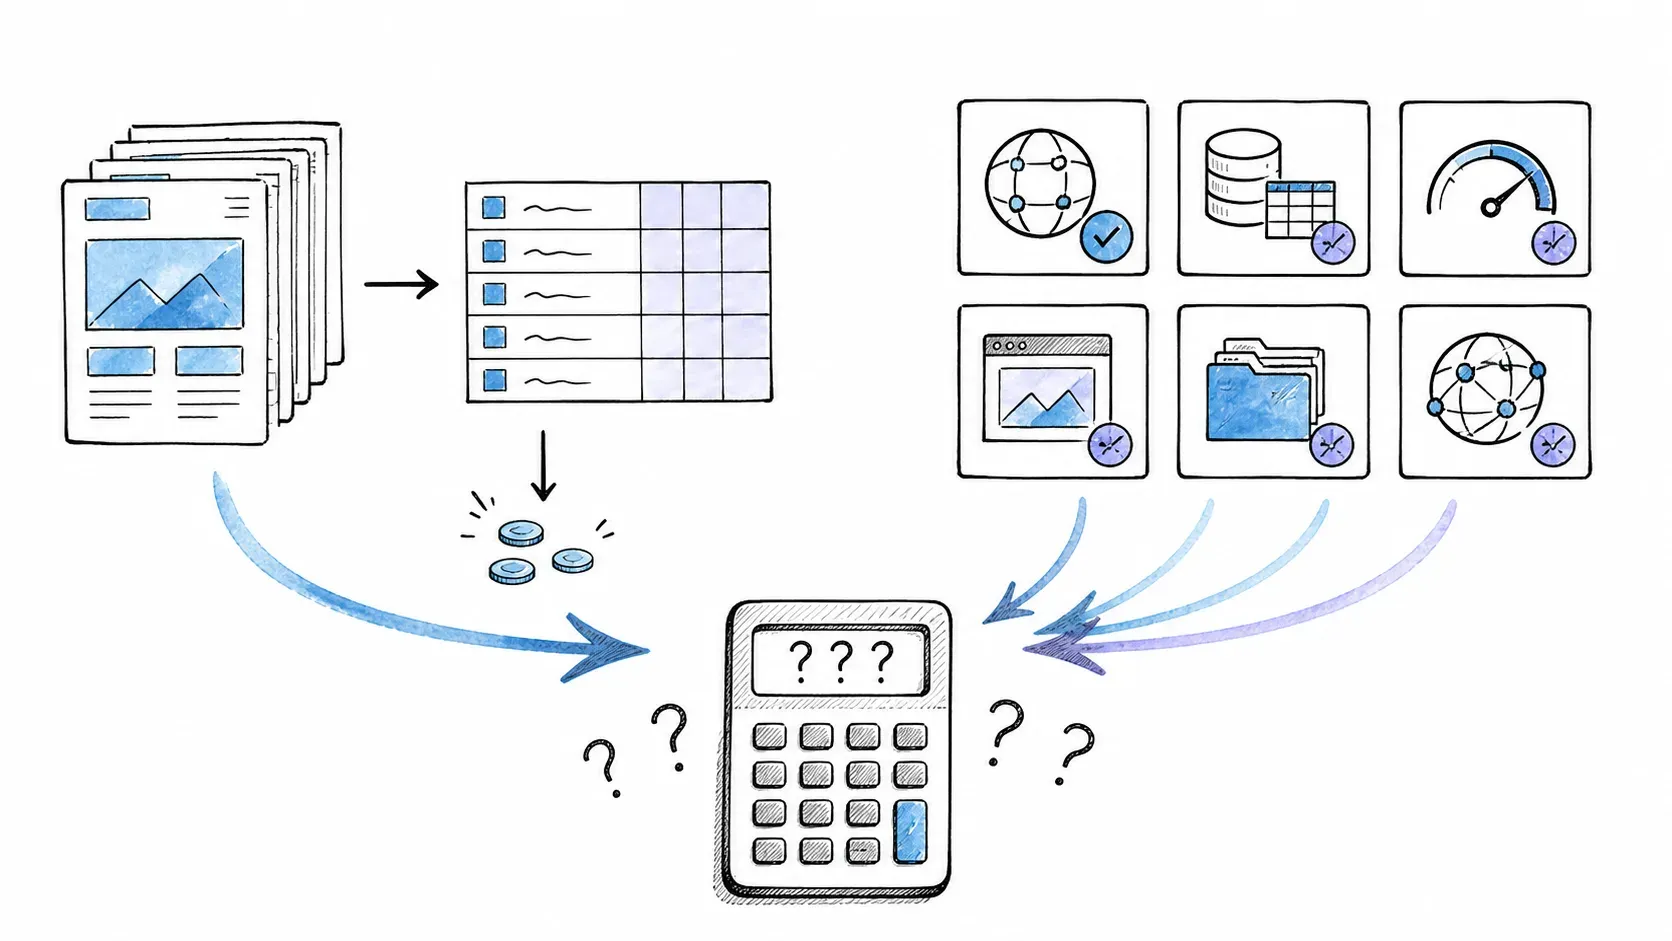
Dlaczego nie ma prostego zwycięzcy cenowego
Sto stron kategorii z 50 wierszami każda może oznaczać 5 000 kredytów no-code w Thunderbit (na poziomie Pro Tier 1 to około $38/miesiąc). To samo zadanie w Bright Data może być 100 page loadów w Scraper Studio, 5 000 dostarczonych rekordów przez Scraper API albo zmienny transfer danych przez Browser API — każda z tych opcji ma inną cenę. „Tańsze” narzędzie zależy wyłącznie od:
- tego, którego produktu/obszaru używasz na każdej platformie
- liczby wyjściowych wierszy przypadających na jeden URL wejściowy
- potrzeby paginacji, podstron lub renderowania w przeglądarce
- rozliczenia miesięcznego vs rocznego
- retry, brakujących pól i zasad naliczania nadwyżek
Dla lekkiego i średniego użycia przez zespoły nietechniczne (kilkaset do kilku tysięcy wierszy miesięcznie) plany kredytowe Thunderbit są zazwyczaj bardziej przewidywalne i bardziej opłacalne. Dla wysokowolumenowych pipeline’ów opartych na API z rozbudowanymi wymaganiami dostarczania danych Bright Data może być bardziej opłacalne na dużą skalę — ale trzeba to policzyć dla konkretnego produktu i metryki.
Zawsze sprawdź aktualne ceny na stronie cennika Thunderbit oraz odpowiedniej stronie cennika Bright Data przed podjęciem decyzji.
Praktyczne zastosowania: Thunderbit vs Bright Data w działaniu
Funkcje na papierze nie zamykają tematu — zamykają go workflowy. Oto pięć typowych scenariuszy i to, jak każde narzędzie sobie z nimi radzi.
Budowanie listy leadów z katalogu
Scenariusz: menedżer sales ops potrzebuje 200 kontaktów z niszowego branżowego katalogu, wyeksportowanych do Google Sheets.
Dopasowanie Thunderbit: to jest idealny case dla Thunderbit. Otwierasz katalog w przeglądarce, uruchamiasz One Click Extract, pozwalasz agentowi przeanalizować stronę i wystartować automatycznie, a potem eksportujesz dane bezpośrednio do Sheets. Bez API, bez proxy, bez kodu. Jeśli strona wymaga zalogowanej sesji, Browser Mode może użyć Twojej bieżącej sesji na zgodnych stronach.
Dopasowanie Bright Data: możliwe przez gotowe Scraper API (jeśli katalog jest wspierany) albo własny scraper w Scraper Studio. Ale dla 200 kontaktów z jednej strony narzut konfiguracji — tworzenie konta, wybór produktu, konfiguracja scrapera — jest trudny do uzasadnienia. Bright Data jest zaprojektowane do takich zadań na dużo większą skalę (tysiące lub dziesiątki tysięcy rekordów).
Monitorowanie cen konkurencji na setkach SKU
Scenariusz: zespół e-commerce śledzi 500+ cen produktów co tydzień na kilku stronach konkurencji.
Dopasowanie Thunderbit: harmonogramowana ekstrakcja na wspieranych stronach sprawdza się dobrze przy umiarkowanych wolumenach. Konfigurujesz scraper dla każdego konkurenta, ustawiasz paginację, planujesz cotygodniowe uruchomienia i eksportujesz do Sheets lub Airtable. Dla 500 SKU prawdopodobnie potrzebny będzie plan Pro.
Dopasowanie Bright Data: dla mocno chronionych sklepów e-commerce (np. zabezpieczonych przez Cloudflare) Unlocker lub Browser API Bright Data, połączone z workflow Scraper Studio lub Scraper API, będzie bardziej odporne. Jeśli śledzisz tysiące SKU na dziesiątkach stron z rozbudowanymi mechanizmami anty-bot, infrastruktura Bright Data jest do tego stworzona. Kosztem jest większa konfiguracja i wyższa krzywa nauki.
Jednorazowy research do raportu rynkowego
Scenariusz: analityk marketingowy potrzebuje danych z 5 stron internetowych do raportu kwartalnego — list produktów, liczby recenzji, poziomów cen.
Dopasowanie Thunderbit: idealne. Instalujesz rozszerzenie, odwiedzasz każdą stronę, scrapujesz, eksportujesz. Zero inwestycji w infrastrukturę, zero dodatkowego kosztu poza planem, który już masz. To dokładnie ten typ zadania, w którym Thunderbit pokazuje swój największy atut: szybki czas do wartości.
Dopasowanie Bright Data: przesada. Czas konfiguracji i proces wyboru produktu nie uzasadniają jednorazowego zadania na 5 stronach. Chyba że strony są mocno chronione i nie da się zdobyć danych inaczej, Bright Data jest tu po prostu większym narzędziem, niż potrzebujesz.
Duży pipeline danych dla zespołu inżynieryjnego
Scenariusz: zespół data engineering buduje zautomatyzowany pipeline do pobierania 100 tys.+ stron dziennie z wielu źródeł, z dostarczaniem do chmurowej hurtowni danych.
Dopasowanie Thunderbit: Open API obsługuje asynchroniczne batch’e, webhooki i — według deklaracji dostawcy — skalę do milionów stron przy nawet 50 równoległych żądaniach w planie Pro API. Dla pipeline’ów średniej skali jest to realna opcja. Jednak głównym centrum projektowym Thunderbit pozostaje rozszerzenie do przeglądarki i workflow dla użytkowników biznesowych, a nie infrastruktura wysokiej współbieżności.
Dopasowanie Bright Data: stworzone dokładnie do tego. Wiele API produktów (Crawl, Unlocker, Browser, Scraper, SERP), zarządzane przeglądarki, sieci proxy oraz dostarczanie do webhooków, storage w chmurze, SFTP i hurtowni danych. Scraper Studio dokumentuje do 1 000 równoległych batch jobów na scraper. Jeśli potrzebujesz głębokiej kontroli proxy, targetowania geograficznego, zarządzania sesjami i dowodów zgodności enterprise, Bright Data jest naturalniejszym kandydatem do oceny.
Zbieranie danych treningowych do AI/ML
Scenariusz: inżynier ML potrzebuje ustrukturyzowanych danych treningowych z setek domen, odświeżanych co miesiąc.
Dopasowanie Thunderbit: API może obsłużyć ustrukturyzowaną ekstrakcję przy umiarkowanej skali, a integracja z MCP/CLI ułatwia użycie w workflowach agentów AI. Dla mniejszych, dobrze zdefiniowanych zbiorów działa bardzo dobrze.
Dopasowanie Bright Data: Datasets, Data Firehose i Scraper APIs są stworzone właśnie do tego — danych ustrukturyzowanych na dużą skalę, z wielu domen i regularnie odświeżanych. MCP Server i Agent Browser dodają dostęp zorientowany na agentów. Przy danych treningowych na dużą skalę Bright Data oferuje więcej powierzchni i opcji dostarczania.
Wybierz Thunderbit, gdy… / Wybierz Bright Data, gdy…
Znajdź swój wiersz w poniższej macierzy. Bądź ze sobą szczery, do której kategorii naprawdę należysz.
| Jeśli jesteś… | I potrzebujesz… | Rozważ… |
|---|---|---|
| Marketerem lub osobą z sales ops (nietech.) | Szybkiej listy leadów lub danych konkurencji, wyeksportowanych do Sheets/Excel | Thunderbit — rozszerzenie do przeglądarki, One Click Extract, bezpośredni eksport |
| Solo founderem lub freelancerem | Doraźnych ekstrakcji bez inwestycji w infrastrukturę | Thunderbit — darmowy plan, szybka konfiguracja, bez stałych kosztów infrastruktury |
| Zespołem operacyjnym o umiarkowanym wolumenie | Cotygodniowego monitoringu kilkuset do kilku tysięcy wierszy | Thunderbit — ekstrakcje cykliczne, plany Pro, eksport do narzędzi biznesowych |
| Programistą budującym pipeline danych | Wysokowolumenowej ekstrakcji API z rotacją proxy i dostarczaniem do hurtowni danych | Bright Data — Crawl/Unlocker/Browser APIs, sieci proxy, dostarczanie przez webhook/storage |
| Zespołem danych w enterprise | Zbierania danych na dużą skalę z potwierdzoną zgodnością i wymaganiami zakupowymi | Bright Data — certyfikacje ISO/SOC, KYC, kontrola enterprise, zarządzane pozyskiwanie danych |
| Inżynierem AI/ML | Ustrukturyzowanych danych treningowych na dużą skalę, stale odświeżanych | Bright Data — Datasets, Firehose, Scraper APIs, MCP; Thunderbit API warto rozważyć dla mniejszych zadań |
| Osobą pracującą z mocno chronionymi stronami | Danych ze źródeł zabezpieczonych przez Cloudflare/DataDome/PerimeterX na dużą skalę | Bright Data — Unlocker, Browser API, rotacja proxy, narzędzia CAPTCHA/fingerprint |
Decyzja nie dotyczy tego, które narzędzie jest „lepsze”. Moc Thunderbit to prostota no-code i szybki czas do wartości dla użytkowników biznesowych. Moc Bright Data to głęboka infrastruktura, odporność na anty-bot, zgodność enterprise i skalowanie dla zespołów technicznych. Używanie jednego tam, gdzie lepiej pasuje drugie, jest jak przyjście z piłą mechaniczną do otwierania listu.
Zgodność i prywatność danych: co powinien wiedzieć użytkownik biznesowy
Żaden program bezpieczeństwa czy zgodności nie daje automatycznie pozwolenia na scrapowanie dowolnego źródła. Za autoryzowany dostęp, obowiązujące przepisy, zobowiązania dotyczące danych osobowych oraz regulaminy stron zawsze odpowiada użytkownik. Oba narzędzia wymagają zgodności z przepisami o prywatności danych, takimi jak GDPR i CCPA.
Bright Data dokumentuje ISO/IEC 27001:2022, ISO 27017, ISO 27018, SOC 2 Type II (pod NDA), publiczny raport SOC 3, CSA STAR, TLS 1.3, AES-256 w spoczynku oraz proces KYC / przeglądu use case’ów. Ma to znaczenie dla branż regulowanych i zespołów procurement w enterprise, które wymagają dowodów audytowych.
Thunderbit opisuje role związane z GDPR/CCPA/CPRA, DPA na życzenie, SCC, TLS 1.2+ i AES-256 w spoczynku w swoich warunkach oraz polityce prywatności. Na moment pisania tego tekstu nie znaleziono publicznego potwierdzenia SOC 2.
Jeśli zbierasz dane osobowe albo działasz w branży regulowanej, skonsultuj się z prawnikiem. Narzędzia zgodności to punkt startowy, a nie meta.
Thunderbit vs Bright Data: wybierz narzędzie dopasowane do realnych potrzeb
Thunderbit to oparte na AI rozszerzenie do przeglądarki dla użytkowników biznesowych, którzy chcą szybko dostać dane w uporządkowanej formie, bez kodu i z minimalną konfiguracją. Bright Data to modułowa platforma infrastruktury danych webowych dla programistów i zespołów enterprise, które potrzebują skali, odporności na anty-bot, głębokiej kontroli proxy i potwierdzeń zgodności.
- Jeśli chcesz pobrać dane ze strony w przeglądarce i wyeksportować je do Sheets w kilka minut: wypróbuj Thunderbit.
- Jeśli budujesz długoterminowy pipeline danych z zasobami inżynieryjnymi i wymaganiami enterprise: sprawdź Bright Data.
- Jeśli jesteś gdzieś pośrodku: zacznij od prostszego narzędzia i sięgnij po cięższe, gdy Twoje potrzeby urosną. To nie jest wymówka — tak właśnie większość zespołów ewoluuje swoje workflowy danych.
FAQ
Co jest tańsze: Thunderbit czy Bright Data?
Dla lekkiego i średniego użycia przez zespoły nietechniczne (kilkaset do kilku tysięcy wierszy miesięcznie) plany kredytowe Thunderbit są zazwyczaj bardziej przystępne cenowo i przewidywalne. Cennik Bright Data jest nastawiony na użycie infrastrukturalne i duży wolumen, a stawki zależą od produktu i jednostki rozliczeniowej (za żądanie, rekord, GB lub IP). Bezpośrednie porównanie kosztów wymaga dopasowania konkretnego produktu, wolumenu i sposobu naliczania. Zawsze sprawdzaj aktualne stawki na stronie cennika Thunderbit oraz odpowiedniej stronie cennika Bright Data.
Czy mogę używać Thunderbit i Bright Data razem?
Tak. Niektóre zespoły używają Thunderbit do szybkich, doraźnych ekstrakcji (wyszukiwanie leadów, jednorazowy research, małe zadania monitorujące), a Bright Data do dużych lub mocno chronionych źródeł, które wymagają infrastruktury proxy. Takie podejście „hybrydowe” pozwala dobrać narzędzie do zadania, bez przepłacania za nadmierną konfigurację przy prostych zadaniach ani bez niedoinwestowania infrastruktury przy złożonych.
Czy potrzebuję umiejętności kodowania, żeby korzystać z Thunderbit lub Bright Data?
Thunderbit: do workflow rozszerzenia do przeglądarki kod nie jest potrzebny. Open API, MCP i CLI wymagają już wiedzy technicznej. Bright Data: Scraper Studio AI Agent, gotowe kolektory i datasets to opcje low-code, które nie wymagają pisania skryptów. Ale większość zaawansowanych funkcji — Unlocker, Browser API, surowe strefy proxy, własne scrapersy w IDE — wymaga udziału programisty. Pełna moc Bright Data oznacza konfigurację techniczną.
Co jest lepsze do scrapowania LinkedIna: Thunderbit czy Bright Data?
Thunderbit może wyciągać dane ze stron, do których masz autoryzowany dostęp w przeglądarce (np. z własnej sesji LinkedIn na zgodnych stronach). Bright Data oferuje gotowe Scraper APIs dla LinkedIna przez swoje API. Oba narzędzia wymagają przestrzegania regulaminu LinkedIna i obowiązujących przepisów. LinkedIn bardzo agresywnie egzekwuje swoje zasady, więc działaj ostrożnie niezależnie od narzędzia. Więcej o podejściach do lead generation znajdziesz w naszym przewodniku.
Co jeśli Thunderbit przestanie mi wystarczać — czy później mogę przejść na Bright Data?
Zdecydowanie tak. Thunderbit eksportuje dane do standardowych formatów (CSV, JSON, Excel, Google Sheets), które można zaimportować do dowolnego pipeline’u. Jeśli Twoje potrzeby urosną poza możliwości rozszerzenia lub API Thunderbit — albo jeśli potrzebujesz głębszej infrastruktury proxy, anty-bot czy zgodności — możesz przejść na Bright Data (albo używać go równolegle z Thunderbit) bez utraty dotychczasowych danych i workflowów. Te dwa narzędzia nie zamykają Ci drogi.
Dowiedz się więcej




