
Wybór między Thunderbit a Apify jest trochę jak decyzja między wiertarką a całym warsztatem maszynowym. Obydwa narzędzia wywiercą dziurę w ścianie, ale doświadczenie — i rachunek — będą zupełnie inne. Thunderbit to agentowy web scraper.
Thunderbit to agentowy web scraper: na zgodnej, dozwolonej stronie wystarczy kliknąć One Click Extract, a agent wykryje, odczyta i przeanalizuje stronę, żeby zdecydować, co wyciągnąć. Run Now uruchamia zadanie od razu, ale jeśli nic nie zrobisz, proces wystartuje automatycznie — więc domyślnie potrzebny jest tylko jeden świadomy klik, bez kodu, selektorów czy konfiguracji schematu.
Od lat buduję i oceniam narzędzia do web scrapingu (nasz zespół w Thunderbit stworzył jedno z nich, więc mam na ten temat własne zdanie), a pytanie, które najczęściej słyszę od osób z sales ops, analityków marketingowych i founderów, brzmi zawsze tak samo: „Którego właściwie powinienem używać?” W internecie znalazłem mnóstwo artykułów porównawczych z ładnymi tabelkami funkcji, ale żaden nie pokazuje, jak to naprawdę się czuje, gdy używa się obu narzędzi do tego samego zadania. I właśnie tę praktyczną lukę chciałem wypełnić. Przeprowadzę Cię przez rzeczywiste workflow, matematykę cenową, możliwości dla developerów i — co najważniejsze — uczciwe wskazówki, kiedy które narzędzie będzie lepszym wyborem. Bez chochołów, bez marketingowego nadęcia. Tylko fakty, kilka tabel i parę kiepskich żartów.
Czym są Thunderbit i Apify (i dla kogo je stworzono)?
Thunderbit to AI web scraper dostępny jako rozszerzenie do Chrome i Edge (plus aplikacja webowa), stworzony dla użytkowników biznesowych, którzy chcą szybko pozyskiwać uporządkowane dane ze stron internetowych — bez kodu. Otwierasz stronę, klikasz „One Click Extract” i pozwalasz agentowi przeanalizować stronę; „Run Now” uruchamia wszystko natychmiast, a jeśli nic nie zrobisz, ekstrakcja startuje automatycznie. Wyniki można wyeksportować do Excel, Google Sheets, Airtable lub Notion. Narzędzie jest skierowane przede wszystkim do zespołów sprzedaży, managerów operacyjnych i badaczy, którzy nie chcą uczyć się selektorów CSS ani uruchamiać kontenerów w chmurze. Rozszerzenie ma w Chrome Web Store ponad 100 000 użytkowników.

Apify to chmurowa platforma do web scrapingu, automatyzacji przeglądarki i ekstrakcji danych — ale w praktyce to znacznie szersza platforma aplikacyjna. Jej centralnym elementem jest Actor Store, czyli marketplace z dziesiątkami tysięcy gotowych narzędzi (zwanych „Actors”), obejmujących wszystko od scraperów produktów Amazon po ekstraktory mediów społecznościowych. Gotowego Actora ze sklepu możesz uruchomić z poziomu formularza w konsoli, bez pisania kodu, albo zbudować własnego Actora w JavaScript lub Pythonie, korzystając z Apify SDK i Crawlee (ich open-source’owej biblioteki do crawlingu, mającej ok. 25 000 gwiazdek na GitHubie). Publiczność Apify obejmuje zarówno osoby nietechniczne uruchamiające gotowe Actors, jak i zespoły inżynieryjne budujące złożone, harmonogramowane pipeline’y danych. Platforma deklaruje 74 000 klientów i przetwarza ponad 1 PB danych miesięcznie.
Kluczowa różnica jest prosta. Thunderbit został zaprojektowany do agentowej, jednoplikowej ekstrakcji z aktualnie oglądanej strony. Apify to szersza platforma, w której wybierasz (lub tworzysz) odpowiedniego Actora do zadania, a następnie orkiestrujesz go przez harmonogramy, webhooki, storage i proxy.
Zadanie: Co chciałem zeskrapować i dlaczego to ma znaczenie w porównaniu Thunderbit vs Apify
Żeby decyzja była konkretna, wybrałem zadanie, które dobrze oddaje to, co naprawdę robią zespoły sprzedażowe i operacyjne: ekstrakcję listingów produktów z publicznej strony kategorii e-commerce. Chodzi o nazwę produktu, cenę, ocenę i URL produktu — czyli typ uporządkowanych danych, które przydają się do analizy konkurencji, list leadów albo researchu produktowego.
To celowo proste, reprezentatywne zadanie. Tego typu praca ma Cię doprowadzić z „patrzę na tę stronę” do „mam czysty arkusz” w kilka minut, a nie godzin. Poniższe sekcje pokazują, jak każde z narzędzi przechodzi przez każdy etap — od konfiguracji, przez ustawienie pól, aż po uruchomienie scrapingu i wysłanie danych do Google Sheets.
Krótka uwaga dla jasności: nie robiłem kontrolowanego benchmarku laboratoryjnego z zamrożonymi wersjami, identycznymi ustawieniami ponowień i wzorcowym zbiorem danych. (Jeśli ktoś chce taki test, potrzebowałby zespołu badawczego i miesiąca czasu.) Zamiast tego przeszedłem przez prawdziwy workflow w obu narzędziach, opisałem kroki i porównałem doświadczenie. Tam, gdzie nie mogę uczciwie postawić znaku równości — np. przy koszcie na stronę albo dokładności — powiem to wprost.
Krok po kroku: Thunderbit vs Apify przy tym samym zadaniu scrapingu
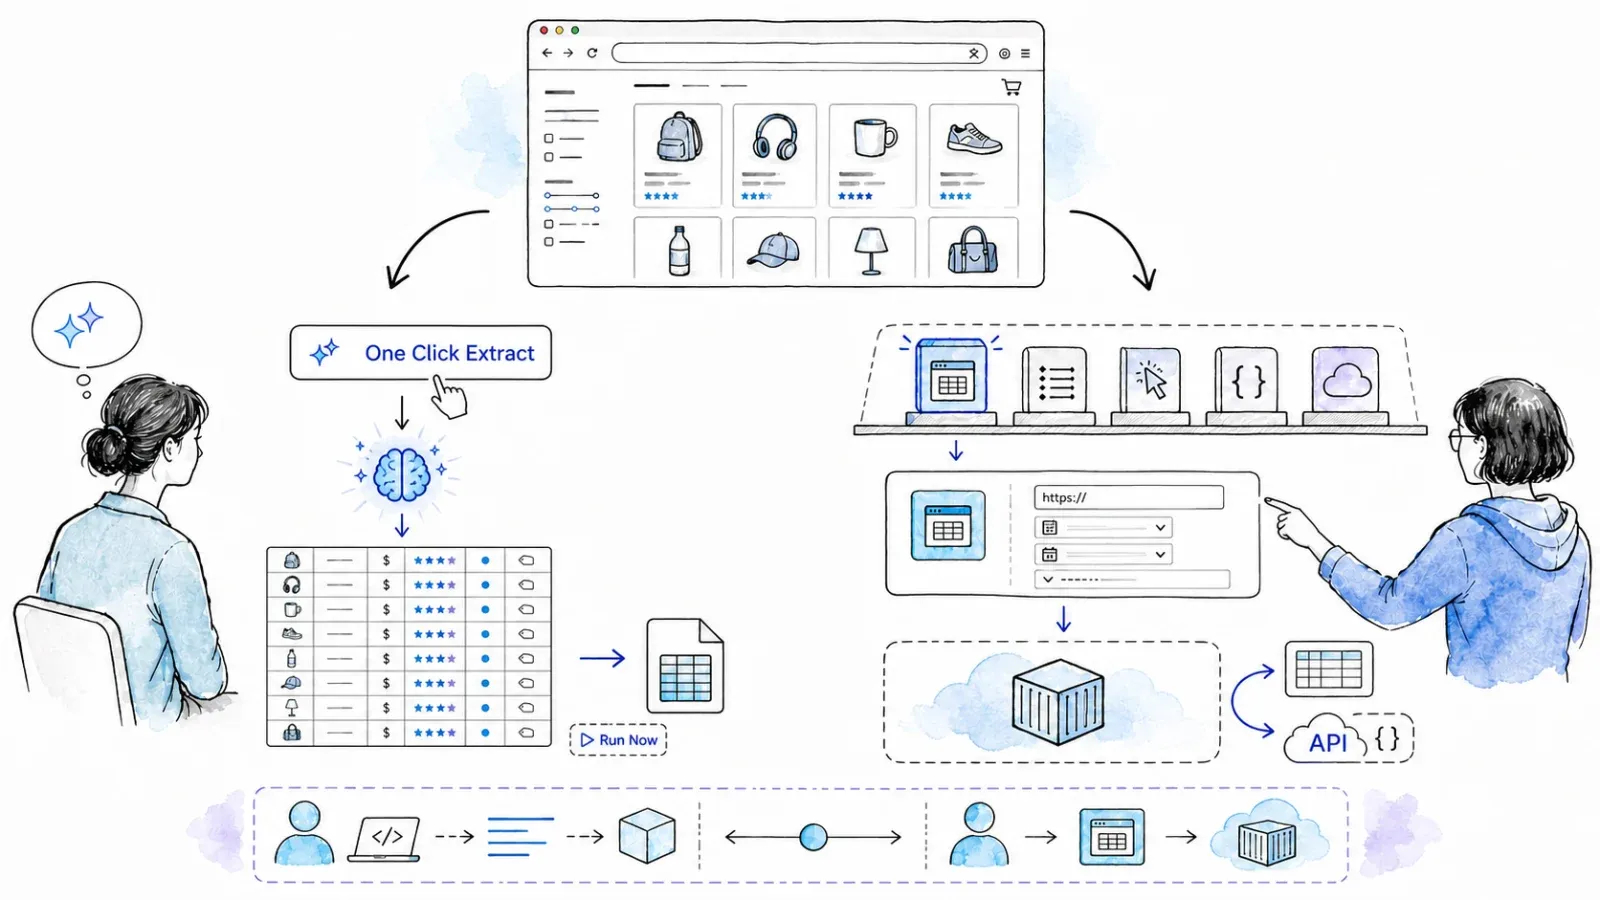
To jest ta część, której nie daje Ci żaden inny artykuł porównawczy: rzeczywisty workflow, krok po kroku, w obu narzędziach.
Konfiguracja: instalacja i tworzenie konta
Thunderbit: Instalujesz rozszerzenie Thunderbit do Chrome ze sklepu Chrome Web Store. Nie ma kodu, serwera ani kontenera Docker. Zakładasz konto i możesz działać. Onboarding jest mniej więcej tak skomplikowany jak instalacja adblockera.
Apify: Zakładasz konto na apify.com, co daje Ci dostęp do Console — webowego panelu do zarządzania Actors, uruchomieniami, storage, harmonogramami i integracjami. Następnie przeglądasz Actor Store, żeby znaleźć gotowego scrapera pasującego do docelowej strony. Jeśli chcesz zbudować własnego, skorzystasz z Web IDE, CLI albo lokalnego środowiska deweloperskiego.
Konfiguracja Thunderbit to instalacja rozszerzenia w przeglądarce. Konfiguracja Apify to założenie konta w aplikacji webowej plus znalezienie (lub zbudowanie) właściwego Actora. Oba rozwiązania można uruchomić za darmo.
Konfiguracja pól: One Click Extract vs wybór Actora w Apify
Thunderbit: Gdy jesteś na stronie, którą chcesz zeskrapować, klikasz „One Click Extract”. AI odczytuje stronę i proponuje zestaw kolumn — na przykład: Nazwa produktu, Cena, Ocena, URL. Ekstrakcja może wystartować automatycznie nawet bez dodatkowej konfiguracji. Jeśli potrzebujesz bardziej wyspecjalizowanego wyniku, możesz dodać własne instrukcje na poziomie pola (np. „wyciągnij tylko wartość liczbową ceny, bez symbolu waluty”). Bez analizy DOM, bez selektorów CSS, bez kodu.
Apify: Wyszukujesz w Actor Store scraper dopasowany do celu (np. ogólny web scraper albo Actor dla konkretnej witryny). Każdy Actor ma własny schemat wejściowy — czasem wystarczy po prostu wkleić URL i kliknąć Start, ale w innych przypadkach trzeba ustawić selektory, zasady paginacji, proxy albo pola wyjściowe. Jeśli żaden gotowy Actor nie pasuje, może być konieczne zbudowanie albo dostosowanie własnego w JavaScript lub Pythonie.
AI w Thunderbit samo wykrywa pola za Ciebie. Gotowe Actors w Apify mogą robić to automatycznie dla obsługiwanych stron, ale Actors niestandardowe lub ogólne często wymagają ręcznej konfiguracji wejścia.
Uruchamianie scrapingu i obsługa paginacji
Thunderbit: Możesz kliknąć „Run Now”, aby rozpocząć od razu; w przeciwnym razie rozszerzenie startuje automatycznie i przetwarza stronę. Jeśli występuje paginacja albo infinite scroll, w kompatybilnych witrynach obsługuje to wbudowany workflow paginacji Thunderbit. Widzisz, jak wiersze pojawiają się na bieżąco, bezpośrednio w przeglądarce.
Apify: Uruchamiasz Actora z poziomu Console (albo przez API/CLI). Obsługa paginacji zależy od Actora — niektóre radzą sobie z nią automatycznie, inne wymagają ustawienia w wejściu. Uruchomienie wykonuje się w chmurze, a postęp, logi i wyniki monitorujesz w Console.
Thunderbit działa w przeglądarce (Browser Mode) albo w chmurze (Cloud Mode). Apify zawsze działa w chmurze. Paginacja w Thunderbit jest wbudowana; w Apify zależy od Actora.
Eksport wyników: dane do Google Sheets, Excel lub Airtable
Thunderbit: Po zakończeniu scrapingu eksportujesz dane bezpośrednio do Excel, CSV, JSON, Google Sheets, Airtable lub Notion — wszystko z poziomu rozszerzenia lub aplikacji webowej. W większości przypadków to eksport jednym kliknięciem.
Apify: Wyniki trafiają do Dataset w Console, skąd można je pobrać jako JSON, CSV, XML, Excel albo HTML. Do Google Sheets możesz użyć integracji Apify albo skonfigurować workflow przez webhook/Zapier/Make/n8n. Jest to bardziej elastyczne, ale dla użytkownika nietechnicznego oznacza też więcej kroków.
Eksport w Thunderbit jest bezpośredni i wbudowany. Eksport w Apify jest potężny i programowalny, ale może wymagać dodatkowej konfiguracji, jeśli celem są narzędzia biznesowe.
Tabela podsumowująca obok siebie
| Krok | Thunderbit (rozszerzenie przeglądarki) | Apify |
|---|---|---|
| Konfiguracja / konto | Instalacja rozszerzenia Chrome, bez kodu | Rejestracja, Actor Store lub SDK |
| Konfiguracja pól | One Click Extract → analiza agentowa | Wybór gotowego Actora albo konfiguracja schematu wejściowego |
| Uruchomienie scrapingu | Kliknij „Scrape” w przeglądarce | Start Actora z Console lub API |
| Obsługa paginacji | Wbudowany workflow paginacji (na kompatybilnych stronach) | Konfigurowana dla konkretnego Actora (zależnie od szablonu) |
| Eksport | Do Excel, Google Sheets, Airtable, Notion | CSV/JSON, webhook API, integracje |
| Wymagany kod? | Nie (dla rozszerzenia/aplikacji webowej) | Nie dla gotowych Actors; tak dla własnych |
Analiza strony przez agenta vs ręczne selektory: kiedy które podejście wygrywa, a kiedy zawodzi
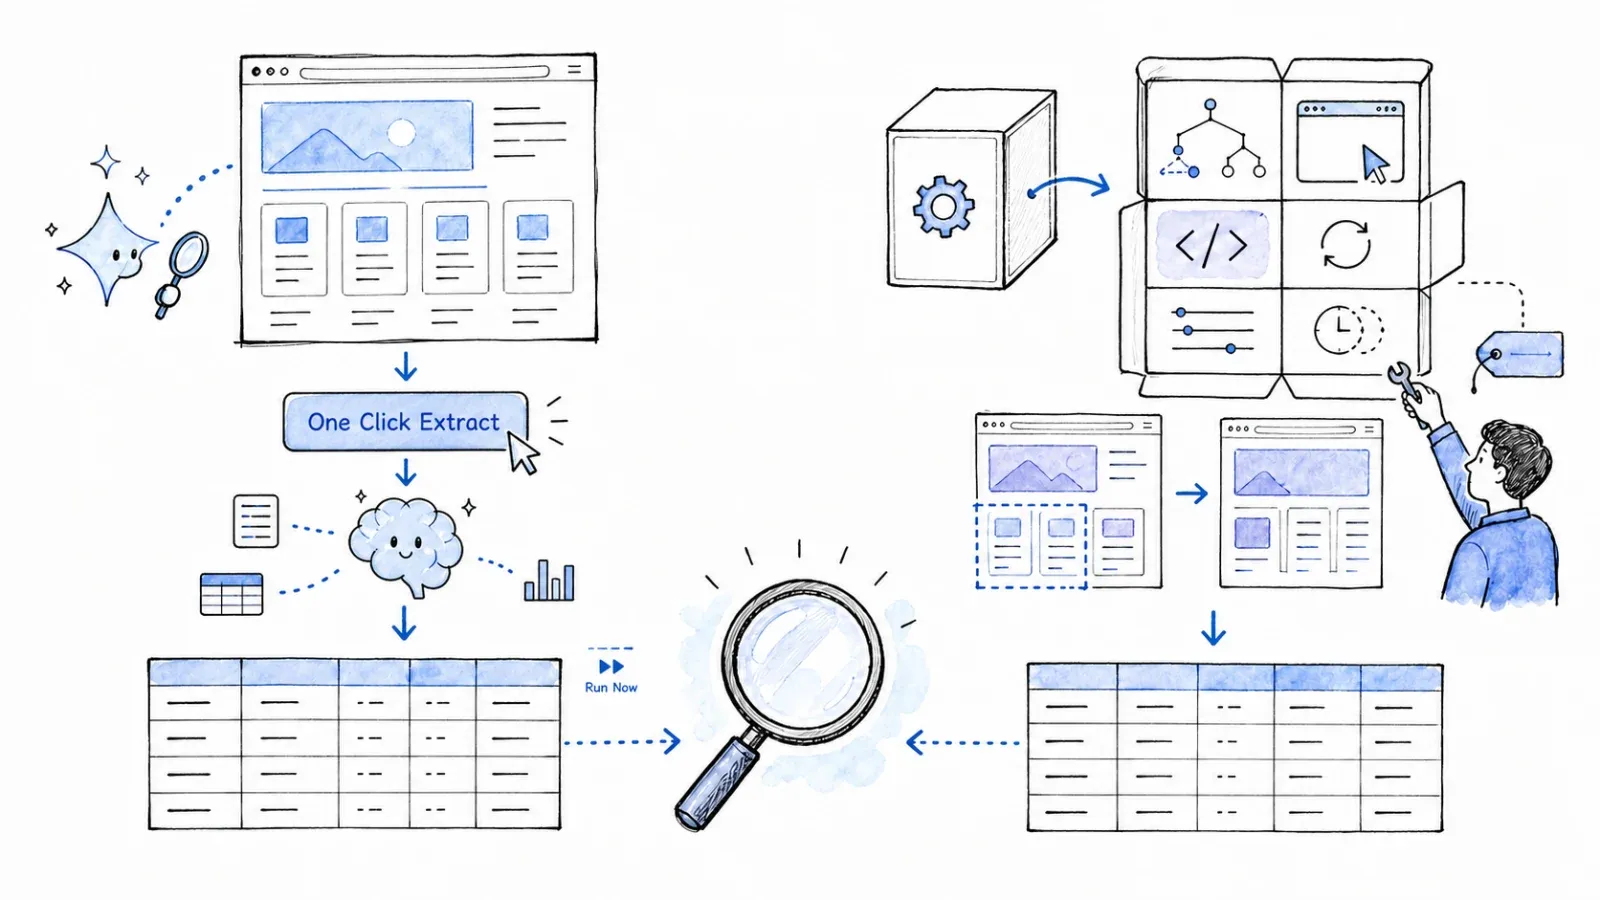
Jedną z największych praktycznych różnic między Thunderbit a Apify jest to, jak mówisz narzędziu, jakie dane ma wyciągnąć. Thunderbit korzysta z agentowej analizy strony; Apify — w zależności od Actora — opiera się na gotowych selektorach, wysokopoziomowych polach wejściowych albo własnym kodzie. Żadne z podejść nie jest uniwersalnie lepsze — każde ma realne zalety i realne tryby awarii.
Kiedy agentowa analiza strony błyszczy (Thunderbit)
- Nieznane strony, jednorazowa ekstrakcja: Trafiasz na stronę, której nigdy wcześniej nie scrapowałeś. AI w Thunderbit odczytuje układ i proponuje kolumny. Nie musisz zaglądać do DOM ani pisać selektorów.
- Szybka konfiguracja dla użytkowników nietechnicznych: Jeśli nie wiesz, czym jest selektor CSS, One Click Extract jest wybawieniem.
- Zmiany układu strony: Ponieważ AI odczytuje stronę za każdym razem od nowa, może dostosować się do drobnych zmian układu na kompatybilnych stronach. (Jednocześnie własne Warunki Thunderbit zaznaczają, że wyniki AI mogą być niedokładne i należy je niezależnie zweryfikować — więc zawsze sprawdzaj rezultaty.)
Kiedy wygrywają ręczne selektory albo konfiguracja specyficzna dla Actora (Apify)
- Bardzo uporządkowany, stabilny HTML: Jeśli HTML strony jest dobrze zorganizowany i rzadko się zmienia, dobrze zbudowany Actor z precyzyjnymi selektorami może dawać stabilny, przewidywalny wynik.
- Złożona, zagnieżdżona lub dynamiczna zawartość: Własne Actor-y dają pełną kontrolę — możesz obsłużyć logowanie, wieloetapową nawigację, wywołania API i trudne renderowanie JavaScript.
- Niszowe lub wyspecjalizowane Actor-y: Actor Store może mieć narzędzie stworzone dokładnie pod Twój cel (np. Amazon, Google Maps, LinkedIn), z polami wejściowymi dopasowanymi do struktury danej witryny.
Uczciwie o trybach awarii
- agentowa analiza strony (Thunderbit): Może błędnie zinterpretować niejednoznaczny układ, pogrupować pola w nieoczekiwany sposób albo pominąć dane na stronach o nietypowej strukturze. Ważne wyniki zawsze warto zweryfikować po ekstrakcji.
- Ręczne selektory (Apify): Psują się, gdy serwis przebuduje HTML. Community Actors mogą nie być aktualizowane na czas. Własne Actors wymagają stałej konserwacji.
Szybkie porównanie: wykrywanie AI vs ręczne selektory
| Scenariusz | agentowa analiza strony (Thunderbit) | Ręczne selektory / konfiguracja Actora (Apify) |
|---|---|---|
| Nieznana strona, jednorazowa ekstrakcja | ✅ Szybka konfiguracja, bez analizy DOM | ⚠️ Może wymagać sprawdzenia struktury strony lub znalezienia pasującego Actora |
| Strona o bardzo uporządkowanym, stabilnym HTML | ✅ Działa dobrze, ale zalecana jest ręczna weryfikacja | ✅ Precyzyjne i niezawodne, jeśli selektory/Actor są dobrze zbudowane |
| Złożona, zagnieżdżona lub dynamiczna zawartość | ⚠️ Może wymagać instrukcji dla pól lub ręcznych poprawek | ✅ Pełna kontrola przez własny kod Actora |
| Zmiana projektu strony | ✅ AI analizuje stronę ponownie przy następnym uruchomieniu (warto sprawdzić wyniki) | ⚠️ Selektory mogą się zepsuć i wymagać aktualizacji Actora |
Żadne z tych podejść nie jest rozwiązaniem typu „ustaw i zapomnij”. Oba wymagają nadzoru i kontroli. Różnica polega na tym, gdzie trafia wysiłek.
Thunderbit vs Apify: modele cenowe wyjaśnione (dlaczego prosta tabelka kosztu za stronę nie działa)
Ceny są najbardziej mylącą częścią tej decyzji i chcę powiedzieć to wprost: nie da się po prostu podzielić ceny planu przez liczbę stron i otrzymać sensownego wyniku. Oba narzędzia stosują fundamentalnie różne jednostki rozliczeniowe.
Jak działa model cenowy Thunderbit
W planach no-code Thunderbit rozlicza się w creditach, gdzie 1 standardowy wiersz wynikowy = 1 credit, 1 wiersz z podstrony = 2 credity, a wzbogacanie danych i funkcje zaawansowane kosztują więcej. Oto migawka z cennika Thunderbit (sprawdź aktualne dane na żywo, zanim na nich polegasz):
| Plan | Miesięcznie | Rocznie | Kredyty |
|---|---|---|---|
| Free | $0 | $0 | 6 stron/miesiąc (sprawdź aktualny limit w tabeli planów na żywo) |
| Starter | $15/mies. | $108/rok | 500/mies. lub 5 000/rok |
| Pro 1 | $38/mies. | $288/rok | 3 000/mies. lub 30 000/rok |
| Pro 2 | $75/mies. | $576/rok | 6 000/mies. lub 60 000/rok |
| Pro 3 | $125/mies. | $1 152/rok | 10 000/mies. lub 120 000/rok |
| Pro 4 | $249/mies. | $2 304/rok | 20 000/mies. lub 240 000/rok |
Ważne: „strony” w opisie darmowego planu i „wiersze wynikowe” w zasadach kredytowych to nie to samo. Jedna strona z listingiem może wygenerować wiele wierszy.
Thunderbit ma też osobny model cenowy API dla developerów (Distill = 1 jednostka/strona, Extract = 20 jednostek/strona, roczne jednostki wydawane z góry).
Jak działa model cenowy Apify
Apify rozlicza się za pomocą compute units (CU) — gdzie 1 CU = 1 GB RAM przydzielony na 1 godzinę — plus potencjalne koszty ruchu proxy, storage, transferu danych i opłat specyficznych dla Actora. Oto migawka z cennika Apify (sprawdź aktualne dane na żywo):
| Plan | Miesięcznie / rocznie | Wliczone użycie platformy | Stawka CU |
|---|---|---|---|
| Free | $0 | $5/mies. | $0.20/CU |
| Starter | $29 / $26 | $29/mies. | $0.20/CU |
| Scale | $199 / $179 | $199/mies. | $0.16/CU |
| Business | $999 / $899 | $999/mies. | $0.13/CU |
Ważne: rzeczywiste zużycie CU zależy od przydziału RAM dla Actora i czasu jego działania, a nie od liczby stron czy wierszy. Actor-y ze sklepu mogą też pobierać opłatę za zdarzenie (PPE) lub za użycie (PPU), z cenami zdarzeń ustalanymi przez twórcę. Koszty proxy, storage i transferu mogą szybko urosnąć, zwłaszcza przy dużej skali.
Dlaczego nie publikuję tabeli kosztu za stronę
Wiem, że zarysy zakładały tabelę porównującą koszt dla 100/1 000/10 000 stron. Nie zamierzam tego zmyślać i już tłumaczę dlaczego:
- Kredyty Thunderbit ≠ compute units Apify ≠ strony ≠ wiersze.
- Koszt uruchomienia w Apify zależy od Actora, jego RAM-u, czasu działania, proxy/storage oraz tego, czy pobiera opłatę za zdarzenie lub użycie.
- Koszt scrapingu w Thunderbit zależy od liczby wierszy wyjściowych, wzbogacania podstron oraz tego, czy korzystasz z rozszerzenia czy API.
- Bez uruchomienia dokładnie tego samego zadania na dokładnie tej samej stronie w obu narzędziach i bez zmierzenia wszystkich zmiennych, każda liczba „kosztu za stronę” byłaby myląca.
Moja rada: Przy małej skali, do jednorazowych zadań, oba darmowe plany mogą wystarczyć. Wraz ze wzrostem wolumenu model kredytowy Thunderbit bywa bardziej przewidywalny przy prostych ekstrakcjach, natomiast model CU w Apify może być bardziej opłacalny przy dużej skali, długich procesach lub złożonych pipeline’ach — ale tylko wtedy, gdy rozumiesz i optymalizujesz zużycie zasobów przez Actora. Zawsze sprawdzaj aktualne cenniki i, jeśli to możliwe, wykonaj mały test na rzeczywistej skali, zanim podejmiesz decyzję.
Dla developerów: Thunderbit API, MCP i CLI vs Apify Actor SDK
Jeśli jesteś developerem — albo osobą technicznie obeznaną, która zastanawia się, czy narzędzie urośnie razem z zespołem — ta sekcja jest dla Ciebie.
Ścieżki developerskie Thunderbit
Thunderbit oferuje trzy punkty wejścia dla developerów, wszystkie skoncentrowane na zarządzanej ekstrakcji stron:
- Open API: endpointy HTTP/JSON dla Distill (zwraca Markdown gotowy dla LLM) i Extract (zwraca uporządkowany JSON według Twojego schematu), a także asynchroniczne workflow Batch z obsługą webhook/polling. Tryby renderowania obejmują
none,basicifull; funkcje zarządzane obejmują rotację proxy, routing geograficzny, retry i obsługę anti-bot (z ograniczeniami — żadna strona nie jest gwarantowana). - MCP Server: pakiet
@thunderbit/mcp-serverudostępnia Distill, Extract, Suggest Fields i batch do kompatybilnych hostów AI (Claude, Cursor, Windsurf itd.). - CLI: pakiet
@thunderbit/thunderbit-cliwspiera workflow terminalowe i z udziałem agentów kodujących, z wyjściem w formacie JSON/Markdown/tabel.
Czym nie są ścieżki developerskie Thunderbit: Nie są uniwersalnym runtime’em dla Actorów/kontenerów. Nie zbudujesz tu dowolnych aplikacji, nie opublikujesz narzędzi na marketplace i nie zorkiestrujesz wieloetapowych workflow z trwałymi kolejkami i storage. Abstrakcja polega na zarządzanej ekstrakcji — wysyłasz URL-e, dostajesz z powrotem uporządkowane dane.
Ścieżki developerskie Apify
Ekosystem developerski Apify jest szerszy i głębszy:
- REST API v2: pełna kontrola nad Actorami, uruchomieniami, buildami, taskami, harmonogramami, webhookami i storage. Oficjalne klienty JavaScript i Python obsługują retry i limity.
- Actor SDK: twórz własnych Actorów w JavaScript lub Pythonie, korzystając z Apify SDK i/lub Crawlee (open-source, Apache-2.0, ok. 25 000 gwiazdek na GitHubie). Crawlee obsługuje HTTP/Cheerio/JSDOM/Playwright/Puppeteer i wiele przeglądarek.
- CLI:
apify-clido wyszukiwania/uruchamiania Actorów, tworzenia/wysyłania/pobierania projektów i konfiguracji MCP. - Actor Store: dziesiątki tysięcy Actorów tworzonych przez społeczność i utrzymywanych przez Apify. Możesz opublikować własnego.
- Scheduling: wbudowane harmonogramy w stylu cron z obsługą stref czasowych i DST (do 10 Actorów i 10 Tasków na harmonogram).
- Webhooks: zdarzenia cyklu życia Actor/build, retry i wykładniczy backoff.
- Storage: Datasets, key-value stores i request queues.
- Proxy: produkty proxy datacenter, residential i Google SERP z opcjami rotacji, sesji i geolokalizacji.
- MCP: hostowane i lokalne endpointy MCP do integracji z agentami AI (z ograniczeniami wynikającymi z uprawnień i modelu Actora).
- Integrations: Make, n8n, Zapier, GitHub, Google Sheets, frameworki AI (LangChain, LlamaIndex) i inne.
Tabela porównawcza ścieżek developerskich
| Możliwość | Thunderbit | Apify |
|---|---|---|
| Dostęp do API | Open API (Distill, Extract, async Batch) | Pełne REST API v2 + Actor SDK |
| Obsługiwane języki | HTTP/JSON (niezależne od języka) | SDK JavaScript/Python |
| Integracja z agentami AI | MCP Server, wtyczka Claude Code | MCP, integracje LLM społeczności |
| CLI / terminal | @thunderbit/thunderbit-cli | apify-cli |
| Marketplace własnych scraperów | Brak | Actor Store (dziesiątki tysięcy Actorów) |
| Harmonogramy | Zależne od planu | Wbudowane, cron-style |
| Storage | Na poziomie konta (zorientowany na eksport) | Datasets, key-value stores, request queues |
| Zarządzanie proxy | Zarządzane (API), bez konfiguracji użytkownika | Datacenter, residential, SERP, konfigurowalne |
| Wdrożenie | SaaS (bez wdrożeń użytkownika) | Web IDE, push przez CLI, Git, Docker, Standby |
Jeśli Twoja potrzeba brzmi: „daj mi uporządkowane dane z URL-i”, API Thunderbit jest proste i zarządzane. Jeśli chcesz budować, wdrażać i orkiestrwać własne aplikacje do scrapingu i automatyzacji na dużą skalę, platforma Apify daje Ci znacznie więcej narzędzi — ale kosztem wyższej krzywej uczenia i większej liczby ruchomych elementów.
Wybierz Thunderbit, gdy (uczciwe rekomendacje)
Jestem tu stronniczy — współzałożyłem Thunderbit — ale postaram się być tak uczciwy, jak sam chciałbym usłyszeć od kogoś innego.
Thunderbit będzie lepszym wyborem na start, gdy:
- Jesteś użytkownikiem nietechnicznym (sprzedaż, operacje, marketing, research) i chcesz mieć uporządkowane dane ze strony od razu, bez nauki kodowania i konfigurowania selektorów.
- Chcesz agentowej analizy strony, która sama odczytuje układ i podpowiada kolumny.
- Twój workflow ma charakter ad hoc: sprawdzanie cen konkurencji, pozyskiwanie leadów, research produktów lub szybkie pobranie danych do arkusza czy bazy Airtable.
- Chcesz bezpośrednio i wbudowanie eksportować dane do Excel, Google Sheets, Airtable lub Notion — bez webhooków i bez konfiguracji integracji.
- Cenisz szybkość uzyskania pierwszego wyniku bardziej niż głęboką personalizację. (Z mojego doświadczenia większości użytkowników biznesowych bardziej zależy na czystych danych w 5 minut niż na 47 opcjach konfiguracji.)
- Chcesz korzystać z istniejącej, zalogowanej sesji przeglądarki do ekstrakcji ze stron wymagających autoryzacji (Browser Mode).
Kiedy Thunderbit może nie być najlepszym wyborem:
- Bardzo duże, cykliczne pipeline’y z rozbudowaną orkiestracją.
- Strony wymagające wieloetapowej nawigacji, niestandardowych flow logowania lub zaawansowanej ochrony anty-bot wykraczającej poza możliwości zarządzanego systemu.
- Zespoły, które chcą budować i dystrybuować własne narzędzia do scrapingu lub aplikacje.
Opinie użytkowników w Chrome Web Store często wskazują wygodę rozszerzenia i automatyczne ustawianie pól przez AI jako jego największe zalety.
Wybierz Apify, gdy (uczciwe rekomendacje)
Ta sekcja to nie ustępstwo — to rada, jaką dałbym znajomemu. Apify to naprawdę potężna platforma i w niektórych przypadkach jest po prostu właściwym narzędziem.
Apify będzie lepszym wyborem na start, gdy:
- Chcesz budować własne Actor-y przy użyciu SDK do złożonego, wieloetapowego crawlowania, automatyzacji przeglądarki lub przetwarzania danych.
- Twój zespół uruchamia duże, harmonogramowane pipeline’y z integracjami webhook, trwałym storage i request queues.
- Chcesz korzystać z marketplace’u scraperów utrzymywanych przez społeczność dla niszowych stron (w Actor Store są dziesiątki tysięcy opcji).
- Potrzebujesz zaawansowanego zarządzania proxy i orkiestracji headless browser na dużą skalę — proxy datacenter, residential lub SERP z rotacją i kontrolą sesji.
- Twój workflow wykracza poza scraping: wypełnianie formularzy, automatyzacja mediów społecznościowych, backendy API czy narzędzia dla agentów AI.
- Chcesz publikować i udostępniać własne narzędzia innym użytkownikom przez Store.
Kiedy Apify może nie być najlepszym wyborem:
- Użytkownicy nietechniczni, którzy po prostu chcą szybko pobrać dane ze strony, którą właśnie oglądają, bez kodu. (Gotowe Actors pomagają, ale odkrywanie i konfiguracja nadal mogą stanowić barierę.)
- Zespoły, które chcą natychmiastowej, agentowej analizy strony bez konfigurowania schematów wejściowych czy selektorów.
- Użytkownicy, którzy chcą bezpośredniego eksportu jednym kliknięciem do Airtable lub Notion bez uruchamiania integracji.
Apify zdobywa bardzo dobre oceny na zewnętrznych portalach opinii — około 4,7/5 na G2 i 4,8/5 na Capterra — z pochwałami za szerokość Actorów, zarządzaną infrastrukturę oraz ekosystem harmonogramów i integracji. Do najczęstszych minusów należą: nierówna jakość Actorów (community Actors nie zawsze są utrzymywane), tarcie przy odkrywaniu odpowiedniego narzędzia, wyższy próg wejścia przy własnym developmentcie, złożoność debugowania i trudniejsze prognozowanie kosztów.
Uwaga o jakości Actorów: Nie każdy Actor w Store jest utrzymywany i weryfikowany w takim samym stopniu. Community Actors są odpowiedzialnością ich twórców, a jakość bywa różna. Zawsze sprawdzaj autora, uprawnienia, wersję, historię uruchomień i przykładowy output, zanim zaufasz Actorowi przy danych wrażliwych albo krytycznych dla biznesu.
Thunderbit vs Apify: pełna tabela porównawcza funkcji
Ta tabela zbiera wszystkie najważniejsze wymiary z powyższych sekcji:
| Wymiar | Thunderbit | Apify |
|---|---|---|
| Główna grupa odbiorców | Nietechniczni użytkownicy biznesowi, sales/ops/research | Developerzy, zespoły danych, operatorzy techniczni (z ścieżkami no-code dla gotowych Actors) |
| Główny produkt | AI web scraper (rozszerzenie Chrome/Edge + aplikacja webowa) | Chmurowa platforma oparta na Actorach (scraping, automatyzacja, aplikacje) |
| agentowa analiza strony | One Click Extract (agent analizuje; Run Now albo automatyczny start) | Zależna od Actora (część Actorów używa AI; większość korzysta z konfiguracji selektorów/wejść) |
| Ścieżka no-code | Tak (rozszerzenie/aplikacja webowa) | Tak (gotowe Actors przez formularze w Console, beta Apify AI, MCP, Tasks) |
| Własny kod | Niewymagany dla rozszerzenia; API/MCP/CLI dla developerów | JavaScript/Python SDK, Crawlee, własne Actors |
| Marketplace | Brak | Actor Store (dziesiątki tysięcy Actorów) |
| Paginacja | Wbudowana (na kompatybilnych stronach) | Zależna od Actora |
| Eksport | Excel, CSV, JSON, Google Sheets, Airtable, Notion | CSV, JSON, XML, Excel, HTML, RSS, JSONL + integracje (Make, n8n, Zapier, Sheets itd.) |
| Harmonogramy | Zależne od planu | Wbudowane, cron-style |
| Zarządzanie proxy | Zarządzane (API), bez konfiguracji użytkownika | Datacenter, residential, SERP, konfigurowalne |
| Storage | Na poziomie konta (zorientowany na eksport) | Datasets, key-value stores, request queues |
| API dla developerów | Open API (Distill, Extract, Batch) | REST API v2 + Actor SDK |
| Integracja z agentami AI | MCP Server, CLI, wtyczka Claude Code | MCP, LangChain, LlamaIndex, integracje społeczności |
| Model cenowy | Kredyty (za wiersz wyjściowy) | Compute units (za GB-godzinę) + proxy/storage/transfer + opłaty zdarzeniowe specyficzne dla Actora |
| Darmowy plan | Tak (zobacz cennik) | Tak ($5/mies. użycia platformy, zobacz cennik) |
| Browser mode | Tak (korzysta z Twojej zalogowanej sesji) | Tylko chmura (Actors działają w kontenerach Apify) |
| Komponenty open-source | Brak | Crawlee (Apache-2.0, ok. 25 000 gwiazdek na GitHubie) |
Ostateczny werdykt: które narzędzie pasuje do Twojego workflow?
Nie ma tu jednego zwycięzcy dla wszystkich i podchodziłbym sceptycznie do każdego, kto twierdzi inaczej bez pokazania konkretów.
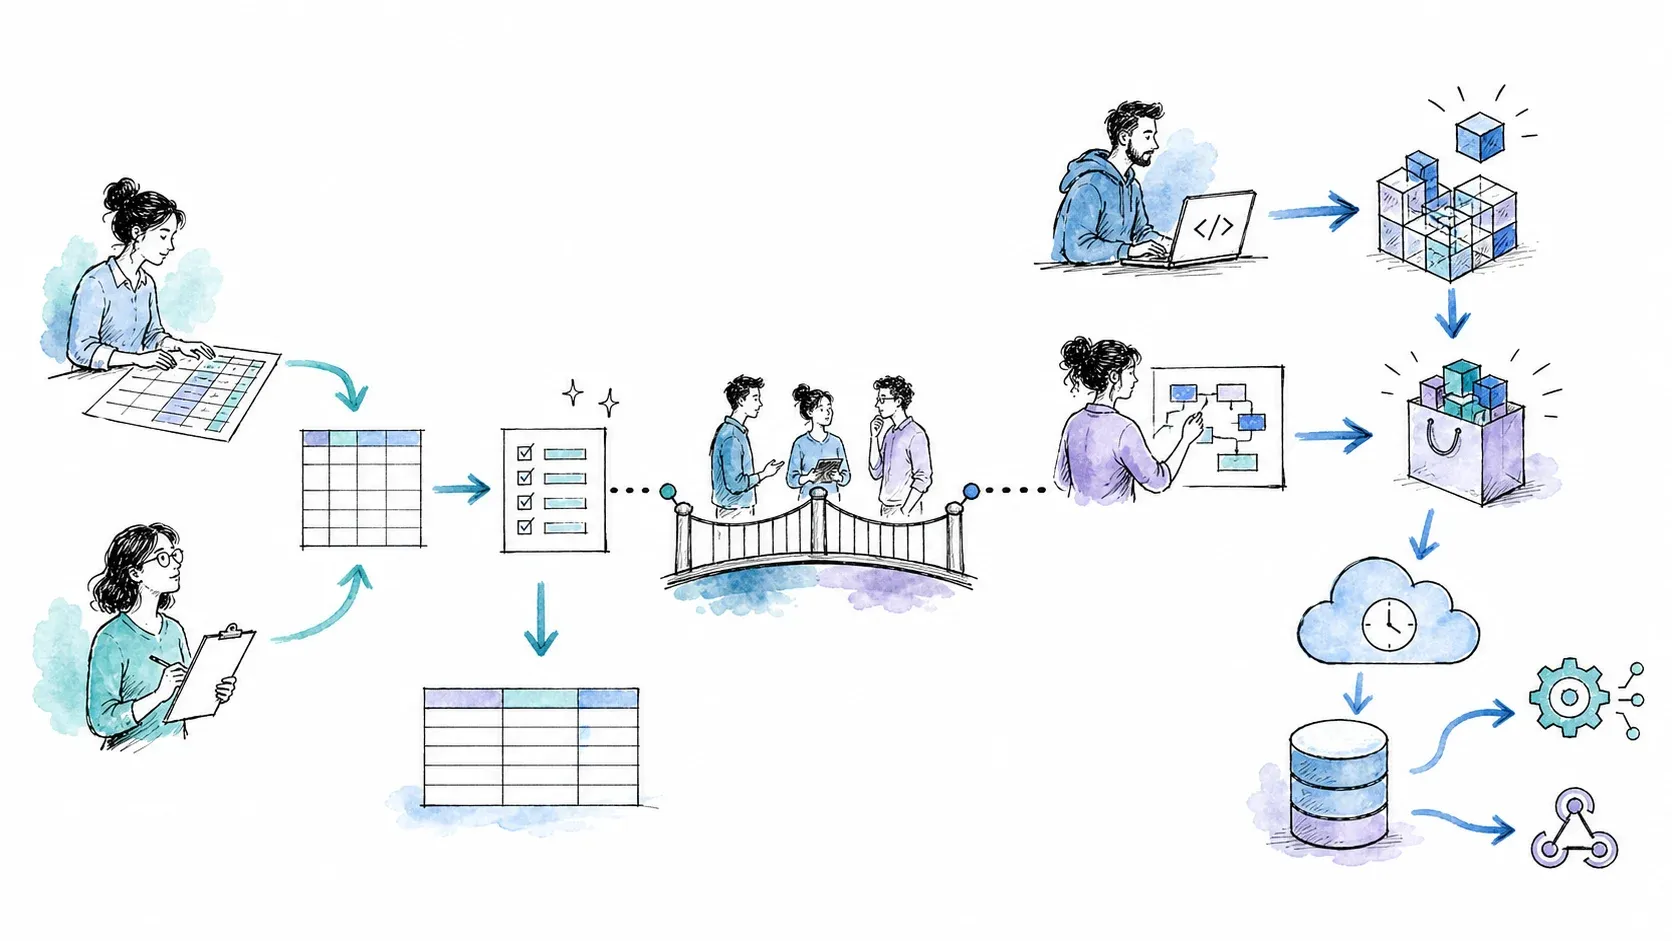
Jeśli jesteś użytkownikiem biznesowym, który chce przejść z „patrzę na tę stronę” do „mam czysty arkusz” w kilka minut, Thunderbit daje bardziej bezpośrednią ścieżkę. Agentowa analiza strony, wbudowany eksport i workflow natywny dla przeglądarki są stworzone właśnie do tego. Nie musisz uczyć się nowej platformy, przeglądać marketplace’u ani konfigurować schematów wejściowych. Po prostu skrapujesz i eksportujesz.
Jeśli jesteś developerem albo zespołem technicznym, który potrzebuje własnych crawlerów, harmonogramowanych pipeline’ów, zaawansowanej orkiestracji proxy/anti-bot albo dostępu do ogromnego marketplace’u gotowych narzędzi, Apify daje znacznie szerszy zestaw klocków do budowy. Krzywa uczenia jest wyższa, ale pułap możliwości też jest wyższy — zwłaszcza przy złożonych, cyklicznych lub bardzo dużych zadaniach.
Jeśli jesteś gdzieś pośrodku — na przykład półtechniczny analityk, który zaczyna od jednorazowego scrapingu, ale chce przejść do workflow programistycznych — oba narzędzia mają ścieżki developerskie (Thunderbit API/MCP/CLI; Apify SDK/CLI/API). Pytanie brzmi, czy Twoją główną potrzebą jest zarządzana ekstrakcja (Thunderbit), czy pełna platforma do budowania i orkiestracji aplikacji danych (Apify).
Moja rekomendacja: wypróbuj oba darmowe plany na swoim rzeczywistym przypadku użycia. Najlepsze porównanie to zawsze to, które przeprowadzisz samodzielnie, na własnych danych i z własnym zespołem. A jeśli chcesz najszybszej drogi do uporządkowanych danych, wypróbuj Thunderbit — możesz się zdziwić, jak szybko zobaczysz efekty.
FAQ
Czy Thunderbit naprawdę jest no-code, czy potrzebuję umiejętności technicznych?
Workflow rozszerzenia Thunderbit — One Click Extract → analiza agentowa → Run Now albo automatyczny start → Export — nie wymaga absolutnie żadnego kodowania. Został stworzony dla użytkowników biznesowych, którzy nigdy nie mieli do czynienia z selektorem CSS. Jednocześnie Thunderbit oferuje też ścieżki dla developerów (Open API, MCP Server, CLI) dla użytkowników technicznych, którzy chcą wbudować ekstrakcję w aplikacje lub workflow agentowe.
Czy z Apify można korzystać bez kodowania?
Tak, w przypadku gotowych Actorów. Console generuje formularz na podstawie schematu wejściowego Actora, więc wiele Actorów można konfigurować i uruchamiać bez pisania kodu. Apify oferuje też Apify AI (beta), MCP, Tasks i integracje (Make, n8n, Zapier) jako punkty wejścia no-code/low-code. Budowanie własnych Actorów lub obsługa zaawansowanych konfiguracji nadal wymaga jednak JavaScript lub Python.
Które narzędzie jest tańsze przy małej skali scrapingu?
Oba narzędzia mają darmowe plany, które mogą wystarczyć przy małej, jednorazowej ekstrakcji. Darmowy plan Thunderbit obejmuje ograniczoną liczbę stron miesięcznie; darmowy plan Apify obejmuje $5 miesięcznie użycia platformy. Przy niskiej skali koszt zwykle nie jest kluczowym problemem. Wraz ze wzrostem skali modele rozliczeń mocno się różnią — Thunderbit rozlicza się za wiersz wynikowy (credit), a Apify za compute unit (GB-godzina) plus potencjalne opłaty za proxy, storage i zdarzenia specyficzne dla Actora. Zawsze sprawdzaj aktualne strony Thunderbit pricing i Apify pricing.
Czy Thunderbit poradzi sobie z dużą skalą, czy tylko z małymi zadaniami?
Rozszerzenie i aplikacja webowa Thunderbit są zoptymalizowane pod agentową ekstrakcję jednym kliknięciem. Przy większych lub programistycznych obciążeniach Open API obsługuje asynchroniczne workflow Batch, a MCP Server i CLI umożliwiają ekstrakcję z poziomu agenta i terminala. Te ścieżki developerskie są nastawione na ekstrakcję i nie oferują tak szerokiego zestawu prymitywów orkiestracyjnych (trwałe kolejki, storage, własne kontenery) jak platforma Apify, która ma dłuższą historię wspierania złożonych, dużych pipeline’ów.
Jak Thunderbit i Apify radzą sobie ze zmianami strony i zabezpieczeniami anti-bot?
AI w Thunderbit odczytuje stronę od nowa przy każdym scrapingu, co może pomóc w dostosowaniu się do zmian układu na kompatybilnych stronach — ale wyniki AI zawsze należy sprawdzać i żadna witryna nie jest gwarantowana. API zawiera zarządzane renderowanie, rotację proxy i obsługę anti-bot, z opisanymi ograniczeniami. Apify oferuje konfigurowalne zarządzanie proxy (datacenter, residential, SERP), orkiestrację headless browser oraz kontrolę sesji i rotacji. Jednak Actors — zwłaszcza utrzymywane przez społeczność — mogą przestać działać, gdy strona docelowa zmieni HTML, a aktualizacje zależą od opiekuna Actora. Żadne z narzędzi nie gwarantuje uniwersalnego dostępu ani obejścia wszystkich zabezpieczeń anti-bot, a oba wymagają przestrzegania warunków serwisu, prywatności i obowiązującego prawa.
Dowiedz się więcej
- Jak wykorzystać AI do prospectingu sprzedażowego: kompletny przewodnik
- Przetestowaliśmy to: alternatywa dla Apify dla początkujących
- Jak opanować automatyczny scraping danych z Thunderbit
- 8 najlepszych AI web scraperów do inteligentniejszej ekstrakcji danych
- Wskaźniki adopcji workflow no-code i efektywność w 2026 roku




