
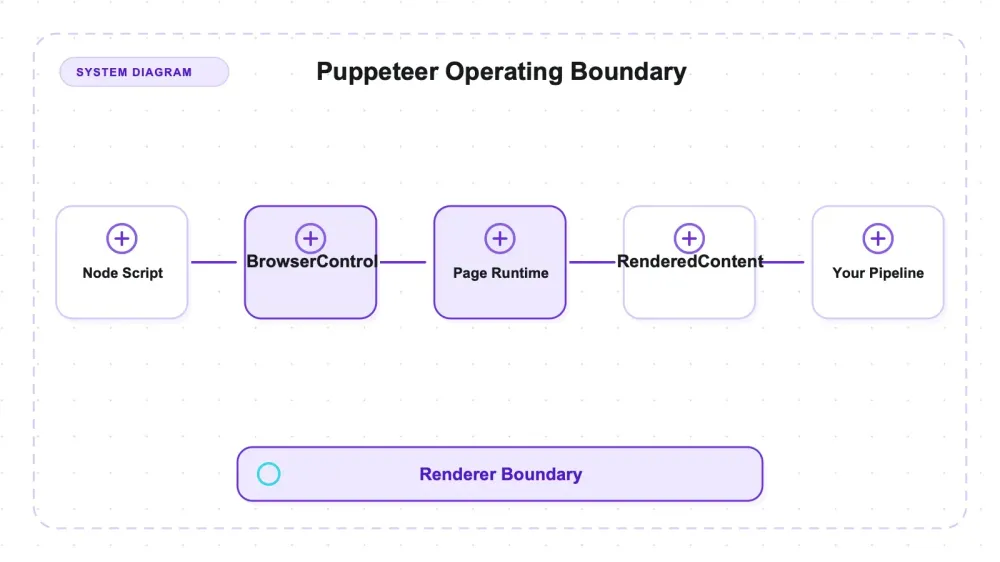
Puppeteer to biblioteka Node od Google do sterowania prawdziwym Chrome z poziomu JavaScriptu — to Ty piszesz automatyzację, Chrome DevTools Protocol przekazuje polecenia, a pełna przeglądarka renderuje stronę, zanim odczytasz z niej choćby bajt. Projekt znajdziesz na GitHubie pod adresem puppeteer/puppeteer: licencja Apache-2.0, kod w TypeScript, i około 95,3 tys. gwiazdek (95 307 w dniu, gdy pobrałem migawkę). Oficjalne pozycjonowanie jest celowo wąskie — „JavaScript API do sterowania Chrome (eksperymentalnie także Firefoxem)” — co od razu mówi, czym Puppeteer jest, a równie ważne, czym nie jest.
Przepuściłem Puppeteer 24.16.0 przez ten sam serwer testowy i publiczne demo, których używamy przy każdej bibliotece do automatyzacji przeglądarki: statyczny katalog z paginacją, artykuł, katalog renderowany przez JavaScript, JSON API, trasę zwracającą 500, mały graf crawl’u, a także Books to Scrape i Quotes to Scrape. Renderowanie wykonał sprawnie i bez zbędnych fajerwerków. Zostawił też dokładnie jedno zadanie na moim biurku — to samo, które zostawia każda biblioteka headless-browser — i uczciwe nazwanie tej luki jest w gruncie rzeczy tym, co odróżnia użyteczną recenzję od komunikatu prasowego.
Bardziej niż same wyniki zapadła mi w pamięć jedna liczba. Na stronie, której dane pochodzą z endpointu JSON, Puppeteer pobrał wszystkie 8 rekordów bez skrobania DOM-u — uruchomił fetch wewnątrz strony i odczytał bezpośrednio obiekt odpowiedzi. To, razem z natywnym renderowaniem i działającymi screenshotami, dobrze pokazuje charakter narzędzia: dojrzały renderer Chrome, a nie framework crawlera — i ta różnica ma znaczenie, zanim napiszesz choćby jedną linijkę.
Czym Puppeteer naprawdę jest (i z czym konkuruje)
Etykieta kategorii robi tu realną robotę, więc zacznijmy od niej. Puppeteer to biblioteka do automatyzacji przeglądarki. Uruchamia Chrome, otwiera strony, pozwala wykonać JavaScript strony i zwraca wyrenderowany rezultat do odczytu lub zapisania jako screenshot. To właśnie dlatego wybierasz go zamiast klienta HTTP i parsera HTML: chcesz zobaczyć stronę po wykonaniu skryptów, a nie pustą powłokę, którą serwer wysyła na początku.
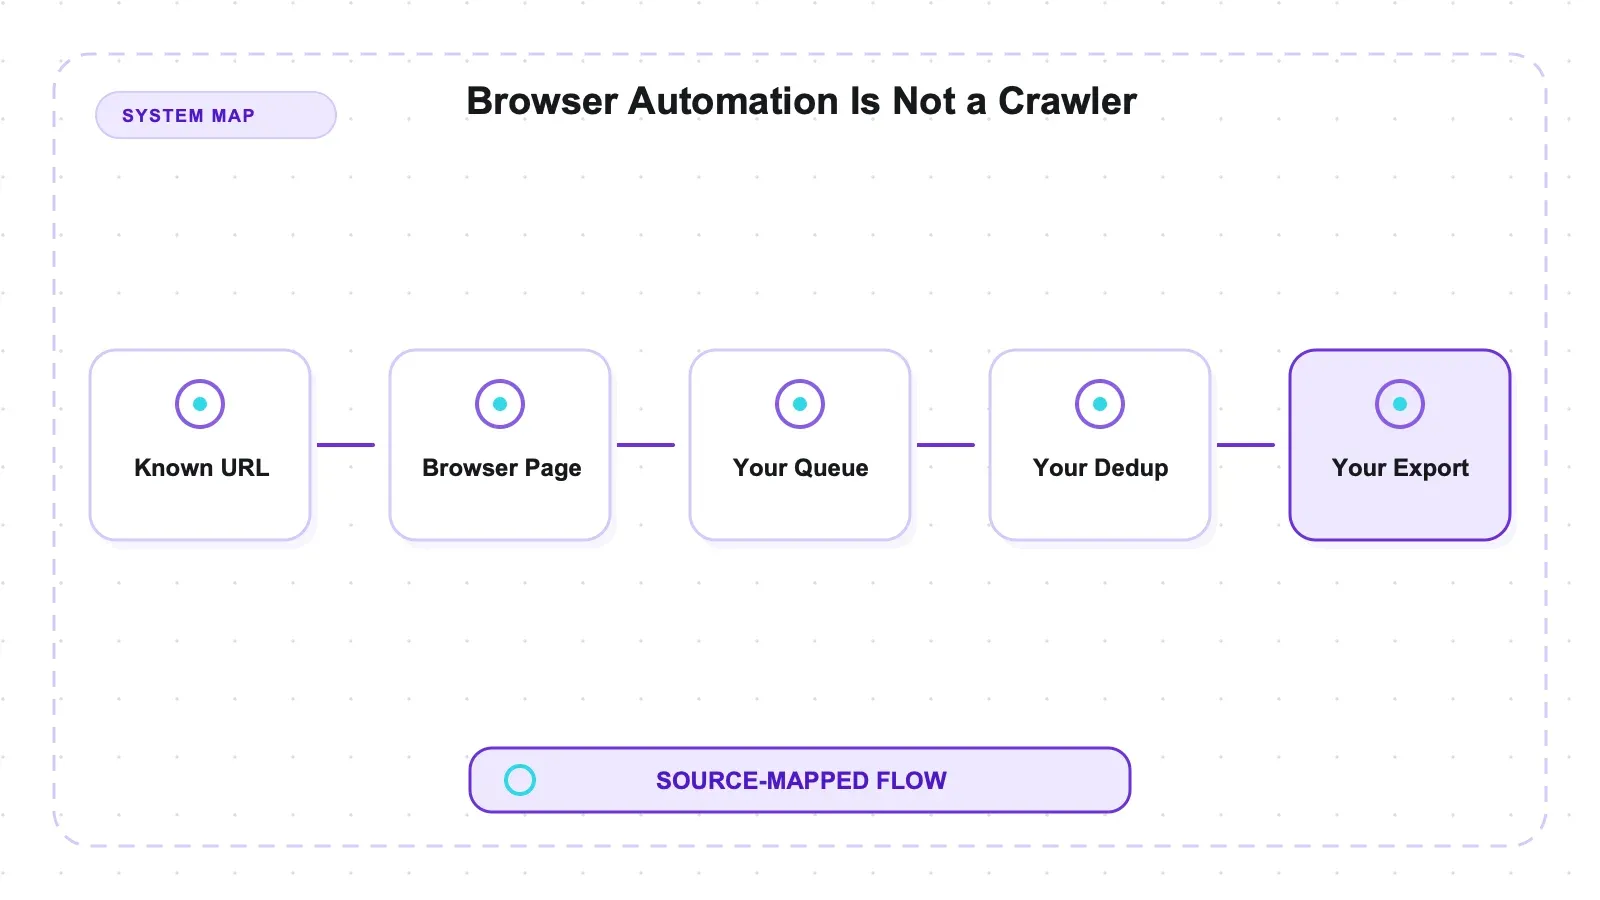
W praktyce konkuruje z innymi bibliotekami opartymi na prawdziwej przeglądarce — Playwright i Selenium — a nie z frameworkami crawlerów, takimi jak Scrapy, ani z narzędziami LLM/Markdown. Jeśli skierujesz Puppeteer na tysiąc URL-i i oczekujesz, że sam ustawi kolejkę, odfiltruje duplikaty, grzecznie ograniczy tempo i zapisze zbiór danych, to do zadania crawl’owego zabrałeś renderer. On każdy adres wyrenderuje pięknie, ale nie zajmie się orkiestracją. (To ograniczenie zakresu, nie błąd — wrócę do tego, bo to absolutnie kluczowa rzecz, którą trzeba zrozumieć przed wdrożeniem tego narzędzia.)
Puppeteer wywodzi się z zespołu Chrome w Google, dlatego z założenia jest „Chrome-first” i dlatego jego API wygląda jak cienka, dobrze wyrobiona rękawiczka nałożona na natywny protokół debugowania przeglądarki. Jest już na tyle dojrzały, że aż przyjemnie „nudny” — potrzebne metody są stabilne od lat, dokumentacja jest solidna, a otaczający ekosystem bardzo rozbudowany.
Natywne renderowanie i wzorzec fetch wewnątrz strony
Dwa zachowania warto wyciągnąć z tabeli wyników, bo dobrze pokazują, jak faktycznie używa się tego narzędzia.
Po pierwsze, natywne renderowanie. Katalog renderowany przez JavaScript — strona, która buduje siatkę produktów po stronie klienta po załadowaniu — zwrócił 8/8, a pełnostronicowy screenshot został zapisany na dysku. Konfiguracja była minimalna, ale zawierała oczekiwanie na docelową treść po goto. Publiczna strona Quotes to Scrape JS zwróciła wszystkie dziesięć cytatów tym samym sposobem. To wyniki konkretnych fixture’ów, a nie ogólny wynik recall dla renderowania.
Po drugie, fixture oparty na JSON API pobierał produkty z /api/dynamic-products. Uruchomienie fetch w tym samym originie przez page.evaluate zwróciło wszystkie osiem rekordów bez parsowania wyrenderowanych wierszy. To ogólny wzorzec ewaluacji w przeglądarce, a nie funkcja odkrywania danych specyficzna dla Puppeteera. Może bardzo uprościć ekstrakcję, jeśli znasz endpoint i kontrakt żądań; ale nagłówki uwierzytelniające, tokeny w runtime, polityka poświadczeń, CORS/CSP, service workery i paginacja nadal mogą sprawić, że żądanie aplikacji będzie inne niż oczekiwane.
Trzecia rzecz, którą warto zapamiętać, to nie liczba, tylko wniosek: Puppeteer to dojrzały renderer Chrome, a nie crawler. Obie części są prawdziwe, a ta druga to właśnie ta, którą większość opisów pomija.
Jak Puppeteer komunikuje się z Chrome
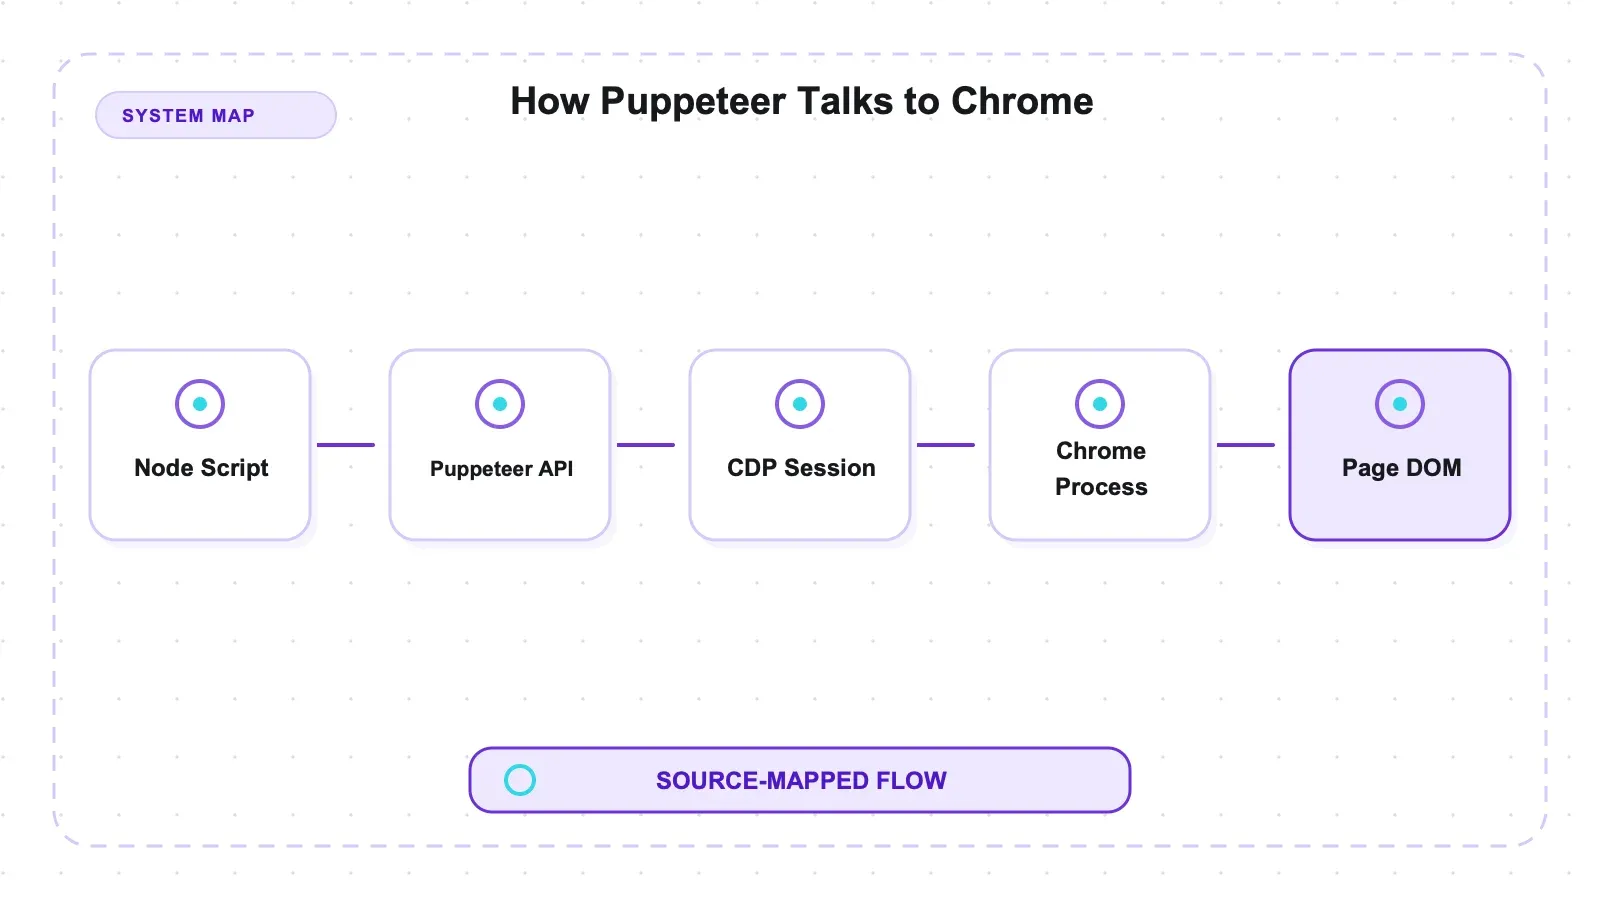
W Chrome Puppeteer używa Chrome DevTools Protocol (CDP), czyli kanału JSON-over-WebSocket używanego przez narzędzia deweloperskie przeglądarki. puppeteer.launch() uruchamia Chrome i otwiera połączenie z tym protokołem; wywołania takie jak goto, $$eval i screenshot wystawiają operacje przeglądarki przez wyższy poziom API. Obsługa Firefoksa opiera się na ścieżce WebDriver BiDi opisanej niżej, więc nie każda operacja Puppeteera jest uniwersalnie komendą CDP.
page.evaluate uruchamia funkcję w kontekście strony, więc względne fetch('/api/...') korzysta z originu tej strony i może ponownie wykorzystać kwalifikujące się ciasteczka oraz stan sesji. Nie odtwarza jednak automatycznie nagłówków autoryzacyjnych tworzonych przez aplikację, opcji żądania, tokenów ani zachowania service workera. W tym fixture same-origin zwrócił JSON bezpośrednio; produkcyjne żądania trzeba sprawdzić pod kątem ich rzeczywistego kontraktu.
To również powód, dla którego Puppeteer jest ciężki. Każda strona to prawdziwa karta przeglądarki z prawdziwym silnikiem renderującym w tle. Zyskujesz dzięki temu poprawność na stronach intensywnie korzystających z JavaScriptu, ale płacisz pamięcią i czasem startu w porównaniu z samym HTTP. Nie ma darmowego renderowania; CDP tylko sprawia, że rachunek jest czytelny.
Wprost o silniku
Popularnym skrótem myślowym jest stwierdzenie, że Puppeteer jest „tylko do Chrome”. Dla wersji, którą testowałem, to nieprawda — a poprawne ujęcie zmienia porównanie.
| Silnik | Jak Puppeteer 24.16.0 go obsługuje | Użyty w tych testach |
|---|---|---|
| Chrome | Chrome-first przez CDP — domyślna ścieżka, więc istniejące automatyzacje dalej działają | tak |
| Firefox | Udokumentowana obsługa przez WebDriver BiDi od v23 | nie |
| WebKit | W ogóle nie jest obsługiwany | — |
Zarówno Chrome for Developers, jak i Mozilla opisali przejście na Firefoksa, gdy tylko się pojawiło. Kompilacja, którą uruchomiłem, 24.16.0, jest już daleko za v23, więc określenie „tylko Chrome” zaniża możliwości, które faktycznie są dostarczane. Brak WebKit, w połączeniu ze stosunkowo młodą historią wielosilnikową na tle Playwrighta, to prawdziwa różnica w szerokości wsparcia — nie „jeden silnik kontra trzy”.
Ścieżka Firefox/BiDi jest udokumentowana i dostępna w wersji, którą testowałem, ale nie przepuściłem przez nią swoich fixture’ów, więc raportuję możliwość, a nie pomiar. Jeśli Firefox jest krytyczny dla Twoich celów, sprawdź go na własnych stronach przed podjęciem decyzji. Dla czytelników, którzy chcą pełnego porównania silnika i zakresu językowego, nasze zestawienie Playwright vs Puppeteer przepuszcza obie biblioteki przez te same testy i rozstrzyga tam pytanie „który wybrać”; tutaj przedmiotem jest sam Puppeteer.
Instalacja i konfiguracja w praktyce: ciężki jest przeglądarkowy silnik
Domyślna ścieżka npm install puppeteer pobiera zgodną wersję Chrome for Testing. To zachowanie można pominąć albo przekierować przez konfigurację, a użytkownicy mogą wskazać Puppeteerowi inny plik wykonywalny, więc dopasowanie wersji zależy od wybranej metody wdrożenia. Najcięższą częścią tej instalacji był właśnie pobierany browser; zrzut audytu menedżera pakietów nie jest tu traktowany jako trwała właściwość bezpieczeństwa.
To automatyczne dołączanie przeglądarki jest jednocześnie prawdziwym plusem ergonomii i prawdziwym kosztem objętości — warto nazwać oba aspekty. Plus: nie szukasz kompatybilnej przeglądarki i nie przypinasz wersji ręcznie; npm install daje od razu działającą parę. Minus: pobierasz całą przeglądarkę, więc trzeba uwzględnić miejsce na dysku i transfer, szczególnie w CI, gdzie zimny cache płaci ten koszt na każdym świeżym runnerze.
To także realny kontrast z Playwrightem, który rozdziela te dwa kroki — najpierw instalujesz bibliotekę, potem uruchamiasz osobno npx playwright install, żeby pobrać buildy przeglądarki. Żadne z tych podejść nie jest bolesne; po prostu zawodzą w inny sposób. Jedno polecenie Puppeteera może zaskoczyć rozmiarem na łączu z limitem transferu, a drugi krok Playwrighta można po prostu zapomnieć wykonać. Dobrze wiedzieć, z czym się pracuje.
Wyniki praktyczne
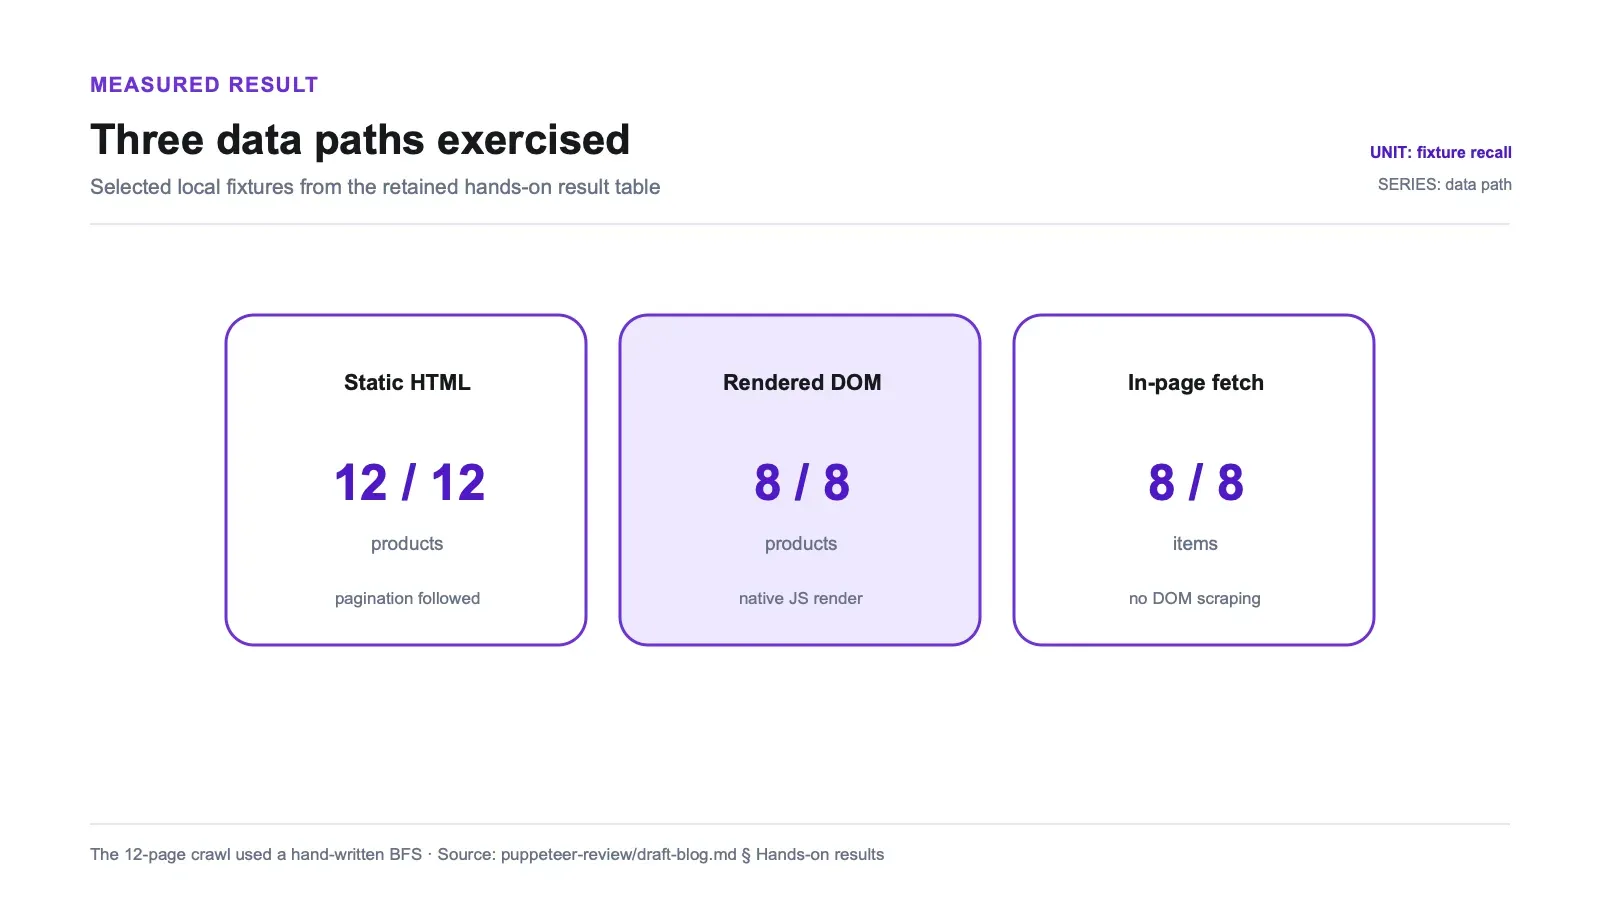
Każdy test został uruchomiony na lokalnym serwerze fixture’ów pod 127.0.0.1 oraz na dwóch publicznych stronach demo, na Node v22.22.3, macOS arm64, z Puppeteer 24.16.0 i dołączonym Chrome. Prawdziwe dane dla każdego fixture’u zostały zapisane przed uruchomieniem, więc recall jest liczony względem ustalonego oczekiwanego zestawu, a nie tego, co Puppeteer akurat wypisał.
Publiczny pakiet badawczy zawiera serwer fixture’ów, runner testów oraz ground truth. Plik lock zależności i surowe podsumowanie uruchomienia zostały celowo pominięte w paczce publikacyjnej, ponieważ rygorystyczny przegląd bezpieczeństwa odrzucił dane lockfile oraz materiał endpointów zależnych od środowiska. Aby odtworzyć bezpieczny lokalny fixture, uruchom npm install, a następnie node run_puppeteer_material_tests.mjs w katalogu tools/puppeteer/tests, i porównaj wynik z opublikowanym ground truth. Publiczne strony demo mogą się zmieniać, więc lokalny fixture jest stabilną podstawą do sprawdzenia liczby oczekiwanych wyników.
Jeśli chcesz dokładnie odtworzyć historyczne zależności, utwórz i przejrzyj świeży lockfile lokalnie, zamiast traktować nieopublikowany lock jako publiczny dowód.
| Test | Cel | Wynik |
|---|---|---|
| Statyczny katalog + paginacja | lokalny fixture | 12/12, recall 1.0 |
| Ekstrakcja artykułu | lokalny fixture | tytuł + 3/3 akapity, boilerplate oddzielony |
| Dynamiczna strona JS (natywne renderowanie) | lokalny fixture | 8/8, recall 1.0, zapisano pełnostronicowy screenshot |
Dynamiczne JSON API (fetch w stronie) | lokalny fixture | 8/8, recall 1.0, bez parsowania DOM |
| Obsługa HTTP 500 | lokalny fixture | status 500 możliwy do sprawdzenia, bez rzucenia wyjątku |
| Graf crawl’u (ręcznie napisane BFS) | lokalny fixture | 12 stron, głębokości {0:1, 1:4, 2:7} |
| Books to Scrape | public demo | 20 produktów |
| Quotes JS | public demo | 10 cytatów, wyrenderowanych natywnie |
Kilka z tych wyników zasługuje na krótkie doprecyzowanie.
Napisany ręcznie kod paginacji odzyskał wszystkie 12 oczekiwanych elementów katalogu. Selektor dla artykułu zwrócił tytuł i trzy oczekiwane akapity; otaczający boilerplate nadal był dostępny w DOM-ie. Puppeteer dostarczył wyrenderowany DOM, a logika selektorów — nie sam Puppeteer — określiła, co liczy się jako treść artykułu.
Na testowanej trasie HTTP 500 goto zwróciło obiekt odpowiedzi z możliwym do sprawdzenia statusem 500 i nie rzuciło wyjątku. To nic nie mówi o timeoutach, błędach DNS, awariach przeglądarki, odłączonych ramkach ani innych błędach nawigacji, które nadal wymagają osobnej obsługi.
Najwięcej mówi graf crawl’u. Przejście po wewnętrznych linkach fixture’u do 12 stron, z pilnowaniem głębokości, żeby nie odwiedzać adresów ponownie, wymagało ręcznie napisanego breadth-first search — bo Puppeteer nie ma wbudowanej kolejki crawl’u. Udało się znaleźć wszystkie 12 stron na głębokościach {0:1, 1:4, 2:7}, czyli mój BFS działał. Ale BFS był mój. Puppeteer wyrenderował każdą stronę; logika przechodzenia po witrynie była kodem, który napisałem sam. Dla dwunastu stron to kilkanaście linijek i żadna filozofia. Dla tysięcy URL-i z deduplikacją, retry i opóźnieniami grzecznościowymi te kilkanaście linijek zmienia się w projekt.
Jedno zastrzeżenie powtórzę, bo łatwo je nadużyć: artefakty zawierają czasy dla każdego testu, ale są to obserwacje z jednego uruchomienia, na jednej maszynie, a nie benchmark. Nie porównuję szybkości Puppeteera z innymi narzędziami na podstawie jednego laptopa i jednego przebiegu. To, co liczby rzeczywiście wspierają, to recall i zachowanie na ośmiu typach stron — nie twierdzenie o czasie na stoperze.
Czego nie testowałem
Żeby wyniki nie były odczytywane szerzej, niż pozwala na to eksperyment, poniżej rzeczy, które zostały poza testem, a więc również poza tymi liczbami:
| Poza zakresem testu | Status |
|---|---|
| Firefox przez WebDriver BiDi | Udokumentowany, dostępny w 24.16.0, ale tutaj nieuruchomiony |
| Proxy i przechwytywanie żądań | Nieteztowane; oba mechanizmy są wspierane, ale nie uruchamiałem ich |
| Skala wielu stron równolegle | Testowałem małą skalę; zachowanie farmy przeglądarek przy realnej współbieżności nie zostało zmierzone |
| Ponowne uruchomienie na najnowszej wersji | Testowałem 24.16.0; npm latest to 25.3.0, czyli pełny major do przodu, według stanu na 2026-07-09. API, których używałem (launch, goto, $$eval, screenshot, fetch w stronie), są stabilne między 24 a 25, ale uczciwym ruchem jest ponowne uruchomienie na 25.3.0, zanim przywiążesz do niego dokładne liczby |
Żadna z tych rzeczy nie jest zarzutem. To po prostu granice tego, co pojedynczy przebieg fixture’u może uczciwie twierdzić.
Plusy i minusy
Plusy:
- Natywne renderowanie JavaScriptu z wyraźnym oczekiwaniem na treść: 8/8 na dynamicznym fixture i wszystkie dziesięć cytatów na publicznym demo, ze screenshotami.
- Ręcznie napisane selektory dla paginacji i artykułu odzyskały oczekiwane elementy fixture’u.
fetchuruchomiony wewnątrz strony pobrał wszystkie osiem rekordów ze znanego endpointu same-origin bez parsowania DOM-u.- Testowany HTTP 500 wrócił jako możliwa do sprawdzenia odpowiedź bez wyjątku.
- Domyślna instalacja pobiera zgodny build Chrome for Testing; nadal można wskazać inny plik wykonywalny albo pominąć pobieranie.
- Dojrzałe API nastawione na Chrome, oparte na CDP, z rozbudowanym ekosystemem i dobrą dokumentacją. Apache-2.0.
- Szerszy niż jego reputacja: od v23 udokumentowana obsługa Firefoksa przez WebDriver BiDi.
Minusy:
- Brak wbudowanej kolejki crawl’u, zapisywania datasetu czy ograniczania tempa — do crawl’u na większą skalę potrzebujesz własnego kodu albo wrappera.
- Brak silnika WebKit i młodsza historia wielosilnikowa niż w Playwright.
- Ciężar prawdziwej przeglądarki: do pobrania dołączony Chrome i koszt pamięci na każdą stronę w porównaniu z narzędziami tylko HTTP.
- Oparty na Node; użycie z innego języka oznacza budowę i utrzymanie mostu.
- Wersja, którą uruchomiłem (24.16.0), jest o jeden major za najnowszą wersją npm (25.3.0) — przed zaufaniem dokładnym liczbom warto zweryfikować na bieżącej wersji.
Dla kogo to jest, a kto powinien odpuścić
Sięgnij po Puppeteer, jeśli pracujesz w Node, Twoje cele poprawnie renderują się w Chrome (a większość tak właśnie działa) i chcesz dojrzałej, wyspecjalizowanej biblioteki, która zamienia „stronę po wykonaniu JavaScriptu” w coś, co możesz odczytać i zrzucić jako screenshot. Do scrapowania zestawu dynamicznych stron, pobierania JSON API z sesją tej samej strony czy zapisywania renderowanych screenshotów jako dowodu — to bardzo mocny, bezstresowy wybór domyślny. Opcja Firefox przez BiDi jest dostępna, jeśli kiedyś się przyda, a ekosystem sprawia, że większość problemów, na które trafisz, została już wcześniej napotkana.
Dwa razy się zastanów, jeśli Twoim problemem jest orkiestracja crawl’u, a nie renderowanie. Jeśli musisz przejść przez setki lub tysiące URL-i z deduplikacją, retry i limitami prędkości, sam Puppeteer zmusi Cię do ręcznego zbudowania crawlera — to niewłaściwy poziom abstrakcji dla tego narzędzia. Zrezygnuj z headless browsera całkowicie, jeśli Twoje strony nie potrzebują JavaScriptu, żeby ujawnić dane; jeśli zwykłe żądanie HTTP i parser wystarczą, prawdziwa przeglądarka jest kosztownym przerostem formy, który tylko zużywa pamięć i czas konfiguracji. A jeśli potrzebujesz zgodności z WebKit albo klienta w języku innym niż JavaScript, to nie jest narzędzie do tego wymiaru problemu.
Alternatywy i miejsce Thunderbit
Najpierw uczciwe ustawienie ram: Puppeteer jest darmowy, na licencji Apache-2.0, hostowany samodzielnie, a Ty odpowiadasz za każdy aspekt jego działania — farmę przeglądarek, kod crawlujący, który dobudujesz, i ciągły wyścig z bot-blockingiem. W wielu projektach dokładnie taka własność jest właściwa i żaden zarządzany serwis nie wyrenderuje autoryzowanej strony taniej niż przeglądarka, którą już masz.
W open source sensowne porównania robi się według zadania, nie według logo. Jeśli chodzi o skalę crawl’u, naturalnym uzupełnieniem jest Crawlee: jego PuppeteerCrawler owija Puppeteera w kolejkę żądań, dataset i ograniczanie tempa, których sama biblioteka celowo nie dostarcza, więc zachowujesz renderowanie i dostajesz orkiestrację. Jeśli celem wyjściowym jest czysty Markdown do pipeline’u LLM, a nie wyrenderowany DOM, Crawl4AI steruje prawdziwą przeglądarką i dokładnie to produkuje. Jeśli Twoje strony w ogóle nie potrzebują przeglądarki, framework HTTP-first, taki jak Scrapy, to inna i lżejsza kategoria. Gdy porównujesz kilka takich narzędzi naraz, nasze zestawienie open-source scraperów pokazuje te kategorie obok siebie.
Usługa zarządzana, taka jak Thunderbit, przenosi obsługę przeglądarki i ekstrakcję za API. Nie była uruchamiana na tych fixture’ach Puppeteera, więc ta recenzja nie składa żadnej porównywalnej deklaracji o renderowaniu, blokowaniu, jakości ekstrakcji czy kosztach. Granica decyzyjna jest operacyjna: samemu utrzymywać kod przeglądarki i crawl’u albo zapłacić dostawcy za obsługę tej warstwy.
W przypadku Puppeteera nie ma opłaty licencyjnej dla dostawcy, ale koszty obliczeń, transferu, utrzymania przeglądarki, orkiestracji i operacji pozostają po Twojej stronie. W modelu zarządzanym płacisz za użycie i przenosisz część tej odpowiedzialności na dostawcę. Ten eksperyment nie porównywał wyników.
Wypróbuj Thunderbit do ekstrakcji danych z sieci
Werdykt
Puppeteer 24.16.0 warto rozważyć, jeśli pracujesz w Node i potrzebujesz automatyzacji przeglądarki nastawionej na Chrome. Ręcznie przygotowane fixture’y odzyskały 12 elementów statycznych, 8 dynamicznych i 10 cytatów z publicznego demo; znane JSON API same-origin zwróciło 8 rekordów przez page.evaluate; screenshoty działały; a testowana odpowiedź HTTP 500 pozostawała możliwa do sprawdzenia. Te wyniki dotyczą konkretnych fixture’ów i starszego wydania major, a nie ogólnego recall w ekstrakcji.
Trzeba jednak odpowiednio skalować oczekiwania. Puppeteer to renderer, nie crawler: mój 12-stronicowy spacer wymagał ręcznie napisanego BFS, bo nie ma wbudowanej kolejki, a przy większej skali ta luka to realna robota — zlecasz ją Crawlee albo piszesz sam. Jest „Chrome-first” z udokumentowaną obsługą Firefoksa przez BiDi, ale bez WebKit, więc nie nadaje się do szerokiego pokrycia silników. Nosi też ciężar prawdziwej przeglądarki. I testowałem 24.16.0 przeciwko najnowszemu 25.3.0, więc przed zaufaniem dokładnym liczbom uruchom to jeszcze raz na bieżącej wersji. Jeśli wejdziesz w to z tymi czterema faktami, Puppeteer jest znakomitą biblioteką do automatyzacji Chrome. Jeśli oczekujesz, że sam będzie crawlował witrynę, skończysz pisząc crawlera, który myślałeś, że właśnie pobierasz.
Wypróbuj Thunderbit do ekstrakcji danych z sieci Get Started Free
FAQ
Czy Puppeteer renderuje strony JavaScriptowe, czy potrzebuję wtyczki?
Renderuje je natywnie, bez wtyczki. Na moim dynamicznym fixture zwrócił 8 z 8 produktów zbudowanych po stronie klienta z recall 1.0 i pełnostronicowym screenshotem, a publiczna strona Quotes to Scrape JS zwróciła w ten sam sposób wszystkie 10 cytatów — zwykłe goto, a potem odczyt wyrenderowanego DOM-u. Ponieważ Puppeteer steruje prawdziwym Chrome przez DevTools Protocol, skrypty strony rzeczywiście wykonują się, zanim cokolwiek odczytasz.
Czy Puppeteer może zeskrobać JSON API bez parsowania HTML?
Tak, jeśli endpoint i kontrakt żądania na to pozwalają. page.evaluate może wysłać żądanie z originu strony i może ponownie użyć kwalifikujących się ciasteczek, ale nie odtwarza automatycznie nagłówków aplikacji, tokenów, opcji ani zachowania service workera. Na fixture same-origin zwrócił wszystkie osiem rekordów bez parsowania DOM-u.
Czy Puppeteer to web crawler? Nie — to biblioteka do automatyzacji przeglądarki, a nie framework crawlujący. Nie ma wbudowanej kolejki żądań, zapisywania datasetu ani ograniczania tempa, więc mój crawl 12 stron (głębokości {0:1, 1:4, 2:7}) wymagał ręcznie napisanego breadth-first search. To granica zakresu, nie wada. Do crawlowania na większą skalę połącz go z wrapperem, takim jak Crawlee PuppeteerCrawler, który dodaje kolejkę i mechanikę datasetu, których Puppeteer nie dostarcza.
Czy Puppeteer działa tylko z Chrome? Już nie. Jest nastawiony na Chrome przez CDP, ale od v23 ma udokumentowaną obsługę Firefoksa przez WebDriver BiDi, a wersja, którą testowałem (24.16.0), jest daleko poza tym punktem. Czego nie obsługuje, to WebKit, a jego historia wielosilnikowa jest młodsza niż w Playwright — to jest właściwe ograniczenie, a nie „tylko Chrome”. Tutaj testowałem wyłącznie Chrome, więc Firefoksa przez BiDi raportuję jako dokumentowaną możliwość, a nie coś, co mierzyłem.
Co właściwie pobiera instalacja Puppeteera?
Domyślnie npm install puppeteer pobiera zgodny build Chrome for Testing. Pobieranie można pominąć lub przekierować, a można też skonfigurować inny plik wykonywalny, więc zgodność wersji zależy od decyzji wdrożeniowych. Zadbaj o miejsce na dysku i transfer dla przeglądarki, zwłaszcza na runnerach CI bez cache. Ta recenzja testowała 24.16.0; uruchom ponownie podstawowe fixture’y na wersji aktualnej w momencie publikacji.




