
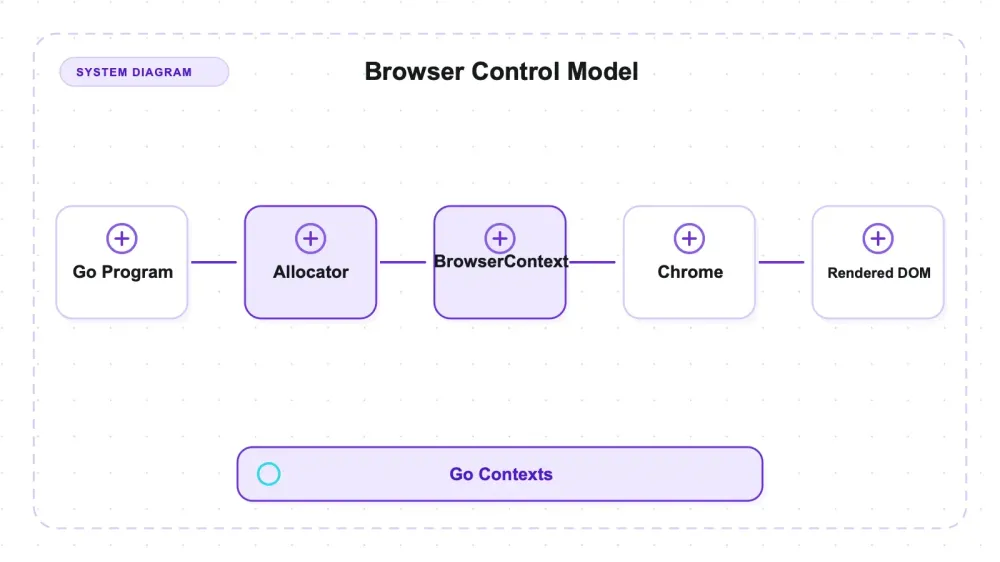
chromedp to biblioteka w 100% napisana w Go, na licencji MIT, która steruje prawdziwym Chrome za pomocą Chrome DevTools Protocol. Odczytuje DOM dopiero po wykonaniu JavaScriptu na stronie, bez osobnego WebDrivera czy środowiska Node. Moduł Go kompiluje się wraz z aplikacją, ale uruchamialny system nadal wymaga zewnętrznego pliku wykonywalnego Chrome, a jego cyklem życia zarządzają konteksty Go.
Instalacja sprowadzała się do jednego go get i Chrome, który musiałem dostarczyć sam: utworzyć allocator, wyprowadzić z niego context i przekazać Run listę akcji. Na tym komputerze macOS arm64, z „rozgrzanym” headless shellem zapisanym na dysku, nowy proces do pierwszego wyniku ze skryptu miał medianę 102 ms. To lokalny punkt odniesienia, a nie uniwersalna teza, że start nigdy nie jest wąskim gardłem. Na testowym zestawie, który wstrzykuje link 800 milisekund po załadowaniu, dwie z czterech strategii odczytu zwróciły wynik, zanim link w ogóle istniał.
Przeglądarka była prawdziwa, treść była obecna, a kod po prostu na nią nie czekał. Ta luka to najcenniejsza lekcja, jaką dał mi chromedp, i nie jest to błąd — to różnica między „wyrenderowałem stronę” a „poczekałem na to, czego naprawdę potrzebowałem”, czyli rozróżnienie, które w opowieściach o headless browserach często się spłaszcza do zera. O tym, czy dostaniesz dane, decyduje strategia oczekiwania, nie sama przeglądarka. Wszystkie liczby poniżej pochodzą z lokalnego fixture’a, który kontroluję, z prawdą referencyjną zapisaną przed każdym uruchomieniem, a surowe podsumowania znajdują się w folderze chromedp w naszym repozytorium benchmarkowym.
Czym właściwie jest chromedp
Stos chromedp jest celowo krótki. Bez serwera Selenium. Bez warstwy pośredniej WebDriver. Bez ukrytego pod spodem runtime’u Node. Twój program w Go otwiera WebSocket do instancji Chrome i rozmawia z nią bezpośrednio przez CDP — mniej więcej tym samym protokołem, którego używa Puppeteer, tylko bez JavaScriptu.
Gdy sprawdzałem 27 lipca 2026, repo miało 13 212 gwiazdek i 178 otwartych zgłoszeń, a licencja była MIT. Testowana przeze mnie wersja to v0.16.0, czyli najnowszy tag w repozytorium. Warto to zaznaczyć, żeby nie było zamieszania: na stronie Releases w GitHubie nadal jako najnowszy obiekt wydania widnieje v0.15.1 (opublikowany 2026-04-01), podczas gdy go get github.com/chromedp/chromedp@latest rozwiązuje się do v0.16.0. Moduły Go i obiekty wydań na GitHubie trochę się tu rozjechały. To nie jest awaria — po prostu irytujące, kiedy próbujesz ustalić, co faktycznie uruchamiasz.
Model mentalny opiera się w całości na kontekstach Go. Tworzysz context allocatora (który wie, jak uruchomić Chrome), z niego wyprowadzasz context przeglądarki, a potem wywołujesz chromedp.Run(ctx, actions...) z listą Action. Dziecko contextu przeglądarki to nowa karta. Anulujesz context i odpowiadający mu byt znika. Jeśli masz doświadczenie z współbieżnością w Go, będzie to natychmiast znajome; jeśli nie, nasz przewodnik po pierwszych krokach ze scrapingiem webowym w Go jest łagodniejszym wejściem niż godoc chromedp.
Jedna ważna granica na start: chromedp daje Ci wyrenderowany DOM. Nie daje strukturalnych danych. Wszystko, co z tego DOM-u wyciągniesz — pola, tabele, ceny — to kod, który piszesz i utrzymujesz sam. To sterownik, a nie framework do scrapingu.
Jak to działa pod maską
W chromedp wszystko jest Action, a Run wykonuje ich sekwencję na celu. Navigate, Click, Evaluate, OuterHTML, WaitVisible — ten sam interfejs, wszystko można łączyć, wszystko to po prostu komendy CDP opakowane w typy Go. Ta jednolitość to najlepsza decyzja projektowa biblioteki, bo sprawia, że „wygodne” API i surowy protokół działają na tym samym poziomie.
To ma znaczenie, bo ta warstwa wygody jest celowo cienka. chromedp opiera się na cdproto, czyli generowanym zestawie typowanych bindingów Go obejmujących całe DevTools Protocol, a chromedp godoc dokumentuje obie warstwy obok siebie. Gdy nie ma gotowej akcji wygodnej, schodzisz poziom niżej do wywołania domeny — network.Enable(), page.CaptureScreenshot(), runtime.Evaluate() — w tym samym Run. Nie ma muru między „ładnym API” a „prawdziwym API”, co nie jest standardem u każdego sterownika przeglądarki.
Akcje oczekiwania to miejsce, gdzie na co dzień zapadają praktyczne decyzje, a jest ich więcej, niż większość osób używa:
| Akcja oczekiwania | Na co blokuje |
|---|---|
WaitReady(sel) | aż węzeł zostanie dołączony do DOM |
WaitVisible(sel) | aż węzeł będzie naprawdę widoczny |
WaitNotPresent(sel) / WaitNotVisible(sel) | odwrotności, przydatne np. przy loaderach |
Poll(js, res) | wykonuje predykat JavaScript w interwałach, aż zwróci true |
Drugim ważnym elementem jest zarządzanie procesami, bo od niego zależy, czy po zakończeniu programu nie zostanie za Tobą uruchomiona przeglądarka. chromedp uruchamia Chrome przez exec.CommandContext z pakietu Go. Anulowanie tego contextu zabija proces. Ten pojedynczy szczegół implementacyjny tłumaczy zarówno poprawne zachowanie, jak i ostrą krawędź, na którą trafiłem podczas testów.
Instalacja to binarka Go plus Chrome, który musisz dostarczyć sam
go get github.com/chromedp/chromedp rozwiązało się bez problemów do v0.16.0, a drzewo zależności nie zawiera importów cgo. Tak więc powtarzane często hasło „pure Go, bez zewnętrznych zależności” jest prawdziwe — ale w odniesieniu do modułu Go.
Nie jest prawdziwe w odniesieniu do runtime’u. chromedp steruje zewnętrznym Chrome, więc bez zainstalowanego Chrome uruchomienie natychmiast kończy się błędem. Każdy pomiar, który wykonałem, wskazywał dokładny plik wykonywalny przez chromedp.ExecPath, ustawiony na Chrome for Testing 151.0.7922.10 w trybie headless shell. To nie jest zarzut — do sterowania przeglądarką potrzebujesz przeglądarki — ale „bez zewnętrznych zależności” i „musisz dostarczyć obok binarki Chrome ważący 155 MB” to zupełnie inne historie wdrożeniowe, a tylko jedna z nich pojawia się w README.
Druga pułapka konfiguracyjna kosztowała mnie czas i warto ją znać, zanim napiszesz jakikolwiek kod. W zgłoszeniu chromedp #1591 opisano, że runner go test w Go 1.25+ potrafi anulować NewExecAllocator w trakcie startu; identyczny kod działa poprawnie jako skompilowana binarka. Zbudowałem binarkę testową przez go build i używałem jej do wszystkich pomiarów, zamiast uruchamiać cokolwiek przez go test. Go tutaj było w wersji 1.26.5, macOS arm64. Jeśli Twoje pierwsze doświadczenie z chromedp to plik testowy, który umiera podczas uruchamiania Chrome, to właśnie ten issue warto przeczytać, zanim zaczniesz obwiniać własny kod.
Praktyka: cztery sposoby odczytu tej samej strony, dwa puste
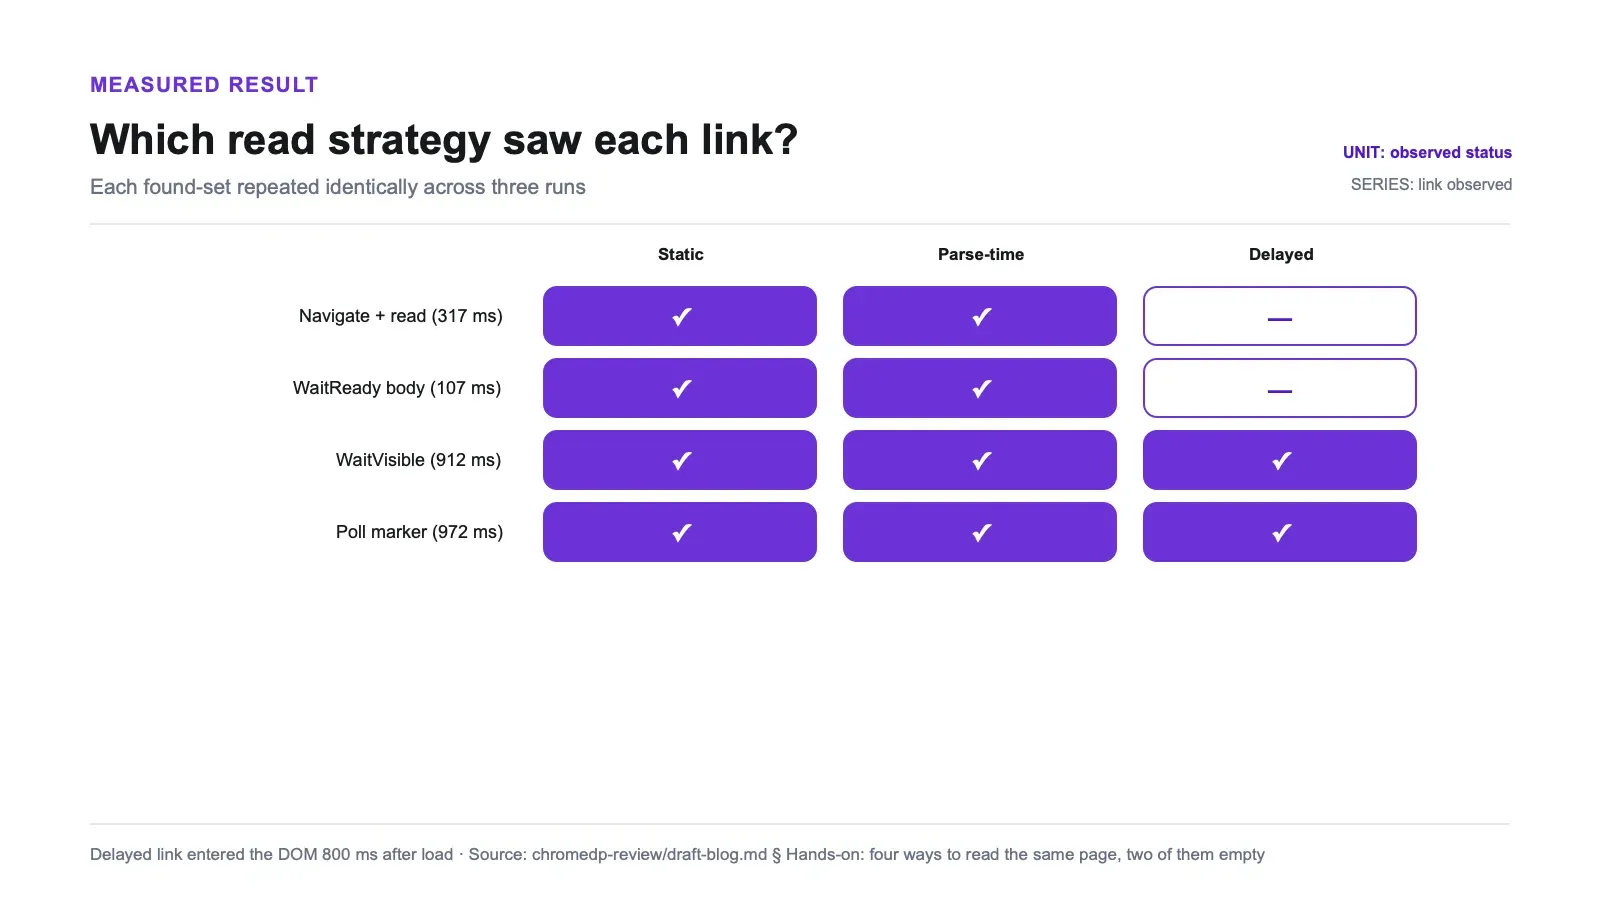
Fixture to lokalny serwer na 127.0.0.1, który serwuje trzy klasy treści różniące się wyłącznie tym, kiedy trafiają do DOM: statyczny <a> w pobranych bajtach, <a> utworzony przez inline <script> podczas początkowego parsowania oraz <a> utworzony przez setTimeout po konfigurowalnej liczbie milisekund po zdarzeniu load. Markery i hrefy dla dwóch linków tworzonych przez skrypt są składane z fragmentów stringów w JavaScript, więc w serwowanych bajtach nie istnieje żaden ciągły literał. „Znaleziony” wynik dowodzi więc, że Chrome wykonał JavaScript, a nie że ktoś odczytał HTML.
Recall jest liczony w Pythonie na podstawie wcześniej zarejestrowanej prawdy referencyjnej, a nie wewnątrz Go probe’a, więc probe nie może „oszukiwać”, znając odpowiedź. Każda strategia została uruchomiona trzy razy; zbiory znalezionych elementów były identyczne we wszystkich trzech przebiegach.
| Strategia odczytu | Link w statycznym HTML | Wstrzyknięty podczas parsowania | Wstrzyknięty 800 ms po load | Czas |
|---|---|---|---|---|
Navigate + odczyt bez oczekiwania | znaleziony | znaleziony | pominięty | 317 ms |
WaitReady("body") | znaleziony | znaleziony | pominięty | 107 ms |
WaitVisible("#delayed-injected") | znaleziony | znaleziony | znaleziony | 912 ms |
| Poll aż pojawi się marker | znaleziony | znaleziony | znaleziony | 972 ms |
Dwie linie zwracają dwa linki z trzech. Naiwny odczyt pomija trzeci link, bo Navigate kończy się na zdarzeniu load, a ten link jeszcze nie istnieje. WaitReady("body") zawodzi z bardziej subtelnego powodu, który w praktyce jest gorszy: body jest dołączone już przy load, więc warunek zostaje spełniony natychmiast i masz wrażenie, że zrobiłeś wszystko jak należy. Zwróciło wynik po 107 ms, szybciej niż ścieżka bez oczekiwania, i dało Ci tę samą niepełną stronę.
Żeby potwierdzić mechanizm zamiast tylko go zakładać, przeskanowałem opóźnienie wstrzyknięcia i ponownie uruchomiłem oba skrajne warianty (recall-summary.json):
| Opóźnienie wstrzyknięcia po load | Odczyt bez czekania widzi element | WaitVisible widzi element | Czas WaitVisible |
|---|---|---|---|
| 0 ms | tak (race) | tak | 109 ms |
| 100 ms | nie | tak | 208 ms |
| 400 ms | nie | tak | 519 ms |
| 800 ms | nie | tak | 911 ms |
| 1500 ms | nie | tak | 1625 ms |
Czas WaitVisible na tym fixture’ze podąża za opóźnieniem wstrzyknięcia — 100 do 208, 400 do 519, 800 do 911, 1500 do 1625 — co pokazuje, że blokował do pojawienia się węzła, zamiast czytać za wcześnie. Wiersz 0 ms to granica: setTimeout(…, 0) może odpalić się przed natychmiastowym odczytem, więc ścieżka bez oczekiwania może to jeszcze złapać. Przy 100 ms i więcej w tym przebiegu ścieżka bez oczekiwania minęła element w każdym uruchomieniu.
W produkcji ten sam błąd w czasie może dać poprawny HTML z zerową liczbą wyekstrahowanych wierszy i kodem wyjścia 0, jeśli pipeline nie sprawdza liczby wyników. To wiarygodny tryb awarii wsparty zachowaniem fixture’a, a nie incydent zmierzony tutaj. Samo renderowanie to tylko połowa wymogu; odczyt musi czekać na warunek na poziomie aplikacji, powiązany z danymi, których faktycznie szukasz.
WaitReady i WaitVisible nie są „lepsze” i „gorsze” — odpowiadają na różne pytania
Często mówi się, że WaitVisible jest „bardziej niezawodne” niż WaitReady. To sformułowanie jest na tyle nieprecyzyjne, że może zaszkodzić. Na stronie, gdzie węzeł jest dołączony do DOM, ale ma styl display: none, te dwie akcje rozchodzą się wyraźnie (waitsem-summary.json, trzy identyczne uruchomienia):
| Węzeł docelowy | Akcja | Wynik | Czas |
|---|---|---|---|
dołączony, display:none | WaitReady | zwraca | ~6 ms |
dołączony, display:none | WaitVisible | timeout, context deadline exceeded | 4000 ms |
| widoczny węzeł | WaitVisible, domyślne query | zwraca | 4–12 ms |
| widoczny węzeł | WaitVisible, ByID | zwraca | 1–2 ms |
| widoczny węzeł | WaitVisible, ByQuery | zwraca | 1 ms |
WaitReady oznacza: węzeł jest dołączony. WaitVisible oznacza: węzeł jest widoczny. Zadaj złe pytanie, a albo przejedziesz obok treści, która nigdy się nie wyrenderowała, albo będziesz blokować się do końca timeoutu na węźle, który w ogóle nie miał być widoczny. Sam timeout zachowuje się czysto — poprawne context deadline exceeded dokładnie po 4 s, bez zawieszenia i bez zombie state — co i tak jest więcej, niż potrafią niektóre sterowniki.
Jeden zgłoszony problem nie dał się odtworzyć. Issue #440 opisuje zawieszenie WaitVisible("#id") przy domyślnym query, ale na v0.16.0 tego nie udało się odtworzyć — domyślne query, ByID i ByQuery wszystkie zwracały na widocznym węźle w każdym uruchomieniu. Brak reprodukcji nie znaczy to samo co naprawa: to tylko jeden kształt selektora na jednej stronie, a nie zamknięcie problemu.
defer cancel() to nie kosmetyka — to element nośny
Liczyłem procesy, nie wartości zwracane. Każdy test cyklu życia używał unikalnego --user-data-dir i zliczał rzeczywiste procesy przeglądarki Chrome przez pgrep, filtrując potomne procesy rendererów. Każda ścieżka była uruchamiana trzy razy (lifecycle-summary.json).
| Ścieżka wyjścia (macOS, po 3 uruchomienia) | Co stało się z uruchomionym chrome-headless-shell | Czas |
|---|---|---|
| Anuluj context i allocator | zniknął | 13, 13 i 12 milisekund |
| Zakończ proces Go bez anulowania | przeżywa Twój program — zero procesów przeglądarki przed, jeden po wyjściu probe’a; osierocone 3 z 3 uruchomień | — |
Anulowanie jest czyste, szybkie i dokładnie takie, jak obiecuje exec.CommandContext. (Każde osierocone uruchomienie zostało później wymuszenie ubite przez harness; host został uprzątnięty.)
To znane, udokumentowane i ograniczone do platformy zachowanie — pomiar jest mój, odkrycie nie. Tracker chromedp opisuje to z kilku stron: #774 opisuje ten sam brak zakończenia na FreeBSD, #752 raportuje wiszące procesy Chromium na macOS, a #562 oraz #1566 wyjaśniają mechanizm. Ja dodałem zliczenie procesów i pomiar czasu po obu stronach kontrastu, czego tamte jakościowe raporty nie zawierały.
Sam mechanizm wynika z tagów build. W źródłach v0.16.0 allocate_linux.go ustawia Pdeathsig = SIGKILL dla procesu potomnego, więc Linux dostaje sygnał śmierci procesu rodzica na poziomie kernela. allocate_other.go, które kompiluje się na macOS, robi z tego wywołania no-op. Na darwin nie ma równoważnego sygnału, więc nic nie zabija Chrome, gdy Twój program się kończy. Tymczasem opis w godoc brzmi jak ogólna obietnica — domyślne polecenie „wysyła SIGKILL do wszystkich otwartych przeglądarek, gdy program Go się kończy” — a zawężenie do Linuxa jest ukryte wyłącznie w źródłach z tagami build, które trzeba samemu przeczytać. Nazwanie tego nadmierną obietnicą dokumentacji jest uczciwe; nazywanie tego bugiem chromedp już nie.
Praktyczny skutek pozostaje taki sam: na macOS defer cancel() to element konieczny. Pomiń go, a każde uruchomienie zostawi po sobie proces przeglądarki. Nie testowałem Linuxa, więc nie uogólniam tamtego wyniku osierocenia — źródło sugeruje inne zachowanie na Linuxie, a sugestia to nie pomiar.
Cold start, współbieżność i nudne szczegóły, które decydują o wdrożeniu
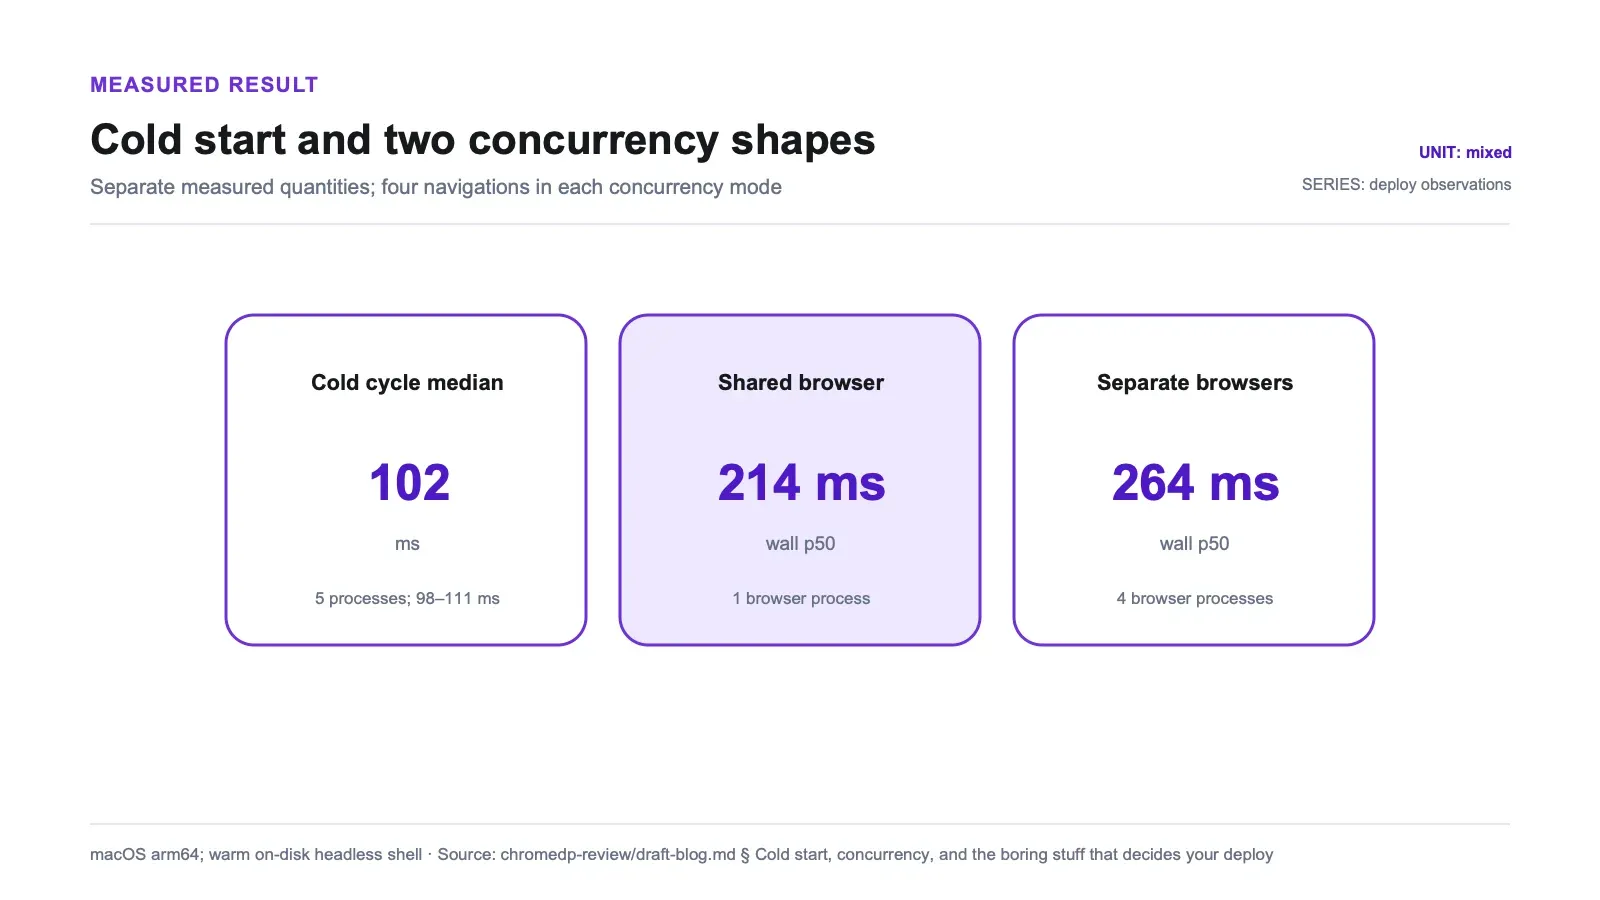
102 ms to mediana od świeżego procesu, allocatora, contextu, nawigacji na localhost i pierwszego Evaluate w pięciu procesach, z zakresem 98–111 ms (coldstart-summary.json). Na tym fixture’ze macOS arm64 z rozgrzanym headless shellem start był niewielki względem oczekiwania na opóźnioną treść. Kontenery, zimne systemy plików, CI, środowiska serverless i nawigacja produkcyjna nie były mierzone.
Jeśli chodzi o współbieżność, chromedp daje dwie formy — jedna przeglądarka z kilkoma child contextami (kartami) albo kilka niezależnych przeglądarek. Cztery nawigacje, po trzy uruchomienia każdej (concurrency-summary.json):
| Tryb | Czas całkowity (p50) | Zakres | Szczytowa liczba procesów Chrome |
|---|---|---|---|
| Współdzielona przeglądarka, 4 child contexts | 214 ms | 209–219 | 1 |
| 4 osobne przeglądarki | 264 ms | 261–278 | 4 |
Najważniejszy zmierzony wniosek dotyczy liczby procesów: jeden proces Chrome zamiast czterech dla tych czterech prostych lokalnych nawigacji. Zakresy czasu nie nakładały się, ale nadal są bardziej sygnałem kierunkowym niż pełnym benchmarkiem przepustowości. Nie mierzyłem RSS ani PSS, więc ten test nie dowodzi oszczędności pamięci.
Krótki test ścieżki błędu nie jest tu wystarczająco szczegółowy, by wyciągać wniosek o odporności: szkic nie identyfikuje, czy przyczyną był status HTTP, błąd nawigacji, zdarzenie czy logika harnessa. Obsługę 500/dead-link należy traktować jako nieopisaną, dopóki nie zostanie opublikowany dokładny wynik API i surowy artefakt.
Czego nie testowałem, a więc co nie mieści się w tych liczbach: zachowanie lifecycle na Linuxie, współbieżność większa niż N=4 albo z realną pracą na stronę, różnice pamięciowe (liczyłem procesy, nie RSS), przechwytywanie ruchu sieciowego i requestów, oraz otwarte raporty timeoutów WaitReady w #168 i #1593 — opisują one sporadyczne timeouty, podczas gdy to, co mierzyłem, to semantyka oczekiwania, czyli inne pytanie. Jedna maszyna, jedna kompilacja Chrome.
chromedp nie jest jedynym sterownikiem CDP w Go na tym stole: rod przeszedł przez identyczny fixture, harness, host i build Chrome podczas tej samej sesji i doczeka się własnego omówienia.
Plusy i minusy
Plusy:
- Prawdziwy dostęp do CDP — akcje wygodne i surowe wywołania
cdprotomogą działać razem w tym samymRun, więc nie trafiasz na ścianę API. - Lokalne odświeżone uruchomienie bazowe 102 ms p50, z rozrzutem 98–111 ms na testowanym fixture’ze macOS.
cancelubija Chrome w ok. 13 ms, konsekwentnie, przy każdym uruchomieniu.- Child contexts współdzielą jeden proces przeglądarki dla N kart (1 proces zamiast 4 dla osobnych przeglądarek).
- Deterministyczność w testach — zbiory recall, semantyka oczekiwania i wyniki lifecycle były identyczne we wszystkich trzech powtórzeniach.
- Czysta obsługa deadline’u:
WaitVisibledla niespełnialnego warunku zwrócił poprawnecontext deadline exceededdokładnie po 4 s, bez zawieszenia. - Moduł pure Go (bez cgo), na licencji MIT; zewnętrzny Chrome nadal jest potrzebny w runtime.
Minusy:
- Wymaga zewnętrznego Chrome w runtime; reputacja „bez zależności” dotyczy tylko modułu Go.
WaitReady("body")to pułapka, która wydaje się poprawna, a po cichu pomija treści pojawiające się po load — u mnie zwróciła wynik po 107 ms z niepełną stroną.- Naiwna ścieżka
Navigate+ odczyt pomija wszystko, co wstrzyknięto ≥ ~100 ms po load, deterministycznie i bez błędu. - Na macOS wyjście bez
cancel()pozostawia osierocony proces przeglądarki (3/3 uruchomienia). To znane i ograniczone do platformy zachowanie, ale łatwo się na nim potknąć. - Sformułowanie w godoc o SIGKILL przy wyjściu brzmi uniwersalnie, choć mechanizm siedzi w źródłach z tagami build tylko dla Linuxa.
go testw Go 1.25+ może anulować start allocatora (#1591); lepiej zbudować binarkę.- Zwraca DOM, nie dane strukturalne — każde pole, którego chcesz, to kod parsujący, który sam piszesz i utrzymujesz.
- Najnowszy tag (v0.16.0) wyprzedza najnowszy obiekt Release w GitHubie (v0.15.1), co chwilowo komplikuje sprawdzanie wersji.
Dla kogo jest chromedp, a kto powinien go ominąć
Jeśli Twoja usługa już jest w Go i potrzebujesz w niej prawdziwej przeglądarki, chromedp jest bardzo blisko oczywistego wyboru. Bez procesu Node do nadzoru, bez serwera WebDrivera do utrzymywania przy życiu, jedna skompilowana binarka plus Chrome, które instalujesz lub dostarczasz. Model contextów tak naturalnie mapuje się na prymitywy współbieżności w Go, że cykle życia przeglądarki kończą się pod tym samym defer jak reszta kodu. A jeśli potrzebujesz czegoś, czego nie obejmuje API wygodne — zdarzeń sieciowych CDP, precyzyjnych hooków lifecycle strony, sztuczek na poziomie protokołu — schodzisz do cdproto bez opuszczania biblioteki.
To też dobry wybór, gdy chcesz mieć jawny kontrolowany mechanizm oczekiwania. Akcje wait są prymitywami, nie heurystykami; robią dokładnie to, co deklarują, co staje się zaletą, gdy zaakceptujesz, że teraz prawidłowy wybór należy do Ciebie.
Omiń go, jeśli Twój zespół nie pisze w Go — koszt to przede wszystkim zobowiązanie językowe, nie sama biblioteka. Omiń go, jeśli chcesz ergonomii auto-wait, która sama zgaduje za Ciebie, bo chromedp nie zgaduje; zrobi dokładnie to, o co poprosiłeś, i zwróci to, co strona miała w tamtym momencie. Omiń go, albo zaplanuj na to poważny budżet, jeśli naprawdę potrzebujesz rekordów strukturalnych, a nie DOM-u: każde pole to selektor, który trzeba napisać, przetestować i naprawiać, gdy strona się zmieni. A jeśli całe wymaganie brzmi „po prostu dajcie mi dane z tych 500 URL-i”, uruchamianie orkiestracji przeglądarki w Go to bardzo dużo mechaniki jak na taki cel. Nasz przewodnik po automatyzacji przeglądarki pokazuje, kiedy ta mechanika się zwraca, a kiedy nie.
Alternatywy i miejsce naszego stacku
W kategorii sterowników przeglądarki rod to kolejny driver CDP w Go, a Playwright i Puppeteer to opcje po stronie Node, omówione w naszym porównaniu Playwright vs Puppeteer. Ich kontrakty oczekiwania nie są wymienne. Playwright auto-czeka na gotowość akcji przed wieloma operacjami, ale to nadal nie mówi mu, kiedy dane aplikacyjne faktycznie przestały napływać po akcji. chromedp daje niższopoziomowe prymitywy oczekiwania i zostawia zarówno gotowość do akcji, jak i warunki gotowości aplikacji po stronie wywołującego. Jeśli oglądasz szerszy rynek, nasz przegląd open-source’owych scraperów, które testowaliśmy obejmuje crawlery statyczne i biblioteki ekstrakcji po drugiej stronie tej granicy.
Powiązana recenzja: Browserless review.
Usługa zarządzanej ekstrakcji to inna kategoria. Wymienia kontrolę nad przeglądarką i selektorami na zewnętrzne renderowanie i kształtowanie schematu. Może to być użyteczne, gdy efektem końcowym mają być rekordy strukturalne, a nie DOM, podczas gdy chromedp lepiej pasuje wtedy, gdy przeglądarka ma pozostać pod kontrolą Twojej usługi Go. Budujemy Thunderbit, czyli jedną z takich usług, ale nie uruchamialiśmy jej na tym fixture’ze; ten test nie uprawnia więc do żadnego porównania równoważności, opóźnień, jakości ekstrakcji ani kosztów z chromedp.
Wypróbuj Thunderbit do ekstrakcji danych z sieci
Werdykt
Czy warto używać chromedp? Tak — jeśli piszesz w Go i chcesz mieć prawdziwą przeglądarkę pod kontrolą. W tym lokalnym fixture’ze dotarł do pierwszego wyniku ze skryptu w 102 ms p50, usuwał Chrome po anulowaniu w około 13 ms i używał jednego procesu przeglądarki dla czterech współbieżnych kart. To obserwacje ograniczone do tego testu, a nie uniwersalne obietnice wydajności; trwała zaleta to bezpośredni dostęp do CDP z Go, kiedy warstwa wygody już nie wystarcza.
Trzeba tylko poprawnie zinterpretować deklaracje, bo reputacja trochę przecenia dwie rzeczy. „Pure Go, bez zależności” opisuje moduł; w runtime i tak dostarczasz i zarządzasz binarką Chrome. A „użyj headless browsera i dostaniesz dynamiczną treść” jest prawdą tylko wtedy, gdy warunek wait jest powiązany z konkretnym węzłem, którego potrzebujesz — naiwny odczyt i WaitReady("body") oba zwróciły mi stronę pozbawioną treści wstrzykniętej 800 ms po load, po cichu, za każdym razem. Na macOS defer cancel() to nie kwestia stylu; pomiń go, a wycieknie Ci jedna przeglądarka na każde uruchomienie, co jest znanym zachowaniem platformowym, ale nadal Twoim problemem do rozwiązania. Zrób te trzy rzeczy dobrze, a chromedp będzie jednym z bardziej przewidywalnych driverów przeglądarki, jakie mierzyłem. Zrób je źle, a zawiedzie po cichu — a to najgorszy możliwy sposób awarii scrapera.
Wypróbuj Thunderbit do ekstrakcji danych z sieci Get Started Free
FAQ
Czy chromedp naprawdę widzi treści renderowane przez JavaScript?
Tak — ale tylko wtedy, gdy czekasz na właściwy węzeł. Na fixture’ze, gdzie link został wstrzyknięty 800 ms po zdarzeniu load, Navigate plus odczyt go pominął, WaitReady("body") też go pominęło, natomiast WaitVisible na tym węźle i polling JavaScriptowy odzyskały go, w trzech z trzech uruchomień każde. Przy przeszukaniu opóźnienia odczyt bez czekania gubił węzeł przy każdej wartości od 100 ms w górę. Renderowanie jest konieczne; poprawne oczekiwanie sprawia, że staje się wystarczające.
Jaka jest różnica między WaitReady a WaitVisible?
WaitReady blokuje do momentu, aż węzeł zostanie dołączony do DOM. WaitVisible blokuje, dopóki naprawdę nie będzie widoczny. Na węźle dołączonym, ale stylowanym jako display: none, WaitReady zwracało po około 6 ms, podczas gdy WaitVisible blokowało aż do 4-sekundowego deadline’u i zwracało czyste context deadline exceeded. Żadna z tych opcji nie jest „bardziej niezawodna” — odpowiadają na różne pytania, a wybór złej jest prawdziwą pułapką.
Czy naprawdę potrzebuję defer cancel() z chromedp?
Na macOS tak. Anulowanie contextu i allocatora usuwało uruchomionego Chrome w 12–13 ms przy każdym uruchomieniu; zakończenie procesu Go bez anulowania zostawiało osierocony proces przeglądarki we wszystkich trzech uruchomieniach. To znane zachowanie ograniczone do platformy — tracker chromedp dokumentuje ten sam wzorzec niekończenia na innych systemach nie-Linux, a mechanizm zabijania przez śmierć rodzica siedzi w źródłach z build tagiem tylko dla Linuxa. Nie testowałem Linuxa, więc traktuj wynik osierocenia jako ograniczony do macOS.
Czy chromedp wymaga osobnej instalacji Chrome?
Tak. Sam moduł Go jest pure Go i nie używa cgo, ale steruje zewnętrzną przeglądarką i bez niej natychmiast kończy się błędem. Jawnie podałem Chrome for Testing 151.0.7922.10 headless shell przez chromedp.ExecPath. Zaletą jest niewielki koszt startu: pełny zimny cykl do pierwszego wyniku ze skryptu miał medianę 102 ms w pięciu świeżych procesach, w zakresie 98–111 ms.
Czy lepiej współdzielić jedną przeglądarkę między kartami, czy uruchamiać osobne przeglądarki? Jeśli celem jest minimalizacja liczby procesów przeglądarki, wybieraj child contexts. Cztery lokalne nawigacje w jednej przeglądarce użyły 1 procesu Chrome; cztery osobne przeglądarki użyły 4. Czas całkowity też był korzystniejszy dla współdzielonej konfiguracji (mediana 214 ms wobec 264 ms), ale cztery proste lokalne strony to nie benchmark przepustowości. Pamięci nie mierzyłem. Osobne przeglądarki nadal mogą być lepsze, gdy potrzebujesz mocniejszej izolacji sesji, różnych proxy albo mniejszego promienia rażenia awarii; te kompromisy nie były częścią tego testu.




