Artikelscraper voor tekst, auteurs en data













Verzamel artikelgegevens ondanks veranderende paginalay-outs
Lees velden op basis van betekenis, plan herhaalde runs en gebruik dezelfde workflow op openbare websites.
Pas je aan wanneer artikelindelingen veranderen
Thunderbit leest zichtbare koppen, bylines, data, samenvattingen en artikeltekst op basis van betekenis. De workflow is minder afhankelijk van vaste posities op de pagina wanneer een nieuwswebsite de lay-out wijzigt.
Laat de artikel-scrape volgens schema draaien
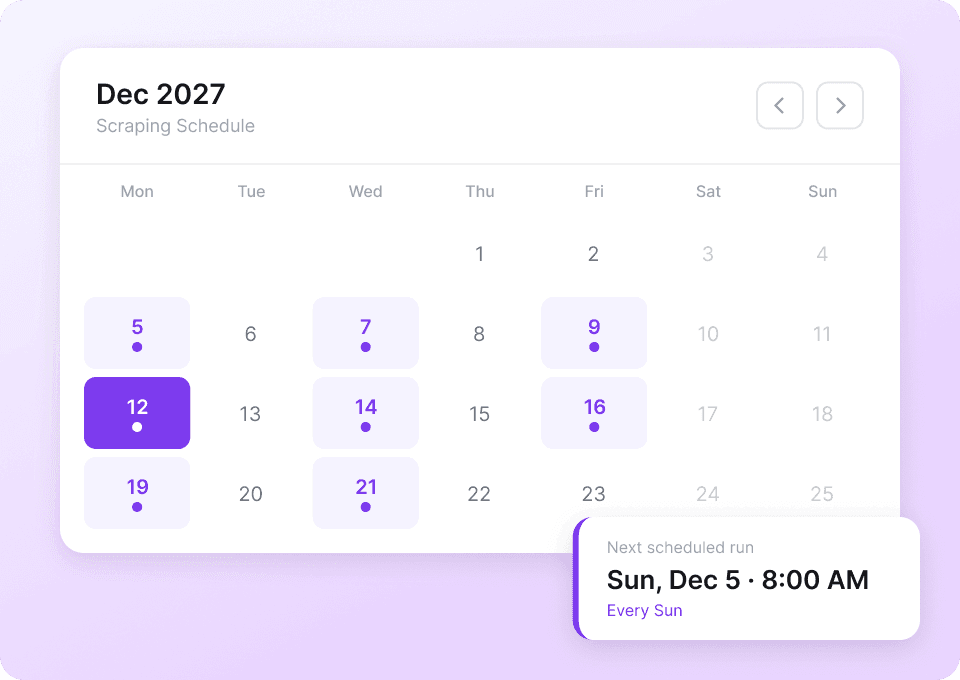
Stel een herhaalde run in voor een openbare nieuws-, blog- of sectiepagina die je regelmatig bezoekt. Thunderbit kan de nieuwste zichtbare artikelen verzamelen en nieuwe rijen naar je gekozen bestand of app sturen.
Gebruik één workflow op elke openbare site
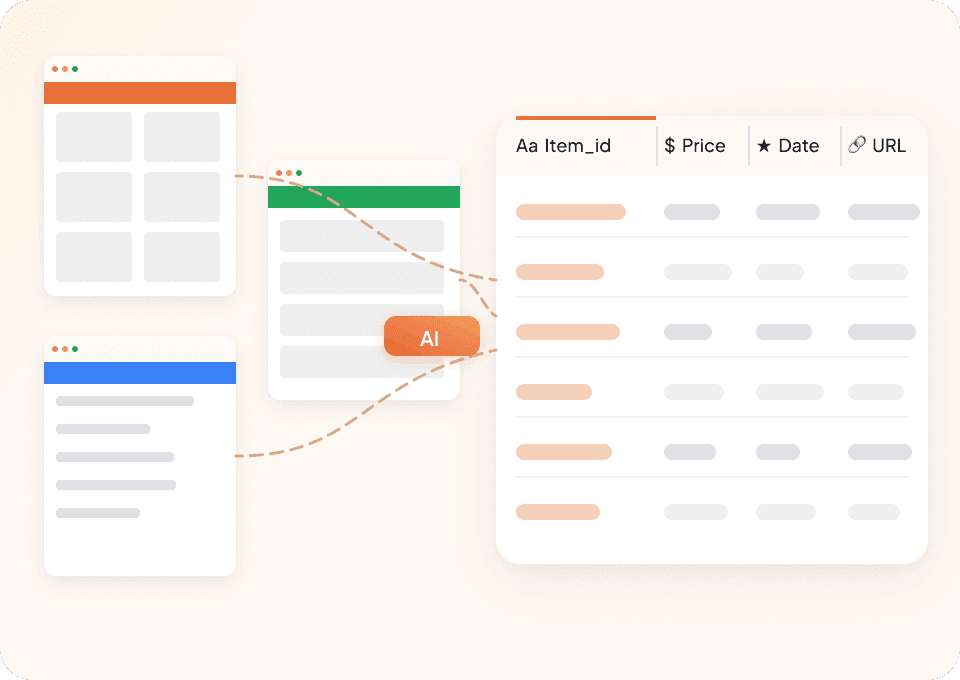
Gebruik dezelfde workflow op elke openbare site met artikelen. Geef de velden op die je nodig hebt en laat Thunderbit elke pagina in dezelfde kolommen plaatsen.
Eén artikelworkflow voor verschillende paginalay-outs
Vaste selectors volgen posities. Thunderbit AI zoekt de artikelvelden op die jij hebt genoemd.
Een selector-map voor elke uitgever
Elke paginalay-out vraagt om apart onderhoudArtikelvelden geordend door Thunderbit
Het gevraagde record blijft consistentWelke gegevens kun je uit een artikel halen?
Kies uit 30 zichtbare velden voor content, auteur, uitgever, datum, links, onderwerpen, media en paginametadata.
- Kop
- Alternatieve kop
- Artikeltekst
- Artikelsamenvatting
- Auteursnaam
- Auteur-URL
- Organisatie van de auteur
- Naam van uitgever
- Uitgever-URL
- Publicatiedatum
- Wijzigingsdatum
- Artikelcategorie
- Trefwoorden
- Woordenaantal
- Taal
- Canonieke URL
- URL van hoofdonderwerp
- Afbeeldings-URL
- Bijschrift bij afbeelding
- Fotocredit
- Video-URL
- Audio-URL
- Datering
- Onderwerpen over
- Vermeldingen
- Citatielinks
- Licentie-URL
- Gerelateerde artikellinks
- Paginatitel
- Metabeschrijving
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.
Vragen over het scrapen van openbare artikelen
Nieuwswebsites gebruiken verschillende lay-outs en paginadetails, dus de velden die je krijgt hangen af van de artikelpagina die je vastlegt.
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

4PDA Webscraper
Met de Thunderbit 4PDA Webscraper kun je eenvoudig gegevens uit 4PDA-nieuwsartikelen en forumberichten halen met behulp van AI. Verzamel snel artikeltitels, publicatiedata, auteurs en foruminhoud voor onderzoek, analyse of het volgen van technologische discussies. Perfect voor techliefhebbers, onderzoekers en marketeers die gestructureerde 4PDA-data zoeken.
Meer info ->
Ptt Webscraper
Met de Thunderbit Ptt Webscraper kun je moeiteloos gegevens van Ptt boards en posts verzamelen dankzij slimme AI-veldherkenning. Verzamel boardnamen, URL’s, populariteit, posttitels, auteurs en reacties voor onderzoek, marketing of contentanalyse. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde Ptt-data nodig hebben.
Meer info ->
Pizza Marketplace Scraper
Met de Thunderbit Pizza Marketplace Webscraper kun je eenvoudig gegevens ophalen uit het nieuwsarchief en de leveranciersgids van Pizza Marketplace. Dankzij AI-gestuurde veldsuggesties verzamel je razendsnel nieuwstitels, publicatiedata, auteurs, bedrijfsnamen, locaties en contactinformatie voor onderzoek, marketing of analyse.
Meer info ->
Failory Scraper
Met de Thunderbit Failory Webscraper kun je gestructureerde data verzamelen uit de startup cemetery en nieuwsartikelen van Failory. Dankzij AI-gestuurde veldsuggesties verzamel je moeiteloos start-upnamen, jaartallen, faalredenen, artikelkoppen, auteurs en meer voor onderzoek of analyse. Perfect voor ondernemers, investeerders en onderzoekers die inzichten uit Failory willen halen.
Meer info ->
Investing.com-scraper
Haal beursgegevens — zoals tickers, koersen, volumes en marktkapitalisatie — met 2 klikken uit Investing.com en exporteer ze direct naar Google Sheets, Notion of Excel. Open een willekeurige Investing.com-pagina en laat AI automatisch de juiste velden voor je herkennen.
Meer info ->
Substack-scraper
Haal in 2 klikken Substack-aantallen van abonnees, artikeltitels en publicatiebeschrijvingen op — en exporteer daarna naar Excel, Google Sheets of Notion. Geen code nodig; Thunderbit’s AI structureert alles automatisch voor je.
Meer info ->Klaar om je data-extractie een boost te geven?
Sluit je aan bij 200.000+ professionals die Thunderbit al gebruiken om hun webscrapingworkflows te automatiseren.
De gratis proefperiode biedt onbeperkte credits voor 8 webpagina’s.



