
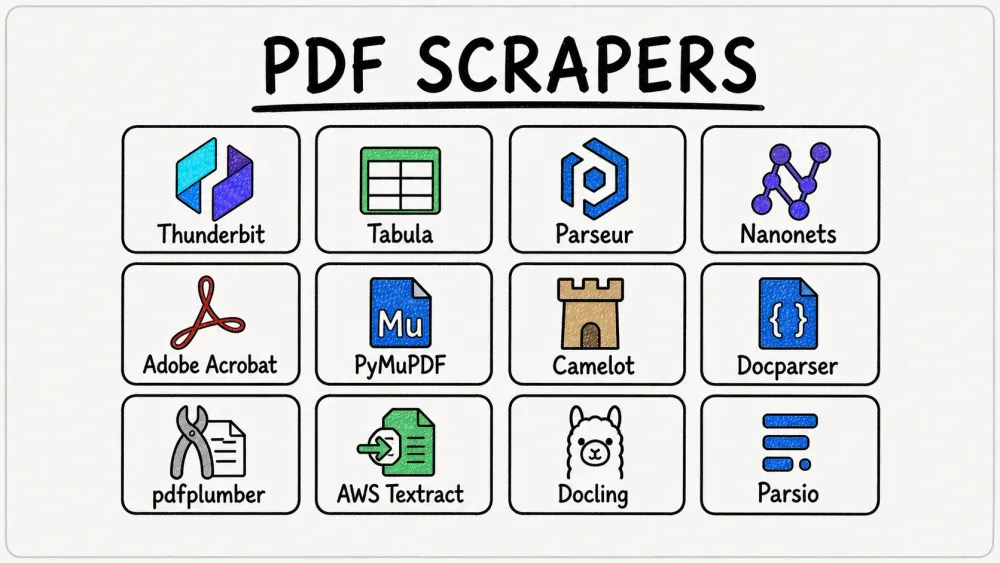
지난주 동료가 47페이지짜리 공급업체 계약서를 던지듯 보내며 물었어요. "가격표만 스프레드시트로 뽑아줄 수 있어요?" PDF 스크래핑을 몇 년째 다루다 보니 몸에 밴 반응이 있어요. 파일을 3초쯤 쳐다보다 그냥 닫고 스크래퍼부터 켜는 거예요. 게을러서가 아니라, 애초에 데이터를 내줄 생각 없이 만들어진 파일과 씨름하느라 반나절을 날리는 사람을 너무 많이 봤기 때문이죠.
이 답답함은 숫자로도 확인돼요. Airbase가 2024년 진행한 재무 전문가 745명 설문에서 **38%**의 팀이 업무 시간의 4분의 1 이상을 수작업에 쓴다고 답했고, SAP Concur의 AP 자동화 보고서 역시 ERP·회계 시스템에 들어가는 송장의 **60%**가 여전히 수동 입력이라고 밝혔어요.
송장, 계약서, 재무제표, 스캔 영수증 — PDF는 어디에나 있는데 업무는 여전히 복사-붙여넣기에 갇혀 있어요. 2026년의 PDF 스크래퍼는 무료 Python 라이브러리부터 AI 기반 노코드 도구까지 스펙트럼이 넓고, 잘못 고르면 시간을 아끼려다 오히려 며칠을 날려요. 그래서 테이블 추출, OCR, 가격, 사용 편의성 네 기준으로 최고의 PDF 스크래퍼 12개를 직접 써봤어요. 몇 분만 읽으면 자신에게 맞는 도구가 보일 거예요.
PDF 스크래퍼란 무엇이고, 왜 중요할까요
PDF 파일에서 텍스트·표·필드·구조화된 데이터를 자동으로 뽑는 소프트웨어가 PDF 스크래퍼예요. PDF 표를 Excel에 붙였는데 열이 뭉개진 적이 있다면 이미 아는 문제일 거고요.
PDF 스크래퍼와 웹 스크래퍼는 자주 헷갈리지만 구분은 간단해요. 웹 스크래퍼는 HTML을 읽고, HTML엔 최소한 제목·표·div 같은 구조 태그가 있어요. PDF 스크래퍼는 반대로 시각적 페이지 설명 형식에서 출발하죠. PDF는 기기마다 화면을 똑같이 보여주도록 설계됐을 뿐, 깔끔한 표나 의미 구조를 드러내려고 만든 게 아니라는 게 Adobe의 설명이에요. 그러니 복사-붙여넣기만 하면 행과 열, 읽는 순서가 쉽게 무너져요.
그럼 PDF 스크래핑이 실제로 시간을 아껴주는 지점은 어디일까요?
- 송장 처리: 공급업체명, 송장 ID, 총액, 세금, 항목별 내역 추출
- 재무 보고서: 연차보고서, 재무제표, 공시자료의 표 추출
- 스캔 문서: 이미지 기반 PDF에서 연락처나 거래 데이터 복원
- 레거시 마이그레이션: 오래된 문서를 검색 가능한 구조화 기록으로 전환
여파는 워크플로 하나로 끝나지 않아요. Gartner 추산 데이터 품질 문제의 조직 손실은 연평균 최소 1,290만 달러이고, 2025년 2월 발표에서는 조직의 63%가 AI에 맞는 데이터 체계를 못 갖췄거나 확신 못 한다고 나왔어요. 2026년까지 AI-ready 데이터 없는 AI 프로젝트의 **60%**가 중단될 거라는 전망도 있고요. 원천 데이터가 여전히 PDF에 있다면, 추출 품질은 곧 AI 준비도 문제예요.
PDF는 사라질 기미가 없어요. Adobe의 2025년 조사에서 **61%**가 PDF를 정기적으로 편집하고 **64%**는 정기적으로 서명한다고 답했고, PDF Association은 CommonCrawl 기준 PDF를 웹에서 세 번째로 인기 있는 형식으로 꼽았어요.
최고의 PDF 스크래퍼, 이렇게 평가했어요
도구 소개에 앞서 평가 기준부터 볼게요. 아래 8가지는 포럼·GitHub 이슈·제품 리뷰에서 가장 자주 보이는 불편함과 직결돼요.
| 평가 기준 | 무엇을 보는가 | 사용자가 중요하게 여기는 이유 |
|---|---|---|
| 지원하는 PDF 유형 | 네이티브 텍스트, 스캔/이미지 전용, 혼합형 | 많은 도구가 추출 시작 전부터 실패함 |
| 표 추출 정확도 | 단순 표, 테두리 없는 표, 여러 페이지 표, 병합 셀 표 | PDF 추출에서 가장 큰 불만 요소 |
| OCR 기능 | 내장, 추가 기능, 없음 | OCR 없이는 스캔 PDF를 사용할 수 없음 |
| 출력/내보내기 형식 | Excel, CSV, JSON, Sheets, Notion, API | 깔끔하게 내보내지 못하면 데이터가 쓸모없음 |
| 설정 난이도 | 노코드, 로우코드, 코드 필요 | 팀마다 필요한 제어 수준이 다름 |
| 가격 / 무료 플랜 | 공개 가격, 체험판, 현실적인 진입가 | 과금 방식이 도구마다 크게 다름 |
| 자동화 / 연동 | Zapier, API, 예약 실행, 웹훅 | 수동 내보내기는 확장성이 없음 |
| 가장 적합한 사용 사례 | 실제로 어떤 작업에 강한가 | 대부분의 도구는 범용이 아니라 워크플로우 특화형임 |
정리하면 12개 도구는 노코드 AI 스크래퍼, 템플릿·SaaS 문서 파서, 개발자용 라이브러리·API·오픈소스 세 범주로 나뉘어요.
한눈에 보는 12가지 최고의 PDF 스크래퍼
마스터 비교표로 상황에 맞는 도구를 바로 찾아보세요.
| 도구 | 유형 | 표 추출 | 내장 OCR | 노코드 | 무료 플랜 | 가장 적합한 용도 |
|---|---|---|---|---|---|---|
| Thunderbit | AI 노코드 스크래퍼 | ✅ AI 기반 | ✅ 있음 | ✅ 있음 | ✅ 무료 크레딧 | 비즈니스 사용자, 다양한 레이아웃 |
| Tabula | 오픈소스 데스크톱 | ✅ 좋음(텍스트 PDF) | ❌ 없음 | ✅ GUI | ✅ 완전 무료 | 단순한 표 중심의 텍스트 PDF |
| Parseur | 하이브리드 SaaS | ⚠️ 템플릿 + AI | ✅ 있음 | ✅ 있음 | ⚠️ 제한적 | 반복되는 송장/이메일 파싱 |
| Nanonets | AI IDP SaaS | ✅ 강력 | ✅ 있음 | ⚠️ 로우코드 | ⚠️ 크레딧 체험 | 대량 문서 자동화 |
| Adobe Acrobat | PDF 생산성 스위트 | ⚠️ 기본 수준 | ✅ 있음 | ✅ 있음 | ❌ 내보내기는 유료 | 가끔 PDF를 Excel로 변환할 때 |
| PyMuPDF | Python 라이브러리 | ⚠️ 수동 파싱 | ❌ 없음(Tesseract 선택) | ❌ 코드 필요 | ✅ 완전 무료 | 개발자, 텍스트 위주의 PDF |
| Camelot | Python 표 라이브러리 | ✅ 강력(lattice + stream) | ❌ 없음 | ❌ 코드 필요 | ✅ 완전 무료 | 개발자, 복잡한 표 |
| Docparser | 템플릿 SaaS | ⚠️ 템플릿 기반 | ✅ 있음 | ✅ 있음 | ⚠️ 체험판 | 반복 문서 + Zapier 워크플로우 |
| pdfplumber | Python 라이브러리 | ✅ 좋음(세밀함) | ❌ 없음 | ❌ 코드 필요 | ✅ 완전 무료 | 개발자, 세밀한 제어 |
| AWS Textract | 클라우드 API | ✅ 강력 | ✅ 있음 | ❌ API 필요 | ⚠️ 무료 티어 제한 | 엔터프라이즈 규모 파이프라인 |
| Docling | 오픈소스 Python | ✅ 좋음 | ✅ 연동 통해 가능 | ❌ 코드 필요 | ✅ 완전 무료 | LLM/RAG 파이프라인 |
| Parsio | 하이브리드 SaaS | ⚠️ AI 보조 | ✅ 있음 | ✅ 있음 | ⚠️ 제한적 | 반복되는 문서 유형 |
설정이 전혀 필요 없다면 노코드·SaaS 행부터, 최대한의 제어가 필요하면 개발자용 행부터 보세요. 스캔 PDF라면 OCR이 No인 행은 빼고 보시고요.
1. Thunderbit
 "이 PDF에서 데이터만 뽑고 싶어요"라고 말하는 사람에게 Python이나 템플릿, API 키 얘기를 꺼낼 필요가 없는 도구, 그게 Thunderbit예요. Chrome 확장 프로그램 형태의 AI 웹 데이터 에이전트로 PDF·이미지·웹사이트를 읽고 곧장 구조화된 데이터로 내보내죠. 템플릿도, 코딩도 필요 없어요.
만드는 계기가 명확했어요. 다섯 개 다른 공급업체에서 온 PDF처럼 레이아웃이 조금씩 다를 때 대부분의 도구가 막히거든요. Thunderbit는 AI가 문서를 매번 새로 읽고 "AI 필드 추천"으로 열 이름과 데이터 유형을 제안한 뒤 구조화된 표로 뽑아내는 방식으로 이 문제를 풀어요. 내장 OCR은 스캔 PDF와 이미지도 기본으로 처리하고, 34개 언어까지 지원해요.
주요 기능:
- 원클릭 추출: 어떤 PDF 레이아웃이든 열과 데이터 유형을 자동 파악 — 수동 설정 불필요
- 내장 OCR: 스캔 PDF와 이미지 지원
- 내보내기: Excel, Google Sheets, Airtable, Notion, CSV, JSON — 모두 무료
- AI 라벨링 및 재구성: 추출 후가 아니라 추출 과정에서 번역·분류·구조 재편 가능
- 표 추출: 사람처럼 레이아웃을 시각적으로 읽어, 테두리 없는 표나 불규칙한 형식, 다중 공급업체 문서에도 적응
Thunderbit로 PDF 스크래핑하는 법:
- Thunderbit Chrome 확장 프로그램 설치
- 브라우저에서 PDF 열기 또는 업로드
- "One Click Extract" 클릭 — AI가 열 이름·유형 자동 파악
- "Scrape" 클릭 — 구조화된 표로 추출
- Google Sheets, Excel, Airtable, Notion, CSV, JSON으로 내보내기
가격: 크레딧이 포함된 무료 플랜 제공(약 6페이지 무료, 체험판 포함 시 10페이지). 스타터 플랜은 월 약 $15, 연간 결제 시 월 약 $9 수준이에요(원화로는 각각 약 2만 원·1.3만 원 안팎). 크레딧은 행 단위로 계산돼요(1 크레딧 = 출력 행 1개). 자세한 내용은 Thunderbit Pricing을 참고하세요.
추천 대상: 공급업체마다 레이아웃이 제각각인 송장을, 클릭 한 번으로 끝내고 싶은 비전문 사용자.
장점: 이 목록 중 설정이 가장 간단함. OCR 내장. Sheets·Notion·Airtable·Excel 직결 내보내기. 템플릿 없이 다양한 레이아웃 소화.
단점: 크레딧 과금이라 페이지당 단가 환산에 손이 좀 감. 대형 SaaS 벤더 대비 서드파티 리뷰 수가 적음.
PDF 스크래핑을 위한 Thunderbit 체험 서로 다른 다섯 공급업체의 송장을 업로드하면 AI가 각 레이아웃에 맞는 열을 알아서 파악해요 — 템플릿별 설정이 필요 없어요. Get Started Free
2. Tabula
 텍스트 기반 PDF 표를 뽑을 때 가장 오래 사랑받은 무료 도구가 Tabula예요. 다만 지금은 레거시라는 꼬리표도 함께 붙어요. 최신 데스크톱 릴리스가 2018년의 1.2.1이고 tabula-java도 2021년 1.0.5에 머물러 있는 데다, 저장소 설명을 보면 자원봉사자들이 운영하는 프로젝트라 당분간 업데이트가 나올 가능성도 낮아요.
주요 기능:
- 표 영역을 직접 선택하는 포인트 앤 클릭 GUI
- 로컬 실행이라 데이터가 컴퓨터 밖으로 안 나감
- 계정, 구독, 가입 절차 없음
가격: 완전 무료, 영구 무료. 오픈소스.
추천 대상: 테두리가 뚜렷한 단순 텍스트 표를 다루면서 로컬 무료 도구를 찾는 사용자.
장점: 비용 0원. 로컬에서 완결. 기본 표라면 조작이 아주 간단.
단점: OCR 미지원(스캔 PDF 사실상 불가). 테두리 없는 표에 취약. 자동화·API 부재. 클라우드 옵션 없음. 관리도 사실상 멈춘 상태.
3. Parseur
 AI 파싱과 템플릿 파싱, 동적 OCR을 한 도구에 묶은 게 Parseur예요. 그래서 SaaS 그룹 안에서는 가장 강력한 하이브리드로 꼽히죠. 순수 영역 기반 파서보다는 유연하고, 완전 범용 AI 스크래퍼보다는 구조가 잡혀 있는 중간 지점이에요.
주요 기능:
- 60개 이상 언어 지원 내장 OCR(160개 이상은 실험적 지원)
- Zapier, Make, Power Automate, API, 웹훅, Google Sheets 연동
- 송장, 배송 통지, 주문 확인서 등 반복 문서 유형에 적합
가격: 월 약 20페이지 무료 플랜. 가장 낮은 셀프서브 유료 진입가는 월 약 $39(약 5.5만 원). 최소 플랜 기준 1,000페이지당 표준화 비용은 약 $390(약 55만 원) 수준이지만, 볼륨이 커질수록 실효 단가는 내려가요.
추천 대상: 같은 유형 문서가 반복 유입되고, 코드 없이 자동화하고 싶은 팀.
장점: OCR 내장. 자동화 스택이 탄탄함. 반복 레이아웃에 강함.
단점: 낯선 레이아웃이나 미세하게 바뀐 레이아웃은 템플릿 재작업이나 AI 대체 경로가 필요할 수 있음. 복잡한 표 구조는 여전히 버거움.
4. Nanonets
 단순 PDF 스크래퍼라기보다는 지능형 문서 처리(IDP) 플랫폼에 가까운 게 Nanonets예요. 강력한 만큼 복잡도도 따라오고요. 2025년 1월 31일에는 가격 체계 자체를 바꿔서, 페이지 단위 요금 대신 선불 사용 크레딧 방식으로 옮겨갔어요.
주요 기능:
- AI 기반 표 추출 및 필드 감지
- 40개 이상 언어 지원 내장 OCR
- 승인 단계가 포함된 워크플로 자동화
- 폭넓은 엔터프라이즈 연동 스택
가격: 가입 시 크레딧 제공. 사용량 기반 과금. 공개 블록 가격 문서 기준 단순 추출 워크플로는 대략 1,000페이지당 $300~$380(약 42만~53만 원) 수준으로 추정돼요.
추천 대상: 월 수천 건 규모를 처리하는 중대형 팀(AP 자동화, 물류, 보험 청구).
장점: AI 추출력이 강함. 엔터프라이즈 연동 풍부. 워크플로 자동화 지원.
단점: 비용을 미리 가늠하기 어려움. 고급 워크플로는 러닝커브가 있음. 무료 티어는 좁음.
5. Adobe Acrobat
 모르는 사람이 거의 없는 기본 PDF 도구, Adobe Acrobat이에요. OCR과 변환은 확실히 강하지만, 냉정히 말하면 이 목록의 다른 도구들과 같은 의미의 '스크래퍼'는 아니에요.
주요 기능:
- Pro 버전의 내장 OCR
- Word, Excel, PowerPoint, HTML, TXT, 이미지 형식으로 내보내기
- 폭넓은 다국어 OCR 지원
가격: Acrobat Standard는 월 $14.99(약 2.1만 원), Acrobat Pro는 월 $19.99(약 2.8만 원)예요. Reader는 무료지만 내보내기는 유료 플랜이 필요해요.
추천 대상: Adobe를 이미 구독 중이고 가끔 PDF를 Word·Excel로 바꿔야 하는 사용자.
장점: 신뢰도가 높음. OCR 내장. 이미 쓰는 사람이 많아 진입장벽이 낮음.
단점: 복잡한 레이아웃의 표 추출은 딱 기본 수준. 대량 처리용 자동화·API는 없음. 애초에 '스크래퍼'로 설계된 도구가 아님.
6. PyMuPDF
 "fitz"라는 이름으로도 불리는 PyMuPDF는 이 비교표를 통틀어 가장 빠른 범용 Python PDF 추출 라이브러리예요. 벤치마크에서도 다른 Python PDF 라이브러리 대부분을 확실히 앞서고, 현재 릴리스는 2026년 3월의 1.27.2.2예요.
주요 기능:
- 매우 빠른 원시 텍스트 추출
- 이미지 추출 및 메타데이터 접근
- Tesseract를 통한 선택적 OCR(다만 문서상 OCR은 일반 추출보다 약 1,000배 느림)
find_tables()를 통한 표 감지
가격: 완전 무료, 오픈소스.
추천 대상: 텍스트 위주의 네이티브 PDF를 다루는 파이프라인 개발자.
장점: 속도가 탁월함. 가벼움. 커뮤니티가 활발함. 텍스트 추출 품질 우수.
단점: OCR 미내장. 표 추출은 파싱 로직을 직접 짜야 함. 코드 작성 필수.
7. Camelot
 표 추출에만 집중한 도구라는 정체성 덕분에, Camelot은 여전히 Python 표 추출 도구 중 가장 이름이 알려져 있어요. 저장소는 지금도 유지보수 중이고 2025년 8월엔 v1.0.9가 나왔어요.
주요 기능:
- 두 가지 추출 모드: 테두리 있는 표용
lattice, 테두리 없는·공백 기반 표용stream - 자동화 워크플로에서 특히 유용한 파싱 리포트의 정확도 지표
- pandas DataFrame, CSV, JSON, Excel로 출력
가격: 완전 무료, 오픈소스.
추천 대상: 구조화된 텍스트 PDF에서 표를 정밀하게 뽑아야 하는 개발자.
장점: 표 정확도 우수. 추출 모드 두 가지. 정확도 점수까지 제공.
단점: OCR 없음. 텍스트 기반 PDF 전용. 코드 필요. 대용량 문서에선 속도가 처질 수 있음.
8. Docparser
 레이아웃을 폭넓게 '이해'하는 AI 독자 흉내를 내는 대신, 영역 OCR과 앵커 키워드, 고정 레이아웃 파싱 규칙으로 승부하는 게 Docparser예요. 이 목록에서 가장 명확한 규칙 기반 SaaS라고 보면 돼요.
주요 기능:
- 내장 OCR
- Zapier, Workato, Power Automate, Google Sheets, Salesforce, REST API 연동
- 추출 데이터를 비즈니스 워크플로에 연결하기 좋음
가격: Starter 월 $39, Professional 월 $74, Business 월 $159로 이어져요(순서대로 약 5.5만 원·10만 원·22만 원 수준). 14일 무료 체험 제공. 문서 단위 과금이라 1,000페이지당 표준화 비용은 문서 길이에 따라 다르며, 스타터 티어 기준 대략 $78~$390(약 11만~55만 원) 수준이에요.
추천 대상: Zapier·Salesforce 등과 촘촘히 엮어 반복 문서 워크플로를 돌려야 하는 팀.
장점: OCR 내장. 워크플로 연동이 강함. 안정적인 레이아웃에 적합.
단점: 템플릿 기반이라 레이아웃이 바뀔 때마다 재설정 필요. 표 추출이 영역 정의에 좌우됨. 1페이지 문서에서 가장 강함.
9. pdfplumber
 가장 세밀한 제어가 필요하다면 pdfplumber를 볼 차례예요. 저장소는 활발히 개발 중이라고 스스로 밝히고 있고, 현재 릴리스는 2026년 1월의 0.11.9예요.
주요 기능:
- 문자 객체, 선, 사각형, 표 탐지 전략을 세밀하게 제어
- 크롭 기반 필터링과 시각적 디버깅
- 데이터를 Python 리스트·딕셔너리로 출력해 가공이 쉬움
가격: 완전 무료, 오픈소스.
추천 대상: 표 추출 로직을 세밀하게 직접 짜고 싶은 Python 개발자.
장점: 하위 레벨 제어력이 뛰어남. 복잡한 표에서도 정확함. 개발이 활발함.
단점: OCR 없음. Camelot보다 진입 장벽이 높음. 코드 필요.
10. AWS Textract
 GUI 편의성이 아니라 대규모 처리와 다양한 문서 유형, 프로그램 연동을 겨냥해 만든 게 AWS Textract예요. 이 목록을 통틀어 가장 엔터프라이즈 친화적인 API라 할 만해요.
주요 기능:
- AI 기반 표 및 양식 추출
- 손글씨 지원이 있는 내장 OCR(이 목록에서 가장 근접하지만 여전히 완벽하진 않음)
- 엔터프라이즈급 확장성
- AWS 생태계와의 깔끔한 통합
가격: 페이지당 과금. 무료 티어: 3개월 동안 월 1,000페이지. 이후 텍스트 OCR $1.50(약 2,100원)/1,000페이지, 표 추출 $15(약 2.1만 원)/1,000페이지, 양식+표 $65(약 9만 원)/1,000페이지, 지출 문서 $10(약 1.4만 원)/1,000페이지예요.
추천 대상: API 파이프라인으로 월 1만 건 넘는 문서를 소화하는 엔터프라이즈 팀.
장점: 양식·표 추출 정확도 높음. OCR 내장. 엔터프라이즈급 확장성.
단점: API 전용이라 화면이 없음. 고급 모드로 갈수록 비용이 빠르게 불어남. AWS 생태계에 묶임.
11. Docling
 문서-LLM 파이프라인을 정면으로 겨냥한 오픈소스 도구가 Docling이에요. 이 목록에서 가장 미래지향적이라 부를 만하죠. 프로젝트는 빠르게 발전 중이고, 현재 릴리스는 2026년 4월 17일의 2.90.0이에요.
주요 기능:
- Markdown, HTML, WebVTT, DocTags, 손실 없는 JSON으로 출력
- 여러 통합 엔진을 통한 OCR 지원
- LangChain, LlamaIndex, CrewAI, Haystack 등과 함께 쓰도록 설계
- 강한 커뮤니티 성장세
가격: 완전 무료, 오픈소스.
추천 대상: PDF를 AI-ready Markdown으로 구조화해야 하는 LLM/RAG 개발자.
장점: Markdown 출력이 깔끔함. OCR 연동. 현대적 AI 워크플로에 최적화됨. 개발 속도가 빠름.
단점: 코드 필요. 개발자 중심 도구. SaaS보다 GUI·내보내기 옵션이 덜 다듬어짐.
12. Parsio
 템플릿과 OCR, AI 파싱, GPT 기반 파싱까지 한데 묶은 하이브리드 SaaS 파서가 Parsio예요. 포지션으로 보면 Parseur와 Docparser 중간쯤이고, 순수 영역 기반 도구보다는 유연하되 반복되는 문서 수집에 더 최적화돼 있어요.
주요 기능:
- 내장 OCR
- AI 보조 필드 감지
- Google Sheets, 웹훅, API, Zapier, Make, n8n, Pabbly 연동
가격: 30 크레딧 포함 샌드박스. Starter는 1,000 크레딧에 월 $41, Growth는 월 $124, Business는 월 $249예요(순서대로 약 5.7만 원·17만 원·35만 원 수준). 파서 모드에 따라 문서 1개나 PDF 1페이지가 1·2·5 크레딧을 쓸 수 있어, 스타터 플랜 기준 표준화 비용은 대략 1,000페이지당 $41~$205(약 6만~29만 원) 수준이에요.
추천 대상: 송장·영수증 같은 반복 문서를 가벼운 AI 노코드 SaaS로 처리하려는 소·중규모 팀.
장점: OCR 내장. 다양한 문서 유형 지원. 자동화 스택이 넓음.
단점: 서드파티 리뷰가 적음. 파서 모드별 가격이 한눈에 안 들어올 수 있음. Parseur나 Nanonets만큼 색깔이 뚜렷하진 않음.
표 추출 대결: 실제 표를 각 PDF 스크래퍼가 어떻게 처리할까
표 추출이 가장 큰 하소연 지점인 데는 이유가 있어요. OmniDocBench(10개 문서 유형·1,651페이지)나 이질적 표 추출 연구를 보면, "표 추출"은 균일한 한 작업이 아니라 난이도 스펙트럼에 가까워요.
단순한 표(명확한 테두리, 단일 페이지)
여긴 대부분 무난해요. Tabula, Camelot, pdfplumber, Thunderbit, AWS Textract 모두 좋은 성능을 내니, 테두리 분명한 단순 표라면 아무거나 골라도 괜찮아요.
테두리 없는 표와 공백 기반 표
여기서 실력 차가 드러나요. 구분선이 없으면 규칙 기반 파서는 열 경계를 못 잡아요. Camelot의 stream 모드나 pdfplumber의 파라미터 튜닝은 직접 다듬는 개발자에게 강하고, Thunderbit·Nanonets·AWS Textract처럼 레이아웃을 시각적으로 읽는 AI 도구는 형식이 들쭉날쭉한 문서를 다루는 비개발자에게 더 맞아요.
여러 페이지에 걸친 표
흔한 실패 지점이에요. 템플릿 도구와 단순 추출기는 워크플로가 명시적으로 이어 붙이지 않는 한 페이지마다 별도 표로 봐요. AI 우선 도구는 의미까지 읽어 연속성을 해석하니 유리하지만, 이 영역에 완벽한 벤더는 없다고 보는 게 맞아요.
병합 셀과 중첩 헤더
가장 까다로운 시나리오예요. 2024 EMNLP의 이질적 표 정보 추출 논문은 상황에 따라 F1이 74.2~96.1까지 벌어진다고 보고해요. 레이아웃을 의미적으로 읽는 AI 기반 도구(Thunderbit, Nanonets, AWS Textract)가 규칙 기반 파서보다 대체로 앞서는 지점이에요.
OCR 비교: 어떤 PDF 스크래퍼가 스캔 문서를 처리할까요
실제 비즈니스 PDF까지 처리하는 도구와 이상적인 기계 생성 문서만 되는 도구를 가르는 기준이 OCR이에요.
| 도구 | 기본 OCR | 스캔 PDF 지원 | 다국어 OCR | 손글씨 지원 |
|---|---|---|---|---|
| Thunderbit | ✅ 내장 | ✅ 가능 | ✅ 34개 언어 | ⚠️ 제한적 |
| Adobe Acrobat | ✅ 내장 | ✅ 가능 | ✅ 강력 | ⚠️ 제한적 |
| AWS Textract | ✅ 내장 | ✅ 가능 | ✅ 여러 주요 언어 | ✅ 가장 근접하지만 완벽하진 않음 |
| Nanonets | ✅ 내장 | ✅ 가능 | ✅ 40개 이상 언어 | ⚠️ 제한적 |
| Parseur | ✅ 내장 | ✅ 가능 | ✅ 60개 이상 언어 | ❌ 없음 |
| Parsio | ✅ 내장 | ✅ 가능 | ✅ 다국어 | ⚠️ 제한적 |
| Docparser | ✅ 내장 | ✅ 가능 | ✅ 가능 | ⚠️ 제한적 |
| Docling | ✅ 연동 통해 가능 | ✅ 가능 | 엔진에 따라 다름 | ⚠️ 제한적 |
| Tabula | ❌ 없음 | ❌ 불가 | 해당 없음 | 해당 없음 |
| PyMuPDF | ❌ 없음(Tesseract 선택) | ❌ 추가 기능 필요 | 엔진에 따라 다름 | 엔진에 따라 다름 |
| Camelot | ❌ 없음 | ❌ 불가 | 해당 없음 | 해당 없음 |
| pdfplumber | ❌ 없음 | ❌ 불가 | 해당 없음 | 해당 없음 |
손글씨를 모든 경우에 안정적으로 처리하는 도구는 2026년에도 없어요. AWS Textract가 엔터프라이즈 API 중 가장 근접하지만 여전히 "주의해서 써야 하는" 영역이고요. 타이핑된 스캔본이면 내장 OCR로 충분하지만, 손글씨는 기대치를 현실적으로 잡으세요.
AI 기반 vs 규칙 기반 vs 템플릿 기반: PDF 스크래핑의 3세대
2026년 PDF 스크래퍼 시장은 3세대로 나눠 보면 가장 쉽게 이해돼요.
1세대: 규칙 기반 (Tabula, Camelot, pdfplumber)
구조화된 텍스트 PDF, 일관된 레이아웃에서 최고예요. 개발자 손에선 강력하지만 레이아웃이 흔들리면 쉽게 깨지죠. 문서가 예측 가능하면 지금도 훌륭하고, 무료라는 점도 강점이에요.
2세대: 템플릿 기반 (Parseur, Docparser, Parsio)
문서 유형별로 영역·필드를 사용자가 직접 정의해요. 같은 공급업체의 반복 송장처럼 형식이 고정된 문서엔 좋지만, 레이아웃이 조금만 바뀌어도 다시 손봐야 해요.
3세대: AI/LLM 기반 (Thunderbit, Nanonets, AWS Textract, LLM 파이프라인용 Docling)
AI가 문서를 의미 단위로 읽고 템플릿 없이 새 레이아웃에 적응하면서, 라벨링과 변환까지 동시에 해내요. Everest Group의 2025 IDP 평가와 ACL 2025 멀티모달 표 연구 모두 LLM·에이전트 기반 추출을 다음 표준으로 봐요.
비전문 사용자에겐 이 차이가 특히 커요. PDF가 여러 공급업체·파트너·고객에서 뒤섞여 온다면 템플릿 도구는 계속 손이 가지만, AI 기반 도구는 다양한 형식을 처음부터 받아줘요. Thunderbit가 겨냥한 자리가 바로 여기, Python도 템플릿 관리도 하고 싶지 않은 비즈니스 사용자예요.
다양한 레이아웃을 위한 AI PDF 스크래핑 모든 공급업체에 하나의 스키마를 억지로 맞출 필요는 없어요 — AI가 문서를 읽고 구조를 스스로 파악해요. Get Started Free
가격 분석: 최고의 PDF 스크래퍼는 실제로 얼마일까요
다른 곳에서는 잘 안 다루는 비교이자, 정작 사용자들이 가장 궁금해하는 부분이 이거예요. 솔직하게 정리해 볼게요.
| 도구 | 무료 플랜 | 시작 유료 가격 | 1,000페이지당 예상 비용 | 오픈소스? |
|---|---|---|---|---|
| Thunderbit | ✅ 무료 크레딧 | 약 $15/월(연간 $9/월) | 약 $18–$30 | 아니오 |
| Tabula | ✅ 무제한 | 영구 무료 | $0 | 예 |
| Camelot | ✅ 무제한 | 영구 무료 | $0 | 예 |
| PyMuPDF | ✅ 무제한 | 영구 무료 | $0 | 예 |
| pdfplumber | ✅ 무제한 | 영구 무료 | $0 | 예 |
| Docling | ✅ 무제한 | 영구 무료 | $0 | 예 |
| Parseur | ⚠️ 월 약 20페이지 | 약 $39/월 | 약 $390(최저 티어) | 아니오 |
| Nanonets | ⚠️ 가입 시 크레딧 | 사용량 기반 | 약 $300–$380 | 아니오 |
| Docparser | ⚠️ 14일 체험 | $39/월 | 약 $78–$390 | 아니오 |
| Parsio | ⚠️ 30 크레딧 | $41/월 | 약 $41–$205 | 아니오 |
| Adobe Acrobat | ❌(내보내기는 유료) | Pro $19.99/월 | 페이지 단위 과금 아님 | 아니오 |
| AWS Textract | ⚠️ 월 1,000페이지(3개월) | 사용량 기반 | $1.50–$65 | 아니오 |
표시 가격보다 숨은 비용이 더 중요할 때가 많아요. 오픈소스 Python 도구는 달러로는 0원이지만 설정·유지보수·디버깅에 개발자 시간이 들고, 템플릿 SaaS는 형식이 고정일 땐 간단해도 레이아웃이 흔들리면 바로 비용이 뛰어요. Thunderbit 같은 AI 노코드 도구는 행 단위 크레딧 대신 설정 시간을 줄여주고, AWS Textract 같은 클라우드 API는 규모가 클수록 싸지지만 엔지니어링 체계가 이미 있을 때 얘기예요.
'진짜 비용'엔 결국 일하는 사람의 급여까지 넣어야 해요. 분석가가 템플릿을 설정하거나 Python 코드를 짜는 한 시간은, 소프트웨어가 무료라 해도 공짜가 아니니까요.
어떤 PDF 스크래퍼를 골라야 할까요
빠르게 고르고 싶다면 이 표를 보세요.
| 상황 | 추천 도구 |
|---|---|
| 비전문가, 다양한 PDF 레이아웃, 빠른 결과 원함 | Thunderbit, Nanonets |
| 같은 형식의 송장/영수증이 반복됨 | Parseur, Docparser, Parsio |
| 데이터 파이프라인을 만드는 개발자 | PyMuPDF, Camelot, pdfplumber |
| 엔터프라이즈, 월 10,000건 이상, API 필요 | AWS Textract, Nanonets |
| LLM/RAG 애플리케이션 구축 | Docling |
| 가끔 PDF를 Excel로 변환, 이미 Adobe 사용 중 | Adobe Acrobat |
| 무료, 로컬, 표 중심, 코딩 없음 | Tabula |
코딩도 템플릿 설정도 필요 없이 PDF 데이터만 꺼내고 싶다면 Thunderbit로 시작하세요. 문서가 반복되는 형식이라면 Parseur나 Docparser가 더 맞을 수 있고, 엔지니어링 제어가 필요하면 오픈소스 스택이 여전히 가장 저렴해요.
마무리
2026년 PDF 스크래핑엔 하나의 정답이 없어요. 개발자인지 비즈니스 분석가인지 엔터프라이즈 팀인지, PDF가 깔끔한 텍스트 문서인지 여러 공급업체에서 뒤섞여 온 스캔 이미지인지에 따라 맞는 도구가 갈려요.
AI 기반 PDF 추출이 궁금하다면 Thunderbit의 무료 플랜을 써보세요. 클릭 몇 번으로 얼마나 많은 정보가 나오는지 놀라실 거예요. 정답이 아니더라도 목록의 다른 도구를 시험해 볼 가치는 충분해요. PDF 앞에서 복사-붙여넣기를 멈추고 데이터를 실제로 써먹기엔 지금이 딱 좋은 때예요.
데이터 추출과 자동화를 더 알고 싶다면 웹사이트에서 Excel로 데이터 추출하기, 최고의 데이터 추출 도구, 비즈니스를 위한 AI 데이터 추출, 이미지를 Excel로 변환하는 방법 가이드도 참고하세요. Thunderbit YouTube 채널에서는 단계별 실습 영상도 볼 수 있어요.
Thunderbit 무료 체험하기 표, OCR, 혼합 형식 보고서를 한 번에 처리하세요. 무료 플랜만으로도 내 문서를 잘 다루는지 충분히 테스트할 수 있어요. Get Started Free
자주 묻는 질문
1. 가장 좋은 무료 PDF 스크래퍼는 무엇인가요?
비개발자라면 Tabula가 텍스트 기반 PDF 표를 다루는 가장 간단한 완전 무료 GUI 도구입니다. 개발자라면 Camelot, pdfplumber, PyMuPDF, Docling 모두 강력한 무료 선택지고요. 노코드에 무료 티어까지 원한다면 Thunderbit부터 보세요.
2. PDF 스크래퍼가 스캔 문서도 처리할 수 있나요?
내장 OCR이 있는 도구만 스캔 PDF를 직접 처리합니다. Thunderbit, Adobe Acrobat, AWS Textract, Nanonets, Parseur, Docparser, Parsio, Docling(통합 OCR 엔진)이 여기 해당하고, Tabula·Camelot·pdfplumber는 자체 처리가 안 돼 Tesseract 같은 외부 OCR을 붙여야 합니다.
3. PDF 표 추출 정확도는 어느 정도인가요?
표의 복잡도가 관건입니다. 단순한 테두리 표는 대부분의 도구가 잘 처리하지만, 테두리 없는 표·병합 셀·여러 페이지 표는 훨씬 어렵습니다. Thunderbit, Nanonets, AWS Textract 같은 AI 기반 도구가 다양한 레이아웃에서 규칙 기반 파서보다 대체로 나으며, 안정적인 텍스트 PDF에서는 규칙 기반 도구도 여전히 우수합니다.
4. PDF를 스크래핑하려면 코딩을 알아야 하나요?
아니요. Thunderbit, Parseur, Docparser, Parsio, Nanonets, Adobe Acrobat은 코딩 없이 쓸 수 있고 Tabula도 GUI가 있습니다. PyMuPDF, Camelot, pdfplumber, Docling 같은 Python 라이브러리는 코드가 필요합니다.
5. PDF 데이터를 Excel이나 Google Sheets로 바로 내보낼 수 있나요?
대부분의 도구가 최소 CSV나 Excel 내보내기는 지원합니다. Thunderbit는 Google Sheets, Airtable, Notion으로도 무료 직접 내보내기가 되고, Parseur·Docparser·Parsio는 Zapier·웹훅·API 연동으로 비즈니스 워크플로에 데이터를 흘려보낼 수 있습니다.
Thunderbit로 AI PDF 스크래핑을 시작해 보세요 Get Started Free
더 알아보기



