
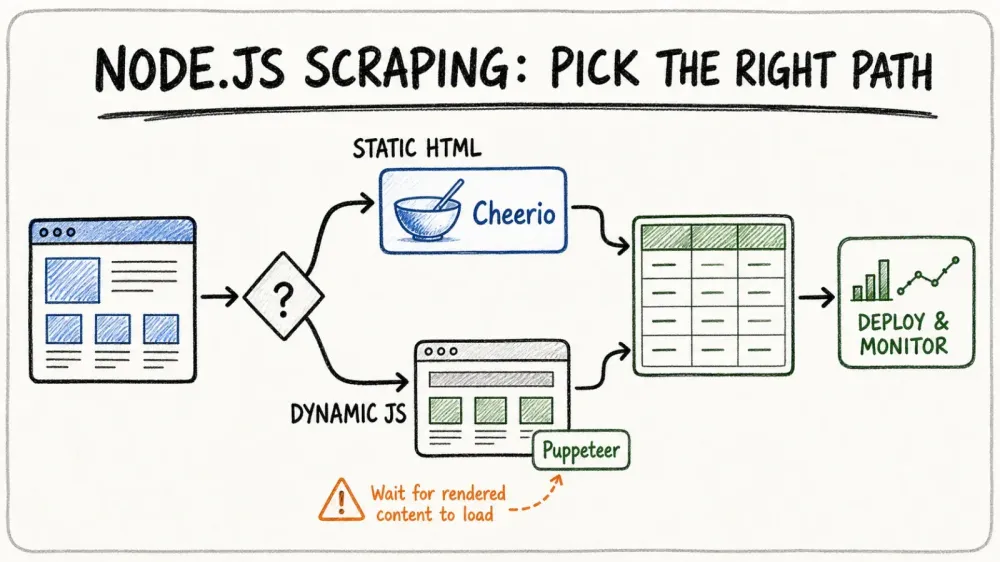
Web kini membutuhkan data lebih dari sebelumnya, dan pada 2026, Node.js jadi andalan tim yang ingin scraping dengan lebih cerdas, bukan lebih capek. Entah kamu kerja di bidang sales, ecommerce, atau cuma pecinta data seperti saya, kamu mungkin sudah sadar kalau scraping sekarang bukan sekadar “ambil datanya”—tetapi juga harus cepat, skalabel, dan tanpa bikin IP kamu masuk “penjara digital”. Permintaan juga tidak melambat — data web publik diam-diam sudah jadi bahan baku yang dipakai banyak tim modern, mulai dari pricing intelligence sampai pipeline pelatihan LLM, dan taruhannya (serta persaingannya) belum pernah setinggi ini.
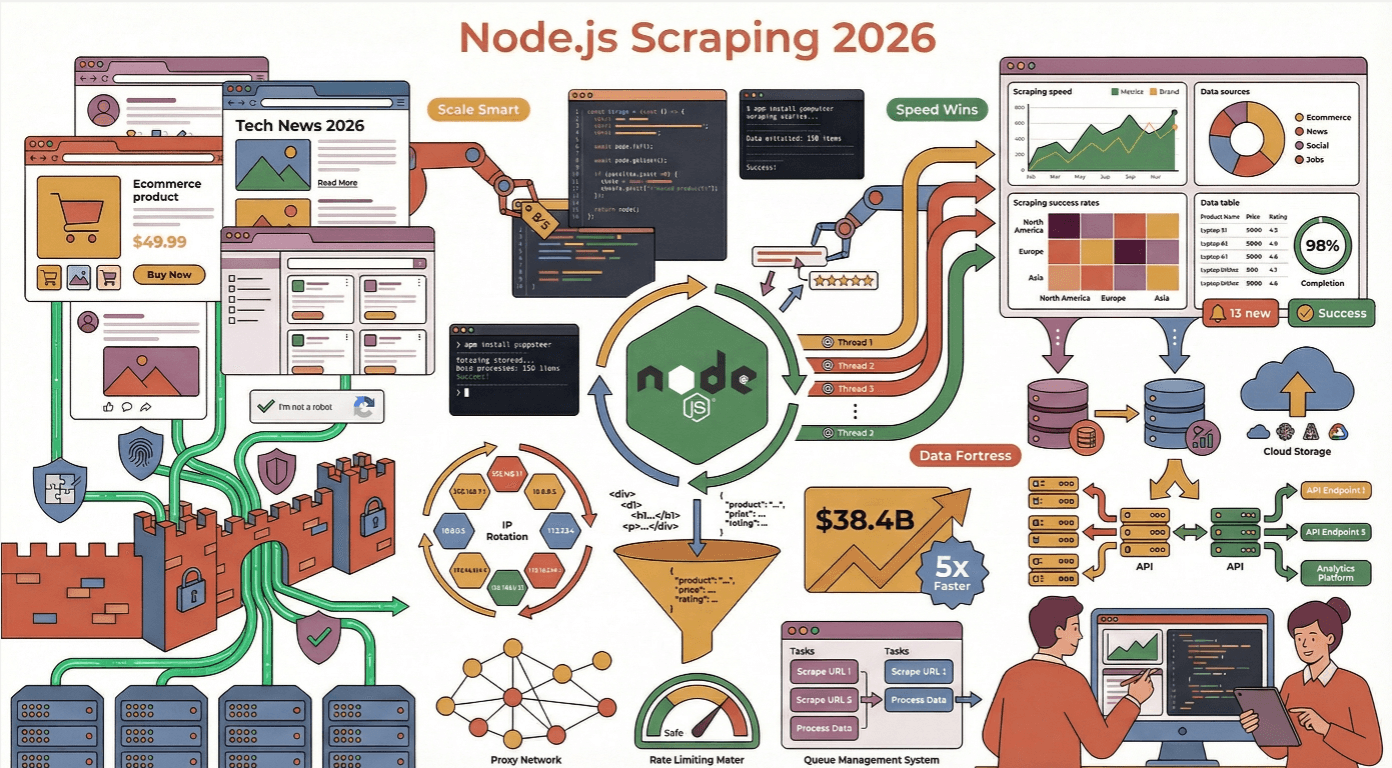
Tapi inilah tantangannya: web modern itu seperti benteng penuh konten dinamis, jebakan anti-bot, dan tata letak yang terus berubah. Saya sudah melihat lebih banyak scraper gagal total daripada yang ingin saya akui—biasanya karena mengabaikan praktik terbaik atau meremehkan betapa pintarnya pertahanan anti-scraping saat ini. Jadi, mari kita bahas praktik terbaik nyata untuk efisiensi web scraping Node.js, lengkap dengan sedikit cerita, sentuhan humor, dan banyak saran yang bisa langsung dipakai.
Mengapa Memilih Node.js untuk Efisiensi Web Scraping?
Kalau kamu pernah mencoba scraping ratusan (atau ribuan) halaman sekaligus, kamu tahu kalau kecepatan dan concurrency itu segalanya. Di sinilah Node.js benar-benar unggul. Model I/O asinkron dan non-blocking miliknya memang dibuat untuk menangani request jaringan dalam jumlah sangat besar secara bersamaan—ibarat multitasker paling kuat di web (Node.js Docs). Saat bahasa lain sibuk menunggu tiap request selesai, Node.js terus memutar event loop-nya, mengatur request seperti pemain sirkus yang kebanyakan minum kopi.
Saya juga pernah melihat Node.js mengungguli Python dan Java dalam skenario yang butuh update real-time dan ekstraksi skala besar, terutama ketika situs target banyak mengandalkan JavaScript. Faktanya, sekitar ~40% developer sekarang memakai Node.js untuk backend dan otomasi, menjadikannya teknologi web paling populer di dunia.
Node.js vs. Framework Web Scraping Lain
Mari sedikit nerdy. Inilah perbandingan Node.js dengan para pesaingnya:
| Framework | Kelebihan | Kekurangan | Kasus Penggunaan Terbaik |
|---|---|---|---|
| Node.js | Asinkron, hebat untuk concurrency, ekosistem npm sangat besar, JS native untuk situs dinamis | Bisa boros memori, callback hell (kalau tidak pakai async/await) | Scraping real-time, situs berat JavaScript, microservices skalabel |
| Python | Banyak library scraping (BeautifulSoup, Scrapy), sintaks mudah | Lebih lambat untuk concurrency besar, kesulitan pada situs berbasis render JS | HTML statis, riset, prototyping |
| Java | Strong typing, tangguh untuk enterprise | Verbose, kurang fleksibel untuk script cepat | Scraping skala besar, kelas enterprise |
| Go | Cepat, concurrency efisien | Ekosistem lebih kecil, kurva belajar lebih tinggi | Scraping berperforma tinggi, latensi rendah |
Bagi sebagian besar pengguna bisnis, Node.js ada di titik paling pas: cepat, fleksibel, dan sangat cocok untuk web modern yang digerakkan JavaScript (Thunderbit Blog).
Menyiapkan Lingkungan Web Scraping Node.js yang Tangguh
Scraper yang bagus selalu dimulai dari fondasi yang solid. Inilah setup andalan saya:
- Struktur Proyek: Buat semuanya modular. Pakai folder seperti
/src,/libs, dan/config. Simpan info sensitif seperti API key dan proxy di environment variables dengandotenv(Thunderbit Guide). - HTTP Client: Gunakan axios, got, atau node-fetch untuk request.
- Parsing HTML: Cheerio untuk HTML statis, Puppeteer atau Playwright untuk konten dinamis.
- Utilitas: Gunakan Lodash untuk olah data, dan validator.js atau Joi untuk validasi data.
- Testing & Linting: Mocha untuk pengujian, ESLint untuk kualitas kode (LogRocket).
Library Esensial untuk Web Scraping Node.js
- HTTP client (axios / got / built-in
fetch): Untuk membuat request. Perlu dicatat sejak awal: sejak Node.js v18 kamu bisa memakaifetchsecara native tanpa install apa pun, dan Node.js v22 menjadikannya stabil. Untuk proyek baru di versi Node yang lebih modern, kamu kemungkinan tidak perlu paketnode-fetchsama sekali — cukup panggilfetchlangsung. Saya masih sering memilih axios saat butuh interceptor, JSON otomatis, dan API promise yang terasa familiar baik di Node maupun browser, sementara got saya pakai saat butuh retry, stream, atau HTTP/2 langsung tersedia. Pilih yang paling cocok dengan stack kamu; untuk script cepat,fetchnative sudah cukup. - Cheerio: Parser HTML cepat, mirip jQuery. Ideal untuk halaman statis—bisa parsing dalam ~0,5 detik (Oxylabs).
- Playwright / Puppeteer: Otomasi browser headless untuk situs dinamis yang berat JavaScript. Lebih lambat (~4 detik per halaman), tetapi penting untuk situs yang memuat konten setelah halaman dibuka (Bright Data). Kalau kamu mulai dari nol di 2026, Playwright adalah pilihan default — dukungan lintas browser bawaan (Chromium / Firefox / WebKit), ada trace viewer bawaan, dan tim yang awalnya membangun Puppeteer kini mengembangkannya di Microsoft. Puppeteer masih dipelihara untuk pekerjaan khusus Chrome, tetapi catatan rilisnya sudah cukup lama lebih banyak fokus ke pembaruan kompatibilitas Chrome ketimbang kemampuan baru.
- dotenv: Untuk mengelola environment variables.
- csv-writer/jsonfile: Untuk ekspor data.
Menghindari Jebakan Umum dalam Web Scraping Node.js
Saya sudah tidak terhitung berapa kali melihat scraper diblokir, crash, atau cuma menghasilkan data yang berantakan. Berikut hal-hal yang perlu kamu waspadai:
- Mengabaikan robots.txt dan Terms of Service: Selalu cek sebelum scraping. Melanggar aturan ini bisa bikin IP kamu diblokir—atau lebih parah lagi, menyeret kamu ke masalah hukum (ScraperAPI).
- Membebani server: Jangan bombardir request. Batasi scraper kamu dengan jeda acak (1–3 detik), gunakan kontrol concurrency, dan jangan bertingkah seperti robot yang terlalu semangat (ScrapeGraphAI).
- Tidak menangani error: Selalu bungkus request dengan try/catch, tangani HTTP error, dan catat kegagalan. Coba ulang error sementara dengan exponential backoff (ScrapeGraphAI).
- Lupa request header: Pakai string User-Agent yang realistis dan lakukan rotasi. Tambahkan Accept-Language, Referer, dan header lain supaya mirip browser sungguhan (ScrapeGraphAI).
Cara Melewati Mekanisme Anti-Scraping
Situs web modern dipersenjatai penuh dengan teknologi anti-bot. Inilah cara saya menghindari ranjau digital itu:
- Rotasi proxy/IP: Gunakan pool proxy dan rotasi IP untuk menghindari blokir (Medium).
- Acak header: Rotasi User-Agent, Accept-Language, dan header lain untuk setiap request.
- Stealth pada headless browser: Gunakan plugin seperti
puppeteer-extra-plugin-stealthuntuk menyamarkan jejak otomasi. - Meniru perilaku manusia: Tambahkan jeda acak, gerakan mouse, scrolling, bahkan typo saat mengetik (ZenRows).
Meniru Perilaku Manusia di Scraper Node.js
Bagian ini seru, dan agak aneh. Alih-alih langsung klik dan scroll, buat scraper kamu:
- Menunggu interval acak antar aksi (
await page.waitForTimeout(randomDelay)) - Menggerakkan mouse dalam langkah kecil yang tidak mulus (
page.mouse.move(x, y)) - Mengetik dengan jeda acak dan sesekali typo (
page.type(selector, text, {delay: random(100,200)})) - Scroll tidak rata, bukan langsung ke bawah saja
Trik-trik ini bisa meningkatkan tingkat keberhasilan kamu secara signifikan di situs yang dilindungi (ScraperAPI).
Menyederhanakan Ekstraksi Data Kompleks dengan Thunderbit
Ekstrak data dari situs mana pun menggunakan AI Lewati kode boilerplate: agentic web scraper Thunderbit membaca halaman apa pun dan mengekstrak data dalam satu klik, tanpa perlu memelihara kode Node.js. Get Started Free
Sekarang, mari kita bahas masalah paling jelas: scraping itu sulit. Tapi tidak harus serumit itu. Itulah alasan kami membangun Thunderbit.
Thunderbit adalah ekstensi Chrome agentic web scraper yang memungkinkan kamu mengekstrak data dari situs mana pun dengan bahasa sehari-hari. Cukup klik “One Click Extract”, biarkan AI memahami isi halaman, lalu tekan “Scrape”. Rasanya seperti punya junior developer yang tidak pernah tidur dan tidak pernah minta naik gaji.
Lebih enak lagi, Thunderbit menyediakan API, jadi kamu bisa langsung menghubungkannya ke workflow Node.js kamu. Daripada menulis ribuan baris kode scraping, kamu bisa membiarkan Thunderbit menangani pekerjaan berat—konten dinamis, subpage, pagination, dan semuanya. Kamu tinggal ambil data terstruktur (CSV, JSON, atau langsung ke Google Sheets, Airtable, Notion) dan lanjut kerjaan kamu (Thunderbit Blog).
Coba Ekstensi Chrome Thunderbit Gratis Pasang ekstensi Chrome gratis dan ekstrak data terstruktur dalam satu klik — atau panggil API Thunderbit dari aplikasi Node.js kamu. Get Started Free
Thunderbit vs. Scraping Node.js Tradisional
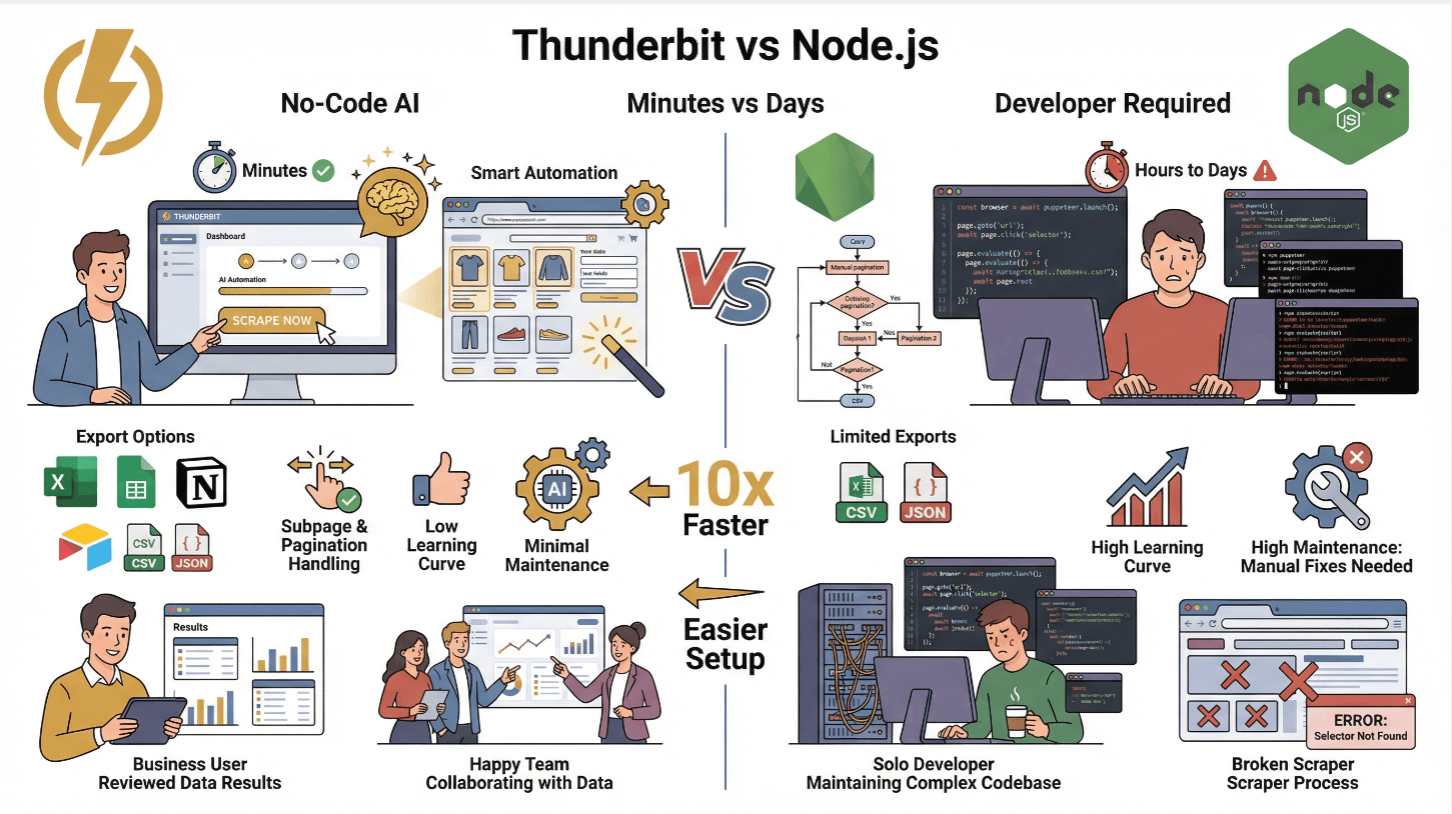
| Fitur | Thunderbit | Scraper Node.js Tradisional |
|---|---|---|
| Waktu Setup | Menit (tanpa kode) | Jam hingga hari (coding, testing) |
| Menangani Konten Dinamis | Ya (AI + browser) | Ya (dengan Puppeteer/Playwright) |
| Subpage & Pagination | 1 klik | Perlu coding manual |
| Ekspor Data | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (kode kustom) |
| Kurva Belajar | Rendah (pengguna bisnis) | Tinggi (developer) |
| Maintenance | Minim (AI beradaptasi) | Tinggi (perlu perbaikan manual saat situs berubah) |
Thunderbit sangat cocok untuk tim non-teknis atau siapa pun yang ingin lepas dari kerjaan rutin dan fokus ke insight. Untuk pengguna tingkat lanjut, kamu tetap bisa memakai API Thunderbit untuk mengotomatiskan scraping skala besar (Thunderbit Docs).
Menggabungkan Cheerio dan Puppeteer untuk Konten Dinamis
Ini kombinasi andalan saya untuk scraping Node.js. Begini alurnya:
- Gunakan Puppeteer untuk memuat halaman dan menjalankan JavaScript (tunggu
networkidlesupaya semua konten selesai dimuat). - Ambil HTML dengan
await page.content(). - Parse dengan Cheerio: Masukkan HTML ke Cheerio untuk parsing dan ekstraksi data yang super cepat dengan gaya jQuery.
Pendekatan hibrida ini memberi kamu dua keuntungan sekaligus: kekuatan Puppeteer untuk konten dinamis, dan kecepatan Cheerio untuk parsing (Browserless).
Tips performa: Pilih hanya elemen yang kamu butuhkan. Cheerio memuat seluruh DOM ke memori, jadi hindari selector yang terlalu luas dan cache hasil jika kamu meng-scrape halaman yang sama berulang kali (Oxylabs).
Mengoptimalkan Parsing HTML dan Ekstraksi Data
- Gunakan selector spesifik: Hindari
$('body *')—targetkan hanya yang kamu butuhkan. - Stream halaman besar: Untuk HTML yang sangat besar, pertimbangkan streaming atau pecah pekerjaannya.
- Cache HTML hasil render: Kalau kamu mengunjungi URL berulang, cache HTML untuk menghindari request yang tidak perlu.
- Validasi dan bersihkan data: Gunakan library validator agar database kamu tidak dipenuhi data sampah (ScrapeGraphAI).
Deployment Web Scraper Node.js yang Skalabel di Cloud
Scraping dalam skala besar? Saatnya pindah ke cloud-native.
- Dockerize scraper kamu: Tulis
Dockerfile, salin kode kamu, instal dependency, dan set entrypoint. - Deploy ke cloud: Gunakan AWS EC2, Google Cloud Compute, atau Azure VM untuk pekerjaan sederhana. Untuk skala serius, pakai Kubernetes atau managed service seperti AWS ECS/EKS, Google Cloud Run, atau Azure Kubernetes Service (DigitalOcean).
- Orkestrasi dengan Kubernetes: Jalankan beberapa pod, lakukan autoscaling sesuai kebutuhan, dan gunakan load balancer untuk membagi URL.
- Jadwalkan pekerjaan: Gunakan cloud scheduler (CloudWatch Events, Cloud Scheduler) atau cron job untuk memicu scraping secara berkala.
Dalam satu contoh nyata, peningkatan dari 5 ke 10 pod Kubernetes memangkas scraping 400 halaman dari beberapa menit menjadi kurang dari satu menit (DigitalOcean).
Monitoring dan Auto-Scaling Infrastruktur Scraping Anda
- Logging: Kirim log ke CloudWatch, Stackdriver, atau Datadog. Pasang alert untuk error atau perlambatan.
- Health check: Gunakan Prometheus dan Grafana untuk metrik seperti halaman yang di-scrape per menit, tingkat error, dan kesehatan pod.
- Auto-scaling: Siapkan Kubernetes HPA (Horizontal Pod Autoscaler) untuk menyesuaikan jumlah pod berdasarkan CPU atau jumlah request.
Selalu terapkan retry dengan exponential backoff untuk pulih dari gangguan jaringan atau blokir sementara.
Praktik Terbaik Penyimpanan Data dan Post-Processing
Setelah data berhasil di-scrape, kamu perlu menyimpan dan membersihkannya:
- Pekerjaan kecil: Ekspor ke CSV, JSON, atau kirim ke Google Sheets, Airtable, atau Notion (Thunderbit sudah menyediakan ini secara bawaan).
- Pekerjaan besar: Pakai SQL (MySQL/PostgreSQL) untuk data terstruktur, atau NoSQL (MongoDB, DynamoDB) untuk data semi-terstruktur atau skema yang terus berkembang (ScrapeHero).
- Penyimpanan cloud: S3 atau Google Cloud Storage untuk file mentah dan backup.
- Pembersihan data: Selalu validasi field, normalisasi format (tanggal, angka), dan deduplikasi entri. Gunakan schema validator untuk menjaga kualitas data (ScrapeGraphAI).
Simpan data mentah dan data yang sudah dibersihkan—kamu tidak akan tahu kapan perlu memproses ulang atau melakukan debugging.
Kesimpulan: Poin Penting untuk Efisiensi Web Scraping Node.js
Lewati Kode Scraper Lihat bagaimana agentic web scraper Thunderbit dibandingkan dengan menulis dan memelihara script scraping kamu sendiri. Get Started Free
Mari kita tutup dengan hal-hal paling penting:
- Manfaatkan kekuatan async Node.js untuk scraping masif dan bersamaan—terutama pada situs yang banyak memakai JavaScript.
- Gabungkan tool yang tepat: Pakai axios/got untuk request, Cheerio untuk HTML statis, Puppeteer untuk konten dinamis, dan kombinasikan semuanya untuk kecepatan serta fleksibilitas.
- Hindari jebakan anti-bot: Rotasi proxy dan header, tirukan perilaku manusia, dan hormati robots.txt.
- Sederhanakan dengan Thunderbit: Untuk pengguna bisnis atau prototyping cepat, Thunderbit memungkinkan kamu mengekstrak data kompleks dengan AI dan menghubungkannya ke stack Node.js lewat API.
- Deploy dalam skala besar: Dockerize, orkestrasi dengan Kubernetes, dan pantau semuanya supaya tetap andal.
- Simpan dan bersihkan data kamu: Pilih penyimpanan yang sesuai kebutuhan, dan selalu validasi sebelum dipakai.
Web tidak akan jadi lebih sederhana, tapi dengan praktik terbaik ini, scraper Node.js kamu bisa tetap cepat, andal, dan selangkah lebih maju dari perlombaan senjata anti-bot. Dan kalau kamu bosan debugging selector jam 2 pagi, ingat: AI Thunderbit selalu terjaga.
Ingin terus belajar? Kunjungi Thunderbit Blog untuk pembahasan lebih dalam, atau coba Ekstensi Chrome Thunderbit untuk melihat betapa mudahnya scraping.
Scrape dengan Thunderbit Agentic Web Scraper API Web Scraper Thunderbit memungkinkan kamu memicu ekstraksi dari kode Node.js milikmu sendiri, dengan paket gratis untuk mulai. Get Started Free
FAQ
1. Mengapa Node.js sangat cocok untuk web scraping pada 2025?
Model Node.js yang asinkron dan berbasis event memungkinkan penanganan ribuan request secara bersamaan, sehingga ideal untuk scraping data dalam volume besar atau update real-time. Ekosistem npm yang sangat besar dan dukungan JavaScript native sangat cocok untuk situs modern yang banyak menggunakan JS (Node.js Docs).
2. Bagaimana cara menghindari diblokir saat scraping dengan Node.js?
Gunakan proxy yang berganti-ganti, acak header request, batasi request dengan jeda acak, dan tirukan perilaku manusia (gerakan mouse, scrolling, mengetik) dengan alat seperti Puppeteer. Selalu patuhi robots.txt dan ketentuan situs (Medium).
3. Kapan saya harus memakai Cheerio vs. Puppeteer di scraper Node.js?
Pakai Cheerio untuk parsing cepat HTML statis (saat data sudah ada di HTML mentah). Pakai Puppeteer untuk situs yang memuat konten secara dinamis dengan JavaScript. Untuk hasil terbaik, render halaman dengan Puppeteer, lalu parsing HTML-nya dengan Cheerio (Bright Data).
4. Bagaimana Thunderbit menyederhanakan web scraping Node.js?
Thunderbit memungkinkan kamu mengekstrak data terstruktur dari situs mana pun menggunakan AI dan prompt bahasa alami—tanpa perlu coding. Thunderbit menangani konten dinamis, subpage, dan pagination, serta menyediakan API untuk integrasi dengan Node.js. Data bisa diekspor langsung ke Excel, Google Sheets, Airtable, atau Notion (Thunderbit Blog).
5. Apa cara terbaik untuk menskalakan dan memantau scraper Node.js di cloud?
Dockerize scraper kamu, deploy di Kubernetes atau layanan cloud terkelola, lalu gunakan auto-scaling untuk menghadapi lonjakan permintaan. Pantau log dan metrik dengan alat seperti CloudWatch atau Prometheus, dan siapkan alert untuk error atau perlambatan (DigitalOcean).
Siap naik level di web scraping? Coba Thunderbit, dan semoga scraper kamu cepat, stealthy, dan selalu selangkah di depan.
Coba Agentic Web Scraper Get Started Free
Pelajari Lebih Lanjut
- Cara Menguasai Web Scraping Node untuk Pemula: Panduan Langkah demi Langkah
- Cara Mengambil Data Website Secara Efisien dengan Tool Terbaik
- Cara Crawl Website Secara Efisien: Panduan Langkah demi Langkah
- Cara Menguasai JavaScript Crawling: Panduan Pemula
- Cara Menguasai Web Scraping untuk Perbandingan Harga di 2026




