
האינטרנט מוצף בנתונים, ואם אתם מנהלים עסק ב־2026, אתם כבר יודעים שמי שמצליח לשלוף את הנתונים הטובים ביותר הכי מהר — בדרך כלל מנצח. בין אם אתם עובדים במכירות, במסחר אלקטרוני, בתפעול או במחקר שוק, היכולת לחלץ נתוני אתרים — בקנה מידה ובאופן מיידי — הפכה בשקט לאחת היכולות שמבדילות בין צוותים שפועלים לפי אותות לבין צוותים שפועלים לפי תחושות בטן. Python הפכה לכלי ברירת המחדל לכך — בסקר “State of Web Scraping” של Apify היא מופיעה אצל כ־69.6% מהמפתחים, הרבה לפני השפה הבאה אחריה. המשיכה נובעת בחלקה מהאקוסיסטם (Requests, Beautiful Soup, Selenium, Scrapy, Playwright, Pandas) ובחלקה מכך שהשפה כמעט נקראת כמו פסאודו־קוד, מה שמוריד את מחסום הכניסה כשמנסים להעמיד scraper עובד מול בעל עניין שאינו מהנדס.
נסו את Thunderbit: AI Web Scraper ללא קוד גרדו, נקו וארגנו נתוני אינטרנט בכמה קליקים בלבד — בלי צורך בקוד. Get Started Free
אבל הנה הטוויסט: למרות ש־Python היא אולר שווייצרי לשליפת נתונים מאתרים, היא לא השחקנית היחידה בזירה. כלים ללא קוד כמו Thunderbit הופכים את זה לאפשרי לכל אחד — כן, אפילו לחבר הצוות הכי מפוחד־מקוד שלכם — לגרד, לנקות ולארגן נתוני אינטרנט בכמה קליקים בלבד. במדריך הזה אוביל אתכם בשני העולמות: הגישה הקלאסית ב־Python (Requests, Beautiful Soup, Selenium, Scrapy, Pandas) ואיך Thunderbit משתלבת כמכפילת פרודוקטיביות. אשתף קוד פרקטי, תרחישים עסקיים, וכמה לקחים שנלמדו בדרך הקשה. בואו נצלול פנימה.
מה המשמעות של "Python pull data from website"?
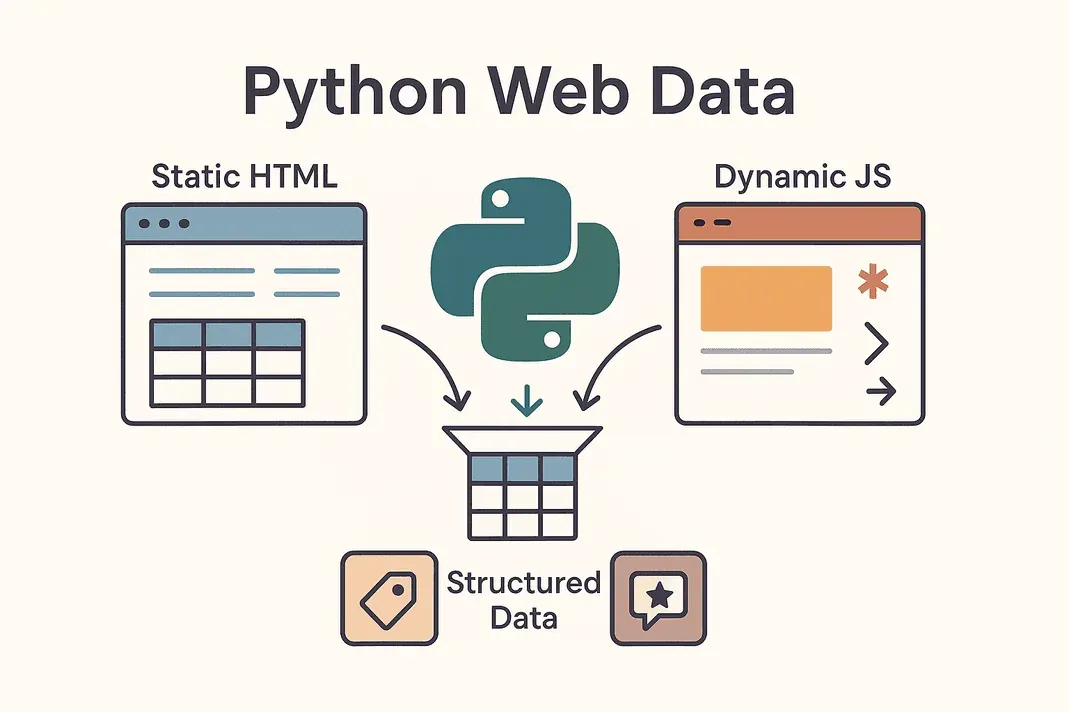 בבסיס, “python pull data from website” פירושו שימוש בסקריפטים של Python כדי לאחזר ולחלץ מידע מדפי אינטרנט באופן אוטומטי — ולהפוך HTML מבולגן לנתונים נקיים ומובנים שאפשר להשתמש בהם. זה נקרא לעיתים קרובות גריפת אתרים. במקום להעתיק ולהדביק ידנית מחירי מוצרים, פרטי קשר או ביקורות, נותנים ל־Python לעשות את העבודה הכבדה.
יש שני סוגים מרכזיים של אתרים שתיתקלו בהם:
- אתרים סטטיים: כל התוכן שלהם מגיע ב־HTML הראשוני. מה שרואים ב־“View Source” הוא מה שמקבלים. הגריפה שלהם פשוטה — פשוט שולפים את ה־HTML ומנתחים אותו.
- אתרים דינמיים: אתרים אלה טוענים נתונים באמצעות JavaScript אחרי טעינת הדף. למשל, גלילה אינסופית, עדכוני מחירים בזמן אמת, או תוכן שמופיע רק אחרי לחיצה על כפתור. גריפה של אתרים כאלה דורשת קצת יותר כוח — או סימולציה של דפדפן בעזרת כלים כמו Selenium, או מציאת ה־API המוסתרים שמניעים את האתר (infatica.io).
יעדים נפוצים לגריפת אתרים כוללים טבלאות של מידע על מוצרים, רשימות לידים, מחירים, ביקורות, תמונות ועוד. בין אם אתם בונים רשימת לידים, עוקבים אחרי מחירי מתחרים או אוספים סנטימנט שוק, Python יכולה לעזור לכם להפוך את האינטרנט לאגם נתונים אישי משלכם.
למה עסקים משתמשים ב־Python כדי לשלוף נתונים מאתרים
בואו נהיה פרקטיים. למה כל כך הרבה עסקים אובססיביים לחילוץ נתונים מהאינטרנט? הנה כמה ממקרי השימוש המובילים — והערך העסקי שהם פותחים:
| מקרה שימוש עסקי | הנתונים שנשלפו | החזר השקעה / תועלת |
|---|---|---|
| יצירת לידים (מכירות) | פרטי קשר ממדריכים, רשתות חברתיות | יותר מ־3,000 לידים בחודש, כ־8 שעות בשבוע נחסכות לכל נציג (Thunderbit)) |
| מעקב מחירים (מסחר אלקטרוני) | מחירי מוצרים, רמות מלאי | עלייה של כ־4% במכירות, 30% פחות זמן אנליסט (blog.apify.com) |
| מחקר שוק | ביקורות, פוסטים ברשתות חברתיות, תגובות בפורומים | שיפור המיקוד; 26% מה־scrapers מכוונים לנתונים חברתיים (Thunderbit) |
| רישומי נדל"ן | נתוני נכסים, השוואות, סטטיסטיקות מיקום | גילוי עסקאות מהיר יותר, השוואות עדכניות |
| אוטומציה תפעולית | מלאי, דוחות, נתונים שחוזרים על עצמם | חיסכון של 10–50% בזמן במשימות ידניות |
השורה התחתונה: חילוץ נתונים מהאינטרנט עם Python (או Thunderbit) עוזר לצוותים לפעול מהר יותר, לקבל החלטות חכמות יותר, ולאוטומט את העבודה השחורה שבעבר גזלה שעות בכל שבוע. לא פלא ששוק תוכנות ה־web scraper הגיע לכ־1.01 מיליארד דולר ב־2024, ולפי אותו דוח “State of Web Scraping” של Apify, צפוי להכפיל את עצמו לכ־2.49 מיליארד דולר עד 2032.
כלי Python חיוניים לחילוץ נתונים מאתרים
הפופולריות של Python בגריפת אתרים נובעת מהאקוסיסטם שלה. הנה סקירה קצרה של הכלים הנפוצים ביותר — ומתי להשתמש בכל אחד מהם:
| כלי | הכי מתאים ל | יתרונות | חסרונות |
|---|---|---|---|
| Requests | שליפת HTML סטטי או APIs | פשוט, מהיר, מצוין למתחילים | לא יודע להתמודד עם JavaScript |
| Beautiful Soup | ניתוח HTML/XML לנתונים מובנים | קל לשימוש, גמיש | צריך את ה־HTML ביד, לא מתאים לאתרי JS |
| Selenium | אתרים דינמיים/כבדי JS, לוגינים, קליקים | מטפל בכל מה שדפדפן יכול | איטי יותר, דורש יותר הכנה, כבד יותר |
| Scrapy | גריפות בקנה מידה גדול, ריבוי דפים | מהיר, אסינכרוני, חזק, ניתן להרחבה | עקומת למידה תלולה יותר, אין תמיכת JS כברירת מחדל |
| Thunderbit | ללא קוד/עם מעט קוד, משתמשים עסקיים | מבוסס AI, מטפל ב־JS, ייצוא קל | פחות ניתן להתאמה ללוגיקה עמוקה |
רוב הפרויקטים בעולם האמיתי משתמשים בשילוב: Requests + Beautiful Soup למשימות פשוטות, Selenium לאתרים דינמיים מאתגרים, Scrapy לגריפות גדולות, ו־Thunderbit כשחשובה לכם מהירות ופשטות.
שלב 1: שימוש ב־Python Requests כדי לשלוף נתוני אתר
נתחיל מהבסיס. Requests היא סוס העבודה לשליפת דפי אינטרנט ב־Python. כך משתמשים בה:
-
התקנת Requests:
pip install requests -
שליפת דף:
import requests url = "https://example.com/products" response = requests.get(url) if response.status_code == 200: html_content = response.text else: print(f"Failed to retrieve data: {response.status_code}") -
טיפים לפתרון בעיות:
- הוסיפו headers כדי לדמות דפדפן:
headers = {"User-Agent": "Mozilla/5.0"} response = requests.get(url, headers=headers) - טפלו בשגיאות עם
response.raise_for_status() - עבור APIs שמחזירים JSON:
data = response.json()
- הוסיפו headers כדי לדמות דפדפן:
Requests מושלמת לדפים סטטיים או ל־APIs. אבל אם שלפתם דף והנתונים לא מופיעים, כנראה שהם נטענים ב־JavaScript — ואז הגיע הזמן להכניס את Selenium לפעולה.
שלב 2: ניתוח תוכן אינטרנט עם Beautiful Soup
ברגע שיש לכם את ה־HTML, Beautiful Soup עוזרת לכם לחלץ את הדברים החשובים. כך עושים זאת:
-
התקנת Beautiful Soup:
pip install beautifulsoup4 -
ניתוח HTML:
from bs4 import BeautifulSoup soup = BeautifulSoup(html_content, 'html.parser') -
חילוץ נתונים:
- מציאת כל כרטיסי המוצר:
for product in soup.select('div.product-card'): name = product.select_one('.product-name').text.strip() price = product.select_one('.product-price').text.strip() print(name, price) - עבור טבלאות:
for row in soup.find_all('tr'):
    cells = row.find_all('td')
    # חלצו נתוני תאים לפי הצורך
- מציאת כל כרטיסי המוצר:
טיפים:
- השתמשו בכלי המפתחים של הדפדפן כדי לבדוק את ה־HTML ולמצוא את הסלקטורים הנכונים.
- השתמשו ב־
.get_text()או ב־.textכדי לחלץ טקסט. - טפלו בנתונים חסרים עם בדיקות (
if price_elem else "N/A").
Requests + Beautiful Soup הם החומוס־עם־פיתה של גריפת אתרים — פשוטים, אמינים, ומתאימים לרוב האתרים הסטטיים.
שלב 3: טיפול בתוכן דינמי עם Selenium
כשאתר טוען נתונים דרך JavaScript, צריך כלי שמתנהג כמו משתמש אמיתי. כאן נכנסת Selenium.
-
התקנת Selenium:
pip install seleniumב־Selenium 4.6 ומעלה, Selenium Manager המובנה מוריד אוטומטית את ה־driver המתאים בפעם הראשונה ש־
webdriver.Chrome()רץ, כך שבדרך כלל כבר אין צורך בהתקנה ידנית של ChromeDriver ב־PATH. (אם אתם נעולים על Selenium ישן יותר, עדיין תצטרכו להוריד את ChromeDriver בעצמכם ולהוסיף אותו ל־PATH.) -
אוטומציה של הדפדפן:
from selenium import webdriver driver = webdriver.Chrome() driver.get("https://example.com/products") products = driver.find_elements_by_class_name("product-card") for prod in products: print(prod.text) driver.quit() -
טיפול בלוגינים וקליקים:
driver.get("https://site.com/login") driver.find_element_by_name("username").send_keys("myuser") driver.find_element_by_name("password").send_keys("mypassword") driver.find_element_by_id("login-button").click() -
המתנה לתוכן דינמי:
from selenium.webdriver.common.by import By from selenium.webdriver.support.ui import WebDriverWait from selenium.webdriver.support import expected_conditions as EC WebDriverWait(driver, 10).until(EC.presence_of_element_located((By.CLASS_NAME, "data-row"))) -
מצב headless (ללא חלון):
options = webdriver.ChromeOptions()
options.add_argument("--headless")
driver = webdriver.Chrome(options=options)
Selenium היא כלי חזק אבל כבד יותר — הכי מתאים לאתרים שחייבים אוטומציית דפדפן.
שלב 4: הרחבה עם Scrapy לשליפת נתונים בקנה מידה גדול
כשצריך לזחול על מאות או אלפי דפים, Scrapy היא החברה שלכם.
-
התקנת Scrapy:
pip install scrapy scrapy startproject myproject -
יצירת spider:
import scrapy class ProductsSpider(scrapy.Spider): name = "products" start_urls = ["https://example.com/category?page=1"] def parse(self, response): for product in response.css("div.product-card"): yield { 'name': product.css(".product-title::text").get().strip(), 'price': product.css(".price::text").get().strip(), } next_page = response.css("a.next-page::attr(href)").get() if next_page: yield response.follow(next_page, self.parse) -
הרצת ה־spider:
scrapy crawl products -o products.csv
Scrapy היא אסינכרונית, מהירה, ובנויה להיקפים גדולים. היא אידיאלית לזחילה על אתרים שלמים או לטיפול בפאג'ינציה מורכבת.
נסו את Thunderbit AI Web Scraper בחינם
שלב 5: חיזוק חילוץ הנתונים עם Thunderbit
עכשיו, בואו נדבר על Thunderbit — AI web scraper ללא קוד שמשנה את כללי המשחק למשתמשים עסקיים.
- הצעת שדות בעזרת AI: Thunderbit קוראת את הדף ומציעה את העמודות הטובות ביותר לחילוץ — בלי לחפור ב־HTML.
- טיפול בדפים דינמיים: היא רואה את הדף בדיוק כפי שאתם רואים אותו, כך ש־JavaScript, גלילה אינסופית ולוגינים כולם אפשריים.
- גריפת תתי־דפים: Thunderbit יכולה להיכנס לדף הפרטים של כל פריט ולהעשיר את מערך הנתונים שלכם אוטומטית.
- תבניות מוכנות מראש: עבור אתרים פופולריים כמו Amazon, Zillow או Shopify, אפשר להשתמש בתבניות מיידיות — בלי הגדרה.
- מחוללי חילוץ בלחיצה אחת: צריכים את כל כתובות האימייל או מספרי הטלפון בדף? Thunderbit עושה את זה בלחיצה אחת.
- תזמון וגריפה בענן: הגדירו גריפות חוזרות בשפה טבעית (“כל יום שני ב־9 בבוקר”) ותנו לענן של Thunderbit לטפל בעד 50 דפים בו־זמנית.
- ייצוא לכל מקום: שלחו את הנתונים מיידית ל־Excel, Google Sheets, Airtable, Notion, או הורידו כ־CSV/JSON — בחינם וללא הגבלה.
הורידו את תוסף Chrome של Thunderbit התחילו לגרד נתונים מכל אתר בתוך שניות — בלי צורך בקוד. Get Started Free
Thunderbit מושלמת לצוותים שרוצים נתונים מהר, בלי שום קידוד. אפשר אפילו להשתמש ב־Thunderbit כדי לשלוף נתונים, ואז לנתח אותם ב־Python — הכי טוב משני העולמות.
שלב 6: ניקוי וניתוח נתונים שנשלפו עם Pandas
ברגע שיש לכם את הנתונים שלכם (מ־Python או מ־Thunderbit), הגיע הזמן לנקות ולנתח אותם עם Pandas.
-
טעינת הנתונים:
import pandas as pd df = pd.read_csv("products.csv") print(df.head()) -
ניקוי הנתונים:
- הסרת כפילויות:
df = df.drop_duplicates() - טיפול בערכים חסרים:
df = df.fillna("N/A") - סטנדרטיזציה של פורמטים (למשל מחירים):
df['price'] = df['price'].str.replace('$','').str.replace(',','').astype(float)
- הסרת כפילויות:
-
ניתוח:
- קבלת סטטיסטיקות:
print(df.describe()) - קיבוץ לפי קטגוריה:
avg_price = df.groupby('category')['price'].mean()
print(avg_price)
- קבלת סטטיסטיקות:
Pandas היא אולר השווייצרי שלכם להפיכת נתוני אינטרנט מבולגנים לתובנות עסקיות.
שלב 7: ארגון ואחסון נתונים שנשלפו לשימוש עסקי
יש לכם נתונים נקיים — עכשיו בואו נהפוך אותם לשימושיים עבור הצוות.
- CSV/Excel: השתמשו ב־
df.to_csv("out.csv", index=False)או ב־df.to_excel("out.xlsx")לשיתוף קל. - Google Sheets: השתמשו בייצוא של Thunderbit או בספריית
gspreadשל Python. - מסדי נתונים: עבור מערכי נתונים גדולים יותר, השתמשו ב־
df.to_sql()כדי לשמור במסדי נתונים מסוג SQL. - אוטומציה: הגדירו סקריפטים או לוחות זמנים ב־Thunderbit כדי לשמור על נתונים עדכניים.
- שיטות עבודה מומלצות: תמיד הוסיפו חותמת זמן לנתונים, תעדו עמודות, ושלטו בגישה אם המידע רגיש.
המפתח הוא להתאים את האחסון לאופן שבו הצוות עובד — גיליונות אלקטרוניים לניצחונות מהירים, מסדי נתונים להיקף גדול.
Thunderbit מול קוד ב־Python: איזו גישה מתאימה לצוות שלכם?
בואו נפרק את זה:
| גורם | Thunderbit (AI ללא קוד) | ספריות Python (קוד) |
|---|---|---|
| מערך מיומנויות נדרש | אין (ממשק מבוסס דפדפן) | נדרש תכנות ב־Python |
| זמן הקמה | דקות (הצעות AI, גריפה מיידית) | שעות–ימים (קוד, דיבוג, הגדרה) |
| טיפול ב־JS/אינטראקטיביות | כן, מובנה (מצבי דפדפן/ענן) | כן, אבל צריך Selenium/Playwright |
| תחזוקה | נמוכה — AI מסתגל לשינויים רבים באתר | ידנית — עדכון קוד כשהאתר משתנה |
| סקייל | בינוני (מהיר לעשרות–מאות דפים דרך הענן) | גבוה (Scrapy יכול להתרחב לאלפים+) |
| התאמה אישית | דרך אפשרויות UI ופרומפטים ל־AI | בלתי מוגבלת (כל לוגיקה, כל אינטגרציה) |
| אנטי־בוט/פרוקסי | מטופל פנימית | צריך לממש ידנית |
| ייצוא נתונים | בלחיצה אחת ל־Sheets, Excel, Notion, Airtable | נדרש קוד מותאם אישית |
| הכי מתאים ל־ | משתמשים לא טכניים, תוצאות מהירות, תחזוקה מינימלית | מפתחים, פרויקטים מורכבים/גדולים |
טיפ מקצועי: השתמשו ב־Thunderbit לניצחונות מהירים ולהעצים את צוות העסק. השתמשו ב־Python כשאתם צריכים התאמה עמוקה או סקייל עצום. הרבה צוותים משתמשים בשניהם — Thunderbit לאימות ולקבלת נתונים מהר, Python לאוטומציה או להתרחבות בהמשך.
יישומי עסקיים בעולם האמיתי לחילוץ נתוני אתרים
 בואו נראה איך צוותים משתמשים בכלים האלה בפועל:
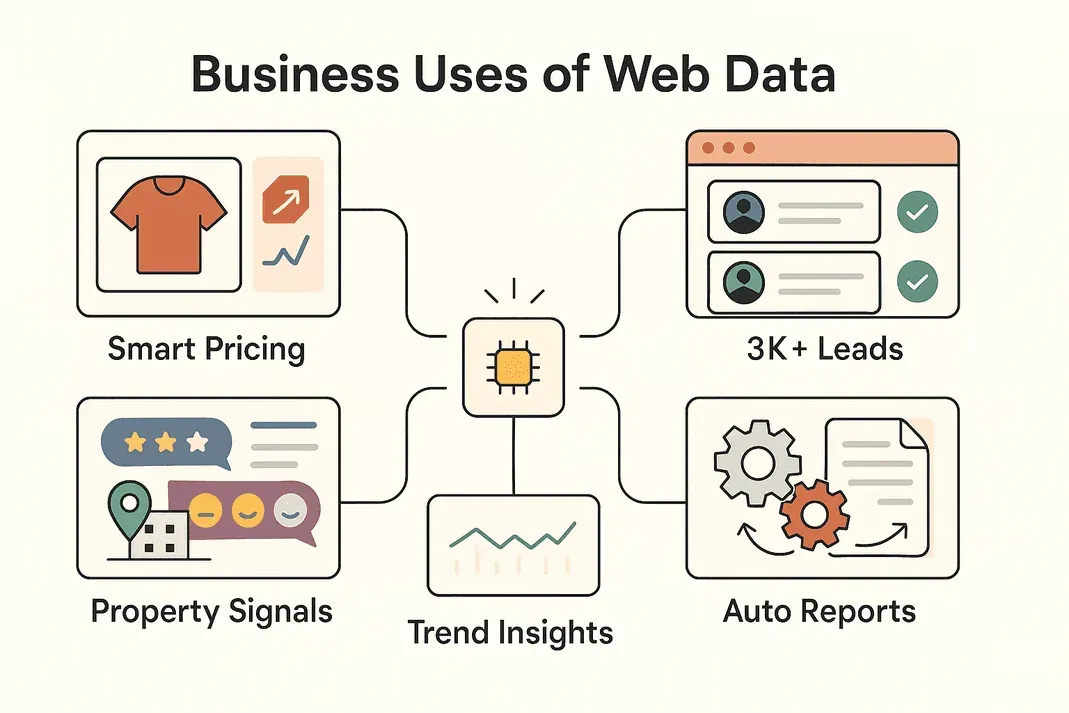
- מסחר אלקטרוני: John Lewis הגדילה את המכירות ב־4% באמצעות גריפת מחירי מתחרים והתאמת המחירים שלה בזמן אמת.
- מכירות: צוותים גורפים יותר מ־3,000 לידים בחודש, וחוסכים 8 שעות בשבוע לכל נציג (Thunderbit)) — בלי מחקר ידני יותר.
- מחקר שוק: משווקים שולפים אלפי ביקורות או פוסטים מהרשתות החברתיות לניתוח סנטימנט, ומזהים מגמות לפני שהדשבורדים מתעדכנים.
- נדל"ן: סוכנים גורפים רישומים כדי לזהות נכסים במחיר נמוך מהשוק או הזדמנויות חדשות — מהר יותר מאשר לחכות לעדכוני MLS.
- אוטומציית תהליכים: צוותי תפעול מאוטומטים בדיקות מלאי, יצירת דוחות, או אפילו שאלות נפוצות לתמיכה באמצעות גריפה של אתרי שותפים או אתרים פנימיים.
לעיתים קרובות, הזרימה היא היברידית: Thunderbit כדי לאסוף את הנתונים, Python כדי לנקות ולנתח, ואז ייצוא ל־Sheets או למסד נתונים עבור הצוות.
סיכום ולקחים עיקריים
שליפת נתונים מאתרים עם Python (ו־Thunderbit) היא עדיין אחת המיומנויות הכי ממונפות שצוות שאינו טהור־הנדסי יכול לאמץ ב־2026 — גם עכשיו, כשסוכני קידוד מבוססי AI יכולים לנסח את הסקריפט בשבילכם, מישהו עדיין צריך לקרוא את הפלט, להעריך האם מבנה האתר השתנה, ולהחליט מה עושים כשסלקטור נשבר ב־2 בלילה. הנה דף העזר:
- Requests + Beautiful Soup: מצוין לאתרים סטטיים, מהיר ופשוט.
- Selenium: לאתרים דינמיים, כבדי JS, או כאלה שדורשים התחברות.
- Scrapy: לגריפות בקנה מידה גדול וריבוי דפים.
- Thunderbit: לגריפה ללא קוד, מבוססת AI — מהירה, קלה, ואידיאלית למשתמשים עסקיים.
- Pandas: לניקוי, ניתוח והבנת הנתונים שלכם.
- ייצאו בחכמה: השתמשו ב־CSV, Sheets, או במסדי נתונים — מה שמתאים לזרימת העבודה שלכם.
הגישה הטובה ביותר? התחילו בכלי שמתאים לנוחות הטכנית ולצרכים העסקיים שלכם. שלבו בין כלים ככל שאתם גדלים. ואם אתם רוצים לראות כמה קל יכולה להיות גריפת אתרים, נסו את תוסף Chrome החינמי של Thunderbit או בדקו את בלוג Thunderbit למדריכים נוספים.
גריפה מהנה — ושכל הנתונים שלכם יהיו תמיד נקיים, מובנים ומוכנים לפעולה.
נסו את Thunderbit AI Web Scraper בחינם Get Started Free
שאלות נפוצות
1. מה הדרך הכי קלה לשלוף נתונים מאתר באמצעות Python?
באתרים סטטיים, השתמשו בספריית Requests כדי להביא את ה־HTML וב־Beautiful Soup כדי לנתח ולחלץ את הנתונים שאתם צריכים. באתרים דינמיים, כנראה שתצטרכו Selenium.
2. מתי כדאי לי להשתמש ב־Thunderbit במקום בקוד Python?
Thunderbit אידיאלית כשצריך נתונים מהר, לא רוצים לקודד, או כשצריך לטפל בדפים דינמיים, תתי־דפים, או ייצוא מיידי ל־Sheets/Excel. היא מושלמת למשתמשים עסקיים או לפרויקטים עם זמן אספקה קצר.
3. איך מטפלים באתרים שטוענים נתונים עם JavaScript?
השתמשו ב־Selenium (או Playwright) כדי לאוטומט דפדפן, או נסו את מצב הדפדפן/ענן של Thunderbit, שמטפל ב־JS אוטומטית.
4. מה הדרך הטובה ביותר לנקות ולנתח נתונים שנגרפו?
ייבאו את הנתונים ל־Pandas, הסירו כפילויות, טפלו בערכים חסרים, תקננו פורמטים, והשתמשו ב־groupby או ב־describe לקבלת תובנות מהירות.
5. האם גריפת אתרים חוקית ובטוחה לשימוש עסקי?
באופן כללי, גריפה של נתונים ציבוריים היא חוקית, אבל תמיד בדקו את תנאי השימוש של האתר ואת robots.txt. הימנעו מגריפת מידע אישי ללא הסכמה, והיו מכבדים למשאבי האתר. גם Thunderbit וגם Python תומכות בפרקטיקות גריפה אתיות.
מוכנים לשדרג את משחק הנתונים שלכם? הורידו את Thunderbit או תפשילו שרוולים עם Python — כך או כך, תתחילו לשלוף נתוני אינטרנט בעלי ערך תוך זמן קצר.
למדו עוד




