
כמעט כל סיכום של "הסקרייפרים בקוד פתוח הטובים ביותר" סובל מפגם שקט אחד: אף אחד לא מריץ את הכלים על אותם עמודים. Scrapy נבחן על כתבת חדשות, Playwright על דמו של מסחר אלקטרוני, Colly על מה שהמחבר מצא במקרה, ואז כולם מדורגים זה מול זה כאילו המספרים האלה בכלל מדברים באותה שפה. הדירוג הזה מספר לכם על העמודים — לא על הכלים.
אז עשיתי את הדבר המשעמם והברור שהרשימות מדלגות עליו. בניתי סט אחד של fixtures והעברתי דרכו את כל תשעת הכלים: קטלוג סטטי, קטלוג שמרונדר ב‑JavaScript, כתבה שמוסתרת בתוך רעש של ניווט ופוטר, שגיאת HTTP 500 מכוונת, גרף קטן של קישורים פנימיים, ועוד שני אתרי תרגול ציבוריים. אותה אמת קרקעית, אותם מדדים, כל ריצה מחדש. הסקריפטים והפלט הגולמי נמצאים ב-מאגר benchmark ציבורי אחד, כך שתוכלו להריץ הכול בעצמכם. מה שעלה מהבדיקה הוא לא טבלת מובילים מסודרת כמו שהסיכומים מבטיחים — אין מנצח יחיד. יש שלוש משימות שונות, ותשעת הכלים מסתדרים לתוכן כמעט מעצמם.
נסו את Thunderbit לחילוץ נתוני רשת
איך ה‑bench עבד, והגבול היחיד שאני אומר בקול רם
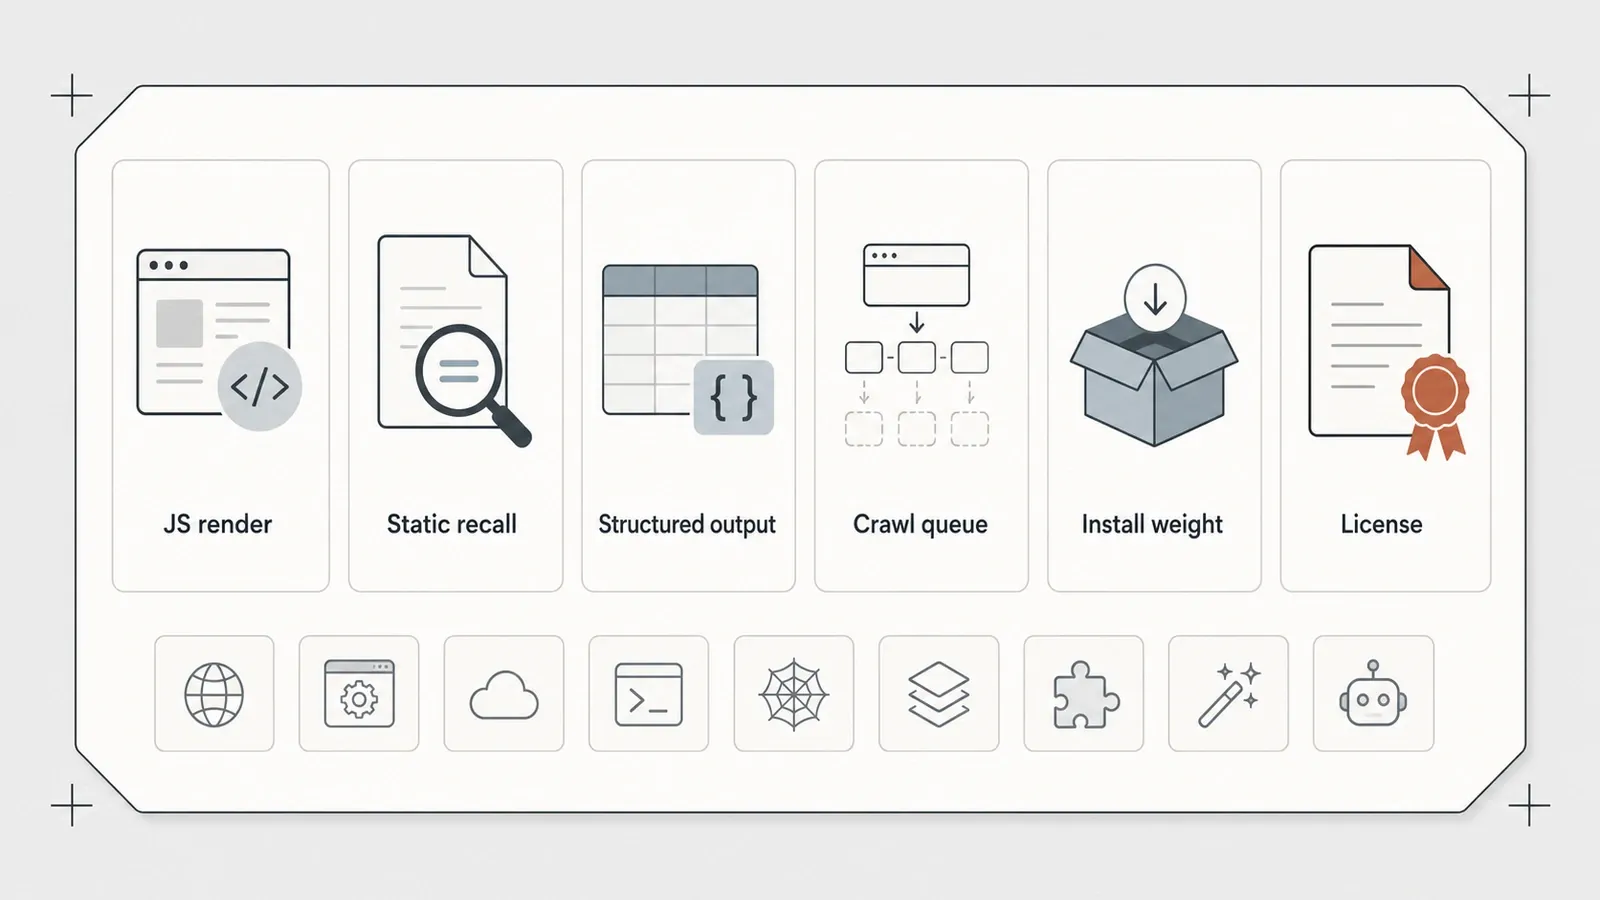
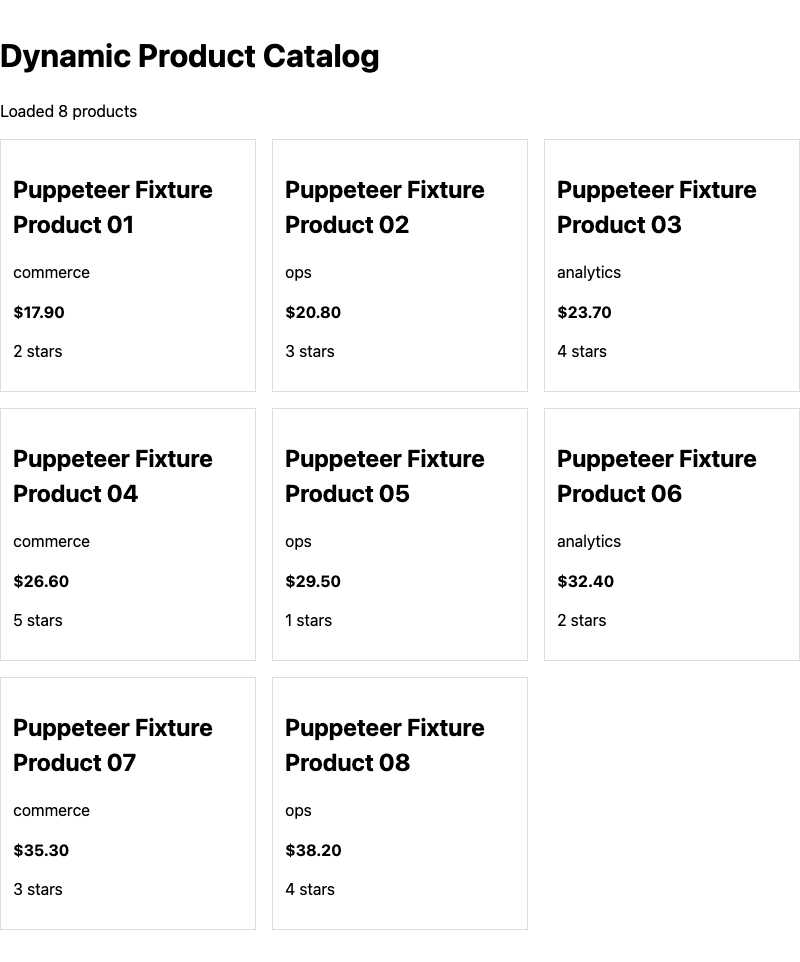
כל כלי פגש בדיוק את אותן תבניות בדיקה: 12 מוצרים סטטיים הפרוסים על פני שני עמודים, 8 מוצרים שמוזרקים ב‑JavaScript אחרי השהיה, כתבה עטופה ב‑nav/footer מסורבל סביב שלושה פסקאות אמיתיות, שרת 500 מכוון, וגרף של קישורים פנימיים. זו הסיבה שהתוצאות מסתדרות — "8/8 מוצרים דינמיים" אומר בדיוק אותו דבר, בין אם Puppeteer או Crawlee יצרו אותו.
הנה הגבול שרוב הסיכומים מדלגים עליו. כל חבילת בדיקה של כלי משקפת את אותן fixtures בגרסה שלה, ולכן ספירות תווים מוחלטות אינן ניתנות להשוואה ישירה בין כלים — צריך לקרוא אותן כאותות בתוך הכלי עצמו, לא כציון חוצה־כלים. המספרים שכן אפשר להשוות הם recall (התייחסו אליו כשיעור), הצלחה/כישלון ב‑JavaScript, והתנהגות מבנית. עוד הערת היקף באותו רוח: הריצה של Crawl4AI על הקטלוג הסטטי כיסתה רק את עמוד 1, כך שה‑6/6 שלו הוא recall מלא על חתך מצומצם יותר, בעוד הכלים האחרים סרקו את שני העמודים לקבלת 12/12 — היקף קטן יותר, לא פספוס חלקי. כל ההיגיון, fixture אחרי fixture, מופיע ב-מסמך המתודולוגיה.
עוד הסתייגות אחת לפני המספרים. כל חבילה כוללת גם ציון מחקר זמני, אבל בכוונה אינני מציג אותם כטבלה מדורגת. הם שימשו כלי בדיקה פנימי של כל כלי מול הראיות שלו, לא טבלת ליגה — והפיכתם לכזו הייתה משחזרת בדיוק את בעיית הדיוק-לכאורה השגוי שכל המהלך הזה נועד להימנע ממנה. זהו סיכום של מה שה‑bench הראה, לא לוח תוצאות.
כל התחום, על ספסל אחד
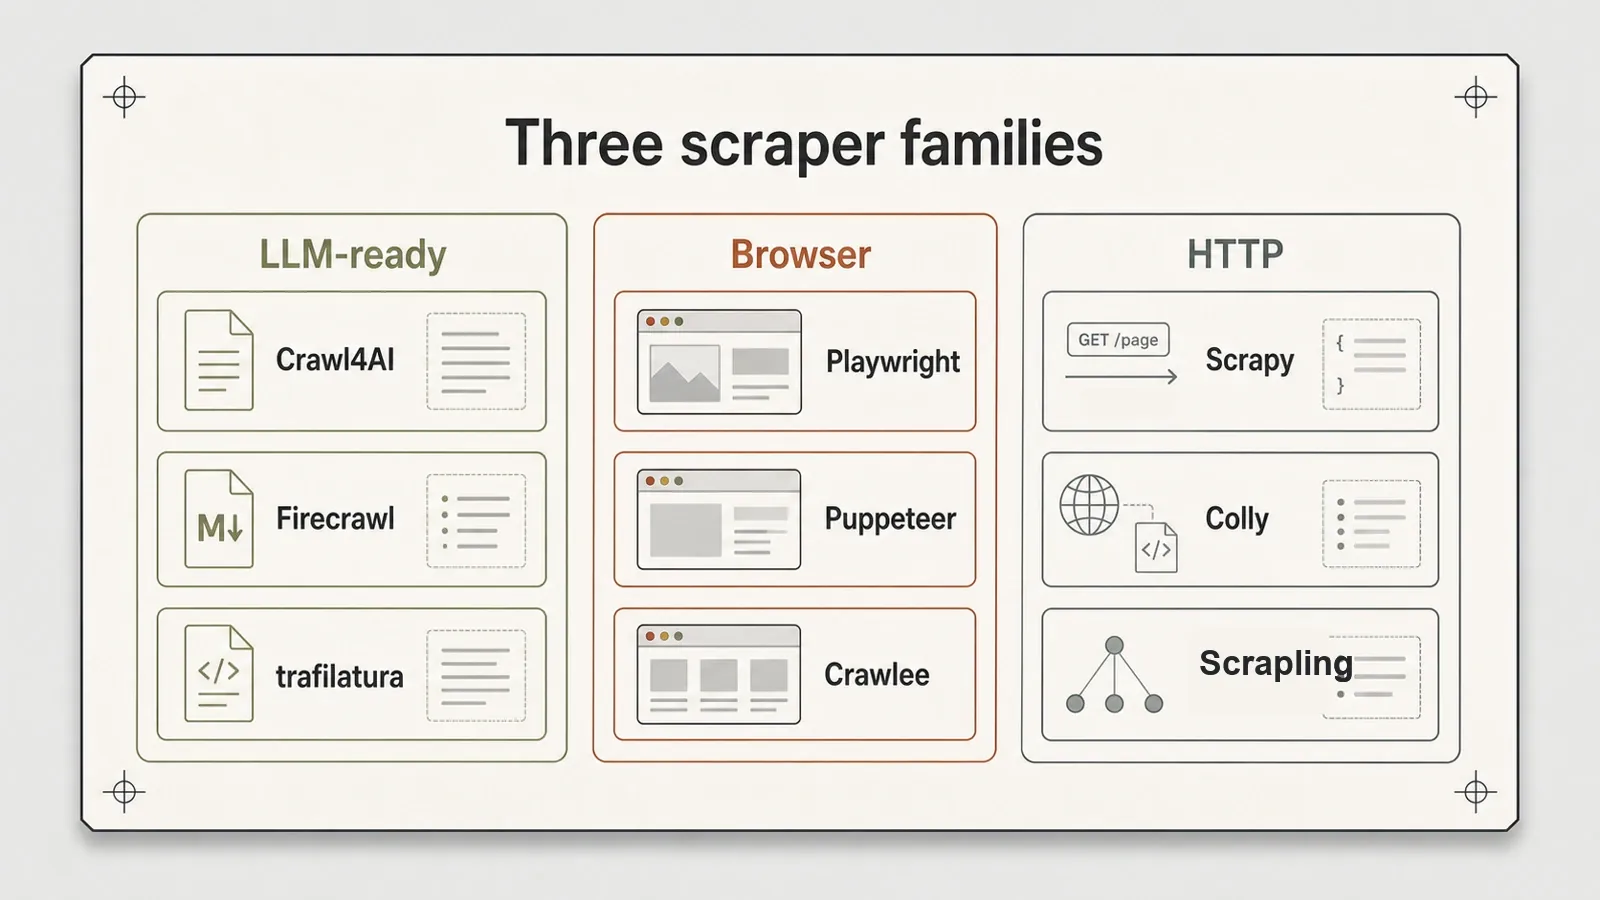
אם קוראים לאורך שתי עמודות בטבלה הזו — "Renders JS?" ו‑"Built-in crawl queue" — שלוש המשימות כמעט מצהירות על עצמן.
| Tool | Language | Renders JS? | Static recall | Structured output | Built-in crawl queue | Setup weight | License |
|---|---|---|---|---|---|---|---|
| Crawl4AI | Python | Yes (browser) | 6/6 (page 1) | CSS schema | BFS/DFS built-in | Heavy (2 browser stacks) | Apache-2.0 |
| Firecrawl | Self-hosted | Yes (playwright-service) | Full Markdown | Yes | /v1/crawl | Heaviest (6 containers) | AGPL-3.0 |
| trafilatura | Python | No | 3/3 article | No (text only) | No | Light | Apache-2.0 |
| Crawlee | Node/TS | Engine-optional | 12/12 | Via extraction | Yes (RequestQueue) | Medium (+~80 MiB) | Apache-2.0 |
| Playwright | Node/multi | Yes | 12/12 | Manual | No (hand-written BFS) | Medium (browser) | Apache-2.0 |
| Puppeteer | Node | Yes (Chrome) | 12/12 | Manual | No (hand-written BFS) | Medium (Chrome) | Apache-2.0 |
| Scrapy | Python | No | 12/12 | Feed export (JSON/CSV/XML) | Yes (built-in) | Medium (Twisted deps) | BSD-3 |
| Colly | Go | No | 12/12 | Via callbacks | Depth control | Light (1 binary + Go) | Apache-2.0 |
| Scrapling | Python | No (HTTP fetcher) | 12/12 | Yes | No | Medium ([fetchers]) | BSD-3 |
הערה על המטא־דאטה בטבלה הזו ובכל מה שמופיע בהמשך: ספירות כוכבים ומספרי גרסאות נלכדו בתחילת יולי 2026, ושניהם משתנים מהר. כדאי לרענן אותם מול GitHub ודף החבילה של כל פרויקט לפני שמתייחסים אליהם כאל עדכניים.
אינדקס הביקורות לכל כלי
לכל פרויקט בסקירה הזו יש ביקורת עומק תואמת:
- סקירת Crawl4AI
- סקירת Firecrawl
- סקירת trafilatura
- השוואת Playwright מול Puppeteer
- סקירת Crawlee
- סקירת Scrapy
- סקירת Colly
- סקירת Scrapling
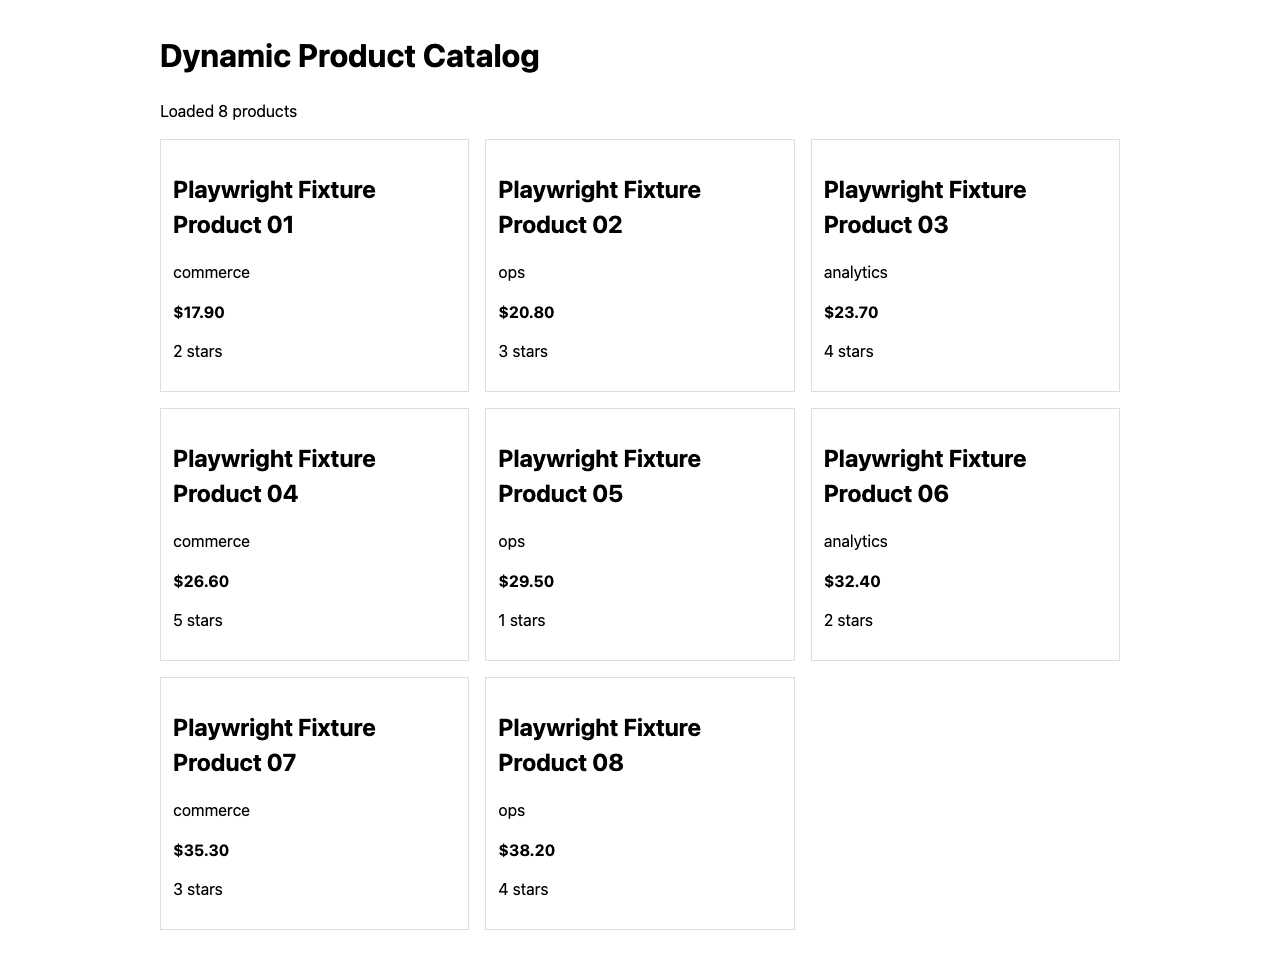
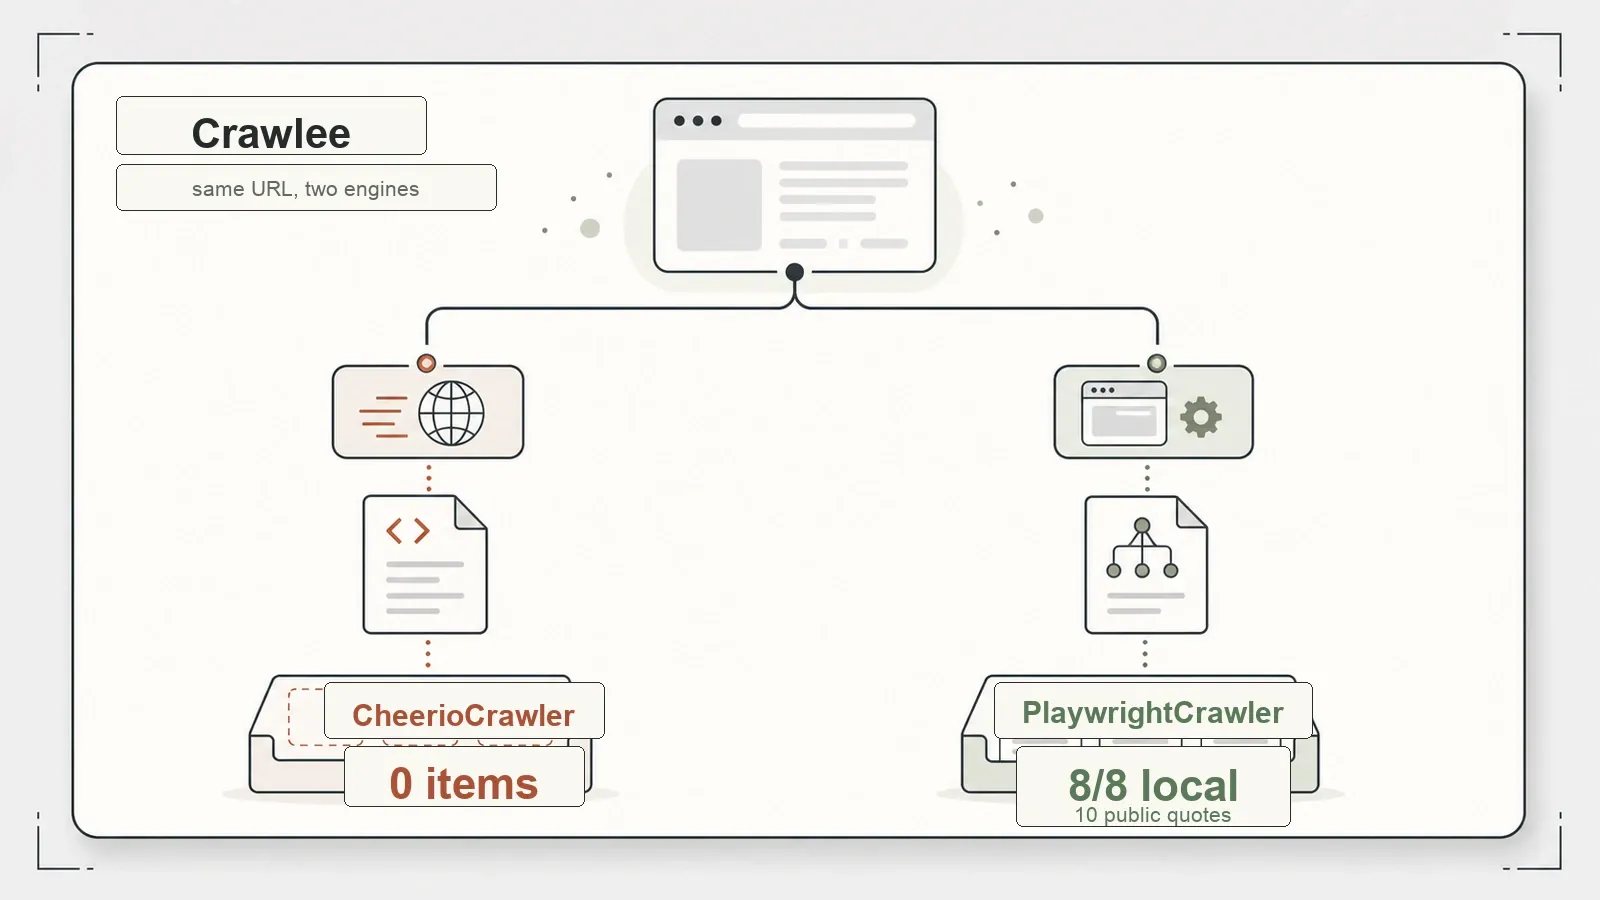
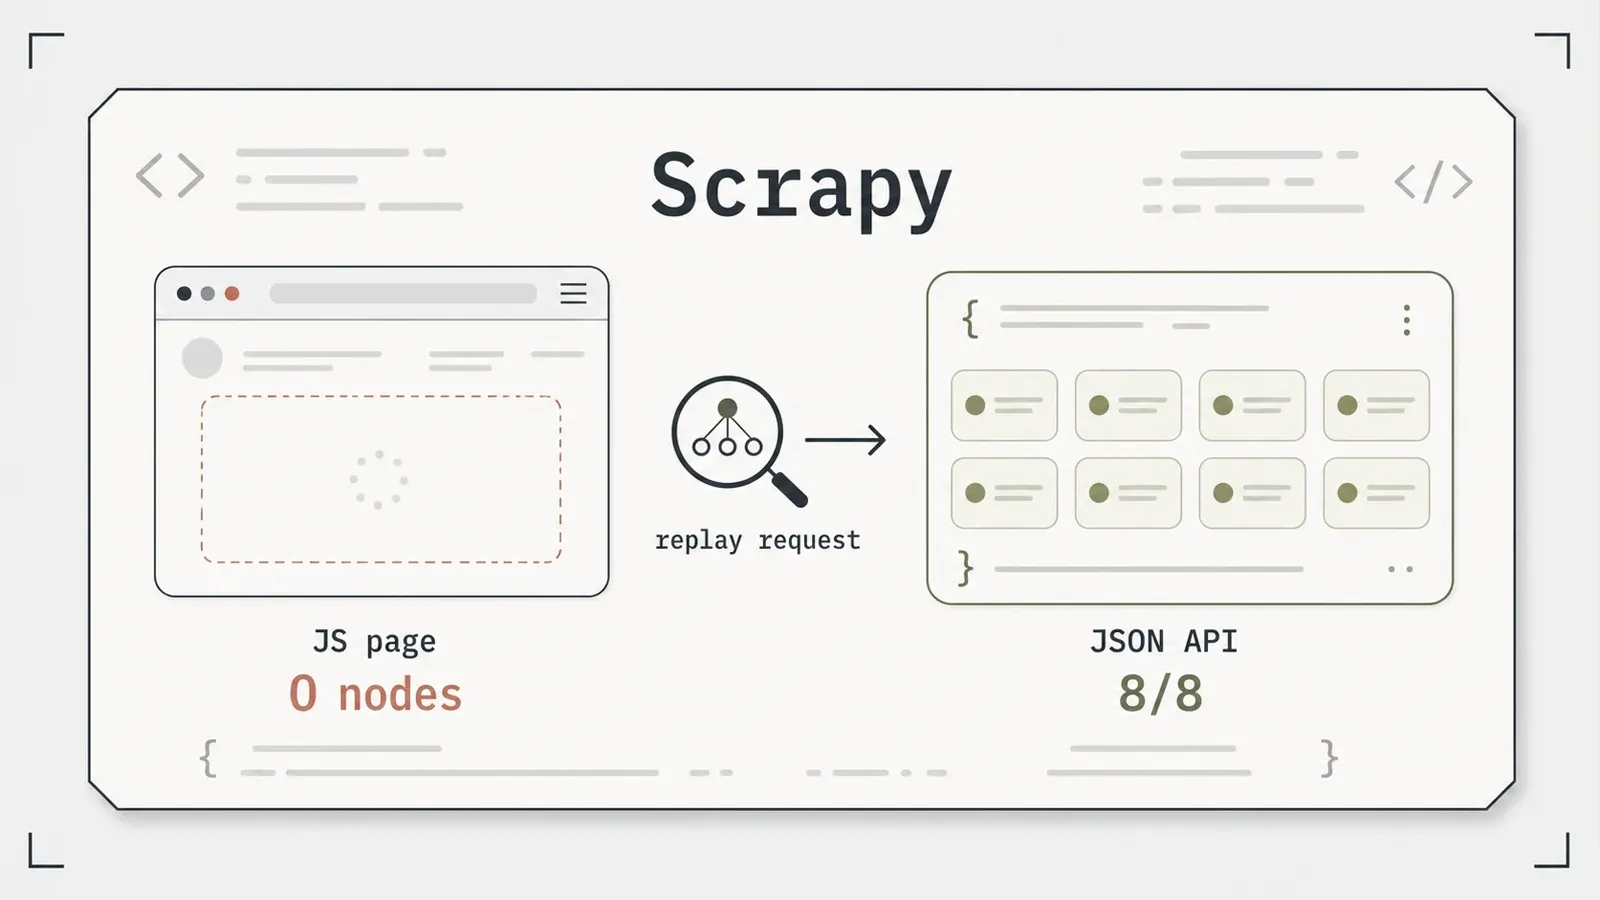
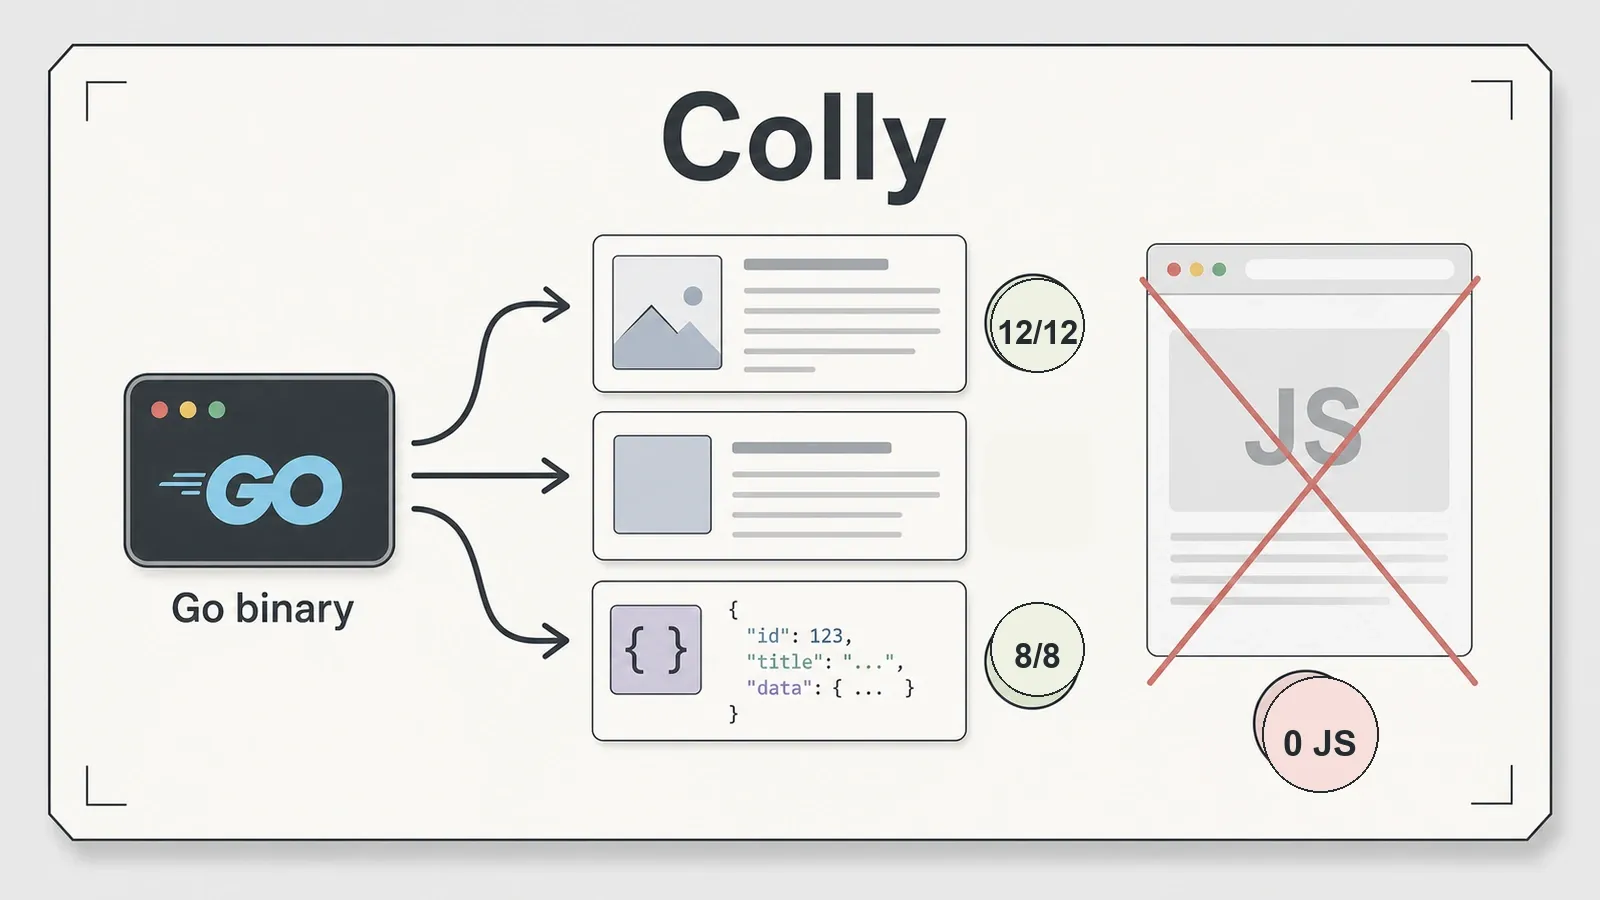
הנה הכיסויים שלהם — ועוד שתי תמונות מסך אמיתיות מבדיקת הרנדור של JavaScript, כדי שטענת ה‑"8/8 דינמי" לא תהיה רק מספר על דף.
משימה ראשונה: להפוך עמוד לטקסט מוכן ל‑LLM
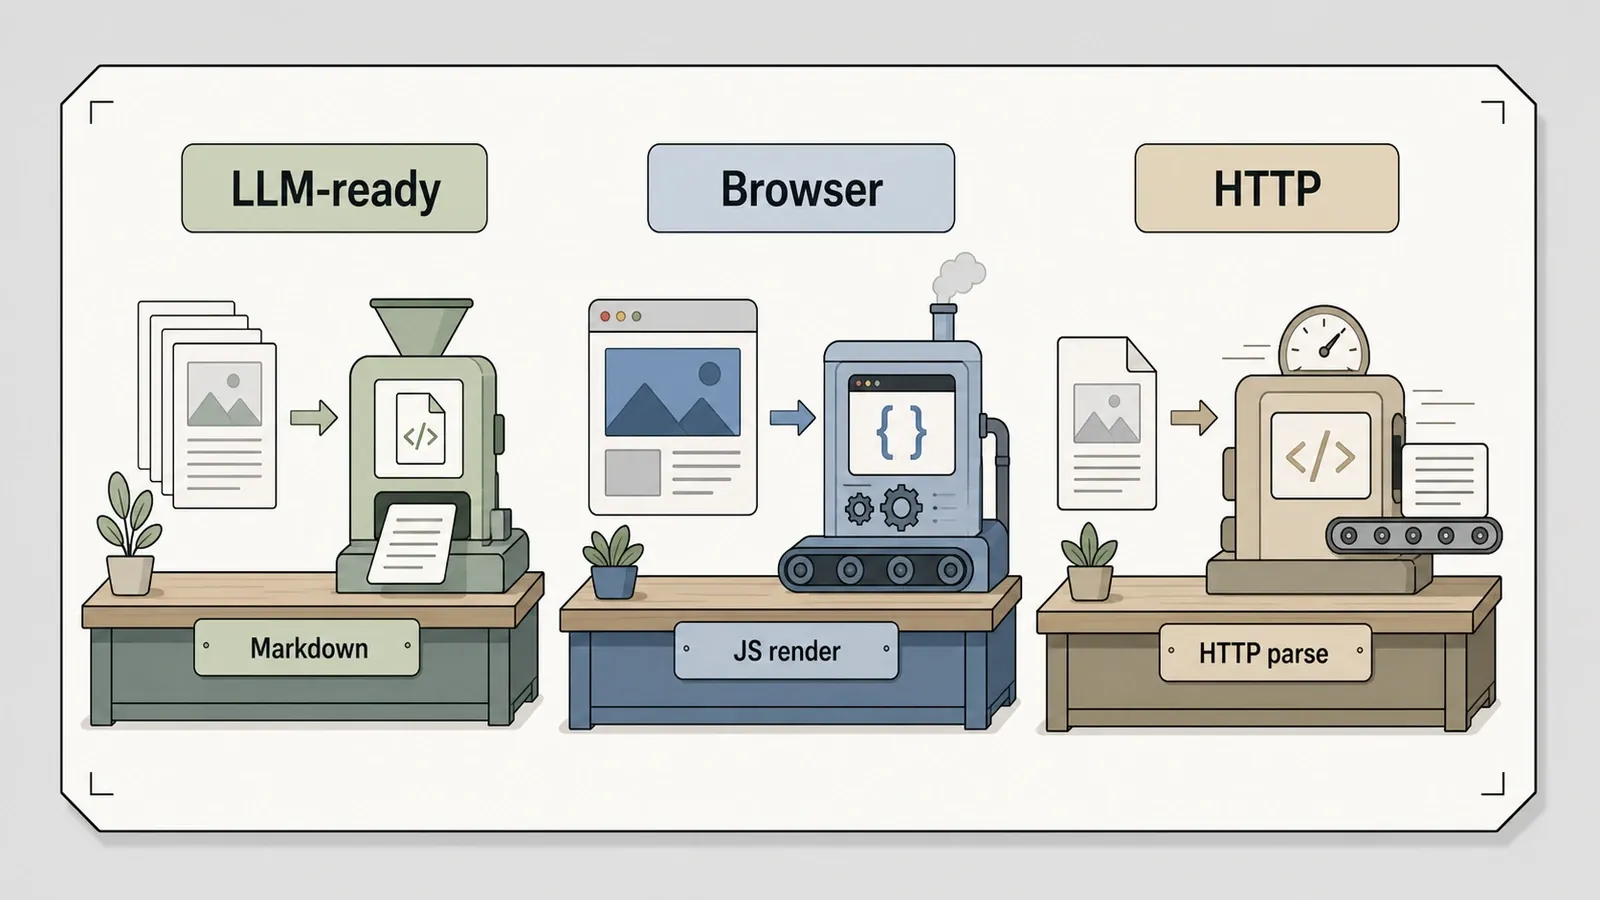
אם מה שאתם צריכים הוא Markdown נקי להזנה ל‑RAG pipeline, שלושה כלים מתחרים — והם לא יכולים להיות שונים יותר זה מזה.
Crawl4AI הוא, מתחת לכל המיתוג, מחולל Markdown שמבוסס דפדפן. כדאי לשבור את סיפור ה‑"adaptive intelligence self-learning selector" שרודף אותו בתוצאות החיפוש: אין לו דבר כזה — זה טריק של ספרייה אחרת לגמרי (נגיע לזה כשנגיע ל‑Scrapling). מה שהוא באמת עושה — הוא עושה טוב. באתר התרגול Books to Scrape הוא הפיק 13,476 תווים של Markdown, יודע לבצע חילוץ מבוסס CSS schema לצרכים מובנים, וה‑BFS deep crawl המובנה שלו סרק 5 עמודים בגרף הבדיקה בזמן שרינדֵר עמוד JavaScript וצילם צילום מסך. אבל יש גם שתי מכות אמיתיות. ה‑Markdown הגולמי שלו נושא איתו את ה‑boilerplate של הדף אלא אם מפעילים content filter, וה‑500 המכוון חזר כ‑success=false — לא כי Crawl4AI זיהה את שגיאת ה‑HTTP בצורה אלגנטית, אלא כי ההיוריסטיקה של התוכן שלו הסתכלה על גוף השגיאה הזעיר וסימנה אותו כ‑minimal_text ... blocked. ובשלב ההקמה הוא גם נוטע שני stacks של דפדפן על הדיסק. גרסה 0.9.0, Apache-2.0, בערך 71 אלף כוכבים בתחילת יולי.
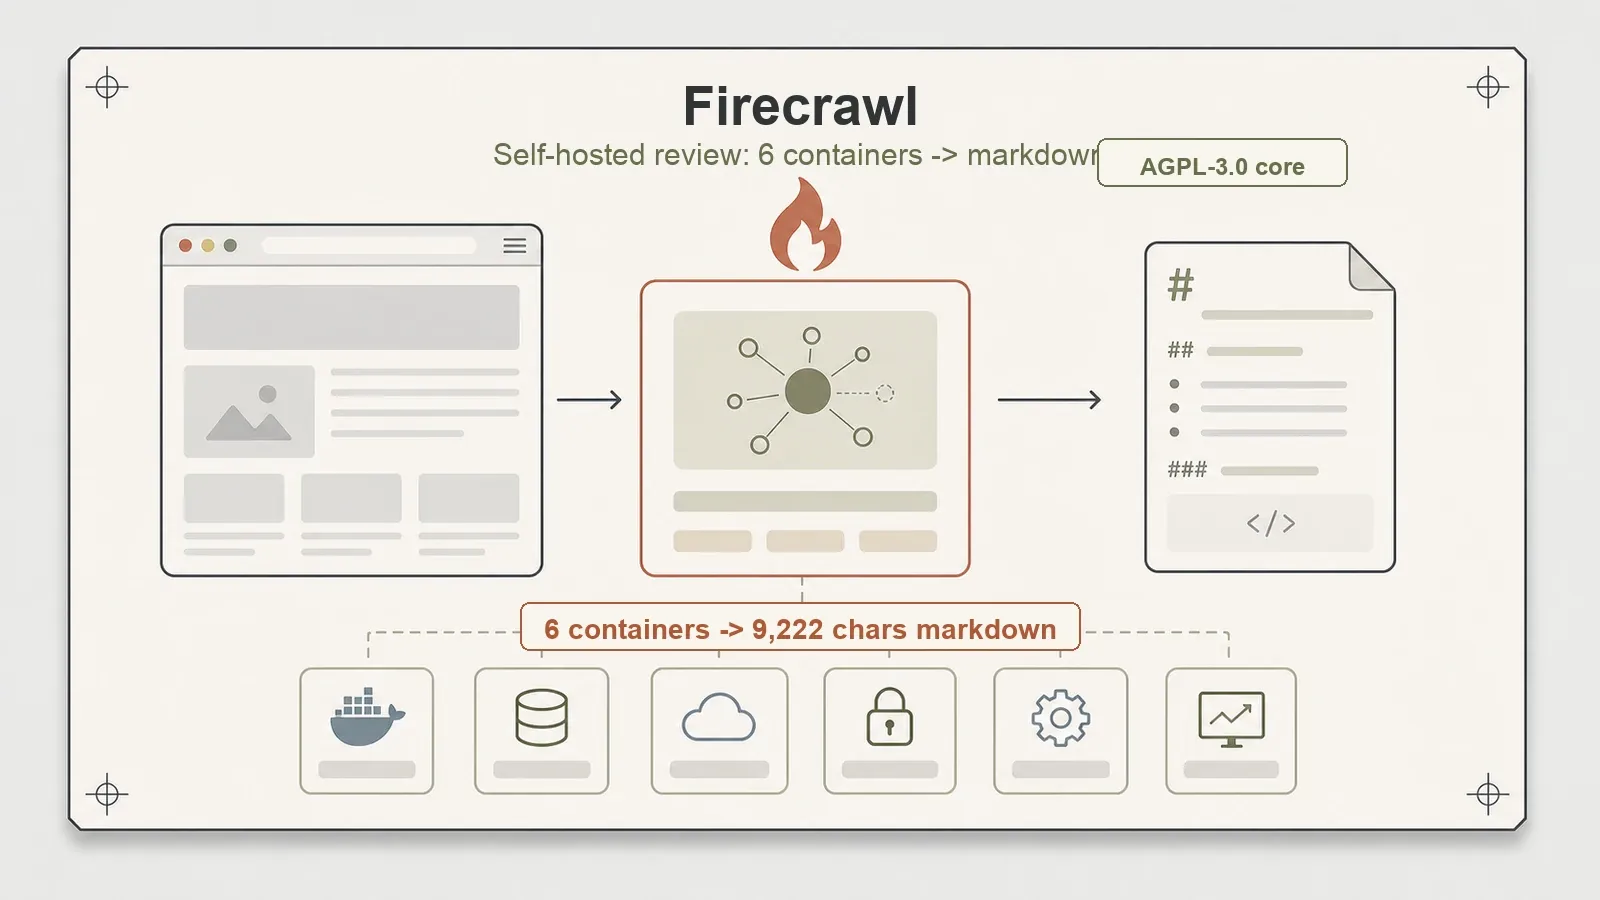
Firecrawl הוא הכלי הכבד, והפעלתו עצמאית באמת עובדת — אני אומר "באמת" כי ה‑stack של שישה קונטיינרים (api, playwright-service, redis, rabbitmq, nuq-postgres, ו‑foundationdb) אכן עלה והפיק 9,222 תווים של Markdown מוכן ל‑LLM מאותו עמוד Books to Scrape. הוא רינדר עמוד JavaScript דרך ה‑playwright-service המובנה שלו, וציטוט איינשטיין שאחרי הסקריפט הופיע בפלט, מה שהוכיח שהרינדור היה אמיתי. שתי התקלויות שחוויתי היו אשמת הסביבה, לא אשמת Firecrawl, ואני מדייק כדי שאף אחד לא ייקח את הפתרון הלא נכון: build מתוך קוד מקור נתקל ב‑snapshotter glitch של containerd תחת colima (עברתי לתמונות prebuilt), וטווח ה‑DNS של colima ב‑198.18.x.x הפעיל את הגנת ה‑SSRF של Firecrawl, מה שפתרתי עם ALLOW_LOCAL_WEBHOOKS=true — פתרון זמני לפיתוח מקומי, לא משהו שצריך לבטל בפריסה אמיתית. הליבה העצמאית גם חסרה את Fire-engine, שכבת ה‑anti-block בענן, ולא בדקתי את ה‑cloud API. הדגל הגדול יותר הוא הרישיון: הליבה העצמאית של Firecrawl היא AGPL-3.0, וזה חומר קריאה משפטי אמיתי לפני כל שימוש מסחרי, לא הערת שוליים. בערך 148 אלף כוכבים בתחילת יולי.
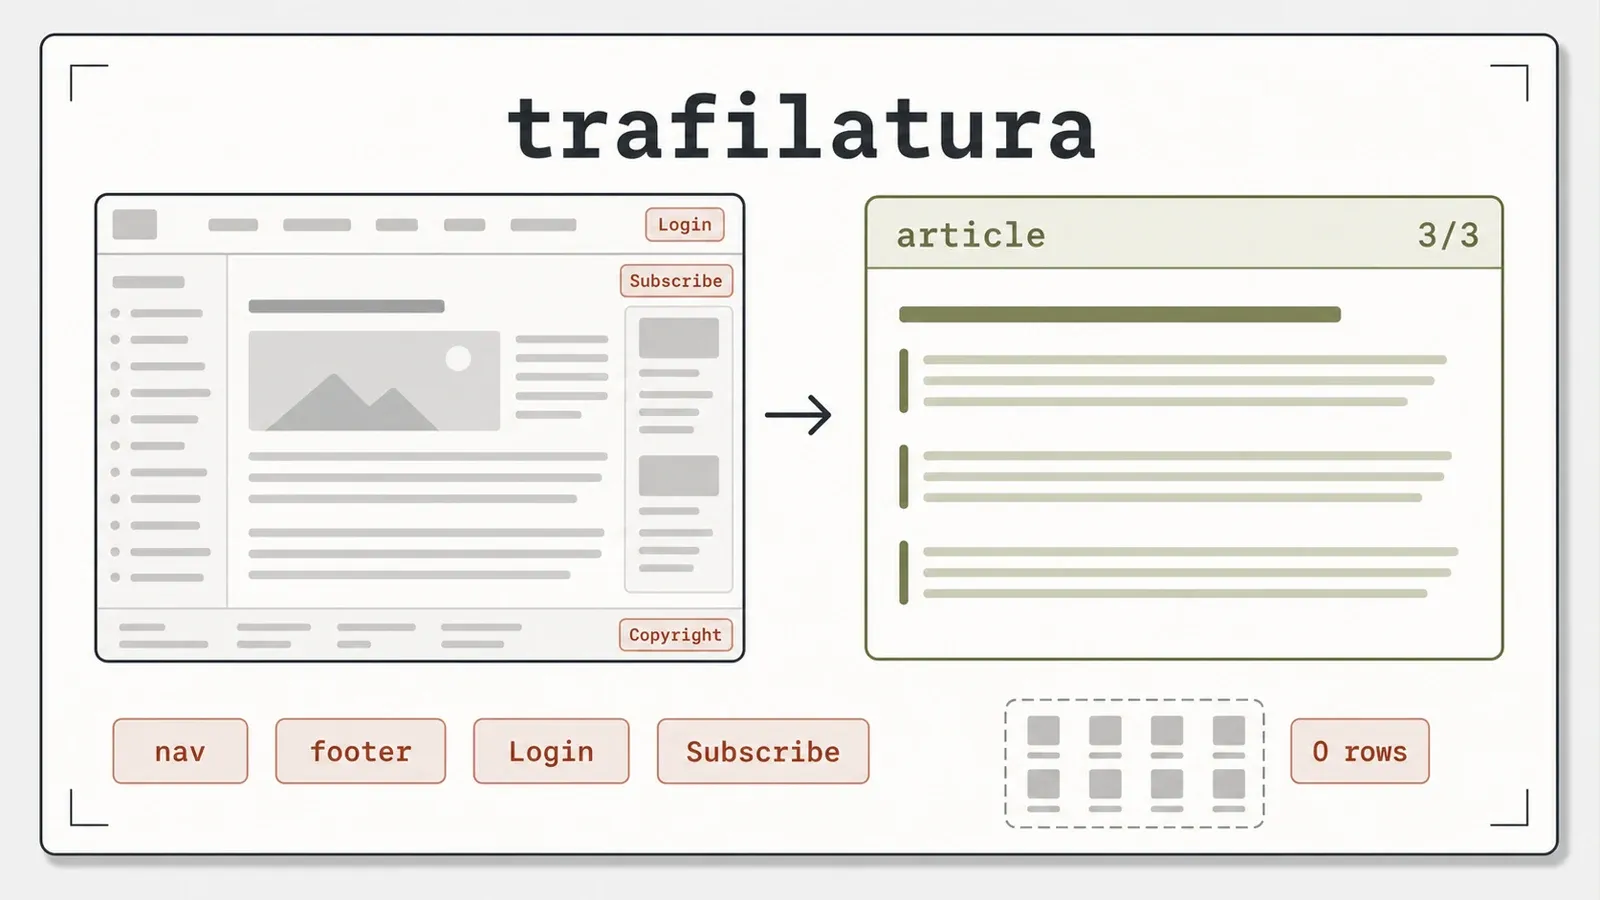
trafilatura היא החריגה בקבוצה, וזו שהרשימות המהוללות של AI שוכחות שוב ושוב. בלי דפדפן. בלי שורות מובנות. רק טקסט כתבה נקי ומהיר ב‑Python טהור. על fixture של כתבה היא משכה את הכותרת ועוד כל 3 מתוך 3 הפסקאות האמיתיות, ניקתה לחלוטין את ה‑boilerplate — שום "Login", "Subscribe" או "Copyright" לא דלפו — וגם החזירה את המחבר והתאריך מעל לזה. בדף מוצר ציבורי היא החזירה 1,324 תווים של טקסט נקי. הגבול שלה הוא בדיוק מה שהעיצוב שלה מרמז: אם מפנים אותה לקטלוג, היא מחזירה 12 שמות מוצרים כטקסט אבל 0 שורות מובנות — הטקסט שם, המבנה לא, והיא לא מרנדרת JavaScript. גרסה 2.1.0 (הגרסה הנוכחית), Apache-2.0, בערך 6.2 אלף כוכבים. לחילוץ כתבות טהור, זה הכלי הראשון שהייתי פונה אליו.
שתי ספירות התווים האלה של Markdown — 13,476 מ‑Crawl4AI, 9,222 מ‑Firecrawl — הגיעו מאותו עמוד ציבורי, אבל אסור לקרוא בהן פער איכות. הן משקפות אסטרטגיות Markdown שונות (כמה מ‑page chrome כל כלי שומר), לא פסק דין על איזה פלט טוב יותר. זהו כלל האות־בתוך־הכלי מהקודם, שמופיע כאן בגלוי.
משימה שנייה: לרנדר JavaScript בצורה אמינה
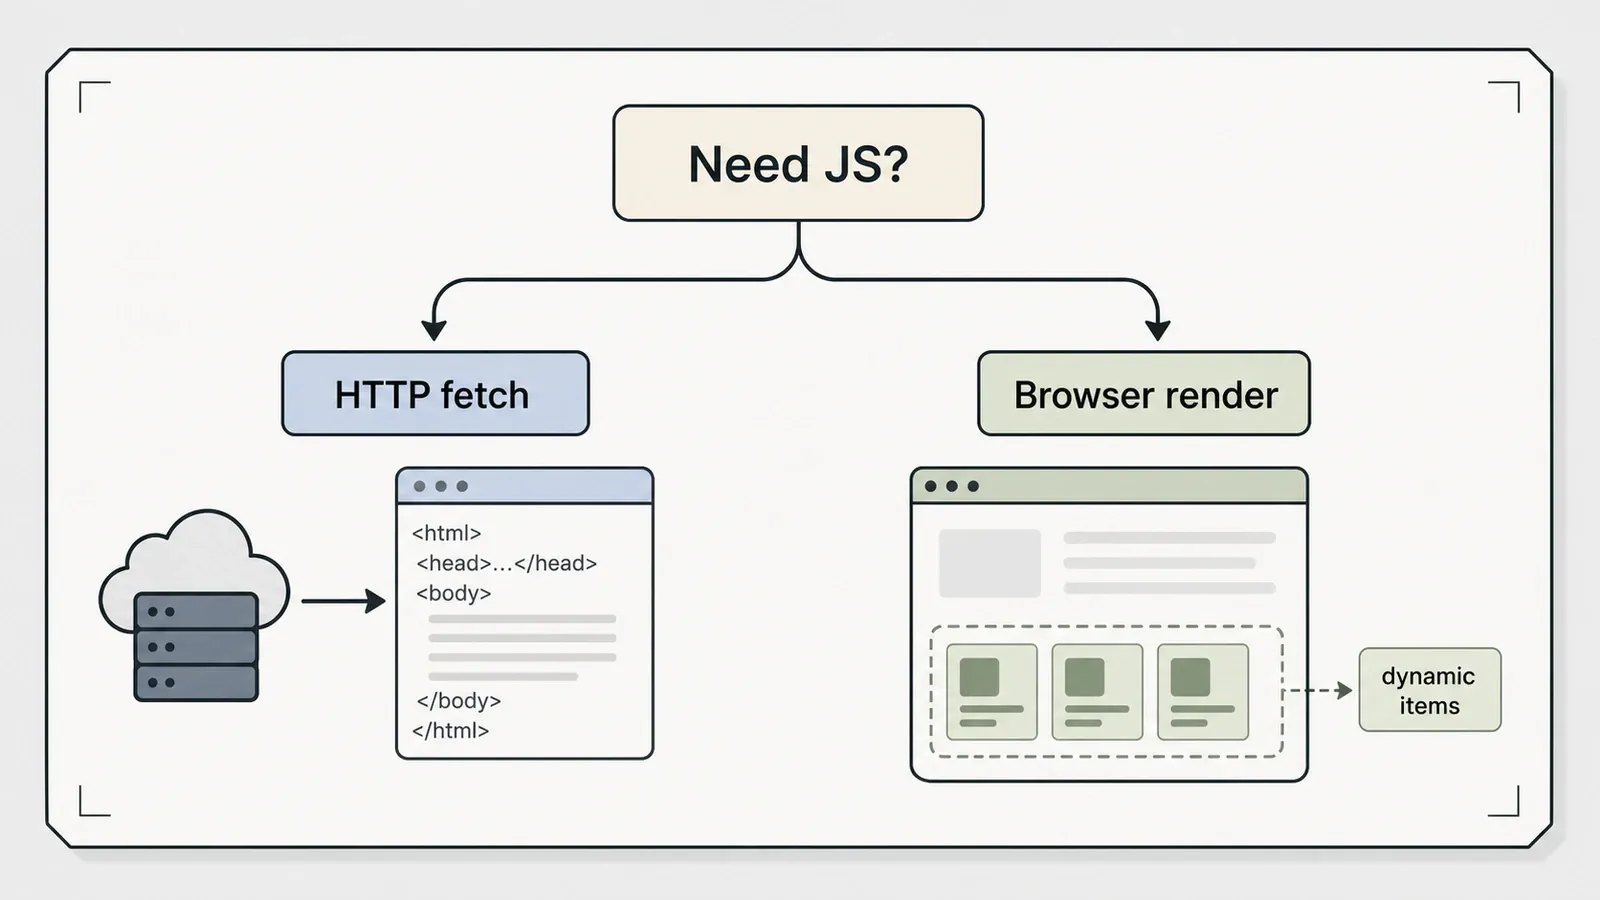
יש נתונים שפשוט לא נמצאים ב‑HTML עד שהסקריפטים רצים, וזה הרגע שבו דפדפן אמיתי מפסיק להיות מותרות. שלושה כלים מכסים את המשימה הזו — ושניים מהם התגלו כמעט ככלי אחד.
Playwright ו‑Puppeteer סיימו בתיקו על כל בדיקה שהטחתי בהם. שניהם רנדורו 8/8 מוצרים דינמיים ב‑fixture המקומי ו‑10 באתר Quotes JS הציבורי, שניהם הגיעו ל‑12/12 recall סטטי, ושניהם טיפלו ב‑500 בצורה נקייה (Puppeteer מחזיר response object במקום לזרוק חריגה). אף אחד מהם לא מגיע עם crawl queue, לכן שניהם נזקקו ל‑BFS שנכתב ידנית, וה‑crawl הזה הגיע ל‑12 עמודים בין עומק 0–2 בגרף הבדיקות. ההבדל האמיתי היחיד הוא הטווח: Playwright מפעיל Chromium, Firefox ו‑WebKit ומדבר Python ו‑.NET, בעוד Puppeteer הוא קודם כל Chrome ורק Node. שתי הבהרות, כי הגרסאות כאן זזות מהר: בדקתי את Playwright 1.56.0 מול גרסה עדכנית 1.61.1 והפעלתי רק Chromium, ואת Puppeteer 24.16.0 מול גרסה עדכנית 25.3.0 — אז יש להריץ מחדש או להוריד משקל בהתאם. שניהם Apache-2.0; בערך 92 אלף ו‑95 אלף כוכבים בהתאמה.
Crawlee הוא זה שפותר את בעיית התור שהשניים האחרים משאירים פתוחה. הוא עוטף מנוע Cheerio (HTTP) ומנוע Playwright (browser) מאחורי API אחד, והניגוד על אותו עמוד הוא כל הרעיון: מנוע Cheerio ראה 0 פריטים שהוזרקו ב‑JavaScript, מנוע Playwright ראה את כולם 8/8 בריצה המקומית (ו‑10 באתר הציבורי), והמעבר ביניהם הוא שינוי של שורה אחת. הוא גם נותן לכם RequestQueue אמיתי, וזה מה שמקנה לו מקום במשימה הזו ולא במשימה שלישית. ההסתייגות שאף אחד לא כותב בכותרת: מנוע הדפדפן דורש npx playwright install נפרד, בערך 80 MiB ש‑npm install crawlee לא מביא אוטומטית. גרסה 3.17.0, TypeScript, Apache-2.0, בערך 24.6 אלף כוכבים.
משימה שלישית: לסרוק מהר בלי דפדפן
אם אין JavaScript בעמוד, דפדפן הוא בזבוז כבד. שלושה כלים שמבוססים HTTP מתחרים כאן, אחד לכל תפיסת שפה, והם לא מסכימים זה עם זה בדרכים מעניינות.
Scrapy הוא הכלי ברמת הנדסה של החבורה — spiders, ייצוא feed ל‑JSON/CSV/XML, AutoThrottle, כל החבילה. הוא הגיע ל‑12/12 recall סטטי, משך את 3/3 הפסקאות של הכתבה, עבר על 11 עמודים בין עומק 0–2 בגרף הבדיקות, ותפס את ה‑500 דרך handle_httpstatus_list. תפיסת העולם שלו היא החלק המעניין: הוא לא מרנדר, הוא משחזר את הבקשה. כשהוא נזרק על העמוד הדינמי הוא קיבל 0 nodes — ואז ה‑JSON API שמאחורי אותו עמוד החזיר לו 8/8. זו הפילוסופיה של Scrapy במשפט אחד: למצוא את הבקשה שהעמוד עצמו שולח ולשחזר אותה, לא לנהוג בדפדפן. המחיר הוא stack של תלויות לא קטן (Twisted, lxml, parsel), ובדקתי אותו רק מול fixtures קטנים. גרסה 2.17.0, BSD-3-Clause, בערך 63 אלף כוכבים.
Colly הוא התשובה של Go, והוא אומר באופן רענן ומילולי בדיוק מה הוא: בינארי סטטי אחד, מונע‑callback דרך OnHTML, OnResponse ו‑OnError, עם שליטה בעומק. הוא פגע ב‑12/12 recall סטטי, משך 8/8 מ‑JSON API דרך OnResponse, תפס את ה‑500 דרך OnError, והגיע ל‑17 עמודים בסריקה בעומק 2 — ואני מנסח זאת בדיוק כך, כי ספירת העמודים הזו היא המונה של ההארנס עצמו, לא הבטחת שלמות ש‑Colly נותן. מה שהוא לא עושה הוא JavaScript: ה‑fixture הדינמי ואתר Quotes JS חזרו שניהם 0, כמתוכנן. תצטרכו toolchain של Go כדי לבנות אותו, וגרסת המודול (v2.3.0) רצה כרגע לפני הגרסה המתויגת (v2.2.0). Apache-2.0, בערך 25 אלף כוכבים.
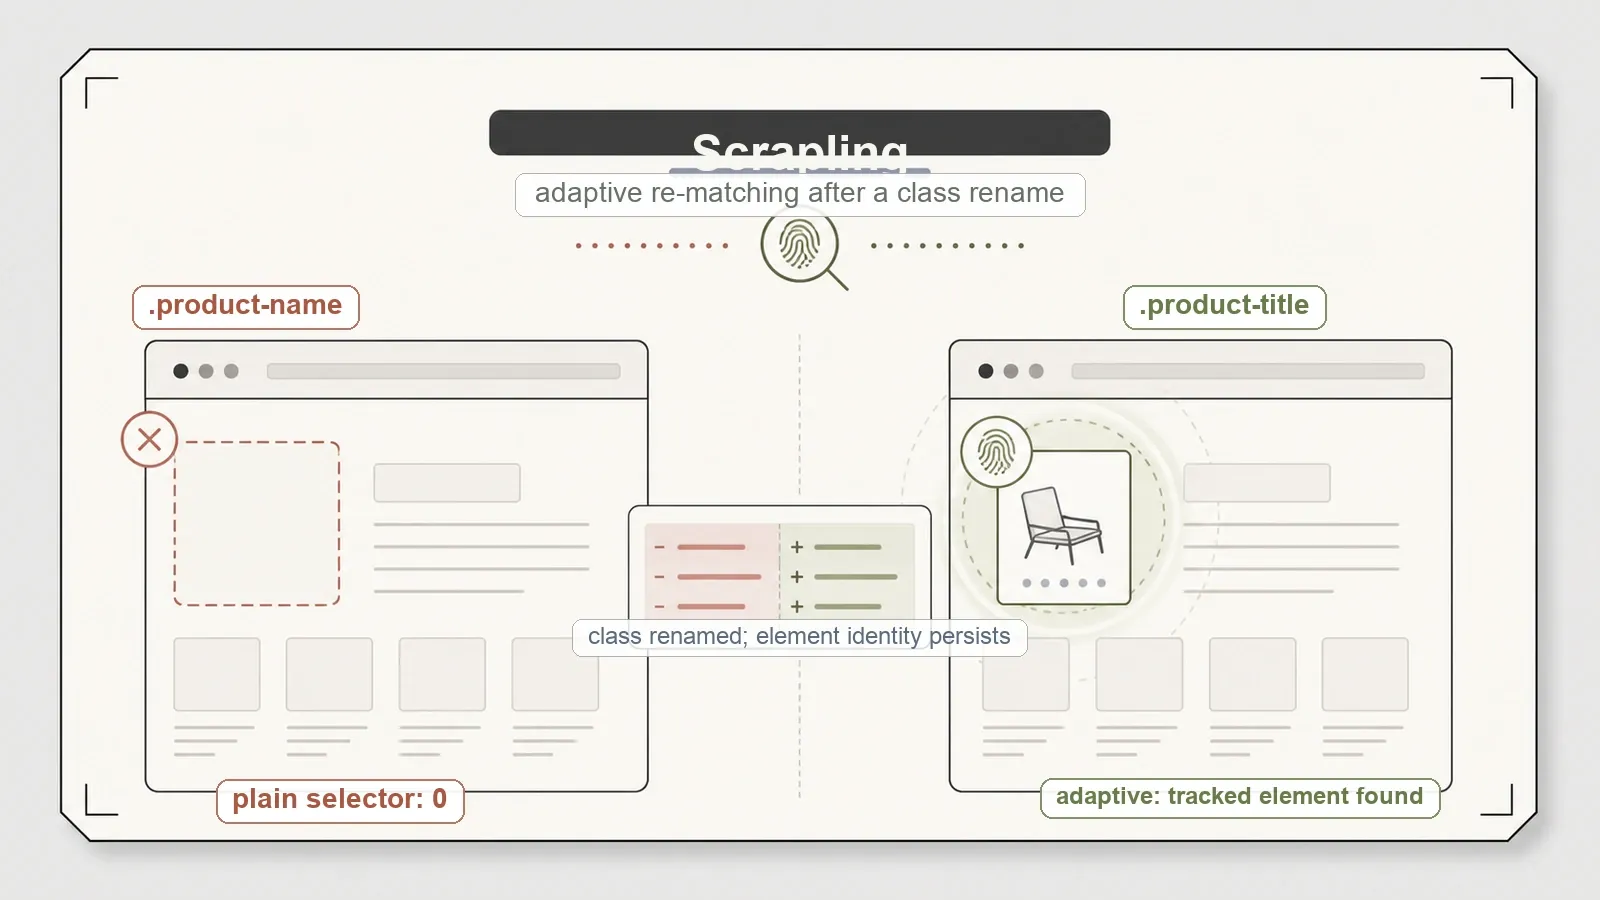
Scrapling הוא המומחה, והוא באמת מרוויח את התואר. ה‑adaptive selectors שלו נבנו כדי לאתר שוב אלמנט אחרי שה‑markup משתנה — כך שכאשר שיניתי במחולל את מחלקת ה‑HTML של יעד מ‑product-name ל‑product-title, selector רגיל מצא 0, אבל ה‑adaptive re-match החזיר בכל זאת את האלמנט הממופה. בחילוץ HTTP פשוט הוא הגיע ל‑12/12 בסטטי ול‑8/8 ב‑JSON API. והחלק שהדוקומנטציה שלו לא מסתירה: בבדיקה סינתטית עם כמה אלמנטים הוא שחזר 1 מתוך 3 — זו עמידות במעקב אחר אלמנטים, לא שחזור מלא, אז לא כדאי למכור לעצמכם תמונה מוגזמת. גם pip install scrapling הבסיסי שלו דורש את התוספת [fetchers] כדי להתחיל לעבוד, וה‑StealthyFetcher שלו הוא הסתייגות של תאימות, לא תכונה שהייתי שם במצגת. גרסה 0.4.10 (הגרסה הנוכחית), BSD-3-Clause, בערך 68.7 אלף כוכבים.
התבנית שמסתתרת מתחת לשלוש המשימות
אם מסדרים את התשעה בשורה, עולה משהו נקי. recall סטטי מלא — שטוח 12/12 — הוא תנאי סף לכל כלי שמבוסס HTTP; אף אחד מהם לא נפל במקרה הקל, כך שזה לא מה שמבדיל ביניהם. כלי דפדפן מצדיקים את המשקל הנוסף רק כשה‑JavaScript באמת חלק מהעניין, וכולם משלמים על זה בהקמה: stack של דפדפן, התקנה נוספת, או חוות קונטיינרים שלמה. והעמודה "built-in crawl queue" היא בעצם הקו שבין framework ל‑engine — Scrapy ו‑Crawlee מביאים orchestration, בעוד Playwright ו‑Puppeteer מחייבים אתכם לכתוב את ה‑BFS בעצמכם. זה המבנה של התחום. אף אחד לא מנצח באופן כללי כי אף אחד לא משחק באותו משחק.
אז מה באמת כדאי לבחור
ה‑bench מסרב להכתיר מנצח, כי התשובה הנכונה איננה כלי — היא שאלה: באיזו משלוש המשימות אתם עוסקים?
- צריכים Markdown מוכן ל‑LLM? פנו ל‑trafilatura כשמדובר בטקסט כתבה נקי, ל‑Crawl4AI כשאתם רוצים גם חילוץ CSS וגם רינדור JavaScript באותה ספרייה, ול‑Firecrawl כשאתם רוצים שירות עצמאי ב‑self-hosting ויכולים להתמודד גם עם רישיון AGPL-3.0 וגם עם משקל של שישה קונטיינרים.
- צריכים רינדור JavaScript? Playwright או Puppeteer לרינדור הגולמי — בחרו לפי מנוע ושפה, כי אחרת זו כמעט תיקו — ו‑Crawlee כשאתם גם רוצים orchestration של הסריקה במקום לכתוב אותו ידנית.
- סורקים עמודים סטטיים או APIs שניתן לשחזר בקנה מידה? Scrapy כ‑framework Python מלא, Colly למהירות Go גולמית בבינארי יחיד, ו‑Scrapling כשעמידות בפני שינויי markup היא הכאב הספציפי והחוזר שלכם.
תתאימו את הכלי למשימה, ולכל אחד מהם יש בחירה לגיטימית. קחו קטגוריה לא נכונה — כלי דפדפן לעמודים סטטיים, או parser HTTP לאפליקציית JavaScript — ואפילו הספרייה המדורגת הכי טוב באינטרנט עדיין תאכזב אתכם.
איפה נכנס במקום זה API מנוהל מבוסס AI
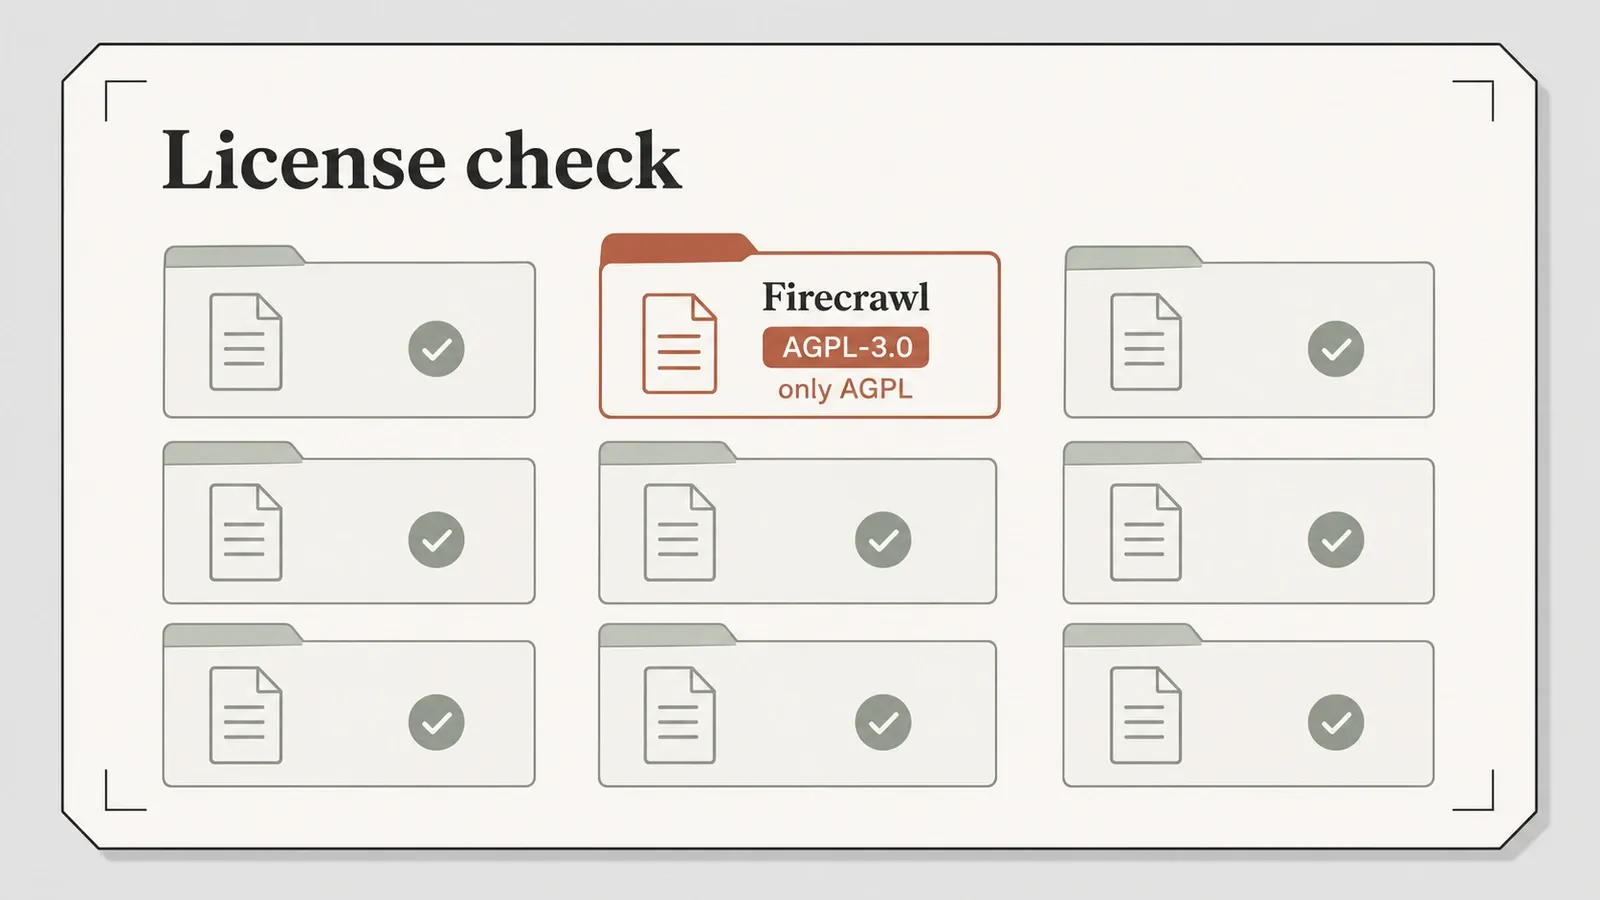
כל כלי למעלה הוא חינמי, קוד פתוח, ושלכם להרצה. אבל זה גם אותו trade-off משותף שה‑bench חושף שוב ושוב: אתם אחראים על סביבת הדפדפן, קוד הסריקה, מרוץ החימוש נגד anti-bot, וכל תחזוקת המערכת. עבור הרבה צוותים, דווקא השליטה הזו היא כל העניין, ומפת הרישיונות חשובה כשנכנסים לזה — רוב התחום הוא permissive (Apache-2.0 ב‑Crawl4AI, Crawlee, Playwright, Puppeteer, ו‑Colly; BSD-3 ב‑Scrapy וב‑Scrapling), עם הליבה העצמאית של Firecrawl ברישיון AGPL-3.0 שהיא היחידה שדורשת בדיקה אמיתית לפני שימוש מסחרי.
אבל שימו לב למה שה‑bench גם מיפה: מה הכלים האלה לא עושים. רינדור, סריקה, מבנה, והתחמקות מחסימות — לעיתים נדירות הכול יחד, ולעולם לא בלי תחזוקה מצדכם. API מנוהל לחילוץ נתונים מבוסס AI דוחס את כל הסטאק הזה לקריאה אחת. הממשק המפתחים שלנו ב-Thunderbit הוא אופציה אחת כזו, ולקהל טכני מה שחשוב הוא ה‑API, שרת ה‑MCP, וה‑CLI — לא תוסף הדפדפן. POST /distill מחזיר Markdown נקי ו‑POST /extract מחזיר JSON שמוגדר לפי schema, עם רינדור JavaScript ו‑anti-bot שמטופלים בצד השרת במקום במחשב שלכם. יש גם שרת MCP רשמי לסוכנים ולעוזרי קוד — thunderbit_suggest_fields רץ בחינם כדי לתכנן חילוץ, ואז thunderbit_distill (קרדיט 1) ו‑thunderbit_extract (20 קרדיטים) מבצעים את העבודה — וגם CLI שאפשר למשוך עם npx @thunderbit/thunderbit-cli למשימות טרמינל ו‑cron. למי שלא מפתח בצוות יש גם תוסף Chrome ללא קוד, ו-המחירון מכסה את שני הממדים.
ה‑trade-off הוא אותו אחד שכל ה‑bench הזה מקיף: להריץ ולתחזק עד תשע ספריות בעצמכם בלי עלות פר קריאה, או להעביר את שכבת התשתית ולשלם לפי בקשה. אף אחת מהבחירות אינה שגויה. זה תלוי בכמה מהסטאק אתם באמת רוצים להחזיק. אם תעדיפו לראות איך החילוץ נראה בפועל, ערוץ YouTube של Thunderbit עובר על זה.
פסק הדין
אין סקרייפר open-source אחד שהוא הטוב ביותר, וכל רשימה שמוסרת לכם כזה בביטחון מסתירה בשקט את השאלה שבאמת קובעת: באיזו משלוש המשימות אתם עוסקים? להפוך עמוד לטקסט, לרנדר JavaScript, או לסרוק מהר בלי דפדפן — התחום מתחלק בצורה נקייה לשלוש הקטגוריות האלה, ובתוך כל אחת מהן הבחירה תלויה בשפה ובמשקל ההקמה, לא באלוף אוניברסלי כלשהו.
אם לקחתם מהרקע הזה רק הרגל אחד, קחו את זה: בדקו על הדפים שלכם לפני שאתם מתחייבים למשהו. כל מספר כאן ניתן לשחזור ב-מאגר ה‑benchmark בדיוק מהסיבה הזו — כי הכלי שמוביל בסיכום גנרי והכלי ששורד את היעדים האמיתיים שלכם אינם תמיד אותו כלי.
נסו את Thunderbit לחילוץ נתוני רשת Get Started Free
שאלות נפוצות
מהו סקרייפר הקוד הפתוח הטוב ביותר? אין כזה יחיד — זה תלוי במשימה. לטקסט מוכן ל‑LLM: trafilatura או Crawl4AI; לרינדור JavaScript: Playwright, Puppeteer או Crawlee; לסריקת HTTP מהירה: Scrapy או Colly. ב‑bench משותף, כל כלי היה חזק ביותר בתוך הקטגוריה שלו ונחלש בצורה מורגשת מחוץ לה, ולכן דירוגים חד־ממדיים מטעים.
אילו סקרייפרים בקוד פתוח מרנדרים JavaScript? Crawl4AI, Firecrawl, Playwright, Puppeteer, ומנוע ה‑Playwright של Crawlee כולם מרנדרים JavaScript. Scrapy, Colly, trafilatura, ו‑HTTP fetcher ברירת המחדל של Scrapling לא — הם או צריכים API שניתן לשחזר מאחורי העמוד (זו הגישה של Scrapy, שהצליחה להגיע ל‑8/8 מקצה ה‑JSON) או מצב דפדפן נפרד.
האם צריך headless browser כדי לסרוק אתר? רק אם הנתונים מופיעים אחרי ש‑JavaScript רץ. אם בקשת HTTP רגילה יחד עם parser יכולה להגיע לתוכן, דפדפן הוא משקל עודף יקר — Scrapy, Colly או Scrapling יהיו הרבה יותר קלים ומהירים במקרה כזה.
לאיזה מהם יש רישיון נוח יותר לשימוש מסחרי? רובם permissive: Apache-2.0 (Crawl4AI, Crawlee, Playwright, Puppeteer, Colly) או BSD-3-Clause (Scrapy, Scrapling). החריג הוא הליבה העצמאית של Firecrawl, שהיא AGPL-3.0 ודורשת בדיקת רישיון אמיתית לפני שמבנים עליה מוצר מסחרי.
האם מספרי ה‑benchmark האלה ניתנים לשחזור? כן. כל runner, fixture ותוצאה גולמית נמצאים במאגר ציבורי ברישיון MIT. הסתייגות אחת שחשוב לזכור: recall ותוצאות מבניות ניתנים להשוואה בין כלים, אבל ספירות תווים מוחלטות הן אותות בתוך הכלי בלבד, כי כל חבילה משקפת את ה‑fixtures במקום לחלוק עותק קנוני אחד — לכן משווים שיעורים ו‑pass/fail, לא סך תווים גולמי.




