
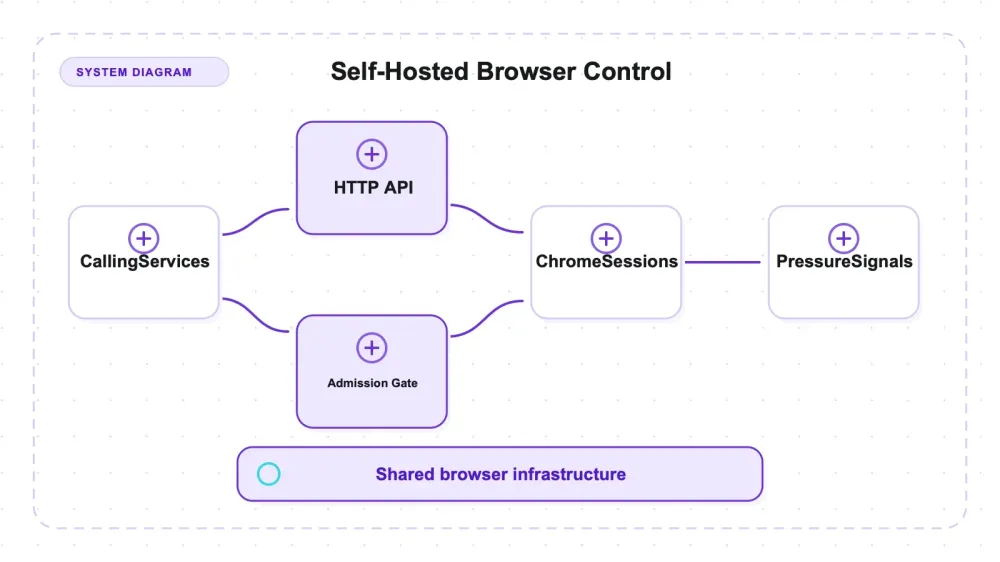
Browserless הוא בעצם Chrome בלי ממשק גרפי, ארוז כשירות שאתם מארחים בעצמכם. קונטיינר ה-Docker שלו נשאר רץ, מקבל משימות דרך HTTP או WebSocket, ומיישם מגבלות כניסה משותפות במקום להיטען מחדש בכל קריאה בנפרד. בבדיקות ה-REST כאן, השירות החזיק אפס תהליכי Chrome במצב סרק, יצר תהליכי Chrome רק בזמן שבקשה הייתה פעילה, וחזר לאפס אחריה. מה שנמצא בבריכה הוא קיבולת השירות ותור ההמתנה — לא סט מאומת של תהליכי דפדפן שכבר “התחממו” מראש.
בדקתי את v2.55.0 מול תרחיש מקומי מבוקר — חלוקה לשלבי עלייה, בקרת כניסה בשלוש תצורות, התאמת נקודות הקצה לאמת ידועה, soak של 30 סשנים, וסף הזמן-נפילה. מה שהתברר כמשמעותי היה תפעולי יותר מאשר שדרוג ביצועים: מגבלות הכניסה תאמו את התגובות שנראו מצד הלקוח, והקצוות החדים היו בעיקר כאלה שנובעים מאופן הפריסה.
התוצאה השימושית ביותר לא הייתה מספר השהיה. Browserless לא גורם ל-Chrome להתחיל מהר יותר — הוא פשוט עומד כשומר בכניסה ל-Chrome: מספר קבוע של סשנים בפנים, תור מאחוריהם, ו-HTTP 429 לכל מי שלא נכנס. התקרה הזו זזה מ-4 ל-8 ל-10 כששיניתי שני משתני סביבה, והחשבונאות של הקונטיינר עצמו תאמה את קודי הסטטוס של הלקוח בכל בקשה ובקשה.
מה Browserless באמת הוא
פה הרבה אנשים נופלים. Browserless הוא לא ספרייה שמייבאים וקוראים לה. זו תמונת Docker — ghcr.io/browserless/chromium — שמריצים כשירות ארוך-חיים. הוא מתווך עבודת דפדפן וחושף אותה בשתי דרכים: נקודות קצה REST (/content, /scrape, /screenshot, /pdf, וגם /function ו-/unblock) וממשק CDP/WebSocket ש-Puppeteer ו-Playwright יכולים להתחבר אליו עם connect().
בדקתי את שכבת ה-REST. נתיב ה-WebSocket אמיתי ונמצא בשימוש נרחב, אבל לא מדדתי אותו.
הגרסה שנבדקה הייתה v2.55.0, אומתה ב-27 ביולי 2026.
| פריט | ערך |
|---|---|
| גרסת התמונה | v2.55.0, פורסמה ב-14 ביולי 2026 |
| Chrome | 149.0.7827.0 |
| Node | 24.18.0 |
| תמונת בסיס | Ubuntu 24.04 |
| כוכבי GitHub | בערך 13,525, נכון ל-27 ביולי 2026 |
מספרי הכוכבים משתנים; קחו זאת כתצלום נקודתי בזמן.
שער הרישוי: SSPL-1.0 או רישיון מסחרי
המאגר מציע את Browserless תחת SSPL-1.0 או רישיון מסחרי של Browserless. קראו את קובץ ה-LICENSE העדכני במאגר ואת ההנחיות הרשמיות של Browserless לפריסה בקוד פתוח לפני שבוחרים מסלול. המאמר הזה לא ביצע ניתוח משפטי של מוצרים מסחריים, יישומים סגורי-קוד, מערכות CI, שירותים מתארחים או פריסות פנימיות, ולכן הוא לא מסווג תרחישים כאלה לפי רישיון. תנו לעו״ד או למי שאחראי על רישוי תוכנה לבחון את מודל הפריסה וההפצה.
Browserless מוכרת גם תוכניות מתארחות. מחירים והגדרות של יחידות שימוש משתנים לעיתים, והם לא היו חלק מהבדיקה העצמאית הזו, לכן כדאי לאמת אותם באתר הרשמי ולא להתייחס לטבלה מיושנת כאן כאל הוכחת רכש.
איך מודל הסשנים עובד מאחורי הקלעים
נתיב ה-REST שנמדד התנהג כמו עבודה של דפדפן לכל בקשה, אבל ההרצה הזו לא עקבה מספיק עמוק אחרי המנגנון הפנימי של Browserless כדי להבדיל בין תהליך דפדפן חדש לבין כל אסטרטגיה אחרת של שימוש חוזר בקונטקסט. מה שכן הוכח הוא פשוט יותר: אפס תהליכי Chrome במצב סרק, 11 תהליכים ממשפחת Chrome בזמן שבקשה הייתה פעילה, ואפס לאחר הרצה סדרתית. לא נמצאה שום עדות לבריכת דפדפנים שחוממה מראש בתצורה הזו.
שירות ה-Node שרץ לאורך זמן מכניס מספר מוגבל של משימות דפדפן, שם עוד קבוצת משימות מוגבלת בתור, ודוחה את השאר. התייחסו למודל הכניסה הזה כאל ההסכם הארכיטקטוני שנמדד בהמשך. אל תסיקו שימוש חוזר בתהליכים או בקונטקסטים מהמילה “pool”; כלי המדידה לא יכול להוכיח את זה.
בקרת הכניסה נשלטת על ידי שני כפתורים:
CONCURRENT— כמה סשנים רצים במקביל.QUEUED— כמה בקשות נוספות יכולות להמתין בתור.
נקודת הקצה /config של הקונטיינר דיווחה על ברירות מחדל של CONCURRENT=10, QUEUED=10, TIMEOUT=30000. כל מה שמעבר ל-CONCURRENT + QUEUED נדחה מיד.
אימות אינו אופציונלי. Browserless v2 תמיד דורש טוקן — אם לא מגדירים TOKEN, הוא מייצר אחד אקראי ומדפיס אותו ל-stdout בזמן ההפעלה. כל קריאת REST נושאת ?token=.
לצורכי תצפית יש /pressure (רץ, ממתין, CPU, זיכרון, נדחו לאחרונה), /sessions, ו-/config. יש גם ייצוא JSON של /metrics, אבל צריך להגדיר METRICS_JSON_PATH ולא השתמשתי בו. בנוסף, התמונה מריצה את dumb-init כ-PID 1, שזה הפתרון המתועד לתלונות על תהליכי זומבי שליוו Chrome בקונטיינרים במשך שנים.
מציאות ההתקנה: פקודה אחת, ועוד ארבעה דברים שאף אחד לא מכניס לפקודה אחת
שורת ההתקנה שכולם מצטטים היא באמת docker run אחד. מה שסביבה הוא מה שצריך לתכנן מראש.
התמונה שוקלת 4.34 GB. זה המספר שצריך לעצב את הציפיות שלכם, לא זמן העלייה. המניפסט כולל גם linux/arm64 וגם linux/amd64; אצליי על מארח arm64 Docker הוריד את גרסת arm64 המקומית. (עם זאת, ה-user-agent של Chrome בתוך הקונטיינר עדיין מציג X11; Linux x86_64 — זו תחפושת UA קוסמטית של Chrome בלינוקס, לא אמולציה. uname -m מחזיר aarch64. אנשים פותחים על זה תקלות.)
השתמשתי ב---shm-size=2g בכל המדידות. ההרצה לא כללה ריצת ביקורת עם /dev/shm ברירת המחדל של Docker, לכן המאמר לא יכול לקבוע ש-2 GiB הם חובה לכל מצב או לכמת את נקודת הכשל. יש להתאים את הגודל למספר הדפדפנים ולעומס שלכם.
הטוקן הוא עניין של פריסה, לא פורמליות. בלעדיו, כל מי שמסוגל להגיע ליציאה 3000 שולט בדפדפן ברשת שלכם.
רשת הקונטיינר היא בעיה שלכם. התרחיש שלי רץ על המארח, ולכן הקונטיינר הגיע אליו דרך host.docker.internal (colima ממפה את זה עם --add-host host.docker.internal:host-gateway). אימתתי שהקונטיינר באמת מצליח להגיע אל התרחיש עם curl גולמי לפני שסמכתי על כל מדידה.
הסביבה שלי: colima 0.10.3 (6 CPU / 11.6 GiB) עם Docker 29.2.1 על macOS 26.5.2 arm64. כלי המדידה היה רק Python 3 stdlib. עבור PNG ו-PDF הוא בדק חתימות קובץ, לא תקינות של decoder, ממדים, מספר עמודים, שלמות או נאמנות ויזואלית.
הרצה מינימלית מקבילה משתמשת בתמונה המקובעת, טוקן מפורש, והקצאת הזיכרון המשותף ששימשה כאן:
docker run --rm -p 3000:3000 --shm-size=2g \
  -e TOKEN=replace-with-a-secret \
  ghcr.io/browserless/browserless/chromium:v2.55.0
אחרי ש-/pressure?token=... מגיב, POST /content?token=... מאומת עם גוף JSON שמכיל את כתובת היעד מפעיל את נתיב ה-REST. גם צרכני ייצור צריכים retry מוגבל עם jitter עבור תשובות 429; ניסיון חוזר מיידי רק מתחרה שוב על אותו תור מלא.
מס ה-startup, מפורק לגורמים
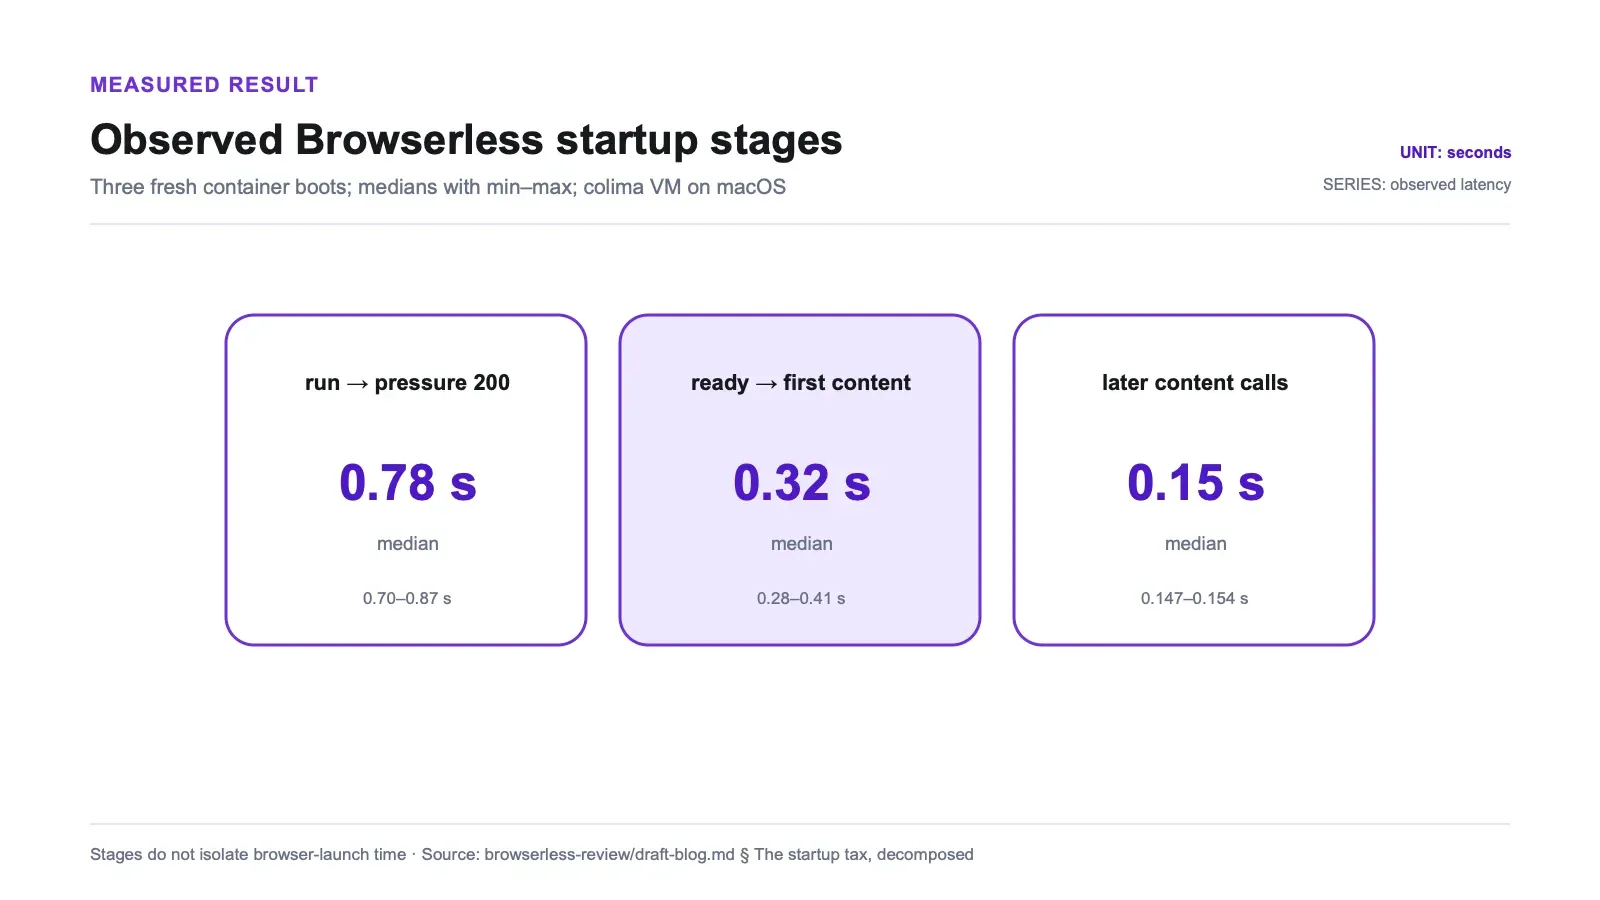
שלוש עליות חדשות של docker run, חציון עם מינימום–מקסימום:
| שלב | חציון | טווח | מה זה באמת |
|---|---|---|---|
docker run → /pressure מחזיר 200 | 0.78 שנ׳ | 0.70–0.87 שנ׳ | נקודת HTTP זמינה; ההפעלה של הדפדפן לא אומתה ע״י הבדיקה הזו |
מוכן → עיבוד ראשון של /content | 0.32 שנ׳ | 0.28–0.41 שנ׳ | בקשה ראשונה שנצפתה: עבודת דפדפן + ניווט + החזרת HTML |
קריאות /content מאוחרות יותר | 0.15 שנ׳ | 0.147–0.154 שנ׳ | זמן השהיה שנצפה לבקשות מאוחרות יותר באותו קונטיינר |
קל מאוד לפרש לא נכון את השורה האמצעית. היא לא מודדת את עליית הדפדפן בבידוד, והיא גם לא מראה ש-Browserless מתחיל את Chrome מהר יותר מספרייה שרצה בתוך התהליך. זו נסיעת HTTP לתוך קונטיינר, בתוספת עבודת דפדפן, ניווט, והעברת תגובה. הפער של בערך 0.17 שנייה בין בקשה ראשונה למאוחרת יכול לכלול השפעות של מערכת קבצים, מערכת הפעלה, Chrome, Node או מטמון של הקונטיינר. מכיוון שבתנאי הסרק תהליכי Chrome היו אפס, וההרצה לא תפסה trace של CDP או ציר זמן של תהליכים עבור הקריאות האלה, אי אפשר לייחס את הפער לשימוש חוזר בדפדפן או לעלות הפעלה “ממוצעת”.
וגם: אלה מספרים מתוך colima VM על macOS. Linux על חומרה פיזית ייתן תוצאות אחרות. אל תציגו 0.78 שנ׳ ל-SRE שלכם כאילו זה מספר שניתן להעברה אחד-לאחד.
בפועל: למצוא את התקרה, משני הצדדים
החוזה CONCURRENT + QUEUED → 429 חוזר בכל מקום אבל כמעט לא מודגם.
ההגדרה: נתיב תרחיש שממתין 5 שניות בצד השרת, כך שכל בקשה תופסת סשן אחד למשך זמן ידוע ואמין. אחר כך שולחים בו-זמנית CONCURRENT + QUEUED + 4 בקשות ובודקים מה חוזר — בעוד Thread נפרד דוגם את /pressure כדי לקרוא את החשבונאות הפנימית של הקונטיינר עצמו.
| תצורה (CONCURRENT, QUEUED) | נשלחו | HTTP 200 | HTTP 429 | שיא /pressure בשרת (running / queued / recentlyRejected) |
|---|---|---|---|---|
| (2, 2) | 8 | 4 | 4 | 2 / 2 / 4 |
| (3, 5) | 12 | 8 | 4 | 3 / 5 / 4 |
| (5, 5) | 14 | 10 | 4 | 5 / 5 / 4 |
שלושה דברים עלו מזה.
התקרה היא בדיוק CONCURRENT + QUEUED, בכל פעם. תשובות מוצלחות היו 4, 8 ו-10 — הסכום המוגדר בכל מקרה. הדחיות היו שוות לעודף, שהיה 4 בכל שלוש הריצות.
התקרה זזה. היא לא קבוע מובנה בתמונה; היא מה שאתם מגדירים. המעבר 4 → 8 → 10 באמצעות שינוי משתני סביבה הוא מה שהופך את זה לשימושי ולא לטריוויה.
ושני האותות בלתי תלויים. קודי הסטטוס של הלקוח הגיעו מתגובות HTTP אמיתיות; /pressure הגיע מהחשבונאות הפנימית של הקונטיינר, שנדגמה על ידי Thread אחר. הם תאמו בשלוש הריצות הקצרות האלה. זה הופך את /pressure לאות מועמד לייצור, אבל לא לחוזה autoscaling מלא: קצב דגימה, סמנטיקת איפוס, איגום של כמה replicas, והתנהגות תחת עומסי mixed ארוכים עדיין דורשים אימות.
ניואנס אחד שמוסתר בספירות הצלחה/כישלון. בקשה שבתור לא נכשלת — היא ממתינה, ולפעמים די הרבה זמן. ב-(2, 2) עם עבודה של 5 שניות, התגובות המוצלחות הגיעו בין 5.7 שנ׳ ל-11.0 שנ׳, חציון 8.3 שנ׳. לכן השהיה מקצה-לקצה הגיעה בערך לשתי תקופות סשן. ההרצה לא תפסה חותמות זמן נפרדות של כניסה וביצוע, ולכן היא לא יכולה לייחס את כל העיכוב לזמן המתנה בתור.
איך זה נראה על עבודה אמיתית
נניח שאתם מרנדרים 4,000 דפי מוצר ל-PDF כל לילה, וכל דף לוקח בערך 5 שניות. אתם מגדירים CONCURRENT=5, QUEUED=5. תקרת התפוקה שלכם היא 5 דפים כל 5 שניות — דף אחד לשנייה — כך שהמשימה נמשכת בערך 67 דקות אם שומרים את הצינור מלא בדיוק. זו אריתמטיקה על בסיס התנהגות שנמדדה, לא benchmark, אבל זו האריתמטיקה שכדאי לעשות לפני הפריסה.
כל בקשה שמגיעה אחרי שכל מקומות הריצה והתור תפוסים יכולה לקבל 429 מיד; שליחה סימולטנית לא מבטיחה איזו בקשה בסדר תפסיד. מריץ משימות צריך להתייחס לתגובה הזו כאל backpressure ולהשתמש ב-retry מוגבל עם jitter. אחרת הוא מסתכן באובדן דפים בזמן שספירת המשימות ברמה הגבוהה ממשיכה — סיכון תפעולי, לא כשל שהודגם ע״י ההרצה הזו.
בפועל: מה באמת רואים בנקודות הקצה
כדי לבדוק נאמנות עיבוד בכנות, דף התרחיש מסתיר את טקסט הסמן שלו מכל מי שלא מריץ דפדפן אמיתי. המחרוזת הגלויה Runtime Injected Marker 88 מורכבת מחלקי JavaScript בזמן טעינה, כך שאין שום מחרוזת רציפה כזו באף בית נתונים שהשרת שולח. fetch סטטי רגיל של אותו דף מחזיר 702 בתים שלא מכילים אף אחד מהסמנים.
| נקודת קצה | תוצאה | בתים |
|---|---|---|
/content | הסמן שהוזרק בזמן ריצה נוכח, וגם שני סמנים סטטיים | 811 |
/scrape על #scrape-me (צומת שהוזרק ע״י JS) | החזיר SCRAPE_TARGET_VALUE_CC | 422 |
/screenshot | תגובה עם חתימת PNG 89 50 4E 47 | 18,621 |
/pdf | תגובה עם חתימת PDF %PDF- | 40,974 |
| כל הארבעה, בלי טוקן | HTTP 401 (לא 403) | — |
העובדה ש-/content מחזיר 811 בתים עם הסמן המוזרק אומרת ש-Chromium אמיתי רינדר את הדף לפני שה-HTML חזר. /scrape חילץ ערך מצומת שלא קיים עד ש-JavaScript רץ. שניהם עבדו בלי קוד אוטומציה בצד הלקוח — POST מאומת אחד.
זה בעצם המסר. באותו סבב בדיקות, crawler סטטי פספס לגמרי את סוג התוכן הזה, וספריות הדפדפן שרצות בתוך התהליך (chromedp, rod, Selenium) תפסו אותו רק אחרי שכתבתי המתנה מפורשת. Browserless תפס אותו עם בקשה בסגנון curl. אתם מחליפים קוד אוטומציה במשקל פריסה.
שני גבולות לטענה הזו. הראיות מכסות את סוגי התוכן של התרחיש שלי, לא סקר של הרשת המודרנית. ו-/unblock, נקודת הקצה נגד זיהוי, נשארה מכוונת בצד — אין לקרוא באף אחת מהתוצאות האלה טענה ליכולת נגד-בוט. גם /function, /download, ו-/performance לא נבדקו.
בפועל: בדיקת שאריות קצרה
ל-Chrome בקונטיינרים יש מוניטין של השארת גופות מאחור, אז הרצתי 30 סשנים סדרתיים עם CONCURRENT=3 וספרתי תהליכים בתוך הקונטיינר.
לפני שסמכתי על משהו, כיילתי את הגלאי. בזמן שסשן היה פעיל, המונה ב-/proc קרא 11 תהליכים ממשפחת chrome (הדפדפן, zygote, GPU, renderers, utilities). זה חשוב: זה מוכיח שהמכשיר באמת רואה את Chrome, ולכן האפס שאחרי הריצה הוא מדידה ולא עיוורון. בדיקת דליפה שמחזירה "0 תהליכים" בלי להוכיח שהיא יודעת לספור, חסרת ערך.
אחרי 30 סשנים: 0 תהליכי chrome, 0 תהליכי zombie. הניצולים היחידים היו dumb-init, node, Xvfb, start.sh, ו-sh. /sessions חזר על 0 במצב סרק.
זיכרון הקונטיינר, מתוך docker stats (המספר שהמפעיל רואה, לא RSS של תהליך בודד):
| אחרי N סשנים | 0 | 5 | 10 | 15 | 20 | 25 | 30 |
|---|---|---|---|---|---|---|---|
| זיכרון קונטיינר (MiB) | 294 | 300 | 301 | 302 | 302 | 303 | 303 |
צמיחה נטו לאורך 30 סשנים: בערך 9.5 MB, והעקומה שנדגמה התיישרה אחרי סשן 10. זה לא תואם דליפה ליניארית פשוטה פר-סשן בחלון הזמן הקצר הזה. חימום של Node הוא הסבר סביר, לא משהו שספירת תהליכים וסדרת הזיכרון הזו יכולות להוכיח.
היקף: 30 סשנים סדרתיים הם soak קטן, לא endurance ולא הרצת concurrency. אזהרות EventEmitter listener הוותיקות בטראקר הבעיות הן בדיוק מסוג הדברים שיכולים לצוץ אחרי שעות ואלפי סשנים, ולא הרצתי את זה. המסקנה הנתמכת היא רק שבחלון הזה, ב-v2.55.0, לא נצברו תהליכי Chrome או zombie.
גבול הזמן-נפילה
TIMEOUT מתועד ככפתור. רציתי לראות אותו מופעל.
| מקרה | זמן החזקת הדף | סטטוס | משך |
|---|---|---|---|
| בתוך התקציב | 2,000 ms | 200 | 2.406 שנ׳ |
| מעבר לתקציב | 15,000 ms | 408 | 5.007 שנ׳ |
עם TIMEOUT=5000, סשן שניסה להחזיק דף במשך 15 שניות חזר עם HTTP 408 אחרי 5.007 שנ׳ במקום להיתקע. תצפית בודדת זו מאשרת אכיפה סמוך לגבול שהוגדר. היא לא חושפת את מימוש הטיימר ולא מוכיחה פינוי של הסלוט; בדיקה חזקה יותר הייתה חוזרת על הניסוי, מתבוננת ב-/sessions וב-/pressure חוזרים למצב סרק, ואז מאשרת שבקשה עוקבת מקבלת את הסלוט שהתפנה.
מלכודת ההגירה: PREBOOT הוא תכונה סתומה, והוא לא אומר לכם
מכל מה שמדדתי, זו התוצאה שהכי הייתי רוצה שמישהו יביא לי לפני שדרוג.
Browserless 2.0.0 הסירה את PREBOOT ואת KEEP_ALIVE — ה-changelog אומר שהם הוסרו כי היו מבלבלים, עשו מעט מדי, וגרמו לבאגים. החלטה סבירה. הבעיה היא מה קורה כשמעתיקים קונפיגורציה של v1 ל-v2, שזה כנראה מסלול השדרוג הנפוץ ביותר.
הרצתי את הקונטיינר עם -e PREBOOT=true ומדדתי מול ברירת המחדל:
| אות | PREBOOT=true | ברירת מחדל, הדגל לא מוגדר |
|---|---|---|
| זמן מוכנות | 0.716 שנ׳ | 0.776 שנ׳ |
| רינדור קר | 0.314 שנ׳ | 0.318 שנ׳ |
| רינדור חם | 0.163 שנ׳ | 0.150 שנ׳ |
| תהליכי Chrome במצב סרק | 0 | 0 |
כל זמני המדידה נמצאים בתוך תחום המינימום–מקסימום של הזרוע הרגילה — זה רעש, לא אפקט. ושום דבר לא חומם מראש: הקונטיינר עם PREBOOT=true יושב בסרק בלי דפדפנים בכלל, בדיוק כמו קונטיינר בלי הדגל. עוד שני אותות, בלי מספר:
/configלא חושף בכלל מפתחpreboot. המפתחות הםconcurrent,queued,timeout,token,maxCPU,maxMemory,retries, ועוד.- אין שגיאה. אין אזהרה. אין כלום בלוגים של הקונטיינר.
אז קונפיגורציית v1 של PREBOOT על v2 היא no-op שקטה בבדיקות הפעלה ולוגים רגילות. המפתח החסר ב-/config יחד עם ההתנהגות שלא השתנתה הם האות שניתן לזהות; Browserless לא פולטת דחייה מפורשת או warning. בדיקת הגירה צריכה לבדוק את ההגדרות שהוחלו, ולא להתייחס ל-startup ירוק כהוכחה שכל משתנה סביבה אכן השפיע.
KEEP_ALIVE הוא המקרה ההפוך, ולא כדאי לערבב ביניהם. הוא הוסר באותו שחרור, אבל הוא לא שקט — בדיקה נקודתית של הקונטיינר מראה שהוא רושם Environment variable of "KEEP_ALIVE" is deprecated and ignored. ממש ב-stdout. זו אזהרה תקינה למפעיל. לא העברתי את KEEP_ALIVE דרך אותו harness מדוד ש-PREBOOT עבר, ולכן אני מציג את זה כבדיקה ולא כמדידה. אבל הכיוון ברור מספיק כדי להיות משמעותי: רק PREBOOT היא המלכודת השקטה. Browserless כנה יותר לגבי KEEP_ALIVE ממה שסיכום גנרי של "v2 מתעלם מדגלי v1" היה נותן לה קרדיט.
יתרונות וחסרונות
יתרונות
- בקרת כניסה שמתנהגת בדיוק כפי שמתועד וניתנת להזזה עם הקונפיגורציה — הוכח בשלוש תקרות שונות, גם בקודי הסטטוס של הלקוח וגם בחשבונאות של השרת עצמו בו-זמנית.
/pressureתאם לספירות client-visible של running, queued, ו-rejected בשלוש ריצות קצרות; אפשר להתייחס אליו כאות קלט מועמד ל-autoscaling ולהתרעות.- רינדור אמיתי של Chromium בלי קוד אוטומציה בצד הלקוח: POST מאומת אחד חשף DOM שהוזרק ב-JS ואי אפשר לראותו ב-fetch סטטי של אותו דף.
- לא נצברו תהליכי Chrome בהרצה סדרתית של 30 סשנים; הספירה אחרי הריצה הייתה 0 תהליכי Chrome ו-0 זומבים.
- ניסוי אחד של
TIMEOUTהחזיר 408 ב-5.007 שנ׳ מול תקציב של 5.000 שנ׳; פינוי הסלוט וה-cleanup לא אומתו בנפרד. - אימות מופעל כברירת מחדל: כל ארבע נקודות ה-REST מחזירות 401 בלי טוקן.
docker runאחד לשירות מוכן בכ-0.78 שנ׳, ורינדור ראשון 0.32 שנ׳ אחר כך.
חסרונות
- תמונה בגודל 4.34 GB. זה המחיר הכנה, והוא מופיע ברג'יסטרי, ב-cache של ה-CI, ובזמן ה-cold deploy.
- SSPL-1.0 או רישיון מסחרי של Browserless. צריך לבחון את התנאים המדויקים מול מודל הפריסה וההפצה שלכם.
PREBOOTמ-v1 מתקבל ומושלך בשקט ב-v2 — בלי שגיאה, בלי warning, בלי מפתח/config.- אתם מפעילים שירות, לא מוסיפים תלות: קונטיינר, טוקן, נתיב רשת, תקרת כניסה, ואחריות לשדרוגים.
- בקשות בתור דחפו את זמן מקצה-לקצה לכמעט שתי תקופות סשן בהרצה
(2, 2); זמן ההמתנה בתור לא נמדד בנפרד. - תזמון ה-REST שנמדד כולל קפיצת HTTP ואינו מבודד את עלות עליית הדפדפן או מוכיח שימוש חוזר בדפדפן.
מי כן צריך להריץ את זה, ומי לא
Browserless מצדיק את המשקל שלו כשיותר מדבר אחד צריך דפדפן. שירות רינדור משותף לכמה אפליקציות, צוות שרוצה צילומי מסך ו-PDF מאחורי endpoint HTTP במקום תלות ב-Chrome בכל שירות, צינור משימות שבאמת צריך תקרת קיבולת עם backpressure שהוא יכול למדוד — זו הצורה שהפתרון הזה מתאים לה. אם אתם כבר מריצים Docker ומישהו אחראי על הפריסה, הסיפור התפעולי ברור: כניסה צפויה, backpressure שניתן לצפייה, וללא הצטברות של תהליכי Chrome או zombie שנצפתה בבדיקה הסדרתית של 30 סשנים.
זה גם נכון אם האלטרנטיבה היא שכל שירות ב-stack שלכם מתקין Chromium משלו. ריכוז זה לקונטיינר אחד עם טוקן ותקרה הוא חילופי ארכיטקטורה טובים לגמרי.
דלגו עליו אם אתם כותבים סקריפט אחד. להוריד 4.3 GB ולהרים קונטיינר כדי שקובץ Python יחיד יוכל לאסוף דף מרונדר זה הרבה טקס בשביל עבודה קטנה — ספריית דפדפן בתוך התהליך עושה את זה בלי שירות נפרד. דלגו עליו אם תנאי SSPL לא מתאימים למוצר המסחרי שלכם ואי אפשר לפתור אותם. דלגו עליו אם מה שאתם באמת רוצים הוא דפדפן שמגיע חם בלי עלות cold, כי PREBOOT לא ייתן לכם את זה ב-v2. ודלגו עליו אם הבעיה האמיתית שלכם היא התמודדות עם anti-bot, כי זה יושב בנקודת קצה שבכוונה לא בדקתי ולא אחתום עליה.
חלופות, כולל איפה Thunderbit נכנסת
ההשוואה הנכונה אינה Browserless מול קונטיינר אחר. היא על איפה הדפדפן חי ומי אחראי להשאיר אותו חי.
סקירה קשורה: Browsertrix Crawler review.
סקירה קשורה: chromedp review.
| ספריית דפדפן (chromedp, rod, Selenium, Playwright) | Browserless self-hosted | Thunderbit managed extraction | |
|---|---|---|---|
| איפה הדפדפן רץ | בתוך התהליך שלכם | בתוך הקונטיינר שלכם | על התשתית של מישהו אחר |
| עלות התקנה | התקנת חבילות | תמונת 4.3 GB + קונטיינר + טוקן | מפתח API |
| תזמון שנמדד כאן | לא נמדד במאמר הזה | 0.32 שנ׳ לרינדור ראשון אחרי זמינות HTTP; קריאות מאוחרות יותר 0.15 שנ׳ חציון | לא נמדד במאמר הזה |
| מה כותבים | קוד אוטומציה עם explicit waits | POST מאומת אחד | קריאת HTTP אחת |
| מה מתקבל | מה שאתם מתכנתים | HTML, תגובות PNG/PDF לפי חתימה, וצמתים שנשלפו | JSON מובנה או Markdown ייעודיים למוצר |
| מגבלת קיבולת | המכונה שלכם | CONCURRENT + QUEUED, ואז 429 | התוכנית של הספק |
| מי בכוננות | אתם | אתם | הם |
אם אתם רוצים דפדפן בתוך התהליך שלכם ולא אכפת לכם לכתוב waits, ספרייה היא קלה יותר ואין פריסה נפרדת. כתבתי על הצד הזה ב-השוואת Playwright מול Puppeteer וב-סיכום פרויקטי קוד פתוח לגריפת נתונים.
אם אתם לא רוצים להפעיל דפדפן בכלל, Thunderbit שלנו היא אלטרנטיבה מנוהלת אחת. Browserless מחזיר חומר מרונדר שהקוד שלכם מפרש; Thunderbit יכולה להחזיר Markdown או נתונים תואמי-סכמה בזמן שספק השירות מחזיק את תשתית הרינדור. המאמר הזה לא מדד את ה-latency, הקיבולת, התנהגות הכשל, איכות החילוץ או העלות של Thunderbit, ולכן הטבלה מתארת גבולות אחריות ולא השוואת ביצועים.
קריאה קשורה מאותו סבב בדיקות: Crawl4AI review and alternative מכסה צינור Markdown מבוסס דפדפן שאתם מריצים בעצמכם, ו-סקירת כלי web scraping ממפה את הקטגוריה הרחבה יותר.
נסו את Thunderbit לחילוץ נתוני רשת
מסקנה
האם כדאי להריץ Browserless? כן, אם כמה צרכנים צריכים עבודת דפדפן, יש מישהו שיכול להפעיל את הקונטיינר, ובדיקת הרישוי שלכם מאשרת את מודל הפריסה. בשלוש ריצות כניסה סינתטיות, מספר הבקשות שהתקבלו תאם ל-CONCURRENT + QUEUED, עודף קיבל 429, ו-/pressure תאם לספירות הנראות ללקוח. בבדיקה סדרתית נפרדת של 30 סשנים, לא נצברו תהליכי Chrome או zombies. ניסוי זמן-נפילה אחד החזיר 408 סמוך לגבול המוגדר. אלו תצפיות שימושיות ומוגבלות, לא הבטחות אוניברסליות.
אבל צריך לתמחר את המחויבות ביושר. זו תמונה של 4.34 GB ושירות שאתם מפעילים, לא תלות שאתם מוסיפים; הבדיקה הזו לא קבעה השוואת מהירות מול ספריית דפדפן שרצה בתוך התהליך. מה שהוא קונה לכם הוא דפדפן שאפשר להקציב: תקרה ידועה ו-backpressure מדיד. בבדיקה הסדרתית של 30 סשנים לא נצפתה הצטברות של תהליכי Chrome או zombies. המחירים הם משקל פריסה ורישיון שצריך לקרוא. אם אתם מרנדרים כמה עמודים מסקריפט אחד, העסקה הזו לא משתלמת. אם אתם מפעילים שכבת רינדור שעליה תלויים כמה שירותים, כן — רק תבדקו את משתני הסביבה מ-v1 בדרך פנימה, כי PREBOOT יישב שם כאילו הוא עובד, בזמן שהוא לא עושה כלום.
נסו את Thunderbit לחילוץ נתוני רשת Get Started Free
שאלות נפוצות
האם Browserless מאיץ headless Chrome?
הבדיקה הזו לא יכולה לענות על כך. נקודת הקצה HTTP הפכה לזמינה 0.78 שנ׳ אחרי docker run; הקריאה הראשונה ל-/content לקחה אז 0.32 שנ׳, וקריאות מאוחרות יותר באותו קונטיינר לקחו בערך 0.15 שנ׳. המספרים האלה כוללים קפיצת HTTP, עבודת דפדפן, ניווט והעברת תגובה. ההרצה לא בודדה את זמן העלייה, לא עקבה אחרי שימוש חוזר בתהליכים, ולא פרסמה benchmark מקביל בתוך התהליך. השתמשו ב-Browserless כגבול שירות משותף וכבקרת כניסה, ואז benchmark את נתיב ההשהיה שלכם בעצמכם.
מה קורה כשעוברים את מגבלת המקביליות של Browserless?
מקבלים מיד HTTP 429. התקרה היא בדיוק CONCURRENT + QUEUED, ואימתתי זאת בשלוש תצורות: (2,2) קיבלה 4 ודחתה 4, (3,5) קיבלה 8 ודחתה 4, (5,5) קיבלה 10 ודחתה 4. נקודת הקצה /pressure של השרת דיווחה בכל פעם על ספירות תואמות של running, queued, ו-recentlyRejected. חשוב לדעת: בקשות שממתינות בתור לא נכשלות — הן מחכות — וב-(2,2) עם עבודה של 5 שניות, התגובות המוצלחות לקחו בין 5.7 שנ׳ ל-11.0 שנ׳. בנו את הלקוח כך שיתייחס ל-429 כ-backpressure עם retry ו-backoff.
האם PREBOOT עדיין עובד ב-Browserless v2?
לא. PREBOOT הוסר ב-2.0.0, ו-v2 מקבלת -e PREBOOT=true בלי שום שגיאה או warning, תוך שהיא לא עושה איתו כלום. אישרתי את חוסר הפעולה בשלוש דרכים: ההשהיה הייתה בלתי ניתנת להבחנה מהברירת מחדל, לקונטיינר PREBOOT=true במצב סרק היו 0 תהליכי chrome ממתינים, ו-/config לא חושף בכלל מפתח preboot. אם העברתם קונפיגורציית v1, המופעים שלכם לא חוממו מראש. שימו לב ש-KEEP_ALIVE, שהוסר באותו שחרור, כן רושם אזהרה של "deprecated and ignored" — כך שבעיית הכשל השקט ייחודית ל-PREBOOT.
האם Browserless חינמי לשימוש מסחרי? המאגר מציע SSPL-1.0 או רישיון מסחרי של Browserless, אבל המאמר הזה לא ממפה תרחישים מסחריים או סגורי-קוד ספציפיים לאף אחת מהאפשרויות. עברו על ה-LICENSE העדכני ועל הנחיות הפריסה הרשמיות, ואז תנו לאדם שאחראי על רישוי תוכנה לבחון את מודל הפריסה וההפצה שלכם.
האם Browserless משאיר תהליכי Chrome זומבי מאחור?
לא נצברו כאלה בחלון הקצר שנבדק. אחרי 30 סשנים סדרתיים היו בקונטיינר 0 תהליכי Chrome ו-0 זומבים, ורק dumb-init, node, Xvfb, start.sh, ו-sh נשארו. הגלאי ספר 11 תהליכים ממשפחת chrome בזמן שסשן היה פעיל, כך שהוא לא היה עיוור. זיכרון הקונטיינר עלה מ-294 MiB ל-303 MiB ואז התייצב בדגימות. זו לא תוצאה של endurance של שעות, concurrency, או אלפי סשנים.




