Le trafic automatisé des bots représente désormais plus de 53 % de tout le trafic web — davantage que celui généré par les humains. Si tu collectes des données, gères des comptes ou vérifies des publicités dans plusieurs régions, tu évolues dans un environnement où les systèmes anti-bot sont conçus spécifiquement pour te repérer.
Pourtant, la plupart des guides sur les « proxies statiques vs rotatifs » résument le sujet à un simple tableau à deux colonnes, puis s’arrêtent là. Ils oublient le troisième concept clé (les sessions sticky), ignorent les mécanismes réels de détection et ne font jamais le calcul du coût à grande échelle. J’ai passé beaucoup de temps à comparer des fournisseurs de proxies et des API de scraping IA pour nos besoins chez Thunderbit, et la réalité est bien plus complexe — et plus intéressante — que ce que la plupart des listes d’outils laissent entendre. Ce guide explique la vraie distinction à trois voies que beaucoup d’articles mélangent, comment les systèmes anti-bot détectent réellement le trafic proxy, combien coûte l’exécution de 50 000 pages/jour selon le type de proxy, et 9 outils que j’envisagerais sérieusement d’utiliser. Certains sont de vrais fournisseurs de proxies, d’autres des API de scraping, et l’un d’eux (le nôtre) supprime complètement la gestion des proxies.
Essayez Thunderbit pour le scraping IA
Proxy statique vs rotatif vs sticky : la distinction à trois niveaux que la plupart des guides ratent
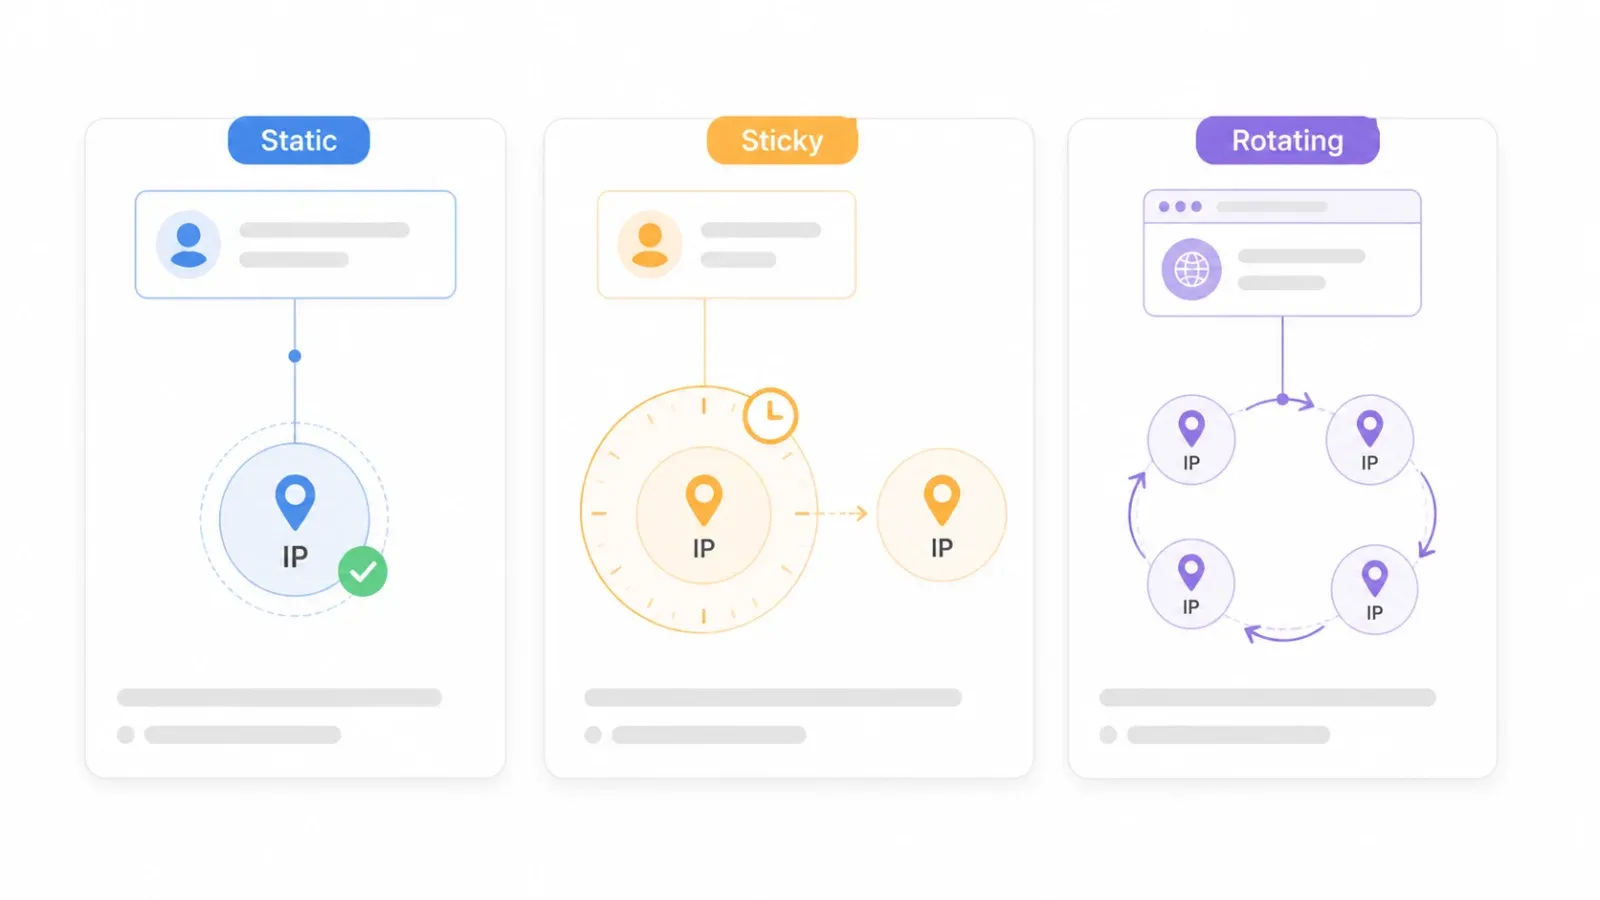
La plupart des articles de comparaison de proxies présentent le sujet comme un choix binaire : statique ou rotatif. Cette vision est incomplète et conduit à de mauvais choix d’achat. Il existe en réalité trois comportements distincts de proxy, chacun répondant à des usages différents.
Proxy statique : la même adresse IP, en continu, jusqu’à ce que tu la changes manuellement ou que la location expire. Imagine ta connexion internet à la maison — la même adresse tous les jours. Utile lorsqu’une plateforme s’attend à voir la même identité dans la durée (gestion de comptes, contenu géobloqué, suivi de classement).
Session sticky : la même IP pendant une période configurable — 10 minutes, 30 minutes, parfois jusqu’à 24 heures selon le fournisseur — puis bascule vers une nouvelle IP. Une session sticky assure une continuité temporaire ; un proxy statique assure une continuité permanente. Decodo (anciennement Smartproxy) décrit les sessions sticky comme le maintien d’une IP pendant 1, 10, 30, 60 minutes, ou selon des intervalles personnalisés allant jusqu’à 24 heures.
Proxy rotatif : une nouvelle IP à chaque requête, ou toutes les quelques secondes. Anonymat maximal pour les gros volumes, mais aucune continuité de session, sauf si tu ajoutes une couche sticky par-dessus.
La distinction en tableau :
| Attribut | Proxy statique | Session sticky | Proxy rotatif |
|---|---|---|---|
| L’IP change ? | Jamais (même IP indéfiniment) | Après une durée définie (ex. 10–30 min) | À chaque requête ou toutes les quelques secondes |
| Persistance de session | Permanente | Temporaire (TTL configurable) | Aucune |
| Cas d’usage typique | Gestion de comptes, contenu géobloqué | Scraping en plusieurs étapes (connexion → navigation → extraction) | Scraping à gros volume, vérification publicitaire |
| Risque de détection | Plus élevé avec le temps (la même empreinte accumule de l’historique) | Modéré | Le plus faible pour la détection basée sur l’IP (si residential) |
| Modèle de coût | Généralement par IP/mois | Inclus dans les offres residential/mobile facturées au Go | Par Go, par requête ou au forfait |
Pourquoi c’est important pour choisir un outil ? Si tu dois te connecter à une plateforme, ajouter des articles à un panier ou remplir un formulaire en plusieurs étapes, il te faut des sessions sticky — pas une rotation pure (qui casserait ta session), et pas forcément une IP statique permanente (souvent excessive et coûteuse). Sur r/proxies, les utilisateurs confondent souvent ces catégories et demandent si les sessions sticky se comportent comme des « proxies residential rotatifs classiques » ou comme des IP statiques. La réponse : ni l’un ni l’autre. C’est une troisième catégorie.
Comment les systèmes anti-bot détectent réellement les proxies statiques vs rotatifs
Chaque article comparatif mentionne un « risque de détection » dans une cellule de tableau. Presque aucun n’explique comment la détection fonctionne en pratique. Et c’est essentiel, car la méthode de détection détermine si la rotation d’IP est vraiment utile.
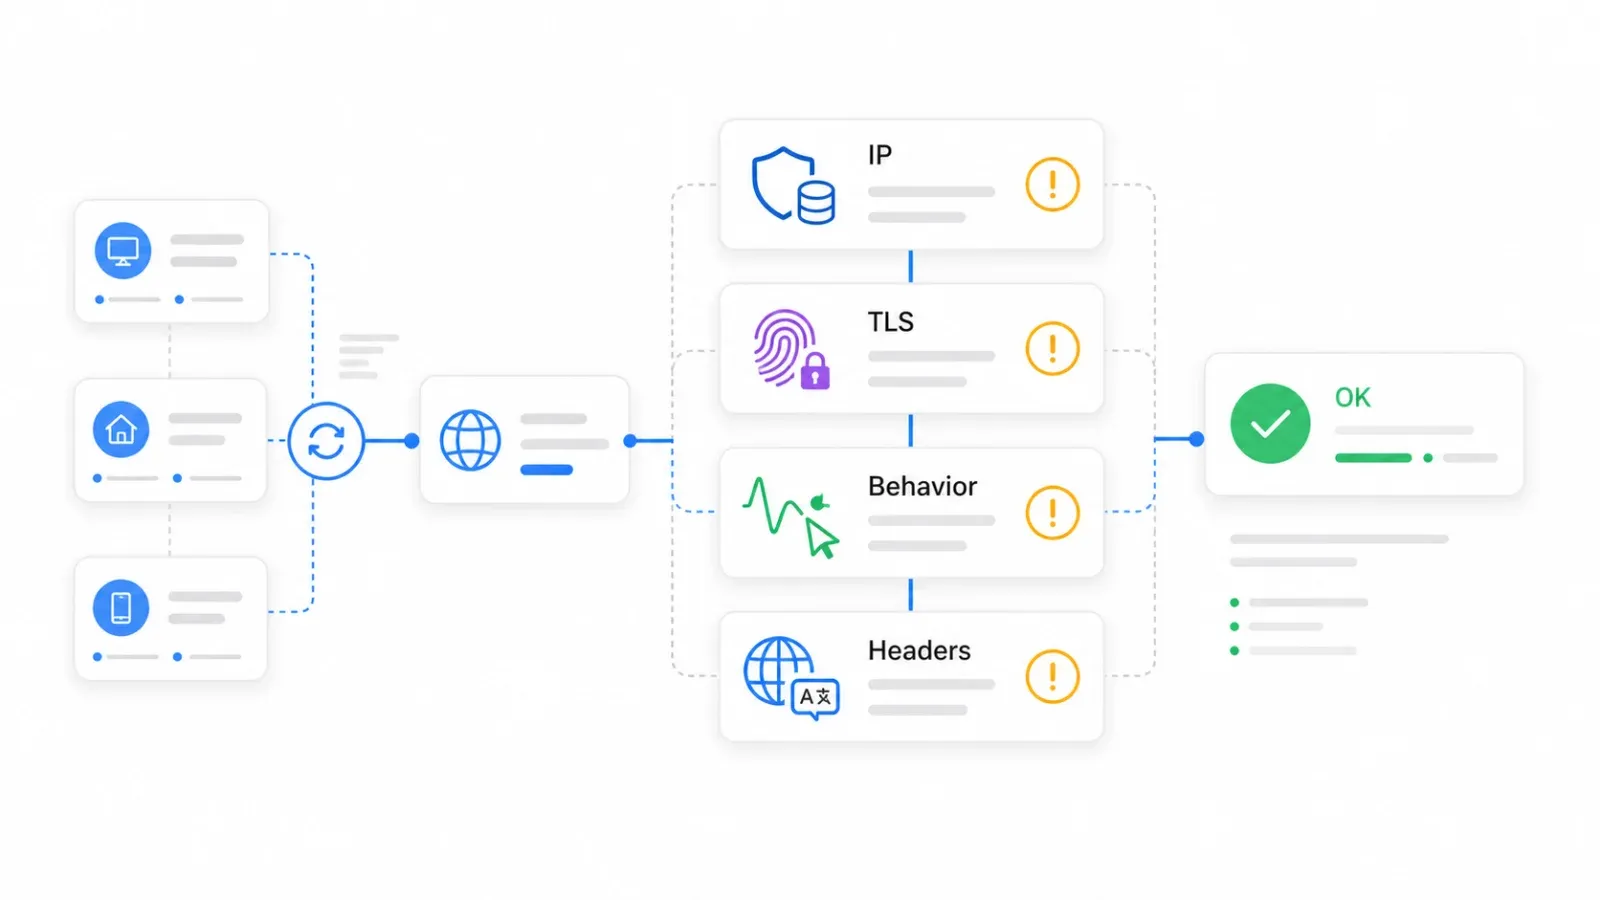
Les systèmes anti-bot modernes utilisent au moins quatre couches, et faire tourner ton IP n’en traite qu’une seule.
Couche 1 : bases de données de réputation IP
Les plages d’IP datacenter proviennent d’ASNs cloud et hébergés — Amazon, Google, DigitalOcean, etc. Les fournisseurs anti-bot maintiennent des bases qui pré-étiquettent ces plages. Les IP residential et mobile démarrent avec un score de confiance plus élevé parce qu’elles ressemblent à du trafic utilisateur normal. La documentation bot de Cloudflare s’appuie sur des bot scores de 1 à 99, où les scores faibles indiquent une forte probabilité d’automatisation. Si ton IP provient d’une plage datacenter connue, tu pars avec un score de confiance faible avant même d’envoyer la moindre requête.
Couche 2 : fingerprinting TLS / JA3 / JA4
C’est la partie que la plupart des acheteurs de proxies ne connaissent pas. Quand ton client initie une connexion HTTPS, la négociation TLS révèle des caractéristiques du logiciel qui effectue la requête. La documentation JA3/JA4 de Cloudflare explique que ces empreintes identifient les clients TLS à partir des caractéristiques de connexion et servent d’identifiants stables, même en changeant d’IP de destination. En clair : si ta requête prétend venir de Chrome sur macOS mais que la poignée de main TLS ressemble à celle d’une bibliothèque Python requests, changer d’IP ne corrige rien. L’empreinte te suit.
Couche 3 : signaux comportementaux
Rythme des requêtes, ordre de navigation, mouvements de souris (ou absence), schémas de connexion et façon dont les sessions évoluent comme une navigation humaine. La documentation de détection de DataDome décrit des modèles comportementaux capables de repérer des anomalies comme trop de tentatives de connexion ou des vitesses de navigation irréalistes. Une étude arXiv de 2026 sur les agents de navigation IA a montré que les empreintes comportementales étaient plus discriminantes que les empreintes de navigateur pour distinguer les agents IA des humains.
Couche 4 : cohérence des en-têtes et de l’environnement
Une étude de mesure académique de 2026 portant sur 10 000 sites a révélé que 75 % des blocages liés à Chromium headless étaient dus à des signaux au niveau des en-têtes בלבד. Si ton en-tête Accept-Language indique en-US alors que ton IP est géolocalisée à São Paulo, cette incohérence devient un signal. Si ton user-agent ne correspond pas à ton empreinte TLS, c’en est un autre.
À retenir : les IP rotatives réduisent les limites de débit basées sur l’IP et l’accumulation de réputation. Elles ne résolvent pas les incompatibilités de fingerprint TLS, les anomalies comportementales ou les incohérences d’en-têtes. C’est précisément pour cette raison que les outils de scraping centrés sur les API — qui gèrent le rendu, la cohérence des empreintes et les CAPTCHA au niveau de l’infrastructure — sont devenus une alternative concrète à la gestion manuelle de ces quatre couches.
Évitez la gestion des proxies avec le scraping IA Get Started Free
Le vrai coût des proxies statiques vs rotatifs à grande échelle
Le prix est l’aspect que la plupart des guides évitent ou résument avec un vague « abordable ». Pourtant, le modèle de facturation + le poids des pages + le taux de blocage changent radicalement le coût total.
Le Web Almanac 2025 de l’HTTP Archive indique qu’une page d’accueil médiane pèse 2,86 Mo sur desktop. Si tu rends des pages complètes via un proxy residential facturé au volume à hauteur de 50 000 pages/jour, cela représente environ 143 Go/jour, soit environ 4,29 To/mois. À 5–15 $/Go pour de la bande passante residential rotative, on arrive à 21 450–64 350 $/mois avant les relances et les requêtes bloquées.
Ce chiffre surprend presque tout le monde la première fois.
C’est aussi pourquoi les scrapeurs expérimentés bloquent les images, polices, vidéos et scripts inutiles dans les navigateurs headless — une optimisation pratique qui peut réduire la bande passante de 60 à 80 %. Même avec cette réduction, on reste autour de 858 Go à 1,72 To/mois, soit 4 290 à 25 740 $/mois aux tarifs residential.
Les requêtes HTTP directes ou au niveau API sont bien plus légères. Une estimation de terrain situe les requêtes HTTP directes entre 50 et 200 Ko par page, contre 1,5 à 8 Mo pour un rendu headless complet. À 200 Ko/page, 50 000 pages/jour ne représentent qu’environ 300 Go/mois.
| Type de proxy | Modèle de facturation | Fourchette de prix typique | Coût estimé pour 50K pages/jour (rendu complet) | Remarques |
|---|---|---|---|---|
| Datacenter (statique) | Par IP/mois | ~0,50–2 $/IP | Faible (forfait, pas de mesure au Go) | Risque élevé de blocage sur les sites protégés |
| ISP / residential statique | Par IP ou par Go | ~3–8 $/Go | Modéré à élevé | Idéal pour la continuité et les cibles difficiles |
| Residential rotatif | Par Go | ~5–15 $/Go | Très élevé sans optimisation de bande passante | Référence pour l’anonymat ; les coûts explosent à volume |
| Datacenter rotatif | Par requête ou par Go | ~0,50–3 $/Go | Faible à modéré | Utile pour les cibles peu protégées |
| API de scraping IA (ex. Thunderbit) | Par requête / crédits | Variable selon le plan | Prévisible (pas de métrique de bande passante) | Renvoie des données structurées, pas du HTML brut |
C’est exactement pourquoi, sur les forums, on voit souvent des questions sur la rotation manuelle de proxies ISP statiques comme alternative moins chère à la bande passante residential facturée au Go. Le compromis anonymat/coût est bien réel, et la bonne réponse dépend du niveau de sophistication anti-bot de ta cible et de ton volume.
Choisissez votre type de proxy en moins de 60 secondes
Aucun des six articles concurrents les mieux classés n’inclut d’arbre de décision. Voici la logique sous forme de décision pas à pas :
-
Avez-vous besoin de la même IP sur de longues sessions ? → Oui → Proxy statique (ISP/residential statique pour les cibles difficiles, datacenter pour les plus faciles)
-
Non → Scrapez-vous plus de 10 000 pages ? → Oui → Proxy rotatif (residential pour les cibles difficiles, datacenter pour les cibles permissives)
-
Avez-vous besoin d’une persistance de session pour des tâches en plusieurs étapes (connexion, panier, formulaires) ? → Oui → Session sticky (residential, avec TTL configurable)
-
Voulez-vous éviter complètement la gestion des proxies ? → Oui → API de scraping IA (ex. Thunderbit API/MCP)
La même logique, présentée en tableau de scénarios :
| Votre situation | Approche la plus adaptée |
|---|---|
| Besoin d’un accès IP brut (gestion de comptes, tests géographiques) | Proxies statiques ou rotatifs gérés en interne |
| Extraction de données structurées sur des sites lourds en JavaScript | API de scraping IA (ex. Thunderbit /extract) |
| Crawling massif pour RAG / indexation | API de distillation IA (ex. Thunderbit /distill) + traitement par lots |
| Scraping en plusieurs étapes avec connexion | Proxies navigateur avec sessions sticky |
| Budget serré, cibles peu protégées | Proxies datacenter (les moins chers) |
La plupart des lecteurs entrent dans l’une de ces cinq catégories. Identifie la tienne avant de passer à la liste des outils.
Ce que nous avons recherché dans ces 9 outils
Chaque outil de cette liste a été évalué selon sept critères :
- Types de proxies proposés : couvre-t-il les proxies statiques, rotatifs, ISP, residential, mobile — ou masque-t-il complètement la couche proxy ?
- Taille du pool d’IP : plus le pool est grand, meilleure est la qualité de rotation et plus faible est le risque de réutilisation. Mais les chiffres annoncés sont marketing et rarement audités de façon indépendante.
- Modèle tarifaire : par IP, par Go, par requête, au forfait ou au crédit. Le modèle de facturation compte autant que le prix unitaire.
- Gestion anti-bot / détection : résolution de CAPTCHA intégrée, gestion des fingerprints, ou rien de plus que la diversité d’IP.
- Support des sessions sticky : TTL configurable, durée maximale, fiabilité.
- Meilleure adéquation d’usage : scraping, gestion de comptes, SEO, vérification publicitaire — chaque outil a son point fort.
- Facilité d’intégration : qualité de l’API, disponibilité des SDK, ergonomie du tableau de bord, options no-code, support MCP/CLI.
La liste commence avec Thunderbit (notre approche d’API de scraping IA), puis couvre neuf fournisseurs de proxies dans un ordre approximatif de taille et de profondeur fonctionnelle.
1. Thunderbit : supprimez la gestion des proxies avec une API de scraping IA
Thunderbit n’est pas un fournisseur de proxies. C’est la solution quand on comprend que les proxies ne sont qu’un moyen, et que le vrai objectif est d’obtenir des données structurées.
Nous avons conçu Thunderbit comme une API de scraping IA qui gère les proxies, les mesures anti-bot, les CAPTCHA et le rendu JavaScript au niveau de l’infrastructure. Tu décris les données souhaitées ; tu reçois en retour un résultat propre et structuré. Pas de configuration de pool proxy, pas de logique de rotation, pas d’usurpation de fingerprint.
Pour les développeurs (cas d’usage principal) :
- API ouverte :
POST /distilltransforme une page en Markdown propre.POST /extractprend un schéma JSON et renvoie des champs structurés. Les deux prennent en charge les optionsrenderModeet les tâches par lots (jusqu’à 100 URL de manière asynchrone avec webhooks). - Serveur MCP : Claude, Cursor et d’autres agents IA peuvent appeler
thunderbit_extractetthunderbit_distillpendant leur tâche. La couche proxy est invisible — l’agent obtient simplement les données. - CLI :
npx @thunderbit/thunderbit-cli extract <url> --schema <json>pour les workflows terminal, CI et cron. Le mode batch prend en charge jusqu’à 100 URL pour distill / 50 URL pour extract. - Tarification par crédits : Distill = 1 crédit/URL. Extract = 20 crédits/URL. Pas de facturation au Go. Le plan Starter commence à 15 $/mois avec 500 crédits.
Pour les utilisateurs non techniques, l’extension Chrome permet un scraping en 2 clics avec AI Suggest Fields, et l’export vers Excel, Google Sheets, Airtable ou Notion. Aucune configuration proxy n’est nécessaire — le scraping cloud de Thunderbit gère la rotation des IP et le rendu.
Idéal pour : l’extraction de données structurées depuis des sites lourds en JS, les pipelines RAG/indexation, les workflows d’agents IA et toute personne qui préfère consacrer son temps à l’analyse plutôt qu’à l’infrastructure proxy.
Limites : ce n’est pas un fournisseur de proxies bruts. Si tu as besoin d’un accès IP direct pour la gestion de comptes, les tests géographiques ou les bots sneakers, un proxy traditionnel est un meilleur choix.
Tarification : formule gratuite disponible ; Starter à partir d’environ 15 $/mois. Consulte Thunderbit Pricing pour les offres à jour.
Pour en savoir plus sur le fonctionnement du scraping web IA en coulisses, consulte notre guide sur le scraping web IA.
2. Bright Data : le plus grand pool d’IP pour les proxies statiques et rotatifs

Bright Data est l’une des suites de proxies les plus anciennes et les plus complètes du marché. Leur chiffre phare est de plus de 400 M d’IP residential rotatives dans 195 pays, avec ciblage ville/État/code postal/ASN, plus plus de 1,3 M de proxies ISP statiques.
- Types de proxies : residential (rotatif), ISP/residential statique, datacenter (statique et rotatif), mobile
- Pool d’IP : 400 M+ residential, 1,3 M+ ISP — le plus grand pool annoncé publiquement
- Gestion anti-bot : produit Web Unlocker avec résolution de CAPTCHA et gestion des fingerprints ; Browser API pour le rendu headless
- Sessions sticky : oui, configurables (généralement 10–30 min pour residential)
Tarification : residential en PAYG régulier à 8 $/Go, avec des tarifs promo autour de 4 $/Go pour des engagements plus importants. Datacenter à partir d’environ 0,90 $/IP. ISP à partir d’environ 1,30 $/IP. La structure tarifaire est flexible mais peut devenir rapidement coûteuse à grande échelle.
Idéal pour : les entreprises qui ont besoin d’une diversité massive d’IP, d’un ciblage géographique précis et d’une suite produit complète. Des équipes disposant du budget et des ressources techniques pour naviguer dans un tableau de bord complexe.
Inconvénients : le tableau de bord demande un temps d’apprentissage. La tarification peut être élevée pour les petites équipes — si tu scrape 50 000 pages/jour via des proxies residential, la facture de bande passante grimpe vite. Les utilisateurs des sites d’avis citent souvent la complexité des prix.
3. Oxylabs : proxies premium rotatifs et statiques pour le scraping à grande échelle
Oxylabs est un autre fournisseur de niveau entreprise avec un fort accent sur l’infrastructure de web scraping. Ils proposent des produits residential, residential statique/ISP, datacenter, mobile, Web Unblocker et Scraper API.
- Types de proxies : residential (rotatif), ISP/residential statique, datacenter (statique et rotatif), mobile
- Pool d’IP : grand pool entreprise (le chiffre exact varie selon le produit)
- Gestion anti-bot : Web Unblocker et Scraper APIs avec rendu et prise en charge des CAPTCHA
- Sessions sticky : la durée standard des sessions residential est de 10 minutes, avec d’autres configurations possibles ; certaines offres vont jusqu’à 24 heures
Tarification : Residential à partir de 6 $/Go, avec baisse à 3,50 $/Go à partir de 1 To. Les proxies ISP sont facturés par IP/mois. Positionnement premium.
Idéal pour : les grandes entreprises avec d’importants besoins de collecte de données, les équipes qui veulent des solutions de scraping gérées en plus de l’accès proxy brut.
Inconvénients : prix plus élevés que les alternatives mid-market. Peut être disproportionné pour les projets de petite à moyenne taille.
4. Smartproxy (Decodo) : proxies rotatifs abordables et mise en route simple
Smartproxy, désormais rebaptisé Decodo, est un fournisseur mid-market populaire, réputé pour ses prix compétitifs et son tableau de bord convivial. Beaucoup d’utilisateurs cherchent encore « Smartproxy », d’où la présence des deux noms.
- Types de proxies : residential (rotatif), ISP/residential statique, datacenter, mobile
- Pool d’IP : 115 M+ d’IP residential
- Gestion anti-bot : produits Site Unblocker et scraping API disponibles
- Sessions sticky : 1, 10, 30, 60 minutes, ou intervalles personnalisés jusqu’à 24 heures sur residential, datacenter, ISP et mobile
Tarification : Residential à partir de 2 $/Go au palier 3 Go, puis baisse avec le volume. Residential statique/ISP à partir d’environ 3,33 $/IP au palier bas. Compétitif au regard des fonctionnalités.
Idéal pour : les petites et moyennes équipes qui veulent un bon équilibre entre prix et fonctionnalités, ainsi que les acheteurs de proxies débutants à la recherche d’une prise en main simple.
Inconvénients : pool d’IP plus petit que Bright Data ou Oxylabs. Certains utilisateurs signalent des vitesses irrégulières selon la cible et le pool.
5. IPRoyal : proxies statiques et rotatifs abordables avec une tarification flexible
IPRoyal s’est taillé une place comme option économique, avec un argument de vente unique : le trafic residential sans expiration. Achète de la bande passante et utilise-la quand tu veux.
- Types de proxies : residential (rotatif), ISP/residential statique, datacenter, mobile, proxies sneakers
- Pool d’IP : en croissance ; la taille exacte varie selon les sources
- Gestion anti-bot : basique — s’appuie sur la qualité des IP plutôt que sur une résolution intégrée des CAPTCHA ou la gestion des fingerprints
- Sessions sticky : jusqu’à 7 jours pour residential
Tarification : Residential à partir de 7 $/Go, réduit à 1,75 $/Go en volume. Le modèle de trafic sans expiration signifie que tu ne perds pas la bande passante non utilisée à la fin du mois.
Idéal pour : les utilisateurs soucieux de leur budget, les usages variables ou saisonniers, et les cas d’usage sneaker / e-commerce.
Inconvénients : pool d’IP plus petit que chez les fournisseurs premium. Fonctionnalités anti-détection intégrées limitées. Moins adapté aux cibles fortement protégées.
6. SOAX : proxies rotatifs ciblés géographiquement avec filtrage granulaire
SOAX est particulièrement performant lorsque tu as besoin d’un ciblage hyper-local. Leur filtrage va jusqu’au pays, à la région, à la ville, à l’ISP et à l’ASN — très utile pour la vérification publicitaire et les études de marché où la précision géographique compte.
- Types de proxies : residential (rotatif), ISP/statique, datacenter, mobile
- Pool d’IP : 155 M+ d’IP dans 195+ localisations
- Gestion anti-bot : pools d’IP propres avec faibles taux de bannissement ; Web Data API disponible
- Sessions sticky : oui, avec fréquences de rafraîchissement personnalisables ; prise en charge de HTTP(S), SOCKS5, UDP et QUIC
Tarification : Plan Business à 4,00 $/Go avec 800 Go inclus (3 200 $/mois). Les tarifs entreprise commencent à 0,32 $/Go pour les gros volumes sur mesure.
Idéal pour : les équipes de recherche de marché qui ont besoin de données hyper-locales, la vérification publicitaire sur des géographies et des FAI spécifiques.
Inconvénients : peut sembler complexe pour des besoins simples. La durée maximale des sessions sticky varie selon le produit — vérifie avant de t’engager.
7. ScraperAPI : des proxies rotatifs intégrés dans une API pensée pour le scraping
ScraperAPI n’est pas un fournisseur de proxies traditionnel. Comme Thunderbit, il masque la couche proxy — mais renvoie du HTML brut plutôt que des données structurées. Envoie une URL, récupère le HTML rendu. ScraperAPI gère en arrière-plan le choix du proxy, la rotation, les tentatives et l’anti-bot.
- Fonctionnement : un seul endpoint API ; ajoute l’URL cible et ScraperAPI s’occupe du reste
- Gestion anti-bot : résolution de CAPTCHA intégrée, rendu JS et ciblage géographique
- Sessions sticky : non applicable au sens traditionnel — l’API gère les sessions en interne
Tarification : 1 000 crédits API gratuits par mois. Page standard = 1 crédit. Amazon = 5 crédits. Google/Bing = 25 crédits. LinkedIn = 30 crédits. Les sites protégés par Cloudflare/DataDome/PerimeterX ajoutent 10 crédits par requête. Offres payantes à partir d’environ 49 $/mois pour 100 000 crédits.
Idéal pour : les développeurs qui veulent éviter l’infrastructure proxy et récupérer simplement du HTML. Scraping à petite ou moyenne échelle.
Inconvénients : renvoie du HTML brut — il faut encore parser et structurer les données soi-même. Peut devenir coûteux à très haut volume à cause des multiplicateurs de crédits sur les sites protégés. Comparé à Thunderbit : ScraperAPI fournit du HTML ; le /extract de Thunderbit renvoie du JSON structuré conforme au schéma.
8. Webshare : proxies datacenter et rotatifs sans superflu, à faible coût
Webshare est l’option sans fioritures. Proxies datacenter extrêmement abordables, offre gratuite avec 10 proxies et outils simples orientés développeurs. (Webshare a été rachetée par Oxylabs en 2024, ce qui pourrait influencer sa future orientation produit.)
- Types de proxies : datacenter (statique et rotatif), residential (rotatif), ISP
- Pool d’IP : 80 M+ residential annoncés, large flotte datacenter
- Gestion anti-bot : minimale — pas de résolution intégrée des CAPTCHA ; repose sur la diversité des IP
- Sessions sticky : oui, pour les proxies residential
Tarification : Residential rotatif à partir de 1,40 $/Go. Residential statique à partir de 0,23 $/IP. Offre gratuite avec 10 proxies. Parmi les options les moins chères du marché.
Idéal pour : les développeurs avec un budget serré, les outils internes, le scraping de sites peu protégés, le prototypage.
Inconvénients : les IP datacenter sont fréquemment bloquées par les grands sites. Anti-détection limité. Qualité du pool residential variable.
9. Storm Proxies : proxies rotatifs simples avec tarification forfaitaire
Storm Proxies est l’un des rares fournisseurs à proposer des forfaits de proxies rotatifs à bande passante illimitée. Le modèle est simple : tu paies par port proxy et par mois, et tu utilises autant de bande passante que tu veux.
- Types de proxies : residential rotatif, datacenter rotatif, datacenter statique dédié
- Pool d’IP : la page officielle annonce 20 M+ de proxies residential reverse backconnect ; des avis tiers suggèrent que le pool effectif est plus petit
- Gestion anti-bot : minimale — pas de CAPTCHA ni de gestion de fingerprint intégrés
- Sessions sticky : rotation à chaque requête, ou toutes les 3 ou 15 minutes
Tarification : forfait mensuel fixe selon le nombre de ports proxy. Des sources tierces décrivent des plans comme 5 ports residential pour environ 50 $/mois avec bande passante illimitée. Vérifie la page de paiement avant d’acheter.
Idéal pour : les utilisateurs qui veulent des coûts mensuels prévisibles sans compteur de bande passante. Scraping léger à modéré, lorsque la prévisibilité du coût compte plus que la taille du pool.
Inconvénients : pool d’IP effectif très petit (risque de réutilisation élevé). Ciblage géographique limité. Tableau de bord daté. Peu adapté aux sites fortement protégés.
Comparatif des outils : proxies statiques vs rotatifs côte à côte
| Outil | Types de proxy / API | Taille approximative du pool | Modèle tarifaire | Gestion anti-bot | Support des sessions sticky | Meilleur cas d’usage |
|---|---|---|---|---|---|---|
| Thunderbit | API de scraping IA, MCP, CLI, extension Chrome | Lots jusqu’à 100 URL | Crédits (Distill 1/URL, Extract 20/URL) | Complète : rendu, anti-bot, CAPTCHA | N/A (géré) | Extraction de données structurées, RAG, agents IA |
| Bright Data | Residential, ISP, datacenter, mobile | 400 M+ residential, 1,3 M+ ISP | Par Go + par IP + par requête | Web Unlocker, Browser API | Oui (10–30 min) | Échelle entreprise, ciblage géographique |
| Oxylabs | Residential, ISP, datacenter, mobile | Grand pool entreprise | Residential 6 → 3,50 $/Go | Web Unblocker, Scraper APIs | Oui (10 min standard, configurable) | Scraping entreprise, solutions gérées |
| Smartproxy/Decodo | Residential, ISP, datacenter, mobile | 115 M+ residential | Residential ~3,75 $/Go ; ISP ~3,33 $/IP | Site Unblocker | Oui (1–60 min, jusqu’à 24 h) | Mid-market, premiers achats |
| IPRoyal | Residential, ISP, datacenter, mobile, sneaker | Pool en croissance | Residential 7 → 1,75 $/Go, sans expiration | Basique (qualité IP) | Oui (jusqu’à 7 jours) | Budget limité, usage saisonnier |
| SOAX | Residential, ISP, datacenter, mobile | 155 M+, 195+ localisations | Business 4 $/Go ; entreprise 0,32 $/Go | Pools propres, Web Data API | Oui (rafraîchissement personnalisé) | Ciblage hyper-local, étude de marché |
| ScraperAPI | API de scraping avec rotation proxy | Au niveau service (pas de pool brut) | Par crédit ; standard 1, Amazon 5, Google 25 | CAPTCHA, rendu, géolocalisation intégrés | Géré en interne | Développeurs voulant récupérer du HTML |
| Webshare | Datacenter, residential, ISP | 80 M+ residential | Residential rotatif 1,40 $/Go ; statique 0,23 $/IP | Minimal | Oui (residential) | Développeurs budget serré, prototypage |
| Storm Proxies | Residential/datacenter rotatif, DC statique | 20 M+ annoncés | Forfait mensuel par port, BW illimitée | Minimal | À chaque requête / 3 / 15 min | Coût prévisible, scraping léger |
NetNut a été retiré de cette comparaison : en août 2026, netnut.io affiche un avis de saisie fédérale américaine à la place du site produit.
Les outils se regroupent en trois catégories. L’infrastructure de proxy brute (Bright Data, Oxylabs, Smartproxy, IPRoyal, SOAX, Webshare, Storm Proxies) te donne l’accès IP et tu gères tout le reste. Les API de scraping (ScraperAPI) abstraient la couche proxy mais renvoient toujours du HTML brut. Les API d’extraction IA (Thunderbit) abstraient à la fois la couche proxy et la couche de parsing, pour renvoyer directement des données structurées.
Quand les proxies ne sont pas la bonne réponse : API de scraping IA vs proxies gérés soi-même
Voici la partie qu’aucun concurrent ne couvre : la plupart des personnes qui cherchent « proxies statiques vs rotatifs » ne sont pas des passionnés de proxies. Elles essaient d’extraire des données, et les proxies ne sont qu’un moyen d’y parvenir.
Pour beaucoup de cas d’usage, gérer des pools de proxies, la logique de rotation, l’usurpation de fingerprint et la résolution des CAPTCHA est une surcharge qu’un outil centré API élimine entièrement. Mais pas toujours. Voici quand chaque approche est pertinente :
Les proxies gérés en interne ont du sens lorsque tu as besoin d’un accès IP brut pour la gestion de comptes, les tests géographiques ou les bots sneakers ; d’un contrôle fin sur l’ASN, le carrier ou le comportement de l’IP de sortie ; ou d’une pile navigateur/proxy personnalisée déjà maintenue par ton équipe.
L’extraction centrée sur l’API a du sens lorsque tu as besoin de données structurées (fiches produit, coordonnées, prix) plutôt que de HTML brut, d’un Markdown propre pour les pipelines RAG, de workflows d’agents IA où l’accès web au milieu d’une tâche doit rester invisible, ou tout simplement de passer moins de temps sur l’infrastructure proxy et plus de temps sur les données elles-mêmes.
L’API de Thunderbit gère le rendu, l’anti-bot et les CAPTCHA côté serveur. Les développeurs obtiennent un Markdown propre (/distill) ou un JSON structuré conforme au schéma (/extract) sans configurer de pool proxy ni de cohérence de fingerprint. Le serveur MCP permet à Claude ou Cursor de scraper en cours de tâche via thunderbit_extract — la couche proxy est réellement invisible.
Pour une vue plus large du web scraping sans coder, nous avons traité ce sujet séparément.
Quel outil de proxy statique ou rotatif vous convient le mieux ?
Recommandations précises par scénario, parce que « ça dépend » est exact mais peu utile :
- Idéal pour les entreprises ayant besoin de pools d’IP massifs : Bright Data, Oxylabs
- Idéal pour les équipes soucieuses du budget : IPRoyal, Webshare, Storm Proxies
- Idéal pour une mise en place simple en mid-market : Smartproxy/Decodo, SOAX
- Idéal pour éviter complètement la gestion des proxies : Thunderbit (données structurées), ScraperAPI (HTML brut)
- Idéal pour les workflows d’agents IA et MCP : Thunderbit
Les systèmes anti-bot deviennent de plus en plus intelligents — en superposant réputation IP, fingerprinting TLS, analyse comportementale et cohérence des en-têtes — et le coût de la gestion manuelle des proxies augmente avec eux. Pour les équipes dont le but final est d’obtenir des données web propres et structurées, les outils centrés API qui abstraient toute la couche proxy deviennent de plus en plus le choix pragmatique.
Ce changement n’est pas théorique. Il est déjà en cours.
Si tu veux voir à quoi cela ressemble en pratique, l’extension Chrome Thunderbit est un excellent point de départ pour les utilisateurs non techniques, et la documentation API détaille le flux développeur. Pour plus de contexte sur le paysage plus large des outils de scraping, consulte notre comparatif des meilleurs web scrapers IA. Tu peux aussi regarder des démonstrations sur la chaîne YouTube Thunderbit.
Essayez Thunderbit AI Web Scraper Get Started Free
FAQ
1. Quand dois-je utiliser des proxies statiques plutôt que des proxies rotatifs ?
Utilise des proxies statiques lorsque tu as besoin d’une IP cohérente sur plusieurs sessions — gestion de comptes, accès à du contenu géobloqué, suivi de classement, ou toute plateforme qui considère un changement d’IP comme suspect. Si la cible s’attend à voir la même identité dans le temps, le statique est le bon choix. Pour les cibles difficiles, les IP ISP/residential statiques sont plus sûres que les datacenter.
2. Quelle est la différence entre une session sticky et un proxy statique ?
Une session sticky conserve la même IP pendant une fenêtre de temps configurable (par exemple 10 minutes, 30 minutes, jusqu’à 24 heures selon le fournisseur), puis passe à une nouvelle IP. Un proxy statique garde la même IP indéfiniment jusqu’à remplacement manuel. Ce ne sont pas la même chose, malgré certains documents fournisseurs qui utilisent ces termes de manière interchangeable.
3. Pourquoi les proxies rotatifs sont-ils encore bloqués sur certains sites ?
Parce que les systèmes anti-bot modernes utilisent une détection multicouche qui dépasse la simple adresse IP. Le fingerprinting TLS/JA3, l’analyse comportementale (motifs de requêtes, parcours de navigation) et les contrôles de cohérence des en-têtes peuvent tous signaler un trafic automatisé, quelle que soit la rotation d’IP. Les IP rotatives réduisent les limites de débit basées sur l’IP, mais ne traitent pas ces autres couches.
4. Combien coûtent les proxies residential rotatifs à grande échelle ?
Les prix publics en self-serve vont d’environ 1,40 $/Go (Webshare) à 8 $/Go en PAYG standard (Bright Data), avec des remises entreprise possibles. À volume de rendu complet (50K pages/jour à ~2,86 Mo/page), la bande passante seule peut dépasser 4 To/mois — soit potentiellement des dizaines de milliers de dollars. Les API facturées au crédit ou à la requête (comme Thunderbit ou ScraperAPI) offrent une tarification plus prévisible, sans comptage de bande passante.
5. Une API de scraping IA peut-elle remplacer totalement les proxies ?
Pour l’extraction de données structurées et le web scraping, souvent oui. Des outils comme Thunderbit gèrent la rotation des proxies, les mesures anti-bot, la résolution des CAPTCHA et le rendu JS au niveau de l’infrastructure — tu récupères des données propres sans gérer l’infrastructure proxy. Pour les cas nécessitant un accès IP brut (gestion de comptes, tests géographiques, bots sneakers), les proxies traditionnels restent nécessaires.
En savoir plus



