
Web dnes potřebuje data víc než kdy dřív a v roce 2026 je Node.js jedním z hlavních nástrojů pro týmy, které chtějí scrapovat chytřeji, ne tvrději. Ať už pracuješ v sales, e-commerce, nebo jsi prostě datový nadšenec jako já, určitě sis všiml, že scraping už dávno není jen o tom „získat data“. Dnes jde o rychlost, škálování a o to, aby ti IP neskončila v digitální kobce. Poptávka navíc neupadá — veřejná webová data se tiše stala vstupem, na kterém dnes staví většina moderních týmů, od cenové inteligence až po pipeline pro trénování LLM, a sázky i konkurence nikdy nebyly vyšší.
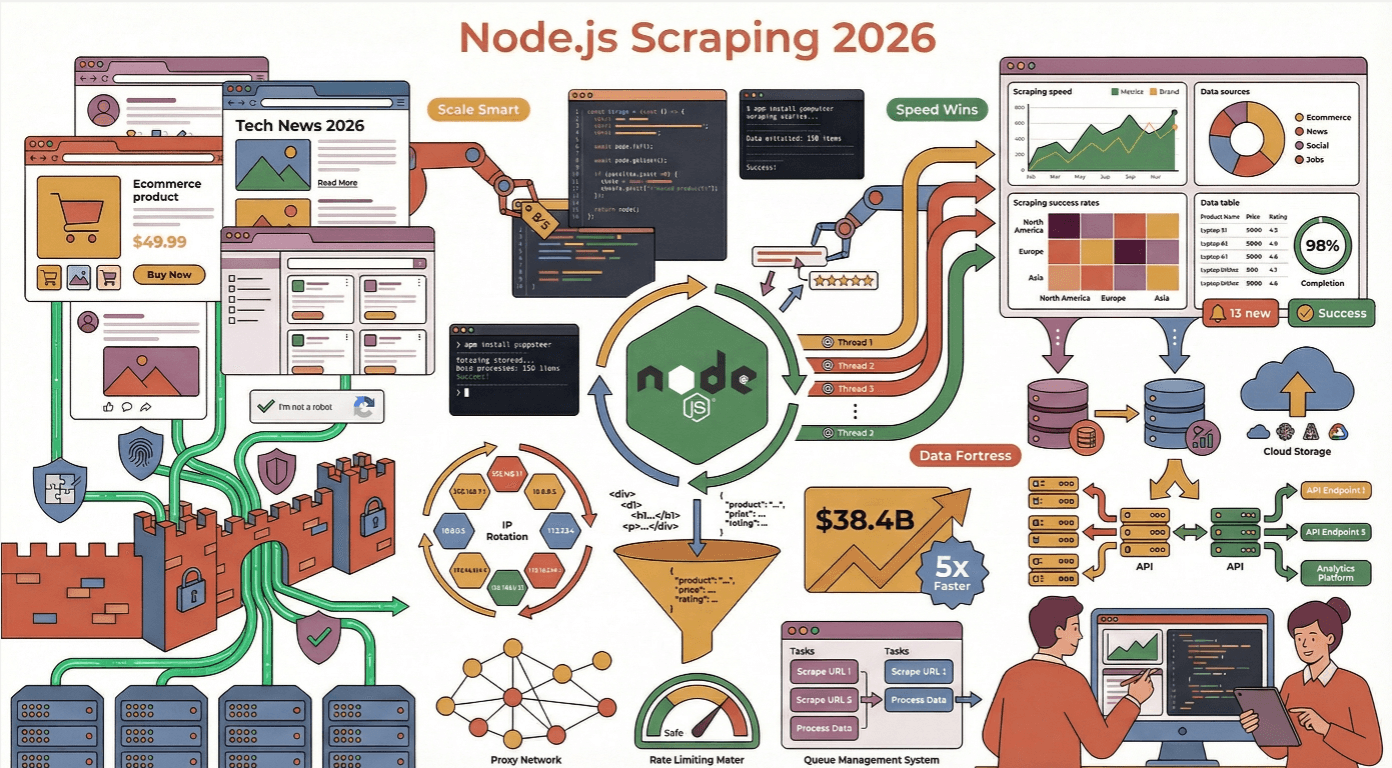
Jenže je tu háček: moderní web je pevnost plná dynamického obsahu, pastí na boty a měnících se layoutů. Viděl jsem víc scraperů, které narazily a spadly, než bych chtěl přiznat — většinou proto, že ignorovaly best practices nebo podcenily, jak sofistikovaná proti-scrapingová obrana dnes je. Pojďme se tedy podívat na praktické osvědčené postupy pro efektivní web scraping v Node.js, doplněné o pár příběhů, špetku humoru a hodně užitečných doporučení.
Proč zvolit Node.js pro efektivní web scraping?
Pokud jsi někdy zkoušel scrapovat stovky nebo tisíce stránek najednou, víš, že rychlost a paralelismus rozhodují. A právě tady Node.js vyniká. Jeho asynchronní, neblokující I/O model je stvořený pro zpracování obrovského množství současných síťových požadavků — představ si ho jako ultimátního multitaskera pro web (Node.js Docs). Zatímco jiné jazyky se zaseknou čekáním na dokončení každého požadavku, Node.js dál točí svůj event loop a žongluje s úlohami jako nabitý cirkusový performer.
Viděl jsem, jak Node.js v určitých scénářích porazil Python i Javu, zejména tam, kde je potřeba zpracovávat real-time aktualizace a rozsáhlé extrakce, obzvlášť když jsou cílové weby postavené na JavaScriptu. Ve skutečnosti už ~40 % vývojářů dnes používá Node.js pro backend a automatizaci, což z něj dělá nejpopulárnější webovou technologii na světě.
Node.js vs. jiné frameworky pro web scraping
Pojďme si na chvíli zapřemýšlet trochu techničtěji. Takhle si Node.js stojí proti konkurenci:
| Framework | Silné stránky | Slabiny | Nejlepší použití |
|---|---|---|---|
| Node.js | Asynchronní, skvělý pro paralelismus, obrovský npm ekosystém, nativní JS pro dynamické weby | Může být náročný na paměť, callback hell (bez async/await) | Real-time scraping, weby s hodně JavaScriptem, škálovatelné mikroslužby |
| Python | Spousta scraping knihoven (BeautifulSoup, Scrapy), snadná syntaxe | Pomalejší při velkém paralelismu, hůř si poradí s JS-renderovanými weby | Statické HTML, výzkum, prototypování |
| Java | Silné typování, robustní pro enterprise | Ukecaný kód, méně flexibilní pro rychlé skripty | Velké enterprise scraping projekty |
| Go | Rychlý, efektivní paralelismus | Menší ekosystém, strmější učení | Vysoce výkonný scraping s nízkou latencí |
Pro většinu business uživatelů je Node.js ideální střed: rychlý, flexibilní a perfektně naladěný na moderní web poháněný JavaScriptem (Thunderbit Blog).
Jak nastavit robustní prostředí pro web scraping v Node.js
Kvalitní scraper začíná pevným základem. Tohle je moje osvědčené nastavení:
- Struktura projektu: Udržuj projekt modulární. Používej složky jako
/src,/libsa/config. Citlivé údaje (API klíče, proxy) ukládej do environmentálních proměnných pomocídotenv(Thunderbit Guide). - HTTP klient: Pro požadavky použij axios, got nebo node-fetch.
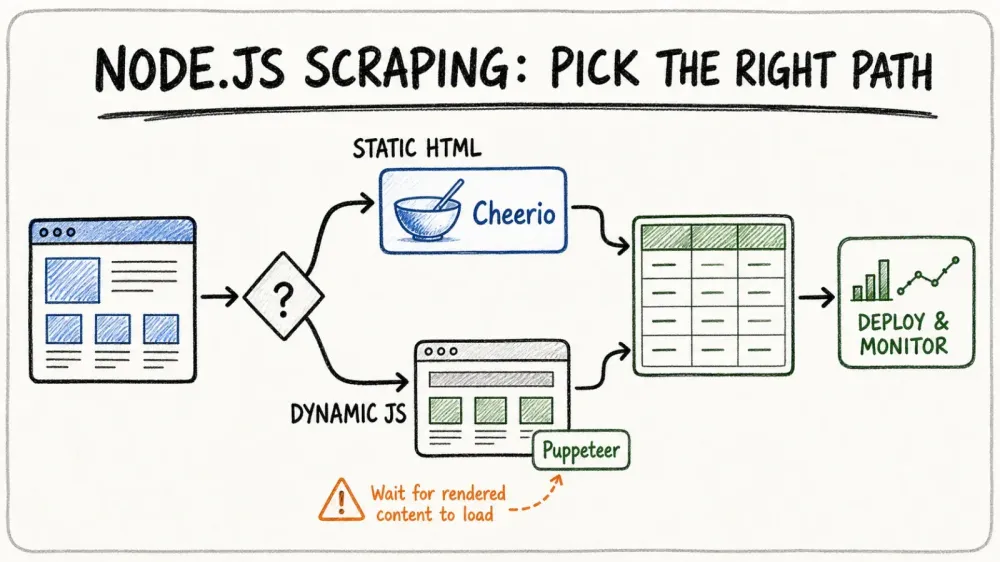
- Parsování HTML: Cheerio pro statické HTML, Puppeteer nebo Playwright pro dynamický obsah.
- Utility: Pro práci s daty použij Lodash a pro validaci dat validator.js nebo Joi.
- Testování a linting: Pro testy Mocha, pro kvalitu kódu ESLint (LogRocket).
Základní knihovny pro web scraping v Node.js
- HTTP klienti (axios / got / vestavěný
fetch): Pro odesílání požadavků. Důležitá poznámka: od Node.js v18 můžešfetchpoužívat nativně bez instalace čehokoli navíc a Node.js v22 ho označil za stabilní. Pro nový projekt na novější verzi Node.js tedynode-fetchčasto vůbec nepotřebuješ — stačí volatfetchpřímo. Já pořád sahám po axios, když chci interceptory, automatické JSON zpracování a známé promise API pro Node i browser, zatímco got volím tehdy, když potřebuji retry, streamy nebo HTTP/2 hned po instalaci. Vyber si to, co sedí tvému stacku; pro rychlý skript je nativnífetchúplně v pohodě. - Cheerio: Rychlý HTML parser ve stylu jQuery. Ideální pro statické stránky — zpracování trvá zhruba 0,5 s (Oxylabs).
- Playwright / Puppeteer: Automatizace headless prohlížeče pro dynamické weby s hodně JavaScriptem. Pomalejší (~4 s na stránku), ale nezbytné tam, kde se obsah načítá až po renderu (Bright Data). Pokud začínáš v roce 2026 od nuly, Playwright je výchozí volba — funguje napříč prohlížeči (Chromium / Firefox / WebKit), má vestavěný trace viewer a tým, který původně vyvinul Puppeteer, ho nyní v Microsoftu vede. Puppeteer se stále udržuje pro práci zaměřenou jen na Chrome, ale jeho release notes už delší dobu přinášejí spíš kompatibilitní aktualizace než nové funkce.
- dotenv: Pro správu environmentálních proměnných.
- csv-writer/jsonfile: Pro export dat.
Jak se vyhnout častým chybám při web scrapingu v Node.js
Nespočetněkrát jsem viděl scrapery, které byly zablokované, spadly, nebo jen vyplivly hromadu nepořádných dat. Na tohle si dej pozor:
- Ignorování robots.txt a podmínek služby: Před scrapováním je vždy zkontroluj. Porušení může vést k banům IP — nebo hůř, k právním problémům (ScraperAPI).
- Přetěžování serverů: Neposílej požadavky bez rozmyslu. Omez rychlost scrapingu náhodnými prodlevami (1–3 sekundy), nastav kontrolu paralelismu a nechovej se jako hyperaktivní robot (ScrapeGraphAI).
- Neošetřené chyby: Požadavky vždy obaluj do try/catch, zpracovávej HTTP chyby a loguj selhání. Dočasné chyby opakuj s exponenciálním backoffem (ScrapeGraphAI).
- Zapomenuté request headers: Používej realistický User-Agent a pravidelně ho obměňuj. Přidej také Accept-Language, Referer a další hlavičky, aby požadavky vypadaly jako z běžného prohlížeče (ScrapeGraphAI).
Jak obejít anti-scraping mechanismy
Moderní weby jsou po zuby ozbrojené proti botům. Takhle se vyhýbám digitálním minám:
- Rotující proxy/IP: Používej pool proxy serverů a měň IP adresy, abys se vyhnul blokacím (Medium).
- Náhodné hlavičky: Pro každý požadavek měň User-Agent, Accept-Language i další hlavičky.
- Stealth pro headless browser: Používej pluginy jako
puppeteer-extra-plugin-stealth, které maskují automatizované stopy. - Simulace lidského chování: Přidávej náhodné pauzy, pohyb myši, scrollování a dokonce i překlepy při psaní (ZenRows).
Simulace lidského chování ve scraperech v Node.js
Tady to začíná být zábavné — a trochu zvláštní. Místo okamžitého klikání a scrollování naprogramuj scraper tak, aby:
- čekal mezi akcemi náhodné intervaly (
await page.waitForTimeout(randomDelay)) - pohyboval myší v malých, roztřesených krocích (
page.mouse.move(x, y)) - psal s náhodnými prodlevami a občasnými překlepy (
page.type(selector, text, {delay: random(100,200)})) - scrolloval nerovnoměrně, ne jen rovnou až dolů
Tyto triky mohou výrazně zvýšit úspěšnost na chráněných webech (ScraperAPI).
Zjednodušení komplexní extrakce dat s Thunderbit
Scrape data from any website using AI Skip the boilerplate: Thunderbit's agentic web scraper reads any page and extracts data in one click, no Node.js code to maintain. Get Started Free
A teď k tomu nejdůležitějšímu: scraping je těžký. Ale nemusí být. Proto jsme vytvořili Thunderbit.
Thunderbit je agentní Chrome Extension pro web scraping, která ti umožní extrahovat data z libovolného webu pomocí běžné angličtiny. Stačí kliknout na „One Click Extract“, nechat AI zjistit, co je na stránce, a stisknout „Scrape“. Je to jako mít juniorního vývojáře, který nikdy nespí a nikdy si neříká o zvýšení platu.
A co je ještě lepší: Thunderbit nabízí API, takže ho můžeš rovnou napojit na své Node.js workflow. Místo psaní tisíců řádků scrapingového kódu můžeš nechat Thunderbit dělat těžkou práci — dynamický obsah, podstránky, stránkování, vše. Ty si jen stáhneš strukturovaná data (CSV, JSON nebo rovnou do Google Sheets, Airtable, Notion) a pokračuješ ve své práci (Thunderbit Blog).
Vyzkoušejte Thunderbit Chrome Extension zdarma Nainstalujte si bezplatné rozšíření do Chrome a extrahujte strukturovaná data jedním kliknutím — nebo zavolejte Thunderbit API z vaší Node.js aplikace. Get Started Free
Thunderbit vs. tradiční scraping v Node.js
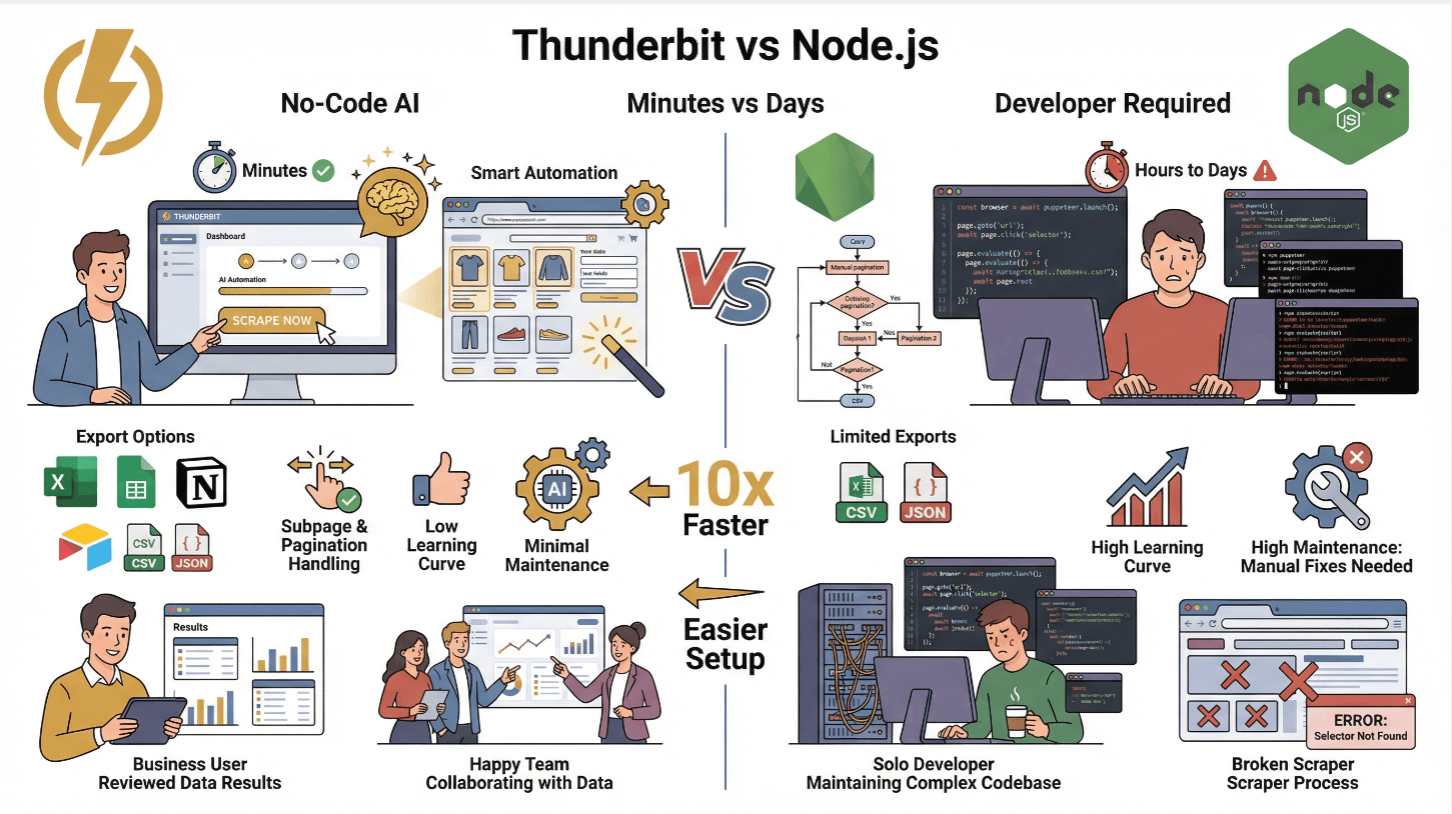
| Funkce | Thunderbit | Tradiční scraper v Node.js |
|---|---|---|
| Doba nastavení | Minuty (bez kódu) | Hodiny až dny (programování, testování) |
| Zpracování dynamického obsahu | Ano (AI + prohlížeč) | Ano (s Puppeteer/Playwright) |
| Podstránky a stránkování | Jedním klikem | Vyžaduje ruční kódování |
| Export dat | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (vlastní kód) |
| Náročnost učení | Nízká (pro business uživatele) | Vysoká (pro vývojáře) |
| Údržba | Minimální (AI se přizpůsobuje) | Vysoká (ruční opravy při změnách webu) |
Thunderbit je ideální pro netechnické týmy nebo pro každého, kdo chce přeskočit rutinu a soustředit se na poznatky. Pokročilí uživatelé mohou stále využít API Thunderbitu pro automatizaci scrapingu ve velkém měřítku (Thunderbit Docs).
Kombinace Cheerio a Puppeteer pro dynamický obsah
Tohle je moje oblíbená power combo pro Node.js scraping. Funguje to takhle:
- Použij Puppeteer k načtení stránky a spuštění JavaScriptu (čekej na
networkidle, aby byl obsah opravdu načtený). - Získej HTML pomocí
await page.content(). - Parsuj přes Cheerio: Pošli HTML do Cheerio pro extrémně rychlé zpracování ve stylu jQuery a extrakci dat.
Tento hybridní přístup ti dá to nejlepší z obou světů: sílu Puppeteeru pro dynamický obsah a rychlost Cheerio pro parsování (Browserless).
Výkonnostní tip: Vybírej jen prvky, které skutečně potřebuješ. Cheerio načítá celý DOM do paměti, takže se vyhni příliš širokým selektorům a výsledky si cachuj, pokud scrapuješ stejné stránky opakovaně (Oxylabs).
Jak optimalizovat parsování HTML a extrakci dat
- Používej přesné selektory: Vyhni se
$('body *')— míř jen na to, co potřebuješ. - Streamuj velké stránky: U obřího HTML zvaž streamování nebo rozdělení úlohy na části.
- Cachuj renderované HTML: Pokud se k URL vracíš, ukládej HTML do cache, ať neděláš zbytečné požadavky.
- Validuj a čistěj data: Používej validační knihovny, aby tvoje databáze neskončila plná odpadu (ScrapeGraphAI).
Nasazení škálovatelného Node.js scraperu v cloudu
Scrapuješ ve velkém? Je čas přejít do cloud-native režimu.
- Zabal scraper do Dockeru: Napiš
Dockerfile, zkopíruj kód, nainstaluj závislosti a nastav entrypoint. - Nasazení do cloudu: Pro jednodušší úlohy použij AWS EC2, Google Cloud Compute nebo Azure VM. Pro větší škálu zvol Kubernetes nebo spravované služby jako AWS ECS/EKS, Google Cloud Run nebo Azure Kubernetes Service (DigitalOcean).
- Orchestrace přes Kubernetes: Spouštěj více podů, škáluj automaticky podle zátěže a použij load balancery pro rozdělení URL.
- Plánování úloh: Pro spouštění scrapů v pravidelných intervalech používej cloud schedulery (CloudWatch Events, Cloud Scheduler) nebo cron.
V jednom reálném případě přechod z 5 na 10 Kubernetes podů zkrátil scraping 400 stránek z minut na méně než minutu (DigitalOcean).
Monitoring a automatické škálování scraping infrastruktury
- Logování: Posílej logy do CloudWatch, Stackdriver nebo Datadogu. Nastav upozornění na chyby nebo zpomalení.
- Health checks: Pro metriky jako počet scrapnutých stránek za minutu, chybovost nebo stav podů použij Prometheus a Grafanu.
- Auto-scaling: Nakonfiguruj Kubernetes HPA (Horizontal Pod Autoscaler), aby škáloval pody podle CPU nebo počtu požadavků.
Vždy implementuj retry s exponenciálním backoffem, abys se zotavil ze síťových výpadků nebo dočasných banů.
Nejlepší postupy pro ukládání dat a následné zpracování
Jakmile data nasbíráš, musíš je uložit a vyčistit:
- Menší úlohy: Exportuj do CSV, JSON nebo posílej do Google Sheets, Airtable či Notion (Thunderbit to umí hned po instalaci).
- Větší úlohy: Pro strukturovaná data používej SQL (MySQL/PostgreSQL), pro polo-strukturovaná nebo proměnlivá schémata NoSQL (MongoDB, DynamoDB) (ScrapeHero).
- Cloud storage: S3 nebo Google Cloud Storage pro surové soubory a zálohy.
- Čištění dat: Vždy validuj pole, normalizuj formáty (data, čísla) a odstraňuj duplicity. Pro vynucení kvality dat používej schema validátory (ScrapeGraphAI).
Uchovávej jak syrová, tak vyčištěná data — nikdy nevíš, kdy je budeš potřebovat znovu zpracovat nebo ladit.
Závěr: Klíčové poznatky pro efektivní web scraping v Node.js
Přeskoč psaní scraper kódu Podívej se, jak si agentní web scraper Thunderbit vede ve srovnání s vlastním psaním a údržbou scrapingových skriptů. Get Started Free
Shrňme si to podstatné:
- Využij asynchronní sílu Node.js pro masivní paralelní scraping — zejména na webech s hodně JavaScriptem.
- Kombinuj správné nástroje: Pro requesty použij axios/got, pro statické HTML Cheerio, pro dynamický obsah Puppeteer a podle potřeby je kombinuj pro rychlost i flexibilitu.
- Vyhni se anti-bot pastem: Rotuj proxy a hlavičky, simuluj lidské chování a respektuj robots.txt.
- Zjednoduš si práci s Thunderbit: Pro business uživatele nebo rychlé prototypování ti Thunderbit umožní extrahovat komplexní data pomocí AI a napojit je přes API do tvého Node.js stacku.
- Nasazuj ve velkém: Používej Docker, orchestrace přes Kubernetes a důkladné monitoringy pro spolehlivost.
- Ukládej a čistěj data: Zvol správné úložiště podle potřeby a před použitím vždy validuj.
Web nebude jednodušší, ale s těmito osvědčenými postupy mohou tvoje Node.js scrapery zůstat rychlé, spolehlivé a o krok napřed v závodech se security proti botům. A pokud tě někdy omrzí debugování selektorů ve dvě ráno, pamatuj: AI v Thunderbit je vzhůru pořád.
Chceš se učit dál? Podívej se na Thunderbit Blog pro další hlubší návody, nebo vyzkoušej Thunderbit Chrome Extension, abys viděl, jak snadný scraping může být.
Scrape s Thunderbit Agentic Web Scraper Web Scraper API od Thunderbit ti umožní spustit extrakci přímo z vlastního Node.js kódu, a to i s bezplatným tarifem na rozjezd. Get Started Free
Často kladené otázky
1. Proč je Node.js v roce 2025 tak dobrý pro web scraping?
Asynchronní, událostmi řízený model Node.js mu umožňuje zpracovávat tisíce souběžných požadavků, takže je ideální pro scraping velkého množství dat nebo real-time aktualizací. Jeho obrovský npm ekosystém a nativní podpora JavaScriptu jsou perfektní pro moderní weby s hodně JS (Node.js Docs).
2. Jak se vyhnout zablokování při scrapingu v Node.js?
Používej rotující proxy, náhodně obměňuj request headers, omezuj rychlost požadavků pomocí náhodných prodlev a simuluj lidské chování (pohyb myši, scrollování, psaní) nástroji jako Puppeteer. Vždy respektuj robots.txt a podmínky webu (Medium).
3. Kdy v Node.js scraperu použít Cheerio a kdy Puppeteer?
Cheerio použij pro rychlé parsování statického HTML, když jsou data už v surovém HTML. Puppeteer použij pro weby, které obsah načítají dynamicky přes JavaScript. Nejlepší výsledek často získáš tak, že stránku nejdřív vyrenderuješ přes Puppeteer a potom HTML zpracuješ v Cheerio (Bright Data).
4. Jak Thunderbit zjednodušuje web scraping v Node.js?
Thunderbit ti umožní extrahovat strukturovaná data z libovolného webu pomocí AI a přirozených promptů — bez nutnosti programování. Umí dynamický obsah, podstránky i stránkování a nabízí API pro integraci do Node.js. Data lze exportovat přímo do Excelu, Google Sheets, Airtable nebo Notion (Thunderbit Blog).
5. Jaký je nejlepší způsob, jak škálovat a monitorovat Node.js scrapery v cloudu?
Zabal scraper do Dockeru, nasazuj přes Kubernetes nebo spravované cloudové služby a využij auto-scaling pro nárazové špičky. Logy a metriky sleduj pomocí nástrojů jako CloudWatch nebo Prometheus a nastav upozornění na chyby či zpomalení (DigitalOcean).
Jsi připravený posunout svůj web scraping na vyšší úroveň? Vyzkoušej Thunderbit a ať jsou tvoje scrapery rychlé, nenápadné a vždy o krok napřed.
Vyzkoušet agentní web scraper Get Started Free
Další čtení
- Jak zvládnout web scraping v Node pro začátečníky: krok za krokem
- Jak efektivně scrapovat data z webu pomocí nejlepších nástrojů
- Jak efektivně crawlovat web: průvodce krok za krokem
- Jak zvládnout JavaScript crawling: průvodce pro začátečníky
- Jak zvládnout web scraping pro porovnávání cen v roce 2026




