
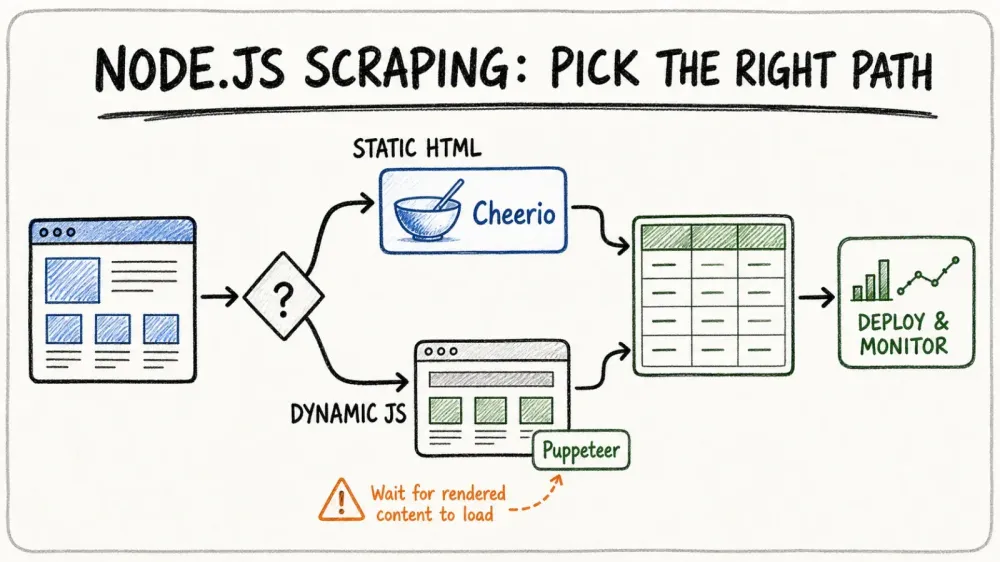
الويب اليوم صار أكثر جوعًا للبيانات من أي وقت مضى، وفي عام 2026 يتصدر Node.js المشهد للفرق التي تريد جمع البيانات بذكاء بدل الشغل المضاعف. سواء كنت تعمل في المبيعات أو التجارة الإلكترونية أو مجرد من محبّي البيانات مثلي، فغالبًا لاحظت أن scraping لم يعد مجرد “جمع معلومات” وخلاص؛ صار الموضوع يتعلق بالسرعة، والتوسع، وتجنب أن تنتهي بحظر عنوان IP. والطلب أيضًا لا يخفّ — فالبيانات العامة على الويب أصبحت بهدوء الأساس الذي تبني عليه أغلب الفرق الحديثة، من تحليلات التسعير إلى خطوط تدريب النماذج اللغوية الكبيرة، والمنافسة لم تكن يومًا أشد.
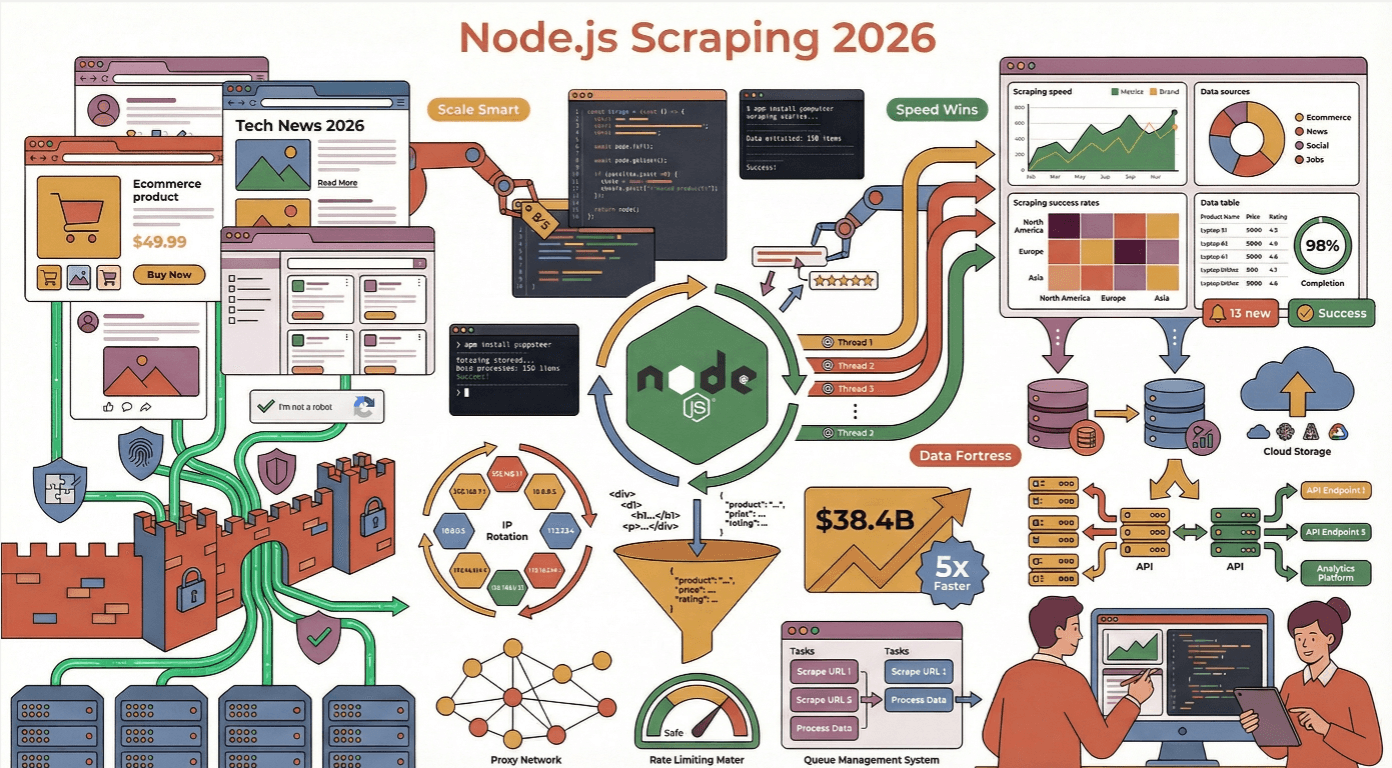
لكن المشكلة أن الويب الحديث يشبه قلعة مليئة بالمحتوى الديناميكي، وفخاخ منع الروبوتات، والتغييرات في البنية والتخطيط. لقد رأيت من أدوات scraping ما تعطّل واحترق أكثر مما أحب أن أعترف به—وغالبًا لأن أصحابها تجاهلوا أفضل الممارسات أو ما قدّروا قد إيش وسائل الحماية المضادة ذكية. لذلك، خلّنا نغوص في أفضل الممارسات العملية لرفع كفاءة Node.js في web scraping، مع شوية قصص، ولمسة دعابة، وكثير من النصائح القابلة للتطبيق.
لماذا تختار Node.js لتحقيق كفاءة أفضل في Web Scraping؟
إذا جرّبت يومًا استخراج البيانات من مئات الصفحات أو آلافها دفعة واحدة، فأنت تعرف أن السرعة والتوازي هما كل شيء. وهنا يبرز Node.js بوضوح. فـ نموذج I/O غير المتزامن وغير الحاجب الذي يعتمد عليه مصمم للتعامل مع أعداد هائلة من الطلبات الشبكية المتزامنة—يمكن اعتباره نجم تعدد المهام في الويب (Node.js Docs). بينما قد تنشغل لغات أخرى بالانتظار حتى يكتمل كل طلب، يواصل Node.js إدارة حلقة الأحداث الخاصة به، ويتعامل مع الطلبات كأنه مؤدي سيرك ماشي على كافيين زيادة.
وشفت Node.js يتفوق على Python وJava في سيناريوهات تحتاج تحديثات لحظية واستخراجًا واسع النطاق، خصوصًا عندما تكون المواقع المستهدفة مبنية بكثافة على JavaScript. في الواقع، يستخدم حوالي 40% من المطورين Node.js اليوم في مهام الخلفية والأتمتة، ما يجعله من أكثر تقنيات الويب انتشارًا في العالم.
مقارنة Node.js مع أطر Web Scraping الأخرى
خلّنا ندخل في التفاصيل شوي. هكذا يقف Node.js أمام المنافسين:
| الإطار | نقاط القوة | نقاط الضعف | أفضل حالات الاستخدام |
|---|---|---|---|
| Node.js | غير متزامن، ممتاز للتوازي، منظومة npm ضخمة، JavaScript أصلي للمواقع الديناميكية | قد يستهلك الذاكرة بكثرة، وقد تدخل في فوضى callbacks إذا لم تستخدم async/await | scraping لحظي، مواقع تعتمد على JS، خدمات مصغرة قابلة للتوسع |
| Python | مكتبات scraping كثيرة (BeautifulSoup, Scrapy)، بناء نحوي سهل | أبطأ في التوازي الضخم، ويتعثر مع المواقع المعتمدة على JS | HTML ثابت، البحث، النماذج الأولية |
| Java | typing قوي، مناسب للمؤسسات | مطوّل، وأقل مرونة للسكربتات السريعة | scraping واسع النطاق على مستوى المؤسسات |
| Go | سريع، وتوازيه فعّال | منظومة أصغر، ومنحنى تعلم أكثر حدة | scraping عالي الأداء ومنخفض زمن الاستجابة |
بالنسبة لمعظم مستخدمي الأعمال، يحقق Node.js التوازن المثالي: سريع، مرن، ومصمم جيدًا للويب الحديث المبني على JavaScript (Thunderbit Blog).
إعداد بيئة Node.js قوية لـ Web Scraping
أي أداة scraping جيدة تبدأ من أساس قوي. هذا هو الإعداد الذي أعتمد عليه عادةً:
- هيكلة المشروع: خل المشروع مرتب وواضح. استخدم مجلدات مثل
/srcو/libsو/config. واحتفظ بالمعلومات الحساسة مثل مفاتيح API والـ proxies داخل متغيرات البيئة معdotenv(Thunderbit Guide). - عميل HTTP: استخدم axios أو got أو node-fetch لإرسال الطلبات.
- تحليل HTML: استخدم Cheerio للـ HTML الثابت، وPuppeteer أو Playwright للمحتوى الديناميكي.
- أدوات مساعدة: استخدم Lodash لتنظيف البيانات وتحويلها، وvalidator.js أو Joi للتحقق من صحة البيانات.
- الاختبار والتنسيق: استخدم Mocha للاختبارات وESLint لجودة الكود (LogRocket).
أهم مكتبات Node.js لعمليات Web Scraping
- عملاء HTTP (axios / got / fetch المدمج): لإرسال الطلبات. ومعلومة مهمة: منذ Node.js v18 تقدر تستخدم
fetchبشكل أصلي بدون تثبيت أي حزمة، وفي Node.js v22 صار مستقرًا. لذلك، في مشروع جديد يعمل على إصدار حديث من Node غالبًا لن تحتاج إلىnode-fetchأصلًا — يكفي تستدعيfetchمباشرة. ومع ذلك، ما زلت أميل إلى axios عندما أحتاج interceptors أو JSON تلقائي أو واجهة promises مألوفة تعمل في Node وفي المتصفح، وأختار got عندما أحتاج retries أو streams أو HTTP/2 جاهزًا من البداية. اختر ما يناسب بنيتك؛ وللأعمال السريعة فـfetchالمدمج مناسب تمامًا. - Cheerio: محلل HTML سريع يشبه jQuery. مثالي للصفحات الثابتة—ويحلل الصفحة في نحو 0.5 ثانية (Oxylabs).
- Playwright / Puppeteer: أتمتة متصفح بلا واجهة للمواقع الديناميكية المعتمدة على JS. أبطأ شوي (~4 ثوانٍ لكل صفحة)، لكنه ضروري للمواقع التي لا يظهر فيها المحتوى إلا بعد تحميل الصفحة (Bright Data). وإذا كنت تبدأ من الصفر في 2026، فـ Playwright هو الخيار الافتراضي — يدعم عدة متصفحات مباشرة (Chromium / Firefox / WebKit)، ويضم عارض traces مدمجًا، كما أن الفريق الذي أنشأ Puppeteer كان من الداعمين الأساسيين لتطويره داخل Microsoft. أما Puppeteer فما زال مدعومًا بشكل جيد لأعمال Chrome فقط، لكن ملاحظات إصداراته اتجهت منذ فترة أكثر نحو تحديثات التوافق مع Chrome بدلًا من قدرات جديدة.
- dotenv: لإدارة متغيرات البيئة.
- csv-writer/jsonfile: لتصدير البيانات.
تجنب الأخطاء الشائعة في Node.js Web Scraping
ما أقدر أحصي كم مرة شفت أدوات scraping تنحظر أو تتعطل أو تطلع ببيانات ملخبطة. إليك أهم الأشياء اللي لازم تنتبه لها:
- تجاهل robots.txt وشروط الخدمة: افحصهما دائمًا قبل ما تبدأ. مخالفة هذه القواعد قد تؤدي إلى حظر عنوان IP الخاص بك—أو الأسوأ، الدخول في متاعب قانونية (ScraperAPI).
- إغراق الخوادم بالطلبات: لا ترسل سيلًا من الطلبات. حط حدودًا للسرعة باستخدام تأخيرات عشوائية (1–3 ثوانٍ)، واستخدم ضوابط للتوازي، وتجنب التصرف كأنك روبوت متهور (ScrapeGraphAI).
- عدم التعامل مع الأخطاء: لفّ الطلبات دائمًا داخل try/catch، وتعامل مع أخطاء HTTP، وسجل حالات الفشل. وأعد المحاولة للأخطاء المؤقتة باستخدام exponential backoff (ScrapeGraphAI).
- نسيان ترويسات الطلب: استخدم User-Agent واقعيًا وبدّله من وقت لوقت. وأضف Accept-Language وReferer وغيرها من الترويسات لمحاكاة المتصفحات الحقيقية (ScrapeGraphAI).
كيف تتجاوز آليات الحماية ضد scraping
المواقع الحديثة مزودة بوسائل قوية جدًا لمكافحة الروبوتات. هكذا أتفادى تلك الألغام الرقمية:
- تدوير proxies / IPs: استخدم مجموعة proxies وبدّل عناوين IP لتجنب الحظر (Medium).
- تغيير الترويسات عشوائيًا: بدّل User-Agent وAccept-Language وترويسات أخرى مع كل طلب.
- إخفاء بصمة المتصفح بلا واجهة: استخدم إضافات مثل
puppeteer-extra-plugin-stealthلإخفاء مؤشرات الأتمتة. - محاكاة السلوك البشري: أضف تأخيرات عشوائية، وحركات ماوس، وتمريرًا، وحتى أخطاء كتابة بسيطة (ZenRows).
محاكاة السلوك البشري في أدوات Node.js Scraper
وهنا تبدأ المتعة—ومعها شوية غرابة. بدل النقر والتمرير الفوريين، خل الأداة تتصرف كإنسان:
- انتظر فواصل زمنية عشوائية بين الإجراءات (
await page.waitForTimeout(randomDelay)) - حرّك الماوس بخطوات صغيرة وغير منتظمة (
page.mouse.move(x, y)) - اكتب مع تأخيرات عشوائية وأخطاء مطبعية أحيانًا (
page.type(selector, text, {delay: random(100,200)})) - مرّر الصفحة بشكل غير منتظم، لا إلى الأسفل فقط
هذه الحيل قد ترفع معدل النجاح بشكل ملحوظ على المواقع المحمية (ScraperAPI).
تبسيط استخراج البيانات المعقدة باستخدام Thunderbit
اجمع البيانات من أي موقع باستخدام الذكاء الاصطناعي تخلّص من الكود المكرر: أداة Thunderbit agentic web scraper تقرأ أي صفحة وتستخرج البيانات بنقرة واحدة، من دون الحاجة إلى صيانة كود Node.js. Get Started Free
الآن خلّنا نتكلم عن المشكلة الواضحة: scraping صعب. لكنه ما لازم يكون كذلك. لهذا السبب بنينا Thunderbit.
Thunderbit هو امتداد Chrome ذكي وموجّه (agentic web scraper) يتيح لك استخراج البيانات من أي موقع باستخدام اللغة الطبيعية. فقط اضغط “One Click Extract”، ودع الذكاء الاصطناعي يفهم الصفحة، ثم اضغط “Scrape”. الموضوع كأن عندك مطور مبتدئ ما ينام أبدًا ولا يطلب زيادة راتب.
والأفضل من ذلك أن Thunderbit يوفر API، بحيث تقدر تربطه مباشرةً مع تدفقات عمل Node.js الخاصة بك. بدل كتابة آلاف الأسطر من كود scraping، تقدر تخلي Thunderbit يتولى الشغل الثقيل—المحتوى الديناميكي، والصفحات الفرعية، والصفحات المتعددة، وكل هذا. كل اللي عليك هو سحب البيانات المهيكلة (CSV أو JSON أو التصدير المباشر إلى Google Sheets أو Airtable أو Notion) ومتابعة يومك (Thunderbit Blog).
جرّب إضافة Thunderbit Chrome مجانًا ثبّت إضافة Chrome المجانية واستخرج البيانات المهيكلة بنقرة واحدة — أو استدعِ API الخاص بـ Thunderbit من تطبيق Node.js لديك. Get Started Free
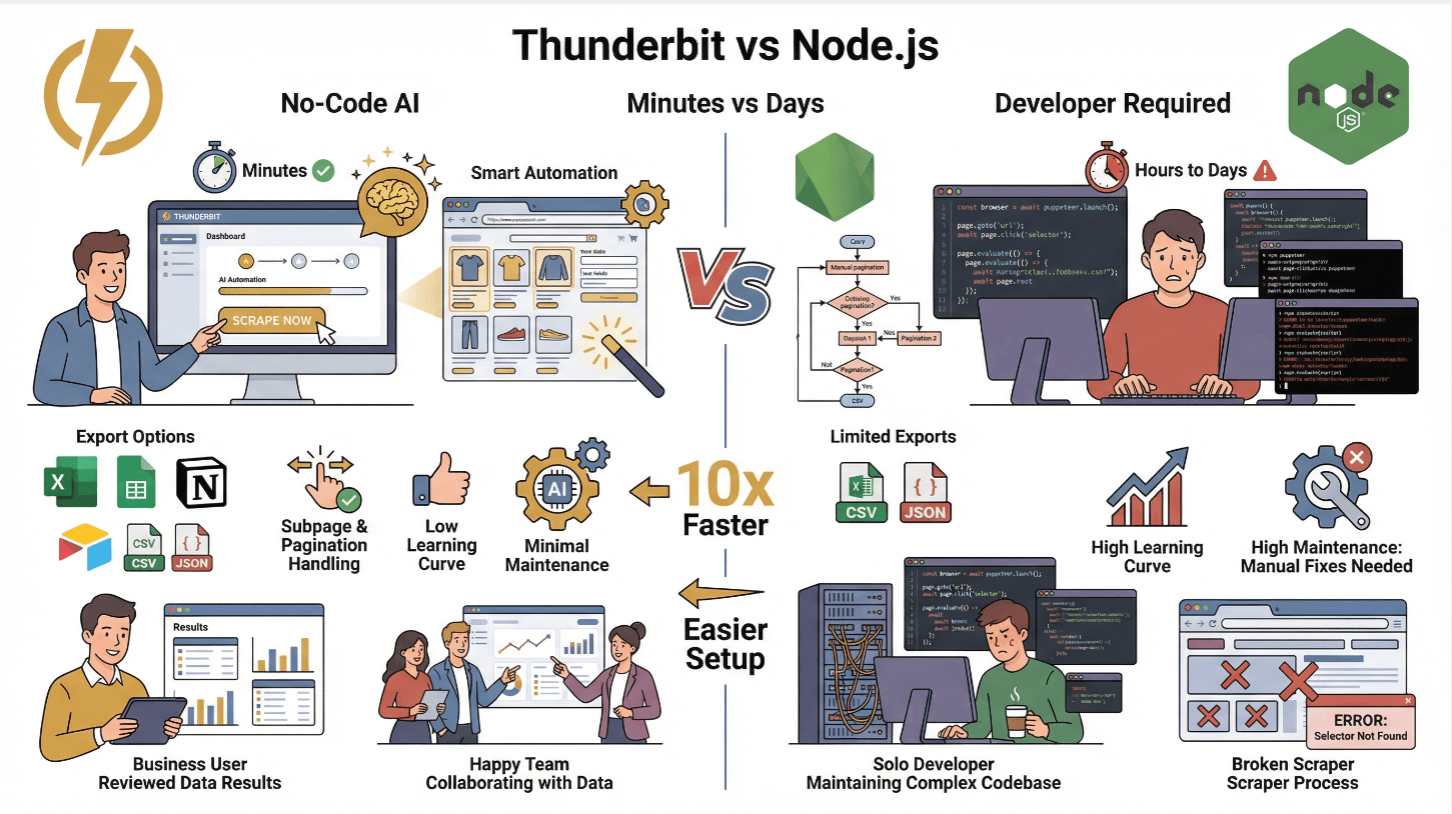
Thunderbit مقابل scraping التقليدي في Node.js
| الميزة | Thunderbit | أداة Node.js تقليدية لـ scraping |
|---|---|---|
| وقت الإعداد | دقائق (بدون كود) | من ساعات إلى أيام (برمجة، اختبار) |
| التعامل مع المحتوى الديناميكي | نعم (ذكاء اصطناعي + متصفح) | نعم (باستخدام Puppeteer/Playwright) |
| الصفحات الفرعية والصفحات المتعددة | بنقرة واحدة | يتطلب برمجة يدوية |
| تصدير البيانات | Excel، Sheets، Notion، Airtable، CSV، JSON | CSV/JSON (كود مخصص) |
| منحنى التعلم | منخفض (مستخدمو الأعمال) | مرتفع (المطورون) |
| الصيانة | بسيطة جدًا (الذكاء الاصطناعي يتكيف) | عالية (إصلاحات يدوية مع تغيّر المواقع) |
Thunderbit مثالي للفرق غير التقنية أو لأي شخص يريد يتجاوز الشغل الروتيني ويركّز على الأفكار والرؤى. وللمستخدمين المتقدمين، تقدر أيضًا تستخدم API الخاص بـ Thunderbit لأتمتة scraping على نطاق واسع (Thunderbit Docs).
الجمع بين Cheerio وPuppeteer للمحتوى الديناميكي
هذا هو المزيج المفضل لدي في Node.js scraping. وهكذا يشتغل:
- استخدم Puppeteer لتحميل الصفحة وتنفيذ JavaScript (وانتظر
networkidleللتأكد من اكتمال تحميل المحتوى). - استخرج HTML باستخدام
await page.content(). - حلله عبر Cheerio: مرّر HTML إلى Cheerio لتحليل سريع جدًا بأسلوب jQuery واستخراج البيانات.
هذا الأسلوب الهجين يعطيك أفضل ما في العالمين: قوة Puppeteer مع المحتوى الديناميكي، وسرعة Cheerio في التحليل (Browserless).
نصيحة أداء: اختر العناصر التي تحتاجها فقط. Cheerio يحمّل DOM كاملًا إلى الذاكرة، لذا تجنب المحددات الواسعة واحتفظ بنتائجك مؤقتًا إذا كنت تزور الصفحات نفسها مرارًا (Oxylabs).
تحسين تحليل HTML واستخراج البيانات
- استخدم selectors محددة: تجنب
$('body *')—استهدف فقط ما تحتاجه. - قم ببث الصفحات الكبيرة: مع HTML الضخم، فكّر في streaming أو تقسيم العمل.
- احتفظ بنسخة مخزنة من HTML المعروض: إذا كنت ترجع لنفس الروابط، خزّن HTML لتجنب الطلبات المتكررة.
- تحقق ونظف البيانات: استخدم مكتبات التحقق حتى لا تملأ قاعدة بياناتك ببيانات غير مفيدة (ScrapeGraphAI).
نشر Web Scraper قابل للتوسع في Node.js على السحابة
هل تعمل على scraping واسع النطاق؟ حان وقت الانتقال إلى السحابة.
- حوّل الأداة إلى Docker: أنشئ
Dockerfile، وانسخ الكود، وثبّت الاعتمادات، وحدد نقطة التشغيل. - انشر على السحابة: استخدم AWS EC2 أو Google Cloud Compute أو Azure VMs للمهام البسيطة. وللتوسع الجاد، استخدم Kubernetes أو خدمات مُدارة مثل AWS ECS/EKS أو Google Cloud Run أو Azure Kubernetes Service (DigitalOcean).
- نسّق العمل عبر Kubernetes: شغّل عدة pods، وفعّل autoscaling حسب الطلب، واستخدم load balancers لتوزيع الروابط.
- جدولة المهام: استخدم مجدولي السحابة (CloudWatch Events, Cloud Scheduler) أو مهام cron لتشغيل عمليات scraping على فترات.
في مثال حقيقي، أدى التوسع من 5 إلى 10 Kubernetes pods إلى تقليص عملية scraping لعدد 400 صفحة من دقائق إلى أقل من دقيقة (DigitalOcean).
مراقبة البنية التحتية الخاصة بـ scraping والتوسع التلقائي
- التسجيل: أرسل السجلات إلى CloudWatch أو Stackdriver أو Datadog. واضبط تنبيهات للأخطاء أو البطء.
- فحوصات السلامة: استخدم Prometheus وGrafana لقياس مؤشرات مثل عدد الصفحات المستخرجة في الدقيقة، ومعدلات الخطأ، وصحة pods.
- التوسع التلقائي: فعّل Kubernetes HPA (Horizontal Pod Autoscaler) لتوسيع pods اعتمادًا على CPU أو عدد الطلبات.
طبّق دائمًا retries مع exponential backoff للتعافي من مشاكل الشبكة أو الحظر المؤقت.
أفضل الممارسات لتخزين البيانات والمعالجة اللاحقة
بعد جمع البيانات، تحتاج إلى تخزينها وتنظيفها:
- المهام الصغيرة: صدّر إلى CSV أو JSON، أو أرسل البيانات إلى Google Sheets أو Airtable أو Notion (وThunderbit يفعل ذلك تلقائيًا).
- المهام الكبيرة: استخدم SQL (MySQL/PostgreSQL) للبيانات المهيكلة، أو NoSQL (MongoDB, DynamoDB) للبيانات شبه المهيكلة أو المتغيرة (ScrapeHero).
- التخزين السحابي: استخدم S3 أو Google Cloud Storage للملفات الخام والنسخ الاحتياطية.
- تنظيف البيانات: تحقّق دائمًا من الحقول، ووحّد التنسيقات (التواريخ، الأرقام)، وأزل التكرار. واستخدم schema validators لضمان جودة البيانات (ScrapeGraphAI).
احتفظ بالبيانات الخام والمنظفة معًا—فأنت ما تعرف متى قد تحتاج إلى إعادة المعالجة أو تتبع الأخطاء.
الخلاصة: أهم النقاط لرفع كفاءة Node.js Web Scraping
تخلَّ عن كود الـ Scraper شاهد كيف يقارن Thunderbit agentic web scraper بكتابة سكربتات scraping الخاصة بك وصيانتها. Get Started Free
لنلخّص الأساسيات:
- استفد من قوة Node.js غير المتزامنة لجمع البيانات بكميات هائلة وبالتوازي—خصوصًا على المواقع الغنية بـ JavaScript.
- اجمع الأدوات المناسبة: استخدم axios/got للطلبات، وCheerio للـ HTML الثابت، وPuppeteer للمحتوى الديناميكي، وامزج بينها للسرعة والمرونة.
- تجنب فخاخ مكافحة الروبوتات: دوّر proxies والترويسات، وامثل السلوك البشري، واحترم robots.txt.
- بسّط العمل مع Thunderbit: للمستخدمين غير المطورين أو للنماذج السريعة، يتيح لك Thunderbit استخراج البيانات المعقدة بالذكاء الاصطناعي وربطها مع بيئة Node.js عبر API.
- انشر على نطاق واسع: استخدم Docker، ونسق عبر Kubernetes، وراقب كل شيء لضمان الاعتمادية.
- خزّن بياناتك ونظفها: اختر التخزين المناسب لاحتياجك، وتحقق دائمًا قبل الاستخدام.
الويب لن يصير أبسط، لكن مع هذه الممارسات الأفضل ستبقى أدوات Node.js الخاصة بك سريعة وموثوقة ومتقدمة خطوة على سباق مكافحة الروبوتات. وإذا تعبت يومًا من إصلاح selectors عند الثانية صباحًا، فتذكر: ذكاء Thunderbit الاصطناعي مستيقظ دائمًا.
هل تريد تكمل التعلم؟ اطلع على Thunderbit Blog لمزيد من التحليلات المتعمقة، أو جرّب إضافة Chrome الخاصة بـ Thunderbit لترى قدّ إيش scraping صار سهلًا.
اجمع البيانات مع Thunderbit Agentic Web Scraper تتيح لك Thunderbit Web Scraper API تشغيل الاستخراج من كود Node.js الخاص بك، مع خطة مجانية للبدء. Get Started Free
الأسئلة الشائعة
1. لماذا يُعد Node.js مناسبًا جدًا لـ web scraping في 2025؟
يتيح نموذج Node.js غير المتزامن والقائم على الأحداث التعامل مع آلاف الطلبات المتزامنة، ما يجعله مثاليًا لاستخراج كميات كبيرة من البيانات أو التحديثات اللحظية. كما أن منظومة npm الضخمة ودعم JavaScript الأصلي يناسبان مواقع الويب الحديثة المعتمدة على JS (Node.js Docs).
2. كيف أتجنب الحظر أثناء scraping باستخدام Node.js؟
استخدم proxies متناوبة، وغيّر ترويسات الطلبات عشوائيًا، وقلّل سرعة الطلبات بتأخيرات عشوائية، وامثل السلوك البشري (حركة الماوس، التمرير، الكتابة) باستخدام أدوات مثل Puppeteer. واحترم دائمًا robots.txt وشروط الموقع (Medium).
3. متى أستخدم Cheerio ومتى أستخدم Puppeteer في scraper الخاص بـ Node.js؟
استخدم Cheerio لتحليل HTML الثابت بسرعة عندما تكون البيانات موجودة في HTML الخام. واستخدم Puppeteer للمواقع التي تُحمّل المحتوى ديناميكيًا باستخدام JavaScript. ولأفضل النتائج، استخدم Puppeteer لعرض الصفحة أولًا، ثم Cheerio لتحليل HTML (Bright Data).
4. كيف يبسّط Thunderbit عملية web scraping في Node.js؟
يتيح لك Thunderbit استخراج بيانات مهيكلة من أي موقع باستخدام الذكاء الاصطناعي ومطالبات اللغة الطبيعية—من دون كتابة كود. ويتعامل مع المحتوى الديناميكي والصفحات الفرعية والصفحات المتعددة، ويقدّم API للتكامل مع Node.js. ويمكن تصدير البيانات مباشرةً إلى Excel أو Google Sheets أو Airtable أو Notion (Thunderbit Blog).
5. ما أفضل طريقة لتوسيع ومراقبة أدوات Node.js scraper في السحابة؟
حوّل الأداة إلى Docker، وانشرها على Kubernetes أو خدمات سحابية مُدارة، واستخدم التوسع التلقائي لمواجهة الازدحام. راقب السجلات والمؤشرات باستخدام أدوات مثل CloudWatch أو Prometheus، واضبط تنبيهات للأخطاء أو البطء (DigitalOcean).
هل أنت مستعد ترفع مستوى مهاراتك في web scraping؟ جرّب Thunderbit، وخلي أدواتك سريعة، متخفية، ومتقدمة دائمًا بخطوة على المنافسة.
جرّب Agentic Web Scraper Get Started Free
اعرف المزيد




