
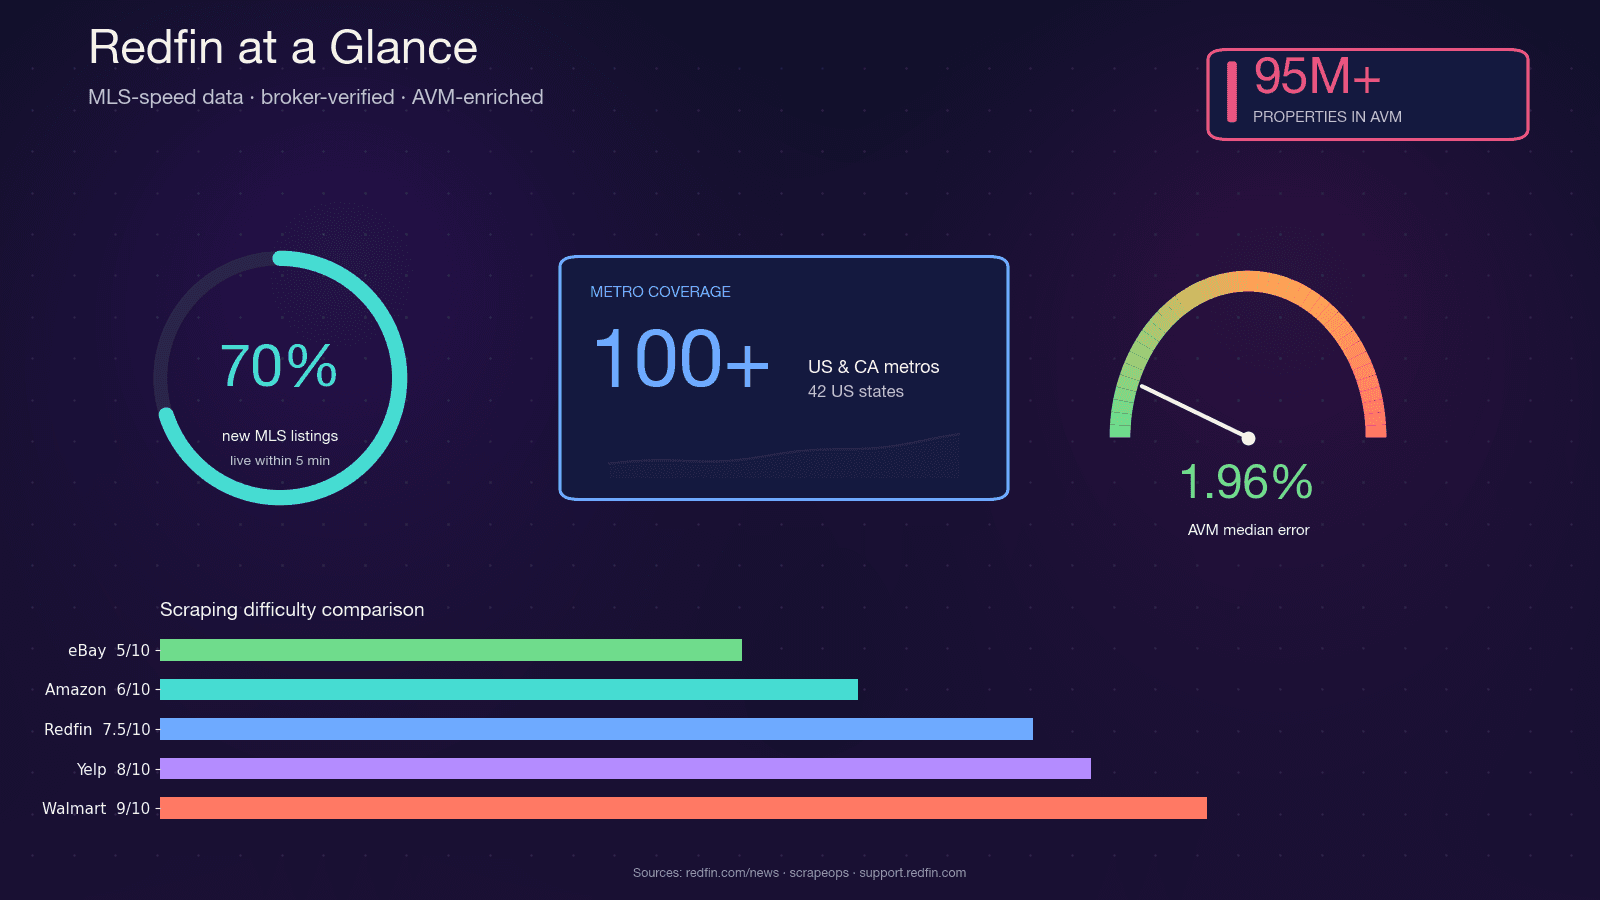
Redfin cập nhật 70% tin đăng MLS mới tại Mỹ trong vòng năm phút sau khi dữ liệu xuất hiện trên hệ thống. Độ tươi dữ liệu như vậy là “món khoái khẩu” với bất kỳ ai đang xây pipeline dữ liệu bất động sản — và cũng chính là lý do rất nhiều scraper nhắm vào Redfin rồi bị chặn chỉ sau vài phút.
Tôi đã dành nhiều năm làm việc với các công cụ trích xuất dữ liệu tại Thunderbit, và tôi có thể nói thẳng: khoảng cách giữa “scrape Redfin” và “scrape Redfin mà không bị chặn” là nơi phần lớn hướng dẫn thất bại. Họ cho bạn đoạn code BeautifulSoup, bỏ qua phần Cloudflare chặn sạch request, rồi để bạn ngồi nhìn trang 403 mà không hiểu vì sao. Bài viết này sẽ khác. Tôi sẽ dẫn bạn qua ba cách làm thực tế — phân tích HTML, dùng API ẩn của Redfin, và cách không cần code với Thunderbit — đồng thời đi sâu vào các lớp chống bot thực sự quan trọng. Đọc xong, bạn sẽ biết chính xác phương pháp nào hợp với trình độ, quy mô và mức độ chịu đựng việc bảo trì của mình.
Dùng thử Thunderbit để scrape Redfin
Redfin là gì, và vì sao dữ liệu của nó lại quan trọng?
Redfin là một công ty môi giới bất động sản ứng dụng công nghệ, với đội ngũ môi giới hưởng lương và lấy tin đăng trực tiếp từ các nguồn MLS. Nền tảng này phủ hơn 100 khu đô thị tại Mỹ và Canada trên 42 bang và phục vụ gần 50 triệu lượt truy cập mỗi tháng. Khác với các cổng tổng hợp dữ liệu đơn thuần, dữ liệu của Redfin được xác minh bởi môi giới, còn mô hình định giá độc quyền Redfin Estimate AVM bao phủ hơn 95 triệu bất động sản với sai số trung vị chỉ 1.96% đối với nhà đang niêm yết.
Sự kết hợp giữa tốc độ cập nhật kiểu MLS, chất lượng được môi giới xác thực và mô hình AVM chính xác khiến nhà đầu tư bất động sản, môi giới, startup proptech và nhà phân tích dữ liệu đều muốn truy cập Redfin theo cách tự động. Python là lựa chọn tự nhiên cho công việc này: hệ sinh thái scraping của nó (requests, BeautifulSoup, Selenium, Playwright) đã rất trưởng thành, cộng đồng hỗ trợ mạnh, và tích hợp trực tiếp với pandas cùng Jupyter để phân tích.
Vì sao nên scrape Redfin bằng Python?
Các nhu cầu sử dụng rất đa dạng, tùy vào người cần dữ liệu. Dưới đây là cách các nhóm người dùng thường khai thác dữ liệu Redfin đã scrape:
| Đối tượng | Mục tiêu chính khi scrape | Ví dụ ứng dụng |
|---|---|---|
| Môi giới bất động sản | Tìm lead, nắm bắt thị trường | Tin đăng mới và tin hết hạn trong khu vực phụ trách; danh bạ môi giới để so sánh đối thủ |
| Nhà đầu tư bất động sản | Dòng deal, phân tích cap rate | Sàng lọc lợi suất cho thuê, phát hiện tài sản định giá thấp, cảnh báo tin đăng mới hàng ngày |
| Startup PropTech | Pipeline dữ liệu cho sản phẩm | Dữ liệu huấn luyện AVM, dashboard thị trường, engine thu mua iBuyer |
| Nhà phân tích dữ liệu | Nghiên cứu thị trường, BI | Xu hướng giá trung vị theo ZIP code, chuỗi thời gian days-on-market, tỷ lệ giá bán/giá niêm yết |
| Wholesaler / flipper | Theo dõi tài sản khó khăn | Phát hiện giảm giá, nhà bị tịch thu, so sánh với tài sản ngoài thị trường |
Xu hướng lớn cũng cho thấy điều này là thật: hơn 72% công ty bất động sản hiện dùng phân tích dự đoán để tìm cơ hội và quản trị rủi ro. Thị trường PropTech được dự báo chạm mốc $47 tỷ vào năm 2025 với tốc độ tăng trưởng kép 16.4%. Dữ liệu bất động sản có cấu trúc giờ không còn là “nên có” nữa — mà là tiêu chuẩn bắt buộc.
Tất cả các trường dữ liệu Redfin bạn có thể scrape (tham khảo đầy đủ)
Trước khi viết một dòng code nào, bạn cần biết chính xác mình có thể lấy được gì. Tôi đã rà soát trang kết quả tìm kiếm, trang chi tiết bất động sản và hồ sơ môi giới của Redfin — rồi đối chiếu với các wrapper Stingray API mã nguồn mở như dự án reteps/redfin và RedfinPlus. Tổng cộng có 117 trường dữ liệu khác nhau trên nhiều loại trang.
Bảng này rất đáng để bookmark. Biết trước schema dữ liệu sẽ giúp bạn tiết kiệm hàng giờ loay hoay tìm selector.
Các trường trên trang kết quả tìm kiếm
Đây là những trường nhẹ trên thẻ tin đăng — thường có thể trích xuất mà không cần render đầy đủ JavaScript:
| Trường | Kiểu dữ liệu | Ghi chú |
|---|---|---|
| Property ID | Số | Số nguyên nội bộ của Redfin, lấy từ /home/{id} trong href |
| Giá niêm yết | Số | |
| Địa chỉ đầy đủ | Văn bản | |
| Phòng ngủ / Phòng tắm / SqFt | Số | Ba giá trị theo thứ tự |
| Loại bất động sản | Chọn một | SFH, Condo, Townhouse, Multi |
| Trạng thái | Văn bản | Active, Pending, Contingent |
| Số ngày trên thị trường | Số | |
| Chỉ báo giảm giá | Số | Mức chênh lệch so với giá niêm yết ban đầu |
| Ảnh chính | URL ảnh | Mỗi thẻ một ảnh |
| Huy hiệu Hot Home | Boolean | |
| Thời gian open house | Văn bản | |
| Ghi nhận môi giới | Văn bản |
Các trường trên trang chi tiết bất động sản
Trang chi tiết mới là nơi có nhiều dữ liệu sâu hơn. Nhiều trường trong số này cần render JavaScript hoặc dùng Stingray API:
| Trường | Kiểu dữ liệu | Ghi chú |
|---|---|---|
| Redfin Estimate (đang niêm yết) | Số | Qua /stingray/api/home/details/avm |
| Redfin Estimate (ngoài thị trường) | Số | Qua /stingray/api/home/details/owner-estimate; sai số trung vị 7.52% |
| Năm xây / cải tạo | Số | |
| Diện tích lô đất | Số | |
| Phí HOA | Số | Hàng tháng, nếu có |
| Thuế bất động sản (năm) | Số | |
| Giá trị định giá thuế | Số | |
| Bảng lịch sử giao dịch | Bảng | Giá, ngày, loại sự kiện |
| Mô tả bất động sản | Văn bản | Đoạn marketing |
| URL ảnh (carousel) | URL ảnh | 20+ ảnh cho mỗi tin |
| Tên môi giới, số điện thoại, email | Văn bản / SĐT / Email | Số điện thoại thường bị ẩn bớt |
| Xếp hạng trường học (tiểu học / THCS / THPT) | Số | Kèm tên khu học chánh |
| Walk / Transit / Bike Score | Số | |
| Điểm rủi ro khí hậu | Số | Lũ, cháy, nóng, gió |
| Nhà tương tự đang bán / đã bán / gần đó | URL | Dữ liệu dạng carousel |
| Chỗ đậu xe, garage, sưởi, làm mát | Văn bản | Nhóm tiện ích |
Các trường trên hồ sơ môi giới
| Trường | Kiểu dữ liệu | Ghi chú |
|---|---|---|
| Tên môi giới, ảnh, công ty môi giới, bio | Văn bản / Ảnh | |
| Số điện thoại, form liên hệ | SĐT / Văn bản | Chỉ hiện khi click |
| Số tin đang hoạt động | Số | |
| Doanh số 12 tháng gần nhất / tổng khối lượng | Số | |
| Tỷ lệ giá niêm yết/giá bán trung bình | Số | |
| Xếp hạng sao / số lượng đánh giá | Số | |
| Số năm kinh nghiệm / số giấy phép | Văn bản / Số |
Khi bạn dùng tính năng AI Suggest Fields của Thunderbit trên một trang Redfin, công cụ sẽ tự nhận diện hầu hết các cột này và gán đúng kiểu dữ liệu — không cần tự map CSS selector thủ công. Tôi sẽ nói kỹ hơn ở phần sau.
Cơ chế chống bot của Redfin hoạt động thế nào? Không chỉ là “dùng proxy”
Đây là điểm tôi muốn nhấn mạnh, vì đa số hướng dẫn thường lướt qua chuyện bị chặn rồi nhảy thẳng đến “mua proxy từ nhà tài trợ của chúng tôi.” Điều đó không hữu ích. Nếu bạn không hiểu Redfin phát hiện scraper bằng cách nào, bạn sẽ đốt sạch proxy credit mà vẫn bị chặn. ScrapeOps chấm độ khó chống bot của Redfin là 7.5/10, còn Scraperly xếp nó ở mức trung bình (3/5) — “ít hung hãn hơn WAF cấp doanh nghiệp của Zillow, chủ yếu dựa vào giới hạn tốc độ tùy biến và các thử thách JavaScript.”
Redfin dùng một hệ thống nhiều lớp: Cloudflare ở lớp biên (JS challenge, Turnstile, fingerprinting TLS/JA3) cộng thêm bộ giới hạn tốc độ ở tầng ứng dụng riêng của Redfin. Trong robots.txt không có chỉ thị Crawl-delay vì việc thực thi nằm ở tầng WAF.
Vì sao requests + BeautifulSoup đơn giản lại thất bại trên Redfin
Nếu bạn gửi một requests.get() cơ bản tới trang bất động sản của Redfin với header mặc định, thường sẽ xảy ra một trong các tình huống sau:
- HTTP 403 — Cloudflare challenge không được giải, nên bạn nhận trang thử thách thay vì nội dung tin đăng.
- Trang challenge xen giữa — phần HTML chứa widget Turnstile của Cloudflare, không phải dữ liệu bất động sản.
- HTTP 200 với HTML dở dang — bạn nhận được khung trang có một blob JSON lớn nhúng dưới
root.__reactServerState.InitialContext, nhưng không có card tìm kiếm đã render sẵn, không có lịch sử giá, không có xếp hạng trường học.
Redfin dùng framework React SSR riêng (không phải Next.js), và key hydration mang tính riêng của Redfin — root.__reactServerState.InitialContext với dữ liệu tin đăng nằm dưới ReactServerAgent.cache.dataCache. Đây không phải __NEXT_DATA__ hay window.__INITIAL_STATE__.
Nguyên nhân phổ biến nhất khiến bị 403 âm thầm? Thiếu header Sec-Fetch-*. Redfin/Cloudflare kiểm tra rõ Sec-Fetch-Site, Sec-Fetch-Mode, Sec-Fetch-Dest và Sec-Fetch-User. Nếu thiếu, bạn sẽ bị đánh dấu ngay.
Bản đồ giảm thiểu rủi ro: delay, header, proxy và session
Dưới đây là phân tích đầy đủ từng lớp phòng thủ và cách xử lý tương ứng:
| Phòng thủ của Redfin | Nó làm gì | Dấu hiệu phát hiện | Cách giảm thiểu |
|---|---|---|---|
| Cloudflare JS challenge | Trang xen giữa cấp cookie cf_clearance | 403 + body HTML của Cloudflare | curl_cffi với impersonate="chrome120"; khởi động session qua trang chủ; proxy residential tại Mỹ |
| Cloudflare Turnstile | CAPTCHA tương tác trên session rủi ro cao | 403 + widget Turnstile | Trình duyệt headless có stealth + proxy residential |
| Cloudflare Error 1020 (cấm ASN) | Chặn IP/ASN bị gắn cờ ở WAF | Body 403 “Error 1020 Access Denied” | Đổi sang proxy residential/mobile; không dùng ASN datacenter |
| TLS/JA3 fingerprinting | Phát hiện stack TLS không giống trình duyệt | 403 âm thầm dù header đúng | Giả lập bằng curl_cffi hoặc dùng trình duyệt thật |
| HTTP/2 fingerprinting | Kiểm tra SETTINGS HTTP/2, thứ tự HPACK | Bị chặn âm thầm | curl_cffi giao tiếp HTTP/2 giống Chrome |
| Kiểm tra header (UA, Sec-Fetch-*) | Bộ header phải giống trình duyệt | 403 ngay từ request đầu | Bộ header Chrome đầy đủ gồm Sec-Fetch-Site/Mode/Dest/User, cùng Referer hợp lý |
| Liên tục cookie/session | Theo dõi cf_clearance, RF_BROWSER_ID | Bị challenge khi vào deep URL từ trạng thái lạnh | Session bền vững; mở trang chủ để làm nóng trước |
| Giới hạn tốc độ tầng ứng dụng | Giới hạn request theo IP | 429 | Delay 2–5 giây kèm jitter; exponential backoff |
| Uy tín IP datacenter | Chặn các ASN datacenter đã biết | 1020/403 ngay | Chỉ dùng proxy residential hoặc mobile tại Mỹ |
| Phát hiện concurrency | Nhiều request song song từ một IP | Tăng cường Turnstile đột ngột | Tối đa 2 request đồng thời mỗi IP |
Ngưỡng thực tế từ thử nghiệm cộng đồng:
- Nhịp an toàn: 1 request mỗi 2–3 giây cho mỗi IP
- Duy trì trên 20–30 req/phút từ một IP datacenter sẽ kích hoạt challenge trong vài phút
- Soft rate-limit thường giảm sau 5–15 phút nếu dừng traffic
- Lệnh cấm IP datacenter (AWS, GCP, Azure, OVH) có thể kéo dài từ vài giờ đến vài ngày
Python requests mặc định (urllib3 + OpenSSL) tạo ra JA3 fingerprint không khớp với bất kỳ trình duyệt nào — và sẽ bị chặn âm thầm dù header nhìn rất “đúng”. Cách sửa chuẩn của ngành là curl_cffi với impersonate="chrome120", để mô phỏng TLS + HTTP/2 giống Chrome.
Ba cách scrape Redfin bằng Python (và nên chọn cách nào)
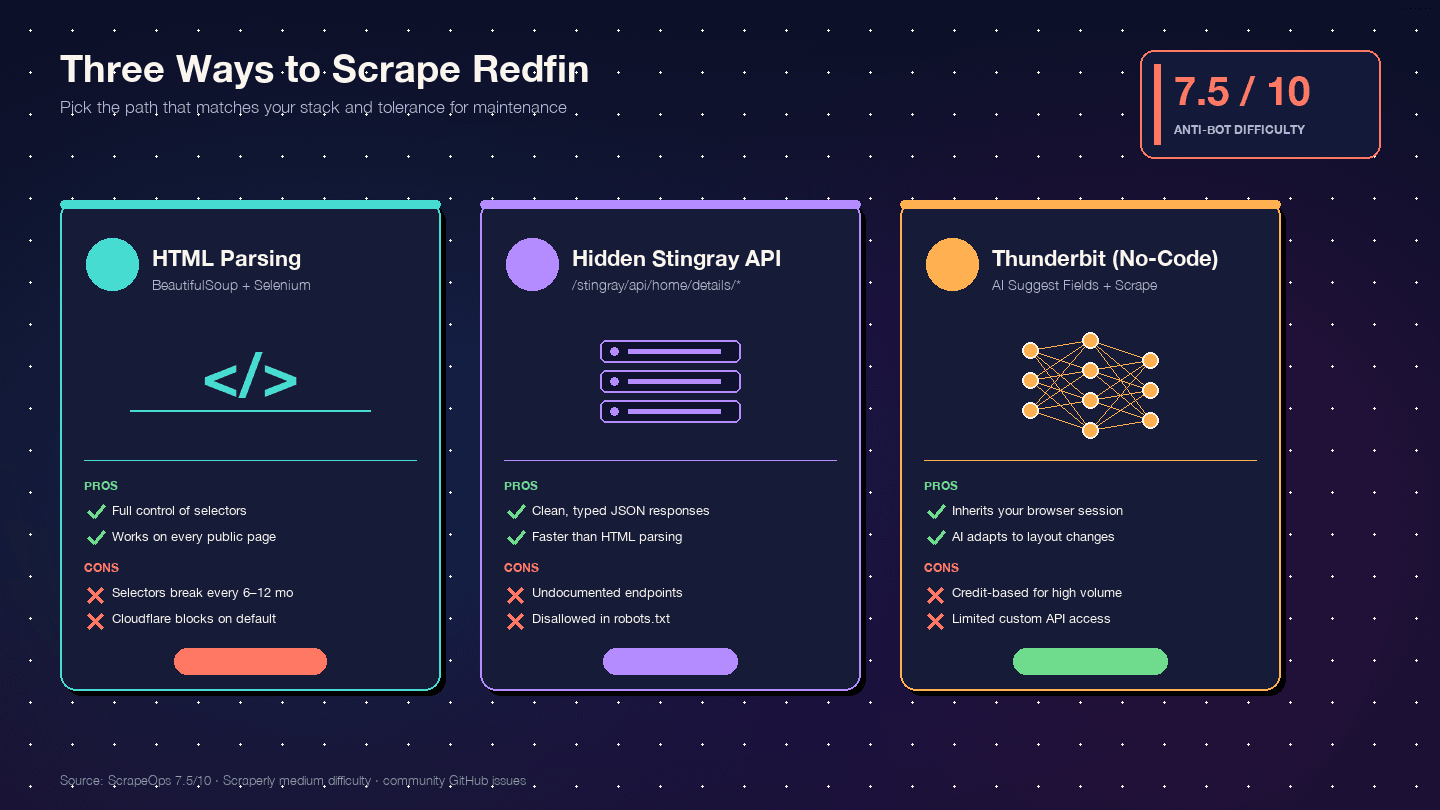
Tôi chưa thấy một hướng dẫn cạnh tranh nào so sánh cả ba cách này cạnh nhau. Đây là bảng quyết định:
| Tiêu chí | Phân tích HTML (BS4 + Selenium) | Hidden API Stingray | Thunderbit (No-Code) |
|---|---|---|---|
| Độ khó thiết lập | Trung bình (Python env + browser driver) | Cao (reverse-engineering endpoint) | Thấp (cài extension Chrome) |
| Rủi ro bị chặn | Cao (request DOM dễ bị phát hiện nhất) | Trung bình (request kiểu API trông sạch hơn) | Thấp nhất (dùng session trình duyệt thật của bạn) |
| Chất lượng cấu trúc dữ liệu | Trung bình (HTML rối → phải parse thủ công) | Rất tốt (JSON có cấu trúc sẵn) | Cao (AI tự nhận diện trường + kiểu dữ liệu) |
| Gánh nặng bảo trì | Cao — chỉ cần đổi layout là selector hỏng | Trung bình — endpoint có thể đổi mà không báo trước | Thấp nhất — AI thích nghi với đổi layout |
| Quy mô | Thấp–trung bình (vài trăm trang nếu có proxy) | Trung bình–cao (hàng nghìn, request sạch hơn) | Trung bình (50 trang/lần qua cloud scraping) |
| Phù hợp nhất với | Developer muốn kiểm soát toàn bộ | Developer cần JSON sạch | Người không code, dự án nhanh, nhu cầu dữ liệu dài hạn không có dev hỗ trợ |
Yếu tố bảo trì đáng được nhấn mạnh. Redfin đã có hai thế hệ DOM cho card — kiểu cũ (homecardV2Price) và kiểu hiện tại (span.bp-Homecard__Price--value). Lịch sử issue trên GitHub cho thấy selector CSS thường gãy khoảng mỗi 6–12 tháng. Khi chuyện đó xảy ra, scraper BeautifulSoup có thể hỏng qua đêm. Bộ dò trường bằng AI sẽ tự thích nghi.
Trước khi bắt đầu
- Mức độ khó: Trung cấp (Cách 1 & 2), Cơ bản (Cách 3)
- Thời gian cần thiết: ~30 phút cho Cách 1 hoặc 2; ~5 phút cho Cách 3
- Bạn cần:
- Python 3.8+ với pip (Cách 1 & 2)
- Trình duyệt Chrome (tất cả các cách)
- Thunderbit Chrome Extension (Cách 3)
- Proxy residential tại Mỹ nếu scrape quy mô lớn (Cách 1 & 2)
Scrape dữ liệu Redfin bằng AI Get Started Free
Cách 1: Scrape Redfin bằng Python với phân tích HTML (BeautifulSoup + Selenium)
Đây là con đường “toàn quyền kiểm soát”. Bạn tự viết selector, tự quản lý trình duyệt, tự xử lý lỗi.
Đây là cách giúp học hỏi nhiều nhất. Nhưng cũng là cách mong manh nhất.
Bước 1: Thiết lập môi trường Python
Tạo virtual environment và cài các thư viện cần thiết:
python -m venv redfin-scraper
source redfin-scraper/bin/activate  # Trên Windows: redfin-scraper\Scripts\activate
pip install requests beautifulsoup4 selenium webdriver-manager pandas curl_cffi
curl_cffi là phần rất quan trọng ở đây — nó cho phép request HTTP của bạn giả lập fingerprint TLS của Chrome thật, thay vì fingerprint mặc định của Python requests vốn bị Cloudflare chặn ngay từ cái nhìn đầu tiên.
Bước 2: Cấu hình header và session trình duyệt
Đây là chỗ nhiều người mới thất bại. Bạn cần bộ header Chrome đầy đủ, bao gồm các header Sec-Fetch-* mà Redfin/Cloudflare kiểm tra trực tiếp:
from curl_cffi import requests as curl_requests

HEADERS = {
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/120.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept-Encoding": "gzip, deflate, br",
    "Sec-Fetch-Site": "none",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-User": "?1",
}

session = curl_requests.Session(impersonate="chrome120")
session.headers.update(HEADERS)

# Làm nóng session — lấy cookie cf_clearance và RF_BROWSER_ID
session.get("https://www.redfin.com/")
Bước làm nóng session là cực kỳ quan trọng — đi thẳng vào một URL bất động sản sâu mà không có cookie hay Referer trước đó sẽ bị Cloudflare đánh điểm thấp.
Luôn bắt đầu từ trang chủ.
Bước 3: Scrape kết quả tìm kiếm trên Redfin
Khi session đã được làm nóng, bạn có thể lấy trang tìm kiếm theo thành phố và parse các card tin đăng. Selector thế hệ hiện tại (2024–2026):
import time
import random
from bs4 import BeautifulSoup

base_url = "https://www.redfin.com/city/17151/CA/San-Francisco"
listings = []

for page_num in range(1, 6):  # Trang 1-5
    url = f"{base_url}/page-{page_num}" if page_num > 1 else base_url
    resp = session.get(url)

    if resp.status_code != 200:
        print(f"Bị chặn ở trang {page_num}: HTTP {resp.status_code}")
        break

    soup = BeautifulSoup(resp.text, "html.parser")
    cards = soup.select("[data-rf-test-id='property-card'], a.bp-Homecard")

    for card in cards:
        price_el = card.select_one("span.bp-Homecard__Price--value")
        addr_el = card.select_one("a.bp-Homecard__Address")
        stats = card.select("span.bp-Homecard__LockedStat--value")

        listing = {
            "price": price_el.text.strip() if price_el else None,
            "address": addr_el.text.strip() if addr_el else None,
            "beds": stats[0].text.strip() if len(stats) > 0 else None,
            "baths": stats[1].text.strip() if len(stats) > 1 else None,
            "sqft": stats[2].text.strip() if len(stats) > 2 else None,
            "url": "https://www.redfin.com" + addr_el["href"] if addr_el else None,
        }
        listings.append(listing)

    # Delay ngẫu nhiên 2-5 giây
    time.sleep(random.uniform(2, 5))

print(f"Đã scrape {len(listings)} tin đăng")
Bạn sẽ thấy một danh sách dictionary tăng dần, mỗi phần tử chứa giá, địa chỉ, phòng ngủ/phòng tắm/diện tích và URL chi tiết của một tin tại San Francisco. Nếu nhận được 0 card, hãy kiểm tra HTTP status code — 403 nghĩa là Cloudflare đã phát hiện ra bạn, và lúc đó rất có thể bạn cần proxy residential.
Bước 4: Scrape trang chi tiết từng bất động sản
Trang kết quả cho bạn thông tin cơ bản. Trang chi tiết mới có Redfin Estimate, năm xây dựng, HOA, lịch sử giao dịch, thông tin môi giới và ảnh. Các trang này cần render JavaScript, nên hãy chuyển sang Selenium:
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from webdriver_manager.chrome import ChromeDriverManager
from selenium.webdriver.common.by import By
import time

options = webdriver.ChromeOptions()
options.add_argument("--headless=new")
options.add_argument("--disable-blink-features=AutomationControlled")
options.add_argument("user-agent=Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                     "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36")

driver = webdriver.Chrome(service=Service(ChromeDriverManager().install()), options=options)

for listing in listings[:10]:  # Làm giàu dữ liệu cho 10 tin đầu
    driver.get(listing["url"])
    time.sleep(random.uniform(3, 6))  # Chờ JS render

    try:
        estimate_el = driver.find_element(By.CSS_SELECTOR, "[data-rf-test-name='avmLdpPrice']")
        listing["redfin_estimate"] = estimate_el.text.strip()
    except:
        listing["redfin_estimate"] = None

    try:
        year_built = driver.find_element(By.XPATH, "//span[contains(text(),'Year Built')]/following-sibling::span")
        listing["year_built"] = year_built.text.strip()
    except:
        listing["year_built"] = None

driver.quit()
Sau bước này, 10 tin đầu tiên của bạn sẽ được bổ sung Redfin Estimate và dữ liệu năm xây dựng. XPath thường bền hơn CSS cho các trường tiện ích lồng nhau, nhưng vẫn dễ gãy — chỉ cần DOM thay đổi là hỏng.
Bước 5: Xử lý chặn và lỗi
Triển khai cơ chế thử lại với exponential backoff:
import time

def fetch_with_retry(session, url, max_retries=3):
    for attempt in range(max_retries):
        resp = session.get(url)
        if resp.status_code == 200:
            return resp
        elif resp.status_code in (403, 429, 503):
            wait = (2 ** attempt) + random.uniform(1, 3)
            print(f"Bị chặn ({resp.status_code}). Thử lại sau {wait:.1f}s...")
            time.sleep(wait)
        else:
            print(f"Trạng thái bất thường: {resp.status_code}")
            break
    return None
Dấu hiệu bạn đã bị chặn: HTTP 403 kèm HTML của Cloudflare trong body, HTTP 429 (giới hạn tốc độ rõ ràng), body rỗng, hoặc cụm “Error 1020 Access Denied” trong nội dung trang. Nếu những lỗi này xuất hiện liên tục, đã đến lúc thêm proxy residential hoặc chuyển sang cách dùng API.
Cách 2: Scrape Redfin bằng Python qua Stingray API ẩn
Đây là cách tôi thích nhất. Frontend của Redfin nói chuyện với một JSON API nội bộ tại /stingray/api/home/details/*, và response trả về là JSON có kiểu dữ liệu rõ ràng — không cần parse HTML.
Cách tìm endpoint API ẩn của Redfin
Mở Chrome DevTools → tab Network → lọc Fetch/XHR → truy cập bất kỳ trang bất động sản nào của Redfin. Bạn sẽ thấy các request tới những endpoint như:
api/home/details/initialInfo— giải URL → propertyId, listingIdapi/home/details/aboveTheFold— giá, beds, baths, sqft, ảnh, trạng thái, môi giới, MLS#api/home/details/belowTheFold— tiện ích, HOA, thuế, parking, năm xây, lô đất, lịch sửapi/home/details/avm— Redfin Estimate cho nhà đang niêm yếtapi/home/details/owner-estimate— Redfin Estimate cho nhà ngoài thị trườngapi/home/details/descriptiveParagraph— mô tả marketing
Với trang cho thuê, rentalId (UUID 36 ký tự) được lấy từ URL trong thẻ <meta property="og:image">.
Scrape dữ liệu bất động sản qua Stingray API
Có một chi tiết quan trọng: phản hồi JSON của Stingray được thêm tiền tố chuỗi chữ {}&& như một biện pháp chống CSRF. Bạn phải bỏ phần này trước khi parse:
import json
from curl_cffi import requests as curl_requests

session = curl_requests.Session(impersonate="chrome120")
session.headers.update(HEADERS)

# Làm nóng session
session.get("https://www.redfin.com/")

# Tải một trang bất động sản để lấy cookie và property ID
property_url = "https://www.redfin.com/CA/San-Francisco/123-Main-St-94102/home/12345678"
page_resp = session.get(property_url)

# Gọi Stingray API
api_url = "https://www.redfin.com/stingray/api/home/details/aboveTheFold?propertyId=12345678"
api_resp = session.get(api_url, headers={"Referer": property_url})

# Bỏ tiền tố chống CSRF
payload = json.loads(api_resp.text.replace("{}&&", "", 1))

# Trích xuất dữ liệu có cấu trúc
listing_data = payload.get("payload", {})
print(json.dumps(listing_data, indent=2))
Response chứa các trường đã được typing rõ ràng: giá là số nguyên, beds/baths là số, URL ảnh là mảng, thông tin môi giới là object lồng nhau. Không cần BeautifulSoup, không cần CSS selector, không phải đoán mò.
Ưu điểm và giới hạn của cách dùng API ẩn
Ưu điểm:
- JSON có cấu trúc sẵn — sạch hơn HTML parsing rất nhiều
- Nhanh hơn cho mỗi request (payload nhỏ hơn, không cần render)
- Rủi ro bị chặn thấp hơn (request kiểu API với header phù hợp trông tự nhiên hơn)
Giới hạn:
- Endpoint có thể thay đổi mà không báo trước — không có tài liệu chính thức
robots.txtcủa Redfin chặn rõ/stingray/với user-agent wildcard- Vẫn cần làm nóng session và dùng header đúng để tránh Cloudflare
Giải pháp không cần code: Scrape Redfin bằng Thunderbit
Nếu bạn cần dữ liệu Redfin nhưng không muốn duy trì script Python — hoặc chỉ muốn có kết quả trong 5 phút — hãy bắt đầu ở đây. Chúng tôi xây dựng Thunderbit đúng cho mục đích này: trích xuất dữ liệu có cấu trúc từ bất kỳ website nào, không cần code.
Bước 1: Cài Thunderbit và mở Redfin
Cài Thunderbit Chrome Extension từ Chrome Web Store. Mở Redfin và đi tới trang kết quả tìm kiếm — ví dụ, danh sách nhà bán ở San Francisco.
Bước 2: Bấm “AI Suggest Fields”
Nhấp vào biểu tượng Thunderbit trên thanh công cụ trình duyệt, rồi chọn "AI Suggest Fields." AI sẽ đọc trang Redfin và tự gợi ý các cột như “Address,” “Price,” “Beds,” “Baths,” “SqFt,” “Property Type,” và “Listing Photo” — đồng thời tự gán đúng kiểu dữ liệu.
Bạn có thể xóa các cột không cần hoặc thêm cột tùy chỉnh bằng cách nhấn "+ Add Column" và mô tả bằng tiếng Anh tự nhiên điều bạn muốn (ví dụ: “listing agent name” hoặc “days on market”).
Bạn sẽ thấy bản xem trước dạng bảng với các cột đã cấu hình, sẵn sàng để điền dữ liệu.
Bước 3: Bấm “Scrape” và xem dữ liệu đổ về
Nhấn nút "Scrape". Thunderbit sẽ xử lý các tin đang hiển thị và điền dữ liệu vào bảng. Với kết quả nhiều trang, công cụ tự xử lý phân trang — không cần viết vòng lặp.
Trong thử nghiệm của tôi, một bảng 50 dòng được điền xong trong khoảng 45 giây. Dữ liệu có cấu trúc, sẵn sàng để xuất.
Thunderbit xử lý lớp chống bot của Redfin như thế nào
Vì Thunderbit chạy ngay trong trình duyệt của bạn, nó thừa hưởng cookie, session và browser fingerprint Redfin hiện có. Với Cloudflare, trông nó như một người dùng bình thường đang duyệt Redfin — vì về mặt kỹ thuật, đúng là như vậy. Không có headless browser, không có IP datacenter, không có TLS fingerprint lệch chuẩn. Với các trang công khai, chế độ cloud scraping của Thunderbit có thể xử lý 50 trang mỗi lần.
Đó là một tư thế hoàn toàn khác so với việc ném requests từ một script Python trên server.
Session trình duyệt của bạn vốn đã được tin cậy.
Scrape các trang con của Redfin với Thunderbit
Sau khi scrape kết quả tìm kiếm, hãy nhấn "Scrape Subpages" để AI tự mở từng URL chi tiết của bất động sản và làm giàu bảng dữ liệu bằng các trường bổ sung — Redfin Estimate, năm xây dựng, phí HOA, thông tin môi giới, ảnh bất động sản và lịch sử giao dịch.
Đó chính là phiên bản tương đương của vòng lặp Selenium 40 dòng ở Cách 1 — nhưng chỉ cần một cú click và gần như không phải bảo trì.
Khi Redfin đổi DOM từ homecardV2Price sang span.bp-Homecard__Price--value, AI sẽ thích nghi. Selector Python của bạn thì không.
Scrape các trang con của Redfin bằng AI Get Started Free
Vượt qua CSV: Xuất dữ liệu Redfin sang Google Sheets, Airtable và Notion
Phần lớn hướng dẫn thường dừng ở df.to_csv(). Điều đó ổn cho một phân tích ngắn hạn. Nhưng nếu bạn đang làm việc trong một đội bất động sản, bạn cần dữ liệu sống, có cộng tác — không phải những file tĩnh nằm im trên desktop ai đó.
Xuất bằng Python (gspread + Airtable API)
Google Sheets qua gspread:
import gspread
import pandas as pd
from gspread_dataframe import set_with_dataframe

df = pd.DataFrame(listings)
gc = gspread.service_account(filename="service_account.json")
sh = gc.open("Redfin Listings")
ws = sh.worksheet("Sheet1")
ws.clear()
set_with_dataframe(ws, df, include_index=False, resize=True)

# Hiển thị ảnh bất động sản trực tiếp bằng công thức IMAGE()
image_col = df.columns.get_loc("image_url") + 1
for row_idx, url in enumerate(df["image_url"], start=2):
    ws.update_cell(row_idx, image_col, f'=IMAGE("{url}")')
Lưu ý: Sheets có giới hạn cứng 10 triệu ô cho mỗi bảng tính, và API cho phép 300 request đọc + 300 request ghi mỗi phút cho mỗi project. Hãy dùng ws.batch_update() thay vì vòng lặp ghi từng ô nếu dữ liệu vượt quá vài chục dòng.
Airtable qua pyairtable:
Thay đổi quan trọng trong năm 2024: Airtable đã ngừng hỗ trợ API key cũ từ ngày 1/2/2024. Hiện bạn phải dùng Personal Access Token (PAT) — mọi hướng dẫn còn viết api_key=... đều đã lỗi thời.
from pyairtable import Api

api = Api("patXXXXXXXXXXXXXX.yyyyyyyyyyyyyyyyyyyy")
table = api.table("appBaseId123", "Redfin Listings")

records = [
    {
        "Address": row["address"],
        "Price": row["price"],
        "Beds": row["beds"],
        "Photo": [{"url": row["image_url"]}],  # Airtable sẽ tự fetch & host lại
    }
    for row in listings
]
created = table.batch_create(records, typecast=True)
Airtable giới hạn 5 request/giây cho mỗi base, và sẽ khóa 30 giây nếu vi phạm. Trường attachment nhận payload [{"url": ...}] — server của Airtable sẽ tự lấy URL, host lại trên CDN của họ và tạo thumbnail tự động.
Xuất bằng Thunderbit (1 click sang Sheets, Airtable, Notion)
Thunderbit có sẵn tính năng xuất 1-click sang Google Sheets, Airtable và Notion — và đây là phần tôi thật sự tự hào: ảnh bất động sản được upload và hiển thị thành ảnh inline trong Notion và Airtable. Không cần mẹo =IMAGE(), không có link CDN hỏng. Bạn chỉ cần bấm “Export to Airtable”, và đội nhóm của bạn sẽ có một cơ sở dữ liệu bất động sản trực quan với thumbnail có thể xem ngay trên điện thoại.
Với các đội bất động sản cần sàng lọc tin đăng bằng hình ảnh, đây là khác biệt giữa một công cụ hữu ích và một đống dòng CSV.
Có hợp pháp khi scrape Redfin không? ToS, robots.txt và án lệ nói gì?
Tôi không phải luật sư, và đây không phải tư vấn pháp lý. Nhưng sau nhiều năm làm trong lĩnh vực trích xuất dữ liệu, tôi có thể nói: “có hợp pháp không?” là câu hỏi ai cũng hỏi nhưng đa số hướng dẫn đều né.
robots.txt của Redfin
robots.txt của Redfin khá chi tiết. Một số điểm chính:
- Bot bị chặn hoàn toàn:
peer39_crawler/1.0,AmazonAdBot,FireCrawlAgent— Redfin còn nêu đích danh cả dịch vụ scraping thời LLM rất phổ biến - Các điểm
Disallowáp dụng choUser-agent: *:/stingray/(toàn bộ namespace API nội bộ),/myredfin/,/api/v1/rentals/,/api/v1/properties/,/owner-estimate/ - Không có chỉ thị
Crawl-delay:cho bất kỳ user agent nào - Khai báo hơn 50 sitemap — sitemap là cách sạch nhất và ít bị WAF chú ý để liệt kê URL
Điều khoản sử dụng của Redfin
Section 2.3.5 ghi rõ: "You may not automatedly crawl or query the Services for any purpose or by any means... unless you have received prior express written permission."
Đây là một thỏa thuận kiểu browsewrap — đồng ý bằng việc tiếp tục sử dụng, không phải clickwrap. Tòa án Mỹ từ trước đến nay thường khá dè dặt trong việc thực thi browsewrap với người dùng không hề có thông báo thực tế (xem Nguyen v. Barnes & Noble, 9th Cir. 2014).
Một vài án lệ liên quan (tóm tắt)
- Van Buren v. United States (Tối cao Pháp viện, 2021): điều khoản CFAA “exceeds authorized access” dùng bài kiểm tra “cổng mở hay đóng”. Dùng cánh cửa đang mở cho một mục đích không được hoan nghênh không đồng nghĩa với hack liên bang.
- hiQ Labs v. LinkedIn (9th Cir., 2022): scrape dữ liệu công khai không vi phạm CFAA. Nhưng hiQ cuối cùng vẫn trả $500,000 trong thỏa thuận dàn xếp theo hướng breach-of-contract — vì hiQ đã đăng ký tài khoản LinkedIn và bấm “I agree.”
- Meta Platforms v. Bright Data (N.D. Cal., 1/2024): tòa xử summary judgment có lợi cho Bright Data — việc scrape dữ liệu công khai khi không đăng nhập không khiến Bright Data trở thành “người dùng” bị ràng buộc bởi ToS của Meta.
- X Corp. v. Bright Data (N.D. Cal., 5/2024): thẩm phán Alsup bác yêu cầu của X, cho rằng các yêu cầu theo luật bang nhằm kiểm soát việc sao chép nội dung công khai bị luật Bản quyền tiền nhiệm hóa (preempted).
Khuyến nghị thực tế
- Chỉ scrape dữ liệu có thể truy cập công khai — đừng đăng ký tài khoản rồi mới scrape (như vậy sẽ tạo rủi ro hợp đồng kiểu clickwrap)
- Tôn trọng rate limit — volume quá gắt có thể hỗ trợ lập luận trespass-to-chattels
- Đừng tái xuất bản dữ liệu thô hoặc ảnh ở quy mô lớn — vụ kiện CoStar v. Zillow (nộp tháng 7/2025, thiệt hại tiềm năng vượt $1 tỷ) là lời nhắc rằng bản quyền ảnh là chuyện nghiêm túc
- Cách làm của Thunderbit — chạy ngay trong phiên trình duyệt đã xác thực của bạn — gần với “duyệt thủ công ở tốc độ máy” hơn là bot datacenter headless, và đó là tư thế có cơ sở phòng vệ hơn nhiều, ngoại trừ trường hợp bạn dùng API được cấp phép
Mẹo và những lỗi thường gặp
Một vài bài học xương máu từ việc xây công cụ trích xuất dữ liệu và quan sát hàng nghìn người dùng scrape các site bất động sản:
- Luôn làm nóng session trước. Hãy mở
redfin.com/trước bất kỳ URL sâu nào. Truy cập deep URL khi session còn lạnh là nguyên nhân số 1 kích hoạt Cloudflare challenge. - Luân phiên User-Agent một cách hợp lý. Đừng chỉ dùng một UA — hãy xoay trong 5–10 UA Chrome/Firefox mới. Nhưng cũng đừng xoay quá nhanh (mỗi request một UA khác nhau trông rất đáng ngờ).
- Khử trùng lặp theo property ID. Phân trang của Redfin đôi khi bị chồng lặp. Hãy lấy
/home/{id}từ từng URL tin và dedupe trước khi làm giàu dữ liệu. - Nếu tránh được, đừng scrape vào giờ cao điểm. Theo kinh nghiệm của tôi, đêm muộn / rạng sáng giờ Mỹ thường bị WAF soi ít hơn.
- Nếu gặp 429, hãy lùi lại theo cấp số nhân. Đừng thử lại ngay — đó là cách bạn đẩy từ soft rate-limit sang cấm IP cứng.
- Với dự án quy mô lớn (1,000+ trang), hãy dự trù chi phí proxy residential. IP datacenter (AWS, GCP, Azure, OVH) thường bị hệ thống đánh giá ASN của Cloudflare đưa vào danh sách đen. Bạn sẽ gặp Error 1020 gần như ngay lập tức.
Chọn cách scrape Redfin phù hợp nhất
Vậy nên chọn cách nào? Điều đó phụ thuộc vào bạn là ai và bạn cần gì.
Phân tích HTML (BeautifulSoup + Selenium): Tốt nhất cho developer muốn kiểm soát toàn bộ, thoải mái bảo trì selector CSS, và không ngại viết lại khi Redfin đổi DOM. Hãy chuẩn bị tinh thần quay lại sửa code mỗi 6–12 tháng.
Hidden Stingray API: Tốt nhất cho developer cần JSON sạch, có cấu trúc, và chấp nhận reverse-engineer endpoint không tài liệu. Bảo trì nhẹ hơn HTML parsing, nhưng endpoint có thể đổi bất cứ lúc nào. Nhớ rằng /stingray/ bị cấm rõ trong robots.txt.
Thunderbit (No-Code): Tốt nhất cho người không code, dự án nhanh và đội nhóm cần dữ liệu Redfin liên tục mà không có tài nguyên dev. AI tự thích nghi khi layout thay đổi, scrape trang con để làm giàu dữ liệu chỉ bằng một cú click, và xuất sang Google Sheets, Airtable hoặc Notion đều có sẵn. Nếu bạn là một đội bất động sản cần một cơ sở dữ liệu sống — chứ không phải một file CSV dùng một lần — đây là con đường ít trở ngại nhất.
Dù chọn cách nào: hãy hiểu cơ chế chống bot của Redfin trước khi bắt đầu, biết rõ mình cần trường dữ liệu nào, chọn định dạng xuất phù hợp với quy trình làm việc của đội, và luôn đi đúng ranh giới của hướng dẫn pháp lý.
Sẵn sàng thử cách không cần code? Gói miễn phí của Thunderbit cho phép bạn thử scrape Redfin và xem kết quả chỉ trong vài phút. Với hai cách dùng Python, các đoạn code ở trên là điểm khởi đầu đã hoạt động — chỉ cần thêm proxy và kiên nhẫn.
Dùng thử Thunderbit để lấy dữ liệu Redfin liên tục
Câu hỏi thường gặp
Redfin có API công khai không?
Không. Redfin không cung cấp API công khai chính thức. Hidden Stingray API (/stingray/api/home/details/*) trả về JSON có cấu trúc và được frontend của Redfin sử dụng, nhưng nó không chính thức, không có tài liệu, có thể thay đổi mà không báo trước và bị cấm rõ trong robots.txt của Redfin. Các wrapper mã nguồn mở như reteps/redfin trên PyPI cho phép truy cập bằng Python, nhưng hãy dùng với nhận thức đầy đủ về rủi ro.
Có thể scrape Redfin mà không dùng Python không?
Có. Thunderbit là extension AI cho Chrome, kế thừa session trình duyệt của bạn để tăng khả năng vượt chống bot — chỉ cần cài đặt, mở Redfin, bấm “AI Suggest Fields”, rồi xuất sang Excel, Google Sheets, Airtable hoặc Notion. Trên thị trường cũng có các công cụ scraping no-code khác và nhà cung cấp dataset dựng sẵn nếu bạn muốn so sánh lựa chọn.
Redfin thay đổi giao diện website bao lâu một lần?
Lịch sử issue trên GitHub cho thấy selector CSS thường gãy khoảng mỗi 6–12 tháng. Redfin đã có hai thế hệ DOM cho card — kiểu cũ (homecardV2Price, homeAddressV2) và kiểu hiện tại (bp-Homecard__Price--value, bp-Homecard__Address). Các scraper trưởng thành thường thử cả hai theo thứ tự.
Các công cụ dựa trên AI như Thunderbit tự động thích nghi vì chúng nhận diện trường theo nội dung thay vì selector CSS.
Loại proxy nào phù hợp nhất để scrape Redfin?
Proxy residential tại Mỹ là lựa chọn tốt nhất cho quy mô lớn — các benchmark cộng đồng đặt tỷ lệ thành công khoảng 80%. Proxy datacenter sẽ đụng Cloudflare Error 1020 gần như ngay lập tức; dải IP của AWS, GCP, Azure và OVH thường đã bị chặn. Proxy mobile có tỷ lệ thành công cao nhất nhưng chi phí đắt hơn 5–10 lần.
Với nhu cầu cá nhân quy mô nhỏ (<100 trang), header chuẩn + giả lập curl_cffi + delay 2–5 giây có thể hoạt động mà không cần proxy.
Có thể scrape dữ liệu nhà đã bán hoặc ngoài thị trường từ Redfin không?
Có. Dữ liệu nhà đã bán và Redfin Estimate ngoài thị trường (sai số trung vị 7.52%) đều có trên trang chi tiết và có thể lấy bằng cùng các cách scraping. Các trường sẽ khác so với tin đang bán: trang ngoài thị trường hiển thị giá bán, ngày bán, lịch sử bất động sản và endpoint owner-estimate, nhưng không có giá niêm yết hiện tại, days on market hay thông tin open house. Endpoint Stingray cho ước tính ngoài thị trường là api/home/details/owner-estimate thay vì api/home/details/avm.
Dùng thử Thunderbit để scrape Redfin Get Started Free
Tìm hiểu thêm



