
Nếu công cụ scrape Glassdoor của bạn chạy ngon lành trong năm 2022 nhưng giờ chỉ còn trả về lỗi 403, thì bạn không hề đơn độc. Từ diễn đàn này sang diễn đàn khác đều ngập cùng một câu hỏi: "Có ai biết vì sao scraper này giờ không còn hoạt động nữa không?"
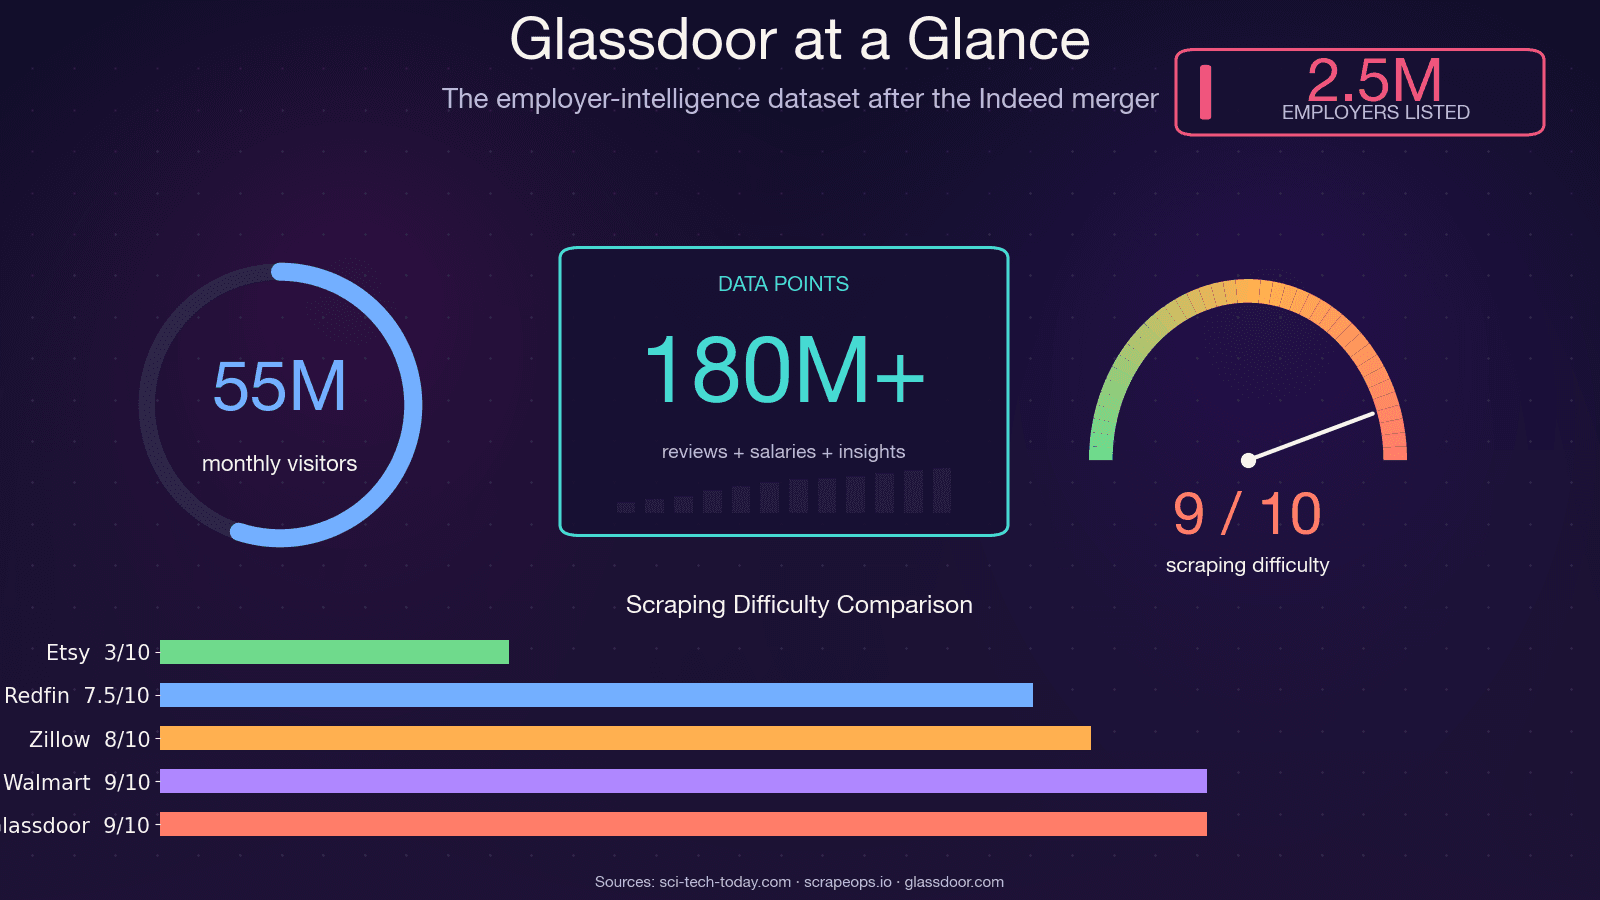
Câu trả lời ngắn gọn là: Glassdoor đã thay đổi gần như hoàn toàn. Recruit Holdings đã sáp nhập Glassdoor vào Indeed vào tháng 7/2025, cắt giảm 1.300 nhân sự, đồng thời siết lớp chống bot đến mức các scraper dùng Selenium thuần hoặc requests sẽ bị chặn trước khi byte HTML đầu tiên kịp tải. Tính đến tháng 2/2026, mọi luồng đăng nhập Glassdoor đều đi qua Indeed Login — nên hầu hết hướng dẫn còn hard-code form đăng nhập riêng của Glassdoor đều hỏng ngay từ nền tảng. Trong khi đó, nền tảng này vẫn có hơn 180 triệu đánh giá, mức lương và thông tin insights cộng gộp trên 2,5 triệu nhà tuyển dụng. Đây là một mỏ dữ liệu cực kỳ giá trị cho benchmark nhân sự, phân tích đối thủ và tìm kiếm khách hàng tiềm năng — nếu bạn lấy được nó. Bài hướng dẫn này là phiên bản vẫn chạy được sau tất cả những thay đổi đó, và bao quát cả ba loại dữ liệu của Glassdoor (việc làm, đánh giá VÀ lương) trong cùng một nơi. Tôi sẽ dẫn bạn qua cách làm bằng Python với code 2025 vẫn còn chạy, giải thích chính xác điều gì đang chặn bạn và cách vượt qua, đồng thời chỉ luôn một lối đi không cần code cho ai muốn bỏ qua phần kỹ thuật hoàn toàn.
Vì sao nên scrape Glassdoor bằng Python trong năm 2025?
Glassdoor không chỉ là một trang tuyển dụng. Nó là một trong những bộ dữ liệu tình báo doanh nghiệp giàu nhất trên web — được khoảng một phần ba các công ty Fortune 500 sử dụng và thu hút chừng 55 triệu lượt truy cập duy nhất mỗi tháng. Dữ liệu ẩn sau những trang đó đang góp phần vào các quyết định kinh doanh thật ở rất nhiều bộ phận khác nhau.
Đây là cách các đội ngũ thường dùng dữ liệu Glassdoor trong thực tế:
| Trường hợp sử dụng | Loại dữ liệu cần | Ai hưởng lợi |
|---|---|---|
| Benchmark lương | Phân phối lương, kích thước mẫu | HR, Total Rewards, Operations |
| Theo dõi tuyển dụng đối thủ | Tin tuyển dụng, tốc độ đăng bài | Sales, Strategy, VC/Corp Dev |
| Giám sát thương hiệu nhà tuyển dụng | Nội dung review, xu hướng đánh giá, mức ủng hộ CEO | HR, Marketing, Comms |
| Tạo lead (công ty đang tăng trưởng) | Tin tuyển dụng + thông tin công ty | Đội ngũ sales, SDRs |
| Nghiên cứu thị trường/học thuật | Cả ba loại | Analyst, Consultant, Researcher |
Khi BLS không thể công bố dữ liệu việc làm trong thời gian chính phủ Mỹ đóng cửa vào tháng 10/2025, đội Economic Research của Glassdoor đã công bố một báo cáo việc làm thay thế dựa trên chính bộ dữ liệu của họ. Điều đó cho thấy giới phân tích cấp tổ chức hiện coi nguồn dữ liệu này nghiêm túc đến mức nào.
Python vẫn là ngôn ngữ được ưu tiên vì hệ sinh thái quá mạnh — Playwright cho tự động hóa trình duyệt, parsel/lxml cho phân tích HTML, curl_cffi để né fingerprint TLS, cùng một cộng đồng rất lớn luôn chia sẻ pattern đang chạy được. Vấn đề không nằm ở Python. Vấn đề là Glassdoor đã trở nên khó scrape hơn rất nhiều.
Scrape dữ liệu Glassdoor bằng AI Get Started Free
Nếu bạn muốn một phương án dự phòng không cần code để trích xuất dữ liệu Glassdoor, Thunderbit có thể giúp bạn lấy jobs, reviews và salary pages mà không cần tự xây hay duy trì một stack Python riêng.
Bạn thực sự có thể scrape dữ liệu nào từ Glassdoor?
Phần lớn hướng dẫn chỉ nói về danh sách việc làm. Nhưng theo nhu cầu từ các thread diễn đàn, issue GitHub và câu hỏi trên Reddit mà tôi theo dõi, hai loại dữ liệu được quan tâm nhất lại là những thứ ít ai hướng dẫn: đánh giá và mức lương. Dưới đây là bức tranh đầy đủ về những gì có thể trích xuất ở cả ba nhóm.
Tin tuyển dụng
Đây là loại dữ liệu dễ lấy nhất. Bạn có thể thu: tiêu đề công việc, tên công ty, địa điểm, mức lương ước tính, đánh giá công ty, ngày đăng, nhãn easy-apply và link việc làm. Tin tuyển dụng vẫn có thể xem một phần mà không cần đăng nhập, dù Glassdoor có thể bật popup login sau vài trang.
Đánh giá công ty
Đây là phần thú vị nhất nếu bạn làm phân tích employer brand. Các trường có thể trích xuất gồm: điểm đánh giá tổng, điểm thành phần (work-life balance, culture & values, diversity & inclusion, career opportunities, comp & benefits, senior management), nội dung ưu điểm, nhược điểm, chức danh người review, ngày review và trạng thái việc làm. Toàn bộ nội dung review bị khóa sau đăng nhập — bạn sẽ chỉ thấy một đoạn ngắn, còn phần pros/cons đầy đủ thì cần xác thực.
Dữ liệu lương
Đây là loại dữ liệu được hỏi nhiều nhất và cũng khó chịu nhất. Bạn có thể lấy: chức danh, khoảng lương cơ bản, tổng đãi ngộ, số lượng báo cáo lương và địa điểm. Nhưng trang lương bị khóa hoàn toàn sau đăng nhập, và Glassdoor đôi khi còn thêm luồng "contribute to unlock", tức là bạn phải tự nhập mức lương của mình mới xem được dữ liệu của người khác. Không có hướng dẫn cạnh tranh nào đưa ra code chạy được cho phần này — chúng ta sẽ xử lý ngay trong bài này.
Cái gì cần đăng nhập, cái gì không?
Bảng này sẽ giúp bạn khỏi phải tự thử sai rồi mới biết trang nào trả dữ liệu rỗng:
| Loại dữ liệu | Có xem được khi chưa đăng nhập không? | Ghi chú |
|---|---|---|
| Tiêu đề việc làm & thông tin cơ bản | Phần lớn là có | Có thể xuất hiện popup sau vài trang |
| Mô tả công việc đầy đủ | Một phần | Thường bị khóa sau 2–3 lượt xem |
| Review công ty (toàn văn) | Không — cần đăng nhập | Chỉ thấy đoạn trích, toàn văn bị khóa |
| Dữ liệu lương | Không — cần đăng nhập | Có thể còn yêu cầu "contribute to unlock" |
Vì sao scraper Glassdoor cũ của bạn có thể đã hỏng
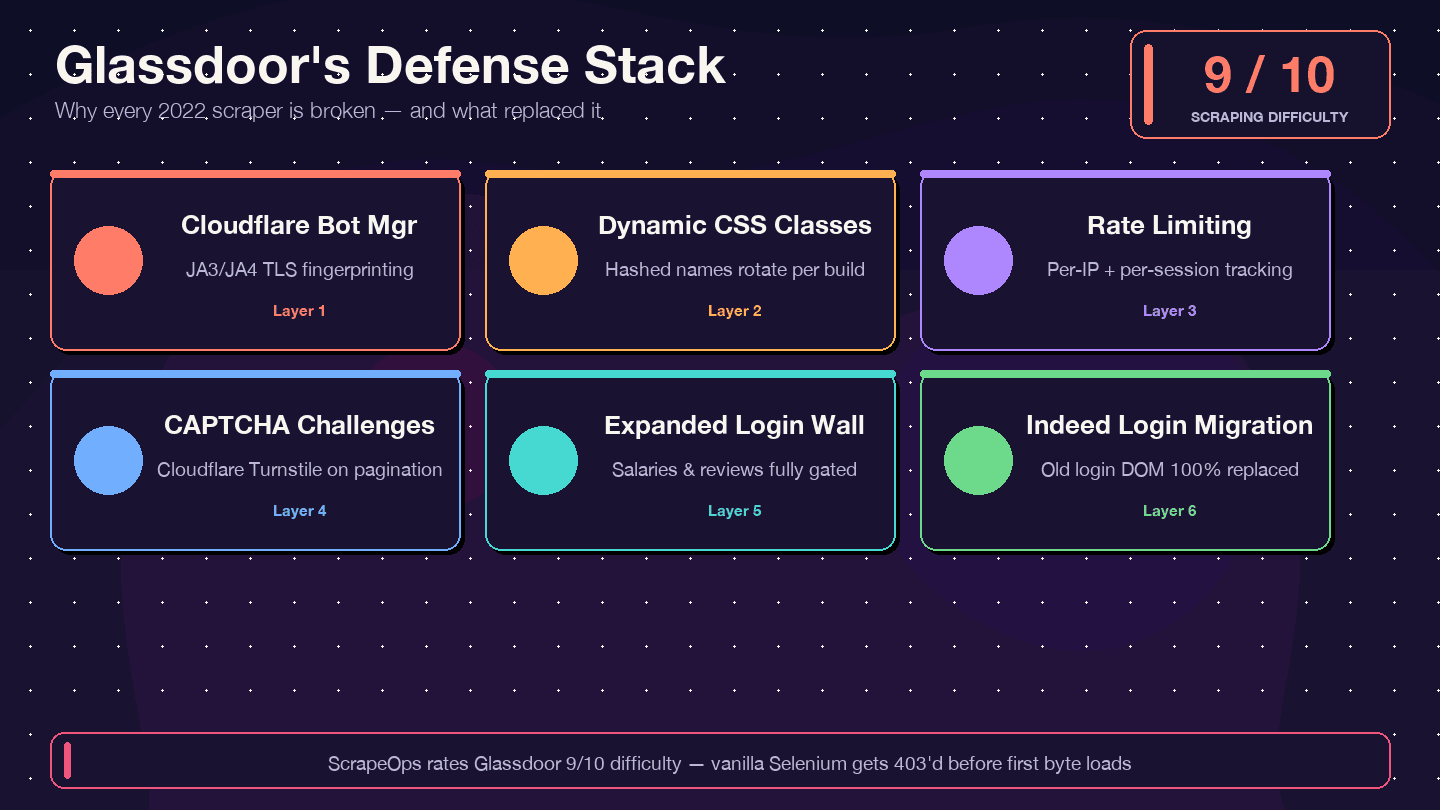
Tôi nói thẳng luôn: nếu bạn đang copy code từ tutorial 2021–2023, nó sẽ không chạy. Repo scraper Glassdoor Selenium cũ có nhiều sao nhất trên GitHub (MatthewChatham/glassdoor-review-scraper, khoảng 1.4k stars) hiện có hơn 12 issue mở chưa được giải quyết — bao gồm "Glassdoor new UI design", "Cloudflare anti-bot protection" và "NoSuchElementException". Repo này gần như đã bị bỏ rơi. Actor glassdoor-jobs-scraper của Apify đã bị gắn nhãn DEPRECATED. ScrapeOps chấm Glassdoor 9/10 về độ khó scraping tổng thể và 8/10 về độ khó vượt chặn.
Đây là những gì đã thay đổi và vì sao code cũ hỏng:
| Lớp bảo vệ | Điều đã thay đổi | Tác động lên scraper cũ |
|---|---|---|
| Cloudflare Bot Management | Siết chặt fingerprint JA3/JA4 từ 2024 | Script requests/Selenium cơ bản bị 403 ngay lập tức |
| CSS class động | Tên class được random lại mỗi lần build | Selector CSS cũ từ tutorial sẽ lặng lẽ hỏng |
| Giới hạn tốc độ + theo dõi session | Giới hạn theo IP và session chặt hơn | Scraper bị chặn sau ít trang hơn |
| Thử thách CAPTCHA (có thể là Cloudflare Turnstile) | Xuất hiện thường xuyên hơn, nhất là khi phân trang | Browser headless dễ bị kích hoạt thử thách |
| Tường đăng nhập mở rộng | Nhiều loại trang hơn yêu cầu xác thực | Trang lương và review trả về dữ liệu rỗng |
| Chuyển sang Indeed Login (2/2026) | Form login Glassdoor bị thay thế hoàn toàn | Mọi code nhắm vào DOM login cũ đều vô hiệu |
Hướng dẫn 2026 của Scrapfly có cảnh báo rất rõ: "Glassdoor is known for its high blocking rate, so if you get None values while running the Python code, it's likely you're getting blocked." Và một bài viết trên DEV.to từ tháng 3/2026 nói thẳng luôn: "Simple HTTP requests with requests or httpx get blocked instantly."
Những biện pháp đối phó tôi sẽ chỉ cho bạn — Patchright (một nhánh Playwright ngụy trang), selector data-test, proxy residential xoay vòng, và session bền vững đã xác thực — được thiết kế riêng để xử lý từng lớp bảo vệ này.
Glassdoor API hay Python scraping: chọn đúng hướng trước đã
Nhiều thread trên diễn đàn hỏi: "Tôi nên dùng Glassdoor API luôn không?" — và câu trả lời là: bạn không thể.
Glassdoor Partner API cũ đã ngừng nhận ứng viên mới. Cổng developer portal về mặt kỹ thuật vẫn còn tồn tại nhưng trả về HTTP 403. Từ trước đến nay cũng chưa từng có public endpoint cho reviews — scraper của MatthewChatham được tạo ra chính là "vì Glassdoor không có API cho reviews." Và cũng không có lộ trình chuyển đổi nào cho reviews hay salaries dưới Indeed Publisher API.
So sánh thực tế như sau:
| Yếu tố | Glassdoor Partner API v1 | Python scraping | Thunderbit (không cần code) |
|---|---|---|---|
| Quyền truy cập | Đã đóng cho ứng viên mới | Mở (bạn tự triển khai) | Chrome extension |
| Tin tuyển dụng | Hạn chế/đang ngừng | Có, nhưng cần công sức | Có |
| Review công ty | Chưa từng có công khai | Có (cần đăng nhập) | Có (qua Browser Mode) |
| Dữ liệu lương | Chưa từng có công khai | Có (cần đăng nhập) | Có |
| Giới hạn tốc độ | Không công bố | Bạn tự kiểm soát | Dựa trên credit |
| Công sức thiết lập | Không thể đăng ký app mới | Vài giờ đến vài ngày | ~2 phút |
| Gánh nặng bảo trì | Không áp dụng | Cao (HTML đổi là hỏng code) | Thấp (AI gợi ý lại field) |
Nếu bạn cần review hoặc dữ liệu lương — mà đa số người đọc bài này đều cần — thì Python scraping hoặc công cụ không cần code là lựa chọn thực tế duy nhất của bạn.
Trước khi bắt đầu
- Độ khó: Trung bình (bạn nên quen với Python và terminal)
- Thời gian cần: khoảng 30–60 phút cho phần thiết lập đầy đủ; khoảng 10 phút cho mỗi loại dữ liệu sau đó
- Bạn sẽ cần:
- Python 3.10+ (khuyến nghị 3.11 hoặc 3.12)
- Đã cài trình duyệt Chrome
- Một tài khoản Glassdoor (miễn phí — cần cho dữ liệu lương và review)
- Proxy residential xoay vòng (nếu scrape hơn vài trang)
- Tùy chọn: Thunderbit Chrome Extension nếu bạn muốn đi theo hướng không cần code
Công cụ và thư viện để scrape Glassdoor bằng Python trong năm 2025
Bức tranh công cụ đã thay đổi khá nhiều. Đây là những gì thực sự còn hiệu quả trước các lớp phòng thủ hiện tại của Glassdoor.
Vì sao Patchright là lựa chọn tốt nhất cho Glassdoor
Patchright là một nhánh Playwright ngụy trang, vá lỗ hổng Runtime.Enable CDP leak — chính là lý do kỹ thuật khiến Playwright thuần bị Cloudflare chặn trên các website được bảo vệ. Nó dùng đúng API như Playwright, nên nếu bạn biết Playwright thì bạn cũng biết Patchright. Phiên bản 1.58.2 (tháng 3/2026) là bản hiện hành và vẫn đang được duy trì tích cực.
So với các lựa chọn khác:
- Playwright thuần: Bị Glassdoor phát hiện ở trang login do lộ Runtime.Enable
- Selenium + undetected-chromedriver: bản phát hành gần nhất của undetected-chromedriver là tháng 2/2024 — về thực tế nó đã là giải pháp cũ. Benchmark của Scrapfly cho thấy nó "failed on every domain in our test"
- requests + BeautifulSoup: Không render được JavaScript, và bị Cloudflare TLS fingerprint chặn ngay
- curl_cffi: Rất tốt cho đường đi nhanh (nhanh hơn browser 10–20 lần) khi trang gửi
__NEXT_DATA__trong HTML ban đầu, nhưng không xử lý được login hay các thử thách trung gian
Thư viện hỗ trợ
- parsel (1.11.0) hoặc lxml (6.0.4): phân tích HTML/XPath nhanh
- csv hoặc pandas: xuất dữ liệu
- asyncio: scraping bất đồng bộ để phân trang nhanh hơn
Proxy: chỉ nên dùng residential
Lớp Cloudflare của Glassdoor kiểm tra rất gắt các ASN datacenter. Proxy residential được cho là giảm tỷ lệ chặn từ 20–30% xuống dưới 5%. Mức giá khởi điểm vào khoảng $1.75/GB từ IPRoyal (khuyến mãi) hoặc $3.00/GB từ Decodo. Với scraping ở môi trường production, nên dự trù $3–8/GB tùy khối lượng.
Khoảng nghỉ ngẫu nhiên giữa các request (ít nhất 3–8 giây, 5–15 giây cho các lần chạy dài) là điều bắt buộc, bất kể chất lượng proxy tốt đến đâu.
Bước 1: Thiết lập môi trường Python
Tạo thư mục dự án và cài stack khuyến nghị:
mkdir glassdoor-scraper && cd glassdoor-scraper
python3.11 -m venv .venv
source .venv/bin/activate
pip install --upgrade pip

# Core stack
pip install patchright==1.58.2 parsel==1.11.0

# Cài browser binaries
patchright install chromium

# Tùy chọn: đường đi nhanh cho việc trích xuất __NEXT_DATA__
pip install "curl_cffi==0.15.0"
Bạn sẽ thấy Patchright tải xuống một binary Chromium. Nếu patchright install chromium thất bại, hãy kiểm tra xem còn đủ dung lượng đĩa không (khoảng 300MB) và phiên bản Python đã từ 3.10 trở lên chưa.
Bước 2: Khởi chạy Patchright và truy cập Glassdoor
Đây là pattern khởi chạy cơ bản vẫn hoạt động trước lớp Cloudflare của Glassdoor:
from patchright.sync_api import sync_playwright
import random, time

with sync_playwright() as p:
    browser = p.chromium.launch(
        headless=False,          # headless vẫn dễ bị phát hiện hơn
        channel="chrome",        # dùng Chrome thật, không dùng Chromium đi kèm
    )
    context = browser.new_context(
        viewport={"width": 1440, "height": 900},
        locale="en-US",
        timezone_id="America/New_York",
        user_agent=(
            "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/134.0.0.0 Safari/537.36"
        ),
    )
    page = context.new_page()
    page.goto(
        "https://www.glassdoor.com/Job/new-york-data-engineer-jobs-"
        "SRCH_IL.0,8_IC1132348_KO9,22.htm"
    )

    # Ẩn lớp login overlay — nội dung vẫn còn trong DOM
    page.add_style_tag(content="""
        #HardsellOverlay, .LoginModal { display: none !important; }
        body { overflow: auto !important; position: initial !important; }
    """)

    page.wait_for_selector("[data-test='jobListing']")
    print("Page đã tải — thấy danh sách việc làm.")
Có vài điểm cần lưu ý. Flag channel="chrome" bảo Patchright dùng binary Chrome đã cài sẵn thay vì Chromium đi kèm — điều này tạo fingerprint trình duyệt giống thật hơn. Mẹo add_style_tag sẽ ẩn modal đăng nhập của Glassdoor (gọi là #HardsellOverlay) mà không cần click gì cả. Scrapfly xác nhận rằng "all of the content is still there, it's just covered up by the overlay" — HTML vẫn chứa dữ liệu bất kể modal đang hiện hay không.
Bạn sẽ thấy một cửa sổ Chrome mở ra, đi tới trang tìm việc của Glassdoor và hiển thị các thẻ job listing mà không bị popup login che mất.
Bước 3: Scrape danh sách việc làm trên Glassdoor
Xác định selector ổn định
Glassdoor random hóa tên CSS class ở mỗi lần build — vì vậy selector .jobCard_xyz123 từ tutorial năm 2023 sẽ âm thầm trả về rỗng ở thời điểm hiện tại. Thay vào đó, hãy dùng các thuộc tính data-test, vì đây là convention QA nội bộ của Glassdoor và thường ổn định qua các lần deploy.
Đây là bảng selector cho các trường của job listing:
| Trường | Selector |
|---|---|
| Container của job card | [data-test="jobListing"] |
| Tiêu đề việc làm | [data-test="job-title"] |
| Link việc làm | a[data-test="job-link"] |
| Tên công ty | [data-test="employer-name"] |
| Địa điểm | [data-test="emp-location"] |
| Khoảng lương | [data-test="detailSalary"] |
| Đánh giá công ty | [data-test="rating"] |
| Ngày đăng | [data-test="job-age"] |
| Trang tiếp theo | [data-test="pagination-next"] |
Trích xuất dữ liệu việc làm
from parsel import Selector
import csv, random, time

def scrape_jobs(page, max_pages=5):
    all_jobs = []

    for page_num in range(1, max_pages + 1):
        html = page.content()
        sel = Selector(text=html)
        cards = sel.css('[data-test="jobListing"]')

        if not cards:
            print(f"Trang {page_num}: không tìm thấy card nào — có thể bị chặn hoặc selector đã đổi.")
            break

        for card in cards:
            job = {
                "title": card.css('[data-test="job-title"]::text').get("").strip(),
                "company": card.css('[data-test="employer-name"]::text').get("").strip(),
                "location": card.css('[data-test="emp-location"]::text').get("").strip(),
                "salary": card.css('[data-test="detailSalary"]::text').get("").strip(),
                "rating": card.css('[data-test="rating"]::text').get("").strip(),
                "link": card.css('a[data-test="job-link"]::attr(href)').get(""),
                "posted": card.css('[data-test="job-age"]::text').get("").strip(),
            }
            if job["link"] and not job["link"].startswith("http"):
                job["link"] = "https://www.glassdoor.com" + job["link"]
            all_jobs.append(job)

        print(f"Trang {page_num}: đã scrape {len(cards)} job")

        # Phân trang
        next_btn = page.query_selector('[data-test="pagination-next"]')
        if next_btn and page_num < max_pages:
            next_btn.click()
            time.sleep(random.uniform(3, 8))
            page.wait_for_selector("[data-test='jobListing']")
        else:
            break

    return all_jobs
Lưu ra CSV
def save_to_csv(jobs, filename="glassdoor_jobs.csv"):
    if not jobs:
        print("Không có job nào để lưu.")
        return
    keys = jobs[0].keys()
    with open(filename, "w", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=keys)
        writer.writeheader()
        writer.writerows(jobs)
    print(f"Đã lưu {len(jobs)} job vào {filename}")
Một lưu ý về giới hạn phân trang: Glassdoor giới hạn kết quả tìm kiếm ở khoảng 30 trang bất kể tổng số lượng là bao nhiêu. Nếu cần bao phủ nhiều hơn, hãy dùng bộ lọc (địa điểm, loại việc, khoảng lương) để thu hẹp từng lần tìm thay vì cố gắng đi quá giới hạn phân trang.
Trong quá trình tôi thử nghiệm, việc scrape 5 trang job listing (khoảng 75 job) mất chừng 45 giây với độ trễ ngẫu nhiên. Làm thủ công cùng khối lượng đó sẽ mất ít nhất 20 phút copy-paste.
Bước 4: Scrape review công ty trên Glassdoor
Đây là phần không có hướng dẫn nào khác đưa ra code chạy được. Review mới là nơi chứa dữ liệu tình báo nhà tuyển dụng thực sự — phân tích sentiment, tín hiệu văn hóa, và các dấu hiệu cảnh báo về quản lý.
Đi tới trang reviews
URL review có dạng: /Reviews/{Company}-Reviews-E{id}.htm. Bạn có thể tìm employer ID bằng cách search công ty trên Glassdoor rồi xem URL.
def navigate_to_reviews(page, company_reviews_url):
    page.goto(company_reviews_url)
    page.add_style_tag(content="""
        #HardsellOverlay, .LoginModal { display: none !important; }
        body { overflow: auto !important; position: initial !important; }
    """)
    page.wait_for_selector('[data-test="review"]', timeout=15000)
Endpoint BFF ẩn (cách sạch nhất)
Phát hiện đáng giá nhất từ quá trình nghiên cứu của tôi là: review trên Glassdoor có một JSON API nội bộ đang hoạt động giúp bỏ qua hoàn toàn việc parse HTML. Repo scrapers của Scrapfly có ghi lại endpoint này, và nó ổn định hơn nhiều so với việc scrape DOM.
import json, re, requests

def get_review_ids(page):
    """Lấy employerId và dynamicProfileId từ HTML trang review."""
    html = page.content()
    sel = Selector(text=html)
    script_text = sel.xpath(
        "//script[contains(text(), 'profileId')]/text()"
    ).get("")
    employer_match = re.search(r'"employer"\s*:\s*(\{[^}]+\})', script_text)
    if employer_match:
        meta = json.loads(employer_match.group(1))
        return meta.get("id"), meta.get("profileId")
    return None, None

def fetch_reviews_bff(page, employer_id, profile_id, max_pages=5):
    """Gọi endpoint BFF nội bộ của Glassdoor để lấy dữ liệu review có cấu trúc."""
    all_reviews = []
    cookies = {c["name"]: c["value"] for c in page.context.cookies()}

    for pg in range(1, max_pages + 1):
        payload = {
            "applyDefaultCriteria": True,
            "employerId": employer_id,
            "dynamicProfileId": profile_id,
            "employmentStatuses": ["REGULAR", "PART_TIME"],
            "language": "eng",
            "onlyCurrentEmployees": False,
            "page": pg,
            "pageSize": 10,
            "sort": "DATE",
            "textSearch": "",
        }
        resp = requests.post(
            "https://www.glassdoor.com/bff/employer-profile-mono/employer-reviews",
            json=payload,
            cookies=cookies,
            headers={"Content-Type": "application/json"},
        )
        if resp.status_code != 200:
            print(f"BFF trả về {resp.status_code} ở trang {pg}")
            break

        data = resp.json()
        reviews = data.get("data", {}).get("employerReviews", {}).get("reviews", [])
        total_pages = data.get("data", {}).get("employerReviews", {}).get("numberOfPages", 1)

        for r in reviews:
            all_reviews.append({
                "title": r.get("summary", ""),
                "rating": r.get("ratingOverall"),
                "pros": r.get("pros", ""),
                "cons": r.get("cons", ""),
                "author_role": r.get("jobTitle", {}).get("text", ""),
                "date": r.get("reviewDateTime", ""),
                "recommend": r.get("isRecommend"),
            })

        print(f"Trang review {pg}/{total_pages}: lấy được {len(reviews)} review")
        if pg >= total_pages:
            break
        time.sleep(random.uniform(3, 6))

    return all_reviews
Endpoint BFF trả về JSON sạch với đầy đủ trường review — không cần parse HTML, không lo selector CSS bị gãy. Bạn cần cookie phiên đã xác thực từ một context Playwright đăng nhập sẵn (phần Bước 6 bên dưới), và trước tiên phải trích employerId cùng dynamicProfileId từ HTML trang reviews.
Selector dự phòng từ HTML cho reviews
Nếu endpoint BFF thay đổi hoặc bạn muốn parse DOM, đây là các selector data-test ổn định:
| Trường | Selector |
|---|---|
| Container review | [data-test="review"] |
| Tiêu đề | [data-test="review-title"] |
| Điểm đánh giá tổng | [data-test="overall-rating"] |
| Ưu điểm | [data-test="pros"] |
| Nhược điểm | [data-test="cons"] |
| Ngày | [data-test="review-date"] |
| Vai trò người viết review | [data-test="author-jobTitle"] |
Bước 5: Scrape dữ liệu lương trên Glassdoor
Trang lương bị khóa hoàn toàn sau đăng nhập. Bạn phải có session đã xác thực (Bước 6) trước thì code bên dưới mới trả về dữ liệu thật.
Đi tới trang lương
URL lương có dạng: /Salary/{Company}-Salaries-E{id}.htm, phân trang bằng _P{n}.htm.
def scrape_salaries(page, salary_url, max_pages=3):
    all_salaries = []

    for pg in range(1, max_pages + 1):
        url = salary_url if pg == 1 else salary_url.replace(".htm", f"_P{pg}.htm")
        page.goto(url)
        page.add_style_tag(content="""
            #HardsellOverlay { display: none !important; }
            body { overflow: auto !important; position: initial !important; }
        """)
        time.sleep(random.uniform(3, 7))

        html = page.content()
        sel = Selector(text=html)
        items = sel.css('[data-test="salary-item"]')

        if not items:
            print(f"Trang lương {pg}: không có item nào — có thể bị chặn hoặc dính login gate.")
            break

        for item in items:
            salary = {
                "job_title": item.css('[class*="SalaryItem_jobTitle__"]::text').get("").strip(),
                "salary_range": item.css('[class*="SalaryItem_salaryRange__"]::text').get("").strip(),
                "count": item.css('[class*="SalaryItem_salaryCount__"]::text').get("").strip(),
            }
            all_salaries.append(salary)

        print(f"Trang lương {pg}: đã scrape {len(items)} mục")

    return all_salaries
Lưu ý pattern khớp tiền tố [class*="SalaryItem_jobTitle__"]. Trang lương của Glassdoor dùng class CSS-module có hash (ví dụ SalaryItem_jobTitle__XWGpT) và phần hash này đổi mỗi lần deploy. Tiền tố thì vẫn giữ nguyên — hash thì không. Tuyệt đối đừng hardcode toàn bộ class name.
Bước 6: Vượt qua tường đăng nhập của Glassdoor
Đây là phần quan trọng để mở khóa dữ liệu lương và toàn văn review. Cách làm là: đăng nhập thủ công một lần trong browser hiển thị, lưu trạng thái session đã xác thực, rồi tái sử dụng cho tất cả các lần scrape sau.
Lưu session đã xác thực
Chạy script này một lần. Nó sẽ mở cửa sổ Chrome, đi tới trang đăng nhập của Glassdoor (hiện nay chuyển hướng sang Indeed Login), và chờ bạn tự đăng nhập:
import asyncio
from pathlib import Path
from patchright.async_api import async_playwright

STATE_FILE = Path("glassdoor_state.json")

async def login_and_save():
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=False, channel="chrome")
        context = await browser.new_context(
            viewport={"width": 1366, "height": 800},
            locale="en-US",
        )
        page = await context.new_page()
        await page.goto("https://www.glassdoor.com/profile/login_input.htm")
        print("Hãy đăng nhập trong cửa sổ browser, rồi nhấn Enter tại đây...")
        input()
        await context.storage_state(path=str(STATE_FILE))
        print(f"Đã lưu session vào {STATE_FILE}")
        await browser.close()

asyncio.run(login_and_save())
Sau khi bạn đăng nhập và nhấn Enter, Patchright sẽ lưu toàn bộ cookie và local storage vào glassdoor_state.json. File này chứa gdId, GSESSIONID, cf_clearance và các auth token của bạn.
Tái sử dụng session cho scraping
Mọi lần scrape tiếp theo chỉ cần nạp lại state đã lưu — không cần đăng nhập thủ công nữa:
async def scrape_with_auth(target_url):
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True, channel="chrome")
        context = await browser.new_context(
            storage_state="glassdoor_state.json"
        )
        page = await context.new_page()
        await page.goto(target_url)
        await page.add_style_tag(
            content="#HardsellOverlay{display:none!important}"
        )
        await page.wait_for_load_state("networkidle")
        html = await page.content()
        await browser.close()
        return html
Session đã lưu thường chỉ sống được khoảng 20–30 phút sử dụng liên tục trước khi Glassdoor yêu cầu xác thực lại. Với những đợt scrape dài hơn, hãy thêm bước kiểm tra: nếu một trang đáng lẽ phải có dữ liệu nhưng lại trả về 0 kết quả, hãy coi đó là session hết hạn và chạy lại script đăng nhập để làm mới file state.
Phát hiện và gỡ popup đăng nhập
Với những trang bị khóa một phần (job listing vẫn hiện dữ liệu nhưng có modal che), cách chèn CSS ở các bước trước sẽ hoạt động:
page.add_style_tag(content="""
    #HardsellOverlay, .LoginModal { display: none !important; }
    body { overflow: auto !important; position: initial !important; }
""")
Cách này chỉ hiệu quả khi HTML bên dưới overlay đã có sẵn dữ liệu. Với các trang bị khóa hoàn toàn từ server (lương, trang review sâu hơn), session đã xác thực ở Bước 6 là con đường duy nhất.
Mẹo để scraper Glassdoor chạy bền hơn
Glassdoor cập nhật frontend khá thường xuyên. Đây là cách tăng khả năng sống sót cho scraper của bạn.
Ưu tiên data-test thay vì class name
Glassdoor random hóa CSS class nhưng thường giữ ổn định các thuộc tính data-test. Luôn ưu tiên [data-test="jobListing"] thay vì .jobCard_abc123. Khi không có data-test (như với field lương), hãy dùng pattern khớp tiền tố: [class*="SalaryItem_jobTitle__"].
Xoay proxy và thêm độ trễ ngẫu nhiên
Dùng proxy residential xoay vòng — IP datacenter sẽ bị thử thách gần như ngay lập tức. Thêm độ trễ ngẫu nhiên 3–8 giây giữa các lần tải trang (5–15 giây cho các batch dài). Nếu có thể, tránh scrape trong giờ làm việc ở Mỹ, khi cơ chế phát hiện hành vi của Cloudflare thường gắt hơn.
Theo dõi tình trạng hỏng
Hãy nhúng một kiểm tra đơn giản vào scraper: nếu một trang vốn phải có dữ liệu mà lại trả về 0 bản ghi, hãy xem đó là lỗi selector chứ không phải kết quả rỗng, rồi tự gửi cảnh báo. Chạy một lượt test nhỏ mỗi tuần để phát hiện hỏng sớm — Glassdoor deploy thay đổi frontend mà không báo trước.
Dùng đường đi nhanh __NEXT_DATA__ khi có thể
Glassdoor là ứng dụng Next.js + Apollo GraphQL. Nhiều trang có thẻ <script id="__NEXT_DATA__"> chứa toàn bộ Apollo cache dưới dạng JSON. Parse dữ liệu này bền hơn nhiều so với scrape DOM và hoàn toàn bỏ qua Hardsell overlay:
import json

def extract_next_data(html):
    sel = Selector(text=html)
    raw = sel.css("script#__NEXT_DATA__::text").get()
    if raw:
        return json.loads(raw)["props"]["pageProps"].get("apolloCache", {})
    return None
Cách này trả về Apollo cache có cấu trúc, gồm đầy đủ field của job, review và salary — không cần selector CSS. Đây là chiến lược trích xuất bền nhất hiện có, vì nó dùng chính dữ liệu nuôi giao diện React của Glassdoor.
Bỏ qua code: scrape Glassdoor bằng Thunderbit (không cần Python)
Không phải ai đọc bài này cũng là developer. Team HR, recruiter, analyst sales ops và nhà nghiên cứu thị trường cũng cần dữ liệu Glassdoor — và họ không nên phải tự quản lý Playwright context hay xoay proxy chỉ để lấy nó.
Thunderbit là một AI Web Scraper Chrome Extension có thể trích xuất cùng dữ liệu jobs, reviews và salary mà không cần viết một dòng code nào. Tôi làm việc ở team Thunderbit nên xin nói rõ điều đó — nhưng lý do tôi đưa nó vào đây là vì nó thực sự giải quyết được hai bài toán khó nhất của Glassdoor scraping.
Thunderbit hoạt động trên Glassdoor như thế nào
Quy trình chỉ có hai cú click:
- Mở bất kỳ trang Glassdoor nào trong Chrome (tìm việc, review công ty, hoặc trang lương)
- Click AI Suggest Fields ở sidebar của Thunderbit — AI sẽ đọc DOM trang và đề xuất cột (job title, company, rating, salary range, pros, cons, v.v.)
- Click Scrape — dữ liệu được trích xuất thành bảng mà không cần selector CSS hay code tự động hóa trình duyệt
Thunderbit có sẵn template Glassdoor company scraper có thể trích hơn 23 trường cho mỗi công ty chỉ trong một lượt chạy. Với tin tuyển dụng, review hoặc salary, quy trình AI Suggest Fields tổng quát có thể xử lý bất kỳ URL Glassdoor nào.
Xử lý tường đăng nhập mà không cần code
Đây là lợi thế cấu trúc của Thunderbit đối với Glassdoor. Browser Mode chạy ngay trong phiên Chrome của chính bạn — nếu bạn đã đăng nhập Glassdoor trong Chrome, Thunderbit sẽ tự kế thừa cookie đó. Tường đăng nhập chặn scraper server-side sẽ không còn là vấn đề. Không quản lý cookie, không cần context bền vững, không viết code phiên đăng nhập.
Scrape subpage để làm giàu dữ liệu
Bắt đầu từ một trang danh sách (ví dụ 30 công ty từ một kết quả tìm kiếm), để Thunderbit liệt kê các dòng, rồi bật subpage scraping để đi vào từng trang review hoặc salary của công ty và làm giàu bảng bằng mô tả đầy đủ, nội dung review hoặc chi tiết lương.
Xuất sang công cụ kinh doanh
Khác với Python script thường chỉ xuất CSV hoặc JSON, Thunderbit xuất thẳng sang Google Sheets, Airtable, Notion hoặc Excel — miễn phí ở mọi gói. Điều này đặc biệt hữu ích cho các team cần chia sẻ và phân tích dữ liệu cùng nhau.
Python vs. Thunderbit: khi nào nên dùng gì
| Tình huống | Cách làm nên chọn |
|---|---|
| Xây dựng pipeline dữ liệu định kỳ | Python + Patchright |
| Nghiên cứu một lần hoặc dự án nhóm nhỏ | Thunderbit |
| Cần kiểm soát lập trình từng field | Python |
| Người không biết code nhưng cần dữ liệu Glassdoor ngay hôm nay | Thunderbit |
| Scrape 1.000+ trang trong một lần chạy | Python + proxy |
| Scrape 30 công ty kèm dữ liệu làm giàu | Cả hai đều được — Thunderbit thiết lập nhanh hơn |
Giá Thunderbit bắt đầu từ miễn phí (6 trang/tháng), với gói Pro $38/tháng cho 3.000 credits. Với 1 credit cho mỗi dòng output (2 credits khi subpage scraping), như vậy đủ cho khoảng 33 lần chạy với 30 công ty đã làm giàu mỗi tháng.
Dùng thử Thunderbit để scrape Glassdoor
Scrape Glassdoor có hợp pháp không?
Tôi sẽ nói ngắn gọn và đúng trọng tâm. Điều khoản sử dụng của Glassdoor ghi rất rõ là cấm scraping tự động: "You may not use any robot, spider, scraper... to access the Services for any purpose without our express written permission."
Tuy nhiên, bối cảnh pháp lý phức tạp hơn một điều khoản ToS đơn lẻ:
- Meta v. Bright Data (N.D. Cal., 01/2024): tòa cho rằng nếu bạn chưa từng đăng nhập thì bạn chưa chấp nhận ToS, và việc scrape công khai khi đã đăng xuất không vi phạm điều đó
- hiQ Labs v. LinkedIn (9th Cir.): CFAA không áp dụng cho việc thu thập tự động dữ liệu công khai có thể truy cập — nhưng tài khoản giả và scraping khi đã đăng nhập là câu chuyện khác
- Van Buren v. United States (Tối cao Pháp viện, 2021): thu hẹp khái niệm "exceeds authorized access" trong CFAA
Kết luận thực tế: scrape các job listing công khai mà không đăng nhập nằm trong vùng pháp lý tương đối an toàn hơn. Nhưng nếu bạn scrape bằng session đã đăng nhập, nghĩa là bạn đã chấp nhận ToS khi đăng ký, và ToS cấm rõ ràng việc đó. Điều này áp dụng như nhau cho cả Python script lẫn Browser Mode của Thunderbit.
Một vài nguyên tắc đạo đức nên tuân thủ dù trong trường hợp nào:
- Giới hạn tốc độ thấp hơn nhiều so với người dùng bình thường
- Không scrape hay bán lại thông tin định danh cá nhân của người review
- Tôn trọng robots.txt
- Chỉ lấy những field bạn thật sự cần
Kết luận: phương pháp nào phù hợp với bạn?
Hướng dẫn này đã bao quát cả ba loại dữ liệu trên Glassdoor — việc làm, đánh giá và lương — bằng code 2025 vẫn còn chạy, có tính đến việc chuyển sang Indeed Login, Cloudflare Bot Management, và cơ chế xoay tên class của CSS module vốn đã làm hỏng mọi tutorial cũ.
Khung ra quyết định như sau:
| Tình huống của bạn | Cách tốt nhất |
|---|---|
| Developer xây pipeline dữ liệu | Python + Patchright (làm theo từng bước ở trên) |
| Nghiên cứu một lần hoặc pull nhỏ lặp lại | Thunderbit (không cần code, chạy trên browser) |
| Chỉ cần job listing cơ bản ở quy mô nhỏ | Kiểm tra xem còn truy cập Glassdoor API không trước đã (khả năng cao là không) |
| Cần riêng dữ liệu lương hoặc review | Bắt buộc dùng Python scraping hoặc Thunderbit — API chưa bao giờ hỗ trợ các dữ liệu này |
| Team không biết code nhưng cần chia sẻ dữ liệu | Thunderbit → xuất sang Google Sheets |
Hệ thống phòng thủ của Glassdoor sẽ còn tiếp tục thay đổi. Selector sẽ gãy. Thử thách mới sẽ xuất hiện. Hãy bookmark hướng dẫn này — và nếu bạn muốn đào sâu hơn về công cụ và kỹ thuật web scraping, hãy đọc thêm các bài viết của chúng tôi về best automated web scraping tools, how to scrape data from a website with Python, và best job scraping tools. Bạn cũng có thể xem các video hướng dẫn trên kênh YouTube của Thunderbit.
Dùng thử Thunderbit để trích xuất dữ liệu Glassdoor Get Started Free
Câu hỏi thường gặp
1. Có thể scrape Glassdoor mà không đăng nhập không?
Có, với phần lớn dữ liệu job listing và điểm đánh giá tổng quan của công ty. Không, với breakdown lương đầy đủ hoặc toàn văn review sau vài trang đầu. #HardsellOverlay chỉ là một modal thuần CSS — HTML bên dưới vẫn chứa dữ liệu của trang đầu — nhưng nội dung sâu hơn bị khóa ở phía server sau bức tường "give-to-get" của Glassdoor.
2. Thư viện Python nào phù hợp nhất để scrape Glassdoor trong năm 2025?
Patchright (một nhánh Playwright ngụy trang) là đề xuất mặc định. Nó vá lỗ Runtime.Enable CDP leak mà Playwright thuần có và Cloudflare kiểm tra rất kỹ. Với các trang list có __NEXT_DATA__ trong HTML ban đầu, curl_cffi với impersonate="chrome124" nhanh hơn 10–20 lần nhưng không xử lý được các trang cần đăng nhập.
3. Làm sao tránh bị chặn khi scrape Glassdoor?
Dùng Patchright hoặc rebrowser-playwright (không dùng Playwright thuần hay Selenium). Xoay proxy residential — IP datacenter sẽ bị thử thách ngay. Thêm độ trễ ngẫu nhiên 3–8 giây giữa các trang. Giữ cookie (gdId, cf_clearance, GSESSIONID) xuyên suốt các request. Hãy chuẩn bị tinh thần session chỉ chạy được khoảng 20–30 phút trước khi bị yêu cầu xác thực lại.
4. Có API nào của Glassdoor để thay cho scraping không?
Gần như là không. Partner API cũ đã đóng với ứng viên mới, endpoint review công khai chưa từng tồn tại, và dưới Indeed Publisher API cũng không có đường chuyển đổi. Với review và dữ liệu lương, scraping hoặc công cụ không cần code như Thunderbit là lựa chọn thực tế duy nhất.
5. Scraper Glassdoor thường hỏng bao lâu một lần?
Rất thường xuyên. Glassdoor deploy thay đổi frontend mà không báo trước, và hash class của CSS module đổi ở mỗi lần build. Các chiến lược trích xuất ổn định nhất là: (1) selector theo thuộc tính data-test, (2) blob JSON __NEXT_DATA__, và (3) endpoint BFF nội bộ cho reviews. Hãy thêm kiểm tra kết quả rỗng và chạy test nhỏ mỗi tuần để phát hiện hỏng sớm.
Tìm hiểu thêm



