

Thu thập dữ liệu web đã đi từ một kỹ năng ngách thành “siêu năng lực” gần như bắt buộc với bất kỳ ai làm sales, vận hành hay nghiên cứu thị trường. Khi lượng dữ liệu web tăng vọt — tổng lượng dữ liệu toàn cầu được tạo ra đã tăng gần 193% từ 2019 đến 2023 — cũng không có gì lạ khi 81% doanh nghiệp hiện xem dữ liệu là “trái tim” của quá trình ra quyết định. Nhưng vấn đề là: 95% tổ chức cho biết việc xử lý dữ liệu phi cấu trúc, như HTML lộn xộn, là một thách thức lớn. Tôi đã thấy không ít đội nhóm ngập trong những “marathon” copy-paste, cố kéo thông tin từ website vào bảng tính — tin tôi đi, chẳng dễ chịu chút nào.
Thu thập dữ liệu từ bất kỳ website nào bằng AI Get Started Free
Đó chính là lúc BeautifulSoup của Python phát huy tác dụng. Trong bài hướng dẫn thực hành này, tôi sẽ chỉ bạn cách dùng BeautifulSoup để thu thập dữ liệu web, kèm một ví dụ Python Beautiful Soup thực tế mà bạn có thể áp dụng cho nhu cầu kinh doanh của mình. Và vì tôi luôn thích làm việc thông minh hơn là làm việc cực hơn, tôi cũng sẽ chỉ bạn cách kết hợp BeautifulSoup với Thunderbit, công cụ thu thập dữ liệu web AI của chúng tôi, để tăng tốc quy trình và lấy dữ liệu sạch, có cấu trúc hơn — bất kể bạn giỏi code đến đâu.
BeautifulSoup là gì và vì sao nên dùng nó để thu thập dữ liệu web?
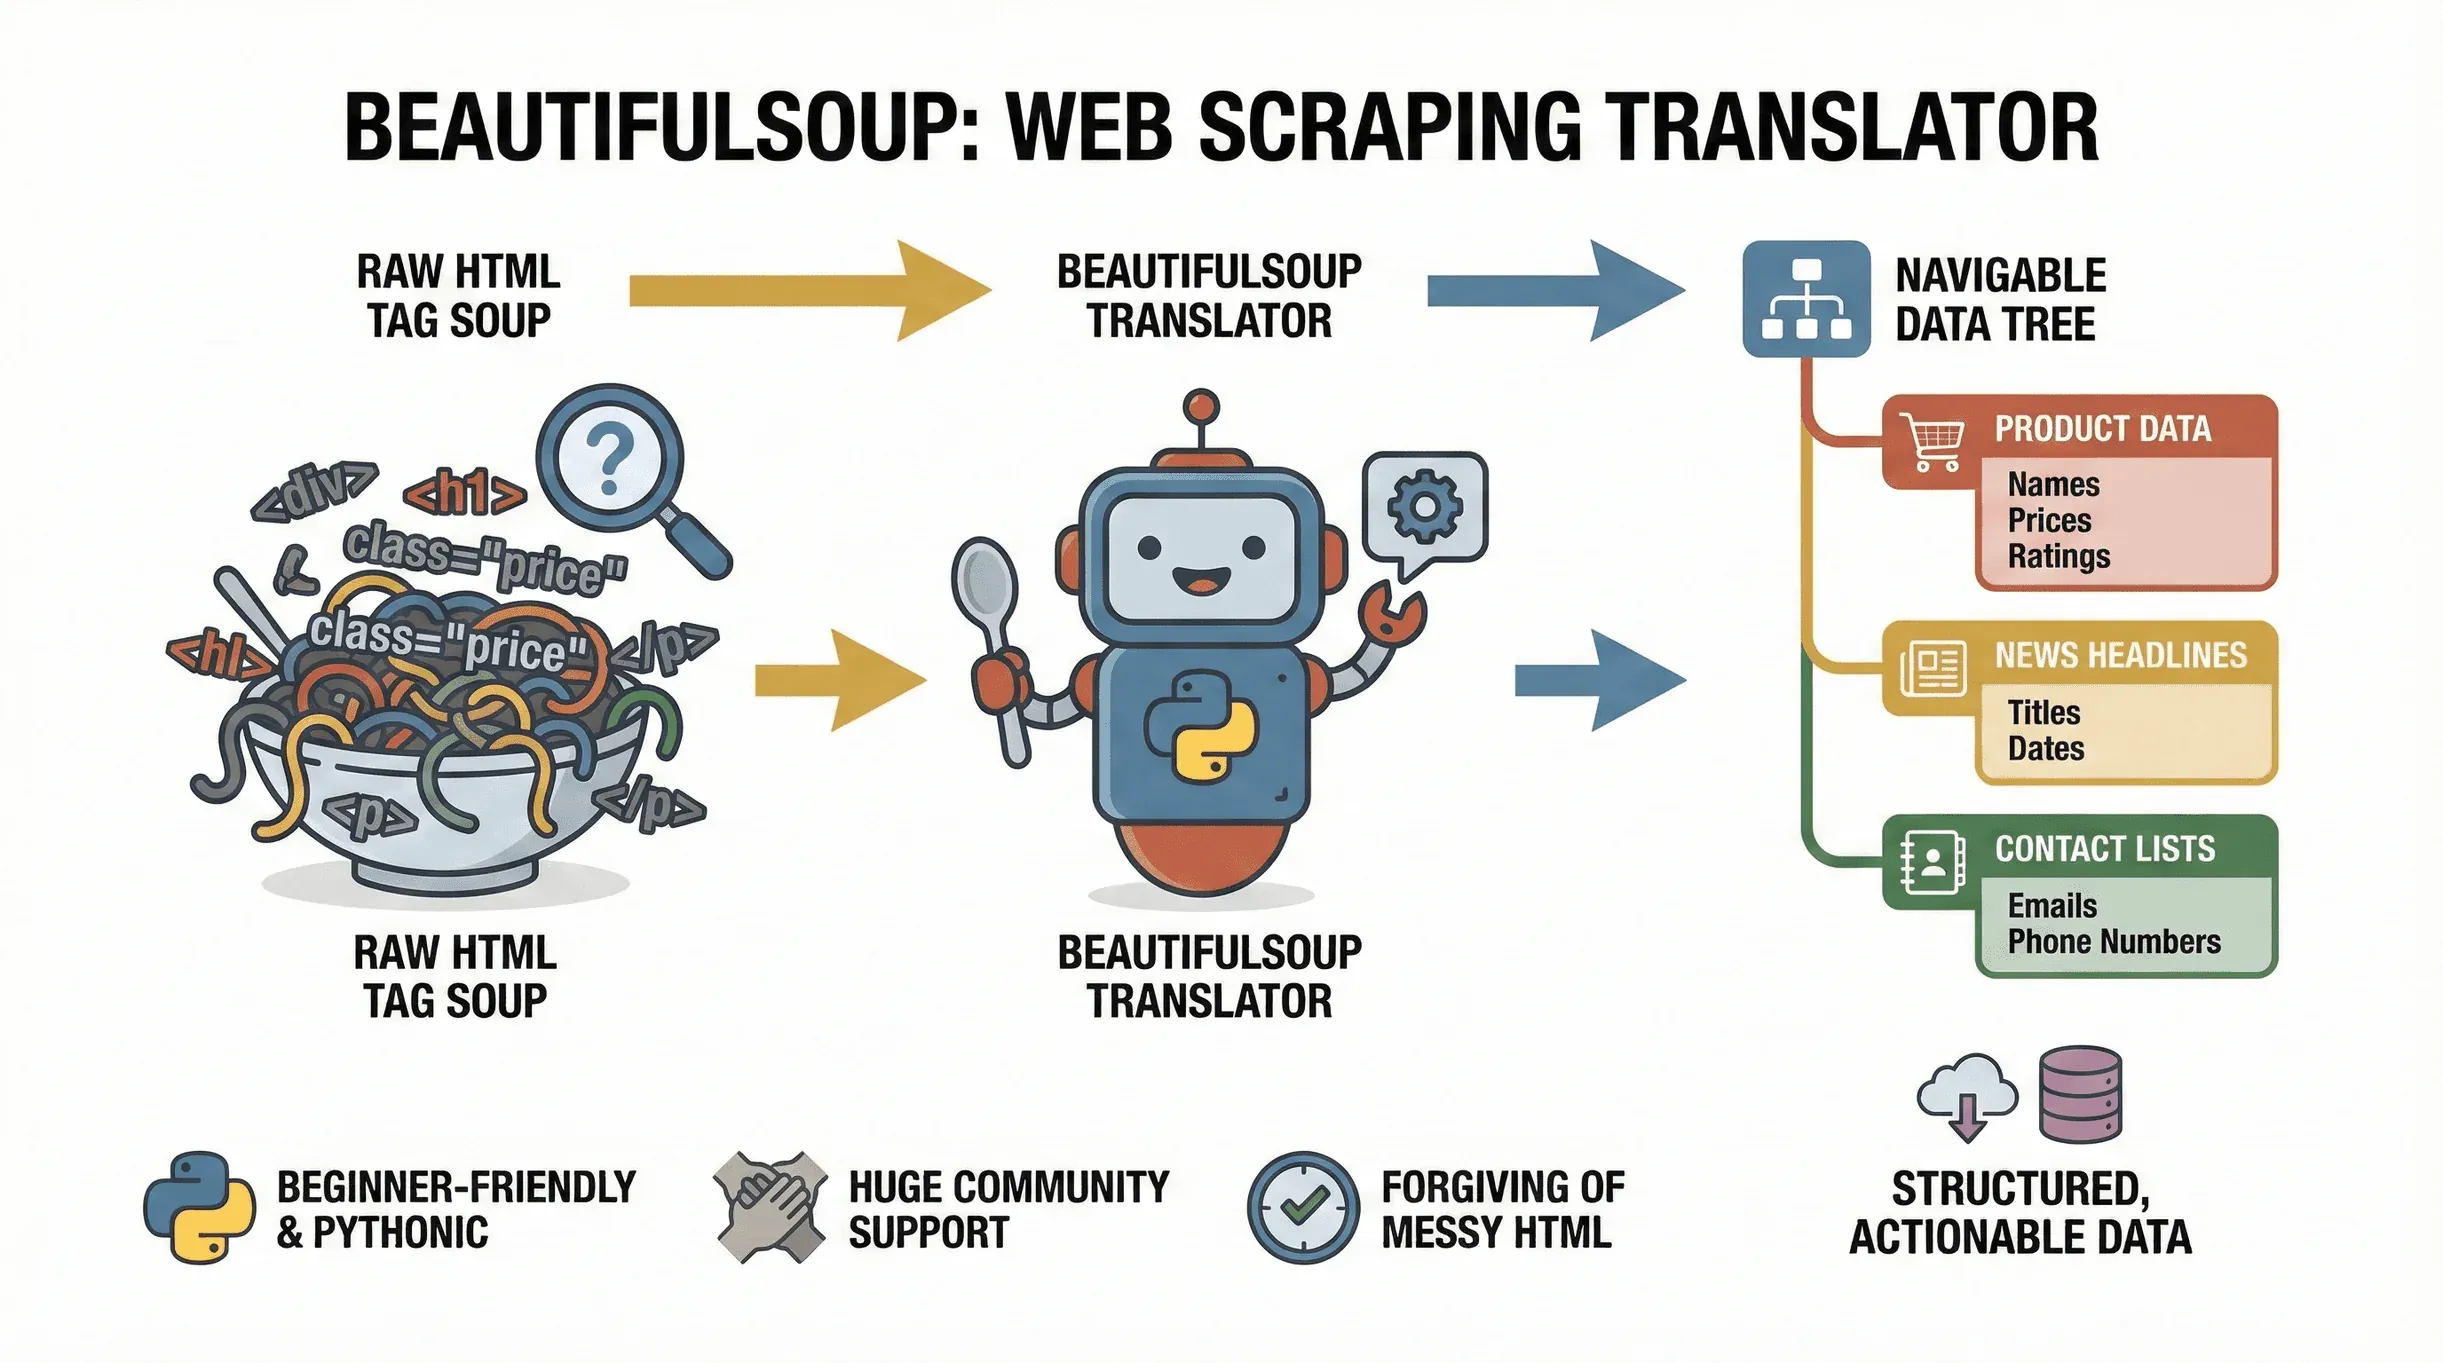 Bắt đầu từ những điều cơ bản nhé. BeautifulSoup là một thư viện Python giúp phân tích tài liệu HTML và XML rất dễ dàng. Hãy xem nó như một “phiên dịch viên”: nó biến mớ “tag soup” của một trang web thành một cây dữ liệu có thể điều hướng, để bạn dễ tìm, trích xuất và chỉnh sửa dữ liệu mình cần. Dự án này vẫn đang được duy trì tích cực —
beautifulsoup4 4.14.3 đã được phát hành trên PyPI vào cuối năm 2025 — nên những gì bạn học ở đây vẫn rất hữu ích. Dù bạn đang lấy giá sản phẩm từ một trang thương mại điện tử, gom tiêu đề tin tức, hay thu thập danh bạ doanh nghiệp để tìm lead, BeautifulSoup vẫn là công cụ quen thuộc để biến trang web thành dữ liệu có cấu trúc và có thể hành động.
Vì sao nó lại phổ biến đến vậy? Trước hết, nó cực kỳ thân thiện với người mới. BeautifulSoup chịu được HTML lộn xộn khá tốt (mà nói thật thì web đầy rẫy kiểu này), và cú pháp đậm chất Python giúp bạn đi từ số 0 đến thu thập dữ liệu chỉ trong vài dòng code. Nó cũng được hỗ trợ rộng rãi, với hàng triệu lượt tải và một cộng đồng khổng lồ — nên nếu bạn bị kẹt, chỉ cần tìm kiếm Google là có thể ra lời giải.
Những trường hợp sử dụng phổ biến của BeautifulSoup gồm:
- Trích xuất tên sản phẩm, giá và đánh giá từ trang thương mại điện tử
- Lấy tiêu đề tin tức, tác giả và ngày xuất bản từ các trang tin
- Phân tích bảng hoặc danh bạ, như danh sách công ty hoặc liên hệ
- Thu thập email hoặc số điện thoại từ các trang đăng tin
- Theo dõi cập nhật, như thay đổi giá hoặc bài đăng tuyển dụng mới
Nếu dữ liệu của bạn nằm trong HTML tĩnh, BeautifulSoup là “bạn thân” nhất của bạn khi thu thập dữ liệu web.
Những lợi thế nổi bật của BeautifulSoup trong thu thập dữ liệu web
Có rất nhiều thư viện Python để thu thập dữ liệu web — vậy vì sao nên chọn BeautifulSoup? Đây là cách nó so sánh với các lựa chọn khác:
- Đơn giản: BeautifulSoup nhẹ, dễ học. Bạn không cần dựng cả một framework hay viết đống mã mẫu lặp đi lặp lại. Nó rất hợp cho những tác vụ thu thập nhanh, làm một lần, hoặc cho người mới bắt đầu.
- Chịu lỗi tốt: Nó xử lý được HTML bị hỏng hoặc không đúng chuẩn, điều này phổ biến hơn bạn nghĩ.
- Linh hoạt: Bạn không bị ép vào một kiến trúc crawl cứng nhắc. Chỉ cần đưa HTML vào và lấy phần mình cần.
- Tích hợp tốt: BeautifulSoup hoạt động rất mượt với các thư viện Python khác như
requestsđể lấy trang web,csvđể lưu dữ liệu vàpandasđể phân tích dữ liệu.
So với các công cụ khác thì sao?
| Công cụ | Phù hợp nhất cho | Ưu điểm | Nhược điểm |
|---|---|---|---|
| BeautifulSoup | Phân tích HTML tĩnh, người mới bắt đầu | Đơn giản, thiết lập nhanh, chịu lỗi tốt, linh hoạt | Không phù hợp với website nặng JavaScript |
| Scrapy | Tác vụ lớn, bất đồng bộ | Mạnh, mở rộng tốt, có sẵn cơ chế crawl | Học khó hơn, cần thiết lập nhiều hơn |
| Selenium | Nội dung JavaScript/động | Tương tác được với JS, điền form, bấm nút | Chậm hơn, nặng hơn, tốn tài nguyên hơn |
Nếu bạn mới bắt đầu hoặc chỉ cần phân tích nhanh các trang tĩnh, BeautifulSoup chính là “dao đa năng Thụy Sĩ” của thu thập dữ liệu web (medium.com). Với các website phức tạp hoặc động hơn, bạn có thể kết hợp nó với Selenium hoặc Scrapy — nhưng BeautifulSoup vẫn là cách tốt nhất để học nhập môn.
Thiết lập môi trường Python cho BeautifulSoup
Sẵn sàng bắt đầu chưa? Đây là cách thiết lập môi trường:
-
Cài Python: Tải phiên bản mới nhất từ python.org.
-
Tạo môi trường ảo (không bắt buộc, nhưng nên làm):
python -m venv venv source venv/bin/activate # Trên Windows: venv\Scripts\activate -
Cài BeautifulSoup và các phụ thuộc:
pip install beautifulsoup4 requests lxml html5libbeautifulsoup4: Thư viện chínhrequests: Dùng để lấy trang weblxmlhoặchtml5lib: Bộ phân tích HTML nhanh hơn/ổn định hơn
-
Mẹo xử lý lỗi:
- Nếu gặp lỗi “pip not found”, hãy thử
pip3hoặcpy -m pip. - Trên Mac/Linux, bạn có thể cần
sudođể cấp quyền. - Nếu dùng Windows, hãy chắc chắn Python đã được thêm vào PATH.
- Nếu gặp lỗi “pip not found”, hãy thử
Để kiểm tra thiết lập, hãy chạy thử đoạn code nhanh này:
from bs4 import BeautifulSoup
import requests

html = requests.get("http://example.com").text
soup = BeautifulSoup(html, "html.parser")
print(soup.title)
Nếu bạn thấy <title>Example Domain</title>, mọi thứ đã sẵn sàng (Thunderbit Blog).
Ví dụ Python Beautiful Soup từng bước
Hãy đi vào một ví dụ Python Beautiful Soup thực tế. Giả sử bạn muốn trích xuất các tiêu đề tin mới nhất từ một trang tin công khai. Cách làm sẽ như sau:
1. Lấy trang web
import requests
from bs4 import BeautifulSoup

url = "https://www.bbc.com/news"
response = requests.get(url)
html = response.text
2. Phân tích HTML
soup = BeautifulSoup(html, "html.parser")
3. Kiểm tra cấu trúc HTML
Mở Developer Tools của trình duyệt (nhấp phải → Inspect) và tìm các thẻ chứa tiêu đề. Ở nhiều trang tin, tiêu đề nằm trong các thẻ <h3> với class cụ thể.
Ví dụ, bạn có thể thấy:
<h3 class="gs-c-promo-heading__title">Tiêu đề bài viết</h3>
4. Trích xuất dữ liệu
headlines = soup.find_all("h3", class_="gs-c-promo-heading__title")
for h in headlines:
    print(h.get_text(strip=True))
Đoạn này sẽ in ra toàn bộ tiêu đề tin trên trang.
5. Lưu dữ liệu ra CSV
Hãy lưu các tiêu đề đó để phân tích sau:
import csv

with open("headlines.csv", "w", newline='', encoding="utf-8") as file:
    writer = csv.writer(file)
    writer.writerow(["tiêu đề"])
    for h in headlines:
        writer.writerow([h.get_text(strip=True)])
Bây giờ bạn đã có một tệp CSV sẵn sàng để mở bằng Excel hoặc Google Sheets.
Hiểu cấu trúc HTML để trích xuất dữ liệu hiệu quả
Trước khi viết bất kỳ dòng code nào, hãy luôn kiểm tra HTML của trang. Cách làm như sau:
- Mở Developer Tools: Nhấp phải vào trang và chọn “Inspect”.
- Tìm dữ liệu: Di chuột qua các phần tử để xem thẻ nào chứa thông tin bạn cần, ví dụ như tiêu đề, giá, tác giả.
- Ghi chú thẻ và class: Tìm các định danh duy nhất như
class="product-title"hoặcid="main-content". - Kiểm tra bộ chọn: Dùng các phương thức
.find(),.find_all()hoặc.select()của BeautifulSoup để nhắm đúng phần tử.
Mẹo nhỏ: Dùng soup.prettify() để in ra phiên bản HTML dễ đọc trong console Python.
Trích xuất và cấu trúc dữ liệu với BeautifulSoup
Giả sử bạn muốn trích xuất cả tiêu đề lẫn tác giả từ một trang blog:
articles = soup.find_all("article")
data = []
for article in articles:
    title = article.find("h2").get_text(strip=True)
    author = article.find("span", class_="author").get_text(strip=True)
    data.append({"title": title, "author": author})
Bây giờ bạn đã có một danh sách các dictionary — rất hợp để xuất ra CSV hoặc phân tích tiếp.
Bạn có thể trích xuất liên kết, hình ảnh hoặc bất kỳ thuộc tính nào như sau:
for link in soup.find_all("a"):
    print(link.get("href"))
Hoặc hình ảnh:
for img in soup.find_all("img"):
    print(img.get("src"))
Lưu dữ liệu đã trích xuất: từ Python sang Excel hoặc CSV
Khi dữ liệu đã được cấu trúc, việc xuất file rất đơn giản. Đây là cách làm với module csv:
import csv

with open("articles.csv", "w", newline='', encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=["title", "author"])
    writer.writeheader()
    for row in data:
        writer.writerow(row)
Hoặc nếu bạn thích pandas:
import pandas as pd

df = pd.DataFrame(data)
df.to_csv("articles.csv", index=False)
df.to_excel("articles.xlsx", index=False)
Luôn dùng mã hóa UTF-8 để tránh lỗi ký tự lạ, đặc biệt khi làm việc với dữ liệu quốc tế.
Nghiên cứu tình huống: Thu thập dữ liệu tin tức bằng BeautifulSoup
Hãy cùng đi qua một ví dụ Python Beautiful Soup thực tế: thu thập tiêu đề bài viết, tác giả và ngày xuất bản từ một trang tin.
Giả sử bạn muốn thu thập dữ liệu bài viết từ CNN:
import requests
from bs4 import BeautifulSoup
import csv

url = "https://edition.cnn.com/world"
response = requests.get(url)
soup = BeautifulSoup(response.content, "html.parser")

articles = soup.find_all("article")
data = []

for article in articles:
    title_tag = article.find("h3")
    date_tag = article.find("span", class_="date")
    author_tag = article.find("span", class_="author")
    title = title_tag.get_text(strip=True) if title_tag else ""
    date = date_tag.get_text(strip=True) if date_tag else ""
    author = author_tag.get_text(strip=True) if author_tag else ""
    data.append({"title": title, "date": date, "author": author})

with open("cnn_articles.csv", "w", newline='', encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=["title", "date", "author"])
    writer.writeheader()
    for row in data:
        writer.writerow(row)
Đoạn script này sẽ lấy các bài viết mới nhất, trích xuất tiêu đề, ngày và tác giả, rồi lưu vào CSV — miễn là cấu trúc hiện tại của CNN vẫn khớp với các thẻ bên trên. Các trang tin lớn thường thay đổi class name và cấu trúc DOM khá thường xuyên, nên hãy kiểm tra lại trang trước khi chạy trên dữ liệu thực tế. Cấu trúc (<article>, rồi dùng find trên các thẻ con) là mẫu bền vững; còn các class cụ thể như "date" và "author" chỉ là chỗ giữ chỗ, bạn cần chỉnh lại theo dữ liệu mà trang đang trả về ở thời điểm hiện tại.
Tăng hiệu quả quy trình của bạn: Kết hợp BeautifulSoup với Thunderbit
Giờ hãy nói về cách làm cho quy trình thu thập dữ liệu mượt hơn nữa. Thunderbit là một tiện ích Chrome thu thập dữ liệu web bằng AI, giúp bạn không còn phải đoán mò khi trích xuất dữ liệu. Với Thunderbit, bạn có thể:
- Dùng “AI Suggest Fields”: Thunderbit đọc trang và tự động gợi ý những trường dữ liệu nên trích xuất — không cần mò HTML hay chỉnh selector nữa.
- Thu thập trang con: Thunderbit có thể đi theo liên kết sang các trang con, như trang sản phẩm hoặc trang bài viết riêng lẻ, và bổ sung thêm chi tiết vào bộ dữ liệu của bạn.
- Xuất ngay lập tức: Gửi dữ liệu thẳng sang Excel, Google Sheets, Airtable hoặc Notion chỉ với một cú nhấp chuột.
- Xử lý phân trang: Thunderbit có thể thu thập dữ liệu qua nhiều trang, kể cả cuộn vô hạn.
- Lập lịch thu thập: Thiết lập tác vụ định kỳ để giữ dữ liệu luôn mới.
Đây là một quy trình kết hợp mà tôi rất thích:
- Bắt đầu bằng Thunderbit: Mở website mục tiêu, nhấp biểu tượng Thunderbit và để “AI Suggest Fields” xác định các cột phù hợp, như tiêu đề, tác giả, ngày.
- Xuất dữ liệu: Tải kết quả xuống dưới dạng CSV hoặc gửi thẳng vào Google Sheets.
- Dùng BeautifulSoup để xử lý tùy chỉnh: Nếu bạn cần phân tích sâu hơn, như làm sạch văn bản, khử trùng lặp, hoặc ghép với nguồn dữ liệu khác, hãy nạp tệp CSV đã xuất vào Python và dùng BeautifulSoup hoặc pandas để hậu xử lý.
Cách kết hợp này cho bạn cả hai thế mạnh: tốc độ và khả năng nhận diện trường dữ liệu bằng AI của Thunderbit, cộng với sự linh hoạt của BeautifulSoup cho logic tùy chỉnh.
Dùng thử miễn phí Thunderbit AI Web Scraper
Tốc độ và chất lượng dữ liệu: Vì sao nên dùng Thunderbit và BeautifulSoup cùng nhau?
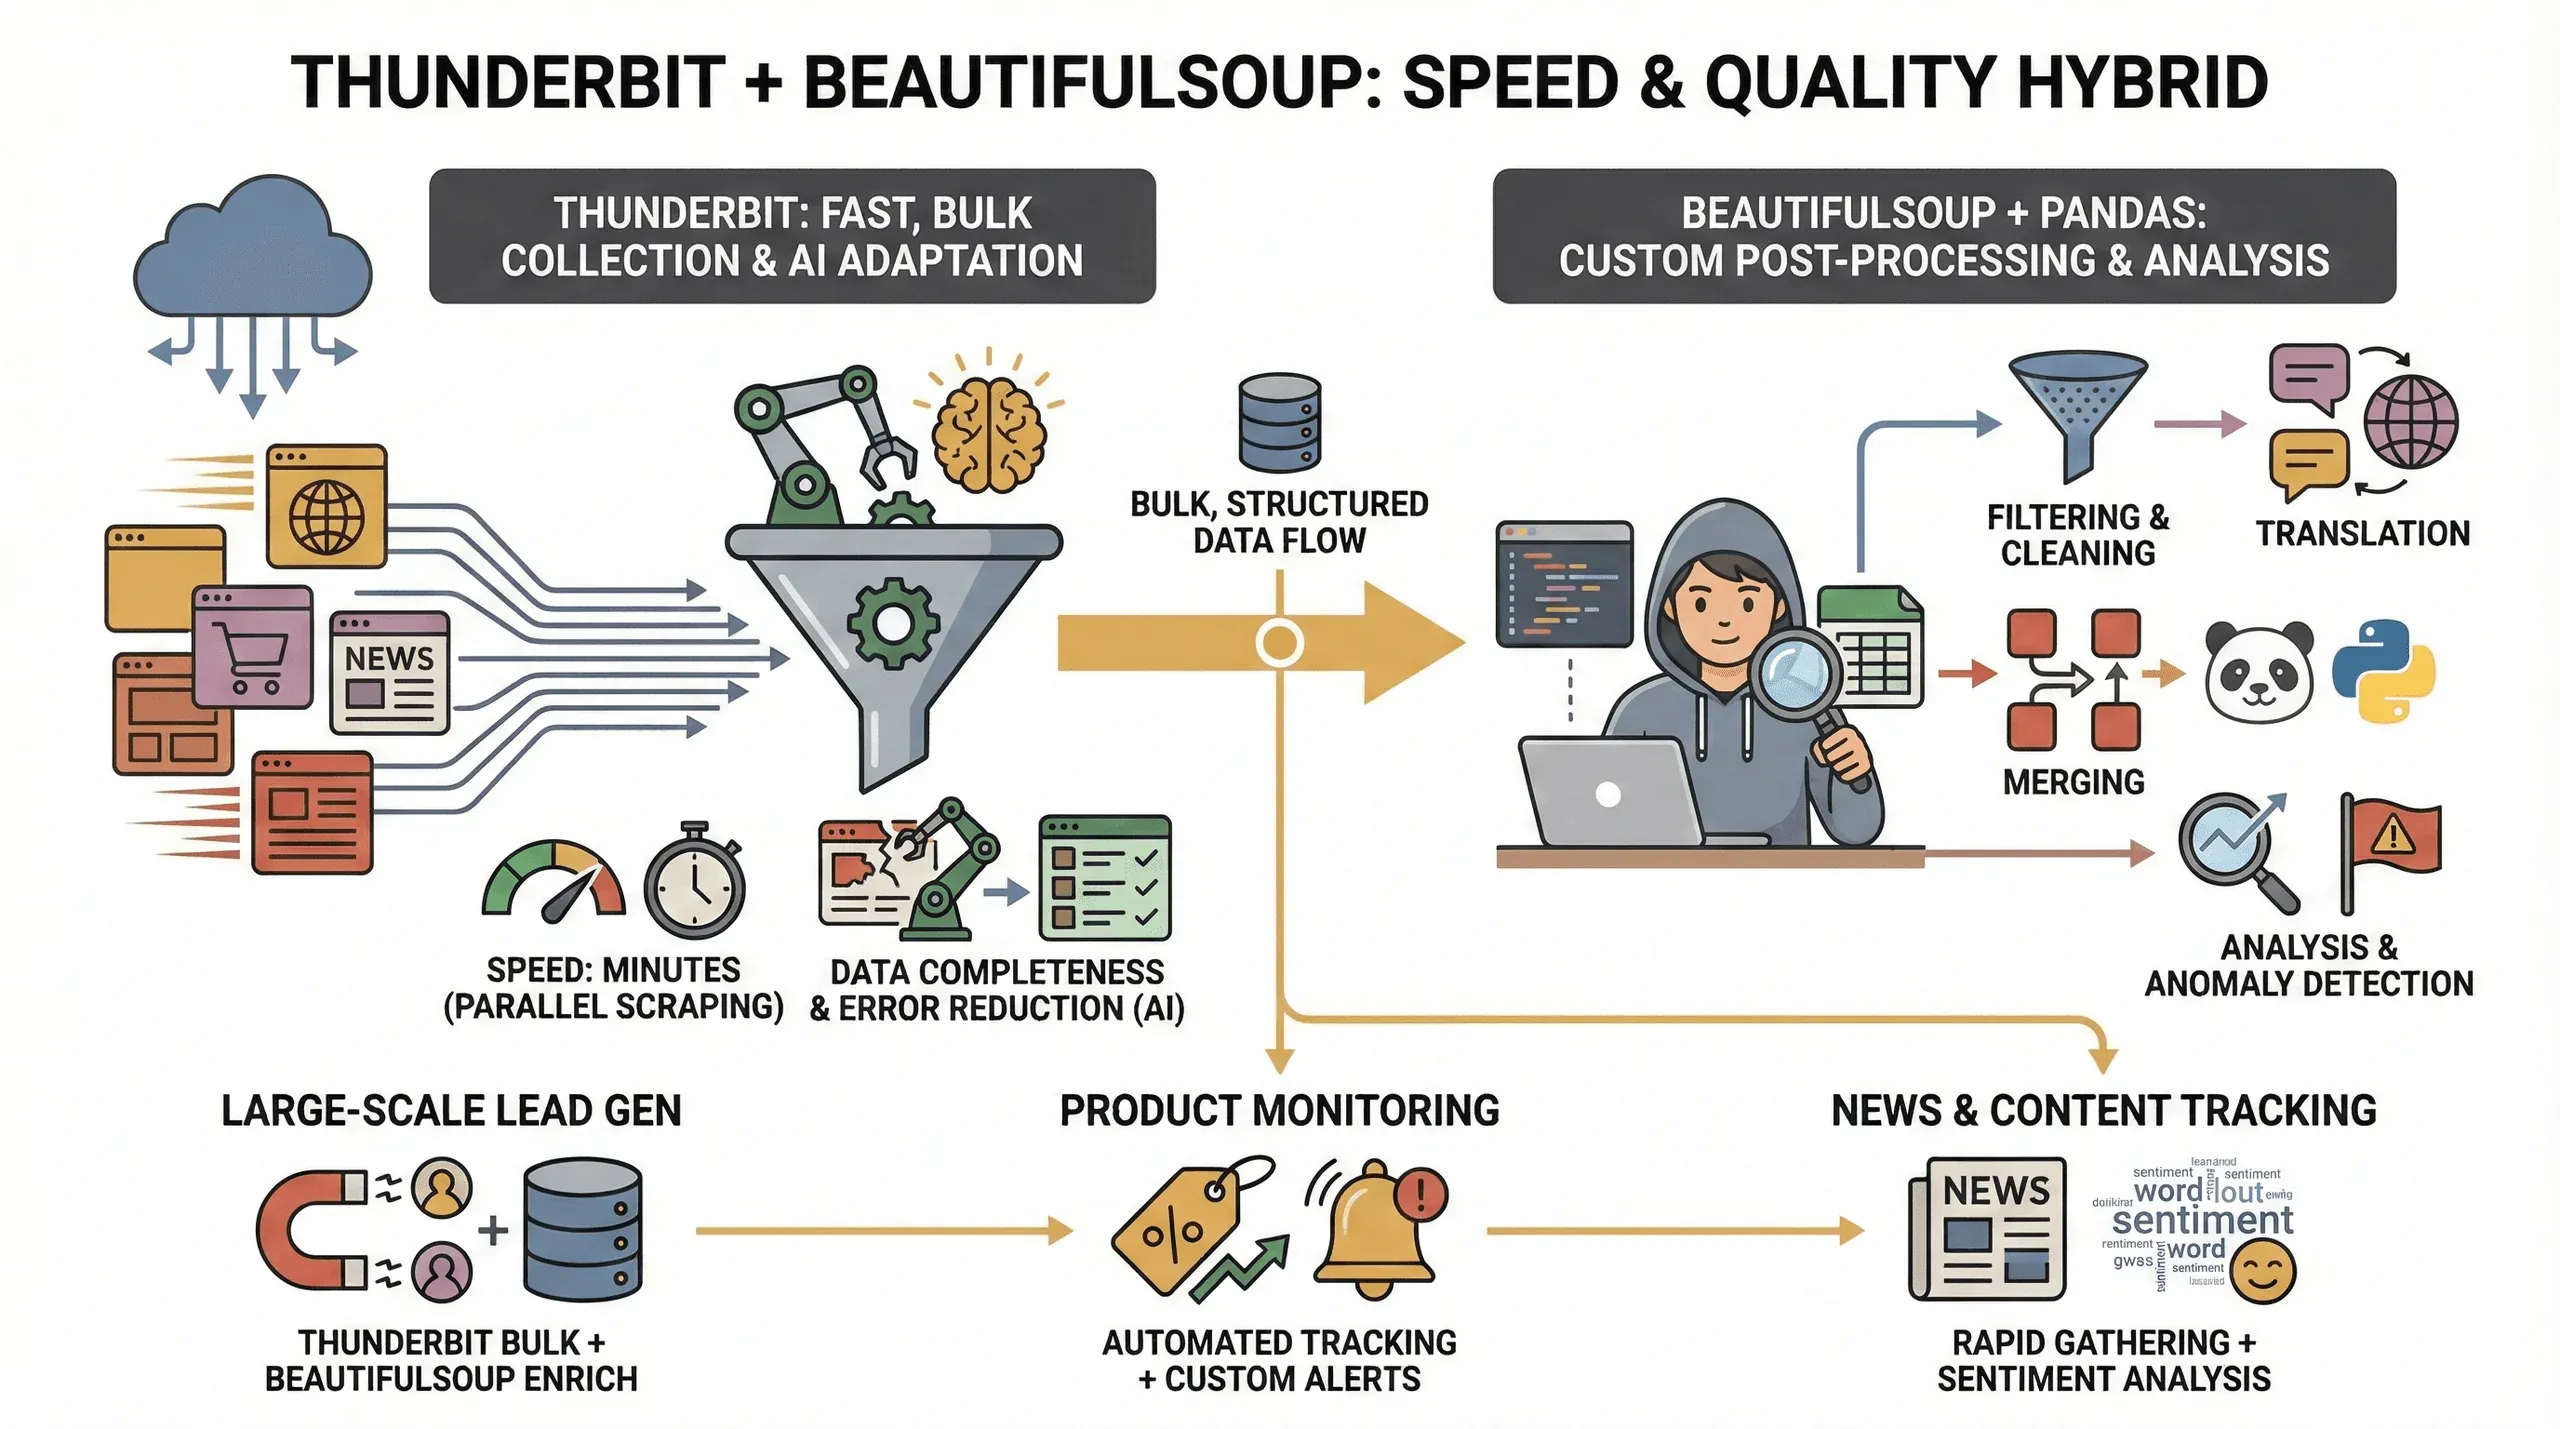 Vì sao phải dùng cả hai công cụ? Đây là những gì tôi đã nhận thấy:
- Tốc độ: Thunderbit có thể thu thập hàng chục trang song song (trong chế độ cloud có thể lên đến 50 trang cùng lúc), nên bạn có dữ liệu trong vài phút thay vì vài giờ.
- Độ đầy đủ của dữ liệu: AI của Thunderbit thích ứng với thay đổi bố cục và có thể trích xuất dữ liệu có cấu trúc ngay cả từ những website khó nhằn, giảm nguy cơ thiếu trường.
- Giảm lỗi: Không còn các script bị hỏng chỉ vì class name thay đổi — AI của Thunderbit sẽ đánh giá lại trang mỗi lần.
- Hậu xử lý tùy chỉnh: Với những nhu cầu nâng cao, như lọc, dịch hoặc ghép dữ liệu, BeautifulSoup và pandas cho bạn toàn quyền kiểm soát.
Cách tiếp cận kết hợp này đặc biệt hữu ích cho:
- Tạo lead quy mô lớn: Dùng Thunderbit để lấy dữ liệu hàng loạt, rồi dùng BeautifulSoup để làm sạch và bổ sung.
- Theo dõi sản phẩm: Thunderbit xử lý phần thu thập lặp đi lặp lại, còn BeautifulSoup giúp bạn phân tích xu hướng hoặc phát hiện bất thường.
- Theo dõi tin tức và nội dung: Gom bài viết nhanh bằng Thunderbit, rồi dùng Python để phân tích cảm xúc hoặc trích xuất từ khóa.
Khắc phục các lỗi thường gặp trong thu thập dữ liệu web bằng BeautifulSoup
Dùng thử Thunderbit Chrome Extension Thu thập dữ liệu từ bất kỳ website nào bằng AI chỉ với 2 cú nhấp. Get Started Free
Thu thập dữ liệu web không phải lúc nào cũng suôn sẻ — dưới đây là những lỗi phổ biến và cách khắc phục:
- Nội dung động: Nếu một website tải dữ liệu bằng JavaScript, như cuộn vô hạn hoặc AJAX, thì chỉ BeautifulSoup thôi sẽ không thấy được. Hãy dùng Selenium hoặc chế độ trình duyệt của Thunderbit cho các trường hợp này.
- Chống bot: Một số site chặn yêu cầu tự động. Hãy thử đặt header User-Agent tùy chỉnh, thêm độ trễ giữa các request, hoặc dùng cloud scraping của Thunderbit để vượt qua các chặn đơn giản.
- HTML thay đổi: Nếu script đột nhiên hỏng, rất có thể HTML của website đã thay đổi. Hãy kiểm tra lại trang và cập nhật selector. AI của Thunderbit có thể hỗ trợ bằng cách thích ứng linh hoạt.
- Thiếu dữ liệu: Luôn kiểm tra xem phần tử có tồn tại trước khi gọi
.get_text(). Dùng.get()thay vì[]cho thuộc tính để tránh KeyError. - Lỗi mã hóa: Lưu tệp với mã hóa UTF-8 để xử lý ký tự đặc biệt.
Và luôn luôn, luôn luôn tôn trọng robots.txt và điều khoản sử dụng của website. Hãy thu thập dữ liệu một cách có trách nhiệm — chẳng ai thích một con bot thô lỗ cả.
Kết luận & điểm chính cần nhớ
Thu thập dữ liệu web bằng BeautifulSoup là một trong những kỹ năng thực tế nhất bạn có thể học trong thế giới dữ liệu hiện nay. Sau đây là những gì chúng ta đã đi qua trong hướng dẫn thu thập dữ liệu web bằng BeautifulSoup này:
- BeautifulSoup là điểm khởi đầu lý tưởng để phân tích HTML tĩnh và trích xuất dữ liệu có cấu trúc bằng Python.
- Thiết lập thì rất nhanh — chỉ cần cài Python, pip và vài thư viện.
- Kiểm tra HTML là chìa khóa để nhắm đúng dữ liệu cần lấy.
- Xuất sang CSV/Excel giúp dữ liệu của bạn sẵn sàng cho phân tích kinh doanh ngay lập tức.
- Kết hợp với Thunderbit mang lại khả năng nhận diện trường bằng AI, thu thập nhanh hơn và xuất dữ liệu dễ hơn — rất phù hợp cho người dùng doanh nghiệp và người không chuyên code.
- Quy trình hybrid (Thunderbit để trích xuất hàng loạt, BeautifulSoup để xử lý tùy chỉnh) mang lại tốc độ, chất lượng dữ liệu và sự linh hoạt tốt nhất.
Nếu bạn sẵn sàng nâng cấp kỹ năng thu thập dữ liệu web của mình, hãy thử cả hai công cụ: thực hành với một script BeautifulSoup đơn giản, rồi xem bạn có thể đi nhanh hơn bao nhiêu với AI web scraper của Thunderbit. Và để xem thêm các hướng dẫn thực hành, hãy ghé Thunderbit Blog.
Chúc bạn thu thập dữ liệu vui vẻ — và mong dữ liệu của bạn luôn sạch, có cấu trúc và sẵn sàng để sử dụng.
Dùng thử Thunderbit AI Web Scraper Get Started Free
Câu hỏi thường gặp
1. BeautifulSoup là gì và dùng để làm gì?
BeautifulSoup là một thư viện Python dùng để phân tích tài liệu HTML và XML. Nó giúp bạn trích xuất dữ liệu từ trang web và chuyển thành các định dạng có cấu trúc như danh sách hoặc bảng, rất lý tưởng cho các dự án thu thập dữ liệu web.
2. BeautifulSoup so với Selenium và Scrapy khác nhau thế nào?
BeautifulSoup nhẹ và dễ dùng cho các trang HTML tĩnh. Selenium phù hợp hơn khi thu thập các website động, nặng JavaScript, còn Scrapy là một framework đầy đủ tính năng cho thu thập quy mô lớn, bất đồng bộ. BeautifulSoup là lựa chọn tốt nhất cho người mới và các tác vụ nhanh.
3. Tôi có thể dùng BeautifulSoup và Thunderbit cùng nhau không?
Hoàn toàn có thể. Thunderbit có thể nhanh chóng nhận diện và trích xuất các trường dữ liệu từ trang web bằng AI, còn BeautifulSoup có thể dùng cho hậu xử lý tùy chỉnh hoặc phân tích sâu hơn dữ liệu đã xuất.
4. Những thách thức thường gặp khi thu thập dữ liệu web bằng BeautifulSoup là gì?
Các vấn đề phổ biến gồm xử lý nội dung động, đối phó với cơ chế chống bot và thích ứng với thay đổi trong cấu trúc HTML. Dùng các tính năng AI của Thunderbit hoặc chế độ trình duyệt có thể giúp vượt qua nhiều thách thức này.
5. Làm sao để xuất dữ liệu BeautifulSoup sang Excel hoặc CSV?
Bạn có thể dùng module csv tích hợp sẵn của Python hoặc thư viện pandas để ghi dữ liệu đã trích xuất ra tệp CSV hoặc Excel. Luôn dùng mã hóa UTF-8 để xử lý ký tự đặc biệt và đảm bảo tương thích với các công cụ bảng tính.
Sẵn sàng tự thử chưa? Tải Chrome Extension của Thunderbit và bắt đầu thu thập thông minh hơn ngay hôm nay. Để xem thêm hướng dẫn và mẹo hay, hãy ghé Thunderbit Blog.
Tìm hiểu thêm
- Làm chủ Beautiful Soup để thu thập dữ liệu web: Hướng dẫn từng bước
- BeautifulSoup trong Python: Hướng dẫn cho người mới bắt đầu
- Hướng dẫn thu thập dữ liệu Python từng bước cho người mới
- Hướng dẫn toàn diện về thu thập dữ liệu web bằng Python: Từng bước một
- Hướng dẫn từng bước: Bài học thu thập dữ liệu web bằng Python




