
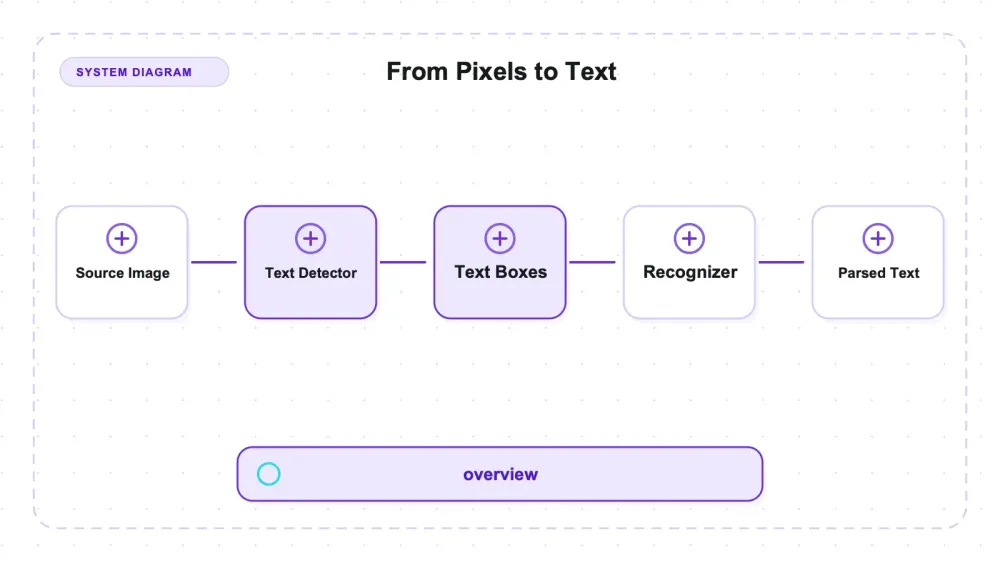
EasyOCR là thư viện OCR kiểu “cài là chạy” của JaidedAI dành cho Python: pip install easyocr, chỉ cần hai dòng code là phần chữ được nhúng trong ảnh sẽ trả về dưới dạng chuỗi. Dự án dùng giấy phép Apache-2.0, hỗ trợ hơn 80 ngôn ngữ, và vận hành theo một pipeline gồm hai mô hình PyTorch — bộ phát hiện CRAFT để khoanh vùng mọi thứ mà nó cho là văn bản, rồi bộ nhận dạng để đọc các ký tự bên trong từng khung. Trọng số pretrained sẽ tự tải xuống ngay lần đầu bạn gọi. Về bản chất, đây là một lựa chọn tự host để thay cho Tesseract và PaddleOCR, chứ không phải OCR cloud tính phí theo từng trang.
API cơ bản rất ngắn: Reader(['en']), rồi readtext(). Nhưng phần triển khai thực tế lại nặng hơn nhiều — trong môi trường này, PyTorch chiếm khoảng 2 GB, và một tiến trình CPU mới khởi tạo có thể lên tới gần 1 GB resident memory ở đỉnh. Tôi đã render 36 ảnh PNG tiếng Anh, chạy easyocr 1.7.2 trên CPU, và chấm kết quả theo từng ký tự so với ground truth được tạo sẵn. Kích thước và hướng xoay là hai yếu tố làm CER tụt mạnh nhất; dashboard cũng lộ ra lỗi nhận diện token ngắn và nhầm dấu đô la.
Thất bại sắc nét nhất liên quan đến đúng tham số mà ai cũng hay khuyên dùng. rotation_info trên tracker lỗi vốn được xem như giải pháp cho ảnh bị xoay, nên tôi cho nó ba bản sao của cùng một câu nhưng xoay trực giao với nhau. Ở góc 270°, nó làm đúng điều được hứa, kéo character error rate từ 0.83 xuống 0.10. Ở góc 180°, nó chỉ hoạt động nửa vời: từ 0.85 xuống 0.67, và mất một cụm từ. Còn ở góc 90°, nó đi ngược lại hoàn toàn: từ 0.81 lên 0.92, trong khi bộ nhận dạng bắt đầu trả về chữ bị lật gương. Cùng một tham số, cùng một danh sách góc, nhưng ba kết quả khác nhau — vì vậy bật nó lên không có nghĩa là “xoay ảnh đã được xử lý”. Bộ 36 fixture đó cũng tạo ra một “vách đá” rất rõ theo cỡ chữ, một lỗi nhầm dấu $ có tính hệ thống, và một dự đoán của tôi cuối cùng hóa ra sai hoàn toàn.
Hai mô hình trong một chiếc áo khoác
EasyOCR không phải một mô hình đơn lẻ. Nó là một pipeline gồm hai phần, và việc biết phần nào thất bại sẽ thay đổi cách bạn gỡ lỗi.
Giai đoạn một là CRAFT, tức bộ phát hiện. Nhiệm vụ của nó chỉ là định vị — xác định chỗ nào trong ảnh có chữ, rồi trả về các khung bao. Nó không đọc ký tự nào cả. Giai đoạn hai là một CRNN bộ nhận dạng — trích xuất đặc trưng bằng ResNet, rồi BiLSTM, rồi giải mã greedy bằng CTC — để đọc các ký tự trong từng khung. Cả hai đều chạy trên PyTorch. Trên CPU, bộ nhận dạng mặc định được lượng tử động sang int8, vì vậy nó nhanh và nhẹ hơn nhiều so với con số tham số thô khiến bạn tưởng.
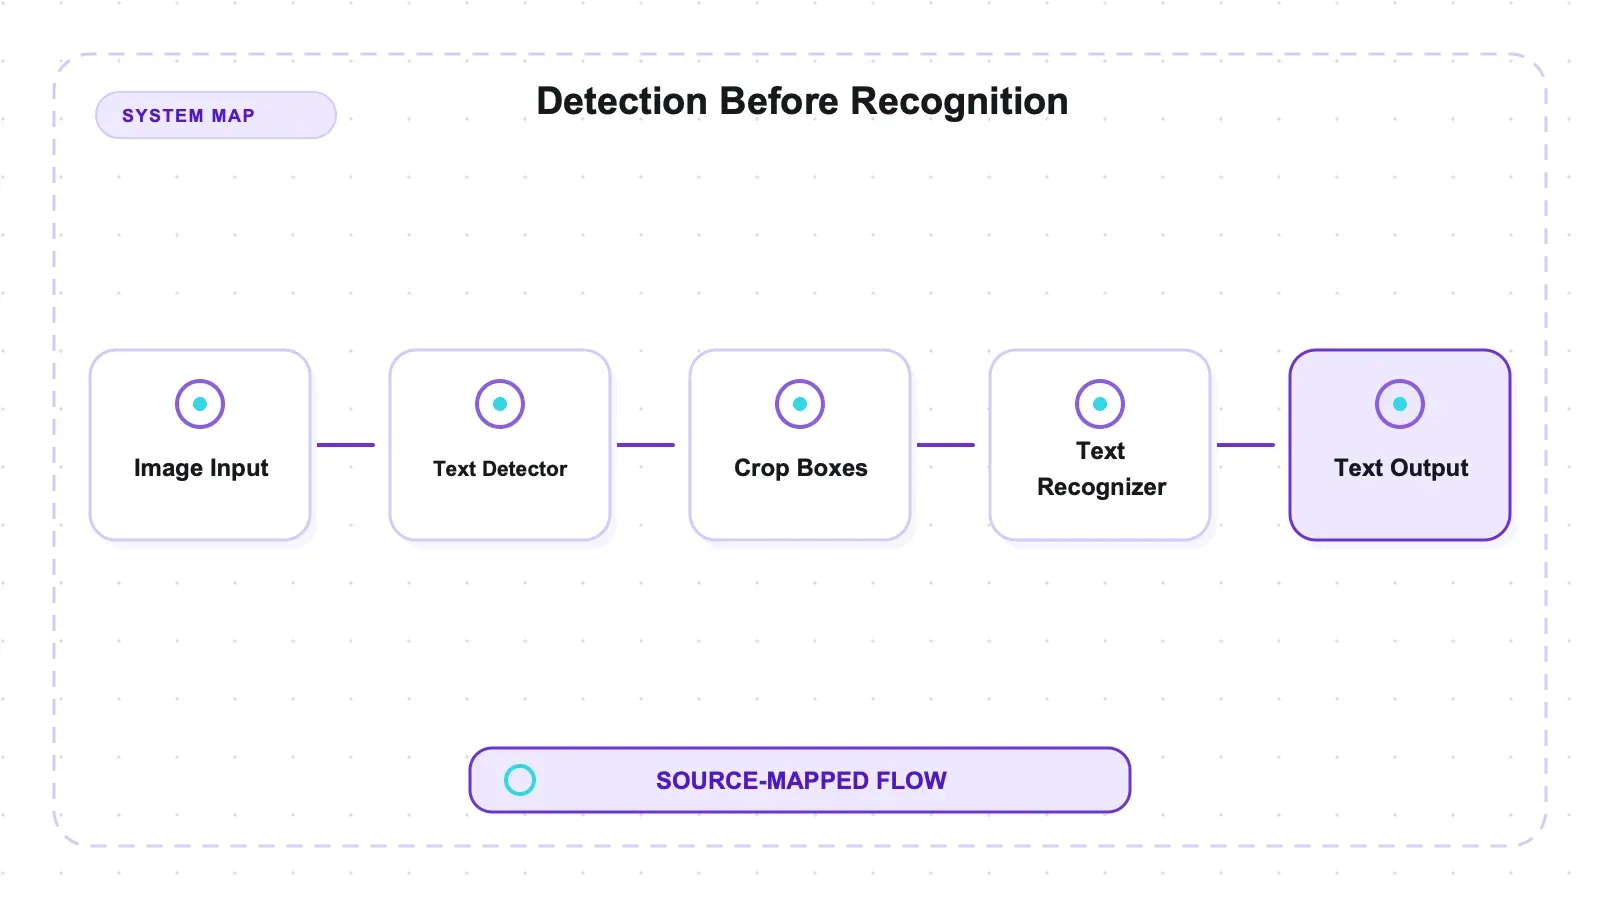
Hệ quả thực tế: EasyOCR có hai kiểu lỗi hoàn toàn khác nhau, và chúng cần hai cách xử lý khác nhau. Nếu bộ phát hiện không vẽ được khung nào, thì dù bạn có tinh chỉnh bộ nhận dạng đến đâu cũng vô ích — chữ đơn giản là chưa từng đi vào pipeline. Nếu khung đã có nhưng chuỗi trả về sai, đó là lỗi ở bước nhận dạng và tiền xử lý có thể cứu vãn. Gần như mọi thread kiểu “EasyOCR bỏ sót chữ của tôi” mà tôi đọc đều đang trộn lẫn hai việc này.
Trạng thái hiện tại của dự án, kiểm tra vào ngày 27/07/2026: 29,825 sao, 528 issue đang mở, Apache-2.0, và v1.7.2 từ tháng 9/2024, với lần push cuối lên master vào tháng 12/2025. Những mốc đó không chứng minh được sự ổn định kiến trúc hay sức khỏe bảo trì. Trước khi dùng, hãy kiểm tra khả năng tương thích với stack Python/PyTorch của bạn, phản hồi gần đây từ maintainer, và các issue liên quan trực tiếp đến kiểu dữ liệu đầu vào của bạn.
OCR thường bị gắn với việc giải CAPTCHA, nhưng đó không phải use case ở đây. Không có gì trong bài này được test để, hoặc ủng hộ, việc vượt qua các bài kiểm tra chống bot. Phạm vi ở đây chỉ là đọc chữ từ ảnh và ảnh chụp màn hình mà bạn có quyền đọc.
Tôi đã đo gì, và những con số này không bao trùm điều gì
Bộ test gồm 36 PNG do tôi tự render: 35 ảnh một dòng, quét qua bảy font, tám cỡ chữ, bảy mức tương phản, bảy góc nghiêng, ba hướng xoay trực giao, và ba nền khác nhau — cộng thêm một ảnh chụp dashboard tổng hợp có 19 thành phần được gắn nhãn riêng. Mỗi ảnh được tạo từ một chuỗi cố định (Sphinx of black quartz, judge my vow. 1234567890 — 48 ký tự, có cả chữ hoa/thường, chữ số và dấu câu) trong cùng một lượt viết nhãn ground truth, nên ảnh và nhãn của nó không thể tự lệch nhau theo thời gian.
Độ chính xác được đo bằng character error rate (CER): khoảng cách Levenshtein theo ký tự chia cho độ dài ground truth. CER 0 nghĩa là đọc hoàn hảo. CER 0.10 nghĩa là xấp xỉ một ký tự trên mười bị sai. Tôi báo CER phân biệt hoa/thường ở tiêu đề chính, và thêm phiên bản không phân biệt hoa/thường bên cạnh, vì hóa ra phần lớn “lỗi” nằm ở chuyện chữ hoa/thường.
Ranh giới của bài test quan trọng hơn bản thân các con số:
- Chỉ tiếng Anh. Dùng recognizer
english_g2. EasyOCR quảng bá hơn 80 ngôn ngữ; tôi chỉ test một ngôn ngữ. Không có gì ở đây nói lên khả năng với các hệ chữ không phải Latin, đúng như nơi mà các bài so sánh OCR học thuật thường tập trung. - Chỉ dữ liệu tổng hợp. Văn bản được render, không phải ảnh chụp. Không có nhiễu camera, không có artefact JPEG, không có ánh sáng thực tế, không có phối cảnh.
- Không có chữ viết tay. Bản thân dự án cũng ghi rõ chữ viết tay hiện chưa hỗ trợ.
- Chỉ CPU. macOS arm64,
gpu=False. Máy có MPS nhưng EasyOCR chỉ dùng CPU nếu không phải CUDA. Hiệu năng GPU không hề được đo, nên bài này không có con số GPU nào. - Một máy, một phiên bản. easyocr 1.7.2, torch 2.13.0, Python 3.12.
Tóm lại: đây là các đường cong đơn biến có kiểm soát, cho thấy chính xác điểm mà độ trung thực bắt đầu gãy trên văn bản Latin render sạch. Chúng không phải điểm số từ tập dữ liệu thực tế, và cũng không thay thế cho nó.
Các bằng chứng có thể kiểm tra chứ không bị nhốt trong notebook. Bộ tạo fixture và chuỗi chính xác nằm ở tests/build_fixtures.py và tests/fixtures/ground_truth.json; phần nhận dạng, đo thời gian và thu tài nguyên nằm ở tests/run_easyocr.py; còn tests/metrics.py tính các tỷ lệ lỗi từ đầu ra thô. Các bản ghi nhận dạng và chỉ số tổng hợp được lưu tại artifacts/raw/. Chạy lại chuỗi đó rất hữu ích để kiểm tra đúng máy và đúng phiên bản này. Nhưng nó vẫn không nói được EasyOCR sẽ hoạt động ra sao trên ảnh chụp điện thoại, ngôn ngữ, bố cục hay pipeline tiền xử lý của bạn, nên việc đưa vào sản xuất cần thêm các input đại diện thay vì coi bộ fixture này là một bộ chứng nhận.
Có một bẫy đáng lưu ý trong harness, vì nó suýt tạo ra một con số tiêu đề sai. Lần tính metrics đầu tiên của tôi báo CER 0.375 trên Arial đen nền trắng sạch — quá tệ đối với input dễ nhất có thể. Nhưng lỗi không nằm ở EasyOCR. Bộ phát hiện đã tách một dòng nhìn thấy thành một box từ ngữ và một box số, còn cách tôi ghép ngây thơ theo thứ tự y rồi x đã khiến phần số đứng trước. Sau khi sửa bằng nhóm theo dòng (gom box theo vùng chồng lấn theo chiều dọc, rồi đọc từ trái sang phải), font sạch rơi về khoảng 0.04–0.10. Nếu bạn tự xây benchmark OCR, bẫy này cũng đang chờ bạn.
Thiết lập: cài đặt nhỏ, nhưng phụ thuộc thì không
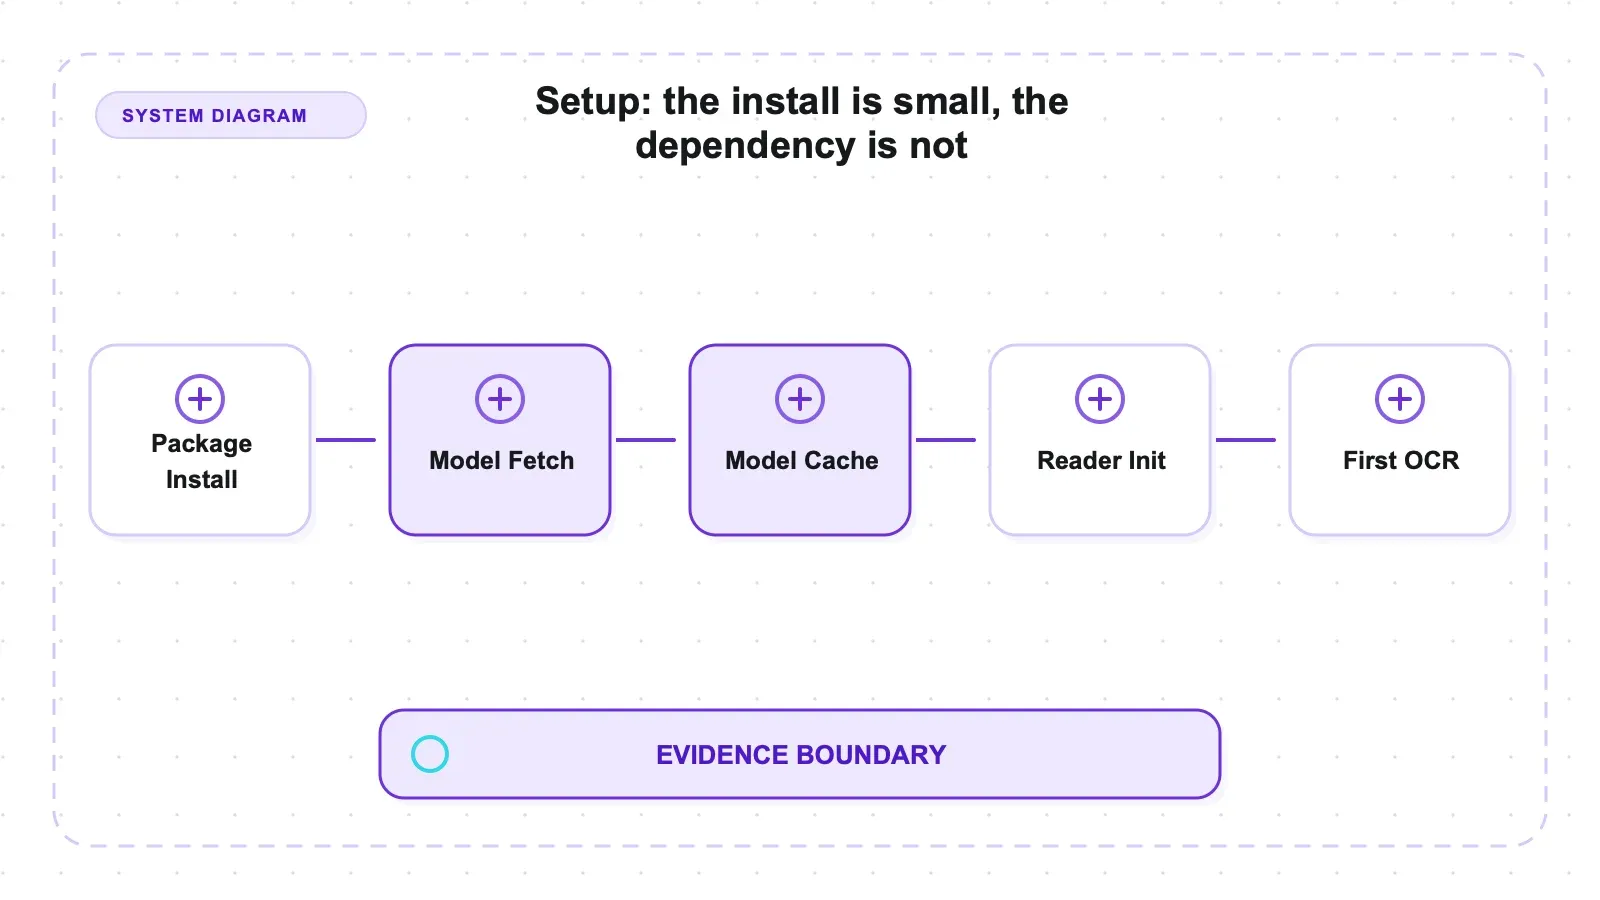
pip install easyocr
Chỉ vậy thôi, và nó chỉ “thành thật” ở mức rất ít. Bản thân package thì nhỏ; thứ nó kéo theo là PyTorch, khoảng 2 GB. Sau đó, lần đầu bạn gọi readtext(), EasyOCR sẽ âm thầm tải trọng số về ~/.EasyOCR/model/ — tổng 93.7 MiB, gồm 79.30 MiB cho bộ phát hiện CRAFT (craft_mlt_25k.pth) và 14.44 MiB cho bộ nhận dạng tiếng Anh (english_g2.pth).
Các tutorial hầu như không nhắc đến điều này, nên nhớ rằng: lần chạy đầu tiên của bạn cần có mạng và sẽ phải chờ tải xuống; còn mọi triển khai dạng container hoặc là phải đóng gói sẵn trọng số vào image, hoặc sẽ phải chịu thời gian tải ở cold start. Khi đã cache rồi thì mọi thứ hoạt động offline.
Khởi tạo lạnh Reader() — đưa model từ đĩa vào RAM, cộng thêm bước lượng tử int8 — mất 1.3–1.7 giây qua các lần chạy. Sau đó:
import easyocr
reader = easyocr.Reader(['en'], gpu=False)
result = reader.readtext('screenshot.png')
Và nó hoạt động. Hai dòng, không cần cấu hình, không cần đi tìm checkpoint. Chữ “easy” trong tên đúng là được trả công ở đoạn này — độ cồng kềnh nằm ở phần phụ thuộc, không nằm ở API.
Ngưỡng với văn bản sạch: gần như hoàn hảo về ký tự, nhưng chưa hoàn hảo về hoa/thường
Bảy font hệ thống, chữ đen trên nền trắng, cỡ 32 px, cùng một chuỗi mỗi lần:
| Font | CER (phân biệt hoa/thường) | CER (không phân biệt hoa/thường) |
|---|---|---|
| Georgia | 0.0625 | 0.0000 |
| Times | 0.0417 | 0.0417 |
| Comic Sans | 0.0417 | 0.0208 |
| Arial | 0.0833 | 0.0208 |
| Verdana | 0.0833 | 0.0208 |
| Impact | 0.0833 | 0.0208 |
| Courier | 0.1042 | 0.0417 |
| Trung bình | 0.0714 | 0.0238 |
CER trung bình 0.071, và giảm xuống 0.024 khi chuẩn hóa hoa/thường. Đó mới là phát hiện chính. EasyOCR không đánh rơi ký tự trên văn bản Latin sạch — nó nhận đúng hình dạng nhưng hay sai chữ hoa/thường.
Cụ thể, từ viết thường vow được nó render thành VOW ở 6/7 font (Comic Sans “nhẹ tay” hơn với Vow). Impact còn thêm lỗi of → Of cho đủ bộ. Lỗi lặp lại khác là dấu câu: dấu chấm cuối câu quay về thành : hoặc _ ở vài font. Georgia là một lần đọc hoàn hảo nếu bạn không còn bận tâm đến hoa/thường.
Đó là một dạng lỗi rất đáng hiểu. Nếu bước sau của bạn là fuzzy matching, tìm kiếm theo từ khóa, hoặc đưa text vào mô hình ngôn ngữ, thì việc đổi hoa/thường gần như chẳng ảnh hưởng gì. Nhưng nếu bước sau là so khớp chính xác với một khóa cơ sở dữ liệu, thì nó phá hỏng tất cả. Chuẩn hóa case trước khi so sánh, và một nửa tỷ lệ lỗi bề ngoài của EasyOCR sẽ biến mất.
Courier là tệ nhất (0.1042) cũng hợp lý: font monospace tạo khoảng cách ký tự bất thường rộng hơn, khó hơn cho bộ giải mã CTC vốn đã học theo khoảng cách chữ điển hình.
Vách đá theo kích thước nằm đúng nơi tài liệu nói
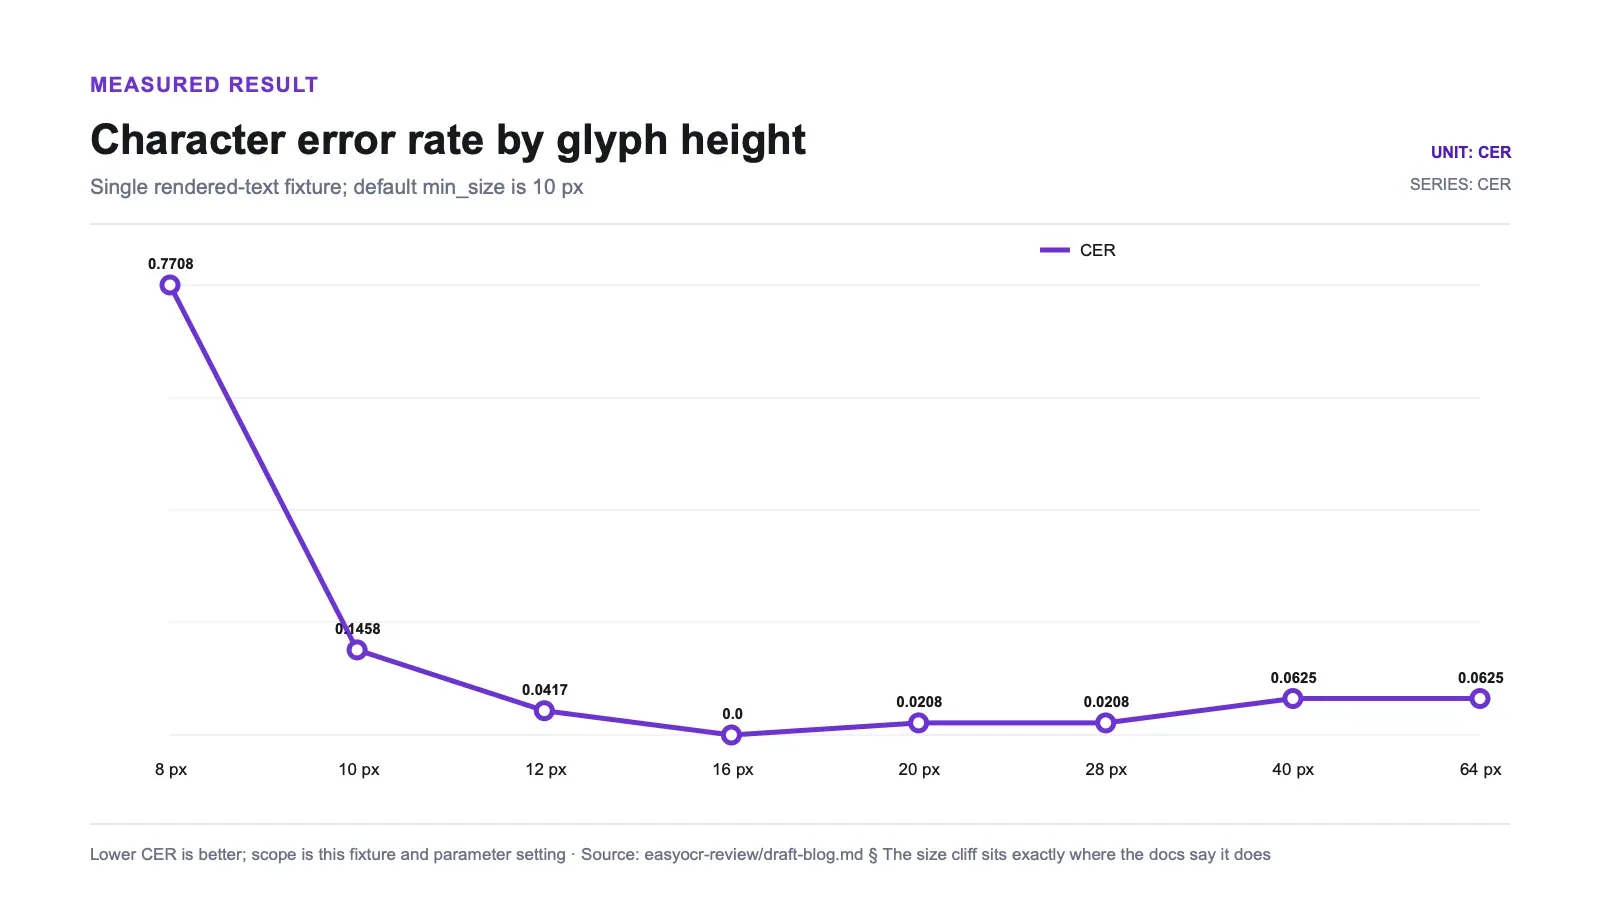
readtext() có một tham số được ghi rõ, min_size=10, dùng để loại bỏ các khung phát hiện có chiều cao dưới 10 pixel. Nhiều người lướt qua nó. Nhưng đây lại là con số có tác động lớn nhất trong API đối với ai đang trích xuất ảnh chụp màn hình hoặc PDF, và đây là điều nó làm khi bạn quét theo chiều cao glyph render:
| Kích thước render (px) | CER | Chuyện gì đã xảy ra |
|---|---|---|
| 8 | 0.7708 | Sụp đổ — các box rơi dưới bộ lọc min_size và bị loại; chỉ còn mảnh vụn |
| 10 | 0.1458 | Suy giảm — ngay tại ngưỡng, bộ phát hiện tách dòng thành 3 box |
| 12 | 0.0417 | Hồi phục |
| 16 | 0.0000 | Đọc hoàn hảo |
| 20 | 0.0208 | Sạch |
| 28 | 0.0208 | Sạch |
| 40 | 0.0625 | Sạch (lỗi đổi hoa/thường quay lại) |
| 64 | 0.0625 | Sạch (đổi hoa/thường) |
Cú nhảy từ 0.04 lên 0.77 giữa 12 px và 8 px không phải là suy giảm từ từ. Đó là một bộ lọc đang làm chính xác điều nó được mô tả, và kết quả là chữ dưới khoảng 10 px gần như vô hình đối với EasyOCR mặc định.
Điểm ngọt nằm ở 12–28 px, với CER hoàn hảo bằng 0 ở 16 px. Trên 40 px, CER lại nhích lên — không phải vì ký tự khó đọc hơn, mà vì lỗi vow → VOW quay trở lại. Chữ to không khó đọc hơn; chỉ là nó không còn hưởng lợi từ khoảng cách giúp 16 px khớp hoàn hảo nữa.
Với ai trích xuất chữ từ ảnh chụp màn hình: hãy kiểm tra chiều cao glyph trước khi đổ lỗi cho mô hình. Một dashboard chụp ở tỷ lệ 1× trên màn HiDPI, hoặc một trang PDF rasterize ở 72 DPI, rất thường đặt body text dưới 10 px. Chụp ở 2× hoặc upscale trước khi OCR, và bạn sẽ bỏ qua cả một họ bug kiểu “EasyOCR bỏ qua nửa trang của tôi”. Nếu không thể làm vậy, hãy giảm min_size — nhưng hãy kỳ vọng thêm nhiễu, vì bộ lọc tồn tại để chặn phát hiện rác.
Xoay: dung sai 10°, và một cách sửa không đối xứng
Bắt đầu với skew. Góc nhỏ, Arial 32 px, cài đặt mặc định so với rotation_info=[90,180,270]:
| Góc nghiêng | CER (mặc định) | CER (với rotation_info) |
|---|---|---|
| 0° | 0.0833 | 0.0833 |
| 5° | 0.0417 | 0.0417 |
| 10° | 0.0208 | 0.0833 |
| 15° | 0.2917 | 0.3750 |
| 20° | 0.7500 | 0.7708 |
| 30° | 0.8958 | 0.8750 |
| 45° | 0.8958 | 0.8750 |
EasyOCR mặc định xử lý skew tới khoảng 10° khá nhẹ nhàng (CER ≤ 0.083), bắt đầu chao đảo ở 15°, và gần như hỏng ở 20°. rotation_info không giúp gì cho skew, điều này hợp lý khi bạn hiểu nó làm gì — nó chỉ thử lại ở các góc bạn liệt kê, còn skew 15° thì không phải 90, 180 hay 270. Ở 10° nó còn làm tệ hơn một chút (0.021 → 0.083), vì một lần thử ở góc sai có thể thắng phiếu tự tin.
Các phép xoay trực giao thì mới kỳ lạ:
| Xoay | CER (mặc định) | CER (với rotation_info) | Khôi phục? |
|---|---|---|---|
| 90° | 0.8125 | 0.9167 | Không — tệ hơn |
| 180° | 0.8542 | 0.6667 | Một phần |
| 270° | 0.8333 | 0.1042 | Có |
Cùng một tham số. Cùng một danh sách góc. Ba kết quả khác nhau.
Ở 270°, rotation_info làm đúng điều thread issue này hứa: CER rơi từ 0.83 xuống 0.10, tức là đọc được thật sự. Ở 180°, nó chỉ hoạt động một nửa — CER tốt hơn còn 0.67, nhưng cụm my vow. biến mất hẳn. Còn ở 90°, nó đi ngược lại, từ 0.81 lên 0.92, và đầu ra thô giải thích tại sao: bộ nhận dạng trả về chuỗi bị lật gương. VOW quay về thành MOA. quartz quay về thành zuuenb. Đọc các chuỗi đó trong gương thì đúng, một mẹo vui trong tiệc tùng nhưng vô dụng trong pipeline dữ liệu.
Tôi đã kiểm tra điều này trên các dự đoán thô thay vì chỉ nhìn vào metrics tổng hợp, vì “thứ tự join làm lệch nó” là nghi ngờ đầu tiên của tôi. Nhưng không phải lỗi ghép nối — đó chính là thứ EasyOCR thực sự trả về.
Cơ chế là một giả thuyết, không phải một phép đo; tôi không chạy thí nghiệm về quy ước xoay. Pillow render góc dương theo chiều ngược kim đồng hồ, nên chỉ ảnh render ở 270° mới tình cờ khớp với một hướng retry mà bộ nhận dạng xử lý tốt, còn case 90° thì retry có điểm số tốt nhất lại rơi vào hướng bị lật. Dù cơ chế là gì, bài học vận hành không phụ thuộc vào nó:
Bộ fixture này cho thấy không thể giả định rotation_info sẽ hoạt động đối xứng giữa các hướng. Hãy kiểm tra những góc xoay thực sự có trong input của bạn; chuẩn hóa hướng ở tầng trước là một hướng giảm thiểu rủi ro, chứ không phải điều kiện đã được ba ví dụ render xác lập.
Dự đoán mà tôi đã đoán sai
Ban đầu tôi tưởng tương phản thấp sẽ là điểm yếu mềm của EasyOCR. Chữ xám nhạt trên nền trắng là câu chuyện thất bại OCR kinh điển, và dự án còn có một đường cứu vãn rất rõ: contrast_ths=0.1 cùng adjust_contrast=0.5, để chạy lại các box tương phản thấp với bản tăng cường sáng tối và giữ kết quả có độ tự tin cao hơn.
Nhưng nó chưa bao giờ kích hoạt, vì đơn giản là không cần.
| Màu xám tiền cảnh | Tương phản Weber | CER (mặc định) | CER (với adjust_contrast=1.0) |
|---|---|---|---|
| 0 (đen) | 1.000 | 0.0833 | 0.0833 |
| 64 | 0.749 | 0.0833 | 0.0833 |
| 110 | 0.569 | 0.0833 | 0.0833 |
| 150 | 0.412 | 0.1042 | 0.1042 |
| 180 | 0.294 | 0.0625 | 0.0625 |
| 200 | 0.216 | 0.0417 | 0.0417 |
| 220 | 0.137 | 0.0417 | 0.0417 |
CER không bao giờ rời khỏi dải sạch, ngay cả xuống tới Weber 0.14 — mức gray-220 trên nền trắng, mờ đến mức tôi phải nheo mắt nhìn fixture mới xác nhận được rằng chữ đúng là có đó. Và cột tăng cường tương phản giống hệt cột mặc định ở mọi bước, vì mặc định đã thành công từ đầu.
Các nền cũng kể cùng một câu chuyện. Chữ đen xuyên suốt:
| Nền | CER |
|---|---|
| Mảng xanh lam nhạt đồng nhất | 0.083 |
| Gradient dọc | 0.021 |
| Nhiễu Gaussian (μ200, σ22) | 0.000 |
Đọc hoàn hảo ngay trên fixture nhiễu nhất của bộ test.
Phạm vi ở đây hẹp: đây là tương phản thấp kiểu màu phẳng, không nhiễu, chứ không phải một hóa đơn chụp ảnh có nhiễu cảm biến và nén JPEG. Trong bộ fixture này, hình học và các token ngắn là nguyên nhân gây lỗi lớn nhất; các biến thể màu và nhiễu tổng hợp đã test thì không.
Một tình huống thực tế: kéo số liệu từ ảnh chụp dashboard
Đây mới là kiểu việc OCR Python thường gặp nhất. Có người gửi một ảnh chụp dashboard nội bộ, hoặc bạn đang chạy một pipeline scraping bằng Python trên một trang analytics nhiều biểu đồ, nơi các con số chỉ tồn tại dưới dạng pixel đã render, và bạn muốn chuyển chúng thành dữ liệu.
Tôi đã render một cửa sổ “Sales Dashboard” — header tối với tiêu đề và một huy hiệu avatar tròn, ba bảng KPI, ba nút bấm, một bảng 2×3 — rồi gắn nhãn toàn bộ 19 phần tử văn bản bằng chuỗi chính xác và box pixel của chúng, sau đó khớp đầu ra của EasyOCR với các box bằng vùng chồng lấp.
Recall của phát hiện: 16/19. Ba phần bị bỏ sót:
- huy hiệu một ký tự "A"
- ô bảng "Q1"
- ô bảng "Q2"
Còn "Q3" thì vẫn được phát hiện. Cùng font, cùng cỡ, cùng cột — bộ phát hiện giữ một token hai ký tự nhưng lại bỏ hai token khác. Việc phát hiện không nhất quán ngay cả giữa các ô trông rất giống nhau. Vì các đầu ra trong các lần chạy này là xác định, đây không phải bằng chứng cho hành vi “ném đồng xu” ngẫu nhiên. Một vấn đề chất lượng ảnh chụp liên quan đã được theo dõi tại #460.
Ở 16 phần tử mà nó tìm thấy, chữ gần như hoàn hảo: CER trung bình 0.027, trong đó 13/16 khớp hoàn toàn. Tiêu đề, nhãn, nút bấm (“Save”, “Cancel”, “Export CSV”), tiêu đề cột, và các con số có dấu phẩy đều về CER 0. 1,284 được đọc đúng, cả dấu phẩy cũng vậy.
Ba lần đọc chưa hoàn hảo đều là cùng một lỗi. Các giá trị tiền tệ:
| Ground truth | EasyOCR đọc |
|---|---|
$57,912 | S57,912 |
$18,330 | S18,330 |
$25,178 | S25,178 |
$12,004 | $12,004 (đúng) |
Ba trên bốn dấu $ bị đổi thành chữ S viết hoa. Nhìn bằng mắt thì cũng có lý — nhưng điều đó có nghĩa mọi trường tiền tệ trong dữ liệu bạn trích xuất chỉ cách rác một ký tự, và một float() ngây thơ sẽ lỗi với tất cả chúng.
Nếu pipeline ảnh chụp màn hình của bạn có nhãn ngắn hoặc trường tiền tệ, hãy kiểm tra các biện pháp giảm thiểu như upscale, crop có padding, ràng buộc kỳ vọng trường dữ liệu, hoặc hậu xử lý nhận biết ký hiệu. Ở đây tôi chưa benchmark cách nào trong số đó, và một regex thay S đầu dòng có thể phá vỡ cả giá trị hợp lệ. Chỉ áp dụng sửa lỗi ở nơi mà schema và quy tắc kiểm tra khiến nó an toàn.
Chi phí để chạy
Các con số trên cùng một máy (macOS arm64, CPU, một host, đo trong lúc có thể có tải đồng thời — hãy xem chúng như hình dạng xu hướng, không phải benchmark phổ quát):
| Chỉ số | Giá trị |
|---|---|
| Trọng số model trên đĩa | 93.7 MiB (79.30 detector + 14.44 recognizer) |
| Peak resident memory, tiến trình CPU mới | 984.5 MiB |
Khởi tạo lạnh Reader() | 1.3–1.7 s |
| Độ trễ warm, một dòng sạch 48 ký tự (p50) | ~0.062 s (p25–p75: 0.059–0.067 s, n=20) |
detail=0 so với detail=1 | gần như bằng nhau (median 0.062 vs 0.063 s) |
Chi phí lớn nhất không phải 94 MB trọng số — mà là khoảng 1 GB bộ nhớ resident cho mỗi worker process, cộng thêm khoảng 2 GB cài đặt torch. Đó là con số quyết định việc nó có vừa trong container của bạn hay không, và cũng là con số mà hầu như chẳng ai nói ra.
Tốc độ thì ổn cho case dễ. Warm dưới 0.1 giây với một dòng sạch trên CPU là hoàn toàn dùng được. Nhưng đó là case dễ: một dòng ngắn, tương phản cao. Những lời phàn nàn lặp đi lặp lại kiểu “EasyOCR mất hàng chục giây trên CPU” là về các tài liệu lớn nhiều vùng ở toàn bộ kích thước canvas, và tôi không tái hiện lại điều đó — workload khác nhau, và tôi chỉ đang dẫn lại nó chứ không khẳng định.
Một hiểu lầm nhỏ cần dập tắt: detail=0 không làm EasyOCR nhanh hơn. Nó chỉ bỏ bounding box và confidence score khỏi giá trị trả về. Phần tính toán đã xong rồi. Median chỉ lệch nhau một mili-giây, tức là nhiễu.
Ưu và nhược điểm
Ưu điểm
- Độ nhớ ký tự trên văn bản Latin render sạch gần như hoàn hảo — CER trung bình 0.071 nếu phân biệt hoa/thường, 0.024 nếu không phân biệt, và có thể đạt CER 0 hoàn toàn ở 16 px.
- API thật sự chỉ hai dòng:
Reader(['en'])rồireadtext(), không cần cấu hình, không cần chọn model. - Chống tương phản tốt hơn nhiều so với cách người ta thường đồn: không sụp xuống ở Weber 0.14 với văn bản sạch, và nền nhiễu/gradient/màu không làm nó giảm chất lượng (fixture nhiễu Gaussian cho kết quả hoàn hảo).
- Gần như hoàn hảo với các phần tử screenshot mà nó phát hiện được: CER trung bình 0.027, 13/16 khớp hoàn toàn, kể cả số có dấu phẩy.
- Có tính xác định. Mọi con số độ chính xác ở đây đều giống hệt nhau giữa hai lần chạy process độc lập hoàn toàn; chỉ thời gian là thay đổi.
- Apache-2.0 và tự host, không có phí sử dụng từ vendor; chi phí thực tế nằm ở compute, bộ nhớ, storage và queueing.
Nhược điểm
- Sụp mạnh dưới ngưỡng
min_size=10như tài liệu nêu — CER 0.77 ở 8 px. Chữ UI nhỏ coi như biến mất theo mặc định. - Dung sai skew dừng ở khoảng 10° và sụp ở 20°.
rotation_infokhông phải là một cách sửa đối xứng: 270° cứu được, 180° chỉ cứu một phần, còn 90° tệ hơn và trả về chữ bị lật gương.- Bộ phát hiện bỏ rơi các token ngắn đơn lẻ — một badge một ký tự và hai ô 2 ký tự, trong khi lại giữ một ô khác có cùng định dạng.
- Nhầm hệ thống
$thànhSở các giá trị tiền tệ (3/4). - Khoảng 1 GB resident memory cho mỗi process, cộng với khoảng 2 GB phụ thuộc torch.
- Bản release mới nhất là từ tháng 9/2024; dự án thiên về ổn định hơn là đang thay đổi mạnh.
Ai nên dùng, và ai nên tránh
Hãy cân nhắc EasyOCR khi input của bạn sạch, thẳng, là văn bản render ở kích thước hợp lý — ảnh chụp màn hình, ảnh giao diện, PDF rasterize, hoặc báo cáo được tạo sẵn — và bạn muốn một pipeline Python tự host không mất phí sử dụng từ vendor. Kết quả CPU tiếng Anh tổng hợp ở đây áp dụng cho đúng phân khúc đó; ảnh chụp, chữ viết tay và các hệ chữ khác cần được test riêng.
Hãy tránh nếu input của bạn rơi vào các trường hợp này. Ảnh chụp thực tế — các số liệu của tôi là văn bản render tổng hợp và không nói gì về nhiễu camera, phối cảnh hay ánh sáng. Chữ viết tay — chính dự án cũng không hứa hỗ trợ. Hệ chữ không phải Latin — EasyOCR hỗ trợ hơn 80 ngôn ngữ, nhưng tôi chỉ test một ngôn ngữ, và các so sánh học thuật công khai mới là tham chiếu ở đây, không phải quét tổng hợp tiếng Anh. Input xoay ngẫu nhiên — trừ khi bạn tự sửa hướng trước. Triển khai thiếu bộ nhớ — một GB cho mỗi worker sẽ cộng dồn rất nhanh.
Trước khi chọn OCR, hãy kiểm tra DOM và phản hồi network. Nếu giá trị bạn cần đã tồn tại dưới dạng text có cấu trúc, thì trích xuất từ nguồn đó sẽ tránh được lỗi phát hiện và nhận dạng của OCR. OCR chỉ nên dùng khi pixel là biểu diễn duy nhất có sẵn.
Các lựa chọn thay thế, và vị trí của stack này
EasyOCR dùng Apache-2.0 và tự host, không có phí sử dụng từ vendor nhưng vẫn có chi phí compute và vận hành thực tế. PaddleOCR, Tesseract, và các mô hình vision-language đã không được chạy qua bộ benchmark này, nên không có kết luận đối đầu trực tiếp nào được đưa ra.
So sánh thú vị hơn không phải OCR với OCR. Mà là liệu bạn có nên dùng OCR hay không.
Phần lớn công việc trích xuất từ screenshot mà tôi thấy thực chất là một cách vòng vì trang web khó scrape — bảng render bằng JavaScript, dashboard bị khóa sau đăng nhập, một site chống lại bạn. Chụp ảnh màn hình rồi OCR nghe có vẻ là con đường ít ma sát nhất, nhưng bạn đang ném đi text có cấu trúc vốn rất tốt, rồi lại trả “thuế dấu đô la” để lấy về một phiên bản tệ hơn của nó.
Ghi chú của tác giả: Thunderbit là lựa chọn được quản lý của chúng tôi để trích xuất từ trang web. Nó chưa được chạy qua các fixture ảnh này. Ranh giới liên quan là dạng biểu diễn nguồn: dùng trích xuất từ DOM/network khi dữ liệu web có cấu trúc tồn tại, và chỉ đánh giá OCR khi pixel là nguồn duy nhất.
Bài đọc liên quan từ cùng bộ test bench: so sánh đầy đủ các scraper mã nguồn mở, đánh giá Crawl4AI, và một cái nhìn rộng hơn về trích xuất dựa trên AI cho các trang chống lại selector.
Thử Thunderbit để trích xuất dữ liệu web
Kết luận
Có nên dùng EasyOCR không? Có, nếu ảnh của bạn thẳng, glyph cao ít nhất 12 pixel, và bạn đang đọc chữ Latin. Trong các điều kiện đó, nó làm rất tốt — CER trung bình 0.071 trên văn bản sạch, 0.024 sau khi chuẩn hóa case, đọc hoàn hảo ở 16 px, và khả năng chịu tương phản tốt hơn tiếng đồn. API thực sự chỉ hai dòng, và đầu ra mang tính xác định, điều này quan trọng hơn nhiều người thừa nhận khi bạn đang debug một pipeline.
Ra ngoài những điều kiện đó, nó thất bại theo những cách cụ thể và có thể học được. Chữ dưới 10 px biến mất vào bộ lọc min_size. Skew quá 20° làm hỏng kết quả đọc. rotation_info sửa được một hướng xoay trực giao, sửa nửa vời một hướng khác, và làm hướng thứ ba tệ hơn với chữ bị lật gương. Chữ một ký tự và token hai ký tự rơi ra khỏi bộ phát hiện trong khi hàng xóm vẫn sống sót. Dấu đô la biến thành chữ S.
Các lỗi của fixture đến từ cả hai giai đoạn: box bị bỏ sót hoặc sai hướng ở phía hình học, và nhầm dấu đô la ở phía nhận dạng. Hãy xem upscale, chuẩn hóa hướng, crop có padding, và sửa ký hiệu dựa trên schema như các giả thuyết cần kiểm tra, chứ không phải các cách sửa an toàn trong mọi trường hợp.
Chỉ đừng test nó theo kiểu tôi suýt làm, với một harness đánh giá bị hỏng và một con số mà bạn không hiểu. Hãy tự render fixture của bạn, biết chính xác ground truth, và tự tìm ra “vách đá” của mình.
Thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
EasyOCR có đủ chính xác cho trích xuất text từ ảnh chụp màn hình trong môi trường sản xuất không?
Trên dashboard tổng hợp, các phần tử được khớp có CER trung bình 0.027 và 13/16 khớp hoàn toàn. Ba trong số 19 phần tử không được phát hiện, và 3 trên 4 dấu đô la biến thành S. Điều đó có chấp nhận được hay không — và liệu upscale hay sửa theo schema có giúp được không — phải được test trên đúng bố cục mục tiêu.
Cỡ font tối thiểu mà EasyOCR có thể đọc là bao nhiêu?
Thực tế, khoảng 12 pixel chiều cao glyph render. Tham số readtext() min_size=10 loại bỏ các box phát hiện thấp hơn 10 px, và hiệu ứng là một “vách đá” chứ không phải một đường dốc: CER là 0.77 ở 8 px, 0.15 ở 10 px, 0.04 ở 12 px, và 0 ở 16 px. Dải sạch trong sweep của tôi là 12–28 px. Nếu nguồn của bạn là screenshot HiDPI chụp ở 1× hoặc PDF rasterize ở 72 DPI, hãy upscale trước OCR thay vì hạ min_size, vì bộ lọc đó tồn tại để chặn các phát hiện rác.
rotation_info có sửa được ảnh bị xoay trong EasyOCR không?
Không đáng tin cậy, và cũng không đối xứng. Với rotation_info=[90,180,270] trên ba bản sao xoay trực giao của cùng một câu, ảnh 270° được phục hồi sạch (CER 0.83 → 0.10), ảnh 180° chỉ phục hồi một phần (0.85 → 0.67, và mất một cụm từ), còn ảnh 90° thì tệ hơn (0.81 → 0.92) trong khi trả về chữ bị lật gương như VOW → MOA. Nó cũng không giúp gì cho các góc skew nhỏ, vì nó chỉ thử lại đúng các góc bạn liệt kê. Hãy chỉnh đúng hướng trước khi gọi EasyOCR thay vì dựa vào tham số này.
EasyOCR cần bao nhiêu bộ nhớ và dung lượng đĩa?
Trọng số là 93.7 MiB, tải về ~/.EasyOCR/model/ ở lần dùng đầu tiên — 79.30 MiB cho detector và 14.44 MiB cho recognizer tiếng Anh. Peak resident memory trong tiến trình CPU mới được đo là 984.5 MiB, cộng thêm khoảng 2 GB cài đặt torch. Khởi tạo lạnh reader mất 1.3–1.7 giây; sau đó một dòng sạch chạy với p50 khoảng 0.062 giây trên máy này. detail=0 chỉ đổi hình dạng giá trị trả về, không làm runtime đo được thay đổi.
EasyOCR có miễn phí cho mục đích thương mại không, và nó còn được bảo trì không?
Nó dùng giấy phép Apache-2.0, tức là khá thoáng và thân thiện với thương mại. Tính đến 27/07/2026, repository có 29,825 sao với 528 issue đang mở, bản release mới nhất là v1.7.2 từ tháng 9/2024, và lần push cuối lên master là tháng 12/2025. Hãy hiểu đó là ổn định hơn là bị bỏ rơi — kiến trúc đã ít thay đổi một thời gian và hoạt động chủ yếu chuyển sang issue tracker. Trước khi xây dựng trên đó, hãy tự xác nhận license và trạng thái release hiện tại.




