
Cứ vài tháng lại có ai đó trên Reddit lại đăng một lời than quen thuộc: "Tôi scrape Yellow Pages được 500 dòng số điện thoại và địa chỉ… nhưng không kiếm ra nổi một email." Đây là nỗi bực mình rất phổ biến trong cộng đồng lead generation, và sau nhiều năm xây dựng các công cụ tự động hóa tại Thunderbit, tôi có thể nói chắc rằng vấn đề này nằm ở cấu trúc dữ liệu, chứ không phải xui rủi.
Phần lớn các công cụ scrape Yellow Pages chỉ lấy những gì hiện ra ngay trên trang kết quả tìm kiếm — tên doanh nghiệp, số điện thoại, địa chỉ, có thể thêm một link website. Nhưng email thì sao? Gần như không bao giờ xuất hiện trên thẻ niêm yết. Chúng thường bị giấu trong trang hồ sơ chi tiết của từng doanh nghiệp, hoặc thậm chí không có trên Yellow Pages.
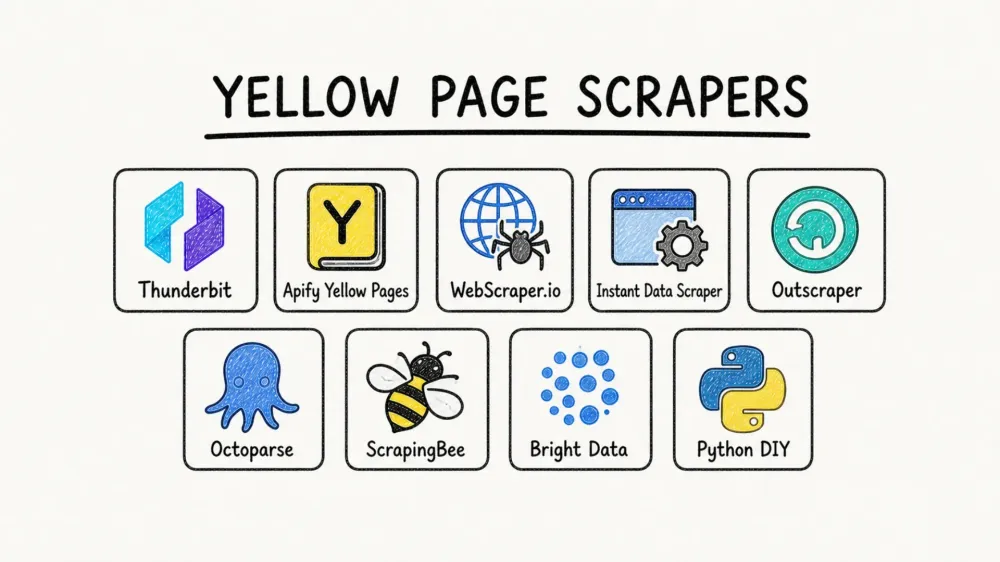
Vì vậy, nếu scraper của bạn không đi vào các trang con này, bạn đang bỏ lỡ nguồn dữ liệu liên hệ giá trị nhất. Bài viết này sẽ tổng hợp 9 công cụ mà tôi đã nghiên cứu và đánh giá, tập trung vào việc chúng có thực sự lấy được email từ Yellow Pages hay không — chứ không chỉ là số điện thoại và mã bưu chính. Tôi cũng sẽ đề cập đến khả năng chống bot, giá cả và công cụ nào hợp nhất với từng nhóm người dùng.
Vì Sao Phần Lớn Scraper Yellow Pages Không Lấy Được Email
Trước khi đi vào từng công cụ, cần hiểu vì sao vấn đề này lại tồn tại ngay từ đầu.
Các trang niêm yết trên Yellow Pages được thiết kế xoay quanh số điện thoại, địa chỉ, giờ mở cửa và liên kết website. Email không phải là một trường dữ liệu tiêu chuẩn trên thẻ kết quả tìm kiếm. Tài liệu scraper hiện có và ví dụ trên trang đều xác nhận điều này: email thường không xuất hiện trên thẻ niêm yết mà phải tìm ở trang hồ sơ chi tiết của từng doanh nghiệp hoặc trên website riêng của họ.
ParseBird Yellow Pages Scraper của Apify hiếm khi nào minh bạch như vậy. Công cụ này tách riêng "listing mode" và "detail mode", đồng thời cho biết tỷ lệ lấy được email thường chỉ khoảng 15–25% ngay cả khi đã bật trích xuất từ trang chi tiết. Điều đó có nghĩa là, ngay cả trong kịch bản đẹp nhất, việc lấy email từ Yellow Pages cũng chỉ ở mức vừa phải — và đa số công cụ còn chẳng cố làm việc đó.
Có ba kiểu thất bại phổ biến:
- Scraper chỉ đọc trang kết quả tìm kiếm. Không vào trang con, không có email.
- Scraper có vào trang chi tiết nhưng không phân tích trường email. Vẫn không có email.
- Doanh nghiệp chưa từng đăng email trên Yellow Pages. Không có công cụ nào trích xuất được thứ không tồn tại.
Một số doanh nghiệp còn chuyển sang biểu mẫu liên hệ hoặc nút "Email Business" thay vì hiển thị địa chỉ email thô. Khi đó, scraper vẫn có thể chạy bình thường nhưng kết quả đầu ra vẫn chỉ là 95% số điện thoại và địa chỉ.
Kết luận: nếu email extraction là điều bạn cần, tính năng cốt lõi phải tìm là subpage scraping — khả năng truy cập từng trang chi tiết doanh nghiệp và lấy dữ liệu không nằm trên trang niêm yết chính.
Cần Tìm Gì Ở Một Scraper Yellow Pages Tốt Nhất
Tôi đã đánh giá cả 9 công cụ dựa trên bảy tiêu chí, và mỗi tiêu chí đều xuất phát từ những nỗi đau rất thật trong các chủ đề Reddit, forum về scraping và cộng đồng lead-gen.
Độ Tin Cậy Khi Trích Xuất Email
Đây chính là lý do bài viết này tồn tại. Công cụ có thực sự trả về địa chỉ email hay chỉ là tên và số điện thoại? Năng lực quan trọng nhất là subpage scraping — truy cập vào hồ sơ của từng doanh nghiệp để tìm email bị giấu khỏi thẻ niêm yết.
Khả Năng Chống Bot và Xử Lý Chặn
Yellow Pages sử dụng Cloudflare Bot Management, bao gồm yêu cầu render JavaScript, fingerprinting trình duyệt, giới hạn tốc độ truy cập và CAPTCHA. Một request thực tế tôi thử vào ngày 27/4/2026 đã bị trả về trang chặn của Cloudflare chỉ sau vài giây. Những công cụ không xử lý sẵn chuyện này sẽ khiến bạn chỉ nhìn vào trang lỗi.
Giá Cả và Gói Miễn Phí
Nhiều người dùng Reddit đặc biệt hỏi về "scraper miễn phí hoặc giá rẻ, càng tốt." Thực tế có sự phân hóa khá rõ giữa extension trình duyệt miễn phí, công cụ cloud có credit khởi đầu và các nền tảng enterprise với giá tùy chỉnh.
Hỗ Trợ Phân Trang
Yellow Pages hiển thị khoảng 30 kết quả mỗi trang, và những truy vấn rộng có thể trả về 500–2.000+ kết quả. Một scraper không hỗ trợ auto-pagination sẽ chỉ lấy được một phần nhỏ dữ liệu có sẵn.
Tùy Chọn Xuất Dữ Liệu
Đội sales cần đầu ra sẵn sàng đưa vào CRM: CSV, Excel, Google Sheets, Airtable. Một số công cụ chỉ xuất JSON hoặc HTML thô, nghĩa là bạn còn phải xử lý thêm trước khi dùng được dữ liệu.
Mức Độ Kỹ Thuật Cần Thiết
Người dùng rất đa dạng. Nhân viên sales và chủ agency muốn công cụ dùng trong hai cú nhấp. Developer thì cần API và sự linh hoạt của Python. Tôi đã chấm mỗi công cụ từ Mới bắt đầu đến Chuyên gia.
Chấm Điểm Lead và Làm Giàu Dữ Liệu
Như một người dùng Reddit từng nói, "dữ liệu thô mà không có scoring thì chỉ là một file spreadsheet." Những công cụ có thể gắn nhãn, phân loại hoặc enrich dữ liệu ngay trong lúc scrape sẽ tiết kiệm hàng giờ hậu xử lý.
Tổng Quan Nhanh Về Các Scraper Yellow Pages Tốt Nhất
Bảng so sánh đầy đủ của cả 9 công cụ nằm dưới đây. Giải thích nhanh ký hiệu: ✅ nghĩa là công cụ xử lý tốt ngay từ đầu, ⚠️ nghĩa là làm được nhưng cần cấu hình thêm hoặc có giới hạn, và ❌ nghĩa là công cụ không hỗ trợ sẵn.
| Công cụ | Loại | Gói miễn phí | Có email không? | Chống bot | Phân trang | Mức độ kỹ năng | Định dạng xuất | Phù hợp nhất cho |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Chrome ext. + cloud | ✅ (6 trang/tháng) | ✅ (subpage + email extractor) | ✅ Chuyển đổi cloud/browser | ✅ Tự động | Mới bắt đầu | Excel, CSV, JSON, Sheets, Airtable, Notion | Đội sales & vận hành không rành kỹ thuật |
| Apify YP Scraper | Cloud actor | ✅ ($5 credit) | ⚠️ 15–25% khi có trang chi tiết | ✅ Proxy pool | ✅ Tích hợp sẵn | Trung cấp | JSON, CSV, Excel, XML | Scraping quy mô lớn trên cloud |
| WebScraper.io | Chrome ext. + cloud | ✅ (miễn phí cho extension) | ⚠️ Cấu hình thủ công | ✅ Gói cloud | ✅ Dựa trên selector | Trung cấp | CSV, XLSX, JSON, Sheets | Người dùng thích scraper trực quan |
| Instant Data Scraper | Chrome ext. | ✅ Miễn phí hoàn toàn | ❌ Không ổn định | ❌ Không có | ⚠️ Thủ công | Mới bắt đầu | CSV, XLSX | Lấy nhanh một lần |
| Outscraper | API/Cloud | ✅ (500 doanh nghiệp) | ⚠️ Cần enrichment thêm | ✅ Quản lý sẵn | ✅ Tự động | Mới bắt đầu–Trung cấp | CSV, JSON, XLSX | Job scrape thư mục tiết kiệm chi phí |
| Octoparse | Desktop app + cloud | ✅ (10 task, 50K/tháng) | ⚠️ Dựa trên template | ✅ Tích hợp sẵn | ✅ Tự nhận diện | Trung cấp | CSV, Excel, JSON, DBs | Scraping trực quan trên desktop |
| ScrapingBee | API | ✅ (1,000 calls) | ❌ Chỉ HTML thô | ✅ Quản lý sẵn | ❌ Thủ công | Nâng cao | JSON, HTML | Developer cần HTML đã render |
| Bright Data | Nền tảng | ✅ (5K records/tháng) | ✅ Data products | ✅ Chuẩn enterprise | ✅ Tích hợp sẵn | Nâng cao | JSON, CSV, NDJSON, S3, more | Quy mô enterprise |
| Python DIY | Code | ✅ Miễn phí (OSS) | ⚠️ Phân tích thủ công | ❌ Tự quản lý | ❌ Thủ công | Chuyên gia | Bất kỳ | Kỹ sư có nhu cầu tùy biến |
1. Thunderbit — Scraper Yellow Pages Tốt Nhất Cho Đội Không Chuyên Kỹ Thuật

Dùng thử Thunderbit để scrape Yellow Pages
Thunderbit là một tiện ích Chrome có AI mà đội tôi xây dựng để giúp người không phải developer cũng có thể làm web scraping dễ dàng. Thay vì phải cấu hình CSS selector hay viết code, bạn chỉ cần nhấp một lần, AI sẽ đọc trang, hiểu dữ liệu nào đang có sẵn và trích xuất ngay. Hoặc nếu bạn đã biết chính xác mình cần gì, chỉ cần mô tả cho AI, nó sẽ làm theo mô tả đó. Vậy thôi — một cú nhấp là ra dữ liệu có cấu trúc.
Riêng với Yellow Pages, quy trình này giải quyết trực diện bài toán email. Sau khi scrape trang niêm yết, bạn có thể mở rộng sang các trang con và Thunderbit sẽ truy cập từng trang chi tiết doanh nghiệp để tìm email, website, giờ làm việc, đánh giá và các trường khác không hiển thị trên thẻ chính. Chúng tôi cũng xây dựng sẵn Email Extractor và Phone Number Extractor như những công cụ độc lập, nên bạn có thể dùng trên bất kỳ trang nào chỉ với một cú nhấp.
Cách Thunderbit Xử Lý Việc Lấy Email Từ Yellow Pages
Điểm khác biệt cốt lõi là subpage scraping. Phần lớn scraper dừng lại ở trang kết quả tìm kiếm và chỉ trả về những gì nhìn thấy được — mà với Yellow Pages, điều đó đồng nghĩa là không có email. Tính năng subpage của Thunderbit sẽ đi vào từng hồ sơ doanh nghiệp và lấy dữ liệu ở lớp sâu hơn này. Bạn cũng có thể dùng Field AI Prompt để thêm hướng dẫn như "trích xuất email từ phần liên hệ" hoặc "đánh dấu doanh nghiệp không có website" nhằm tăng độ chính xác và bổ sung ngữ cảnh ngay trong lúc scrape.
Dựa trên cấu trúc trang hiện tại và tài liệu scraper, email trên thẻ niêm yết của Yellow Pages gần như bằng 0. Những scraper truy cập trang chi tiết như tính năng subpage của Thunderbit có thể lấy lại email từ khoảng 15–25% doanh nghiệp — đây là mức trần thực tế cho việc lấy email từ Yellow Pages trong năm 2026. Đây không phải giới hạn riêng của Thunderbit, mà là giới hạn dữ liệu của Yellow Pages.
Khả Năng Chống Bot và Phân Trang
Thunderbit có hai chế độ scraping: cloud scraping (đi qua máy chủ US/EU/Asia với tự động xoay proxy) và browser scraping (dùng phiên trình duyệt cục bộ của bạn). Nếu cloud mode bị Cloudflare chặn, bạn có thể chuyển sang browser mode như một phương án dự phòng — phiên đăng nhập của bạn thường vượt qua được những lớp bảo vệ vốn chặn request cloud headless.
Phân trang hoàn toàn tự động. Thunderbit xử lý cả nút "Next" theo kiểu nhấp chuột lẫn cuộn vô hạn mà không cần cấu hình.
Giá Cả và Xuất Dữ Liệu
- Gói miễn phí: 6 trang mỗi tháng
- Dùng thử miễn phí: 10 trang
- Gói Starter: từ khoảng ~$9/tháng khi thanh toán theo năm cho 500 credit (1 credit = 1 dòng)
- Xuất dữ liệu: Excel, CSV, JSON có sẵn ở gói miễn phí; Google Sheets, Airtable và Notion ở các gói trả phí
Bạn có thể xem thông tin mới nhất tại trang giá.
Phù hợp nhất cho: Nhân viên sales, agency và đội vận hành cần dữ liệu lead nhanh mà không phải viết code hay quản lý proxy.
2. Apify Yellow Pages Scraper — Tốt Nhất Cho Scraping Cloud Quy Mô Lớn
 Apify là một nền tảng scraping trên cloud với marketplace các "actor" dựng sẵn — trong đó có vài công cụ được thiết kế riêng cho Yellow Pages. Bạn cấu hình tác vụ trong Apify console (từ khóa tìm kiếm, địa điểm, số lượng kết quả), sau đó nó chạy trên cloud mà không cần trình duyệt hay máy cục bộ.
ParseBird Yellow Pages actor là công cụ minh bạch nhất về email extraction mà tôi tìm thấy. Nó tách rõ listing mode và detail mode, đồng thời ghi rõ email thường chỉ đạt 15–25% số listing khi bật trang chi tiết. Scrape ở detail mode có giá khoảng $6 cho mỗi 1.000 doanh nghiệp, so với $1 cho mỗi 1.000 ở listing mode — phản ánh trực tiếp chi phí tính toán tăng thêm khi phải truy cập từng trang con.
- Có sẵn proxy pool với hỗ trợ residential proxy
- Phân trang tích hợp cho bộ kết quả nhiều trang
- Xuất dữ liệu: JSON, CSV, Excel, XML, HTML, RSS, JSONL
- Giá: Gói miễn phí có $5 credit; gói trả phí $29, $199 và $999/tháng
Phù hợp nhất cho: Người dùng trung cấp đến nâng cao chạy các chiến dịch lead-gen lớn trên nhiều thành phố hoặc nhiều danh mục.
3. WebScraper.io — Tốt Nhất Khi Muốn Tự Xây Sitemap Yellow Pages Riêng
 WebScraper.io cung cấp extension Chrome với "Sitemap Wizard" trực quan, có thể tự nhận diện cấu trúc niêm yết trên Yellow Pages. Đây là công cụ đứng sau một trong những hướng dẫn scrape Yellow Pages có thứ hạng cao, và điều đó hoàn toàn có lý do — nó cho bạn mức kiểm soát rất chi tiết về thứ gì được scrape và theo cách nào.
Đổi lại, sự kiểm soát này đi kèm với cấu hình. Email extraction không tự động; bạn cần thiết lập selector thủ công để nhắm đúng trường email và cấu hình scraper để đi theo link sang trang chi tiết của doanh nghiệp. Nếu cài đúng, nó hoạt động. Nếu không, bạn sẽ nhận được đầu ra chỉ gồm số điện thoại và địa chỉ giống mọi công cụ khác.
Ghi chú marketplace của WebScraper.io cũng hiếm khi nào thẳng thắn đến vậy về lớp phòng vệ của Yellow Pages: họ nêu rõ Cloudflare bot management, yêu cầu render JavaScript và browser fingerprinting là những rào cản cụ thể.
- Phân trang: Xử lý qua cấu hình nút "Next" dựa trên selector
- Xuất dữ liệu: CSV, XLSX, JSON; bản cloud thêm Google Sheets, Dropbox, S3, Azure, API, webhook
- Giá: Extension Chrome miễn phí; gói cloud từ $50/tháng
Phù hợp nhất cho: Người dùng quen với công cụ point-and-click dựa trên selector và muốn linh hoạt tùy chỉnh cấu trúc scrape.
4. Instant Data Scraper — Scraper Yellow Pages Miễn Phí Tốt Nhất (Nhưng Có Giới Hạn)
 Instant Data Scraper là câu trả lời cho câu hỏi: "Có gì miễn phí để tôi thử ngay bây giờ?" Đây là một extension Chrome hoàn toàn miễn phí — không cần tài khoản, không giới hạn credit, không giới hạn số lần dùng — và có thể tự động nhận diện dữ liệu dạng bảng trên trang web. Mở trang kết quả Yellow Pages, bấm icon extension, và nó sẽ nhận ra dữ liệu niêm yết.
Vấn đề nằm ở tất cả những gì nó không làm được. Nó chỉ scrape những gì đang hiển thị trên trang, nghĩa là không đi vào trang con và trong hầu hết quy trình thực tế sẽ không lấy được email. Công cụ này không có xử lý chống bot, nên nếu Yellow Pages trả CAPTCHA hoặc chặn IP của bạn thì bạn sẽ bị kẹt. Hỗ trợ phân trang cũng khá cơ bản — bạn có thể phải tự nhấn "Next" hoặc dựa vào auto-scroll hạn chế.
- Xuất dữ liệu: CSV, XLSX
- Giá: Miễn phí vĩnh viễn
Phù hợp nhất cho: Người mới cần scrape nhanh, miễn phí một trang kết quả và không cần email. Không phù hợp cho chiến dịch tập trung vào email hoặc lead generation quy mô lớn.
5. Outscraper — API Quản Lý Tốt Nhất Cho Yellow Pages và Google Maps
 Outscraper là nền tảng cloud/API với hạ tầng được quản lý sẵn để scrape các thư mục như Yellow Pages và Google Maps. Điểm hấp dẫn của nó là sự đơn giản: bạn không phải tự lo proxy, logic chống bot hay phân trang.
Với Yellow Pages, 500 doanh nghiệp đầu tiên được miễn phí, sau đó giá khoảng $1 cho mỗi 1.000 doanh nghiệp. Việc lấy email từ Yellow Pages chỉ giới hạn ở những gì có trên trang; nếu muốn làm giàu email sâu hơn, Outscraper có các tính năng enrichment riêng có thể kết hợp với scrape cơ bản.
Điểm mạnh của Outscraper là hỗ trợ đa thư mục. Nếu bạn scrape Yellow Pages và Google Maps cho cùng một chiến dịch, bạn có thể chạy cả hai từ một nền tảng.
- Có auto-pagination
- Xuất dữ liệu: CSV, JSON, XLSX, API
- Giá: Gói miễn phí (500 doanh nghiệp); sau đó tính phí theo kết quả
Phù hợp nhất cho: Đội sales ops muốn scraping ổn định, gần như không cần can thiệp, trên nhiều thư mục khác nhau mà không phải quản lý hạ tầng.
6. Octoparse — Ứng Dụng Desktop Tốt Nhất Cho Scraping Yellow Pages Trực Quan
 Octoparse là một ứng dụng desktop (Windows/Mac) với trình dựng workflow trực quan kiểu point-and-click. Nó có sẵn template cho Yellow Pages và các website thư mục tương tự, cùng các tính năng chống bot tích hợp như xoay IP, residential proxy và tự động giải CAPTCHA.
Việc lấy email phụ thuộc vào template. Khi template được cấu hình để vào trang chi tiết doanh nghiệp hoặc website liên kết, nó có thể trích xuất email. Nhưng template có thể hỏng khi Yellow Pages thay đổi bố cục, và người dùng báo cáo kết quả khá khác nhau tùy danh mục và khu vực địa lý.
- Gói miễn phí: 10 task, 50.000 lượt xuất mỗi tháng
- Tự động nhận diện phân trang
- Xuất dữ liệu: CSV, Excel, JSON, HTML, XML, databases, Google Sheets, API
- Giá: Có gói miễn phí; gói trả phí cho chạy cloud
Phù hợp nhất cho: Người dùng trung cấp thích ứng dụng desktop với workflow trực quan và không ngại tinh chỉnh template.
7. ScrapingBee — API Tốt Nhất Cho Developer Cần HTML Đã Render
 ScrapingBee là dịch vụ web scraping ưu tiên API. Nó xử lý render JavaScript, xoay proxy và giải CAPTCHA — rồi trả về HTML thô, JSON hoặc Markdown. Nó không tự động trích xuất email hay các field có cấu trúc. Phần đó là việc của bạn.
Chính hướng dẫn Yellow Pages của ScrapingBee còn minh họa cách phân trang thủ công bằng cách thêm &page=n vào URL, càng cho thấy đây là công cụ dành cho developer, không phải giải pháp point-and-click.
- Gói miễn phí: 1.000 API credit
- Không có phân trang hay field extraction tích hợp
- Xuất dữ liệu: JSON, HTML
- Giá: Từ $49/tháng
Phù hợp nhất cho: Developer cần HTML render ổn định kèm xử lý chống bot và sẵn sàng tự viết logic phân tích dữ liệu.
8. Bright Data — Nền Tảng Enterprise Tốt Nhất Cho Scraping Quy Mô Lớn
 Bright Data vận hành mạng proxy lớn nhất trong ngành và cung cấp một bộ đầy đủ gồm scraping API, công cụ trình duyệt và dataset dựng sẵn. Nền tảng này được thiết kế cho các tổ chức cần thu thập dữ liệu ở quy mô rất lớn, đồng thời có các tính năng tuân thủ.
Riêng với Yellow Pages, thế mạnh của Bright Data là hạ tầng — residential proxy, giải CAPTCHA, bảo vệ fingerprint trình duyệt — và khả năng đẩy dữ liệu xuống JSON, CSV, NDJSON, S3, Snowflake, GCS, Azure và SFTP. Tôi không tìm thấy template Yellow Pages chuyên biệt nào được ghi nhận hiện tại, nên cách định vị ở đây là nền tảng enterprise-grade, chứ không phải sản phẩm chuyên lấy email từ YP.
- Giá: Web Scraper API có gói miễn phí 5.000 records/tháng, sau đó $1.50 cho mỗi 1K records theo pay-as-you-go; $499/tháng ở quy mô lớn
- Phân trang tích hợp cho tất cả công cụ scraping
Phù hợp nhất cho: Doanh nghiệp lớn hoặc agency có ngân sách dữ liệu đáng kể, cần quy mô, tuân thủ và hạ tầng proxy.
9. Python DIY (BeautifulSoup + Playwright) — Tốt Nhất Khi Cần Toàn Quyền Kiểm Soát
 Đây là con đường open-source: dùng BeautifulSoup để phân tích HTML và Playwright để tự động hóa trình duyệt. Thư viện miễn phí, linh hoạt tối đa, nhưng cũng là lựa chọn đòi hỏi kỹ thuật cao nhất trong danh sách này.
Việc trích xuất email đòi hỏi bạn phải tự viết logic để đi đến từng trang chi tiết doanh nghiệp và tìm trường email. Xoay proxy, xử lý CAPTCHA, giới hạn tốc độ và phân trang đều phải tự triển khai hoặc mua riêng. Như một người dùng Reddit nói: "Một khi đã thử Playwright, bạn sẽ không muốn quay lại Selenium nữa" — nhưng bạn cũng sẽ không bao giờ thôi debug cấu hình proxy của mình.
- Giá: Miễn phí (thư viện open-source); chi phí hạ tầng tính thêm
- Xuất dữ liệu: Bất kỳ định dạng nào bạn tự code
- Không có gì tích hợp sẵn — bạn phải tự xây từng phần
Phù hợp nhất cho: Developer chuyên sâu với yêu cầu scraping đặc thù mà công cụ dựng sẵn không đáp ứng được, và thoải mái quản lý hạ tầng đầu-cuối.
Điều Gì Thực Sự Xảy Ra Khi Yellow Pages Chặn Bạn (Kiểm Tra Thực Tế Anti-Bot)
Tôi muốn dành một chút thời gian cho phần này vì đây là nỗi đau số 1 xét theo số lần được nhắc tới trong cộng đồng scraping, nhưng hầu hết bài viết lại chỉ lướt qua bằng câu "dùng proxy là xong."
Khi tôi thử gửi một request script cơ bản tới một URL tìm kiếm của Yellow Pages vào ngày 27/4/2026, phản hồi nhận được là trang chặn của Cloudflare: "Sorry, you have been blocked. This website is using a security service to protect itself from online attacks." Điều đó xảy ra ngay từ request đầu tiên. Không cảnh báo, không giới hạn dần dần — chỉ có một bức tường chặn.
Hệ thống chống bot của Yellow Pages bao gồm Cloudflare Bot Management, yêu cầu render JavaScript, browser fingerprinting, giới hạn tốc độ và reCAPTCHA. Hướng dẫn scrape của IPRoyal cũng cho biết dấu hiệu có thể bao gồm chặn cứng, chặn mềm, CAPTCHA, chuyển hướng tới splash page, theo dõi session và rate limit.
Bối cảnh chung còn làm tình hình tệ hơn. Báo cáo Imperva 2025 cho thấy traffic tự động chiếm 51% toàn bộ lưu lượng internet trong năm 2024, và báo cáo 2025 của DataDome trên gần 17.000 website cho thấy chỉ 2,8% được bảo vệ đầy đủ. Những website như Yellow Pages có đầu tư bảo vệ thì ngày càng phát hiện scraper tốt hơn, chứ không hề kém đi.
Phân tích thực tế cách từng công cụ xử lý vấn đề này:
| Công cụ | Xoay proxy | Xử lý CAPTCHA | Độ bền trước rate limit | Phương án dự phòng khi bị chặn |
|---|---|---|---|---|
| Thunderbit | ✅ Cloud mode với server US/EU/Asia | ✅ Quản lý qua cloud | ✅ Tự động điều chỉnh tốc độ | Chuyển sang browser scraping |
| Apify | ✅ Bao gồm residential proxy | ✅ Qua actor/browser infrastructure | ✅ Có thể cấu hình | Thử lại với proxy mới |
| WebScraper.io | ✅ Gói cloud + proxy add-on | ✅ Gói cloud | ✅ Mạnh | Dùng cloud execution |
| Instant Data Scraper | ❌ Không có | ❌ Không có | ❌ Yếu | Thử lại thủ công hoặc dừng |
| Outscraper | ✅ Backend được quản lý | ⚠️ Tài liệu hạn chế | ✅ Trung bình | Dịch vụ quản lý xử lý |
| Octoparse | ✅ Bao gồm residential | ✅ Tự động giải CAPTCHA | ✅ Mạnh | Cloud templates + anti-block |
| ScrapingBee | ✅ Proxy được quản lý | ✅ Tích hợp sẵn | ✅ Mạnh | Tinh chỉnh code, proxy cao cấp |
| Bright Data | ✅ Chuẩn enterprise | ✅ Tích hợp sẵn | ✅ Rất mạnh | Tinh chỉnh hạ tầng đầy đủ |
| Python DIY | ❌ Chỉ tự quản lý | ❌ Chỉ tự quản lý | ❌ Tùy biến | Tất cả đều do bạn xây |
Vượt Qua Dữ Liệu Thô: Biến Scrape Yellow Pages Thành Lead Sẵn Sàng Đưa Vào CRM
Tôi thấy một mô-típ lặp đi lặp lại: ai đó scrape 500 listing trên Yellow Pages, xuất ra spreadsheet, rồi mất ba tiếng tự Google từng doanh nghiệp để tìm email, kiểm tra website và xem doanh nghiệp nào đáng liên hệ. Phần scrape chỉ mất 10 phút. Phần enrich dữ liệu thì ngốn cả buổi chiều.
Đây là lý do câu than phiền "dữ liệu thô mà không có scoring thì chỉ là một file spreadsheet" xuất hiện. Một file xuất thô từ Yellow Pages sẽ trông như thế này:
| Tên doanh nghiệp | Số điện thoại | Địa chỉ | Website | Danh mục |
|---|---|---|---|---|
| Example Plumbing Co. | 555-0199 | 123 Main St | exampleplumbing.com | Plumbers |
| NoSite HVAC | 555-0112 | 456 Oak Ave | None | HVAC |
Còn một bảng lead đã được enrich — thứ thực sự hữu ích cho outreach — sẽ trông như thế này:
| Tên doanh nghiệp | Số điện thoại | Địa chỉ | Website | Đánh giá | Có website không? | Ghi chú prospect | |
|---|---|---|---|---|---|---|---|
| Example Plumbing Co. | 555-0199 | 123 Main St | exampleplumbing.com | info@exampleplumbing.com | 42 | Có | Có trang liên hệ |
| NoSite HVAC | 555-0112 | 456 Oak Ave | None | None | 8 | Không | Có thể là prospect cho agency |
Dùng Subpage Scraping Để Làm Giàu Lead
Tính năng subpage scraping của Thunderbit sẽ truy cập từng trang chi tiết doanh nghiệp và thêm các trường như email, URL website, giờ làm việc, đánh giá và danh mục. Với một lần scrape 500 listing, khác biệt giữa 10 phút thao tác tự động và hơn 3 tiếng nghiên cứu thủ công là cực lớn.
Scrape ở detail mode của Apify cũng làm điều tương tự, nhưng chi phí trên mỗi record cao hơn (khoảng $6 cho mỗi 1.000 doanh nghiệp so với $1 cho mỗi 1.000 ở listing mode).
Gắn Nhãn và Phân Loại Lead Ngay Trong Lúc Scrape
Field AI Prompt của Thunderbit cho phép bạn thêm hướng dẫn ngay trong quá trình scrape — như "đánh dấu doanh nghiệp không có website" hoặc "phân loại theo quy mô doanh nghiệp." AI sẽ xử lý các nhãn này trong lúc trích xuất dữ liệu, giúp bạn nhận được danh sách lead đã được sàng lọc thay vì chỉ là một đống dữ liệu thô.
Một lưu ý quan trọng từ nghiên cứu: website bị thiếu không phải lúc nào cũng có nghĩa là doanh nghiệp là một prospect tốt. Đây là tín hiệu hữu ích cho outreach của agency, nhưng không nên là tiêu chí duy nhất để đánh giá.
Quy Trình Xuất Sang CRM
Quy trình phổ biến nhất mà tôi thấy từ người dùng:
- Thunderbit → Google Sheets hoặc Airtable → CRM (xuất trực tiếp, không cần bước trung gian)
- Apify → Webhook → CRM (cần cấu hình thêm)
- Outscraper → tải CSV → nhập vào CRM (thủ công nhưng khá đơn giản)
Nếu CRM của bạn tích hợp với Google Sheets hoặc Airtable, tính năng xuất trực tiếp của Thunderbit sẽ loại bỏ hoàn toàn bước tải file. Bạn có thể tìm hiểu thêm về web scraping không cần code trên blog của chúng tôi.
Scraper Yellow Pages Tốt Nhất Theo Từng Nhu Cầu: Gợi Ý Nhanh
Không phải công cụ nào cũng hợp với mọi người dùng. Dưới đây là đề xuất theo từng nhóm:
Tốt nhất cho nhân viên sales và chủ agency không rành kỹ thuật: Thunderbit (AI scraping 1 cú nhấp, email extractor miễn phí, subpage scraping) và Instant Data Scraper (miễn phí, đơn giản — nhưng không có email)
Tốt nhất cho vận hành lead generation quy mô lớn: Apify (cloud actor, job đa thành phố, trích xuất email từ trang chi tiết) và Outscraper (API được quản lý, hỗ trợ nhiều thư mục)
Tùy chọn miễn phí tốt nhất: Instant Data Scraper (miễn phí vĩnh viễn) và gói miễn phí của Thunderbit (6 trang/tháng với AI features)
Tốt nhất cho developer: Python DIY với Playwright (kiểm soát tối đa) và ScrapingBee API (render + proxy được quản lý)
Tốt nhất cho enterprise / quy mô lớn: Bright Data (mạng proxy lớn nhất, tính năng tuân thủ, giá enterprise)
Chúng tôi cũng đã viết bài tổng hợp về best AI web scrapers và một hướng dẫn sâu hơn về AI lead generation nếu bạn muốn tìm hiểu thêm.
Yellow Pages vs. Google Maps vs. Các Directory Khác: Khi Nào Nên Dùng Cái Gì
Phần lớn chuyên gia lead-gen không scrape Yellow Pages một cách riêng lẻ. Họ thường lấy dữ liệu từ nhiều thư mục rồi đối chiếu chéo. So sánh nhanh dựa trên dữ liệu hiện có:
| Yếu tố | Yellow Pages | Google Maps | Facebook Business |
|---|---|---|---|
| Khả năng có email | Thấp (chỉ ở trang chi tiết) | Rất thấp (không phải field tiêu chuẩn) | Trung bình (trang có thể hiển thị email) |
| Số điện thoại | ✅ Luôn được liệt kê | ✅ Luôn được liệt kê | ⚠️ Đôi khi bị ẩn |
| Đánh giá/xếp hạng | ✅ Có | ✅ Dữ liệu phong phú hơn | ✅ Có |
| Danh mục/ngách | ✅ Mạnh cho ngách địa phương | ✅ Rộng và giàu dữ liệu | ⚠️ Không đồng nhất |
| Công cụ scraper tốt nhất | Thunderbit, Apify YP actor | Outscraper, Apify Maps actor | Thunderbit (AI tự nhận diện field trên bất kỳ website nào) |
Yellow Pages mạnh nhất ở phủ danh mục địa phương theo ngách — nếu bạn cần tất cả thợ sửa ống nước trong một khu vực đô thị cụ thể, rất khó có công cụ nào qua mặt. Google Maps lại cung cấp dữ liệu đánh giá phong phú hơn và tín hiệu độ mới cao hơn. Trang Facebook Business đôi khi còn vượt cả hai về khả năng nhìn thấy email trực tiếp, vì chủ trang thường công khai email.
Thunderbit dùng AI để tự nhận diện field trên bất kỳ website nào, nên bạn có thể scrape Yellow Pages, Google Maps và Facebook bằng cùng một extension. Tính linh hoạt này rất quan trọng khi bạn xây dựng một danh sách lead đa nguồn. Bài viết web scraping là gì của chúng tôi sẽ giúp bạn nắm nền tảng nếu mới bắt đầu.
Những Lưu Ý Pháp Lý Và Đạo Đức Khi Scrape Yellow Pages
Phần này ngắn thôi, nhưng rất quan trọng.
Dữ liệu Yellow Pages là công khai, nhưng Điều khoản sử dụng của YP.com nêu rõ rằng việc truy cập chỉ dành cho mục đích "cá nhân, phi thương mại, thông tin" và người dùng không được dùng "bots, scrapers, crawlers, spiders" để trích xuất dữ liệu. Bức tranh pháp lý ở Mỹ quanh web scraping khá phức tạp — việc dữ liệu công khai có thể làm giảm rủi ro CFAA so với các trang cần đăng nhập, nhưng luật hợp đồng, quy định về quyền riêng tư (CCPA) và tuân thủ marketing vẫn áp dụng.
FTC đã gửi thư cảnh báo đến 21 nhà tiếp thị và lead generator trong ngành bảo hiểm y tế vào tháng 12/2024 về cách thông tin người tiêu dùng được sử dụng trong quy trình lead-gen. Kết luận: hãy scrape có trách nhiệm, tôn trọng giới hạn tốc độ, đừng bán lại dữ liệu thô khi chưa hiểu rõ ranh giới pháp lý, và chỉ dùng dữ liệu scrape cho mục đích kinh doanh hợp pháp.
Bài viết này chỉ mang tính thông tin, không phải tư vấn pháp lý.
Kết Luận
Phần lớn scraper Yellow Pages bỏ lỡ email vì chúng dừng lại ở trang niêm yết. Những công cụ làm tốt hơn là những công cụ có thể đi đến trang chi tiết doanh nghiệp, theo link sang website riêng, hoặc chạy quy trình enrichment trên nền dữ liệu gốc. Ngay cả như vậy, tỷ lệ email có sẵn trên Yellow Pages cũng chỉ khoảng 15–25% số listing — vì thế, đặt kỳ vọng thực tế quan trọng không kém việc chọn đúng công cụ.
Nếu bạn là một đội không rành kỹ thuật nhưng cần lead có thông tin liên hệ thật sự, hãy thử gói miễn phí của Thunderbit — tính năng subpage scraping và email extraction được thiết kế riêng cho bài toán này. Nếu bạn chạy chiến dịch lớn hơn, Apify và Outscraper cung cấp hạ tầng cloud khá vững. Còn nếu bạn là developer muốn toàn quyền kiểm soát, Python với Playwright và ScrapingBee sẽ đưa bạn tới đích, dù bạn sẽ phải tự xây nhiều phần của pipeline hơn.
Hãy bắt đầu từ bảng so sánh phía trên, chọn theo kỹ năng và ngân sách của bạn, và nhớ rằng: scraper tốt nhất là scraper lấy được đúng dữ liệu bạn cần để outreach, chứ không phải scraper có danh sách tính năng dài nhất.
Bạn cũng có thể khám phá trực tiếp Thunderbit Chrome Extension, hoặc xem các hướng dẫn trên kênh YouTube của chúng tôi.
Câu Hỏi Thường Gặp
Có thực sự scrape được email từ Yellow Pages không?
Có, nhưng đa số email nằm ở trang chi tiết doanh nghiệp (subpage), chứ không phải thẻ niêm yết chính. Tài liệu scraper hiện tại cho thấy chỉ khoảng 15–25% doanh nghiệp hiển thị email mà scraper trang chi tiết có thể lấy được. Bạn cần một công cụ có khả năng subpage scraping — như Thunderbit hoặc actor chế độ detail của Apify — để đạt kết quả tốt nhất.
Scraper Yellow Pages miễn phí tốt nhất là gì?
Instant Data Scraper miễn phí hoàn toàn, không cần tài khoản hay credit, nhưng không trích xuất email ổn định và không có khả năng chống bot. Thunderbit có gói miễn phí (6 trang/tháng) với AI scraping, truy cập subpage và email extraction — đây là lựa chọn mạnh hơn nếu email quan trọng với quy trình của bạn.
Làm sao để tránh bị chặn khi scrape Yellow Pages?
Yellow Pages dùng Cloudflare Bot Management, CAPTCHA, rate limiting và browser fingerprinting. Hãy dùng các công cụ có sẵn xoay proxy và xử lý CAPTCHA (Thunderbit, Apify, Octoparse, ScrapingBee, Bright Data). Cơ chế chuyển đổi cloud sang browser của Thunderbit là một phương án dự phòng thực tế — nếu cloud scraping bị chặn, browser mode sẽ dùng phiên cục bộ của bạn để vượt qua một số lớp bảo vệ.
Scraper Yellow Pages hay Google Maps tốt hơn cho lead?
Tùy vào nhu cầu của bạn. Yellow Pages phủ tốt hơn các ngách địa phương và luôn liệt kê số điện thoại. Google Maps có dữ liệu đánh giá giàu hơn và cập nhật thường xuyên hơn. Cả hai đều không mạnh về email — thực tế Facebook Business Pages thường có tỷ lệ hiển thị email cao hơn. Lý tưởng nhất là đối chiếu nhiều thư mục để có hồ sơ lead đầy đủ nhất.
Scrape Yellow Pages có hợp pháp không?
Dữ liệu Yellow Pages là công khai, nhưng Điều khoản sử dụng của YP.com hạn chế việc thu thập dữ liệu tự động và sử dụng thương mại từ kết quả tìm kiếm. Khung pháp lý tại Mỹ về việc scrape dữ liệu công khai vẫn đang thay đổi. Người dùng nên xem Điều khoản sử dụng của website, tuân thủ các quy định quyền riêng tư áp dụng (CCPA, GDPR nếu liên quan) và sử dụng dữ liệu scrape một cách có trách nhiệm. Bài viết này chỉ mang tính thông tin và không phải tư vấn pháp lý.
Dùng thử Thunderbit để scrape Yellow Pages Get Started Free
Tìm hiểu thêm



