
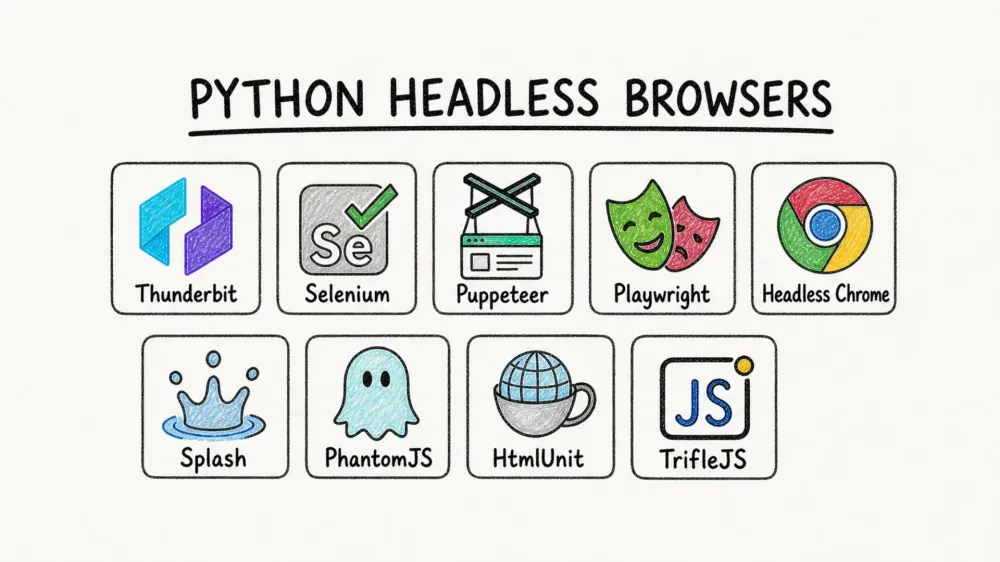
Web hiện nay đã biến thành một “rừng dữ liệu” đầy biến động, khó đoán hơn hẳn một “thư viện số”. Đến năm 2026, nếu bạn muốn scrape dữ liệu từ các website hiện đại, bạn không còn chỉ đối mặt với một bức tường JavaScript — mà là cả một pháo đài. Tôi đã tận mắt thấy các công cụ scraping truyền thống “đuối sức” trước nội dung động, cuộn vô hạn và những lớp chống bot ngày càng dày. Đó là lý do vì sao sự trỗi dậy của python headless browser không chỉ là một xu hướng — mà là một cuộc cách mạng thật sự dành cho bất kỳ ai cần trích xuất dữ liệu web ổn định và có thể mở rộng.
Không chỉ dân kỹ thuật mới để ý đến chuyện này. Tính đến năm 2025, 73% doanh nghiệp dựa vào trích xuất dữ liệu web tự động cho mục đích business intelligence, và hơn 94% website hiện nay phụ thuộc vào việc render JavaScript phía client. Dù bạn làm sales, ecommerce hay vận hành, chọn đúng python headless browser chính là ranh giới giữa “dữ liệu trong tầm tay” và “dữ liệu ngoài tầm với”. Vậy nên, bỏ qua những tiếng ồn xung quanh đi — tôi đã test, so sánh và gắn bó với các công cụ này, và dưới đây là phân tích 10 python headless browser tốt nhất cho scraping hiện đại (kèm một góc nhìn riêng về cách AI đang đổi luật chơi cho người không biết lập trình).
Điều gì khiến Python headless browser trở nên thiết yếu cho scraping hiện đại?
Dùng AI để scrape dữ liệu từ bất kỳ website nào Get Started Free
Hãy làm rõ thuật ngữ trước đã: python headless browser thực chất chỉ là một trình duyệt web được điều khiển bằng code Python, nhưng không hiện cửa sổ đồ họa trên màn hình. Nó tải trang, chạy JavaScript, bấm nút, điền form — tất cả diễn ra âm thầm ở phía sau. Cứ hình dung nó như một “trình duyệt ma”, làm việc lặng lẽ trong lúc bạn thong thả nhâm nhi cà phê.
Vì sao chuyện này quan trọng? Vì website hiện đại được thiết kế cho người dùng chứ không phải bot. Chúng giấu dữ liệu sau JavaScript, yêu cầu đăng nhập, và kỳ vọng bạn tương tác như người thật. Những scraper truyền thống chỉ đọc HTML thường chỉ nhận lại những khung rỗng. Trong khi đó, headless browser mô phỏng hành vi người dùng thực — chúng chờ các lời gọi AJAX, cuộn qua feed vô hạn, và lấy nội dung đúng như thứ bạn nhìn thấy trên Chrome hoặc Firefox (LiveProxies).
Nhưng chưa hết:
- Tốc độ & hiệu suất: Headless browser bỏ qua phần render giao diện, nên chạy nhanh hơn và ngốn ít bộ nhớ hơn — rất hợp để scrape quy mô lớn (LiveProxies).
- Hỗ trợ nội dung động: Chúng thực thi JavaScript, nên bạn lấy được dữ liệu đã render thật sự — chứ không chỉ HTML thô.
- Tự động hóa cực mạnh: Cần đăng nhập, phân trang hay xử lý pop-up? Python headless browser có thể làm hết.
- Khả năng mở rộng: Bạn có thể chạy hàng trăm phiên bản trên cloud, scrape hàng nghìn trang song song mà không phải “toát mồ hôi”.
Với người dùng doanh nghiệp, điều đó có nghĩa là bạn có thể thu thập lead, theo dõi đối thủ hoặc cập nhật giá — ngay cả khi website được xây như một pháo đài Fort Knox. Và với các công cụ mới nhất có AI hỗ trợ, bạn thậm chí không cần biết code vẫn có thể tham gia cuộc chơi.
Chúng tôi chọn các Python headless browser tốt nhất như thế nào
Tôi không chọn đại từ một danh sách tên trình duyệt. Đây là những tiêu chí tôi dùng:
- Hiệu năng & tốc độ: Nó có xử lý được các website hiện đại, nhiều JavaScript một cách nhanh và ổn định không?
- Hỗ trợ trình duyệt: Nó chạy được với Chrome, Firefox, WebKit hay thậm chí các engine cũ như IE không?
- Dễ sử dụng: Nó có thân thiện với người không biết code, hay bắt bạn phải có “bằng tiến sĩ Python”?
- Tính năng AI & no-code: Người dùng doanh nghiệp có thể tận dụng AI để tự động scraping mà không cần viết script không?
- Cộng đồng & hỗ trợ: Có cộng đồng năng động, tài liệu tốt và được phát triển đều đặn không?
- Tính năng nổi bật: Nó có gì đặc biệt — như template có sẵn, cloud scraping hay điều hướng qua trang con không?
Tôi đã thấy nhiều team mất hàng tuần loay hoay với phần cài đặt, rồi lại vấp ngã khi giao diện website đổi thay. Công cụ tốt không chỉ là “chạy được” — chúng phải thích nghi, mở rộng và giúp cuộc sống của bạn nhẹ nhàng hơn.
Top 10 Python headless browser tốt nhất cho scraping hiện đại
Dưới đây là danh sách tôi tin cậy nhất, kèm phần phân tích kỹ về điểm mạnh và điểm yếu của từng công cụ.
1. Thunderbit
 Thunderbit là python headless browser mà tôi ước mình đã có từ nhiều năm trước. Đây không chỉ là một công cụ tự động hóa trình duyệt — mà là một AI-powered web scraper Chrome Extension được tạo ra cho người dùng doanh nghiệp muốn có kết quả, không muốn đau đầu.
Vì sao Thunderbit nổi bật:
- Thiết lập trường dữ liệu bằng AI: Chỉ cần mở extension — một cú nhấp chuột — AI của Thunderbit sẽ tự hiểu bố cục, chọn trường dữ liệu và chạy scrape giúp bạn (Thunderbit Docs).
- Template dữ liệu có sẵn: Với các website phổ biến (Amazon, Zillow, LinkedIn, v.v.), bạn có thể dùng template một chạm — khỏi cần thiết lập.
- Scrape trang con & phân trang: Thunderbit có thể bấm qua các trang con, xử lý cuộn vô hạn và ghép toàn bộ dữ liệu vào một bảng duy nhất.
- Prompt ngôn ngữ tự nhiên: Chỉ cần mô tả thứ bạn muốn bằng tiếng Anh tự nhiên; AI của Thunderbit sẽ lo phần còn lại.
- Scrape trên cloud hoặc ngay trong trình duyệt: Chạy tác vụ cục bộ hoặc trên cloud (tối đa 50 trang cùng lúc để tăng tốc).
- Không cần viết code: Thật đấy — chỉ cần bạn dùng được trình duyệt, là dùng được Thunderbit.
- Xuất dữ liệu miễn phí: Xuất sang Excel, Google Sheets, Notion hoặc Airtable chỉ với một cú nhấp.
Tôi đã thấy Thunderbit giúp các team sales và ops tiết kiệm hàng giờ — từ scraping lead, theo dõi giá đến gom dữ liệu sản phẩm mà chẳng phải chạm vào code. Công cụ này được hơn 200,000 người dùng trên toàn thế giới tin dùng, và phản hồi gần như lúc nào cũng là: “Không thể tin là nó dễ đến vậy.”
Phù hợp nhất cho: Người không chuyên kỹ thuật, team doanh nghiệp, bất kỳ ai muốn AI làm phần việc nặng.
Dùng thử Thunderbit AI Web Scraper miễn phí
2. Selenium
 Selenium là “lão làng” của tự động hóa trình duyệt. Nếu bạn từng tìm “python headless browser”, rất có thể bạn đã gặp Selenium WebDriver.
Ưu điểm:
- Hỗ trợ hầu hết các trình duyệt lớn: Chrome, Firefox, Safari, Edge, thậm chí Internet Explorer (cho những ai đủ gan).
- Cộng đồng cực lớn: Có vô số hướng dẫn, plugin và câu trả lời trên Stack Overflow.
- Rất linh hoạt: Tự động hóa gần như mọi thao tác người dùng có thể làm — click, form, điều hướng.
Nhược điểm:
- Cài đặt khá phiền: Bạn phải quản lý browser driver và đồng bộ phiên bản.
- Chậm hơn các công cụ hiện đại: WebDriver tạo thêm độ trễ, và mở rộng lên hàng trăm trình duyệt thì khá cồng kềnh.
- API dài dòng: Bạn sẽ phải viết nhiều code hơn so với Playwright hoặc Puppeteer.
Phù hợp nhất cho: Các team đã quen Selenium, kiểm thử đa trình duyệt hoặc workflow tự động hóa kiểu cũ.
3. Puppeteer
 Puppeteer là thư viện tự động hóa cấp cao của Google dành cho Chrome/Chromium. Dù nó sinh ra cho Node.js, người dùng Python vẫn có thể tham gia thông qua Pyppeteer.
Ưu điểm:
- Tối ưu cho Chrome: Nhanh, hiệu quả và tích hợp chặt với Chrome DevTools.
- API bất đồng bộ: Rất hợp với các website hiện đại, nhiều JavaScript.
- Tính năng phong phú: Chụp screenshot, xuất PDF, chặn/lọc network.
Nhược điểm:
- Chỉ dành cho Chromium: Không hỗ trợ Firefox hay Safari.
- Native cho Node.js: Người dùng Python phải dùng Pyppeteer (và bản này hiện không còn được duy trì — xem bên dưới).
Phù hợp nhất cho: Lập trình viên muốn tự động hóa Chrome nhanh và ổn định, không cần hỗ trợ đa trình duyệt.
4. Playwright
 Playwright là “tân binh” do Microsoft phát triển — và rất nhanh trở thành công cụ tôi ưu tiên cho scraping nâng cao.
Ưu điểm:
- Hỗ trợ đa trình duyệt: Tự động hóa Chromium, Firefox và WebKit chỉ với một API.
- Tự động chờ: Không còn phải đoán khi nào trang sẵn sàng — Playwright tự chờ giúp bạn.
- Chạy song song: Có thể chạy nhiều browser context cùng lúc để đạt tốc độ rất cao.
- Ưu tiên Python: Có binding Python native, cả async lẫn sync.
Nhược điểm:
- Cài đặt nặng hơn: Đi kèm nhiều trình duyệt nên bước setup hơi “nặng đô”.
- Vẫn cần code: Không thân thiện với người không chuyên bằng Thunderbit.
Phù hợp nhất cho: Lập trình viên cần tự động hóa hiện đại, mạnh mẽ — đặc biệt cho web app phức tạp và nhiều biến động.
5. Headless Chrome
 Headless Chrome là “động cơ” đứng sau nhiều công cụ ở trên. Bạn có thể điều khiển trực tiếp qua Chrome DevTools Protocol (CDP) để có mức linh hoạt tối đa.
Ưu điểm:
- Hỗ trợ web hiện đại hàng đầu: Nếu nó chạy tốt trên Chrome, nó cũng chạy tốt trên headless Chrome.
- Kiểm soát rất sâu: Truy cập gần như mọi ngóc ngách của trình duyệt.
Nhược điểm:
- Đường cong học tập cao: Bạn cần hiểu CDP hoặc dùng một thư viện bọc bên trên.
- Chỉ dành cho Chrome: Không hỗ trợ đa trình duyệt.
Phù hợp nhất cho: Chuyên gia xây dựng pipeline tự động hóa riêng hoặc tích hợp Chrome ở tầng thấp.
6. Pyppeteer
 Pyppeteer là bản port Python không chính thức của Puppeteer. Nó mang tự động hóa Chrome bất đồng bộ đến với Python, nhưng… có một điểm cần lưu ý.
Ưu điểm:
- API kiểu Puppeteer: Nếu bạn biết Puppeteer, bạn sẽ thấy quen thuộc ngay.
- Tự động hóa Chrome nhanh: Rất hợp với các website động.
Nhược điểm:
- Không còn được duy trì: Dự án gốc đã ngừng cập nhật (nhà phát triển khuyên nên chuyển sang Playwright).
- Chỉ dành cho Chromium: Không có Firefox hay Safari.
Phù hợp nhất cho: Các dự án cũ đang dùng Pyppeteer. Với dự án mới, hãy chọn Playwright.
7. Splash
 Splash là một headless browser nhẹ, có thể lập trình, đi kèm HTTP API, do đội Scrapinghub (nay là Zyte) phát triển.
Ưu điểm:
- Nhẹ: Dùng QtWebKit nên tốn ít tài nguyên hơn Chrome.
- HTTP API: Có thể điều khiển từ bất kỳ ngôn ngữ nào, không chỉ Python.
- Rất hợp với Scrapy: Tích hợp mượt với Scrapy spider để render JavaScript.
Nhược điểm:
- Engine WebKit cũ: Có thể gặp khó với JavaScript hiện đại.
- Cần script Lua: Với tương tác nâng cao, bạn phải học thêm Lua.
Phù hợp nhất cho: Người dùng Scrapy cần render JavaScript thỉnh thoảng, hoặc các tác vụ render phía server nhẹ.
8. PhantomJS
 PhantomJS là headless browser có thể lập trình đầu tiên, được xây trên WebKit. Nó từng là người mở đường — nhưng giờ thì phần lớn đã lỗi thời.
Ưu điểm:
- Viết script đơn giản: Dễ tự động hóa bằng JavaScript.
- Hỗ trợ hệ thống cũ: Vẫn có thể dùng cho các website tĩnh, đời cũ.
Nhược điểm:
- Không còn được duy trì: Không có cập nhật từ năm 2016.
- Engine lỗi thời: Không xử lý tốt các website hiện đại nhiều JavaScript.
- Rủi ro bảo mật: Không có bản vá mới.
Phù hợp nhất cho: Duy trì script cũ. Với dự án mới, hãy chuyển sang Playwright hoặc Puppeteer.
9. HtmlUnit
 HtmlUnit là headless browser dựa trên Java, mô phỏng hành vi trình duyệt. Nó nhanh và nhẹ, nhưng không phải browser engine thực thụ.
Ưu điểm:
- Thuần Java: Rất hợp cho môi trường thiên về Java.
- Nhanh với trang tĩnh: Không cần khởi chạy một trình duyệt đầy đủ.
Nhược điểm:
- Hỗ trợ JavaScript hạn chế: Gặp khó với các website hiện đại, động.
- Không native cho Python: Cần lớp tích hợp trung gian (ví dụ Selenium HtmlUnitDriver).
Phù hợp nhất cho: Workflow dựa trên Java, kiểm thử ứng dụng cũ hoặc scrape các trang đơn giản, render phía server.
10. TrifleJS
 TrifleJS là headless browser dành cho Internet Explorer (IE), hướng tới việc tự động hóa các web app cũ trên Windows.
Ưu điểm:
- Tự động hóa IE: Xử lý tốt các ứng dụng nội bộ cũ hoặc hệ thống chỉ chạy trên IE.
- API giống PhantomJS: Ít phải sửa khi chuyển từ script PhantomJS.
Nhược điểm:
- Chỉ chạy trên Windows: Không hỗ trợ đa nền tảng.
- Lỗi thời: IE đã ngừng hỗ trợ; TrifleJS là công cụ ngách và hiếm khi được duy trì.
Phù hợp nhất cho: Các workflow legacy đặc thù, nơi vẫn bắt buộc phải tự động hóa IE.
Bảng so sánh tính năng: Python headless browser nhìn nhanh
| Công cụ | Hỗ trợ trình duyệt | Hiệu năng & quy mô | Mức độ dễ dùng | Tính năng AI/no-code | Cộng đồng & hỗ trợ | Phù hợp nhất cho |
|---|---|---|---|---|---|---|
| Thunderbit | Chrome (Extension/Cloud) | Cao (parallel trên cloud) | Dễ nhất — không cần code | Có (AI, template) | Đang phát triển, năng động | Người không biết code, sales/ops, trích xuất dữ liệu nhanh |
| Selenium | Hầu hết trình duyệt lớn | Trung bình | Trung bình (setup) | Không | Rất lớn, trưởng thành | Đa trình duyệt, legacy, test automation |
| Puppeteer | Chromium/Chrome | Rất cao | Cao (cho developer) | Không | Lớn (Node.js) | Chrome-only, developer, tự động hóa nhanh |
| Playwright | Chromium, Firefox, WebKit | Rất cao (multi-context) | Cao (cho developer) | Không | Tăng trưởng nhanh | Nâng cao, đa trình duyệt, scraping hiện đại |
| Headless Chrome | Chrome/Edge | Rất cao | Thấp (manual CDP) | Không | N/A (nền tảng) | Tùy biến, chuyên gia, kiểm soát tầng thấp |
| Pyppeteer | Chromium/Chrome | Cao | Trung bình (async) | Không | Nhỏ, không còn duy trì | Script Pyppeteer legacy |
| Splash | QtWebKit | Trung bình | Trung bình (API/Lua) | Không | Ngách (Scrapy/Zyte) | Người dùng Scrapy, render JS nhẹ |
| PhantomJS | WebKit (cũ) | Thấp (nay đã lỗi thời) | Trung bình (JS) | Không | Đã ngừng phát triển | Chỉ dùng cho legacy |
| HtmlUnit | Mô phỏng (Java) | Trung bình/Cao (static) | Thấp (Java) | Không | Nhỏ, thiên về Java | Workflow Java, trang đơn giản/tĩnh |
| TrifleJS | Internet Explorer (Trident) | Thấp/Trung bình | Trung bình (JS, Win) | Không | Rất nhỏ, legacy | Tự động hóa legacy chỉ dành cho IE |
Cách chọn Python headless browser phù hợp cho doanh nghiệp của bạn
Data scraping là gì và cách thực hiện trong năm 2025 Get Started Free
Đây là “phao cứu sinh” của tôi khi chọn công cụ phù hợp:
- Cần scrape nhanh, không cần code và có AI hỗ trợ? Chọn Thunderbit. Đây là cách dễ nhất để người không biết code lấy dữ liệu đáng tin cậy — đặc biệt hữu ích cho team sales, ecommerce hoặc research.
- Muốn kiểm soát tối đa và hỗ trợ đa trình duyệt? Playwright là lựa chọn đáng giá nhất. Mạnh, hiện đại và sinh ra cho quy mô lớn.
- Đã đầu tư vào Selenium? Hãy tiếp tục dùng Selenium — nó vẫn là “ông vua” cho workflow legacy và đa trình duyệt.
- Là developer và chỉ cần tự động hóa Chrome? Puppeteer (hoặc Playwright) rất nhanh và mạnh.
- Scrape các trang đơn giản, tĩnh trong môi trường Java? HtmlUnit nhẹ và dễ tích hợp.
- Cần duy trì script cũ hoặc app chỉ chạy trên IE? PhantomJS và TrifleJS là lựa chọn cuối cùng khi không còn cách nào khác.
Và nhớ nhé: công cụ tốt nhất là công cụ khớp với workflow, kỹ năng của team và nhu cầu kinh doanh của bạn. Đôi khi, điều đó có nghĩa là kết hợp nhiều công cụ — dùng Thunderbit cho việc nhanh, Playwright cho tác vụ nặng và Selenium cho hệ thống cũ.
Câu hỏi thường gặp
1. Python headless browser là gì, và vì sao tôi cần nó cho scraping?
Python headless browser là trình duyệt web được điều khiển bằng code Python, nhưng chạy ẩn không có giao diện. Nó rất cần thiết để scrape các website hiện đại nhiều JavaScript vì nó có thể chạy script, xử lý tương tác người dùng và trích xuất nội dung đã render đầy đủ — điều mà scraper HTML truyền thống không làm được.
2. Python headless browser nào tốt nhất cho người không rành kỹ thuật?
Thunderbit là lựa chọn hàng đầu cho người không biết code. Nó dùng AI để tự động hóa quá trình thiết lập, có template sẵn và cho phép bạn scrape dữ liệu chỉ với một cú nhấp chuột hoặc bằng cách mô tả dữ liệu cần lấy bằng một câu đơn giản — không cần lập trình.
3. Playwright và Puppeteer khác nhau thế nào đối với người dùng Python?
Playwright hỗ trợ nhiều trình duyệt (Chromium, Firefox, WebKit) và có binding Python rất tốt, nên phù hợp cho tự động hóa nâng cao. Puppeteer chỉ dành cho Chrome và native cho Node.js, nhưng người dùng Python có thể dùng Pyppeteer (dù hiện đã không còn được duy trì). Với dự án Python mới, Playwright là lựa chọn tốt hơn.
4. Selenium còn phù hợp với web scraping hiện đại không?
Có — Selenium vẫn được dùng rất rộng rãi, đặc biệt cho kiểm thử đa trình duyệt và tự động hóa legacy. Tuy nhiên, nó chậm và phức tạp hơn khi cài đặt so với các công cụ mới như Playwright hay Thunderbit, và cũng kém hiệu quả hơn khi scrape ở quy mô lớn.
5. Khi nào nên dùng các công cụ cũ như PhantomJS, HtmlUnit hoặc TrifleJS?
Chỉ nên dùng để duy trì hoặc chuyển đổi các workflow cũ. PhantomJS và TrifleJS đã lỗi thời, còn HtmlUnit phù hợp hơn trong môi trường Java với các trang đơn giản. Với dự án mới, hãy chọn các công cụ hiện đại và còn được phát triển tích cực.
Nếu bạn đã sẵn sàng xem scraping hiện đại, được AI hỗ trợ, trông như thế nào, hãy dùng thử Thunderbit. Và để đọc thêm các bài phân tích sâu về tự động hóa web, hãy xem Thunderbit Blog. Chúc bạn scrape vui vẻ — mong rằng dữ liệu của bạn luôn mới và các trình duyệt của bạn mãi ở chế độ headless.
Dùng thử Thunderbit AI Web Scraper ngay hôm nay Get Started Free
Tìm hiểu thêm



