
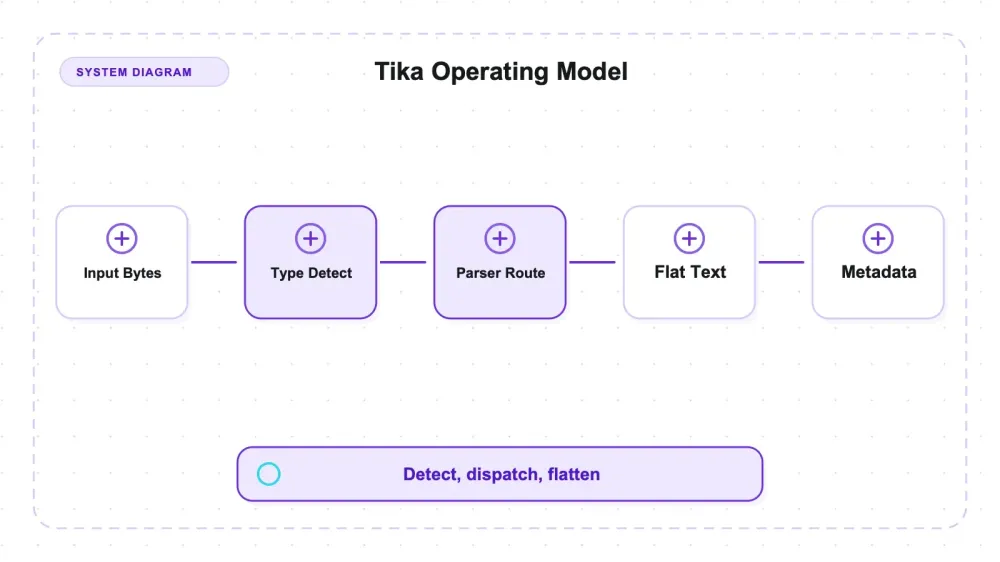
Apache Tika là bộ công cụ phân tích tài liệu của Apache Software Foundation: chỉ cần đưa vào gần như bất kỳ tệp nào, nó sẽ trả lại văn bản thuần và một bộ siêu dữ liệu đã được chuẩn hóa. README của dự án cho biết Tika hỗ trợ hơn một nghìn định dạng tệp, và nó làm được điều đó bằng cách tự đóng gói các thư viện chuyên dụng bên trong — PDFBox cho PDF, Apache POI cho tài liệu Office, jsoup cho HTML, bộ đọc ODF cho ODT — nên toàn bộ được phát hành dưới dạng một fat jar duy nhất, không cần tải thêm gì khi phân tích. Trong một pipeline dữ liệu, nó là bước đầu tiên khá ít phô trương: thành phần đứng trước chỉ mục tìm kiếm, bộ tài liệu e-discovery, hay kho ngữ liệu cho LLM, biến một đống tệp lộn xộn thành thứ gì đó đồng nhất. Thực ra chỉ có hai việc — xác định luồng byte đó là gì, rồi rút văn bản và metadata ra khỏi nó.
Đây là công cụ ít đòi hỏi nhất mà tôi từng thiết lập trong một thời gian dài. Một jar duy nhất, java -jar tika-app-3.3.2.jar --text file.pdf, không file cấu hình, không trọng số mô hình, không bước cài đặt thêm, và nó chạy ngon lành trên một bản JDK mới tinh vốn đã làm các công cụ Java khác đứng hình ngay trên cùng máy trong cùng buổi chiều. Tuy nhiên, tôi không muốn kiểm tra lời quảng cáo về danh mục định dạng; câu hỏi đáng kiểm chứng hẹp hơn nhiều. Khi đầu vào nói dối bạn, Tika thực sự làm gì? Vì thế tôi tạo một bộ fixture có kiểm soát, trong đó mỗi khối nội dung đều mang một token đánh dấu riêng, xuất cùng một tài liệu logic sang chín định dạng khác nhau, rồi “tấn công” toàn bộ bằng phần mở rộng sai, thiếu phần mở rộng, không có tên tệp, tệp rỗng byte, và các binary bị cắt dở.
Khâu nhận diện là nơi hành vi thú vị nhất xuất hiện. Tôi đổi tên một PDF thành .txt và hỏi Tika đó là gì; nó trả lời application/pdf. Sau đó tôi xóa hẳn tên tệp, truyền raw bytes qua stdin, và nhận cùng một câu trả lời. Trên năm định dạng có thể nhận diện bằng nội dung trong bộ của tôi, điều đó đúng trong toàn bộ 20 điều kiện logic duy nhất: ba điều kiện về tên tệp cộng với một điều kiện luồng không có tên tệp cho mỗi định dạng. Harness chạy trường hợp stream ba lần dưới các nhãn khác nhau, tạo ra 30 lần chạy thành công ở dạng raw, nhưng các lần lặp đó không phải bằng chứng độc lập. PDF và RTF có byte đặc trưng dễ nhận; DOCX bộc lộ thông qua container; HTML và XML có thể được nhận diện từ markup hoặc nội dung gốc. Cơ chế khác nhau, kết quả hữu ích như nhau trong bộ fixture này: phần mở rộng không lấn át nội dung. Rồi đến nhóm định dạng văn bản, nơi Markdown rơi về text/plain ngay khi tên tệp sai hoặc bị xóa. Trong trường hợp này, danh tính của nó hoàn toàn phụ thuộc vào .md.
Hai lưu ý giới hạn cho mọi con số bên dưới. Tôi đã kiểm tra Apache Tika 3.3.2 — xác nhận ngày 27/07/2026 rằng đây vẫn là bản ổn định mới nhất; nhánh 4.0.0 mới chỉ tồn tại dưới dạng alpha và beta trên Maven Central. Dự án có khoảng 3,9 nghìn GitHub stars tại thời điểm tôi kiểm tra ngày 27/07/2026, và được cấp phép Apache-2.0, thuộc nhóm “thoải mái” nhất xét về mặt thương mại. Và tôi hoàn toàn không test OCR. Không có trang scan nào, không có PDF chỉ chứa ảnh nào. Máy tôi chạy thử không có Tesseract và poppler, nên mọi đường OCR đều bị chặn ngay từ đầu. Vì vậy ở đây không có số liệu OCR nào cả — tuyệt đối không.
Tika là gì, khi bạn ngừng đọc phần marketing trên hộp
Giả định phổ biến là Apache Tika là một bộ chuyển đổi tài liệu — đưa vào DOCX, nhận lại Markdown sạch sẽ với heading và bảng được giữ nguyên. Nó không phải như vậy, và càng hiểu sớm điểm này thì công cụ càng nhìn hợp lý hơn.
Luồng được kiểm tra ở đây có ba giai đoạn liên quan: một bộ nhận diện kiểu nội dung, một dispatcher giao bytes cho parser phù hợp, và handler đầu ra --text của CLI, vốn xuất ra văn bản phẳng cùng metadata có thể truy cập riêng. Trong hợp đồng đầu ra đó không có đối tượng Title, không có ListItem, và không có lưới bảng được dựng lại. Tika cũng có các handler và API khác, bao gồm đầu ra theo hướng XHTML/SAX; tôi không test các phần đó. Mọi kết luận về cấu trúc bên dưới vì thế chỉ nói về tika-app --text, chứ không khẳng định toolkit này không có luồng sự kiện có cấu trúc ở nơi khác.
Nghe có vẻ là một hạn chế, và ở một khía cạnh thì đúng là vậy. Nhưng nó cũng đồng nghĩa Tika không có gì để nhận nhầm, và đó chính là sự đánh đổi mà các công cụ “tham vọng” hơn thường làm theo chiều ngược lại.
Bản thân việc nhận diện chạy theo thứ tự đã được tài liệu hóa: trước hết là byte chữ ký, rồi kiểm tra root XML, rồi wildcard của tên tệp, rồi bất kỳ kiểu nào bạn tự cung cấp (tài liệu nhận diện của Tika nêu rõ điều này). Chỉ sau khi kiểu dữ liệu được xác định xong, dispatcher mới chuyển bytes sang parser đi kèm tương ứng — PDFBox, POI, jsoup, TextAndCSVParser cho nhóm văn bản.
Tách bạch giữa nhận diện và phân tích không phải chuyện nội bộ vụn vặt. Nó giải thích vì sao một tệp hỏng đến mức không thể parse vẫn có thể được gán kiểu chính xác, và đó trở thành mẹo thực dụng nhất mà Tika mang lại khi mọi thứ bắt đầu vỡ.
Thiết lập: một jar, một lệnh, và một JVM không khó tính
Cài đặt chỉ là tải xuống. tika-app-3.3.2.jar từ Maven Central nặng khoảng 67 MB — một fat jar chứa mọi parser — và sau đó chỉ cần java -jar tika-app-3.3.2.jar --text file.pdf. Không file config, không weights của mô hình, không bước sau cài đặt, không chuỗi brew install dài lê thê.
Câu chuyện về JDK làm tôi khá bất ngờ. Tôi chạy toàn bộ trên OpenJDK 26.0.1, một bản non-LTS rất mới, và --version, --text, --metadata, lẫn --detect đều trả về exit 0 mà không phàn nàn gì về tương thích. Điều đó đáng nhắc tới, vì tôi cũng thử Apache Nutch trên cùng máy trong cùng thời điểm và vòng crawl của nó không chạy nổi trên JDK 26 — nó cần LTS ở mức 21 hoặc thấp hơn, do SecurityManager đã bị gỡ bỏ ở các JDK mới hơn. Tika thì không bận tâm. Nếu bạn từng né các công cụ JVM vì kiểu rắc rối đó, Tika không phải nơi khiến bạn bị vướng.
Hai kết luận thực tế về phần thiết lập. CLI khởi tạo một JVM mới cho mỗi lần gọi, nên chi phí cold start là có thật — chạy 131 lượt gọi cho harness của tôi mất khoảng một phút, chủ yếu là thời gian JVM warm up. Nếu bạn xử lý tệp ở quy mô lớn, bạn nên dùng thư viện hoặc chế độ server, chứ không phải lặp shell trên jar. Và câu chuyện “không phụ thuộc gì thêm” có một ranh giới rõ ràng: trích xuất text layer của PDF không cần gì bên ngoài, nhưng OCR thì cần tesseract và poppler. PDF có text layer, DOCX, ODT, RTF, HTML, XML, TXT, Markdown, CSV đều parse được trên máy không cài hai công cụ đó. Tài liệu scan thì sẽ không, và tôi cũng không giả vờ là đã thử.
Sự khác biệt này còn rõ hơn khi so với thư viện anh em tôi test cùng ngày, unstructured, nơi đường xử lý PDF điện tử bị chặn hoàn toàn vì import module PDF của nó sẽ kéo theo stack inference (torch và các thành phần liên quan) ngay từ lúc nạp — trước cả khi dispatcher chọn chiến lược, nên ngay cả “fast strategy” cũng không import nổi nếu thiếu. Tika thì parse text layer của cùng file PDF chỉ với một lệnh java -jar thuần túy.
Bài test phần mở rộng nói dối: nhận diện mime type không quan tâm bạn đã đặt tên file gì
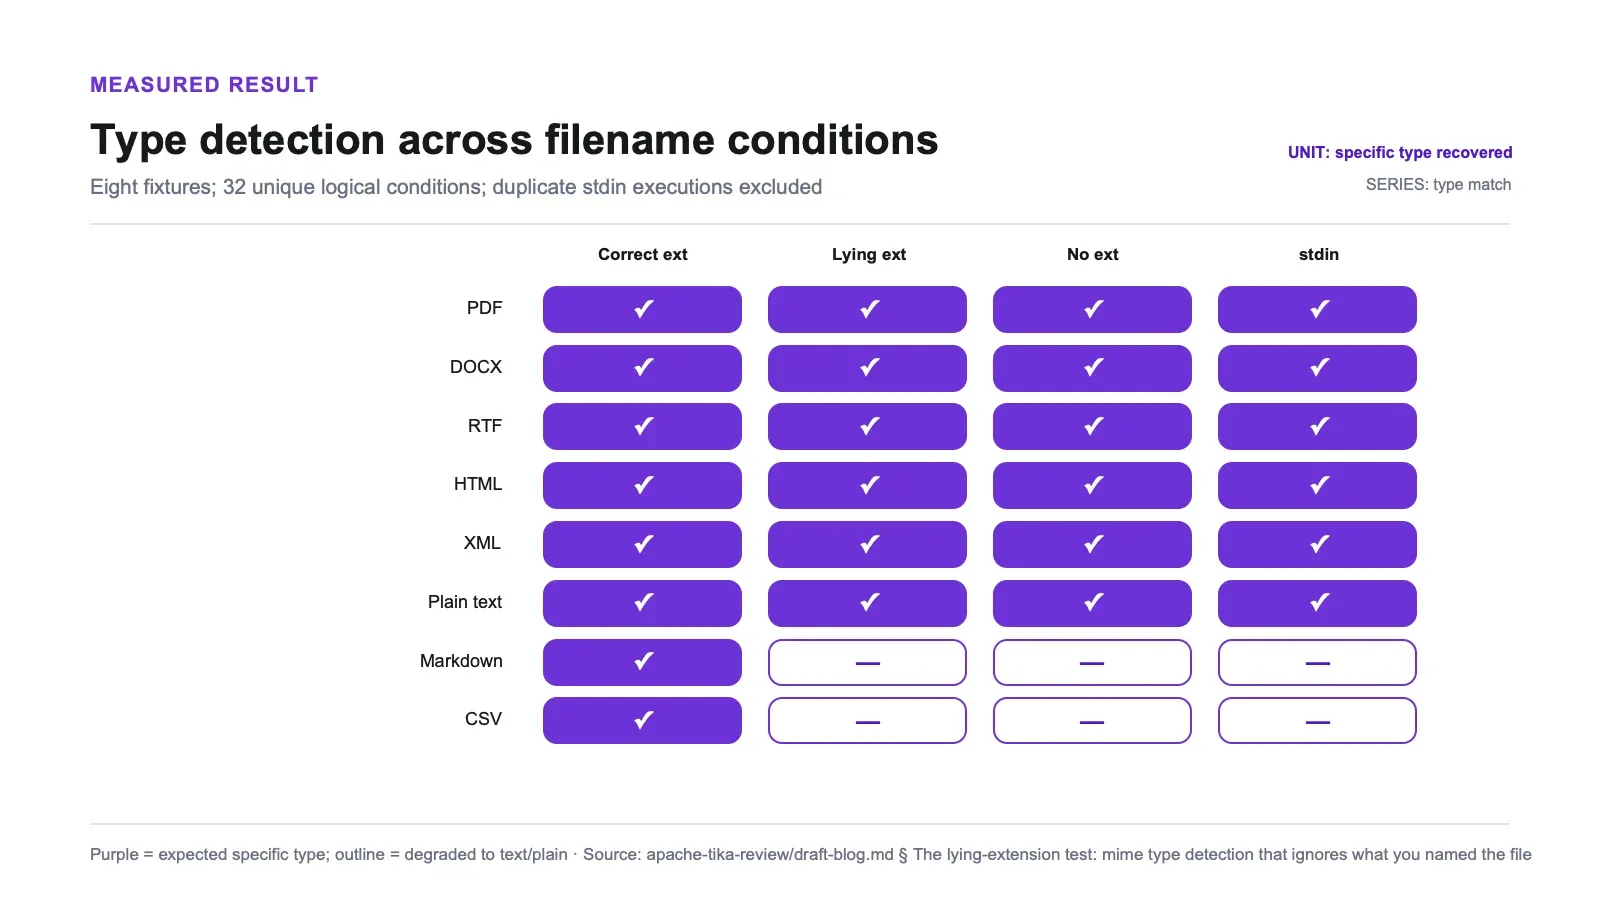
Tám định dạng, mỗi định dạng được đưa ra với phần mở rộng đúng, phần mở rộng cố tình sai, hoặc không có phần mở rộng, cộng thêm một luồng byte không có tên tệp trên stdin. Đó là 32 điều kiện logic duy nhất. Harness gốc cũng chạy đúng cùng một luồng byte một lần dưới mỗi nhãn tên tệp, tạo thành 48 lần chạy raw; ba hàng stream đó được gộp thành một điều kiện vì stdin không mang tên tệp.
| Fixture | Kiểu thật | Đổi tên thành | Đúng ext | Ext nói dối | Không ext | Raw stream, không tên tệp |
|---|---|---|---|---|---|---|
application/pdf | .txt | ✅ | ✅ | ✅ | ✅ | |
| DOCX | OOXML wordprocessingml | .jpg | ✅ | ✅ | ✅ | ✅ |
| RTF | application/rtf | .html | ✅ | ✅ | ✅ | ✅ |
| HTML | text/html | .csv | ✅ | ✅ | ✅ | ✅ |
| XML | application/xml | .txt | ✅ | ✅ | ✅ | ✅ |
| Plain text | text/plain | .pdf | ✅ | ✅ | ✅ | ✅ |
| Markdown | text/markdown | .pdf | ✅ | ❌ text/plain | ❌ text/plain | ❌ text/plain |
| CSV | text/csv | .txt | ✅ | ❌ text/plain | ❌ text/plain | ❌ text/plain |
(Hàng stream được gộp cho cả ba điều kiện phần mở rộng, vì không có tên tệp thì wildcard chẳng có gì để đọc.)
Năm định dạng có thể nhận diện bằng nội dung — PDF, DOCX, RTF, HTML, và XML — đều trả về đúng kiểu trong 20 trên 20 điều kiện logic duy nhất (và 30 trên 30 lần chạy raw của harness, gồm cả các lượt stream lặp). Một PDF tên report.txt vẫn là PDF. Một DOCX tên photo.jpg vẫn là DOCX. Cả hai đều không cần tên tệp. Điều này không có nghĩa cả năm đều dựa trên chữ ký byte cố định: PDF và RTF có header dễ nhận, DOCX là container dựa trên ZIP, còn HTML/XML được nhận từ markup hoặc nội dung gốc. Cơ chế khác nhau, nhưng trong bộ fixture này thì phần mở rộng nói dối không thắng.
Rồi đến chế độ của nhóm văn bản. Markdown chỉ được gán text/markdown khi phần mở rộng .md có mặt và đọc được. Đổi tên, bỏ phần mở rộng, hoặc gửi nó qua stream, và trong bài test này nó rơi về text/plain. CSV cũng giống vậy trên lưới nhỏ có chủ ý này: text/csv chỉ xuất hiện từ wildcard .csv. Nếu đếm theo điều kiện duy nhất, Markdown và CSV mỗi loại chỉ được nhận dạng đúng một trong bốn điều kiện; còn plain text vốn đã là text/plain, nên không có gì để “rơi xuống” nữa. Harness raw 48 lượt vẫn hữu ích như một hồ sơ lặp lại, nhưng không nên dùng làm mẫu số lớn hơn.
Có một điểm Tika làm tốt ở đây: phần mở rộng nói dối cũng không thắng. Fixture Markdown của tôi bị đổi tên thành .pdf nhưng trả về text/plain, không phải application/pdf. Tika không tin lời nói dối; nó chỉ không xác nhận được sự thật. Việc rơi về kiểu cha còn tốt hơn nhiều so với việc khẳng định nhầm một kiểu cụ thể, và chuyện text/markdown là một subtype đã được tài liệu hóa của text/plain khiến fallback này có cơ sở chứ không hề tùy tiện.
Riêng với CSV cần một lưu ý. Tika có bộ nhận diện CSV theo thống kê, và ở thời điểm parse — được xác nhận qua chuỗi X-TIKA:Parsed-By có TextAndCSVParser — lưới nhỏ 2 cột × 3 hàng của tôi được gán text/plain chứ không phải text/csv. Đây chỉ là một quan sát trên fixture tối thiểu có chủ ý. CSV lớn hơn hoặc có dấu ngoặc kép hoàn toàn có thể kích hoạt bộ nhận diện. Tôi không nói nhận diện nội dung CSV bị hỏng; tôi chỉ nói rằng trên lưới này, chính phần mở rộng là thứ tạo ra text/csv.
Điều này có ý nghĩa gì trong một pipeline upload thực tế
Tình huống cụ thể là một bộ định tuyến upload. Giả sử bạn nhận file người dùng tải lên và route theo kiểu: PDF sang bộ parse hóa đơn, bảng tính sang bộ nhập sổ cái, còn lại thì vào chỉ mục văn bản. Nếu bạn tin phần mở rộng, một file PDF tên notes.txt sẽ đi nhầm nhánh — và đó còn là trường hợp “hiền”; biến thể xấu hơn là một file polyglot với phần mở rộng trông vô hại.
Với các fixture binary và markup tôi test ở đây, Tika route theo nội dung ngay cả sau khi tên tệp biến mất, điều này rất hữu ích khi blob store hoặc trình xử lý HTTP body đã loại bỏ nó. Kết quả đó không bao quát đuôi dài của Tika, các file mơ hồ, hay file polyglot. Các fixture thuộc nhóm văn bản thì khác: khi pipeline lược bỏ tên tệp, Markdown và CSV đều đến dưới dạng text/plain, nên các rule dựa trên media type cụ thể sẽ ngừng kích hoạt. Hãy giữ tên gốc như metadata đi kèm thay vì kỳ vọng nhận diện nội dung sẽ tự dựng lại nó.
Nội dung được cài sẵn vẫn sống sót. --text làm phẳng cấu trúc.
Độ trung thực là trục thứ hai, và nó tách khá rõ thành hai phần. Tôi dựng một tài liệu chuẩn (heading, hai đoạn thân bài, một danh sách gạch đầu dòng, một danh sách đánh số, và một đoạn kết) sang HTML, Markdown, plain text, DOCX, PDF, RTF, ODT, và XML, rồi thêm một tài liệu bảng sang HTML, Markdown, text, DOCX, CSV, và XML. Tổng cộng mười bốn bản render. Mỗi khối đều mang một token duy nhất — zztitle1, zzitem3, zztblcell_beta và tương tự — nên “còn sống” hay “bị rơi mất” được xác định bằng kiểm tra substring chính xác, chứ không phải phán đoán cảm tính.
Độ thu hồi marker-token đạt 1.000 trên cả mười bốn bản render. Không một token nào được cài sẵn bị mất: mọi ô bảng, mục danh sách và heading có gắn nhãn đều xuất hiện. Ba lần lặp cục bộ cho mỗi carrier sau khi warm up đều trả về đầu ra --text giống hệt byte. Oracle này không nói gì về ký tự không gắn nhãn, thứ tự, khoảng trắng, chuẩn hóa Unicode, nội dung lặp lại, link, header, footnote, hay object nhúng. Đây là kiểm tra sự hiện diện của các khối, không phải bằng chứng cho tính toàn vẹn tuyệt đối của tài liệu.
Đầu ra văn bản phẳng đánh đổi phần lớn cấu trúc nguồn.
Đây là tài liệu bảng HTML khi đi ra từ --text:
	Tool	Throughput

	zztblcell_alpha	120

	zztblcell_beta	95
Các dòng được nối bằng tab. Hàng header không được đánh dấu là header. Không có lưới, không có biên ô ngoài dấu tab, không có cách nào biết nó từng là một <table>. Bảng trong DOCX cũng bị làm phẳng theo cách tương tự.
Danh sách tinh tế hơn, và nó tách theo nội dung nguồn thực sự chứa gì:
| Dấu bullet trong nguồn là gì | Carrier | --text trả về gì |
|---|---|---|
Một ký tự literal — các bản render này đều viết - như văn bản thực | plain text, Markdown, RTF, ODT, PDF | dấu - vẫn còn, vì Tika chỉ truyền nguyên ký tự qua |
Cấu trúc thật — một <li> của HTML, hoặc style List Bullet trong DOCX | HTML, DOCX | marker biến mất hoàn toàn và bạn chỉ còn text của mục: trong HTML là dòng thụt tab, trong DOCX là một dòng trơn không trang trí |
Tika không bao giờ render lại một marker mà nó không nhận dưới dạng text. Cùng nội dung, nhưng đầu ra trông khác nhau.
Trường hợp Markdown cho thấy điều này rất rõ. Đưa cho Tika một file .md có bảng pipe và các dấu | sẽ quay trở lại nguyên văn, trông như giữ được cấu trúc. Nhưng không phải vậy. Tika chỉ parse nó như text rồi trả bytes lại. Không có gì hiểu đó là bảng.
Vì thế, hợp đồng đo được hẹp hơn: mọi marker được cài sẵn đều sống sót, còn --text thì không giữ được các phần tử có kiểu hay một lưới bảng có thể tái dựng. Gọi đó là lỗi parser sẽ bỏ lỡ bản chất. Trích xuất phẳng cố ý tránh vấn đề phân loại phần tử; đồng thời nó cũng không thể đáp ứng consumer phía sau cần những kiểu phần tử đó. Nếu bạn cần block có kiểu hoặc bảng được tái cấu trúc, --text chỉ là một mảnh của stack, không phải toàn bộ stack. Các Tika handler khác có thể cho thấy thêm cấu trúc, nhưng chúng nằm ngoài lần chạy này.
Nhắc lại một cảnh báo quen thuộc cho mọi con số fidelity ở đây: chúng đến từ fixture tổng hợp có kiểm soát trên một máy, một phiên bản, một JDK. Chúng cho thấy các block đã được gắn nhãn có mặt trong đầu ra. Chúng không chứng minh độ chính xác từng ký tự trên một corpus thực tế đầy lộn xộn.
Metadata: đã được chuẩn hóa, và rất không thích bịa ra thứ không có
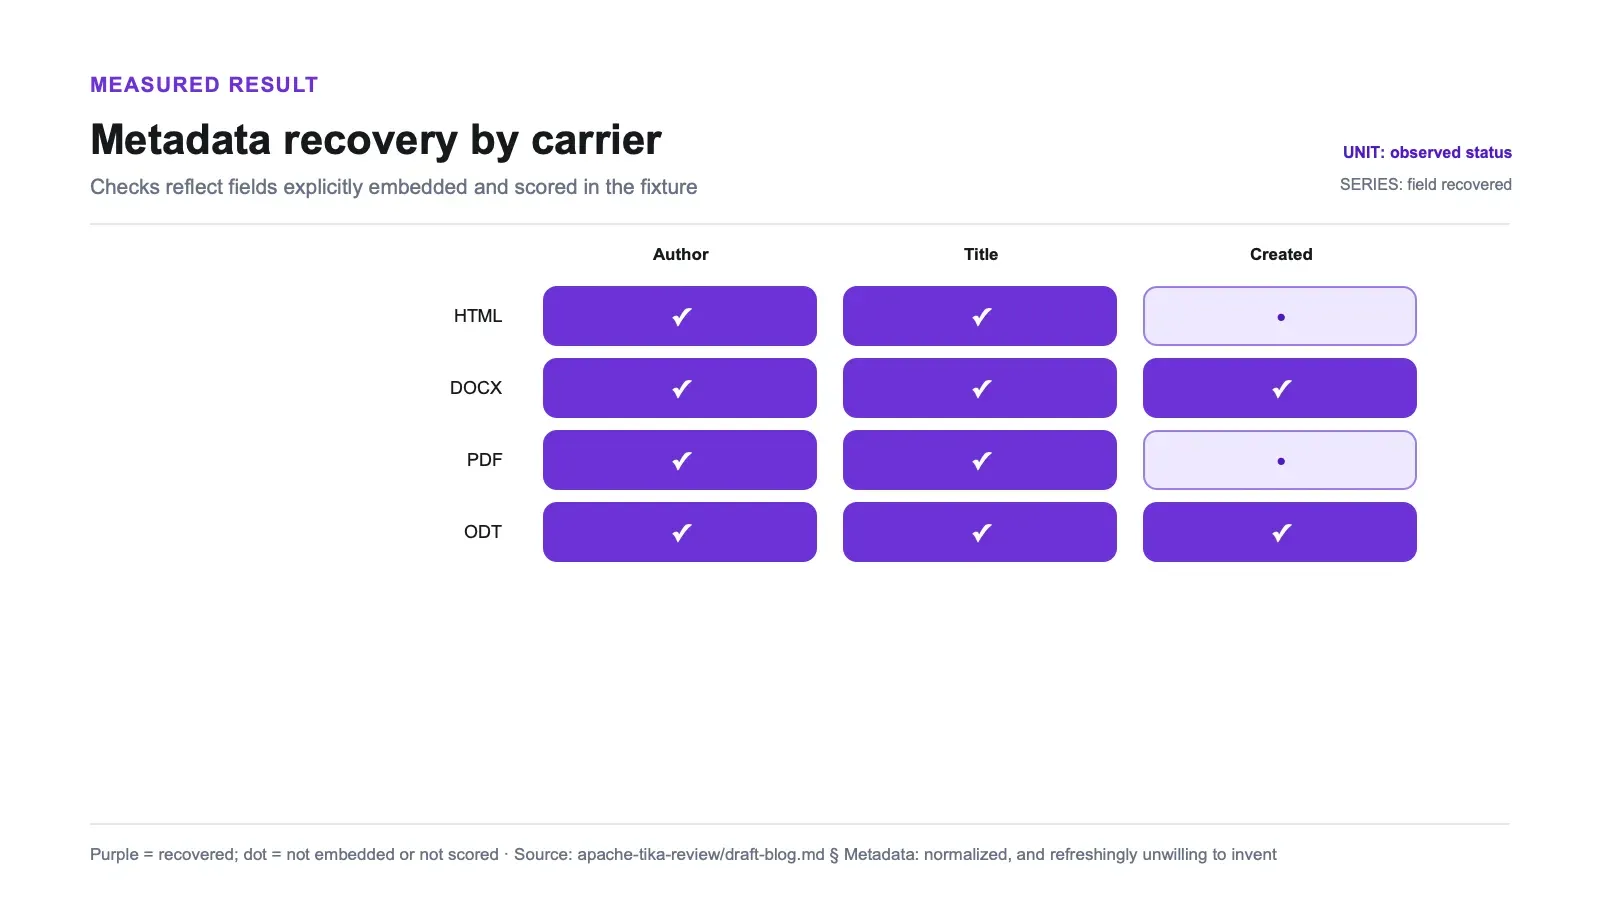
Tôi nhúng giá trị author, title và ngày tạo đã biết vào mọi carrier có lớp metadata, rồi kiểm tra thứ trả về.
| Carrier | author → dc:creator | title → dc:title | created → dcterms:created |
|---|---|---|---|
HTML (<meta name=author>, <title>) | ✅ | ✅ | không nhúng |
| DOCX (core properties) | ✅ | ✅ | ✅ chính xác 2021-03-15T09:30:00Z |
| PDF (info dict) | ✅ | ✅ | có, nhưng đó là timestamp do chính generator gắn — không tính điểm |
ODT (meta.xml) | ✅ | ✅ | ✅ chính xác 2021-03-15T09:30:00Z |
| TXT / MD / CSV / RTF / XML | không có lớp metadata | — | — |
Author và title được khôi phục trên 4 trên 4 carrier có metadata, và — phần đáng giá ở đây — chúng được chuẩn hóa. Một thẻ HTML <meta name="author">, core property của DOCX, mục /Author trong PDF, và phần tử dc:creator của ODT đều đi vào cùng một key dc:creator. Bạn chỉ cần viết một consumer, không phải bốn.
created mới là chỗ lệch trung thực. DOCX và ODT trả lại đúng timestamp 2021 mà tôi nhúng vào. PDF thì có ngày tạo, nhưng đó là ngày thư viện generator đóng dấu lúc build, không phải giá trị tôi định nhúng — nên tôi chấm là có xuất hiện, chứ không phải khôi phục đúng. Và các định dạng không có lớp metadata thì không hiện ra gì cả, và đó là câu trả lời đúng. Tika không tự bịa author từ phần thân văn bản.
Cố tình phá nó, và mẹo phân luồng phát sinh từ đó
Bốn đầu vào độc hại. Một file rỗng byte. Một PDF hợp lệ chỉ còn header, phần thân bị cắt bỏ. Một ZIP DOCX bị truncation. Và một file UTF-8 chứa ký tự đa byte nhưng không BOM, không khai báo encoding. Đây là các hình dạng fixture cục bộ, không phải ngưỡng của Tika.
Harness nền, các fixture được sinh, raw JSON, checksum của jar, và manifest môi trường không được liên kết công khai ở đây, nên người ngoài không thể tự tái tạo chính xác các mẫu số. Hãy xem các bảng dưới đây như quan sát đã được báo cáo, không phải bằng chứng có thể kiểm chứng độc lập từ bên thứ ba.
| Input | --text / --json | Nó ném ra gì | --detect |
|---|---|---|---|
| File 0 byte | exit 1, stdout trống | ZeroByteFileException: InputStream must have > 0 bytes | exit 0 → text/plain với tên tệp, application/octet-stream từ stream |
| PDF bị cắt dở | exit 1, stdout trống | TikaException: TIKA-198: Illegal IOException from PDFParser | exit 0 → application/pdf |
| DOCX bị cắt dở | exit 1, stdout trống | POI FATAL: "XML document structures must start and end within the same entity" | exit 0 → kiểu OOXML |
| UTF-8, không BOM, không khai báo | exit 0 | không có gì | exit 0 → text/plain, charset UTF-8 |
Trích xuất lỗi rất rõ ràng, và các lỗi này có cùng hình dạng bên ngoài. File rỗng byte, PDF bị cắt dở, và DOCX bị cắt dở đều tạo ra exception, exit 1, và stdout rỗng. CLI không nuốt lỗi để trả về một kết quả rỗng gọn gàng. Ở các trường hợp này, nó an toàn về tiến trình — không treo, không segfault — nhưng caller phải kiểm tra exit status và stderr, chứ không chỉ nhìn xem có chuỗi rỗng hay không.
Nhận diện tách rời khỏi phân tích. Trên cả hai binary bị cắt dở, --detect vẫn trả exit 0 với kiểu mong đợi từ phần đầu còn nguyên; parser sau đó mới thất bại vì thân file hỏng. Vì vậy một pipeline có thể dùng nhận diện như tín hiệu phân luồng riêng trước hoặc sau một lần parse thất bại. Việc detect-first có phải mặc định tốt hay không còn tùy chế độ triển khai: bài test này không benchmark detect-first so với parse-only, và hai lần khởi chạy CLI JVM mới có thể là cái giá không đáng ở quy mô lớn.
Nhận diện charset hoạt động. File UTF-8 không BOM, không khai báo được decode là UTF-8 và 日本語テスト đi qua nguyên vẹn. Một lưu ý nhỏ cho ai đọc metadata dict: các fixture ASCII thuần của tôi báo charset=ISO-8859-1, điều này không phân biệt được với UTF-8 trên byte ASCII. Đó không phải lỗi bỏ sót, mà là một thế hòa.
Tika bên cạnh unstructured: cùng kiểu file, khác nhiệm vụ
Cả hai đều được chạy trong cùng một phiên nghiên cứu, nhưng đây là phân loại hợp đồng đầu ra, không phải một benchmark đối xứng. Hai công cụ được chấm trên các kết quả khác nhau.
Bài liên quan: Đánh giá Unstructured.
| Apache Tika | unstructured | |
|---|---|---|
| Tôi đo trên gì | độ trung thực nội dung: có gì bị rơi mất không? | độ chính xác phân loại phần tử: mỗi block có đúng kiểu không? |
| Kết quả | mọi marker đã cài đều có mặt trên cả mười bốn bản render | trong bài test phân loại riêng, một bảng văn bản thuần cho recall Table bằng 0.000, và một heading có chứa động từ bị phân loại thành narrative text |
| Phần tử có kiểu trả về | không có — cấu trúc không được trả lại | Title, NarrativeText, ListItem, Table — chính xác thứ mà Tika từ chối làm |
| OCR | bị chặn trên máy tôi, thiếu tesseract | bị chặn trên máy tôi, thiếu tesseract |
Đầu ra phẳng nhưng giữ marker so với đầu ra có kiểu phần tử nhưng có lỗi phân loại quan sát được. Hãy chọn theo nhu cầu của consumer phía sau. Nếu đó là search index hay cửa sổ ngữ cảnh của LLM, văn bản phẳng có thể là đủ. Nếu nó phụ thuộc vào kiểu phần tử, đường --text của Tika không thể cung cấp hợp đồng đó.
Cả hai bên đều không có số liệu cho tài liệu scan.
Ưu và nhược điểm
Ưu điểm
- Nhận diện kiểu nội dung bỏ qua tên tệp nói dối trong 20/20 điều kiện logic duy nhất trên năm fixture có thể nhận diện bằng nội dung; các lần chạy stream lặp cũng khớp.
- Mọi marker được cài đều sống sót trong cả 14 bản render, bao gồm các ô bảng và mục danh sách có gắn nhãn.
- Có thể lặp lại ổn định trong ba lần chạy lại cục bộ: mỗi carrier trả về text giống hệt byte trong môi trường này.
- Metadata được chuẩn hóa xuyên định dạng —
dc:creator/dc:title/dcterms:createdbất kể format nguồn, và khôi phục được trên 4/4 carrier có metadata. - Thực sự không phụ thuộc gì thêm cho các định dạng tôi test: text layer PDF, DOCX, ODT, RTF, HTML đều parse từ một jar mà không cần binary bên ngoài.
- Chạy sạch trên OpenJDK 26 — không bị ràng buộc phải dùng LTS.
- Nhận diện vẫn đúng (exit 0) trên binary bị cắt dở, cho bạn tín hiệu phân luồng đáng tin khi parse thất bại.
- Apache-2.0, trưởng thành, được duy trì tích cực.
Nhược điểm
- Markdown và CSV phụ thuộc hoàn toàn vào phần mở rộng; 10 trong 18 ô không có chữ ký đặc trưng rơi về
text/plainkhi tên tệp bị mất hoặc sai. --textkhông trả về kiểu phần tử; lưới bảng bị làm phẳng thành các dòng nối tab và dấu đánh dấu cấu trúc của danh sách bị mất.- Trích xuất ném lỗi không được bắt trên đầu vào rỗng và hỏng; hai trường hợp trông giống hệt nhau nếu chỉ nhìn vào lệnh trích xuất.
- Jar 67 MB cộng với cold start JVM cho mỗi lần gọi ở chế độ CLI.
- OCR và PDF scan chỉ chứa ảnh hoàn toàn không được test ở đây — thiếu tesseract và poppler, nên không có bất kỳ kết luận nào về đường này.
- Mọi con số ở đây đều là ground truth tổng hợp trên một máy, một phiên bản. Độ chính xác trên corpus thật, file mã hóa, tài liệu nhúng/đệ quy, và throughput ở quy mô lớn đều chưa được đo.
Ai nên dùng, và ai không nên
Tika phù hợp khi đầu vào của bạn là các tệp đã có sẵn và đầu ra cần là văn bản plus metadata để máy có thể lập chỉ mục. Search indexing, e-discovery, xử lý lưu trữ, đưa corpus vào LLM, xây lớp kiểm tra loại nội dung của một pipeline upload. Nó hữu ích như một bước sàng lọc và chuẩn hóa ban đầu trước một thứ thông minh hơn: nhận diện các kiểu đã test, trích xuất text phẳng, rồi chuyển tiếp với các kiểm tra rõ ràng cho nội dung mà pipeline của bạn không thể để mất.
Hãy bỏ qua nó — hay đúng hơn, đừng dừng ở --text — nếu bạn cần phần tử có kiểu, bảng được tái dựng, hoặc bố cục tài liệu. Cũng nên bỏ qua nếu tài liệu của bạn là bản scan, ít nhất cho đến khi bạn cài tesseract và tự chạy số liệu của mình, vì tôi không có gì để cung cấp ở đó. Với bài toán khối lượng lớn, hãy benchmark chế độ library hoặc server so với CLI trên tài liệu đại diện. Chi phí khởi động process đã lộ ra trong harness file nhỏ này, nhưng throughput và chi phí tài nguyên thì chưa được đo.
Có một điểm dễ khiến người ta vấp: nếu lớp lưu trữ của bạn lược bỏ tên tệp và bạn xử lý Markdown hoặc CSV, đừng trông chờ Tika phân biệt chúng với plain text. Hãy giữ lại tên gốc.
Các lựa chọn thay thế, và Thunderbit nằm ở đâu
Trước hết nói công bằng, vì so sánh trung thực ở đây là về đầu vào, không phải chất lượng. Tika là một toolkit miễn phí, Apache-2.0, tự host để parse tệp. Những file bạn đã có trên đĩa hoặc trong bucket. Nó không đi fetch trang, không chạy JavaScript, không xử lý anti-bot, và cũng không giả vờ là có làm.
Đó là ranh giới nơi một dịch vụ trích xuất web được quản lý, bao gồm chính Thunderbit của chúng tôi, có thể xuất hiện trong kiến trúc: nó lấy trang live, còn Tika parse các tệp đã nằm trong tay bạn. Bài viết này không benchmark các dịch vụ đó so với Tika, và chúng không phải là vật thay thế cho cùng một đầu vào.
Chia tách rõ ràng là: Tika dành cho tài liệu bạn đã sở hữu, còn một API trích xuất được quản lý dành cho các trang web bạn cần đi lấy. Rất nhiều pipeline dùng cả hai — crawl và extract ở phía web, Tika cho các file PDF và DOCX được trả về.
Nếu bạn đang so sánh trong phạm vi open-source rộng hơn, tôi đã có bài so sánh đầy đủ các scraper mã nguồn mở, một khảo sát về những dự án scraping hữu ích nhất trên GitHub, bài đánh giá Crawl4AI thực chiến về cách tiếp cận Markdown dựa trên browser, và một tổng hợp rộng hơn về các công cụ scraping. Với hướng no-code, cũng có hướng dẫn cách scrape một trang web bằng AI.
Dùng thử Thunderbit để trích xuất dữ liệu web
Kết luận
Có nên dùng Apache Tika không? Có, nếu công việc của bạn là biến các tệp dị biệt thành văn bản phẳng và metadata đã chuẩn hóa, và bạn có bước xác thực cho các field hoặc marker mà pipeline của bạn không được phép làm mất.
Bộ nhận diện là phần mạnh nhất của lần thử này. Nó trả đúng kiểu trong 20 trên 20 điều kiện logic duy nhất cho năm fixture có thể nhận diện bằng nội dung, kể cả luồng không có tên tệp. Mọi marker được cài đều sống sót qua mười bốn bản render, và đầu ra lặp lại byte-for-byte trong ba lần chạy lại cục bộ. Bằng chứng hữu ích. Dù vậy, vẫn là bằng chứng tổng hợp. Việc thực hiện chỉ bằng một jar trên JDK này, không cần binary bên ngoài cho các đường không phải OCR đã test, khiến triển khai khá nhàn.
Nhưng hãy định cỡ cho đúng. Mọi bảng bạn đưa vào đều quay ra thành các dòng nối tab. Mọi marker cấu trúc của danh sách đều biến mất. Markdown và CSV mất danh tính ngay khi tên tệp biến mất. File rỗng và file hỏng ném ra cùng một dạng lỗi, và bạn sẽ cần lệnh detect riêng để phân biệt. Còn OCR, câu hỏi mà nhiều người dùng Tika quan tâm nhất, thì tôi không có gì để nói: tôi không chạy được, và tôi sẽ không ước lượng.
Trong những giới hạn đó, Tika làm tốt một việc tẻ nhạt với độ tin cậy khác thường. Nó đọc bytes, không đọc nhãn trên hộp. Chỉ là đừng bắt nó nói cho bạn biết hình dạng của những bytes đó.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Apache Tika có nhận diện đúng kiểu tệp khi phần mở rộng sai không?
Với năm fixture có thể nhận diện bằng nội dung được test ở đây, có. PDF, DOCX, RTF, HTML và XML đều được gán đúng media type trong toàn bộ 20 điều kiện logic duy nhất (30 lượt chạy raw gồm các lần stream lặp), kể cả khi phần mở rộng cố tình gây hiểu lầm, không có phần mở rộng, hoặc luồng không có tên tệp. Một PDF tên .txt vẫn được nhận là application/pdf. Markdown và fixture CSV nhỏ thì phụ thuộc vào thông tin tên tệp và rơi về text/plain khi nó bị thiếu hoặc sai.
Tika có giữ lại bảng và cấu trúc tài liệu không?
Không ở chế độ --text được test tại đây. Lưới bảng quay về thành các dòng nối tab, không còn ngữ nghĩa ô hay header, và các marker cấu trúc của danh sách (một <li> của HTML, hoặc style List Bullet trong DOCX) biến mất. Mọi marker được cài đều sống sót qua toàn bộ 14 bản render, nhưng điều đó không chứng minh tính toàn vẹn nội dung hoàn chỉnh, và --text cũng không cung cấp kiểu phần tử. Nếu bạn cần phần tử có kiểu hoặc bảng được tái dựng, hãy test một output handler khác của Tika hoặc dùng công cụ khác kèm theo.
Apache Tika có OCR được PDF scan không? Tika hỗ trợ OCR thông qua Tesseract, nhưng tôi không test nó, và không một kết quả nào ở đây là kết luận về phần đó. Máy test của tôi không có Tesseract và poppler, nên mọi đường OCR và PDF chỉ chứa ảnh đều bị chặn trước khi chạy. Ở đây không có số liệu OCR nào cả. Nếu OCR là use case của bạn, hãy cài tesseract và tự benchmark — hãy xem phần đó của Tika là chưa được xác minh trong bài test này.
Tika làm gì với file rỗng hoặc file bị hỏng?
Nó thất bại rõ ràng chứ không âm thầm bỏ qua. File 0 byte ném ZeroByteFileException; PDF bị cắt dở ném TikaException từ PDFParser; DOCX bị cắt dở ném lỗi XML của POI. Cả ba đều exit 1 với stdout rỗng, nên file rỗng và file hỏng không thể phân biệt chỉ từ lệnh trích xuất. Tuy nhiên, nhận diện vẫn ổn định — --detect trả exit 0 với đúng kiểu trên cả hai binary bị cắt dở, nên đây là bước phân luồng đáng tin trước khi bạn tốn công parse.
Phần nào của quá trình test Tika chưa được bao phủ? Bốn thứ, nói rõ ràng. OCR và ảnh scan (bị chặn, chưa test). Độ chính xác trên corpus thật — mọi kết quả đều là fixture tổng hợp có kiểm soát với token đánh dấu được cài sẵn, tức là đo độ trung thực so với nhãn đã biết chứ không phải độ chính xác trên tài liệu thật lộn xộn. Chi phí tài nguyên, throughput, và peak memory, tôi không đo. Và đuôi dài của lời quảng cáo “hơn một nghìn định dạng tệp”: tôi chỉ test chín định dạng đại diện, không phụ thuộc bên ngoài, chứ không phải toàn bộ danh mục. Mọi thứ ở đây đều là Tika 3.3.2 trên OpenJDK 26.0.1, macOS arm64, một máy duy nhất.




