
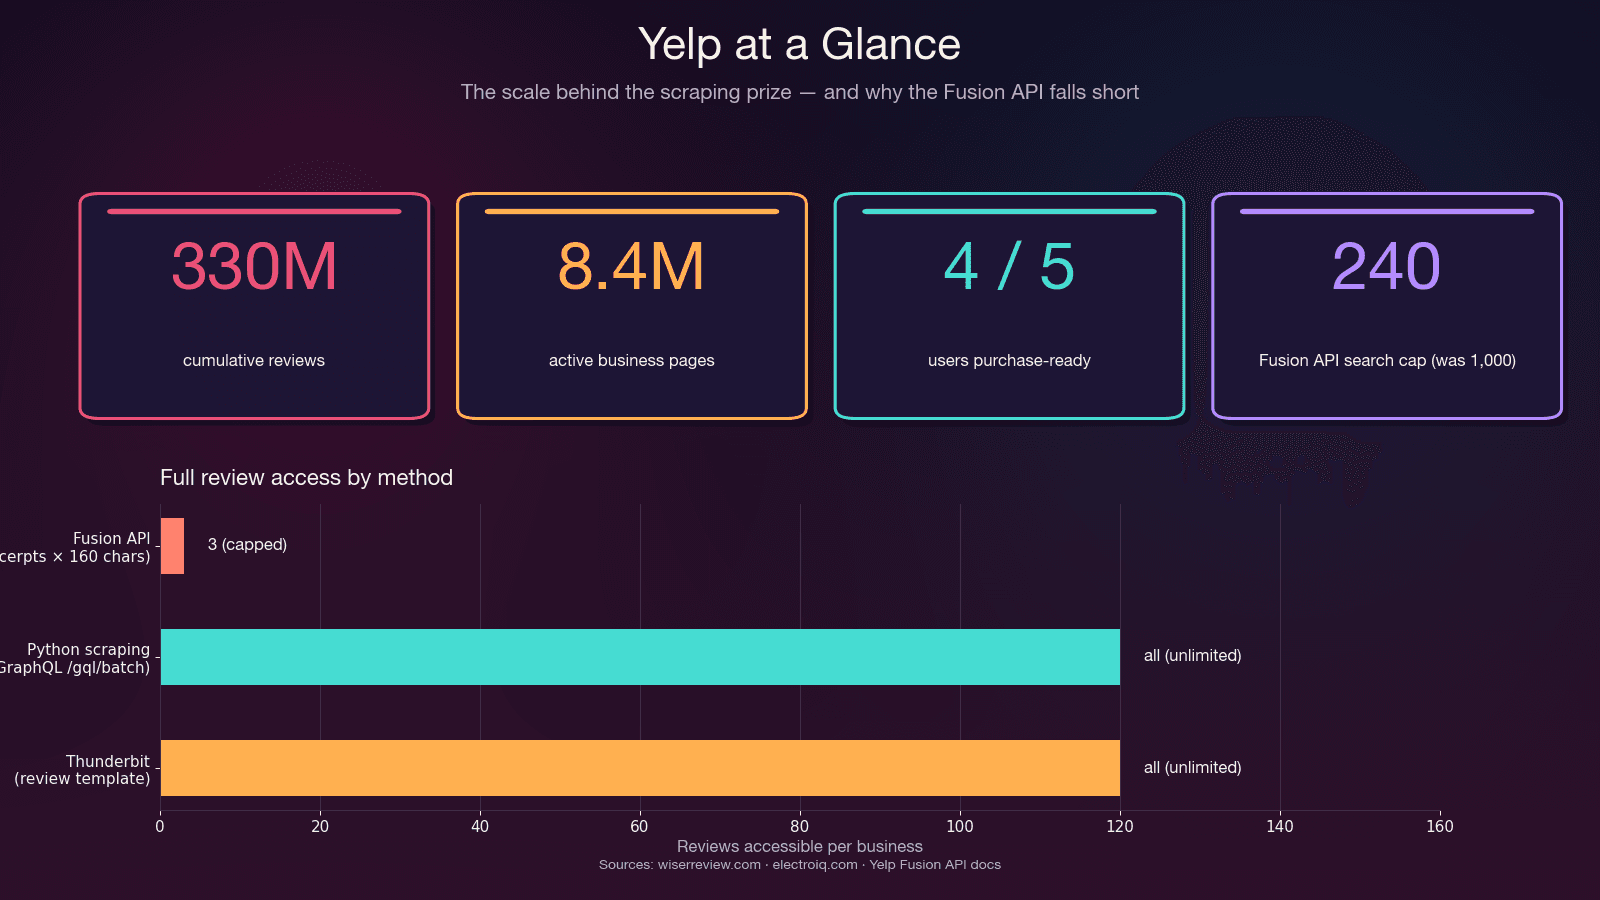
Yelp, 8,4 milyon aktif işletme sayfası üzerinde toplam 330 milyon yorum barındırıyor — ancak bu veriyi kullanılabilir bir formata dönüştürmek hiç olmadığı kadar zorlaştı. Yelp’in 2024–2025 dönemindeki anti-bot sertleşmesi, mevcut Python kazıma rehberlerinin çoğunu sessizce işlevsiz hale getirdi.
Yakın zamanda bir Yelp scraper çalıştırmaya çalışıp 403 hataları, boş HTML yanıtları ya da altı ay önce olmayan CAPTCHA’larla karşılaştıysanız, bunu siz uydurmuyorsunuz. Yelp artık TLS/JA3 parmak izi kontrolü, sürekli değişen gizlenmiş CSS sınıf adları ve agresif IP itibarı puanlaması kullanıyor — yani hâlâ pek çok rehberin önerdiği eski requests + BeautifulSoup yaklaşımı ilk istekte çöküyor. Son birkaç haftayı Yelp’in güncel altyapısına karşı farklı yöntemleri test ederek geçirdim; bu rehber 2025’te gerçekten çalışan her şeyi kapsıyor: resmi Fusion API’yi (ve neden büyük olasılıkla yeterli olmayacağını), katmanlı bir engel aşma stratejisiyle tam bir Python kazıma iş akışını ve sadece veriyi almak isteyip debug maratonuna girmek istemeyen okuyucular için Thunderbit ile 2 tıkla çalışan no-code alternatifi.
Yelp Kazıma İçin Thunderbit’i Deneyin
Neden Python ile Yelp Kazıyorsunuz ve Asıl Kimler Faydalanıyor?
Kod yazmaya başlamadan önce asıl soru şu: Yelp verisini neden topluyorsunuz? Bu platform sadece bir restoran yorum sitesi değil — yapılandırılmış iletişim bilgileri, puanlar, kategoriler, çalışma saatleri ve yüz milyonlarca müşteri yorumu içeren canlı bir yerel işletme veritabanı gibi çalışıyor.
En çok kimler yararlanıyor ve neyi çekiyorlar, bakalım:
| Kullanım Senaryosu | Temel Veri Alanları | Neden Önemli? |
|---|---|---|
| Satış ve lead oluşturma | İşletme adı, telefon, web sitesi, adres, kategori, puan | Yerel KOBİ’lerden oluşan hedefli potansiyel müşteri listeleri oluşturun — Yelp kullanıcılarının 5’te 4’ü satın almaya hazır şekilde geliyor |
| Rekabet analizi | Yorumlar, yıldız puanları, yorum hacmi, duygu analizi | Rakip itibarını izleyin, hizmet boşluklarını bulun, trendleri takip edin |
| Pazar araştırması ve NLP | Tam yorum metni, tarihler, yorumcu meta verileri | Duygu analizi, konu modelleme — Yelp yorumları akademik araştırmada en çok kullanılan NLP veri kümelerinden biri |
| Gayrimenkul ve lokasyon seçimi | Bölge bazında işletme yoğunluğu, kategori karması, yorum kalitesi | Franchise ve perakende lokasyon seçimi — Yelp bu amaçla Location Intelligence ürününü lisanslı B2B çözüm olarak satıyor |
| E-ticaret ve operasyonlar | Fiyat sinyalleri, müşteri şikâyetleri, hizmet saatleri | Rakiplerin nasıl yorumlandığını izleyin, operasyonel kalıpları belirleyin |
Ortak nokta şu: asıl hedef yapılandırılmış veridir ve Python yalnızca buna ulaşmak için bir araçtır. Bazı okuyucular tam programatik kontrol ister. Bazıları ise Austin’deki tesisatçıların iletişim bilgilerini içeren bir tabloya ihtiyaç duyar. Bu rehber her iki yolu da kapsıyor.
Yelp Fusion API mi, Python Web Scraping mi? Hangisini Kullanmalısınız?
Birçok rehber bu kararı hiç tartışmadan doğrudan koda atlıyor; oysa resmi Yelp Fusion API (“Yelp Places API” olarak yeniden markalandı) işinizi görür müydü, değerlendirmek saatlerce boşa uğraşmaktan kurtarabilir. Deneyimlerime göre API bazı işler için harika, bazıları için ise tamamen yetersiz.
Fusion API Gerçekte Neler Sunuyor?
Fusion API; yapılandırılmış işletme araması, işletme detayları, otomatik tamamlama ve bir yorum uç noktası sunuyor. Yetkili, dokümante edilmiş ve anti-bot numaralarına gerek duymaz.
Ama yorum uç noktasında işler kopuyor. Yelp çalışanlarının GitHub’da doğruladığı şey şu:
"Yelp API tam yorum metnini döndürmez. Varsayılan olarak 160 karakterlik üç yorum alıntısı sağlanır." — Yelp çalışanı yanıtı, GitHub Issue #163
Bu bir hata değil — tasarım gereği böyle. API fiziksel olarak 3 yorum alıntısıyla sınırlı (Premium’da 7); her biri yaklaşık 160 karaktere kırpılıyor. Yorum meta verisi yok (useful/funny/cool oyları), yorumcu geçmişi yok, işletme sahibinin yanıtı yok. Ayrıca yeni müşteriler için günlük oran limiti Mayıs 2023 sonrası 300–500 çağrı/gün seviyesine indi — eskiden 5.000’di. Giriş fiyatı $29/ay seviyesinden başlıyor.
Karar Çerçevesi
| Kriter | Yelp Fusion API | Python Web Scraping | Thunderbit (No-Code) |
|---|---|---|---|
| Tam yorumlar | ❌ Yalnızca 3 alıntı (~160 karakter) | ✅ GraphQL ile tüm yorumlar | ✅ Görünen tüm yorumlar |
| Oran limitleri | 300–500/gün (yeni); 5.000 (eski) | Sizin yönettiğiniz (proxy bütçesi) | Kredi bazlı |
| Kurulum zahmeti | ~15 dk (API anahtarı + SDK) | Saatler ila günler | ~2 dakika |
| İşletme alanları | ~20 yapılandırılmış alan | Sınırsız (HTML/JSON ayrıştırma) | AI’nın önerdiği alanlar |
| Anti-bot yönetimi | Yok (yetkili) | Kendiniz kurmalısınız | Otomatik halledilir |
| Hukuki risk | ✅ Yetkili | ⚠️ ToS gri alanı | ⚠️ Kazıma ile aynı |
| Maliyet | Minimum $29/ay | Ücretsiz (+ proxy maliyeti $0,75–$4/GB) | Ücretsiz plan mevcut |
| Bakım | Düşük (API stabil) | Yüksek (selector’lar bozulur, anti-bot sertleşir) | Düşük (AI yeniden uyarlanır) |
Fusion API’yi kullanın, eğer: temel işletme bilgisine, küçük ölçekli sorgulara ya da yetkili bir entegrasyona ihtiyacınız varsa — ve işletme başına 3 yorum özeti sizin için yeterliyse.
Python kazıma kullanın, eğer: tam yorum metnine, bir işletmeye ait tüm yorumlara, yorum meta verisine, arama başına 240’tan fazla sonuca ya da 29$/ay altı bütçeye ihtiyacınız varsa.
Thunderbit kullanın, eğer: kod yazmadan, kod bakımına girmeden veriyi hızlıca almak istiyorsanız. Aşağıdaki no-code bölümde buna daha detaylı değineceğim.
No-Code Kestirme Yol: Thunderbit ile Yelp Kazıma (Python Gerekmez)
Python derin dalışına geçmeden önce, gerçek hedefi veri olan okuyucular için en hızlı yolu söyleyelim. Rakip rehberlerin hepsi Python bilgisi varsayıyor; ancak Thunderbit’teki işimde, "scrape Yelp" araması yapanların büyük kısmının satış temsilcileri, operasyon yöneticileri ve küçük işletme sahipleri olduğunu gördüm. Bunların derdi TLS parmak izi değil, yerel işletmelerin bir Excel tablosu.
Thunderbit hazır Yelp şablonlarıyla geliyor:
- Yelp İşletme Web Scraper — işletme adı, puan, iletişim bilgileri, adres, çalışma saatleri, kategori çeker
- Yelp Yorum Scraper — yorumcu kullanıcı adı, yorum içeriği, puan, tarih, yorumcu konumu çeker
Gerçekte Nasıl Çalışır?
- Chrome’da bir Yelp arama sonucu ya da işletme sayfası açın
- Thunderbit uzantısında AI Alanları Öner’e tıklayın — AI sayfayı okur ve sütunları önerir (işletme adı, puan, yorum sayısı, fiyat aralığı, kategori, adres, telefon, URL)
- Kazı’ya tıklayın — bitti
Hazır Yelp şablonlarında iş daha da kolay: şablonu açın, Kazı’ya tıklayın.
Alt sayfa kazıma, zenginleştirme döngüsünü otomatik yönetir — bir Yelp arama sonucu sayfasından başlayın, alt sayfa kazımayı açın, Thunderbit her işletme sayfasına giderek çalışma saatlerini, tam yorumları, web sitesini, fotoğrafları ve olanakları çeker. Ek kurulum yok.
Sayfalama otomatik — hem tıklamalı hem kaydırmalı akışlar kutudan çıktığı gibi desteklenir. (Bu işleyiş hakkında daha fazla bilgi için sayfalama rehberimize bakın.)
Tüm plânlarda dışa aktarma ücretsiz — Excel, Google Sheets, Airtable, Notion, CSV, JSON. Pandas yok, CSV yazma kodu yok.
Zaman Karşılaştırması
| Süre | Python Scraper | Thunderbit |
|---|---|---|
| İlk çalıştırma | Saatler ila günler (selector yazma, sayfalama, proxy, yeniden deneme mantığı) | Hazır Yelp şablonuyla ~30 saniye |
| Yelp işaretlemesi değiştiğinde | Selector’ları manuel yeniden yazmanız gerekir | Tekrar AI Alanları Öner’e tıklayın — otomatik uyarlanır |
| IP engellenirse | Hata ayıklayın, proxy havuzunu değiştirin, yeniden test edin | Cloud modu IP rotasyonunu yönetir |
| Google Sheets’e aktarım | OAuth + pandas bağlantı kodu yazın | Tek tıkla, ücretsiz |
Önce Thunderbit’i deneyip ihtiyaçlarınızı karşıladığını görürseniz, bu makalenin geri kalanını atlayabilirsiniz. Tam programatik kontrol, özel alanlar ya da ayda birkaç bin kaydın ötesinde ölçek gerekiyorsa okumaya devam edin.
Yelp Kazımak İçin Python Kütüphaneleri: Hangisini Seçmelisiniz?
"Scrapy mi, BS4+requests mi, Selenium mu kullanmalıyım?" sorusu, Yelp hakkında r/webscraping başlıklarında en sık sorulan sorulardan biri. Ama çoğu rehber sadece sevdiği kütüphaneyi seçip nedenini anlatmadan geçiyor. İşte dürüst döküm.
2025 Gerçeği: requests + BeautifulSoup Yelp İçin Bozuk
Klasik Yelp rehberlerinin önerdiği yığın — pip install requests beautifulsoup4 — 2025’te ilk istekte engelleniyor. 50’nci istekte değil. İlk istekte.
Sebep şu: Python’un requests kütüphanesi, gerçek bir tarayıcıyla eşleşmeyen bir TLS/JA3 parmak izi gönderiyor. Yelp’in anti-bot katmanı bunu User-Agent başlığı okunmadan önce, TLS el sıkışması seviyesinde işaretliyor. Bunu defalarca test ettim — yeni IP, gerçekçi başlıklar, rastgele gecikmeler — ama yine de sade requests ile anında 403 Forbidden aldım.
Kütüphane Karar Matrisi
| Kütüphane | En İyi Kullanım | JS Destekler mi? | Anti-Bot? | Öğrenme Eğrisi | Hız |
|---|---|---|---|---|---|
requests + BeautifulSoup | ❌ | ❌ | Çok düşük | Hızlı (engellenene kadar) | |
httpx async + parsel | Büyük ölçekli asenkron kazıma | ❌ | ❌ | Düşük | Çok hızlı |
curl_cffi + parsel | Yelp’e özel: TLS taklidi | ❌ | ✅ TLS/JA3/HTTP2 | Düşük | Çok hızlı |
Scrapy 2.14 | Sayfalama içeren tam tarama boru hatları | Kısmi (scrapy-playwright ile) | AutoThrottle, retry middleware | Orta-Yüksek | Hızlı |
Selenium 4.43 / Playwright 1.58 | JS ağırlıklı sayfalar, CAPTCHA etrafından dolaşma | ✅ | Kısmi | Orta | Yavaş (~10–30 sayfa/dk) |
| Thunderbit | Kod yazmayanlar, hızlı çıkarım | ✅ (tarayıcı) | Dahili (Cloud modu) | Çok düşük | Hızlı |
curl_cffi Neden Oyun Değiştiriyor?
Yelp kazıma iş akışımı değiştiren kütüphane curl_cffi oldu — curl-impersonate için bir Python bağlayıcısı. Gerçek Chrome ile aynı TLS/JA3 + HTTP/2 parmak izini üretir ve API’si requests için doğrudan bir alternatiftir:
from curl_cffi import requests

r = requests.get(
    "https://www.yelp.com/biz/some-restaurant",
    impersonate="chrome131",
)
print(r.status_code, len(r.text))
Sadece bu değişiklik — from curl_cffi import requests ve impersonate="chrome131" — tarayıcı açmadan Yelp’in en büyük anti-bot katmanını aşmanızı sağlar. Testlerimde bu, anında gelen 403’lerle temiz 200 yanıtları arasındaki fark oldu.
2025’te Yelp için önerdiğim yığın: curl_cffi + parsel + jmespath + residential proxy’ler. Planlı, tam bir tarama hattına ihtiyacınız varsa bunu Scrapy 2.14 içine gömüp curl_cffi tabanlı bir downloader middleware ile sarmalayın.
Yelp Kazımak İçin Python Ortamınızı Kurma
- Zorluk: Orta
- Gerekli Süre: Kurulum için ~15 dakika, çalışan bir scraper için 1–2 saat
- Gerekenler: Python 3.10+ (3.12 önerilir), bir terminal ve isteğe bağlı olarak residential proxy sağlayıcısı
Adım 1: Sanal Ortam Oluşturun ve Paketleri Kurun
python3.12 -m venv .venv
source .venv/bin/activate  # Windows'ta: .venv\Scripts\activate
pip install "curl_cffi>=0.11" "parsel>=1.9" "jmespath>=1.0" pandas
Her paketin görevi:
curl_cffi— Chrome’un TLS parmak iziyle HTTP isteği atar (anti-bot aşma katmanı)parsel— HTML ayrıştırmak için CSS/XPath seçicileri sağlar (Scrapy’nin kullandığı motorun daha hafif versiyonu)jmespath— JSON sorgulama için bildirimsel bir dil sunar (Yelp’in gömülü JSON’unda iç içe sözlük erişiminden daha temiz)pandas— veriyi CSV/Excel’e aktarmak için kullanılır
İsteğe bağlı ama faydalı:
pip install fake-useragent # Not: depo Nisan 2026'da arşivlendi ama hâlâ kurulabiliyor
Adım Adım: Python ile Yelp Nasıl Kazınır?
Bu bölüm rehberin kalbi. Her şeyi daha dayanıklı yapan temel fikir şu: CSS selector’ları atlayın, gizli JSON’u çekin. Yelp CSS sınıf adlarını derleme sırasında rastgeleleştiriyor (y-css-14xwok2 bir hafta, y-css-hcq7b9 ertesi hafta), bu yüzden onlara kilitlenen her scraper birkaç hafta içinde bozuluyor. Oysa gömülü JSON yükleri — application/ld+json şeması ve react-root-props — stabildir.
Adım 2: Yelp Arama Sonuçlarını Kazıyın
Yelp arama URL’leri tahmin edilebilir bir yapı izler: https://www.yelp.com/search?find_desc={term}&find_loc={location}. Arama sonuç verileri CSS sınıf yığını içinde değil, bir <script data-id="react-root-props"> etiketi içine JSON olarak gömülüdür.
import re, json, jmespath
from curl_cffi import requests
from parsel import Selector

HEADERS = {
    "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/124.0.0.0 Safari/537.36",
    "accept": "text/html,application/xhtml+xml,application/xml;q=0.9,"
              "image/avif,image/webp,image/apng,*/*;q=0.8",
    "accept-language": "en-US,en;q=0.9",
    "accept-encoding": "gzip, deflate, br",
    "cookie": "intl_splash=false",
}

def scrape_search(term: str, location: str, max_pages: int = 3):
    results = []
    for page in range(max_pages):
        url = (f"https://www.yelp.com/search?"
               f"find_desc={term}&find_loc={location}&start={page * 10}")
        r = requests.get(url, headers=HEADERS, impersonate="chrome131")
        if r.status_code != 200:
            print(f"Sayfa {page} üzerinde engellendi: {r.status_code}")
            break
        sel = Selector(text=r.text)
        script = sel.xpath(
            "//script[@data-id='react-root-props']/text()"
        ).get() or ""
        m = re.search(r"react_root_props\s*=\s*(\{.*?\});", script, re.S)
        if not m:
            print(f"Sayfa {page} üzerinde react-root-props bulunamadı — muhtemel yumuşak blok")
            break
        data = json.loads(m.group(1))
        businesses = jmespath.search(
            "legacyProps.searchAppProps.searchPageProps"
            ".mainContentComponentsListProps"
            "[?searchResultBusiness].searchResultBusiness.{"
            "name: name, url: businessUrl, rating: rating, "
            "reviews: reviewCount, phone: phone, "
            "neighborhoods: neighborhoods}",
            data,
        ) or []
        results.extend(businesses)
        import time, random
        time.sleep(random.uniform(3, 7))
    return results
İşletme adları, URL’ler, puanlar ve yorum sayılarından oluşan bir dict listesi döndürmelisiniz. Eğer yanıtta react-root-props yoksa, size engel kabuğu servis edilmiştir — IP’nizi değiştirip tekrar deneyin.
Cookie: intl_splash=false başlığı, Yelp’in ülke karşılama yönlendirmesi için standart bir geçici çözümdür. Bu olmadan, ABD dışı IP’ler soft block’a benzeyen ama aslında farklı olan bir karşılama sayfasına düşer.
Adım 3: Yelp İşletme Sayfalarını Kazıyın
Arama sonuçlarındaki her işletme URL’si, daha zengin veriler içeren detay sayfasına götürür. En stabil çıkarım hedefi <script type="application/ld+json"> bloğudur — Yelp’in SEO için koruduğu ve gizlemediği schema.org verisini içerir.
def scrape_business(biz_url: str) -> dict:
    url = f"https://www.yelp.com{biz_url}" if biz_url.startswith("/") else biz_url
    r = requests.get(url, headers=HEADERS, impersonate="chrome131")
    if r.status_code != 200:
        return {"url": url, "error": r.status_code}
    sel = Selector(text=r.text)
    biz_id = sel.css('meta[name="yelp-biz-id"]::attr(content)').get()
    for raw in sel.css('script[type="application/ld+json"]::text').getall():
        try:
            data = json.loads(raw)
        except json.JSONDecodeError:
            continue
        for node in (data if isinstance(data, list) else [data]):
            if node.get("@type") in (
                "Restaurant", "LocalBusiness", "FoodEstablishment",
                "HealthAndBeautyBusiness", "HomeAndConstructionBusiness",
            ):
                return {
                    "biz_id": biz_id,
                    "name": node.get("name"),
                    "rating": (node.get("aggregateRating") or {}).get("ratingValue"),
                    "review_count": (node.get("aggregateRating") or {}).get("reviewCount"),
                    "address": node.get("address"),
                    "telephone": node.get("telephone"),
                    "price_range": node.get("priceRange"),
                    "hours": node.get("openingHours"),
                    "url": url,
                }
    return {"biz_id": biz_id, "url": url}
meta[name="yelp-biz-id"] değeri, yorum uç noktası için gereken kodlanmış işletme kimliğidir. Bunu burada alın — bir sonraki adımda kullanacaksınız.
Adım 4: Sayfalama ile Yelp Yorumlarını Kazıyın
İşte Fusion API’nin yetersiz kaldığı ve scraping’in parladığı yer burası. Yelp’in dahili GraphQL batch uç noktası tam yorum metnini, yorumcu bilgilerini, tarihleri, puanları ve oy sayılarını döndürür — API’nin sakladığı her şey burada vardır.
Uç nokta https://www.yelp.com/gql/batch ve GetBusinessReviewFeed işlemi için sabit bir documentId kullanıyor. Sayfalama base64 ile kodlanmış bir cursor üzerinden yapılır.
import base64

GQL_URL = "https://www.yelp.com/gql/batch"
DOC_ID = "ef51f33d1b0eccc958dddbf6cde15739c48b34637a00ebe316441031d4bf7681"

def fetch_reviews(enc_biz_id: str, num_pages: int = 5):
    all_reviews = []
    for page in range(num_pages):
        offset = page * 10
        cursor = base64.b64encode(
            json.dumps({"version": 1, "offset": offset}).encode()
        ).decode()
        payload = [{
            "operationName": "GetBusinessReviewFeed",
            "variables": {
                "encBizId": enc_biz_id,
                "reviewsPerPage": 10,
                "after": cursor,
                "sortBy": "DATE_DESC",
                "language": "en",
            },
            "extensions": {
                "operationType": "query",
                "documentId": DOC_ID,
            },
        }]
        r = requests.post(
            GQL_URL,
            json=payload,
            headers={
                **HEADERS,
                "content-type": "application/json",
                "x-apollo-operation-name": "GetBusinessReviewFeed",
                "apollographql-client-name": "yelp-main-frontend",
            },
            impersonate="chrome131",
        )
        if r.status_code != 200:
            print(f"Yorum çekimi offset {offset} noktasında başarısız oldu: {r.status_code}")
            break
        data = r.json()
        # Yorumları çıkarmak için yanıt yapısını gezin
        try:
            reviews = data[0]["data"]["business"]["reviews"]["edges"]
            for edge in reviews:
                node = edge.get("node", {})
                all_reviews.append({
                    "reviewer": node.get("author", {}).get("displayName"),
                    "rating": node.get("rating"),
                    "date": node.get("localizedDate"),
                    "text": node.get("text", {}).get("full"),
                })
        except (KeyError, IndexError, TypeError):
            break
        import time, random
        time.sleep(random.uniform(3, 7))
    return all_reviews
Her sayfa 10 yorum döndürür. Sayfalama yapmak için base64 cursor içindeki offset değerini artırın. sortBy parametresi DATE_DESC (en yeni önce), RATING_ASC, RATING_DESC ve başka değerler kabul eder.
Adım 5: Kazıdığınız Yelp Verisini Dışa Aktarın
import pandas as pd

# İşletmeleri ve yorumları topladığınızı varsayalım
df_businesses = pd.DataFrame(businesses)
df_businesses.to_csv("yelp_businesses.csv", index=False)

df_reviews = pd.DataFrame(all_reviews)
df_reviews.to_csv("yelp_reviews.csv", index=False)

# Ya da esneklik için JSON olarak kaydedin
import json
with open("yelp_data.json", "w") as f:
    json.dump({"businesses": businesses, "reviews": all_reviews}, f, indent=2)
No-code yolu seçen okuyucular için Thunderbit aynı veriyi doğrudan Excel, Google Sheets, Airtable veya Notion’a aktarır — pandas ya da dosya yazma kodu gerekmez.
Anti-Engel Oyun Planı: Yelp Engellenmeden Nasıl Kazınır?
Bu bölüm, makalenin var olma sebebinin ta kendisi. Yelp’in anti-bot önlemleri 2024 sonundan bu yana ciddi biçimde sertleşti — TLS fingerprinting, IP reputation kontrolleri, CAPTCHA’lar ve davranış analizi artık devrede. Mevcut rehberlerin çoğu eski çünkü bu sertleşmeden önce yazıldılar.
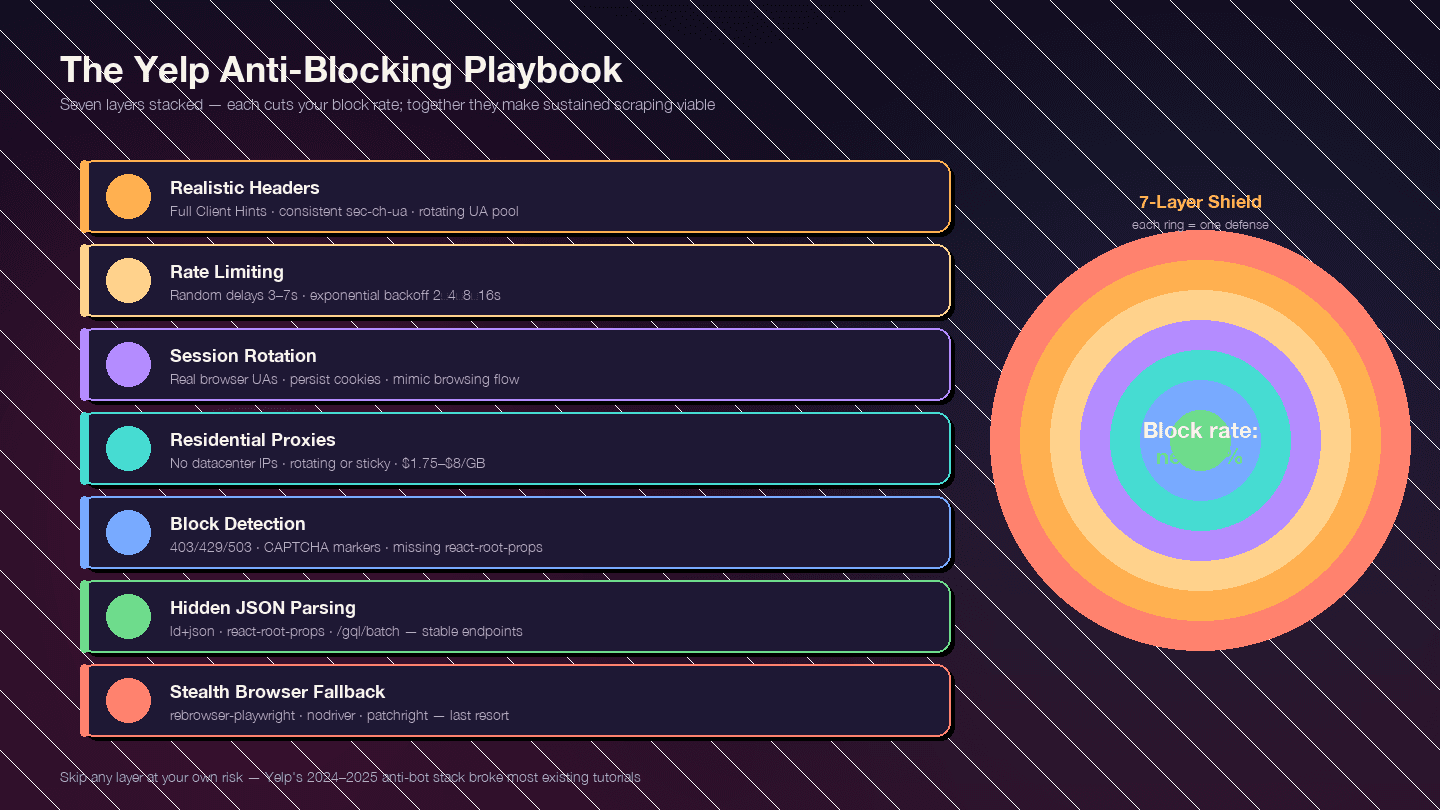
Strateji katmanlıdır. Her katman blok oranınızı düşürür; birlikte ise sürdürülebilir kazımayı mümkün kılar.
Katman 1: Gerçekçi İstek Başlıkları
Varsayılan Python requests başlıkları User-Agent: python-requests/2.x gönderir — bu da anında engellenir. Ama gerçekçi bir User-Agent bile yetmez. Yelp, tutarlılık için tam Client Hints başlık kümesini kontrol eder.
FULL_HEADERS = {
    "authority": "www.yelp.com",
    "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/124.0.0.0 Safari/537.36",
    "accept": "text/html,application/xhtml+xml,application/xml;q=0.9,"
              "image/avif,image/webp,image/apng,*/*;q=0.8",
    "accept-language": "en-US,en;q=0.9",
    "accept-encoding": "gzip, deflate, br",
    "sec-ch-ua": '"Chromium";v="124", "Google Chrome";v="124", "Not-A.Brand";v="99"',
    "sec-ch-ua-mobile": "?0",
    "sec-ch-ua-platform": '"Windows"',
    "sec-fetch-dest": "document",
    "sec-fetch-mode": "navigate",
    "sec-fetch-site": "same-origin",
    "sec-fetch-user": "?1",
    "upgrade-insecure-requests": "1",
    "referer": "https://www.yelp.com/",
    "cookie": "intl_splash=false",
}
Sizi işaretleyen üç hata:
- UA Chrome olduğunu söylüyor ama
sec-ch-uaeksik ya da UA sürümüyle çelişiyor sec-ch-ua-platform"Windows" diyor ama UA dizesi macOS gösteriyor- Aynı User-Agent binlerce istekte birebir aynen kullanılıyor — 10–20 güncel Chrome/Firefox/Safari dizesinden oluşan bir havuzla rotasyon yapın
Katman 2: Hız Sınırı ve Rastgele Gecikmeler
Öngörülebilir zamanlama desenleri kırmızı bayraktır. Rastgele uyku aralıkları ekleyin ve hata yanıtlarında üstel geri çekilme uygulayın.
import random, time

def polite_get(client_get, url, attempt=0):
    r = client_get(url, headers=FULL_HEADERS, impersonate="chrome131")
    if r.status_code in (403, 429, 503):
        if attempt >= 4:
            raise RuntimeError(f"{url} üzerinde {attempt + 1} denemeden sonra engellendi")
        backoff = 2 ** (attempt + 1) + random.random()
        print(f"  {r.status_code} alındı, {backoff:.1f}s geri çekiliyorum (deneme {attempt + 1})")
        time.sleep(backoff)
        return polite_get(client_get, url, attempt + 1)
    time.sleep(random.uniform(3, 7))
    return r
| Parametre | Önerilen Değer |
|---|---|
| İstekler arasında rastgele bekleme | random.uniform(3, 7) saniye |
| 429/403/503 için geri çekilme | 2 → 4 → 8 → 16 sn, en fazla 5 deneme |
| IP başına eşzamanlı iş parçacığı | 1 (IP başına seri çalışın; paralellik için proxy kullanın) |
| Residential IP başına sürdürülebilir maksimum oran | Yaklaşık 1 istek / 5 sn (~12 rpm) |
Katman 3: User-Agent ve Oturum Rotasyonu
Gerçek tarayıcı User-Agent dizeleri arasında rotasyon yapın. Oturumları ve çerezleri kalıcı tutarak gerçek gezinme davranışını taklit edin — Yelp çerez tabanlı tespit kullanır, bu yüzden her istek için sıfırdan oturum açmak da şüphelidir.
UA_POOL = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/124.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14_4_1) AppleWebKit/537.36 Chrome/124.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:125.0) Gecko/20100101 Firefox/125.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14.4; rv:125.0) Gecko/20100101 Firefox/125.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14_4_1) AppleWebKit/605.1.15 Safari/17.4.1",
    # 5-10 tane daha güncel dize ekleyin
]
Katman 4: Proxy Rotasyonu
Gerçek hacimde residential proxy gerekir. Datacenter ve ücretsiz proxy’ler Yelp üzerinde çalışmaz — Yelp’in IP itibar katmanı AWS, GCP ve DigitalOcean IP aralıklarını daha baştan 403’ler.
| Sağlayıcı | Giriş $/GB | Notlar |
|---|---|---|
| IPRoyal | $1,75/GB | En ucuz seçenek; en çok atıf alan Yelp rehberini çalıştırıyor |
| Decodo (eski Smartproxy) | $3,20–$3,50 | Hacimde GB/$ oranı çok iyi |
| Bright Data | $4,00 (kullandıkça öde) | 150M+ IP havuzu; Yelp’e özel sayfası var |
| Oxylabs | $6,00–$8,00 | Premium; 10M+ IP |
| Aluvia (mobil SIM) | $3,00 | Gerçek ABD operatör mobil IP’leri, Yelp için konumlandırılmış |
Rotating residential (her istekte yeni IP) yüksek hacimli arama taramaları için en iyi seçenektir. Sticky session’lar (10 dakika tek IP tutma) ise işletme sayfası → yorumlar → sayfalama akışında çerezleri korumak için daha uygundur.
Katman 5: Blokları Tespit Etme ve Yönetme
Her blok aynı görünmez. Yelp çoğu zaman CAPTCHA yerine genel bir "sayfa kullanılamıyor" kabuğu döndürür; bu yüzden saf scraper’lar boş yanıt aldıklarını fark etmeden veri aldıklarını sanabilir.
BLOCK_MARKERS = (
    "captcha", "px-captcha", "page not available",
    "access denied", "unusual traffic",
)

def is_blocked(resp):
    if resp.status_code in (401, 403, 429, 503):
        return True
    body = resp.text.lower()
    if any(m in body for m in BLOCK_MARKERS):
        return True
    # Bu bir arama/işletme sayfasıysa ama react-root-props eksikse,
    # Yelp soyulmuş bir blok yanıtı servis etmiştir
    if "react-root-props" not in body and "/biz/" in str(resp.url):
        return True
    return False
| Sinyal | Anlamı |
|---|---|
| HTTP 403 | Sert blok — IP/başlık/TLS yanmış |
| HTTP 429 | Oran limiti — çoğu zaman geri çekilme ile toparlanabilir |
| HTTP 503 | Genel blok ya da yük azaltma |
/error yönlendirmesi veya "page not available" gövdesi | Yumuşak blok |
| Sadece | JS bekleyen challenge sayfası |
Gövdede captcha / g-recaptcha / px-captcha | Durum ağır — CAPTCHA gerekiyor |
Listeleme sayfasında react-root-props eksik | Soyulmuş blok yanıtı |
Katman 6: Dayanıklı Ayrıştırma Tekniği — CSS Selector Yerine Gizli JSON
Tekrar etmenin değeri var: Yelp CSS sınıf adlarını derleme zamanında rastgeleleştirir. h3.y-css-14xwok2 üzerine kurulu bir scraper, Yelp h3.y-css-hcq7b9 ile yeniden dağıtım yaptığında birkaç hafta içinde kırılır.
Değişmeyen yükler şunlar:
<script type="application/ld+json">— schema.org yapılandırılmış verisi (ad, adres, telefon, puan, saatler)<script data-id="react-root-props">— arama sonuçlarının tamamı JSON olarakhttps://www.yelp.com/gql/batch— sabitdocumentIdiçeren GraphQL yorum uç noktası
CSS sınıfı ayrıştırıyorsanız, kum üstüne inşa ediyorsunuz demektir. Bunun yerine JSON’u ayrıştırın.
Katman 7: Gizli Tarayıcı Yedeği
Headless tarayıcıya yalnızca curl_cffi + residential proxy’ler yeterli olmadığında geçin — genellikle Yelp bir JavaScript challenge sayfası ya da CAPTCHA sunduğunda.
İşletme/arama/yorum kazımalarının %95’inde curl_cffi + gizli JSON + residential proxy’ler bir tarayıcıdan daha hızlı, daha ucuz ve daha güvenilirdir. Ama tarayıcı gerektiğinde:
| Araç | Durum (2025) | Notlar |
|---|---|---|
| rebrowser-playwright | Başlamak için önerilen nokta | CDP sızıntılarını düzeltmek için yamalanmış doğrudan Playwright |
| nodriver | Chrome gizliliğinde sınıfının en iyisi | undetected-chromedriver’ın halefi; WebDriver protokolünü tamamen atlar |
| patchright | Aktif olarak sürdürülen Playwright çatalı | Modern tespit testlerinden geçer |
| playwright-stealth | Olgun | navigator.webdriver yamalar, UA’dan HeadlessChrome ifadesini çıkarır |
Yelp için düz Selenium’dan kaçının. Fazla kolay parmak izi bırakır.
Yelp Fusion API vs. Python Scraping vs. Thunderbit: Tam Karşılaştırma
| Boyut | Yelp Fusion API | Python Scraping | Thunderbit |
|---|---|---|---|
| Tam yorum metni | ❌ 3 alıntı × ~160 karakter | ✅ Sınırsız (GraphQL) | ✅ Yerleşik yorum şablonu |
| Yorum meta verisi (oylar, işletme sahibi yanıtları) | ❌ | ✅ | ✅ AI’nın önerdiği alanlarla |
| Fotoğraflar | ❌ (Base planında 0) | ✅ Sınırsız | ✅ |
| Arama başına maksimum sonuç | 240 (2024 öncesi 1.000’di) | Sınırsız (sayfalanabilir) | Sınırsız |
| Günlük oran limiti | 300–500 (yeni) / 5.000 (eski) | Sadece proxy bütçesi | Kredi bazlı (Pro’da 3.000/ay) |
| Kurulum zahmeti | ~15 dk | Saatler ila günler | ~2 dakika |
| Anti-bot yönetimi | Yok | Sizin sorununuz | Halledilir (Cloud modu) |
| Hukuki risk | Düşük (yetkili) | Orta (ToS gri alanı) | Orta (kazıma ile aynı) |
| Maliyet (giriş) | $29/ay | ~$0,75–$4/GB proxy + geliştirme süresi | Ücretsiz plan |
| Maliyet (yoğun kullanım) | $643+/ay | $50–$500/ay proxy + geliştirme süresi | $38–$49/ay |
| Veri dışa aktarma | JSON | CSV/JSON (siz yazarsınız) | Excel / Sheets / Airtable / Notion — ücretsiz |
| Bakım | Düşük | Yüksek (selector’lar bozulur, anti-bot sertleşir) | Düşük (AI yeniden uyarlanır) |
Yelp Kazıma İçin Hukuki ve Etik İpuçları
Avukat değilim; bu hukuki tavsiye değildir. Ancak son iki yılda hukuki tablo yeterince değişti, bu yüzden bir Yelp kazıma projesine zaman yatırmadan önce temel noktaları bilmelisiniz.
Yelp’in Kullanım Şartları ne diyor: Ekim 2025 ToS güncellemesi açıkça "herhangi bir robot, spider... veya başka bir otomatik cihaz" kullanarak Servisin herhangi bir bölümüne "erişmeyi, almayı, kopyalamayı, kazımayı veya indekslemeyi" yasaklıyor. Ayrıca "AI Technologies ve/veya diğer otomatik araçlar" hakkında da yeni ifadeler ekledi.
Yelp Destek bunu şöyle tekrar ediyor: "Yelp, site üzerindeki herhangi bir kazımaya izin vermez."
robots.txt ne diyor: Yelp’in robots.txt dosyasında User-agent: * / Disallow: / kuralı var ve ayrıca GPTBot, ClaudeBot, PerplexityBot, CCBot ve Meta-ExternalAgent açıkça engelleniyor. Yalnızca Googlebot, Bingbot ve birkaç sosyal medya tarayıcısı izinli.
Önemli emsal karar: Meta v. Bright Data (N.D. Cal. Ocak 2024) davasında mahkeme, herkese açık ve oturum açılmamış verilerin kazınmasının Meta’nın Kullanım Şartları’nı ihlal etmediğine hükmetti. Buradaki kritik ayrım: oturum kapalı herkese açık veri vs. oturum açılmış veri. hiQ v. LinkedIn davası, açık verilerin kazınmasının büyük olasılıkla CFAA’yı ihlal etmediğini ortaya koydu; ancak hiQ yine de eyalet düzeyindeki haksız fiil iddialarında (chattels’a izinsiz girme, misappropriation) kaybetti ve 500.000 $’lık bir karar ile karşılaştı.
Pratik yönergeler:
- Yalnızca herkese açık, oturum açılmamış sayfaları kazıyın
- İstek hızınızı sınırlayın (bu rehberdeki gecikmeler etik hız limiti işlevi de görür)
- Adı geçen kullanıcılara atfedilmiş ham yorum metnini yeniden satmayın — yorumcu gizliliğine saygı gösterin
- Yerel veri koruma yasalarına uyun (CCPA, GDPR)
- Kazımak için giriş yapmayın — bu yetki sınırını aşar
- İşletme bilgisini (ad/adres/telefon/puan) herkese açık olgusal veri olarak, yorum metnini ise daha hassas veri olarak değerlendirin
Kendi durumunuz için bir hukuk uzmanına danışın.
Sonuç
Üç yol, tek hedef.
Yelp Fusion API; yetkili, bakımı kolay seçenektir — ancak 3 yorum alıntısıyla sınırlıdır ve başlangıç maliyeti 29$/ay’dır. Python scraping, Yelp üzerindeki her veri noktasında tam kontrol sağlar; fakat bunun için gerçek yatırım gerekir: TLS taklidi için curl_cffi, residential proxy’ler, rastgele gecikmeler, gizli JSON ayrıştırma ve Yelp’in savunmaları geliştikçe süren bakım. Thunderbit ise sizi "Yelp verisine ihtiyacım var" noktasından yaklaşık 30 saniyede "işte tablom" noktasına getirir; kod yok, proxy ayarı yok.
2025’te gerçekten çalışan anti-engel temelleri şunlar: tam Client Hints içeren gerçekçi başlıklar, TLS parmak izi taklidi için curl_cffi, üstel geri çekilmeli rastgele gecikmeler, residential proxy rotasyonu ve her şeyden önemlisi, kırılgan CSS selector’lar yerine gizli JSON’u (application/ld+json ve react-root-props) ayrıştırmak.
Hangi yolun size uyduğundan emin değil misiniz? Önce Thunderbit’in ücretsiz planını deneyin. İhtiyacınızı karşılarsa saatler kazandınız demektir. Daha fazla kontrol, tam programatik boru hatları, özel alanlar ya da CRM entegrasyonu gerekiyorsa yukarıdaki Python rehberi sizi kapsar. Kazıma araçları ekosistemine daha geniş bakmak isterseniz, en iyi web scraper Chrome uzantıları derlememize ya da web sitelerinden Excel’e veri çekme rehberimize göz atın.
Yelp Veri Çıkarma İçin Thunderbit’i Deneyin Get Started Free
SSS
Python ile Yelp’i ücretsiz olarak kazıyabilir miyim?
Evet — curl_cffi, parsel ve jmespath gibi ücretsiz kütüphanelerle. Ancak gerçek hacimde (birkaç düzineden fazla sayfa) $1,75/GB’dan başlayan IPRoyal gibi ücretli residential proxy’lere ihtiyacınız olacak. Thunderbit de hızlı ve no-code çıkarım için ayda 6 sayfalık ücretsiz bir plan sunuyor.
Yelp scraper’ları engelliyor mu?
Evet, agresif biçimde. Yelp TLS/JA3 fingerprinting, IP reputation scoring, CAPTCHA’lar, davranış analizi ve değişken gizlenmiş CSS sınıfları kullanıyor. Sade requests ilk istekte engellenir. Bu rehberdeki çok katmanlı anti-engel stratejisi — TLS taklidi için curl_cffi, gerçekçi başlıklar, rastgele gecikmeler ve residential proxy’ler — 2025’te işe yarayan yöntemdir.
Yelp Fusion API, scraping’den daha mı iyi?
İhtiyacınıza bağlı. API yetkili ve düşük riskli, ancak yalnızca her biri ~160 karakterlik 3 yorum alıntısı döndürüyor, arama sonuçlarını 240 ile sınırlıyor ve 29$/ay’dan başlıyor. Tam yorum metnine, yorum meta verisine ya da günde birkaç yüz kaydın üzerine ihtiyacınız varsa scraping tek seçenektir.
Python ile Yelp yorumlarını nasıl kazırım?
İşletme sayfasını çekmek için impersonate="chrome131" ile curl_cffi kullanın, kodlanmış işletme kimliğini <meta name="yelp-biz-id"> içinden alın, ardından GetBusinessReviewFeed işlemiyle https://www.yelp.com/gql/batch adresine POST atın ve base64 ile kodlanmış after cursor üzerinden sayfalayın. Adım adım kod yukarıdaki eğitim bölümünde yer alıyor. Scrapfly Yelp scraper deposu da sağlam bir referans uygulamadır.
Kod yazmadan Yelp kazıyabilir miyim?
Evet — Thunderbit’in AI Web Scraper’ı hazır Yelp işletme ve yorum şablonlarıyla gelir. Bir Yelp sayfası açın, AI Alanları Öner’e tıklayın, sonra Kazı’ya tıklayın. Google Sheets, Excel, Airtable ve Notion’a dışa aktarma; ücretsiz plan dahil tüm paketlerde ücretsizdir.
Daha Fazla Bilgi



