ESPN Scraper ใช้งานง่าย













ดึงข้อมูล ESPN ได้โดยไม่ต้องปวดหัว
Thunderbit ช่วยให้คุณดึงข้อมูลกีฬาจาก ESPN ได้ง่ายๆ ในไม่กี่คลิก
ดึงข้อมูล ESPN ได้ใน 2 คลิก
ไม่ต้องเสียเวลาทำโค้ดหรือเซ็ตอัปที่ซับซ้อน ด้วย Thunderbit คุณเพียงไฮไลต์ข้อมูลที่ต้องการ เช่น ชื่อนักกีฬา คะแนน วันที่แข่งขัน หรือสถิติใดๆ แล้วดึงออกมาได้ใน 2 คลิก ไม่ต้องใช้ CSS selector ไม่ต้องยุ่งกับ API ซับซ้อน แค่ชี้ คลิก แล้วได้ข้อมูล ESPN ที่ต้องการ
ข้อมูล ESPN ที่สะอาด ใช้งานได้ทันที
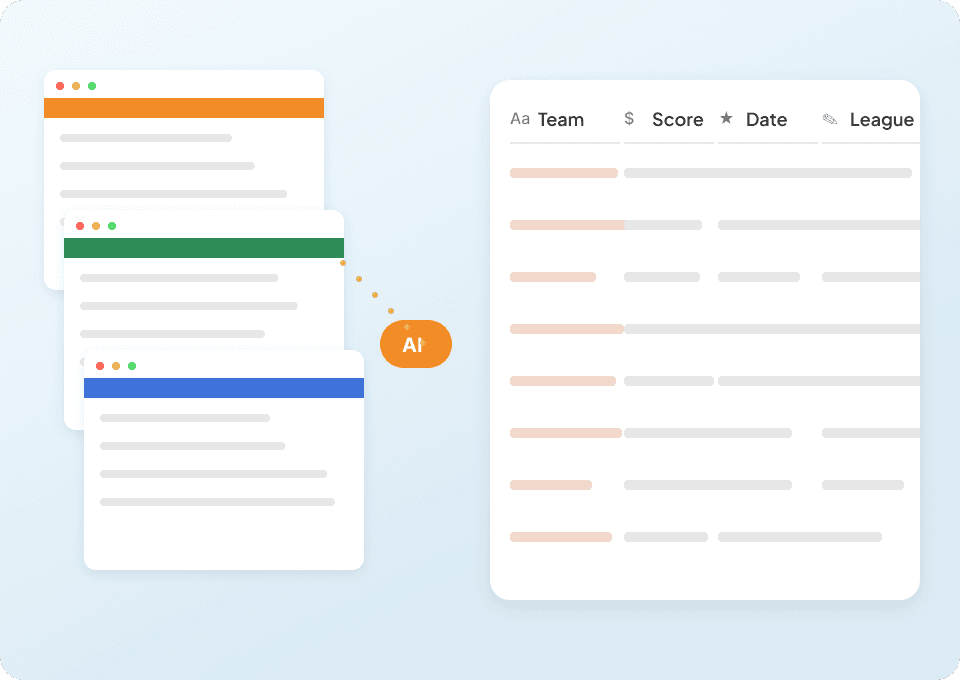
ข้อมูลดิบจาก ESPN มักมาในรูปแบบที่ไม่สม่ำเสมอและใช้งานยาก Thunderbit จะทำความสะอาดและจัดโครงสร้างข้อมูลให้อัตโนมัติขณะดึงข้อมูล ไม่ว่าจะเป็นสถิตินักกีฬา ชื่อทีม หรือสถานะเกม ทำให้ผลลัพธ์พร้อมสำหรับการวิเคราะห์หรือรายงานทันทีเมื่อดึงเสร็จ ไม่ต้องจัดรูปแบบเอง
ดึงข้อมูล ESPN หลายหน้าได้พร้อมกัน
การดึงข้อมูล ESPN ทีละหน้าใช้เวลามากเกินไป Thunderbit สามารถเข้าไปดึงข้อมูลจากหน้า ESPN ได้หลายร้อยหน้าในการทำงานครั้งเดียว โดยไล่ตามลิงก์ไปยังหน้าทีม โปรไฟล์ผู้เล่น หรือรายละเอียดเกมแต่ละนัด เพียงใส่ URL ตั้งต้น แล้วให้ Thunderbit จัดการที่เหลือ
อะไรทำให้ Thunderbit แตกต่างจาก ESPN scrapers แบบเดิม?
ดึงข้อมูลกีฬาได้อย่างง่ายดาย แม้ว่าเลย์เอาต์ของ ESPN จะเปลี่ยนโดยไม่แจ้งล่วงหน้า
scraper แบบเดิม
วิธีทำงานแบบเก่าThunderbit AI
แนวทางที่ฉลาดกว่า

คำถามที่พบบ่อย
ที่เกี่ยวข้อง กรณีใช้งาน
สำรวจกรณีใช้งานเพิ่มเติมของ web scraper จาก Thunderbit

Substack Scraper
ดึงจำนวนผู้ติดตาม Substack, ชื่อบทความ และรายละเอียดของสำนักพิมพ์ได้ใน 2 คลิก — จากนั้นส่งออกไปยัง Excel, Google Sheets หรือ Notion ได้ทันที ไม่ต้องเขียนโค้ด เพราะ Thunderbit ใช้ AI จัดโครงสร้างข้อมูลให้คุณเอง
เรียนรู้เพิ่มเติม ->
TechCrunch scraper
ดึงบทความ TechCrunch, อัปเดตสตาร์ทอัพ, ชื่อเรื่อง, ลิงก์, วันที่, ผู้เขียน และสรุปได้ใน 2 คลิก — ไม่ต้องเขียนโค้ด Export ไปยัง Excel, Google Sheets หรือ Notion ได้ทันที เปลี่ยนข่าวดิบให้กลายเป็นข้อมูลที่มีโครงสร้างและนำไปใช้งานต่อได้จริง
เรียนรู้เพิ่มเติม ->
PubMed Scraper
Thunderbit’s PubMed Scraper ช่วยให้คุณดึงข้อมูลที่มีโครงสร้างจากหน้าค้นหาและหน้าบทความของ PubMed ด้วย AI ได้อย่างง่ายดาย ไม่ว่าจะเป็นงานวิจัยทางการแพทย์ที่กำลังมาแรง หลักฐานจากการทดลองทางคลินิก บทคัดย่อ ผู้เขียน สังกัดหน่วยงาน วันที่เผยแพร่ และลิงก์ต่าง ๆ แล้วส่งออกไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ทันที
เรียนรู้เพิ่มเติม ->
เครื่องมือดึงข้อมูลบทความสำหรับข้อความ ผู้เขียน และวันที่
รวบรวมพาดหัว ชื่อผู้เขียน วันที่ สรุป เนื้อหาบทความ ลิงก์ และสื่อจากหน้าบทความสาธารณะ จัดรายละเอียดของแต่ละบทความให้อยู่ในแถวเดียวกันอย่างชัดเจน แม้เว็บไซต์ข่าวจะมีรูปแบบหน้าแตกต่างกันก็ตาม
เรียนรู้เพิ่มเติม ->
เครื่องมือดึงข่าว: เชื่อมหัวข้อข่าวไปยังรายละเอียดบทความฉบับเต็ม
รวบรวมหัวข้อข่าวจากหน้าหมวดหมู่ หน้าเซ็กชัน หรือหน้าค้นหา จากนั้นเปิดลิงก์บทความเพื่อดึงชื่อผู้เขียน วันที่เผยแพร่ บทสรุป หมวดหมู่ และ URL ต้นทางที่มองเห็นได้ บอก Thunderbit เป็นภาษาเข้าใจง่ายได้เลยว่าคุณต้องการรายละเอียดบทความอะไร ก่อนเริ่มรัน
เรียนรู้เพิ่มเติม ->พร้อมเร่งพลังการดึงข้อมูลของคุณหรือยัง?
เข้าร่วมกับมืออาชีพกว่า 200,000+ คนที่ใช้ Thunderbit เพื่อทำเวิร์กโฟลว์การดึงข้อมูลเว็บให้อัตโนมัติ
ทดลองใช้ฟรีพร้อมเครดิตไม่จำกัดสำหรับ 8 หน้าเว็บ



