เครื่องมือดึงข้อมูลบทความสำหรับข้อความ ผู้เขียน และวันที่













เก็บข้อมูลบทความได้แม้เลย์เอาต์หน้าจะเปลี่ยน
อ่านฟิลด์ตามความหมาย ตั้งรันซ้ำตามเวลา และใช้เวิร์กโฟลว์เดียวกันได้กับเว็บไซต์สาธารณะหลายแบบ
ปรับตัวได้เมื่อเลย์เอาต์บทความเปลี่ยน
Thunderbit อ่านพาดหัว ชื่อผู้เขียน วันที่ สรุป และเนื้อหาบทความที่มองเห็นได้ตามความหมาย เวิร์กโฟลว์จึงพึ่งพาตำแหน่งคงที่บนหน้าเว็บน้อยลงเมื่อเว็บไซต์ข่าวเปลี่ยนเลย์เอาต์
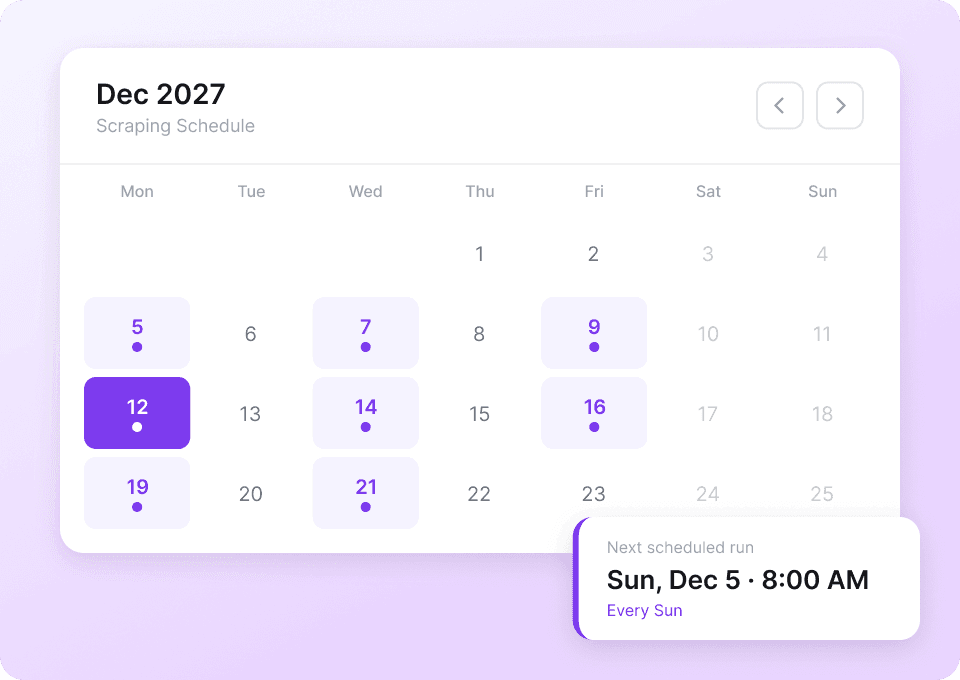
ตั้งเวลารันการดึงบทความซ้ำได้
กำหนดการรันซ้ำสำหรับหน้าข่าว บล็อก หรือหน้าหมวดสาธารณะที่คุณกลับมาใช้อีกได้ Thunderbit สามารถเก็บบทความล่าสุดที่มองเห็นได้ และส่งแถวใหม่ไปยังไฟล์หรือแอปที่คุณเลือก
ใช้เวิร์กโฟลว์เดียวกับทุกเว็บไซต์สาธารณะ
ใช้เวิร์กโฟลว์เดิมกับเว็บไซต์สาธารณะที่มีบทความได้ทั้งหมด เพียงระบุฟิลด์ที่ต้องการ แล้วให้ Thunderbit จัดข้อมูลของแต่ละหน้าให้อยู่ในคอลัมน์เดียวกัน
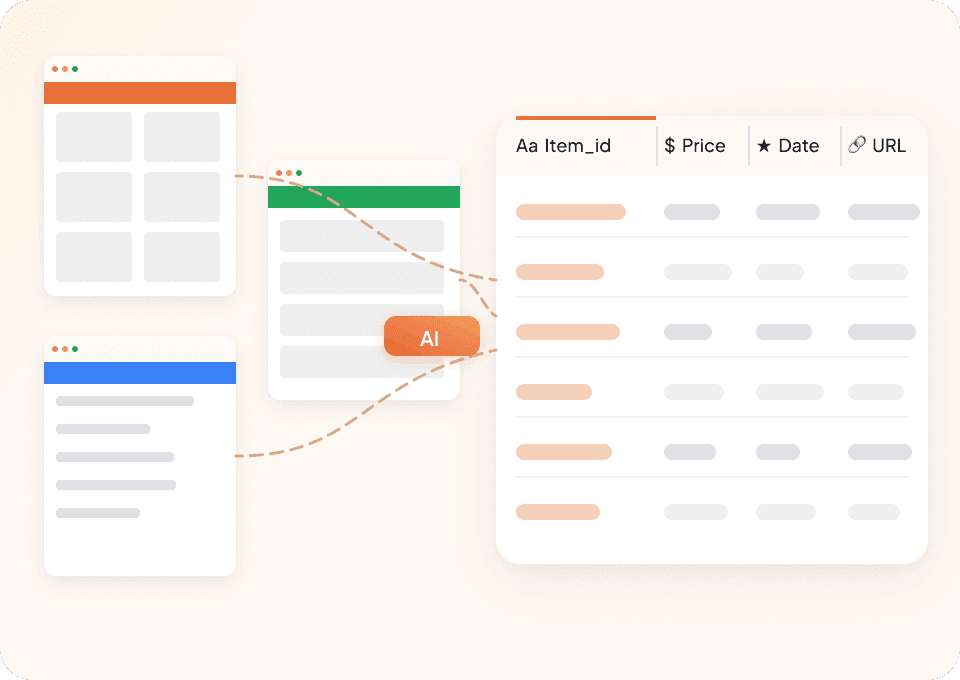
เวิร์กโฟลว์บทความเดียว ใช้ได้กับหลายเลย์เอาต์หน้า
ตัวเลือกแบบกำหนดตำแหน่งจะตามตำแหน่งบนหน้า แต่ Thunderbit AI จะมองหาฟิลด์บทความที่คุณระบุ
แผนผังตัวเลือกแยกสำหรับแต่ละผู้เผยแพร่
ดีไซน์ของแต่ละหน้าต้องดูแลแยกกันThunderbit จัดระเบียบฟิลด์บทความให้
เรคคอร์ดที่ต้องการจะคงรูปแบบสม่ำเสมอคุณดึงข้อมูลอะไรจากบทความได้บ้าง?
เลือกได้จากฟิลด์เนื้อหาที่มองเห็นได้ ผู้เขียน ผู้เผยแพร่ วันที่ ลิงก์ หัวข้อ สื่อ และเมตาดาต้าของหน้า รวม 30 รายการ
- พาดหัว
- พาดหัวสำรอง
- เนื้อหาบทความ
- สรุปบทความ
- ชื่อผู้เขียน
- URL ของผู้เขียน
- องค์กรของผู้เขียน
- ชื่อผู้เผยแพร่
- URL ของผู้เผยแพร่
- วันที่เผยแพร่
- วันที่แก้ไข
- หมวดบทความ
- คีย์เวิร์ด
- จำนวนคำ
- ภาษา
- Canonical URL
- URL ของเอนทิตีหลัก
- URL รูปภาพ
- คำบรรยายภาพ
- เครดิตภาพ
- URL วิดีโอ
- URL เสียง
- บรรทัดนำข่าว
- หัวข้อที่เกี่ยวข้อง
- การกล่าวถึง
- ลิงก์อ้างอิง
- URL ของสิทธิ์การใช้งาน
- ลิงก์บทความที่เกี่ยวข้อง
- ชื่อหน้า
- คำอธิบายเมตา
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.
คำถามเกี่ยวกับการดึงข้อมูลบทความสาธารณะ
เว็บไซต์ข่าวมีเลย์เอาต์และรายละเอียดหน้าที่ต่างกัน ดังนั้นฟิลด์ที่คุณได้จะขึ้นอยู่กับหน้าบทความที่คุณดึงข้อมูลมา
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

Substack Scraper
ดึงจำนวนผู้ติดตาม Substack, ชื่อบทความ และรายละเอียดของสำนักพิมพ์ได้ใน 2 คลิก — จากนั้นส่งออกไปยัง Excel, Google Sheets หรือ Notion ได้ทันที ไม่ต้องเขียนโค้ด เพราะ Thunderbit ใช้ AI จัดโครงสร้างข้อมูลให้คุณเอง
เรียนรู้เพิ่มเติม ->
TechCrunch scraper
ดึงบทความ TechCrunch, อัปเดตสตาร์ทอัพ, ชื่อเรื่อง, ลิงก์, วันที่, ผู้เขียน และสรุปได้ใน 2 คลิก — ไม่ต้องเขียนโค้ด Export ไปยัง Excel, Google Sheets หรือ Notion ได้ทันที เปลี่ยนข่าวดิบให้กลายเป็นข้อมูลที่มีโครงสร้างและนำไปใช้งานต่อได้จริง
เรียนรู้เพิ่มเติม ->
ESPN Scraper ใช้งานง่าย
ติดตามชื่อผู้เล่น วันที่แข่งขัน และคะแนนจาก ESPN ได้ใน 2 คลิกด้วย AI ของ Thunderbit — ไม่ต้องเขียนโค้ด ไม่ต้องตั้งค่าใดๆ ส่งออกไปยัง Excel, Google Sheets หรือ Notion ได้โดยตรง แล้วนำข้อมูลกีฬาไปใช้งานต่อได้ทันที
เรียนรู้เพิ่มเติม ->
PubMed Scraper
Thunderbit’s PubMed Scraper ช่วยให้คุณดึงข้อมูลที่มีโครงสร้างจากหน้าค้นหาและหน้าบทความของ PubMed ด้วย AI ได้อย่างง่ายดาย ไม่ว่าจะเป็นงานวิจัยทางการแพทย์ที่กำลังมาแรง หลักฐานจากการทดลองทางคลินิก บทคัดย่อ ผู้เขียน สังกัดหน่วยงาน วันที่เผยแพร่ และลิงก์ต่าง ๆ แล้วส่งออกไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ทันที
เรียนรู้เพิ่มเติม ->
เครื่องมือดึงข่าว: เชื่อมหัวข้อข่าวไปยังรายละเอียดบทความฉบับเต็ม
รวบรวมหัวข้อข่าวจากหน้าหมวดหมู่ หน้าเซ็กชัน หรือหน้าค้นหา จากนั้นเปิดลิงก์บทความเพื่อดึงชื่อผู้เขียน วันที่เผยแพร่ บทสรุป หมวดหมู่ และ URL ต้นทางที่มองเห็นได้ บอก Thunderbit เป็นภาษาเข้าใจง่ายได้เลยว่าคุณต้องการรายละเอียดบทความอะไร ก่อนเริ่มรัน
เรียนรู้เพิ่มเติม ->พร้อมเร่งพลังการดึงข้อมูลของคุณหรือยัง?
เข้าร่วมกับมืออาชีพกว่า 200,000+ คนที่ใช้ Thunderbit เพื่อทำเวิร์กโฟลว์การดึงข้อมูลเว็บให้อัตโนมัติ
ทดลองใช้ฟรีพร้อมเครดิตไม่จำกัดสำหรับ 8 หน้าเว็บ



